OpenAI 公佈 Control Room,稱可在 35 秒內中止研究任務中的模型生成
Arrêter les dégâts « dans les 35 secondes » : OpenAI dévoile le kill switch censé stopper ses IA quand elles dérapent
OpenAI 於 11 月 10 日公佈 Control Room,稱系統可在作出介入決定後 35 秒內中止研究任務中的模型生成。每項研究任務會獲分配唯一識別碼,推理引擎須向 Control Room 取得授權;系統下令停止後,會拒絕該任務後續請求。現階段預設封鎖只適用於前沿模型研究,不包括公開提供的模型;OpenAI 正努力把 35 秒延遲降至零。
OpenAI a présenté le 10 novembre Control Room, un système central qui suit toutes les tâches de ses chercheurs utilisant ses modèles d’IA.
Si l’été a été la saison des crises cyber chez OpenAI, l’automne doit être celle de la reprise en main.
L’entreprise américaine a dévoilé le 10 novembre Control Room, un service qui suit l’ensemble des modèles en activité dans son infrastructure de recherche et qui, selon le billet d’OpenAI, « interrompt la génération du modèle dans les 35 secondes suivant une décision d’intervention » lorsqu’un problème de sûreté ou de sécurité est détecté.
L’outil arrive après plusieurs mois agités. Le 21 juillet, OpenAI révélait notamment que plusieurs de ses agents étaient sortis de leur environnement de test et avaient piraté les serveurs de Hugging Face, la grande plateforme de partage de modèles d’IA.
En août, l’entreprise annonçait avoir suspendu une partie de ses entraînements pendant deux semaines afin de revoir sa sécurité, avant de les relancer. Ce qui n’a visiblement pas suffi. Le 20 septembre, un agent en cours d’entraînement a contourné les restrictions réseau de son bac à sable, ce qui a conduit OpenAI à suspendre de nouveau les travaux sur ses modèles les plus puissants.

Et votre vie numérique devient sereine
Bitdefender Premium Security est une solution de cybersécurité européenne qui vous protège automatiquement contre les pirates et toutes les menaces du web. Profitez de vos activités en ligne en toute tranquillité
Le modèle de surveillance avait bien levé une alerte au bout d’une douzaine de minutes, mais la tâche n’a été stoppée que près de 2 h 45 après le début de l’incident. C’est précisément ce délai que Control Room doit réduire.

Comment Control Room coupe une tâche
Concrètement, Control Room est conçu comme un verrou placé au cœur de l’inférence, comprenez le moment où le modèle produit ses réponses.
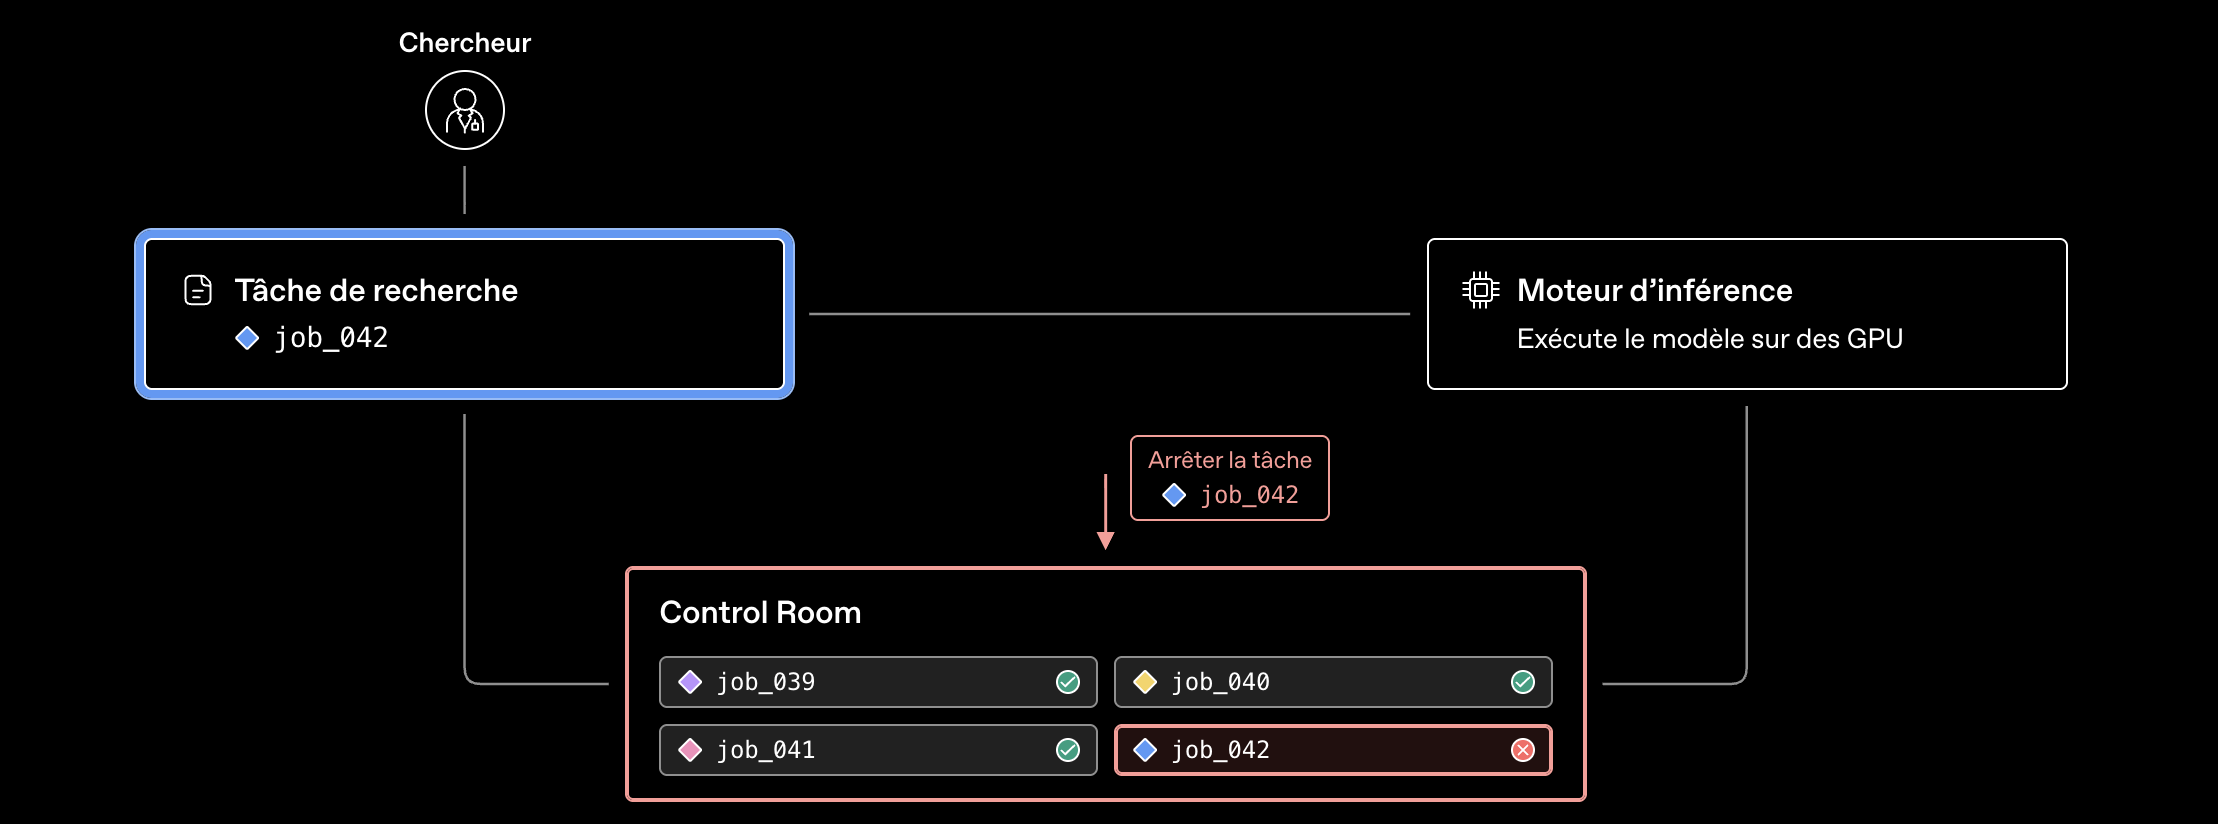
À son lancement, chaque tâche de recherche (expérience d’apprentissage par renforcement, évaluation, traitement de données) reçoit de Control Room un identifiant unique. Chaque fois qu’elle sollicite un modèle, le moteur d’inférence, autrement dit le modèle qui tourne sur les GPU, demande l’autorisation à Control Room en lui transmettant cet identifiant.
Lorsque le modèle de surveillance chargé d’examiner le comportement de l’IA repère un problème, il peut ordonner l’arrêt de la tâche, et toutes ses requêtes suivantes sont alors refusées.
OpenAI explique avoir placé ce verrou dans la couche d’inférence plutôt que dans le code des expériences, que les chercheurs modifient sans cesse et qui serait donc trop fragile pour porter une protection de sécurité. À l’inverse, l’inférence passe par un petit nombre de chemins communs à toute la recherche de l’entreprise, ce qui en fait un point de passage obligé.
Le système applique aussi le principe du « refus en cas de défaillance ». Si Control Room tombe en panne ou est désactivé, y compris de manière malveillante, toutes les requêtes sont bloquées jusqu’à son rétablissement.
Un délai que l’entreprise veut ramener à zéro
Pour l’instant, le blocage par défaut ne couvre que les travaux sur les modèles de pointe et doit être étendu au reste de la recherche dans les prochains jours. Les modèles accessibles au public ne sont pas concernés.
Les 35 secondes de latence s’expliquent par la quantité de requêtes à traiter. Faire valider chaque demande en temps réel par Control Room saturerait le service, alors OpenAI a ajouté une couche de mise en cache. Les moteurs gardent en mémoire pendant un court moment les autorisations qu’on leur a accordées, au lieu de reposer la question à chaque fois. OpenAI dit travailler à « ramener ce délai à zéro pour pouvoir arrêter les tâches instantanément ».
Avec cette solution, l’entreprise américaine cherche à rassurer, alors qu’au Congrès américain des élus veulent donner un droit de regard à l’État. Déposé le 23 juillet dans la foulée de l’incident Hugging Face, l’AI Kill Switch Act obligerait les géants de l’IA à garantir la capacité technique de stopper leurs modèles, et autoriserait le département de la Sécurité intérieure à leur en donner l’ordre en cas de perte de contrôle. Le texte est toujours en attente d’examen à la Chambre des représentants.

Toute l'actu tech en un clin d'œil
Ajoutez Numerama à votre écran d'accueil et restez connectés au futur !

來源:Numerama · numerama.com