Amazon Bedrock Managed Knowledge Base 如何透過 Agentic Retrieve 建構具記憶能力的 AI 智能體
Build memory-aware AI agents with Agentic Retrieve on Amazon Bedrock Managed Knowledge Base
Amazon Bedrock Managed Knowledge Base 透過 memoryConfiguration 接入 AgentCore memory,處理對話還原、相關記憶搜尋及回存。
文章以員工助理示範結合對話記憶與知識庫檢索,並以已驗證身份及 IAM 條件分別控制文件存取和用戶記憶隔離。
使用以知識為依據的應用程式的用戶,期望應用程式不僅搜尋效果良好,還能記住他們。他們會提出只有結合上一輪對話內容才能理解的追問。他們期望應用程式回答政策或程序相關問題時,會納入他們上個月告知應用程式的個人情況。他們亦期望每個答案都有權限閲讀的文件作為依據,並附上引用來源。無論應用程式是客戶支援助理、SaaS 產品內的文件聊天功能,還是用於查閲公司政策的內部助理,用戶的期望都一樣。
要滿足這些期望並不容易,因為有助提升搜尋精準度的背景資料往往存在知識庫以外。用戶的所在地、職務或產品方案級別,可能早在數週前一段無關的對話中提及。要運用這些資料,應用程式必須保存每段對話、從中擷取可長期使用的事實、判斷哪些事實與當前問題相關,再將它們加入請求。多人共用應用程式時,上述每個步驟都必須按用戶隔離,每份文件也一樣。
Amazon Bedrock Managed Knowledge Base 和 Amazon Bedrock AgentCore memory(Amazon Bedrock AgentCore 的一項功能) 現在會接手處理這些步驟:保存每段對話、從中擷取事實,並將相關事實帶入搜尋。只要在 AgenticRetrieveStream 請求中加入 memoryConfiguration,即可啟用此功能,讓 AgentCore memory 成為知識庫以外的另一個檢索來源。在同一次呼叫中,服務會還原對話內容,並由規劃器自行判斷用戶相關事實何時有助於回答。服務會從長期記憶中擷取該事實,並用來組成傳送至知識庫的子查詢。生成答案後,服務會將該輪對話保存至記憶中。同一個請求亦會帶有 userContext,因此知識庫只會傳回用戶的存取控制清單(ACL)允許其讀取的文件。此整合可選擇啟用,並向後相容。應用程式只需保留真正由你負責的部分:驗證用戶身份並傳遞其身份資料。
本文展示如何為多名用戶建置這類助理,讓他們共用一個知識庫和一個記憶資源。每位用戶只會看到有權閲讀的文件,而每位用戶的記憶資料亦會保持私密。本文以一家虛構公司 AnyCompany 的內部員工助理為例。員工透過 Amazon Cognito 登入,並就人力資源政策、IT 指南、工程操作手冊和銷售計劃提問。我們會示範如何從 Cognito ID token 讀取用戶身份、如何將身份傳遞至 AgenticRetrieveStream 以設定文件 ACL 和記憶資料、如何為多名用戶設計記憶命名空間,以及如何查看追蹤記錄,瞭解規劃器何時使用了記憶資料。最後,即使應用程式程式碼出錯,我們也會透過 AWS Identity and Access Management (IAM) 強制執行按用戶隔離記憶資料。如果你按照 在企業數據上使用 Amazon Bedrock Managed Knowledge Base 建置多租戶代理式聊天應用程式 部署了應用程式,本文會取代其中「自行保存對話記錄」這一步。
解決方案概覽
AnyCompany 將文件存放在 Amazon Simple Storage Service (Amazon S3)。一個受管理知識庫透過啟用了 ACL 的 Amazon S3 資料來源同步這些文件。同一個儲存貯體中的全域 ACL 檔案,列明哪些員工可以讀取各個資料夾:所有人均可讀取 HR 和 IT 資料夾,只有工程師可以讀取工程操作手冊,只有銷售人員可以讀取佣金計劃。所有員工共用一個 AgentCore memory 資源。Amazon Cognito 負責驗證員工身分,其 ID token 提供兩項聲明:sub(用戶 ID)用來識別用戶的記憶,而已驗證的 email 則用來讓知識庫的 ACL 篩選器識別用戶。三名測試用戶登入:兩名工程師 Maya 和 Liam,以及一名銷售人員 Sofia。本文中的追蹤記錄摘錄,取自 GitHub repository 中範例應用程式的一次執行。
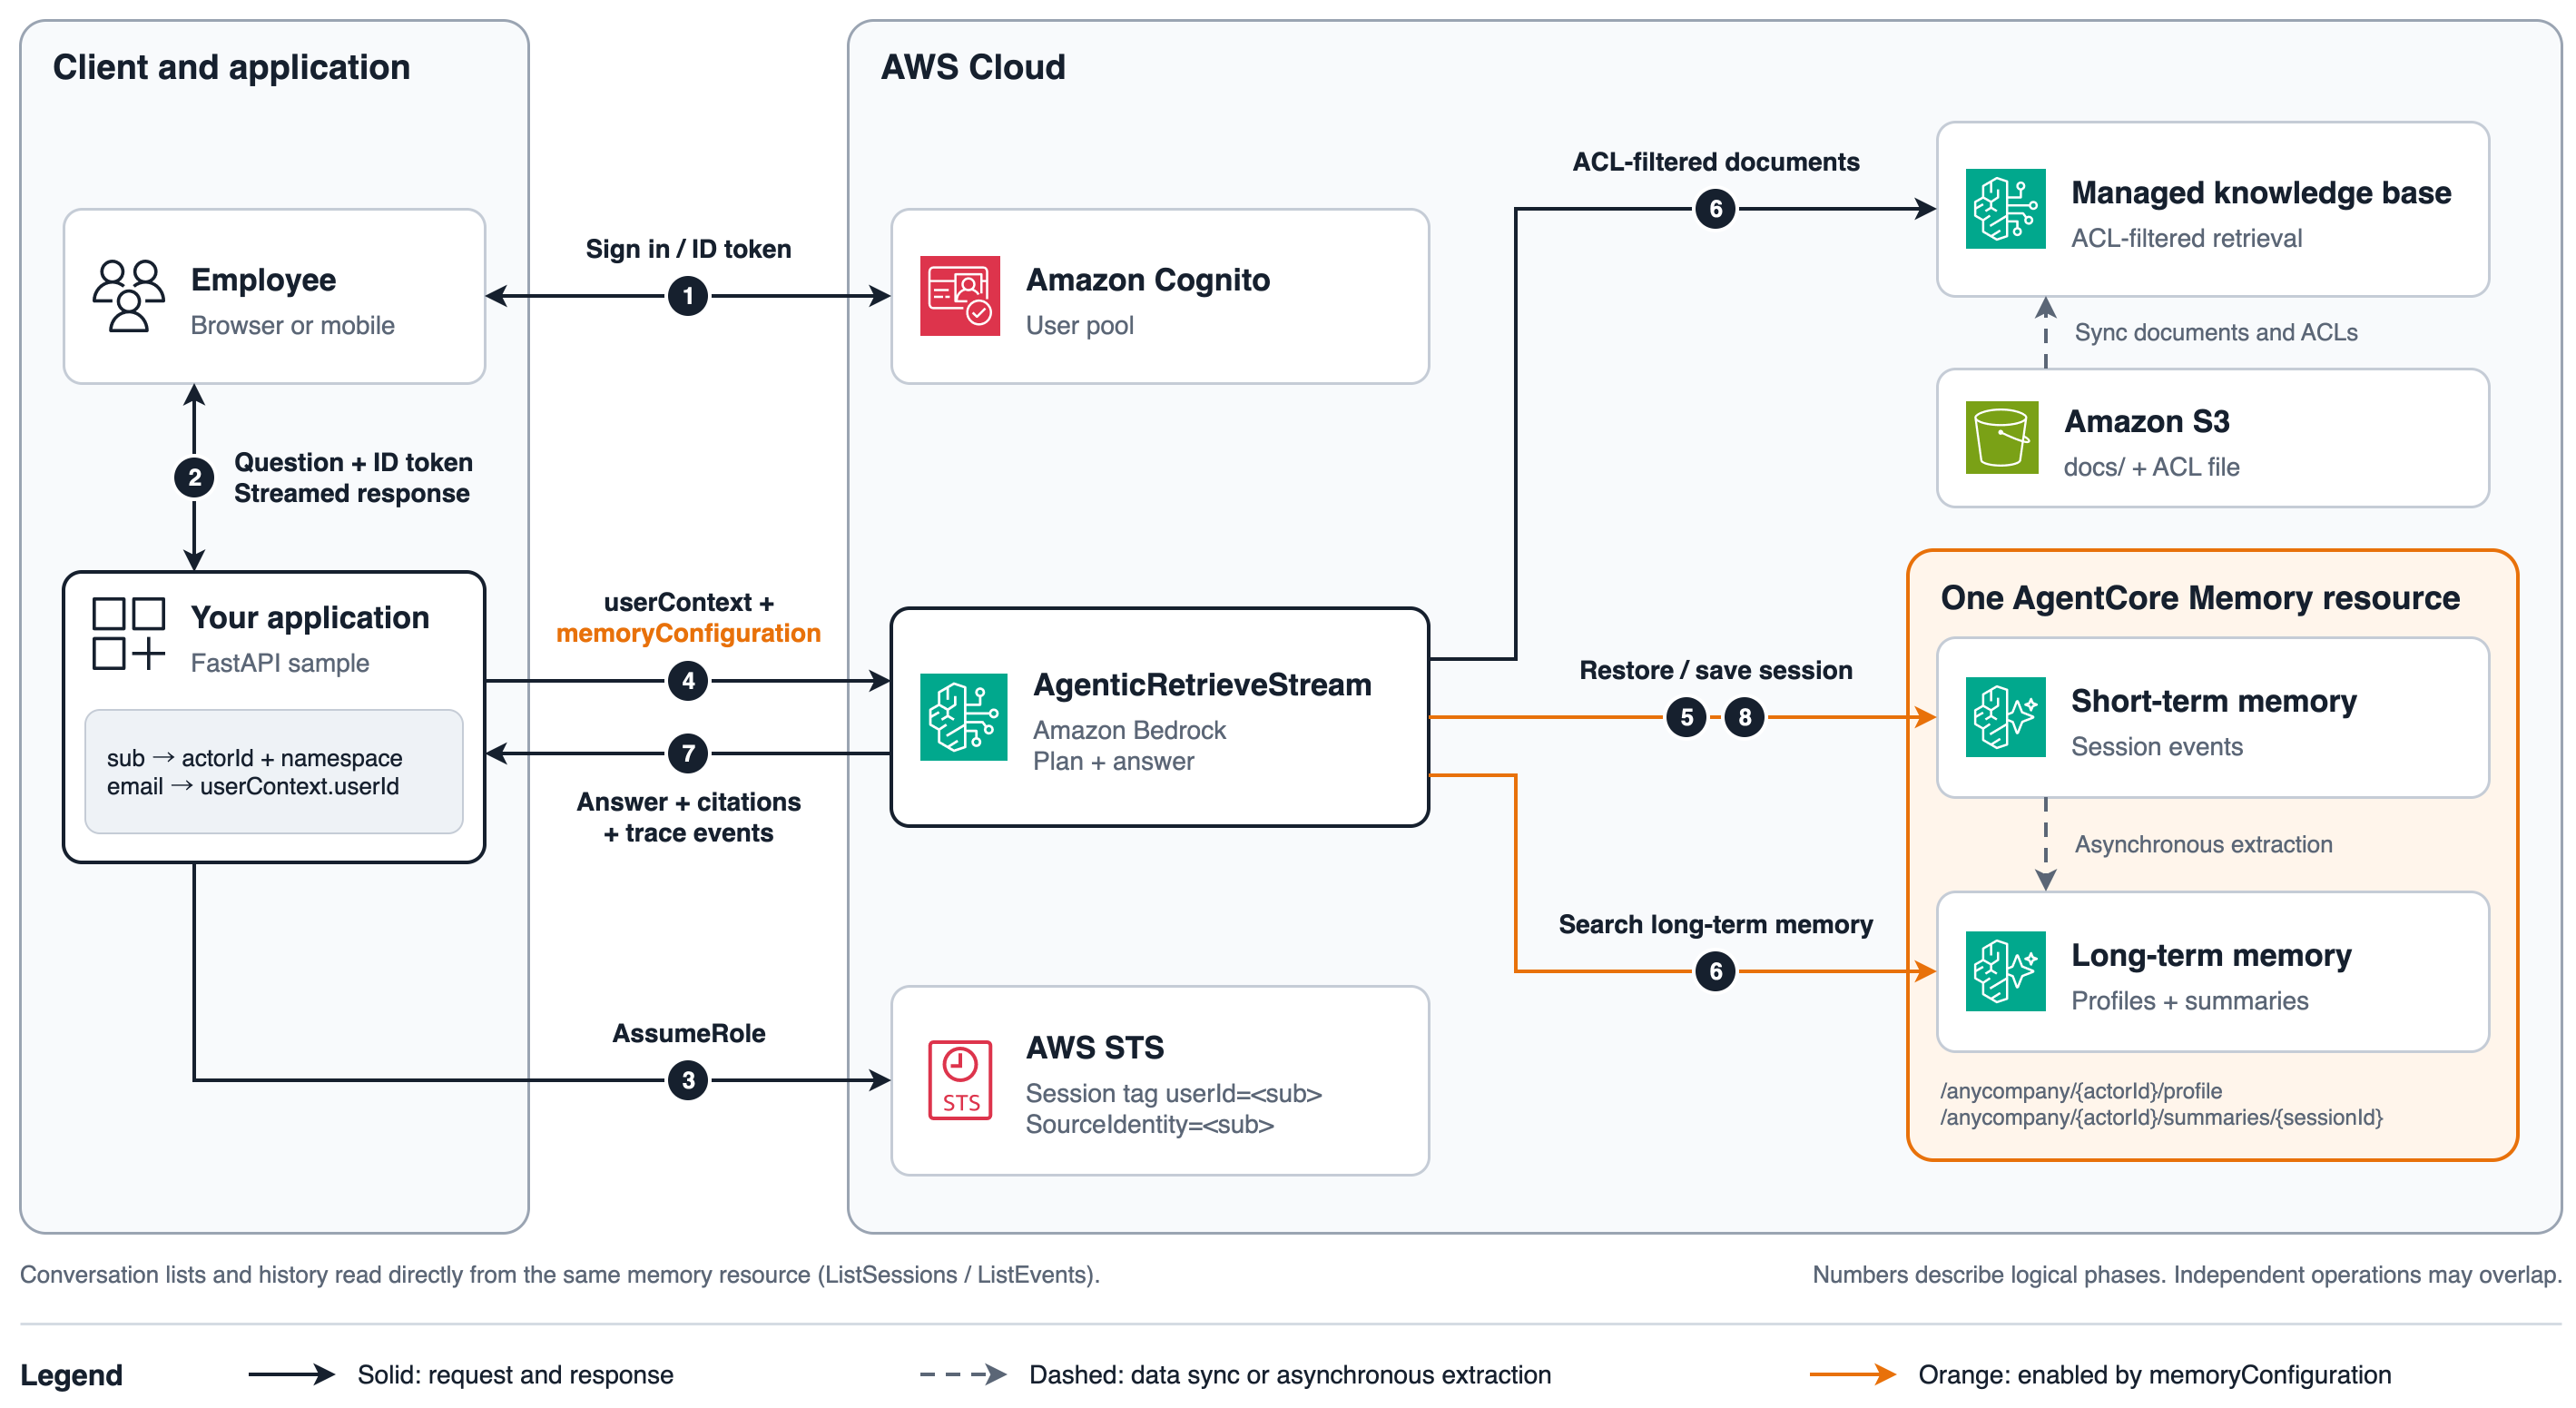
圖 1:具備記憶功能的員工助理架構。應用程式會驗證用戶身分並構建請求(步驟 1–4)。Amazon Bedrock Managed Knowledge Base 會還原工作階段、檢索資訊、傳回答案,並將對話內容儲存至 AgentCore memory(步驟 5–8)。短期事件和長期記錄都屬於同一個記憶資源。
- 員工透過 Cognito 登入,並取得 ID token;這是一個由用戶集區簽署的 JSON Web Token (JWT)。
- 應用程式的 API 會驗證 token——在正式環境中使用 Amazon API Gateway JWT authorizer,在範例中則使用小型 FastAPI 服務。未經驗證的請求不會到達處理常式。
- 處理常式會從已驗證的 token 讀取兩項聲明:
sub會成為記憶的actorId和命名空間,而email會成為userContext.userId。用戶端本文只包含{ question, sessionId? }。處理常式隨後會代入應用程式的 IAM 角色,並附上此用戶的工作階段標籤userId=<sub>。 - 處理常式會呼叫
AgenticRetrieveStream,並使用知識庫作為檢索器、userContext,以及一個與此用戶綁定的memoryConfiguration。 - Managed Knowledge Base 會從 AgentCore memory 的短期記憶(STM)還原對話記錄,所用的是由
sessionBinding識別的 actor 和工作階段。 - Managed Knowledge Base 會根據
userContext套用 ACL 篩選,並從知識庫檢索資訊。它亦可透過推測式檢索,或由規劃器選取的記憶搜尋,檢索用戶已設定的長期記憶。 - Managed Knowledge Base 會將附有引用來源的答案和追蹤事件串流傳回處理常式。處理常式會使用關聯 ID 記錄追蹤資料,並將答案和追蹤資訊傳送至 UI。
- 使用
persistenceMode: DEFAULT時,服務會將問題和生成的答案儲存至工作階段。AgentCore memory 隨後會根據已設定的策略,非同步抽取長期記錄。
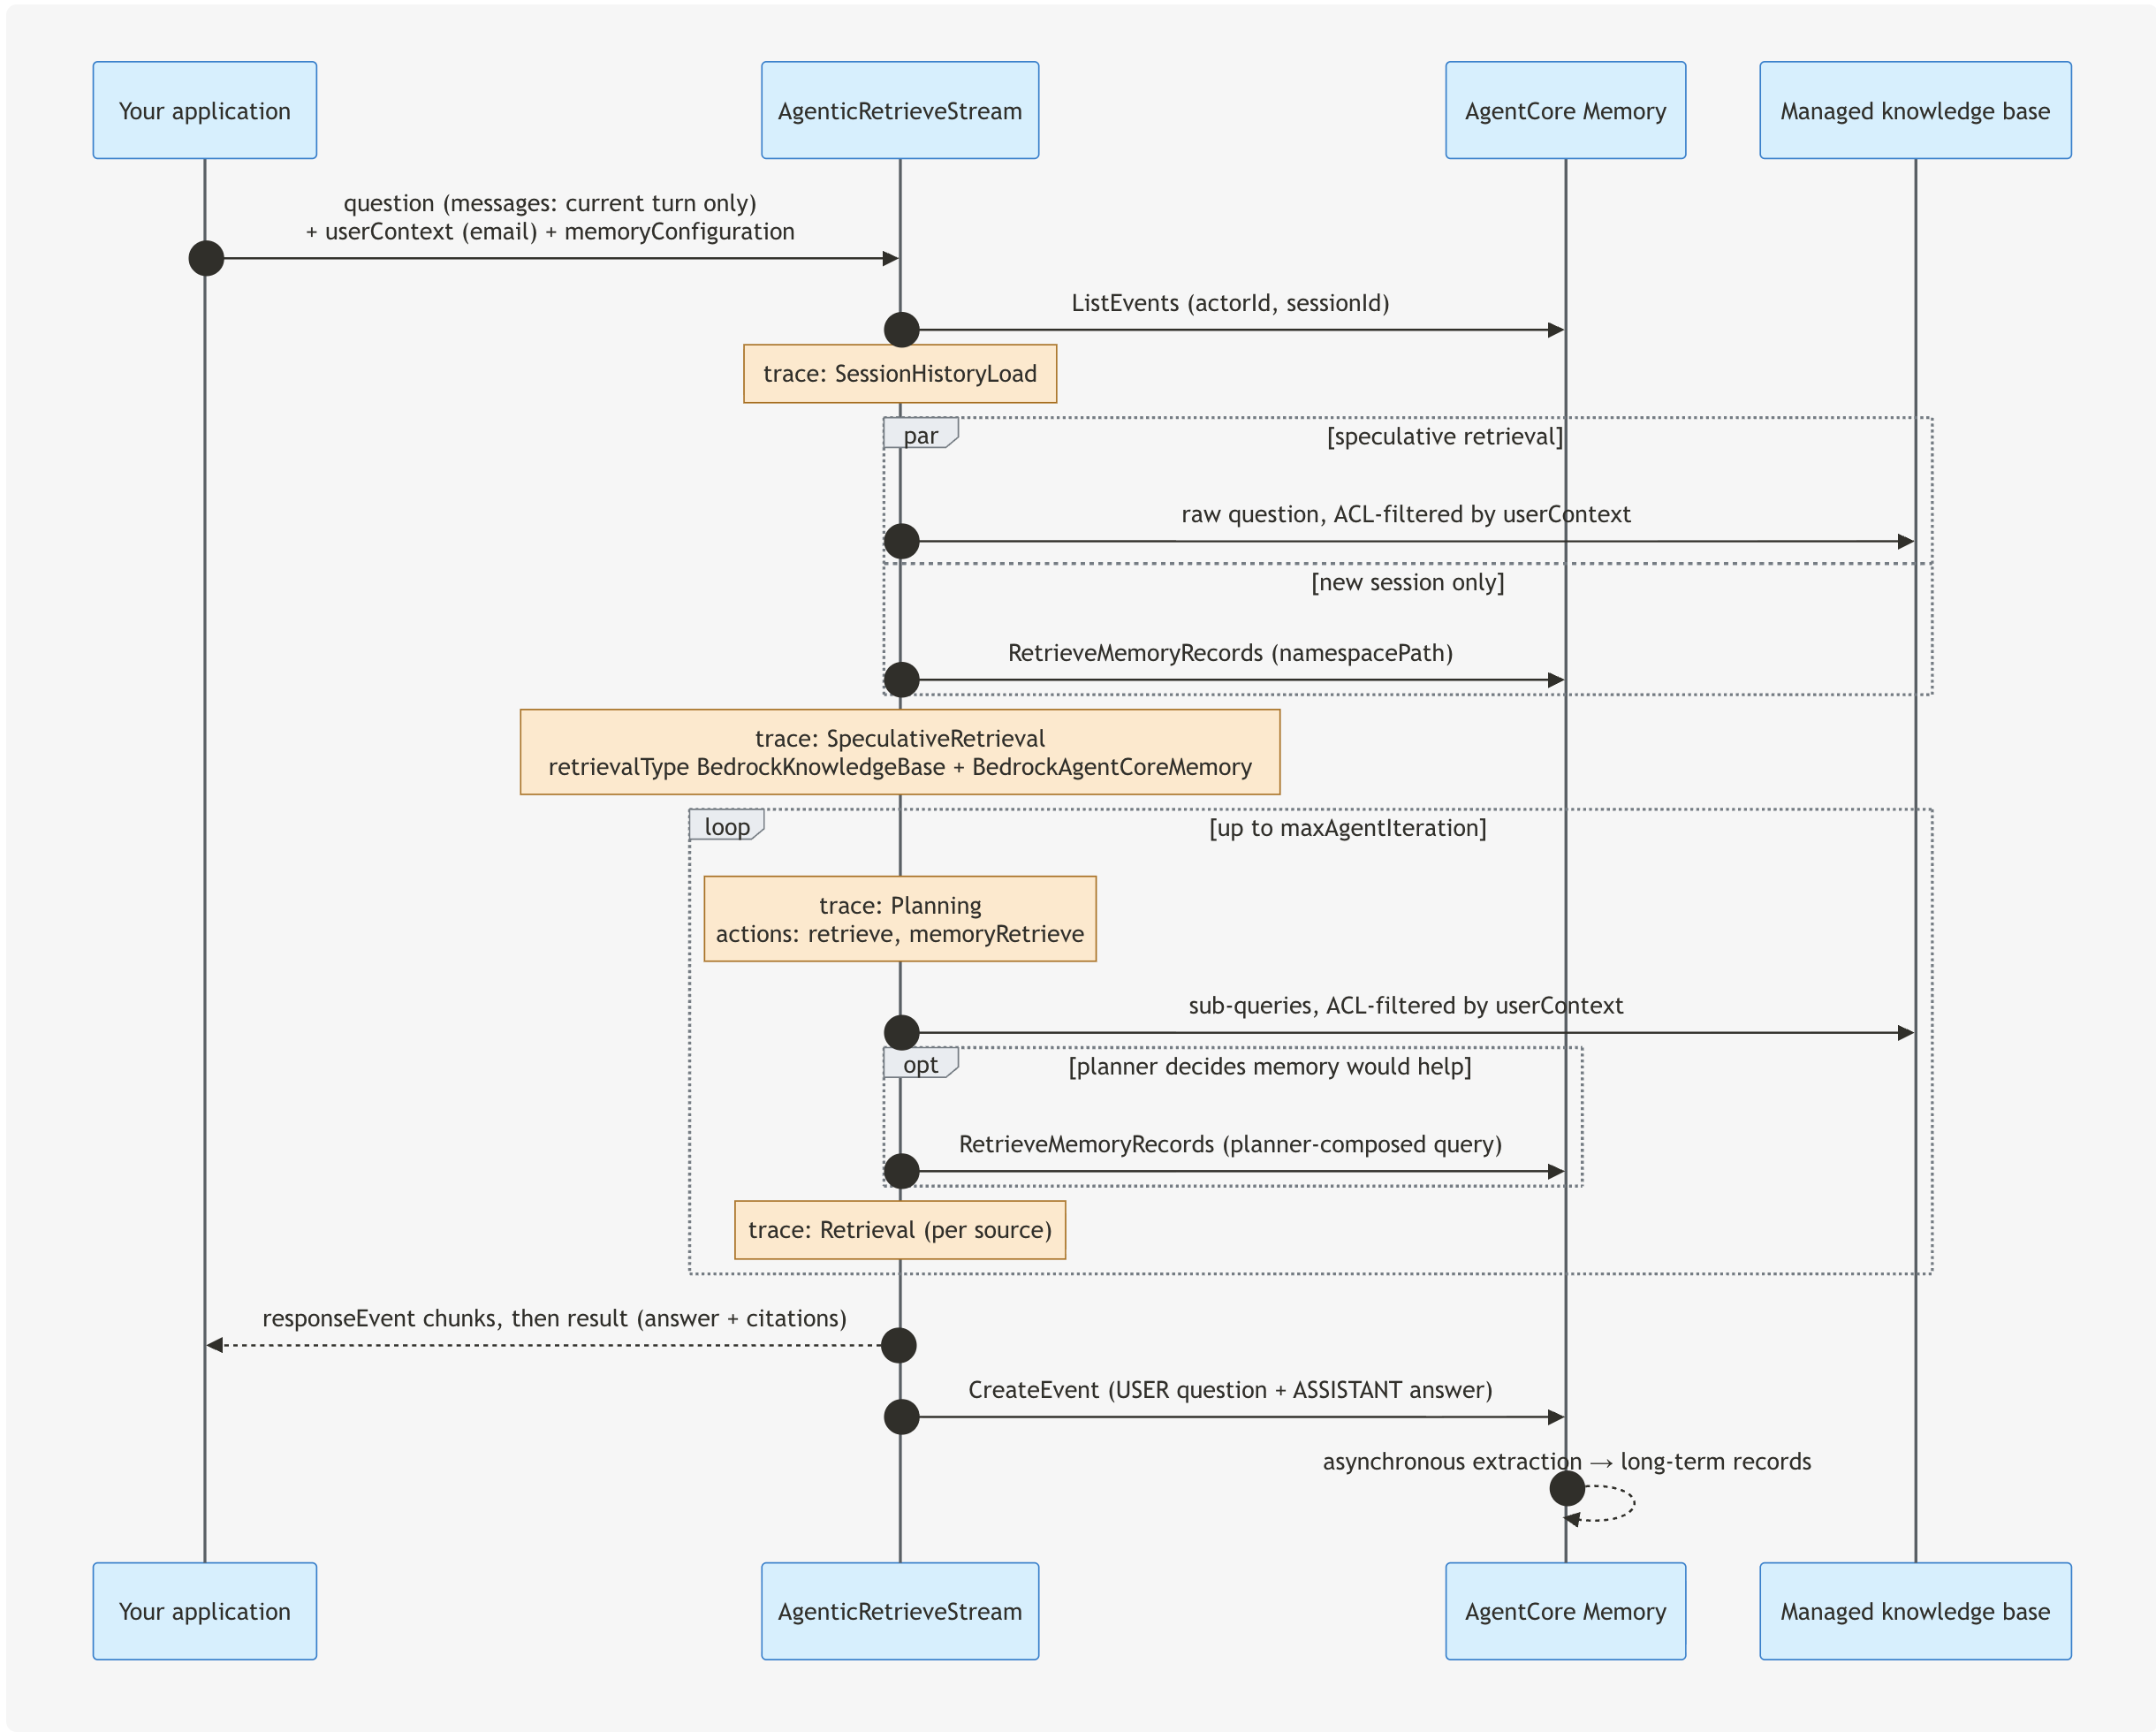
圖 2:一個使用 userContext 和 memoryConfiguration 的 AgenticRetrieveStream 回合。第一個箭頭與最後一個箭頭之間的所有工作,都由服務負責處理。
Managed Knowledge Base 負責擷取、ACL 篩選、編製索引、排序、規劃、檢索和生成。使用 memoryConfiguration 時,它亦負責還原工作階段、搜尋記憶和儲存資料。AgentCore memory 負責儲存、保留、加密和抽取。應用程式負責驗證用戶身分、UI,以及從 token 讀取用戶身分。系統沒有對話資料表:UI 列出或重新開啟對話時,會讀取同一個記憶資源。
身分如何對應至請求
每個值均由應用程式根據已驗證的 ID token 衍生。沒有任何值來自請求本文。
| 請求欄位 | 衍生自 | 限定範圍 | 執行限制的元件 |
userContext.userId |
ID token email(已驗證,且在用戶集區中不可變) |
可檢索哪些文件 | 知識庫 ACL 篩選 |
memoryConfiguration.sessionBinding.actorId |
ID 權杖 sub |
其短期記憶會在哪裏還原及寫入,以及長期命名空間中的 {actorId} |
AgentCore 記憶的鍵值設計,以及 IAM 條件 |
memoryConfiguration.sessionBinding.sessionId |
由應用程式為新對話產生。與 ListSessions 一同列出 |
該 actor 中的哪個對話 | 以 actorId 作為鍵 |
memoryConfiguration.retrievalConfigs[0].namespacePath |
/anycompany/<sub> |
規劃器可搜尋哪些長期記錄 | IAM 條件 |
這兩種聲明各有不同用途。知識庫以電郵地址識別用戶,因為已連接的資料來源會在其 ACL 中記錄電郵地址。記憶需要一個永不變更且永不重用的 actorId。Cognito sub 同時符合這兩點。電郵地址可以更改,也可能在有人離職後重新分配給新員工,令該員工繼承舊有記憶。你可以使用自己用戶資料儲存庫中的另一個穩定用戶 ID 作為 actorId。重點是它永遠不會轉到另一個人名下。
先決條件
- 本操作示範會使用位於美國西部(奧勒岡)區域(us-west-2)的受管理知識庫和 AgentCore 記憶資源。如代理式擷取文件所述,與此整合搭配使用的記憶資源必須與知識庫位於同一個 AWS 帳戶,並處於
ACTIVE狀態。 - Python 3.10 或更新版本,以及 Boto3 1.43.72 或更新版本。
- 具備建立 S3 儲存貯體、Cognito 用戶集區、IAM 角色、知識庫和記憶資源的權限。範例中的
infra/setup.py會以冪等方式建立所有這些資源。
解決方案操作示範
以下步驟會建立知識庫及其資料來源、設定記憶資源和 Amazon Cognito、建立請求,並讀取追蹤資料以確認結果。
步驟 1:建立啟用 ACL 的資料來源的知識庫
受管理知識庫不需要向量儲存庫:
請按照為受管理的 Amazon Bedrock 知識庫建立服務角色的指示,為你的設定設定服務角色,並在 roleArn 中傳入其 ARN。有關模型存取要求,亦請參閲受管理模型和自訂模型的先決條件。
kb = agent.create_knowledge_base(
    name="anycompany-assistant-docs",
    description="AnyCompany internal documents: HR policies, IT guides, engineering runbooks, sales plans.",
    roleArn=kb_service_role_arn,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {"embeddingModelType": "MANAGED"},
    },
)["knowledgeBase"]
文件位於儲存貯體的 docs/<folder>/ 路徑下。Amazon S3 本身沒有供爬取作業使用的權限系統,因此你需要在同一個儲存貯體中提供全域 ACL 檔案。每個項目都會將 S3 前綴對應至可讀取該前綴的電郵地址:
[
  {"keyPrefix": "s3://BUCKET/docs/hr/",
   "aclEntries": [{"Name": "maya@example.com",  "Type": "USER", "Access": "ALLOW"},
                  {"Name": "liam@example.com",  "Type": "USER", "Access": "ALLOW"},
                  {"Name": "sofia@example.com", "Type": "USER", "Access": "ALLOW"}]},
  {"keyPrefix": "s3://BUCKET/docs/engineering/",
   "aclEntries": [{"Name": "maya@example.com",  "Type": "USER", "Access": "ALLOW"},
                  {"Name": "liam@example.com",  "Type": "USER", "Access": "ALLOW"}]},
  {"keyPrefix": "s3://BUCKET/docs/sales/",
   "aclEntries": [{"Name": "sofia@example.com", "Type": "USER", "Access": "ALLOW"}]}
]
範例中的檔案亦會向所有人授予 docs/it/。然後建立資料來源。對於受管理知識庫,每個連接器的類型都是 MANAGED_KNOWLEDGE_BASE_CONNECTOR,而 connectorParameters.type 用來指定來源:
ds = agent.create_data_source(
    knowledgeBaseId=kb["knowledgeBaseId"],
    name="s3-docs-acl",
    dataSourceConfiguration={
        "type": "MANAGED_KNOWLEDGE_BASE_CONNECTOR",
        "managedKnowledgeBaseConnectorConfiguration": {
            "connectorParameters": {
                "type": "S3",
                "version": "1",
                "connectionConfiguration": {"bucketName": BUCKET, "bucketOwnerAccountId": ACCOUNT_ID},
                "filterConfiguration": {"inclusionPrefixes": ["docs/"]},
                "aclEnabled": True,
                "aclConfiguration": {"globalAccessControlListS3Uri": f"s3://{BUCKET}/acl/global-acl.json"},
            }
        },
    },
)["dataSource"]
建立資料來源後,便不能更改 aclEnabled。CreateDataSource 是非同步操作,因此請等候狀態變為 AVAILABLE。然後呼叫 StartIngestionJob,並等候 COMPLETE。同步操作會讀取文件和 ACL 檔案,並為每份文件連同其 ACL 一併建立索引。在範例中,系統掃描並建立了全部 11 份文件的索引,沒有任何失敗。未被任何 ACL 項目涵蓋的文件不會被匯入;電郵地址與任何項目都不相符的用戶,則不會從此資料來源取得任何結果。
同一模式亦適用於會從來源系統爬取權限的連接器,例如 Microsoft SharePoint、Google Drive 和 Atlassian Confluence。在這些情況下,權限來自來源系統,羣組亦會由來源系統解析,而知識庫也會即時根據來源系統檢查每項結果。你的應用程式程式碼無須更改:仍然只需在 userContext 中傳入用戶的電郵地址。如需完整清單,請參閲啟用存取控制清單感知功能。
步驟 2:建立記憶資源並設計命名空間
一個記憶資源供所有用戶共用。每位用戶之間的隔離由命名空間範本中的 {actorId} 實現;AgentCore memory 會在擷取時,根據每個事件解析這個值。有兩個選擇至關重要。
策略。兩種策略會擷取不同內容。摘要策略會為每段對話撰寫摘要,因此能捕捉用戶隨口提及的事實,例如「我在法蘭克福辦公室使用 Mac」。這些事實能讓之後的回答更切合個人情況,例如回答有關 PTO 的問題。用戶偏好策略會將用戶明確表達的偏好擷取為結構化記錄(「偏好簡短的項目符號回答,不要用表格」、「總是先部署至 eu-central-1」),不會將偶然提及的內容視為偏好。摘要讓你知道「我們談過甚麼」,偏好則讓你知道「這個人希望如何獲得答覆」。兩種策略都要使用。
配置。retrievalConfigs 只接受一個項目,因此單一 namespacePath 必須能讓規劃器看到某位用戶的所有相關內容。將 {actorId} 直接放在根節點之下:這樣 namespacePath: "/anycompany/<sub>" 就會涵蓋個人檔案及所有對話摘要。像 /anycompany/profile/{actorId} 和 /anycompany/summaries/{actorId} 這樣的配置,會令單一項目只能觸及其中一項。
memory = control.create_memory(
    name="anycompany_assistant_memory",
    eventExpiryDuration=30,          # days; raw conversation events expire after this
    # encryptionKeyArn=CMK_ARN,      # optional customer managed key
    memoryStrategies=[
        {"userPreferenceMemoryStrategy": {
            "name": "EmployeeProfile",
            "namespaces": ["/anycompany/{actorId}/profile"],
        }},
        {"summaryMemoryStrategy": {
            "name": "ConversationSummaries",
            "namespaces": ["/anycompany/{actorId}/summaries/{sessionId}"],
        }},
    ],
)["memory"]
等待記憶達到 ACTIVE 狀態。建立記憶時不需要用戶或 actorId,因此步驟 2 和步驟 3 的先後次序並不重要。無需為每位用戶個別佈建資源:新的 Cognito 用戶首次提出問題時,就會成為新的 actor。
步驟 3:設定 Cognito 並授予應用程式所需權限
建立用戶集區和不設用戶端密碼的應用程式用戶端。電郵地址決定用戶可以讀取哪些文件,因此必須設為必填、已驗證,並不可由用戶更改:
pool_id = idp.create_user_pool(
    PoolName="anycompany-assistant-employees",
    AutoVerifiedAttributes=["email"],
    Schema=[{"Name": "email", "Required": True, "Mutable": False, "AttributeDataType": "String"}],
    AdminCreateUserConfig={"AllowAdminCreateUserOnly": True},
)["UserPool"]["Id"]
Mutable 在建立用戶集區後便無法更改。如果電郵地址可由用戶更改,已登入的用戶便可能將自己的電郵地址改成同事的地址。如果用戶透過 Okta 或 Microsoft Entra ID 聯合登入,請將 IdP 的電郵地址對應至這項屬性,確保它與資料來源 ACL 中的電郵地址相符。
範例會啟用 USER_PASSWORD_AUTH,讓本機 UI 和測試可以直接登入。正式環境的應用程式通常會使用 Cognito 受管登入或 AWS Amplify。
為應用程式設定 IAM 角色。後端會為每位用戶承擔一次這個角色,並使用工作階段標籤 userId=<sub>;每條記憶政策陳述式都會以該標籤作為條件。以下是範例所用的完整政策:
{
  "Version": "2012-10-17",
  "Statement": [
    { "Sid": "AgenticRetrieve", "Effect": "Allow",
      "Action": "bedrock:AgenticRetrieveStream", "Resource": "*" },
    { "Sid": "KnowledgeBaseRetrieval", "Effect": "Allow",
      "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
      "Resource": "arn:aws:bedrock:us-west-2:111122223333:knowledge-base/KB_ID" },
    { "Sid": "PlannerAndGeneration", "Effect": "Allow",
      "Action": "bedrock:InvokeModelWithResponseStream", "Resource": "*" },
    { "Sid": "MemoryDescribe", "Effect": "Allow",
      "Action": "bedrock-agentcore:GetMemory",
      "Resource": "arn:aws:bedrock-agentcore:us-west-2:111122223333:memory/MEMORY_ID" },
    { "Sid": "MemorySessionsScopedToCaller", "Effect": "Allow",
      "Action": ["bedrock-agentcore:ListEvents", "bedrock-agentcore:CreateEvent",
                 "bedrock-agentcore:ListSessions"],
      "Resource": "arn:aws:bedrock-agentcore:us-west-2:111122223333:memory/MEMORY_ID",
      "Condition": {"StringEquals": {"bedrock-agentcore:actorId": "${aws:PrincipalTag/userId}"}} },
    { "Sid": "MemoryRecordsScopedToCaller", "Effect": "Allow",
      "Action": ["bedrock-agentcore:RetrieveMemoryRecords", "bedrock-agentcore:ListMemoryRecords"],
      "Resource": "arn:aws:bedrock-agentcore:us-west-2:111122223333:memory/MEMORY_ID",
      "Condition": {"StringLike": {"bedrock-agentcore:namespacePath": "/anycompany/${aws:PrincipalTag/userId}/*"}} }
  ]
}
ListEvents 必須與 sessionBinding 一併使用;RetrieveMemoryRecords 必須與 retrievalConfigs 一併使用;而當 persistenceMode 為 DEFAULT 時,則需要 CreateEvent。ListSessions 和 ListMemoryRecords 用於應用程式自身的讀取操作(對話清單和「記憶對你的瞭解」檢視畫面),而非用於 AgenticRetrieveStream。角色的信任政策允許後端自身的身分(正式環境中的 AWS Lambda 執行角色或 Amazon Elastic Container Service (Amazon ECS) 任務角色)使用 sts:AssumeRole、sts:TagSession 和 sts:SetSourceIdentity。如果記憶使用客戶管理金鑰,請在該金鑰上加入 kms:Decrypt。
步驟 4:從權杖讀取用戶身分,再建構請求
驗證 ID 權杖並讀取兩項聲明。只有 ID 權杖包含 email。存取權杖則不包含:
@dataclasses.dataclass(frozen=True)
class Principal:
    sub: str     # -> memory actorId and namespace
    email: str   # -> userContext.userId (document ACLs)

    def namespace_path(self, root: str) -> str:
        return f"{root}/{self.sub}"       # resolved literal, e.g. /anycompany/a8e1b390-...


def verify(id_token: str) -> Principal:
    key = jwks.get_signing_key_from_jwt(id_token)   # public keys from {issuer}/.well-known/jwks.json
    claims = jwt.decode(id_token, key.key, algorithms=["RS256"], issuer=ISSUER, audience=CLIENT_ID)
    if claims.get("token_use") != "id" or claims.get("email_verified") is not True:
        raise PermissionError("a verified ID token is required")
    return Principal(sub=claims["sub"], email=claims["email"].lower())
jwt.decode 會檢查簽章、簽發者(你的用戶集區)、到期時間,以及受眾(你的應用程式用戶端)。有關各項聲明的詳情,請參閲 瞭解身分(ID)權杖。使用 API Gateway 時,JWT 授權器會執行相同的檢查,並將聲明傳遞給你的處理常式。
接下來,取得用戶的 AWS 憑證。後端會為這位用戶承擔應用程式角色,並將工作階段快取至即將到期前:
creds = sts.assume_role(
    RoleArn=APP_ROLE_ARN,
    RoleSessionName=f"user-{principal.sub}",
    SourceIdentity=principal.sub,
    Tags=[{"Key": "userId", "Value": principal.sub}],
)["Credentials"]
現在,這位用戶發出的每個呼叫,包括代理式檢索代表呼叫者發出的記憶呼叫,都會以 assumed-role/anycompany-assistant-app-role/user-<sub> 身分執行,並附帶步驟 3 中政策所檢查的標籤。
決定 sessionId。開始新對話時,應用程式會產生一個,例如 "conv-" + uuid4().hex,並將它傳回用戶端。要繼續對話,用戶端便會將它傳回。要向用戶顯示其對話,請使用該用戶的 actorId 呼叫 ListSessions:
def list_conversations(principal):
    try:
        resp = memory.list_sessions(memoryId=MEMORY_ID, actorId=principal.sub, maxResults=50)
    except memory.exceptions.ResourceNotFoundException:
        return []   # the user has not asked anything yet, so there is no actor
    return [{"sessionId": s["sessionId"], "createdAt": s["createdAt"].isoformat()} for s in resp["sessionSummaries"]]
你不需要自行建立用戶與工作階段的對照表。接受用戶端傳來的 sessionId 是安全的,因為短期記憶以 (memoryId, actorId, sessionId) 作為鍵值,而 actorId 來自權杖。如果 Liam 傳來 Maya 的 sessionId,它指向的是 Liam 自己空間內的工作階段,而該空間是空的。Agentic 檢索本身不會驗證你提供的 actorId、sessionId 或命名空間是否屬於提出請求的用戶,因此這些值絕不能來自用戶端。只有在需要儲存記憶體不包含的資料(例如對話標題)時,才需要自行保留工作階段表。
然後建構請求:
def build_request(principal, question, session_id):
    return {
        # With sessionBinding, messages carries ONLY the current question.
        "messages": [{"role": "user", "content": {"text": question}}],
        "retrievers": [{"configuration": {"knowledgeBase": {"knowledgeBaseId": KB_ID}},
                        "description": KB_DESCRIPTION}],
        # Document ACLs: only documents this email may read are retrieved.
        "userContext": {"userId": principal.email},
        "agenticRetrieveConfiguration": {
            "foundationModelType": "MANAGED",
            "rerankingModelType": "MANAGED",
            "maxAgentIteration": 3,
        },
        "generateResponse": True,
        "memoryConfiguration": {
            "memoryId": MEMORY_ID,
            "sessionBinding": {"actorId": principal.sub, "sessionId": session_id},
            "persistenceMode": "DEFAULT",
            "retrievalConfigs": [{"namespacePath": principal.namespace_path("/anycompany")}],
        },
    }
如果沒有 userContext,啟用 ACL 的資料來源完全不會傳回任何結果。比較此請求與它取代的無狀態處理常式:
history = history_table.query(KeyConditionExpression=Key("sessionId").eq(session_id))
messages = [*replay(history), {"role": "user", "content": {"text": question}}]
response = runtime.agentic_retrieve_stream(messages=messages, retrievers=..., agenticRetrieveConfiguration=...)
history_table.put_item(Item={"sessionId": session_id, "q": question, "a": consume(response)})
呼叫前的查詢和呼叫後的寫入都已移除,而 messages 只包含一個元素。sessionBinding 包含三項規則,每項均透過特定的 ValidationException 強制執行。第一,messages 只承載目前的問題,因此你要為每個請求選擇一個歷史紀錄來源。第二,persistenceMode: DEFAULT(預設值)會將問題和產生的答案作為同一事件寫入,因此需要 generateResponse: true。第三,單獨使用 memoryId 無效。persistenceMode: NONE 會還原歷史紀錄但不寫入任何資料,適用於稽核或重播檢視。
步驟 5:更新用戶端合約並呈現歷史紀錄
用戶端會傳送 { question, sessionId? }。開始新對話時,應用程式會產生一個 sessionId,並將它作為第一個串流訊框傳回。用戶端在之後的回合會將它傳回;如要重新開始,則省略它。
由於記憶資源屬於你,應用程式會直接讀取它,以呈現對話:
def conversation_history(principal, session_id):
    resp = memory.list_events(memoryId=MEMORY_ID, actorId=principal.sub, sessionId=session_id,
                              includePayloads=True, maxResults=100)
    return [{"role": p["conversational"]["role"].lower(), "text": p["conversational"]["content"]["text"]}
            for ev in sorted(resp["events"], key=lambda e: e["eventTimestamp"])
            for p in ev["payload"] if "conversational" in p]
每個已儲存的回合恰好是一個事件,包含兩項資料:用戶的問題和最終答案。因此,歷史紀錄會呈現為清晰的對話紀錄,其他 AgentCore 記憶用戶端也能繼續使用。
步驟 6:從追蹤記錄驗證
每個回合的追蹤記錄會顯示知識庫和記憶功能執行的操作:
| 追蹤事件 | 出現時機 | 檢視內容 |
SessionHistoryLoad |
首個事件;每當設定 sessionBinding 時出現 |
_memory_event_count 和 _memory_message_count;在新工作階段中兩者皆為 0 |
SpeculativeRetrieval |
規劃前 | 在新工作階段中,retrievalMetadata 亦會列出 BedrockAgentCoreMemory。記憶項目帶有 _memory_* 中繼資料,但不包含文字。知識庫項目則帶有 _source_uri |
Planning |
每次迭代 | actions[].memoryRetrieve 表示規劃器選擇搜尋記憶,並使用自行編寫的查詢 |
Retrieval(含 retrievalType: BedrockAgentCoreMemory) |
每項已規劃的記憶操作 | _memory_record_count。計數為 0 屬正常結果 |
包含 status: FAILED 的記憶事件 |
記憶功能不可用或存取遭拒 | failures[].message。記憶功能以盡力而為方式運作:請求會繼續處理,答案則由知識庫產生 |
以下執行記錄展示了這些行為。摘錄均為原文,並為縮短篇幅而有所刪節。
文件 ACL:Maya 和 Sofia,問題相同。「每週的值班津貼是多少?」值班指南位於 docs/engineering/。Maya 的檢索結果包含 docs/engineering/oncall.md,答案是「每週 500 USD 或 450 EUR。」Sofia 的推測式檢索,以及規劃器後續提出的子查詢,只傳回人力資源和銷售資料片段:
Planning/SUCCEEDED   actions: retrieve("on-call stipend compensation policy")
Retrieval/SUCCEEDED  [BedrockKnowledgeBase]  9 items   # docs/hr/*, docs/sales/commission-plan.md
她的答案指出,她可存取的來源中沒有記載值班津貼。應用程式沒有作出存取判斷,而是傳入 userContext.userId: "sofia@example.com",由知識庫進行篩選。佣金計劃的情況則相反:Sofia 可享 12% 加速獎勵,而 Maya 的檢索結果不包含 docs/sales/。
回合 1:Maya,開始新對話。「我如何在手提電腦上設定 VPN?我在法蘭克福辦公室使用 Mac。」
SessionHistoryLoad/SUCCEEDED    "Restored 0 short-term memory event(s)"
SpeculativeRetrieval/SUCCEEDED  [BedrockAgentCoreMemory, BedrockKnowledgeBase]  10 items
Planning/SUCCEEDED答案會提供法蘭克福閘道(vpn-fra.anycompany.example)和 macOS 的操作步驟。之後,工作階段中的 ListEvents 會顯示一個事件,當中有兩個酬載。
第 2 輪:Maya,同一段對話。「每隔幾分鐘就會斷線。我可以試試甚麼?」請求只包含這一句:
{"step": "SessionHistoryLoad", "status": "SUCCEEDED",
 "message": "Restored 1 short-term memory event(s)",
 "retrievalResponse": [{"metadata": {"_memory_session_id": "conv-d25dccca6cbf47a6af893621e546905d",
                                     "_memory_event_count": 1, "_memory_message_count": 2}}]}
規劃器發送了 retrieve("VPN disconnects every few minutes troubleshooting") 和 retrieve("Cisco Secure Client macOS frequent disconnect fix")。答案解讀了「it」所指的對象,並指出指南中 macOS 專屬的原因:iCloud Private Relay。在延續中的工作階段,SpeculativeRetrieval 只會查詢知識庫。該步驟中的長期記憶查詢會在新工作階段進行。
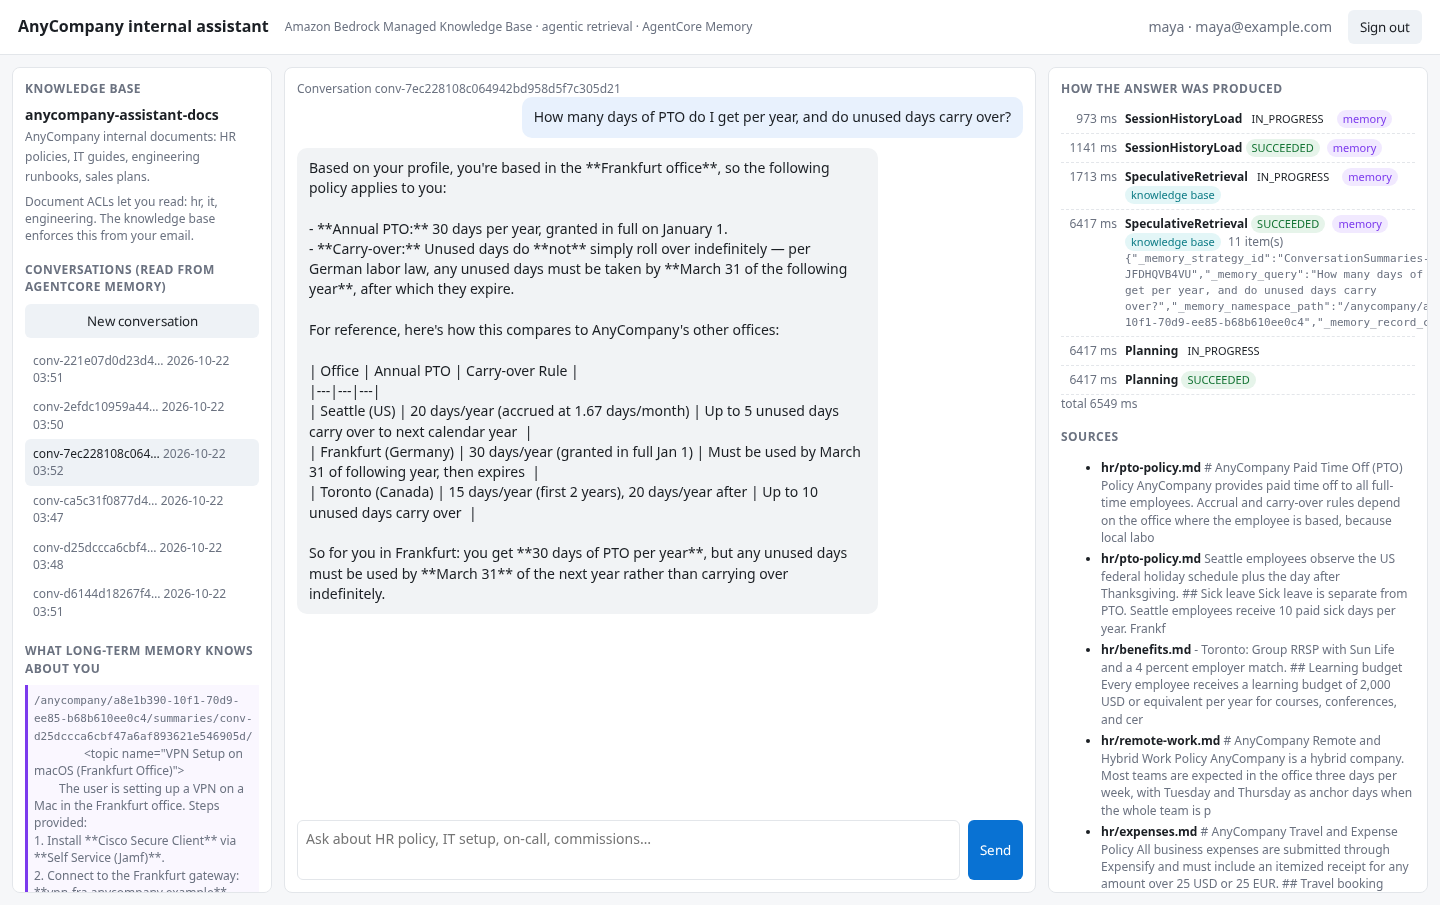
第 3 輪:Maya,稍後開啟的新對話。「我每年有多少天帶薪休假?未用完的日數可以累積到下一年嗎?」答案取決於她所屬的辦公室,而她在這段對話中從未提及相關資訊。推測式檢索以原始問題搜尋長期記憶,找到一筆記錄:
{"step": "SpeculativeRetrieval",
 "retrievalMetadata": [{"identifier": "JQUFTMTNZV", "retrievalType": "BedrockKnowledgeBase"},
                       {"identifier": "anycompany_assistant_memory-5llXYu8f2i", "retrievalType": "BedrockAgentCoreMemory"}],
 "retrievalResponse": [
   {"content": {"mimeType": "text/plain", "text": "# AnyCompany Paid Time Off (PTO) Policy ..."},
    "metadata": {"_document_title": "pto-policy.md", "_data_source_type": "S3",
                 "_source_uri": "https://.../docs/hr/pto-policy.md"},
    "sourceRetriever": {"identifier": "JQUFTMTNZV"}},
   {"content": {"mimeType": "text/plain"},
    "metadata": {"_memory_strategy_id": "ConversationSummaries-JFDHQVB4VU",
                 "_memory_query": "How many days of PTO do I get per year, and do unused days carry over?",
                 "_memory_namespace_path": "/anycompany/a8e1b390-10f1-70d9-ee85-b68b610ee0c4",
                 "_memory_record_count": 1},
    "sourceRetriever": {"identifier": "anycompany_assistant_memory-5llXYu8f2i"}}]}
知識庫項目和記憶項目共用一個 retrievalResponse。可透過 sourceRetriever.identifier 或 _memory_* 鍵來區分兩者。該記錄是她 VPN 對話的摘要。這已足夠:規劃器直接提供答案:「根據記憶資料,你在法蘭克福辦公室工作……你每年可享有 30 天帶薪休假,於 1 月 1 日全數批給,未用完的日數必須在翌年 3 月 31 日前用完。」IT 對話中提及的一項事實,令 HR 答案因人而異。
第 4 輪:Liam,提出相同問題的新對話。使用相同處理常式和相同記憶資源,但 token 不同。推測式檢索找不到任何關於他的資料,因此規劃器決定使用自己的查詢搜尋記憶:
{"step": "Planning", "status": "SUCCEEDED",
 "actions": [{"memoryRetrieve": {"inputQuery": {"text": "employee office location"},
                                 "memoryId": "anycompany_assistant_memory-5llXYu8f2i"}}]}
{"step": "Retrieval", "status": "SUCCEEDED",
 "message": "Retrieved 0 long-term memory record(s)",
 "retrievalMetadata": [{"identifier": "anycompany_assistant_memory-5llXYu8f2i", "retrievalType": "BedrockAgentCoreMemory"}],
 "retrievalResponse": []}
Liam 收到列出三個辦公室的表格,並被要求説明自己在哪個辦公室。應用程式決定規劃器可以搜尋哪些地方;規劃器則決定是否搜尋,以及要查詢甚麼:只有當規劃器判斷再次搜尋記憶會有幫助時,才會出現 memoryRetrieve 操作。使用 Liam 的 token,透過歷史記錄端點讀取 Maya 的 sessionId,結果是空清單。
 |
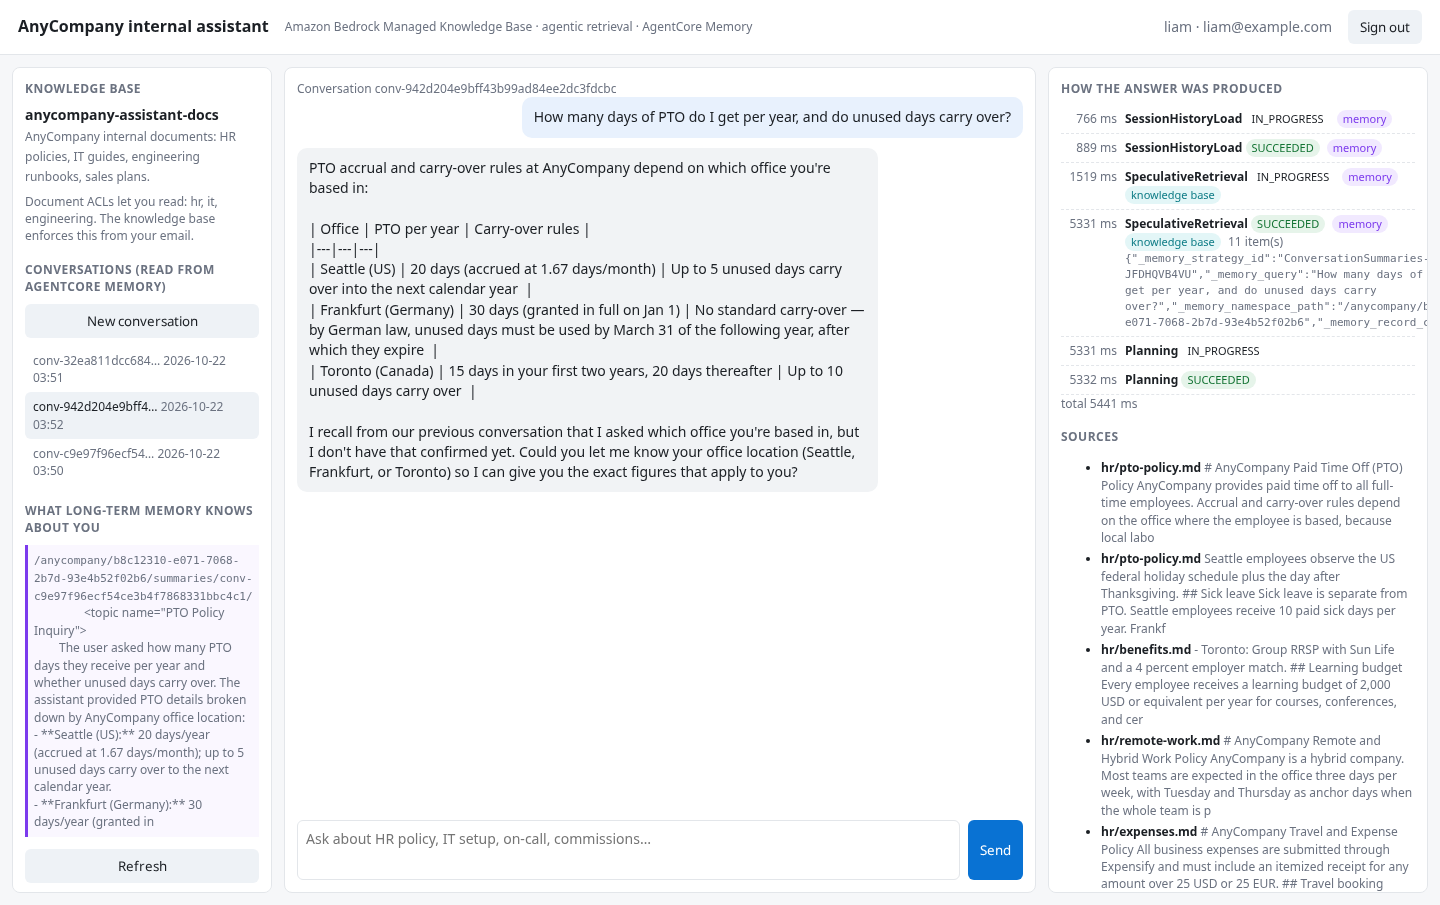 |
圖 3:兩位用戶提出相同問題。Maya 的追蹤記錄顯示命中記憶,並得到法蘭克福專屬答案;Liam 的追蹤記錄則顯示零筆記憶記錄和通用表格。
長期記憶抽取會在該回合持久化儲存後以非同步方式執行。在我們的測試中,第一筆記錄在第 2 輪後 81 秒出現,但這個時間並非保證。設計時須考慮資料可能要稍後才可用。本次對話提及的事實,不保證能在下一次對話中立即檢索到。範例會在執行第 3 輪前輪詢 ListMemoryRecords。
安全性和多用戶隔離
在此操作示範中,應用程式負責驗證身分;知識庫負責篩選。採用 ACL 的檢索只是篩選,並非授權。電郵地址只可從帶有 email_verified: true 的已驗證 ID token 取得,並須在 pool 中設為不可變更;同時要處理電郵地址重用問題:如果某個地址重新分配給另一人,該人便會取得舊用戶的文件存取權。知識庫採取失敗時拒絕的策略:文件沒有 ACL,或發生 ACL 錯誤,都只會令結果減少,不會增加。如果缺少結果,請檢查電郵地址是否與 ACL 項目相符。
記憶功能的身分識別同樣來自 token(步驟 4):actorId 和命名空間取自經驗證的 sub,絕不取自用戶端。
IAM 條件索引鍵,作為縱深防禦。 AgentCore memory 在 ListEvents、CreateEvent 和 ListSessions 上公開 bedrock-agentcore:actorId,並在 RetrieveMemoryRecords 和 ListMemoryRecords 上公開 bedrock-agentcore:namespacePath。記憶服務在請求期間進行代理式檢索時所作的呼叫,會根據呼叫者身分進行授權。這就是為何呼叫者的政策必須授權這些動作,以及第 3 步中的條件適用於這些動作的原因。使用以 Maya 身分承擔的工作階段時,若請求綁定至 Maya 的 actorId,便會正常進行。若請求綁定至 Liam 的 actorId,就是此政策要防範的錯誤,而且每項記憶操作都會遭拒:
SessionHistoryLoad/FAILED      failures: ["AccessDeniedException"]
SpeculativeRetrieval/SUCCEEDED failures: ["AccessDeniedException"]   # memory leg denied, KB leg answered
沒有任何內容寫入 Liam 的記憶:他的工作階段數量維持在 0。答案仍由知識庫產生。由於每位用戶都有自己的角色工作階段,AWS 亦會識別每次呼叫所屬的用戶:呼叫者為 assumed-role/anycompany-assistant-app-role/user-<sub>,並帶有 SourceIdentity=<sub>;工作階段持有人無法更改此項資料。
還有兩點需要注意。記憶服務是客戶擁有的資源,帳戶中的其他系統亦可能寫入其中。應將其內容視為輸入,並透過 policyConfiguration 將 Amazon Bedrock guardrail 附加至請求。亦要規劃資料生命週期。原始事件會根據 eventExpiryDuration 到期,但擷取的記錄不會。因此,用戶刪除工作流程須涵蓋該行為者工作階段的 DeleteEvent,以及該行為者命名空間下的 DeleteMemoryRecord。
可觀測性與失敗處理方式
記錄每個回合的完整追蹤資料,並為每個回合使用一個關聯 ID。規劃器的子查詢和最終結果同樣值得稽核。AWS/Bedrock/KnowledgeBases 會回報 Operation=AgenticRetrieveStream 的 Invocations、ClientErrors 和 TotalIterationCount。AWS/Bedrock-AgentCore 會回報每項記憶操作的 Invocations、Latency、Errors 和 UserErrors,以及每種擷取策略的 InputTokenUsage/OutputTokenUsage。啟用 Amazon CloudWatch Transaction Search 後,AgentCore Observability(Amazon Bedrock AgentCore 的一項功能)可端對端顯示一個回合的 spans。
記憶操作在設計上屬於盡力而為。若記憶呼叫失敗或遭拒,請求不會因此失敗。追蹤資料會包含一個 FAILED 記憶事件,並附上失敗訊息;回合會在不使用該記憶資料的情況下繼續。答案會由知識庫產生。請決定用戶介面是否要顯示此降級狀態。
注意事項
- 在整段對話期間使用固定的
sessionId。API 接受每個請求使用新的 ID,但使用新 ID 會在不明顯提示的情況下中斷連續性,並為每個回合產生一筆摘要記錄。 - 使用
namespacePath存取用戶所有長期記錄。retrievalConfigs接受一個項目,最多包含五個metadataFilters。namespace以字首比對,namespacePath則按階層比對,因此namespacePath適合用於根節點下的用戶專屬 ID。提供完整解析後的命名空間,因為系統會拒絕/anycompany/{actorId}這類範本。 - 預期只會還原
USER和ASSISTANT角色的對話事件。其他系統寫入、角色為TOOL或OTHER的事件會略過。 - 當應用程式需要精確控制每個請求所攜帶的歷史記錄時,請繼續傳送
messages,而非sessionBinding。例如,現有的歷史記錄儲存庫可能是對話的記錄系統,或者你可能會在傳送前編輯或隱去歷史記錄。使用sessionBinding時,服務會代你還原並儲存對話。你不能在同一個請求中同時使用兩者。 - 一個請求最多可攜帶五個知識庫。使用多個檢索器時,規劃器會根據知識庫
description路由各個子查詢,因此請仔細撰寫。 - 延遲與成本規劃。工作階段還原會增加約 200 milliseconds。在我們的測試中,使用託管模型時,配備一個知識庫、ACL 和記憶功能的完整回合需時 4–10 seconds。耗時取決於規劃迭代,而非記憶功能。這些是實測數字,並非服務承諾。智能體檢索按呼叫次數及底層檢索次數收費,而呼叫期間進行的記憶操作則按 AgentCore memory usage 計費。詳情請參閲 Amazon Bedrock 定價及 Amazon Bedrock AgentCore 定價。
清理
在範例中執行 python infra/teardown.py,以刪除知識庫、S3 儲存貯體及其中的物件、記憶資源(包括對話記錄和長期記錄)、Cognito 用戶集區,以及 IAM 角色。
總結
Amazon Bedrock Managed Knowledge Base 已提供檢索堆疊即服務。這個堆疊涵蓋資料匯入、文件 ACL、索引、排序,以及 AgenticRetrieveStream 中的規劃迴圈;規劃迴圈會將難題轉化為附有引用的答案。加入 memoryConfiguration 後,同一個呼叫現在會一併傳遞對話及用戶歷史記錄。對於多用戶應用程式,這免除了對話儲存層、歷史記錄重播和擷取流程。剩下的職責不多:驗證用戶身份,並從 ID token 讀取兩項聲明;將已驗證的電郵地址作為 userContext 傳入,讓知識庫篩選文件;並使用 sub 作為單一記憶資源的 actorId,其命名空間以 {actorId} 為根。在每位用戶各自的角色工作階段上使用 IAM 條件鍵,作為第二道防線,確保防線在整個智能體流程中持續有效。
如要開始使用,請從 GitHub 儲存庫部署範例。然後閲讀 AgenticRetrieveStream API 參考、啟用存取控制清單感知功能及 在智能體檢索中使用 AgentCore 記憶功能。如要了解檢索迴圈本身,請參閲 Amazon Bedrock Managed Knowledge Base 的智能體檢索。如要了解記憶功能的概念,請參閲 Amazon Bedrock AgentCore 記憶功能:建構具備情境感知能力的智能體。
作者簡介

Peng Yang
Peng 是 Amazon Bedrock Managed Knowledge Base 團隊的資深軟件工程師。過去數年,他的工作涵蓋 Amazon Kendra、Amazon Q Business、AWS Quick 及 Amazon Bedrock Managed Knowledge Base 的檢索和生成式 AI 系統。

Renya Kujirada
Renya 是 Amazon Web Services Japan 的 AI 專家解決方案架構師。他是 Amazon Bedrock AgentCore 在日本的技術負責人,與各行各業的客戶合作開發智能體、設計智能體平台及微調 LLM。加入 AWS 前,他曾任資料科學家,負責開發深度學習模型及建構由智能體驅動的解決方案。他獲選為 2025 Japan AWS Top Engineer,亦是 AWS Community Builder。

Jason Sheng
Jason 是 Amazon Bedrock Knowledge Bases 的資深軟件工程師,專門建構機器學習及生成式 AI 服務。過去六年,他參與了 Amazon Q、Bedrock Knowledge Bases、Amazon Kendra 及 Amazon Translate 的開發。

Siddhant Sahu
Siddhant 是 AWS 的資深產品經理,也是 Amazon Bedrock Managed Knowledge Base 的單一專責負責人,負責制定產品策略、規劃路線圖及推出產品。他構思並推出了代理式檢索功能及應用程式連接器,讓 AI Agent 能夠在 SharePoint、Confluence、S3 等重要商業應用程式的企業數據中執行複雜搜尋。服務自 2026 年 6 月推出以來,已獲 OpenAI、Syngenta、MRH Trowe、Sony 等企業採用,以企業數據建構 AI Agent。
來源:AWS Machine Learning Blog · aws.amazon.com