使用 Diffusers 以 Dreambooth 微調 Stable Diffusion 的實驗與設定建議
Training Stable Diffusion with Dreambooth using Diffusers
Hugging Face 團隊以 Diffusers 的 `train_dreambooth.py` 對 Stable Diffusion 進行 Dreambooth 微調實驗,整理降低過擬合及改善生成品質的設定建議。
文中以不同主體的對照實驗梳理學習率、訓練步數與 prior preservation 對過擬合的影響,為 Dreambooth 微調提供具體設定參照。
Dreambooth 是一種透過專門微調方式,向 Stable Diffusion 教授新概念的技術。有些人會用幾張自己的相片,讓模型把自己放進奇幻場景;另一些人則用它加入新風格。🧨 Diffusers 提供 Dreambooth訓練指令碼。訓練所需時間不長,但要選出合適的超參數並不容易,而且模型很容易過度擬合。
我們進行了大量實驗,分析 Dreambooth 中不同設定的影響。本文會介紹研究結果,以及使用 Dreambooth 微調 Stable Diffusion、改善成果的一些建議。
開始之前請留意,絕不可將此方法用於惡意用途、以任何方式製造傷害,或在未經他人知情下冒充他人。使用此方法訓練的模型仍受規管 Stable Diffusion 模型分發的 CreativeML Open RAIL-M license 約束。
注意:本文的前一版本曾以W&B 報告形式發佈。
重點摘要:建議設定
- Dreambooth 容易迅速過度擬合。要生成高質素圖像,必須在訓練步數和學習率之間找出「最佳平衡點」。我們建議採用較低學習率,逐步增加訓練步數,直至結果令人滿意。
- Dreambooth 訓練人臉需要更多訓練步數。在我們的實驗中,批次大小為 2、學習率(LR)為 1e-6 時,訓練 800 至 1200 步效果良好。
- 在人臉訓練中,使用先驗保留有助避免過度擬合。對其他主體而言,它似乎沒有太大影響。
- 如果生成圖像有雜訊或質素下降,很可能是過度擬合。首先,請採用上述步驟避免這種情況。如果生成圖像仍有雜訊,可使用 DDIM 排程器,或增加推論步數(我們的實驗中約 100 步效果良好)。
- 除了 UNet 之外,也訓練文字編碼器,對質素有重大影響。我們以文字編碼器微調、低學習率及合適步數的組合取得最佳成果。不過,微調文字編碼器需要更多記憶體,因此最好使用至少配備 24 GB RAM 的 GPU。使用 8-bit Adam、
fp16訓練或梯度累積等技術,也可以在配備 16 GB 記憶體的 GPU 上訓練,例如 Google Colab 或 Kaggle 提供的 GPU。 - 使用或不使用 EMA 進行微調,結果相近。
- 訓練 Dreambooth 無須使用
sks一詞。早期其中一個實作採用它,是因為它在詞彙表中屬於罕見 token;但它其實是一種步槍。我們的實驗,以及例如 @nitrosocke 的實驗均顯示,選用自然地用來描述目標的詞語也可以。
學習率的影響
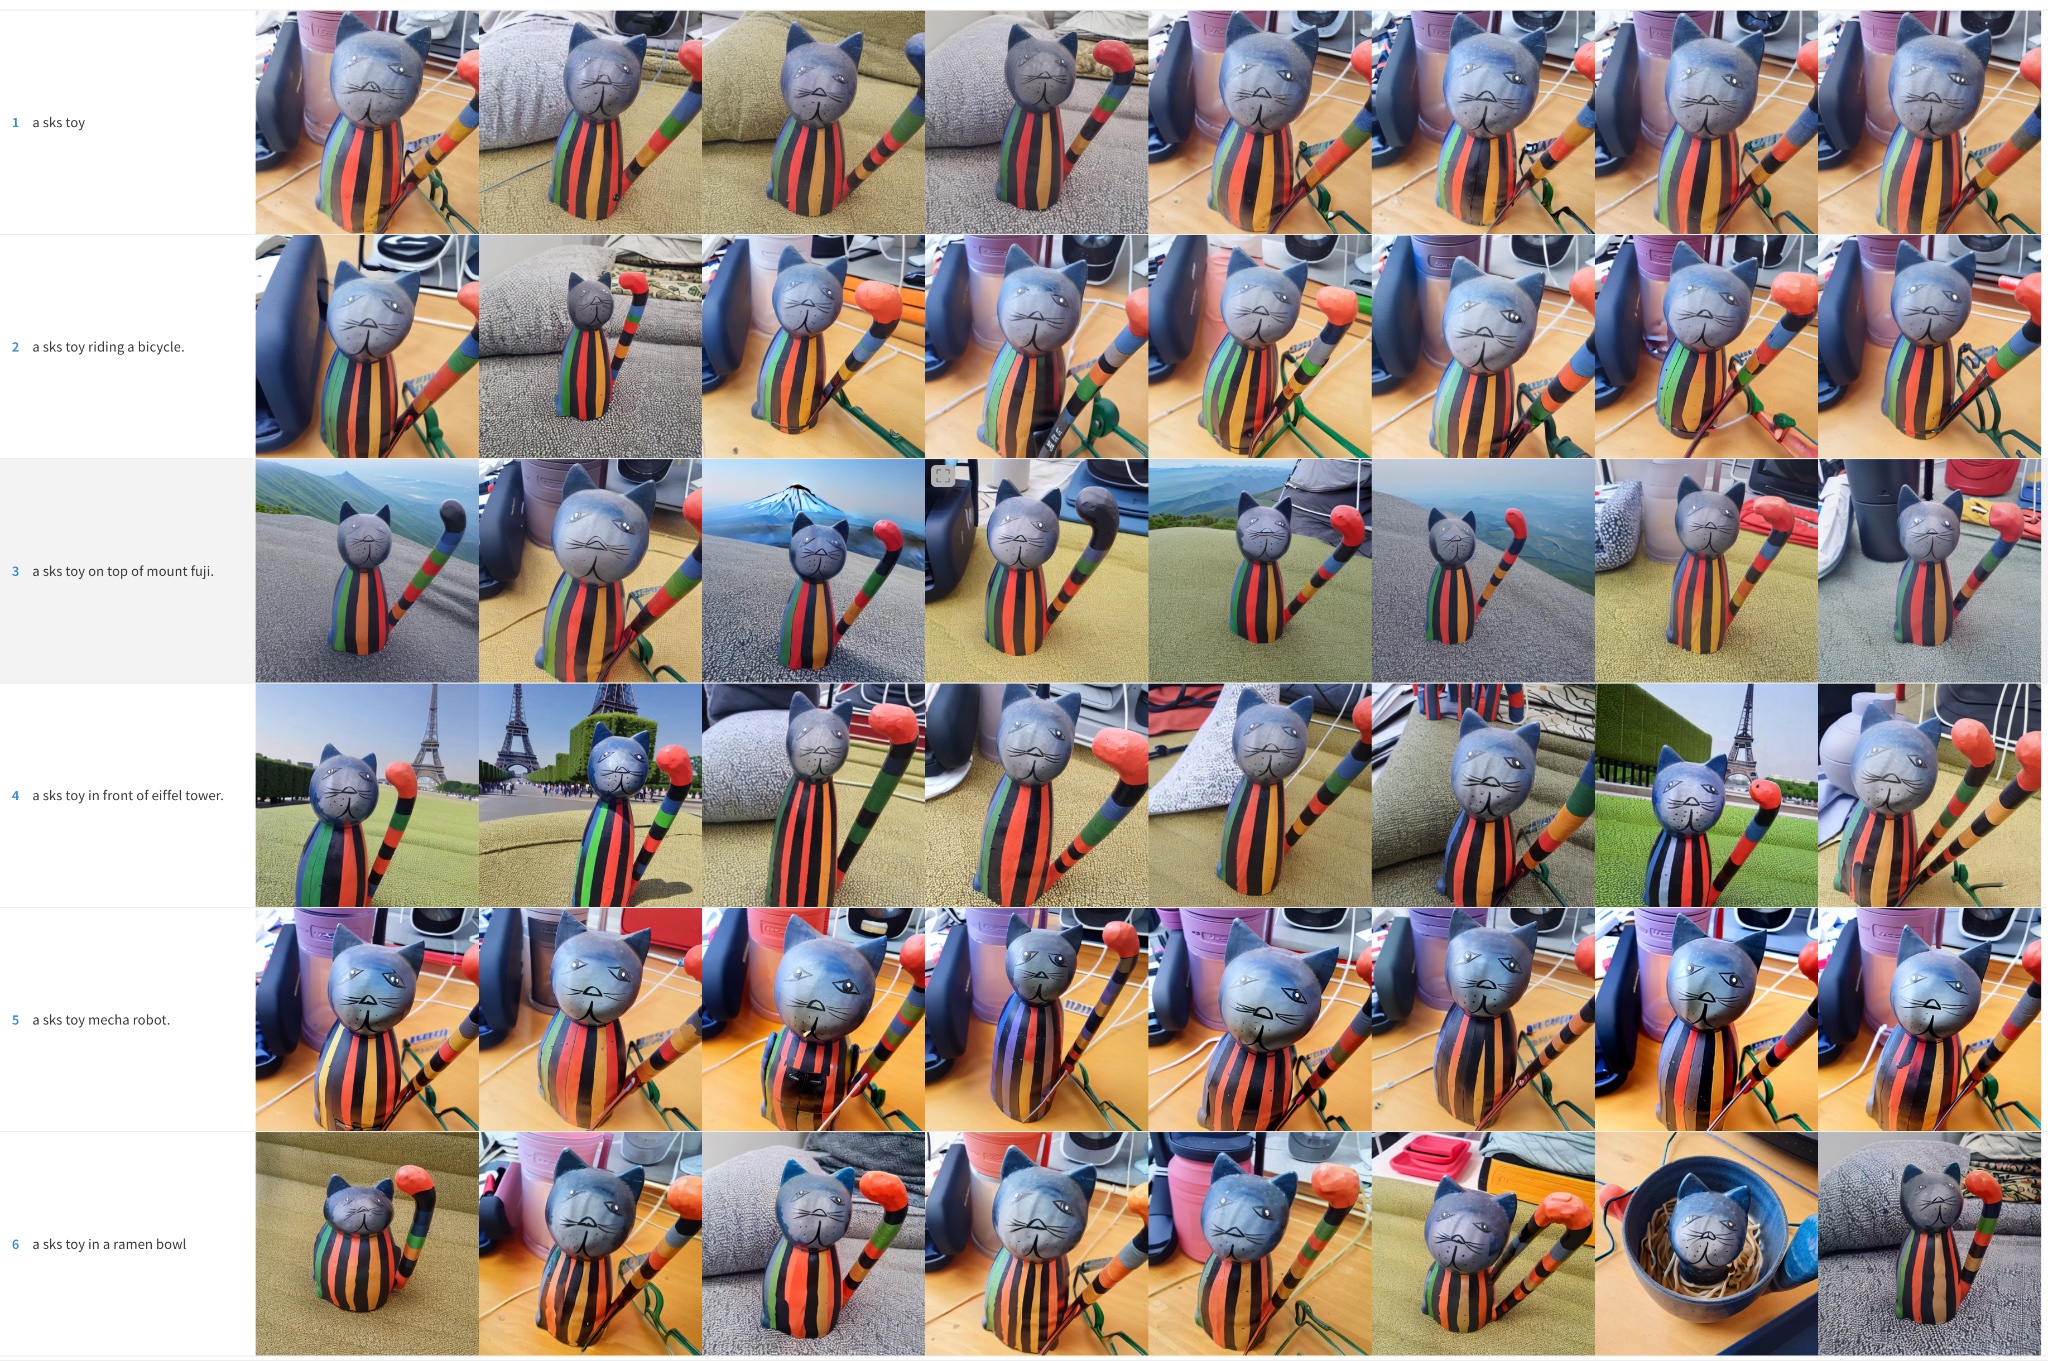
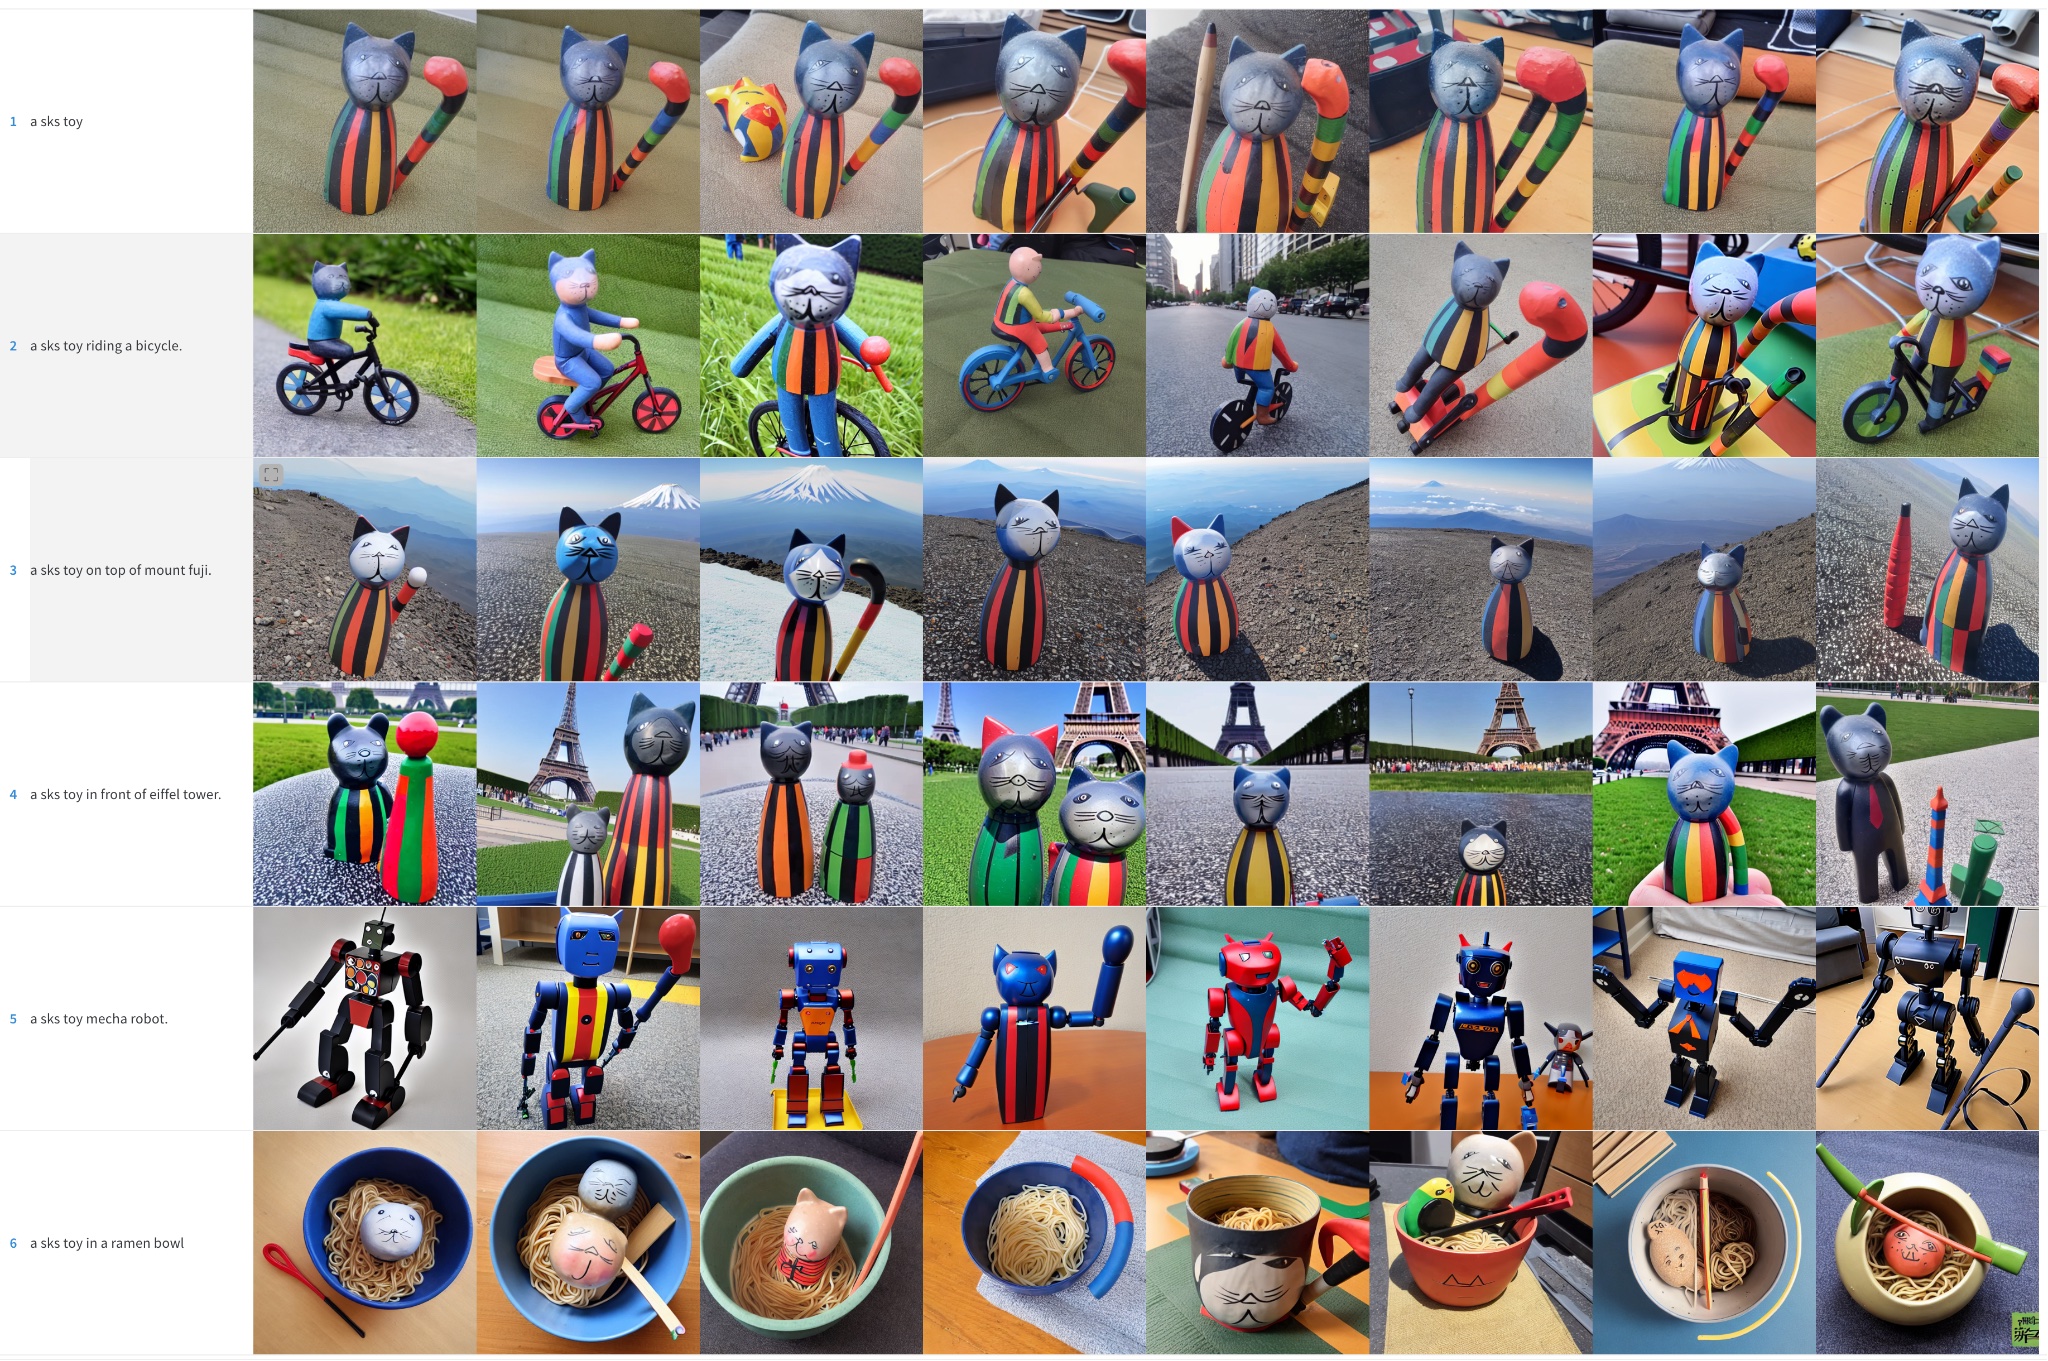
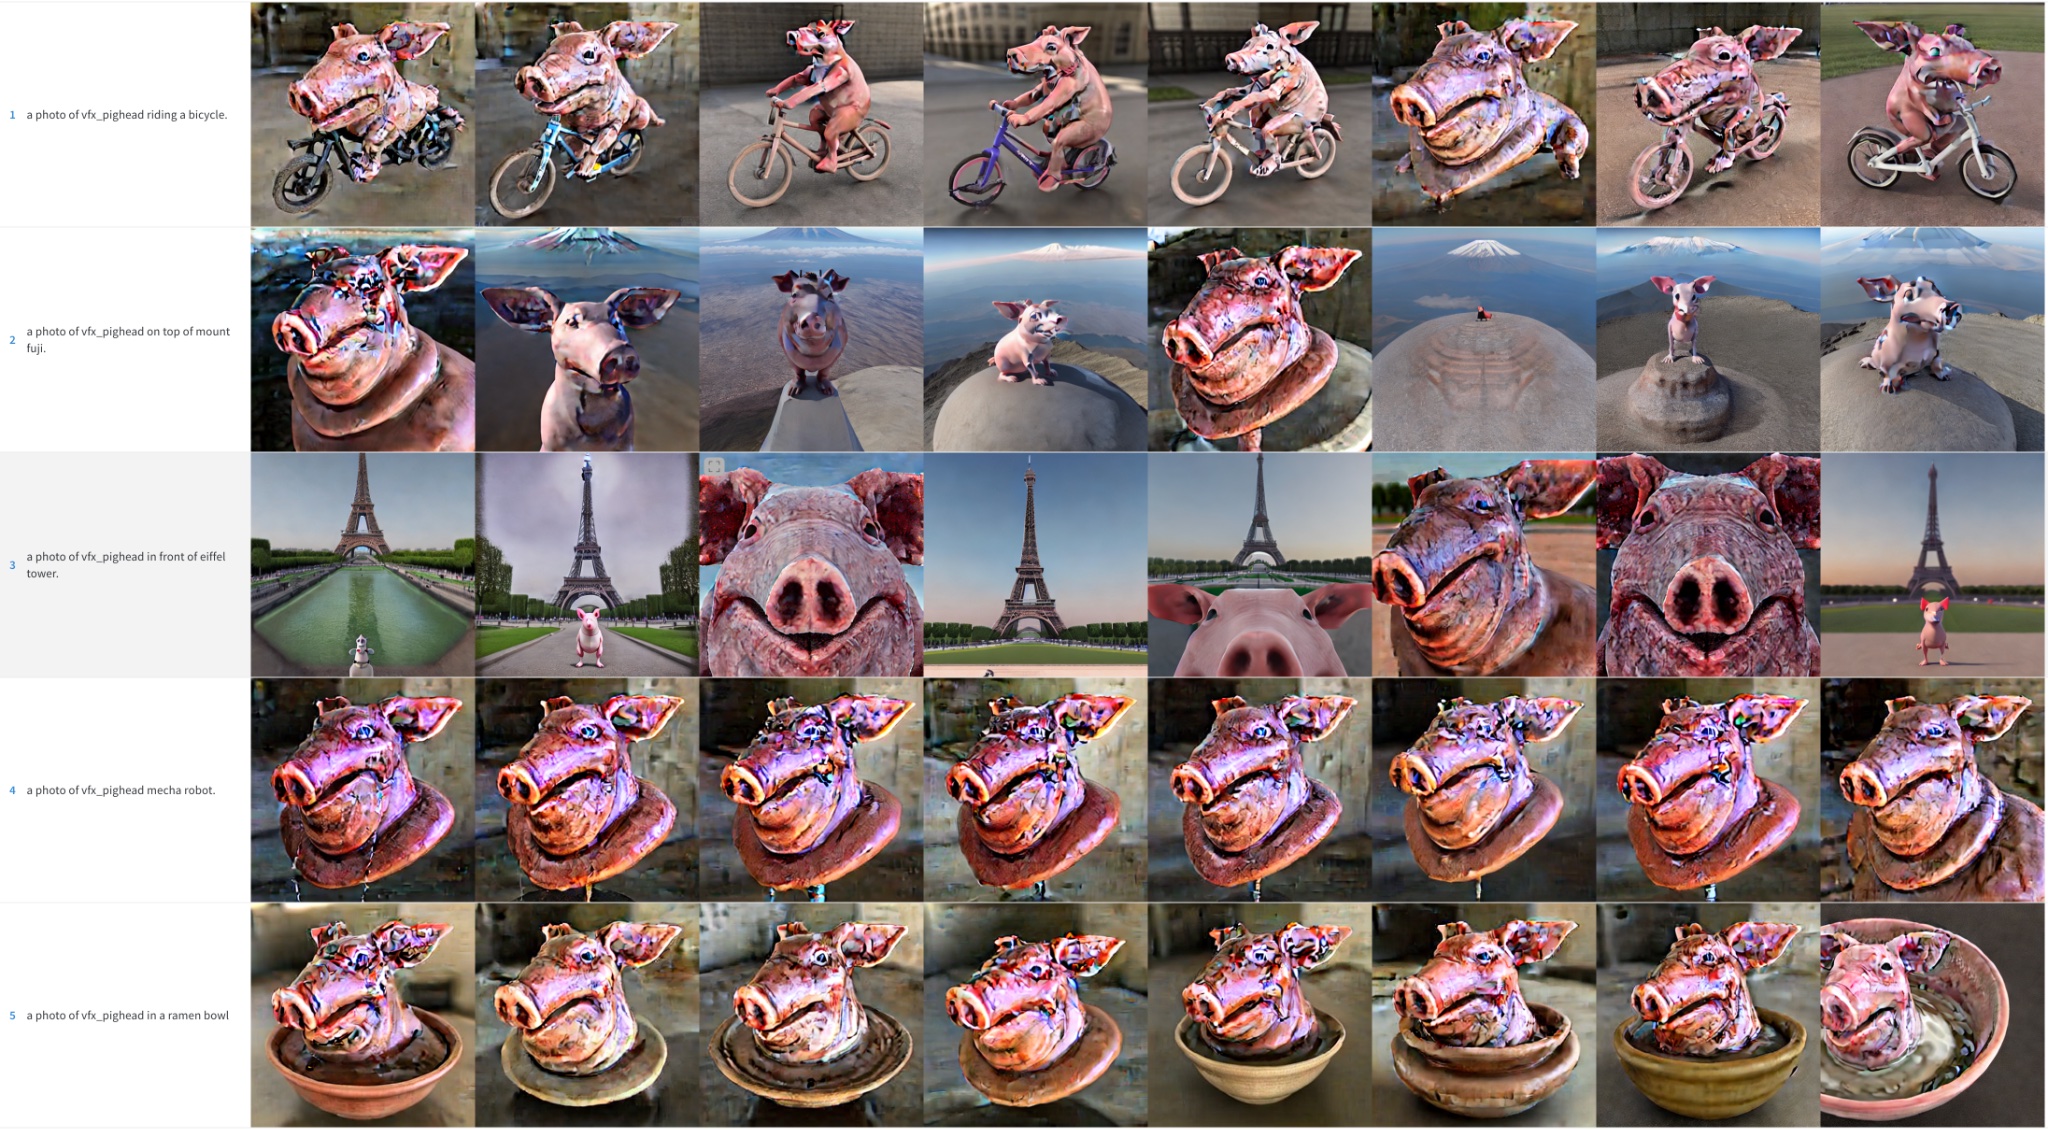
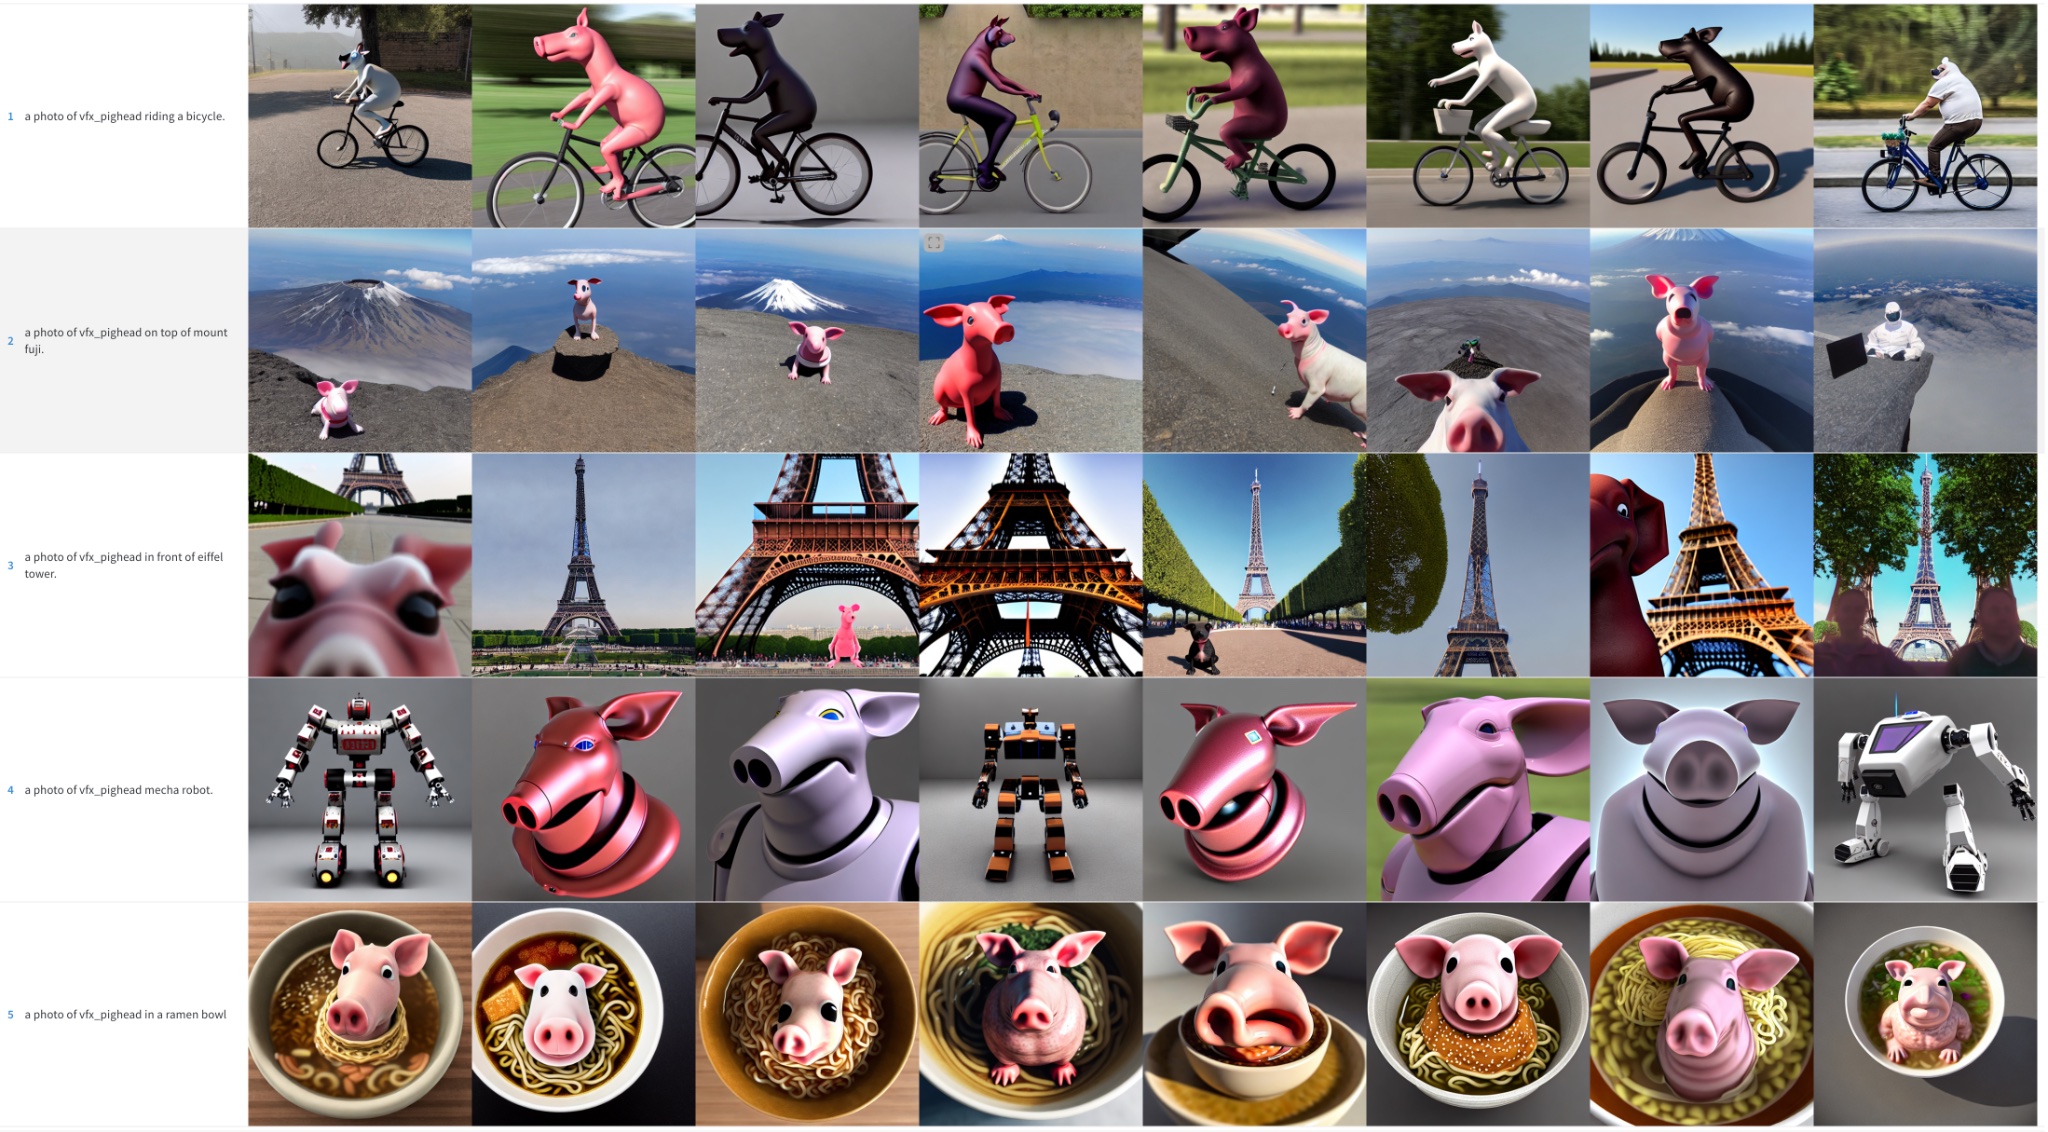
Dreambooth 很容易迅速過度擬合。要取得良好成果,應按資料集情況調整學習率和訓練步數。在下文詳述的實驗中,我們使用四個不同資料集,分別以高、低學習率進行微調;所有情況下,較低學習率都帶來更佳成果。
實驗設定
我們所有實驗均使用 train_dreambooth.py 指令碼和 AdamW 最佳化器,在 2 張 40GB A100 上進行。我們使用相同隨機種子,並在各次執行中維持所有超參數相同,只有 LR、訓練步數及是否使用先驗保留不同。
在首 3 個示例(不同物件)中,我們以批次大小 4(每張 GPU 2 個)訓練模型 400 步。高學習率設為 5e-6,低學習率設為 2e-6。沒有使用先驗保留。
最後一項實驗嘗試把人物主體加入模型。此實驗採用先驗保留,批次大小為 2(每張 GPU 1 個),並訓練 800 及 1200 步。高學習率設為 5e-6,低學習率設為 2e-6。
請注意,你可使用 8-bit Adam、fp16 訓練或梯度累積降低記憶體需求,並在配備 16 GB 記憶體的 GPU 上進行類似實驗。
貓咪玩具
高學習率(5e-6)
低學習率(2e-6)
豬頭
高學習率(5e-6)。請注意,彩色瑕疵是殘留雜訊;增加推論步數或有助修復部分細節。
低學習率(2e-6)
Potato Head 先生
高學習率(5e-6)。請注意,彩色瑕疵是殘留雜訊;增加推論步數或有助修復部分細節。
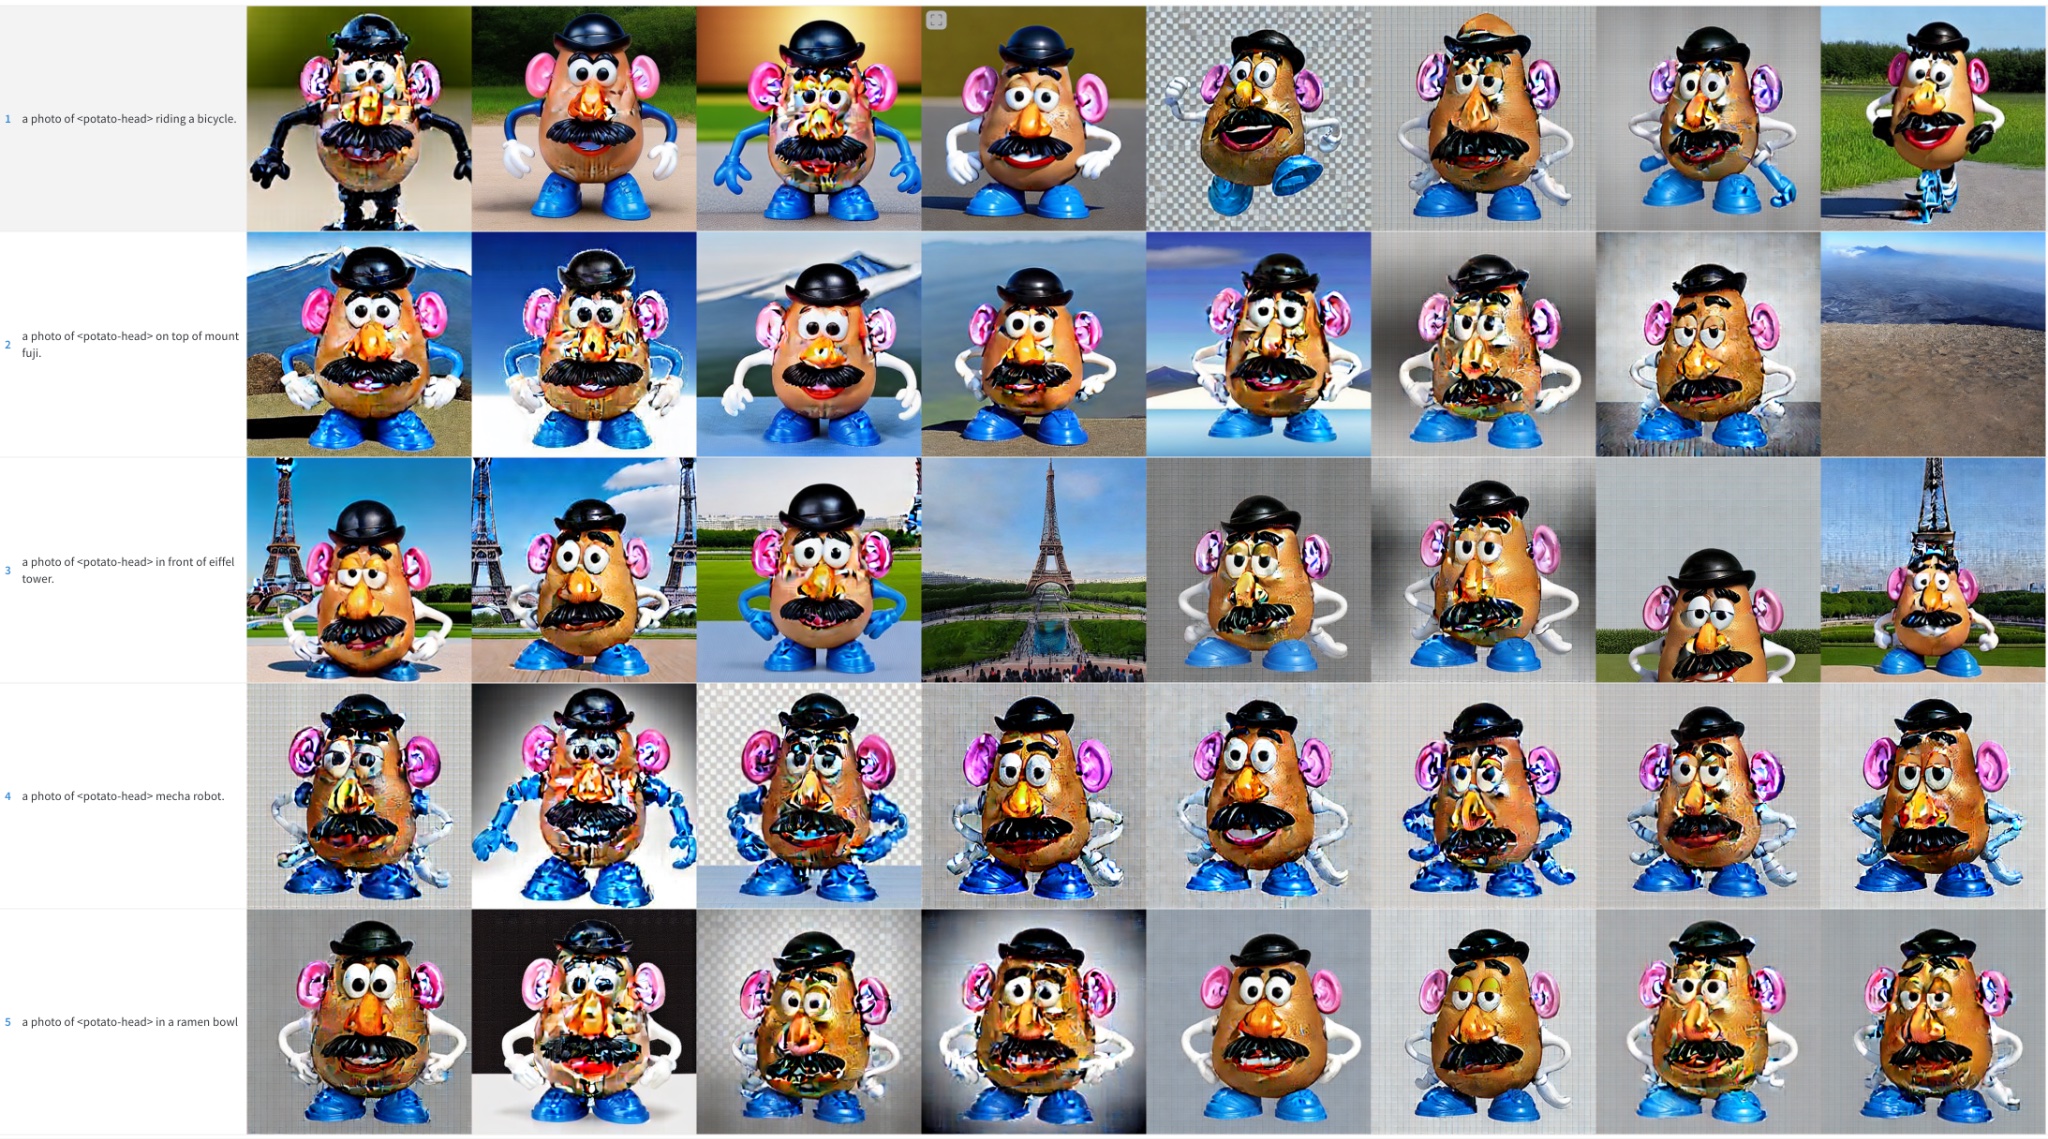
低學習率(2e-6)
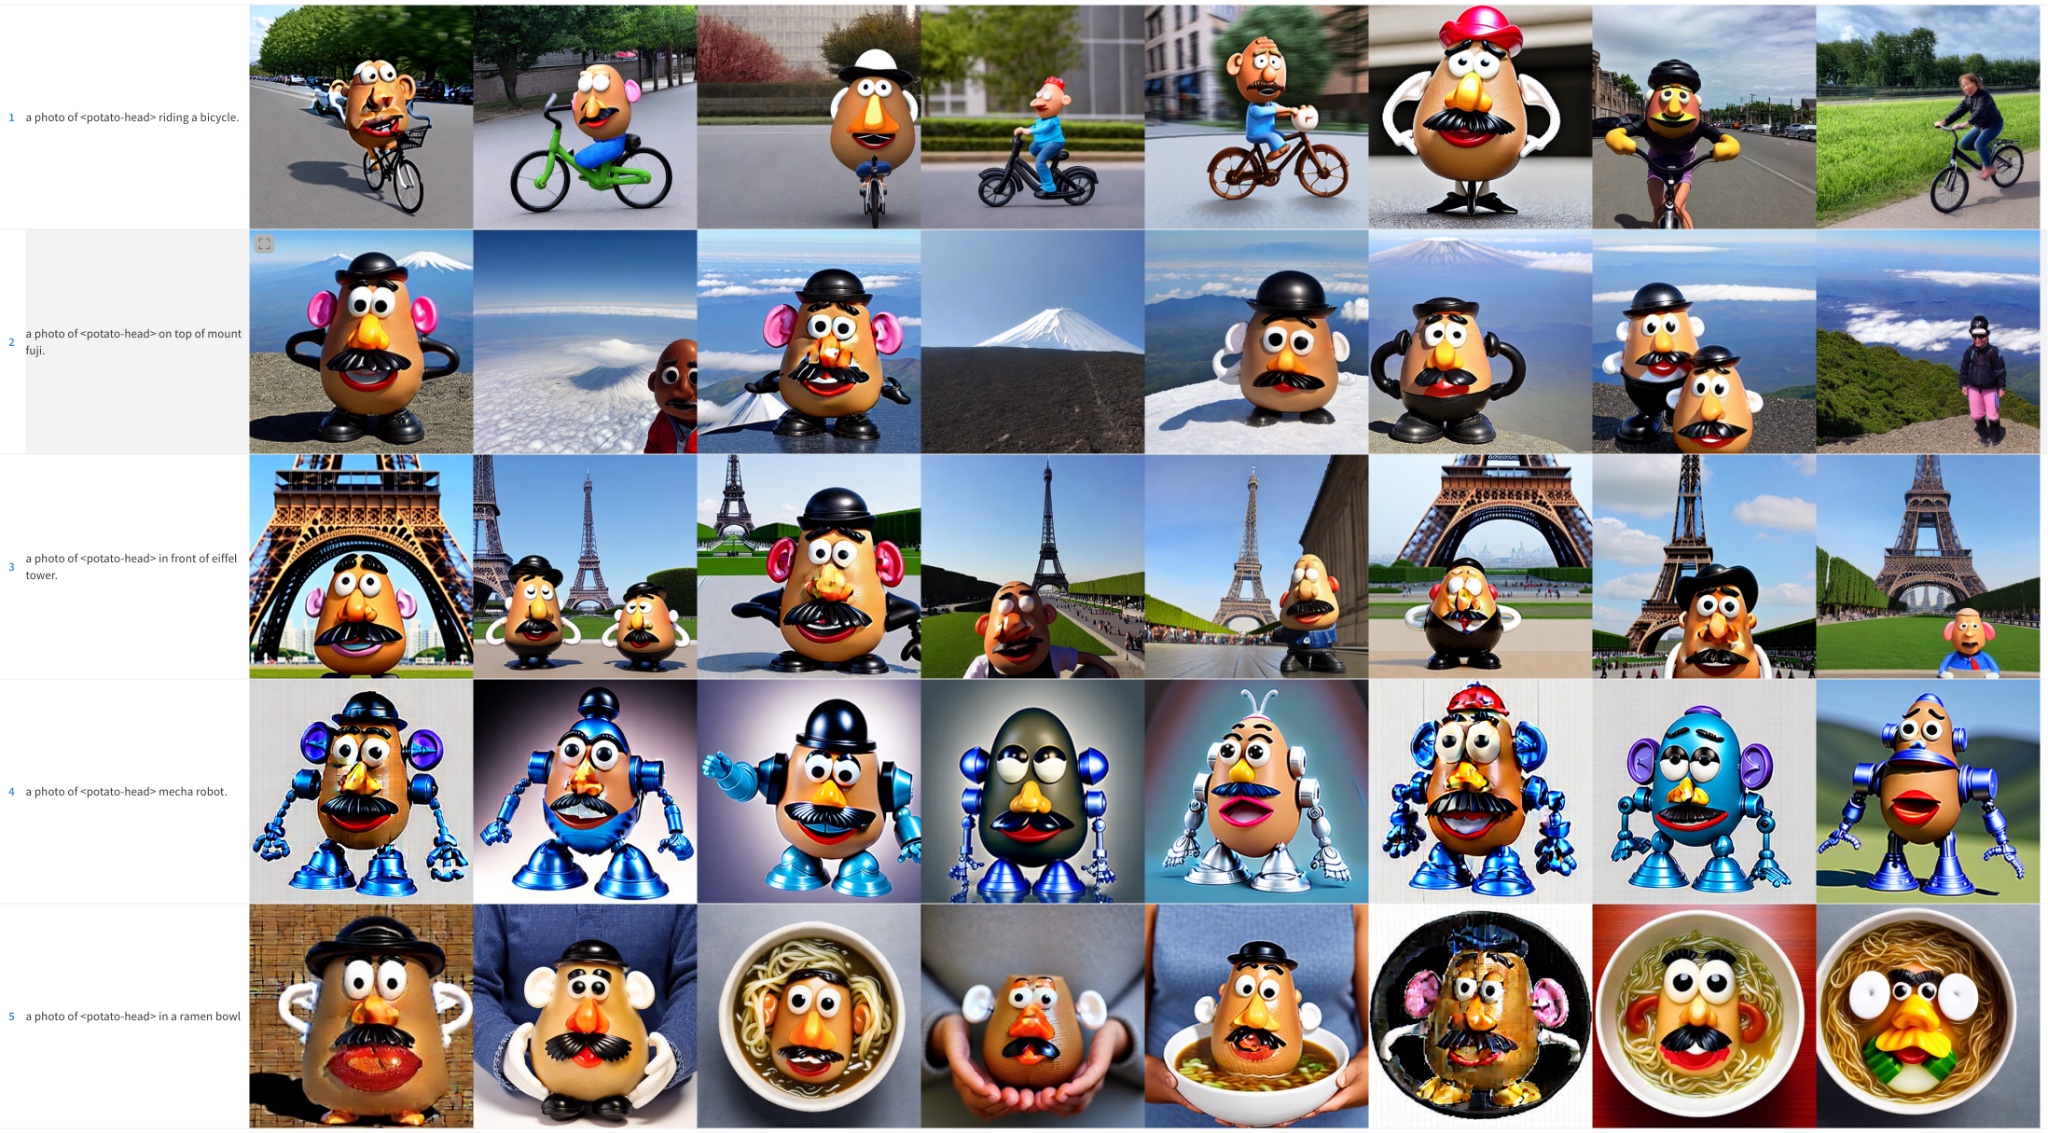
人臉
我們嘗試把 Seinfeld 角色 Kramer 加入 Stable Diffusion。如前所述,我們增加了訓練步數並縮小批次大小,但成果仍不理想。為了精簡篇幅,我們省略了這些示例圖像,請讀者參閲下文;之後我們把重點轉向人臉訓練。
初步結果摘要
要使用 Dreambooth 訓練 Stable Diffusion 並取得良好結果,按資料集調整學習率和訓練步數十分重要。
- 學習率過高或訓練步數過多都會導致過度擬合。無論使用甚麼提示,模型大多隻會生成訓練資料中的圖像。
- 學習率過低或步數不足則會導致欠擬合:模型無法生成我們嘗試加入的概念。
人臉較難訓練。在我們的實驗中,物件使用 2e-6 學習率和 400 個訓練步數效果良好;但人臉需要 1e-6(或 2e-6)學習率及約 1200 步。
模型過度擬合會令圖像質素大幅下降;以下情況都可能導致過度擬合:
- 學習率過高。
- 訓練步數過多。
- 在人臉案例中,沒有使用先驗保留也會導致過度擬合,詳見下一節。
人臉訓練中的先驗保留
先驗保留是一種微調技術,會把我們嘗試訓練之同一類別的額外圖像加入訓練過程。例如,如果我們嘗試把新人物加入模型,希望保留的類別便是人物。先驗保留會把新人物的相片與其他人物的相片一併使用,以減少過度擬合。好處是,這些額外的類別圖像可直接由 Stable Diffusion 模型生成!訓練指令碼可按需要自動處理;你亦可自行提供一個資料夾,放入先驗保留圖像。
使用先驗保留,1200 步,lr=2e-6。
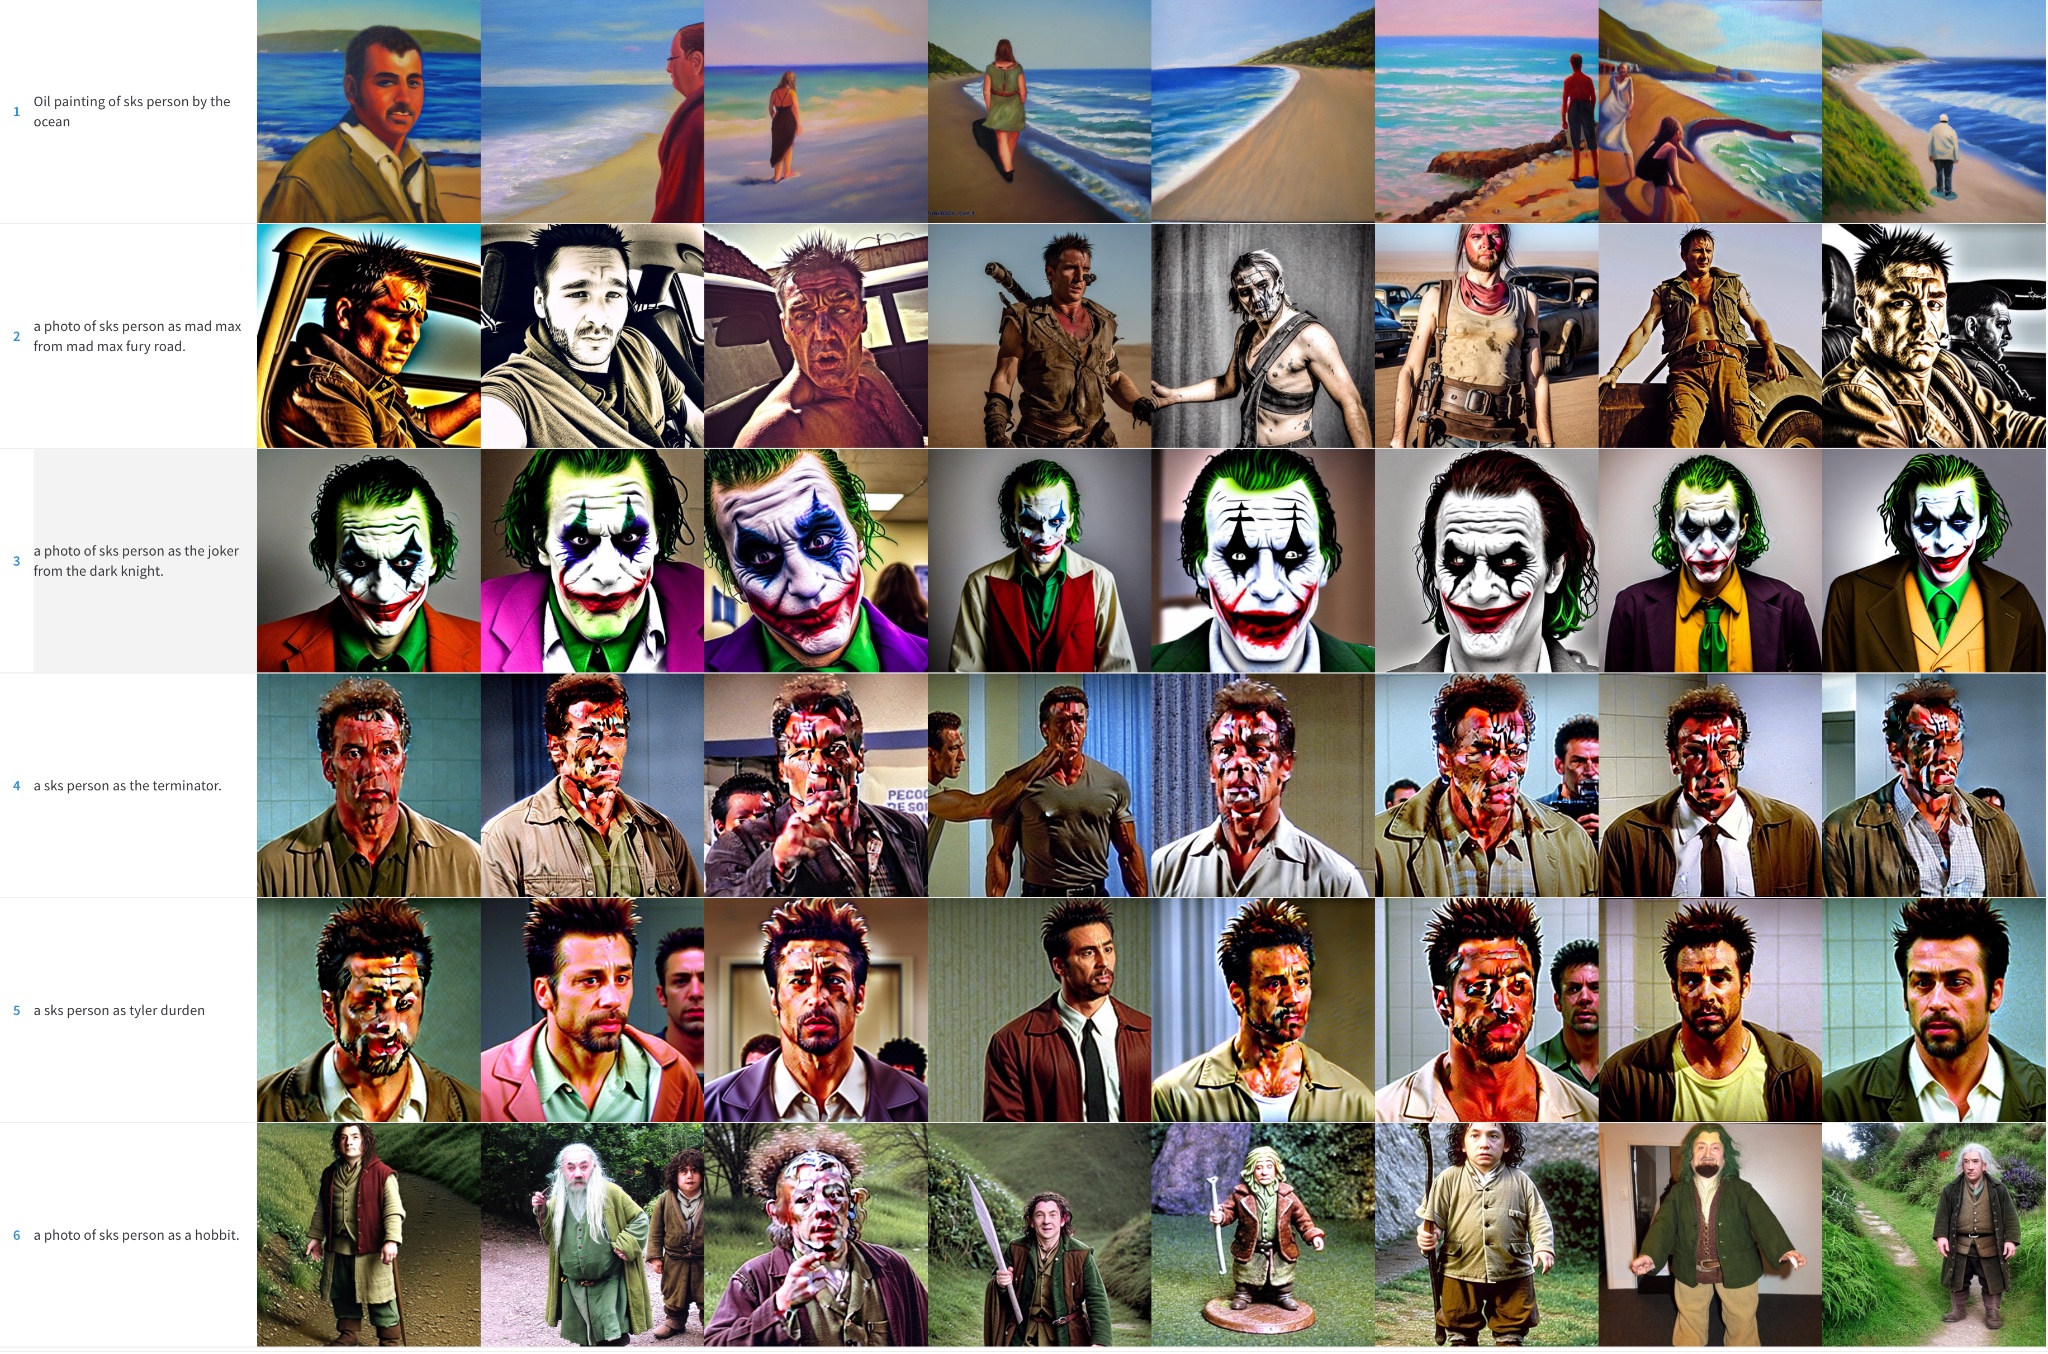
沒有使用先驗保留,1200 步,lr=2e-6。
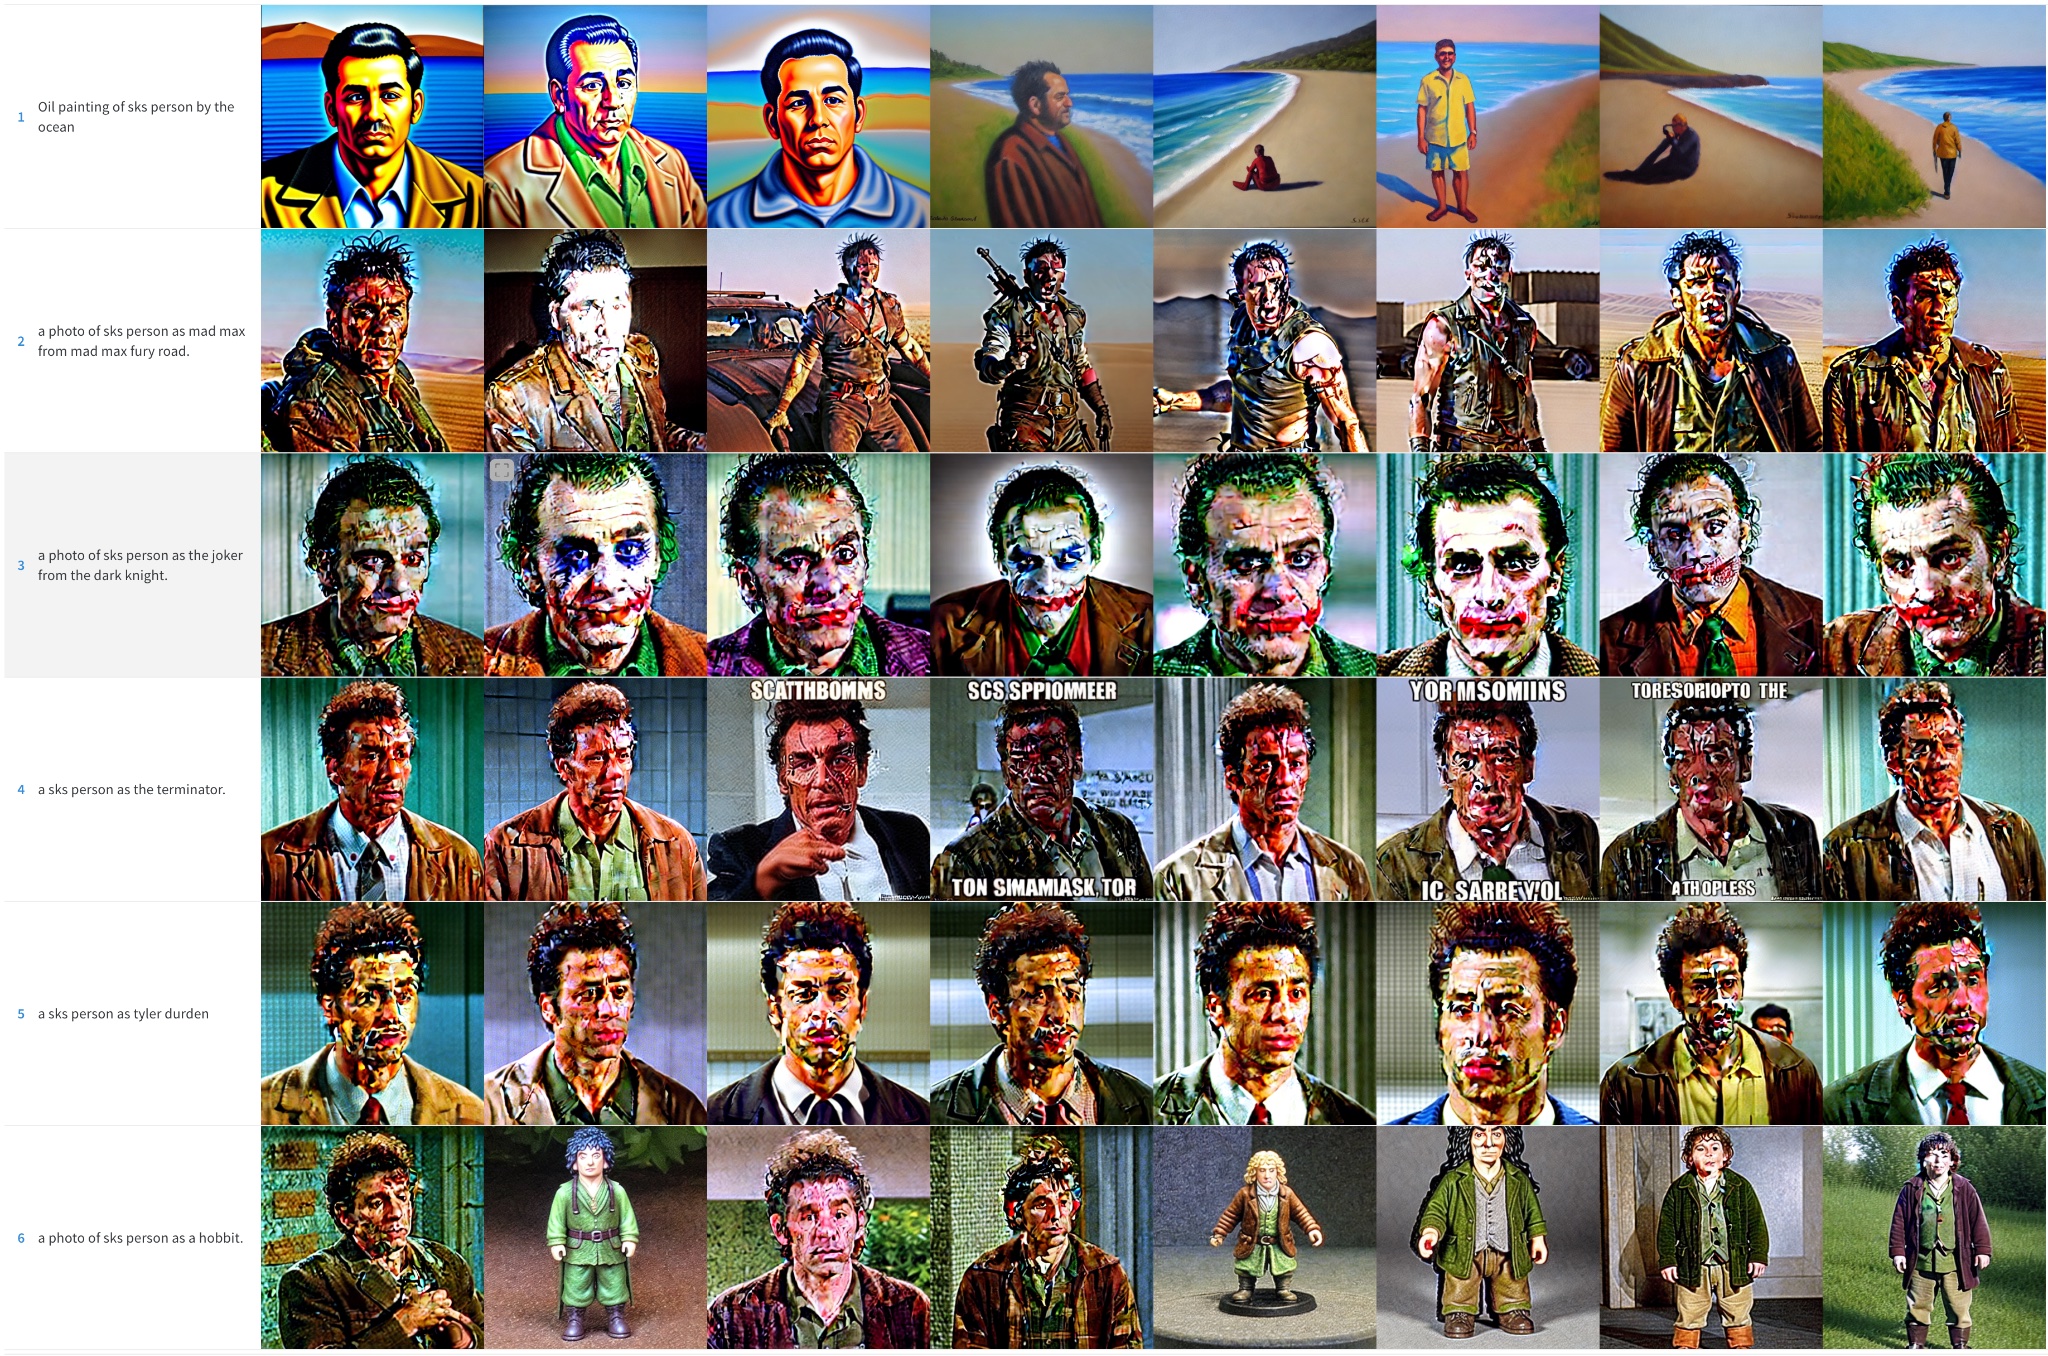
如你所見,使用先驗保留時結果較佳,但仍有雜訊斑塊。是時候試試其他技巧了!
排程器的影響
在前面的示例中,我們使用 PNDM 排程器在推論過程中抽樣生成圖像。我們發現模型過度擬合時,DDIM 通常比 PNDM 和 LMSDiscrete 效果好得多。此外,增加推論步數也可改善質素:100 步似乎是合適選擇。額外步數有助把部分雜訊斑塊轉化為圖像細節。
PNDM,Kramer 人臉
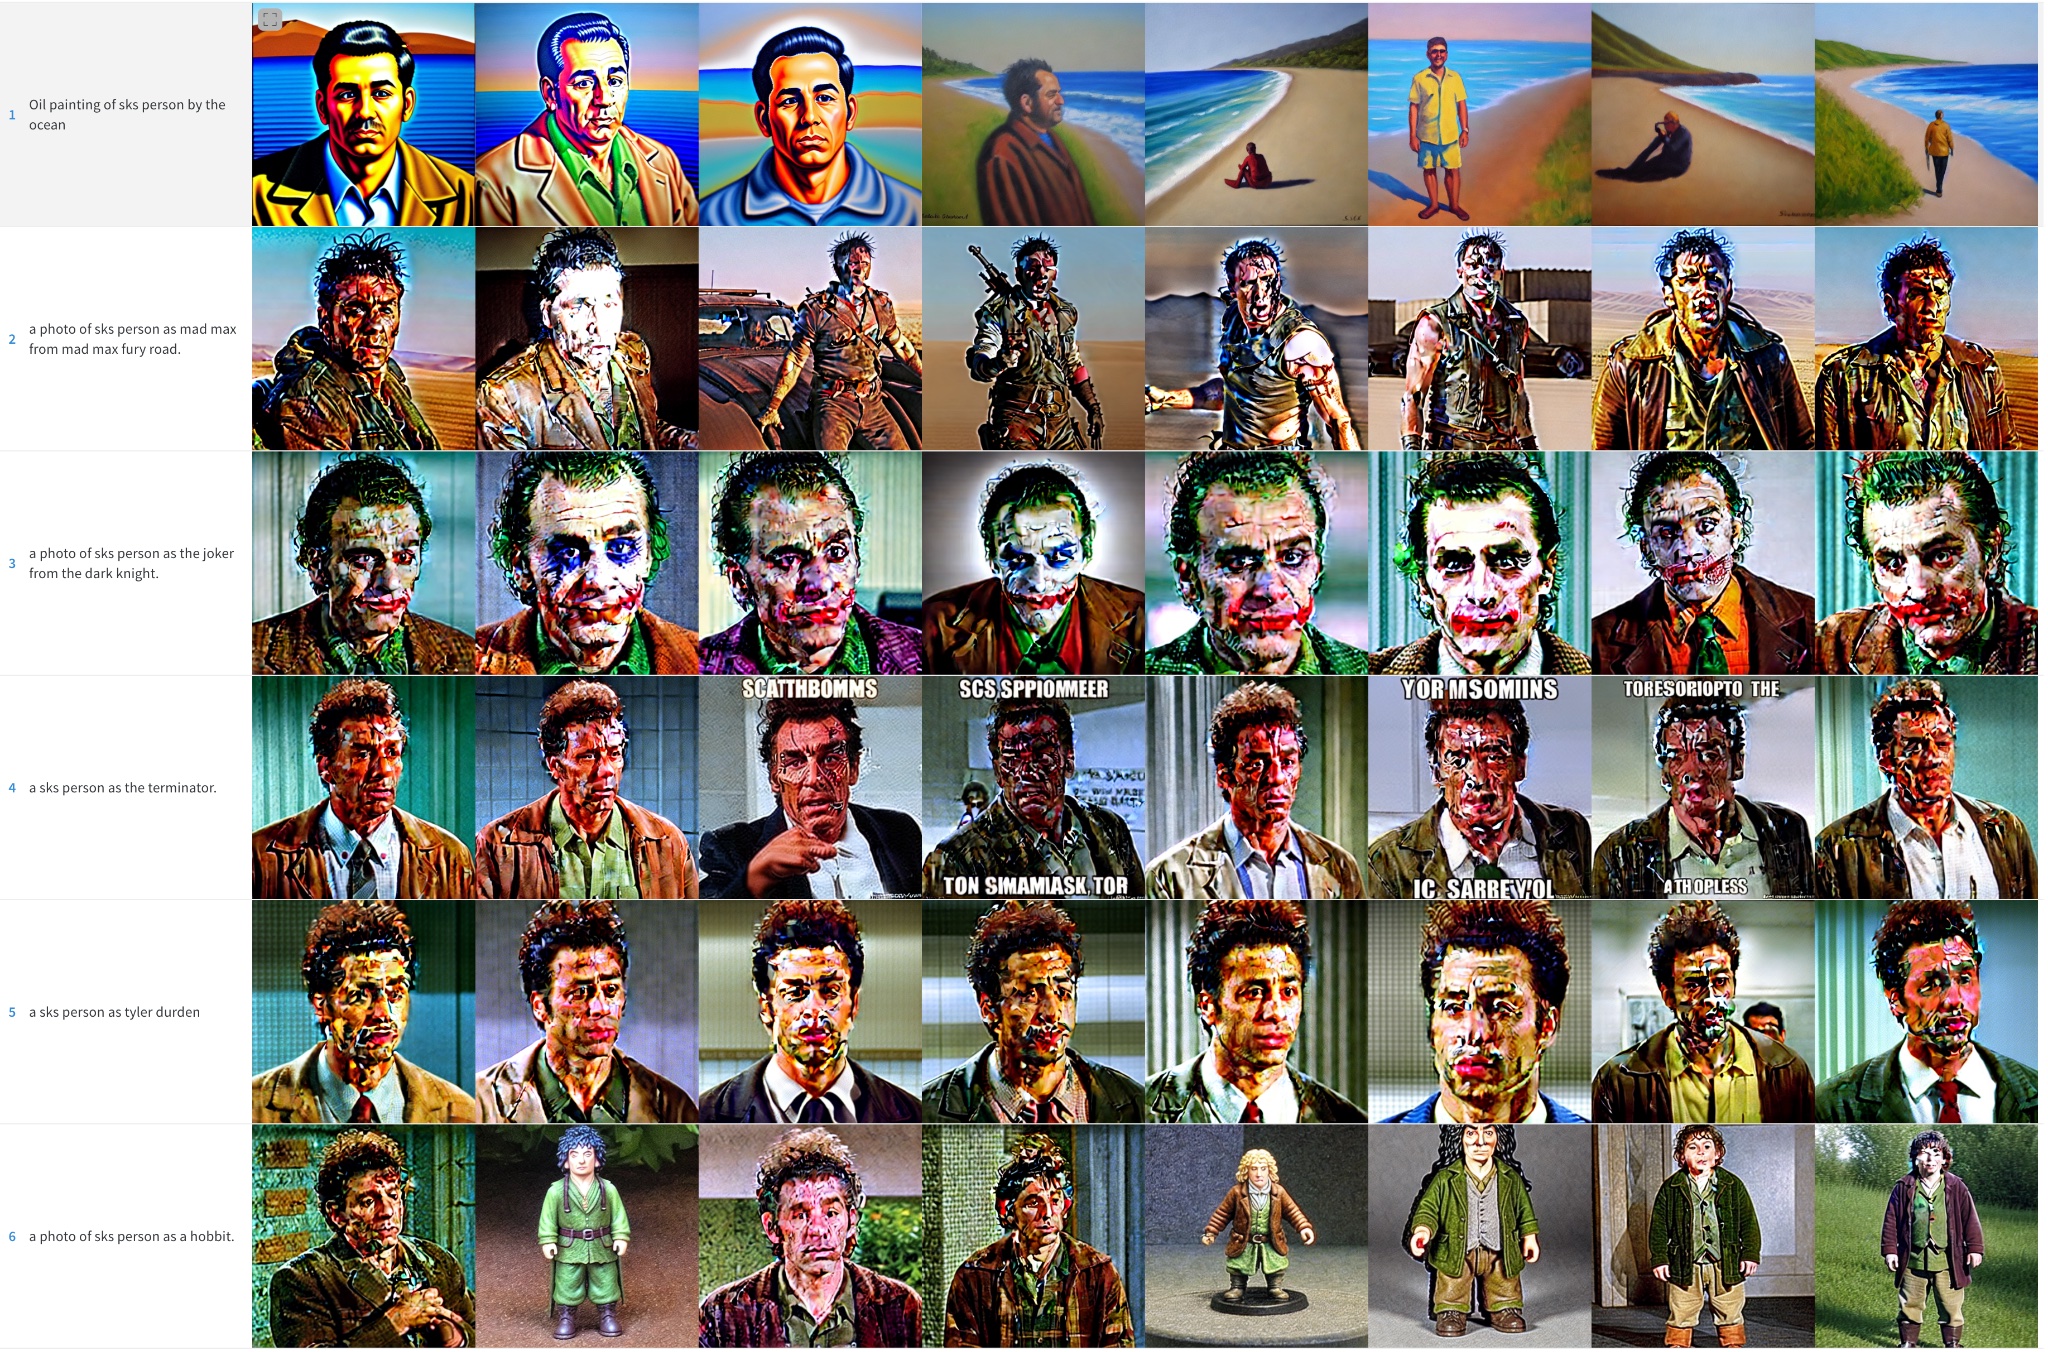
LMSDiscrete,Kramer 人臉。結果很差!

DDIM,Kramer 人臉。好得多。

其他主體亦可觀察到類似情況,只是程度較輕。
PNDM,Potato Head
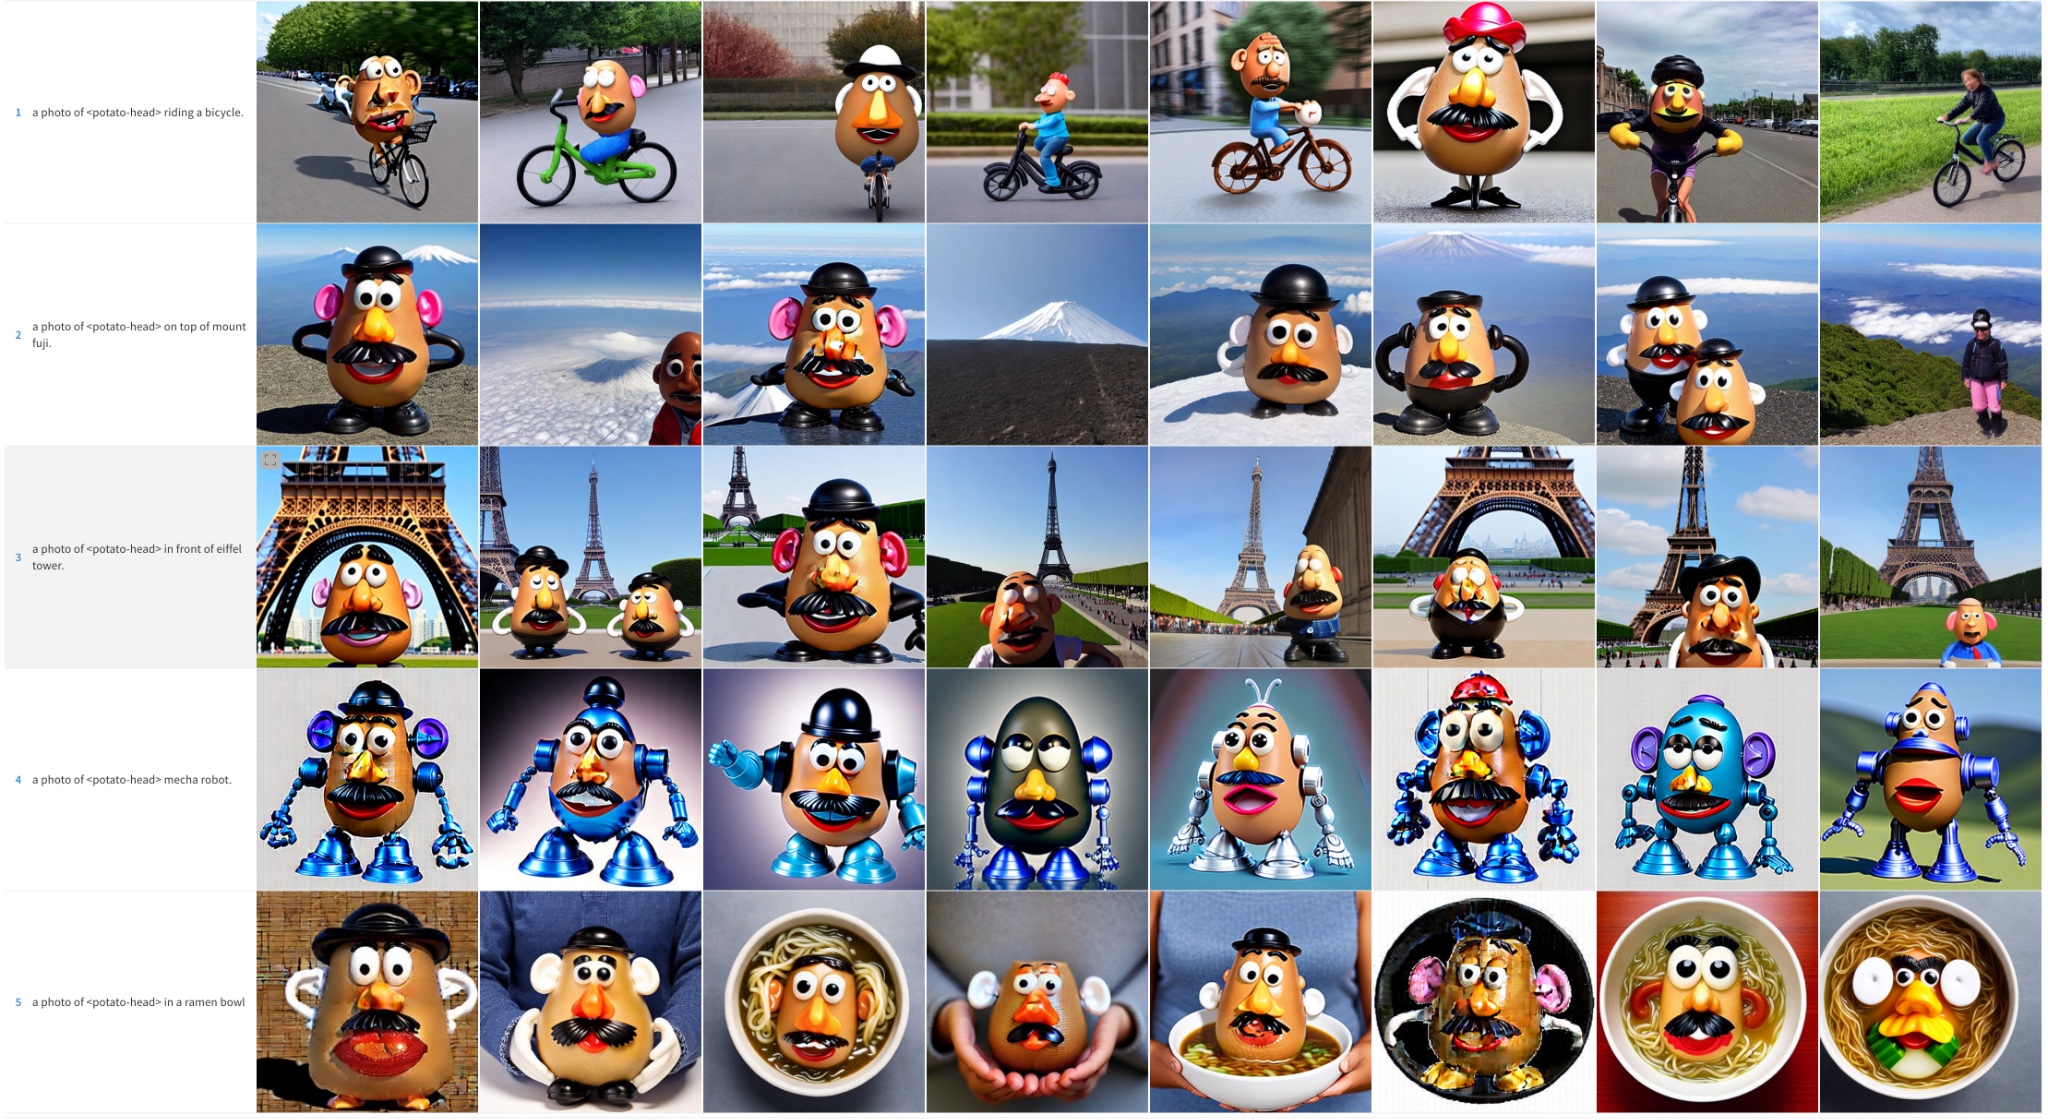
LMSDiscrete,Potato Head
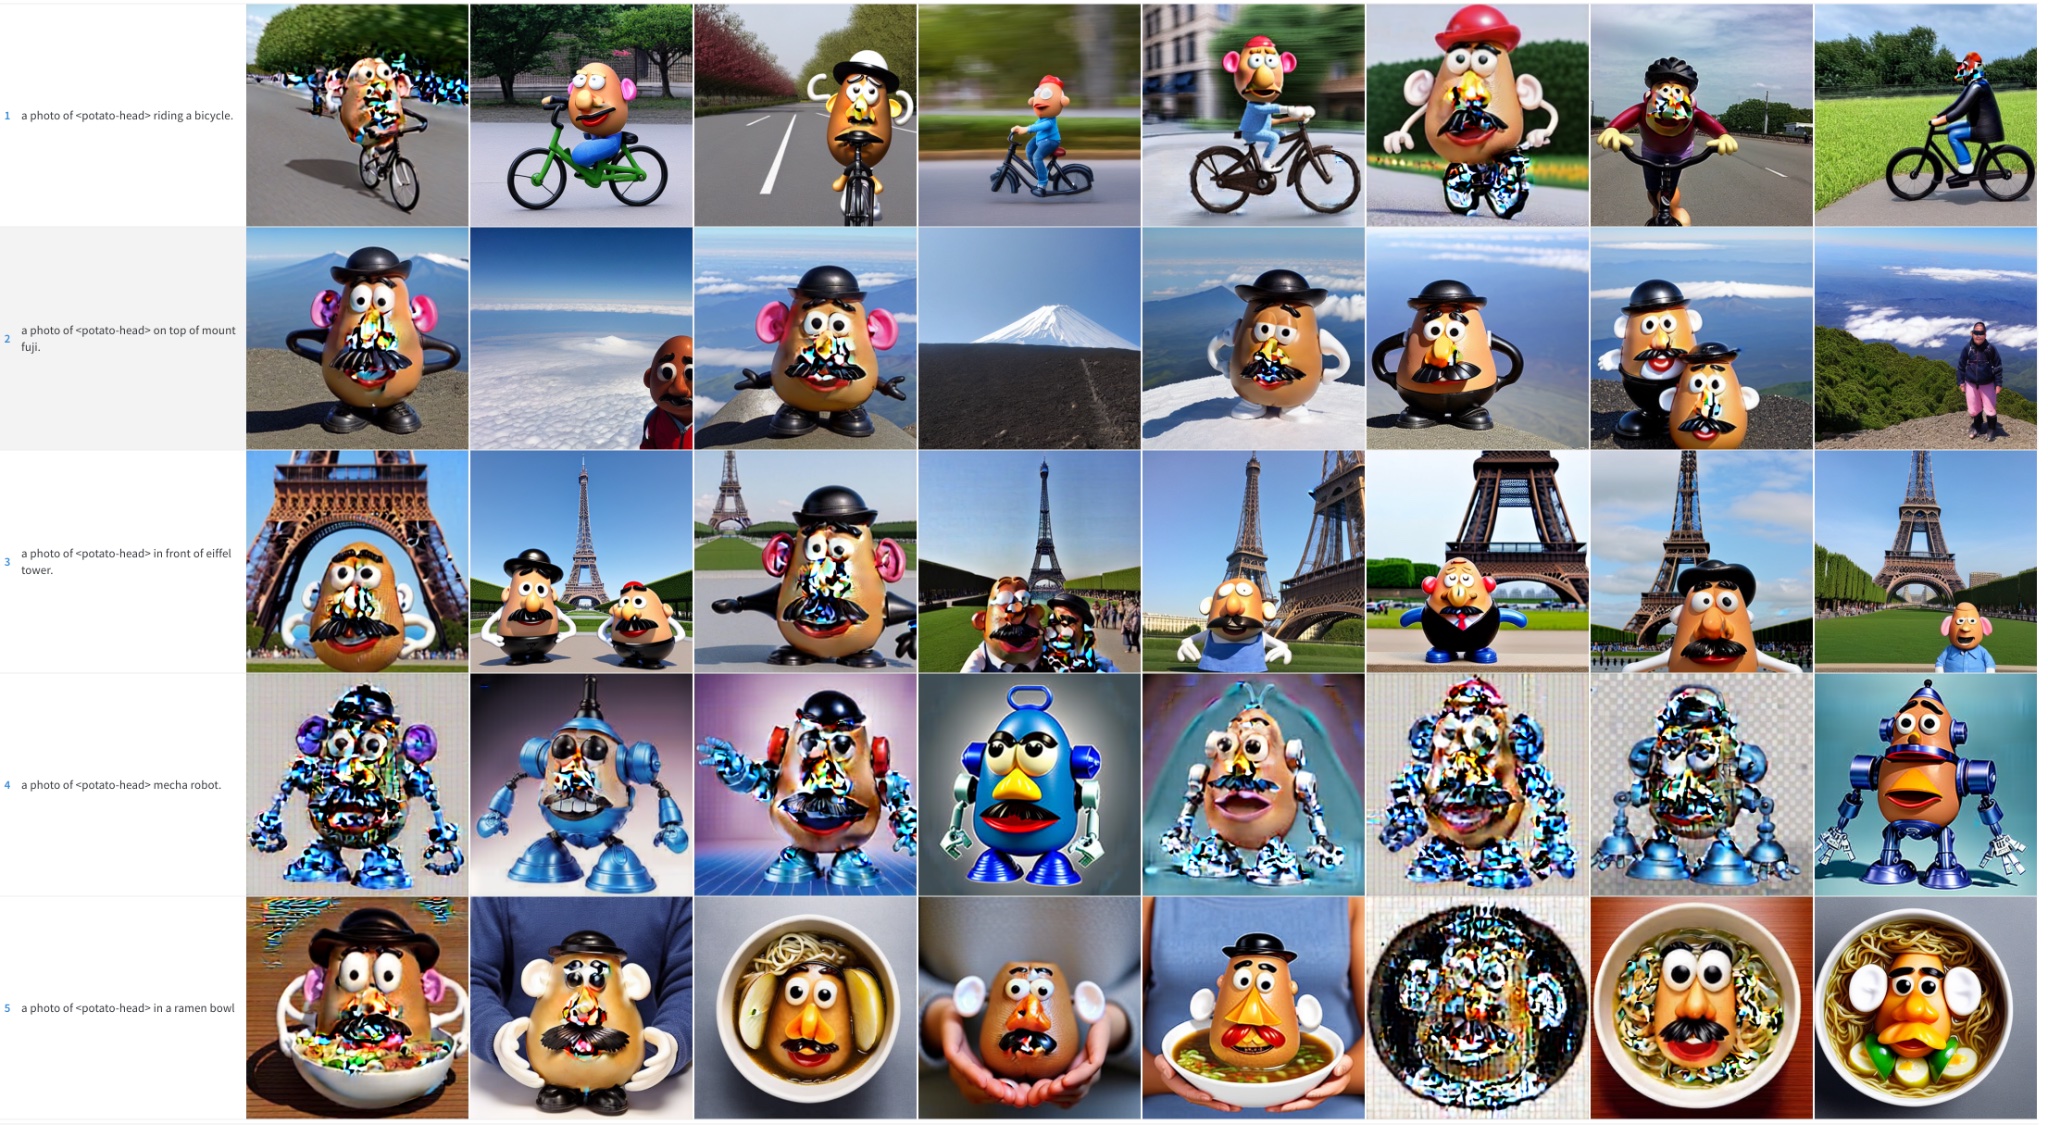
DDIM,Potato Head

微調文字編碼器
原始 Dreambooth 論文描述了一種微調模型 UNet 組件、但保持文字編碼器凍結的方法。不過,我們觀察到微調編碼器可帶來更佳成果。我們參考其他 Dreambooth 實作後嘗試此方法,結果相當出色!
文字編碼器凍結

微調文字編碼器
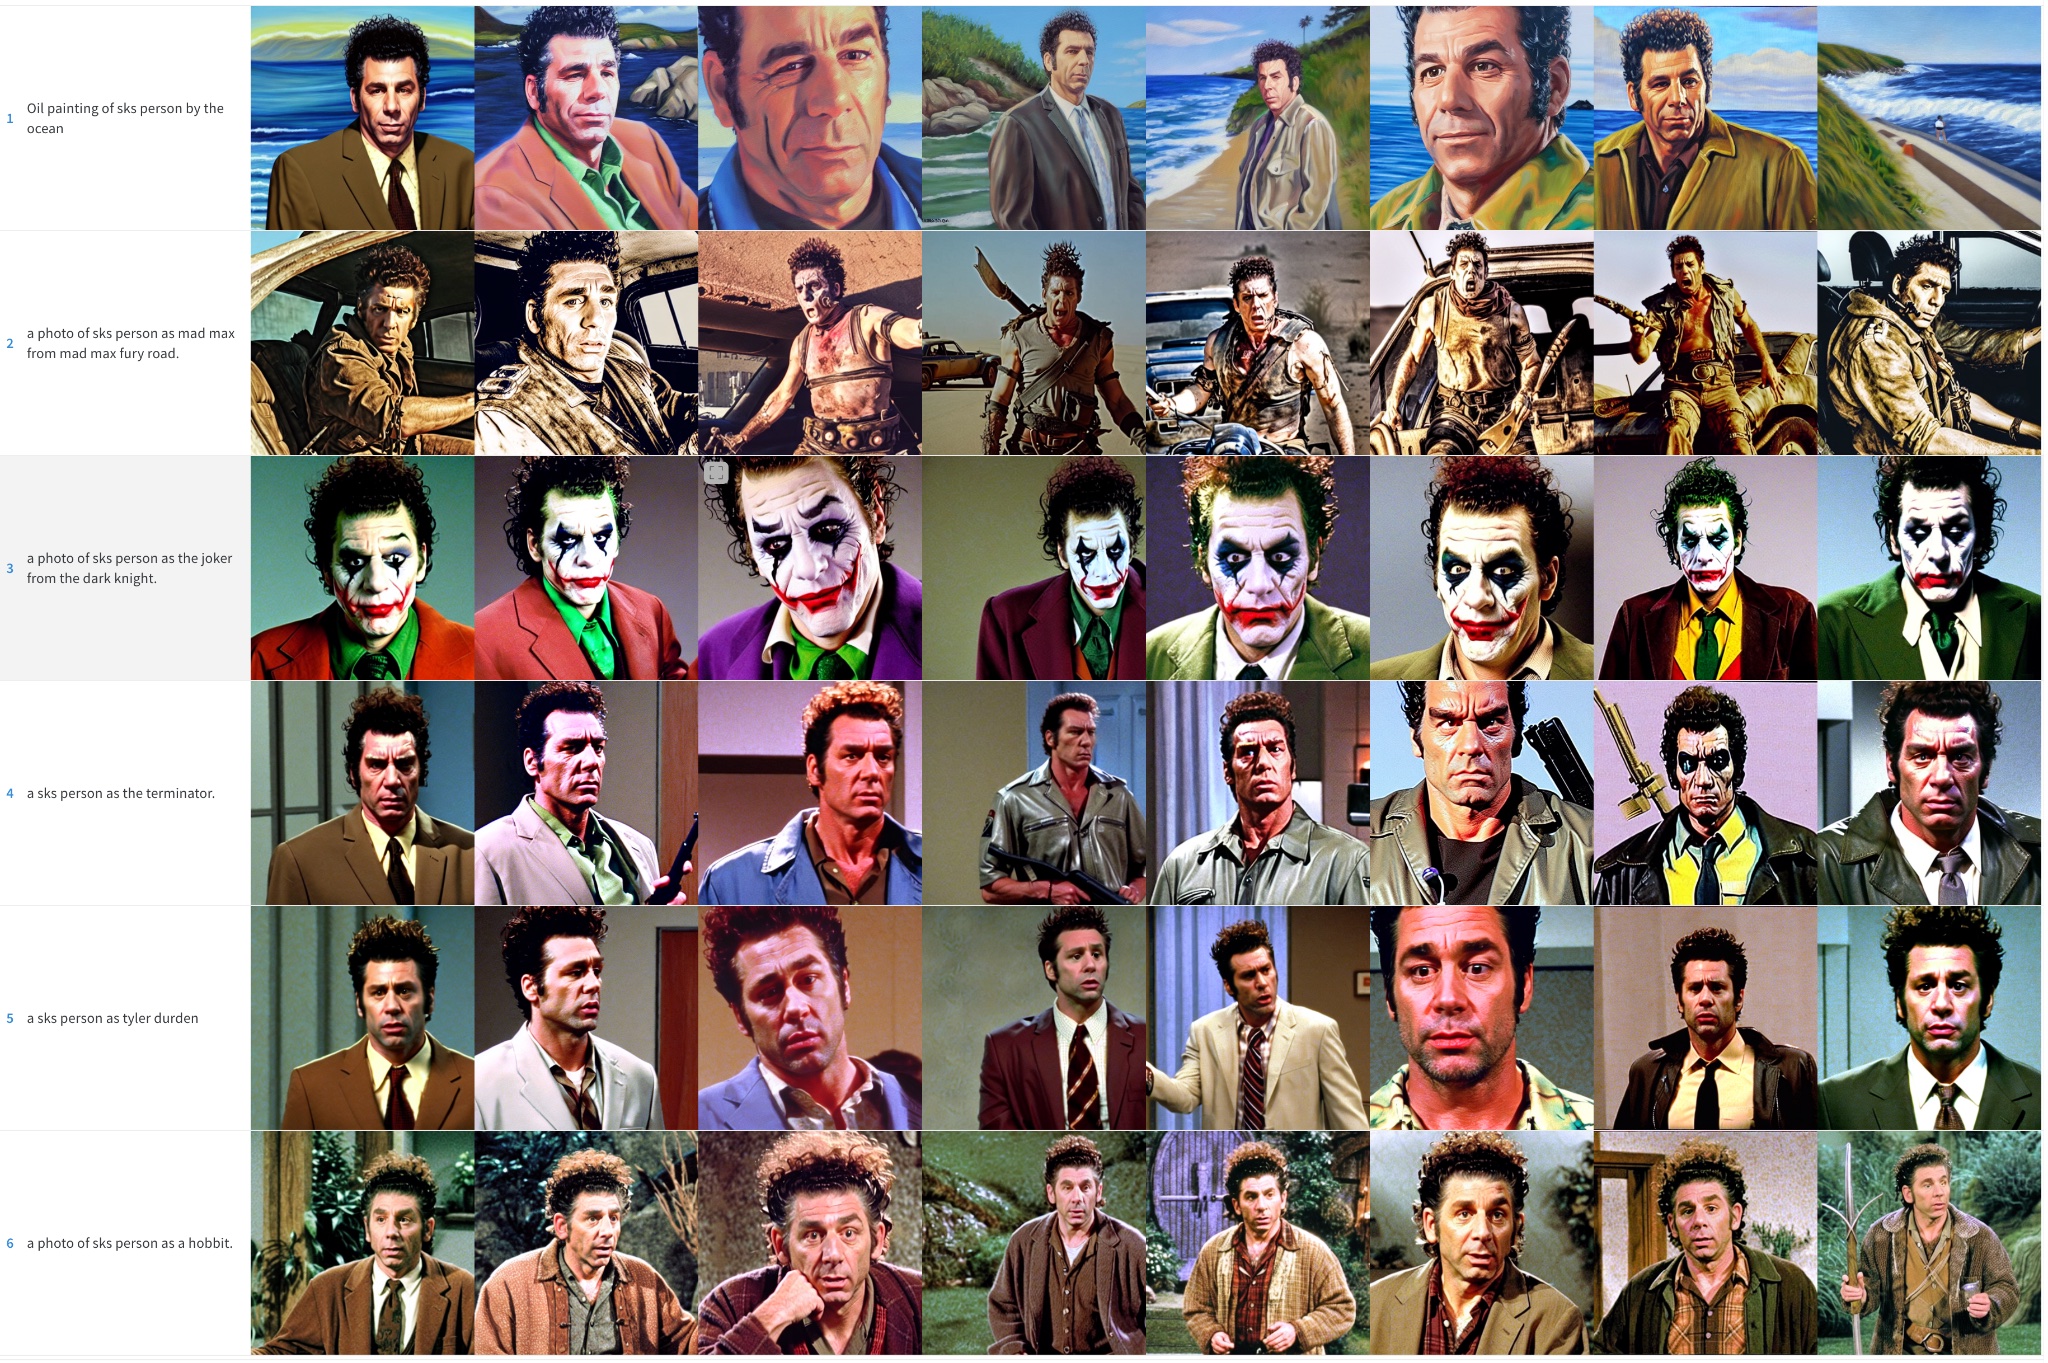
微調文字編碼器可帶來最佳成果,尤其在人臉方面。生成圖像更逼真、不易過度擬合,提示詞的可解讀性亦更佳,能處理更複雜的提示。
後記:Textual Inversion + Dreambooth
我們亦進行了最後一項實驗,把 Textual Inversion 與 Dreambooth 結合。兩種技術目標相近,但方法不同。
在這項實驗中,我們先執行 textual inversion 2000 步。再以該模型使用 1e-6 學習率進一步執行 Dreambooth 500 步。結果如下:

我們認為結果比單獨使用 Dreambooth 好得多,但不及微調整個文字編碼器。它似乎較多複製訓練圖像的風格,因此可能對這些圖像過度擬合。我們沒有進一步探索這種組合,但它或許是改進 Dreambooth、同時把整個流程放進 16GB GPU 的有趣替代方案。歡迎自行探索並分享成果!
來源:Hugging Face Blog · huggingface.co