Hugging Face Skills 讓 Claude Code 微調開源大語言模型
We Got Claude to Fine-Tune an Open Source LLM
Hugging Face Skills 讓 Claude Code 等編碼智能體透過對話處理模型微調,涵蓋資料集驗證、GPU 選擇、雲端工作提交與進度監控。它亦兼容 Codex 和 Gemini CLI;文中以 Qwen3-0.6B 在 open-r1/codeforces-cots 上進行 SFT 為例,估算使用 t4-small 約需 20 分鐘、成本約 $0.30。
文章將資料集驗證、GPU 選擇、雲端工作提交與進度監控串成智能體訓練流程,並比較 SFT、DPO、GRPO 的適用場景。
我們讓 Claude 使用一項名為 Hugging Face Skills 的新工具微調語言模型。它不只會編寫訓練指令碼,還會實際把訓練工作提交至雲端 GPU、監察進度,並把完成的模型推送至 Hugging Face Hub。本教學會示範它如何運作,以及你如何自行使用。
Claude Code 可以使用「skills」:一套封裝好的指令、指令碼和領域知識,協助它完成專門任務。
hf-llm-trainerskill 教導 Claude 訓練所需的一切,包括按模型規模選擇 GPU、設定 Hub 驗證、判斷何時使用 LoRA 或完整微調,以及妥善處理成功訓練所涉及的其他數十項決策。
使用這項 skill,你可以這樣要求 Claude:
Fine-tune Qwen3-0.6B on the dataset open-r1/codeforces-cots
接着 Claude 會:
- 驗證數據集格式
- 選擇合適硬件(為 0.6B 模型選用 t4-small)
- 使用訓練指令碼,並以 Trackio 監察進度
- 把工作提交至 Hugging Face Jobs
- 回報工作 ID 和預計費用
- 在你詢問時查看進度
- 發生問題時協助除錯
模型會在 Hugging Face GPU 上訓練,你可以同時處理其他事情。訓練完成後,微調模型便會出現在 Hub,隨時可用。
這不是玩具示範。這項 skill 支援正式環境採用的訓練方法:監督式微調、直接偏好最佳化,以及以可驗證獎勵進行強化學習。你可以訓練參數量由 0.5B 至 70B 的模型、轉換成 GGUF 以便本地部署,亦可執行結合不同技術的多階段流程。
設定及安裝
開始之前,你需要:
- 擁有 Pro 或 Team/Enterprise 方案的 Hugging Face 帳戶(Jobs 需要付費方案)
- 來自 huggingface.co/settings/tokens、具寫入權限的 token
- Claude Code、OpenAI Codex 或 Google Gemini CLI 等 coding agent
Hugging Face skills 相容於 Claude Code、Codex 和 Gemini CLI。Cursor、Windsurf 及 Continue 的整合功能即將推出。
Claude Code
- 把這個儲存庫註冊為 marketplace 外掛:
/plugin marketplace add huggingface/skills
- 安裝 skill 時,執行:
/plugin install <skill-folder>@huggingface-skills
例如:
/plugin install hf-llm-trainer@huggingface-skills
Codex
- Codex 會透過
AGENTS.md檔案識別 skills。你可以執行以下指令,確認指示已載入:
codex --ask-for-approval never "Summarize the current instructions."
- 如需更多詳情,請參閲 Codex AGENTS 指南。
Gemini CLI
此儲存庫內含
gemini-extension.json,可用來整合 Gemini CLI。在本機安裝:
gemini extensions install . --consent
或使用 GitHub URL:
gemini extensions install https://github.com/huggingface/skills.git --consent
- 如需更多協助,請參閲 Gemini CLI 擴充功能文件。
連接至 Hugging Face
你必須使用 Hugging Face 帳戶的寫入權限 token完成驗證,讓工作能建立模型儲存庫。
設定 token:
hf auth login
# or
export HF_TOKEN=hf_your_write_access_token_here
將寫入 token 傳入
HF_TOKEN或Authorization: BearerHTTP 標頭,設定 Hugging Face MCP Server 使用該 token。使用 Claude Code:
claude mcp add --transport http hf-skills https://huggingface.co/mcp?bouquet=skills --header "Authorization: Bearer $HF_TOKEN"
首次訓練
以下以完整範例説明。我們會先微調一個小型模型,展示整個流程,再介紹更進階的功能。
指示 coding agent 進行微調
先清楚簡單地指示 agent 微調指定模型。
Fine-tune Qwen3-0.6B on the open-r1/codeforces-cots dataset for instruction following.
Coding agent 會分析你的要求並準備訓練設定。若要在示範數據集上訓練 0.6B 模型,它會選用 t4-small:這張 GPU 足以應付該模型規模,而且是目前最便宜的選項。
open-r1/codeforces-cots數據集收錄 Codeforces 問題及解答,適合用來指令微調模型,讓它解答高難度程式問題。
這個方法同樣適用於視覺語言模型!你只需執行「在 llava-instruct-mix 上微調 Qwen/Qwen3-VL-2B-Instruct」即可。
提交前先檢查
Coding agent 提交任何內容之前,你會先看到設定:
I'll fine-tune Qwen/Qwen3-0.6B on open-r1/codeforces-cots using SFT.

Configuration:
- Hardware: t4-small (~$0.75/hour)
- Estimated time: ~20 minutes
- Estimated cost: ~$0.30
- Output: username/qwen-codeforces-cots-sft

The model will be pushed to Hub automatically. Should I submit?
這是你調整任何設定的機會。你可以更改輸出儲存庫名稱、選擇其他硬件,或要求 Claude 修改訓練參數。你核准後,agent 才會提交訓練工作。
例如,你可以要求 agent 先試跑:
Do a quick test run on 100 examples.
追蹤進度
提交後,你會收到工作詳情:
✅ Job submitted successfully!

Job ID: abc123xyz
Monitor: https://huggingface.co/jobs/username/abc123xyz

Expected time: ~20 minutes
Estimated cost: ~$0.30

View real-time metrics at: https://huggingface.co/spaces/username/trackio
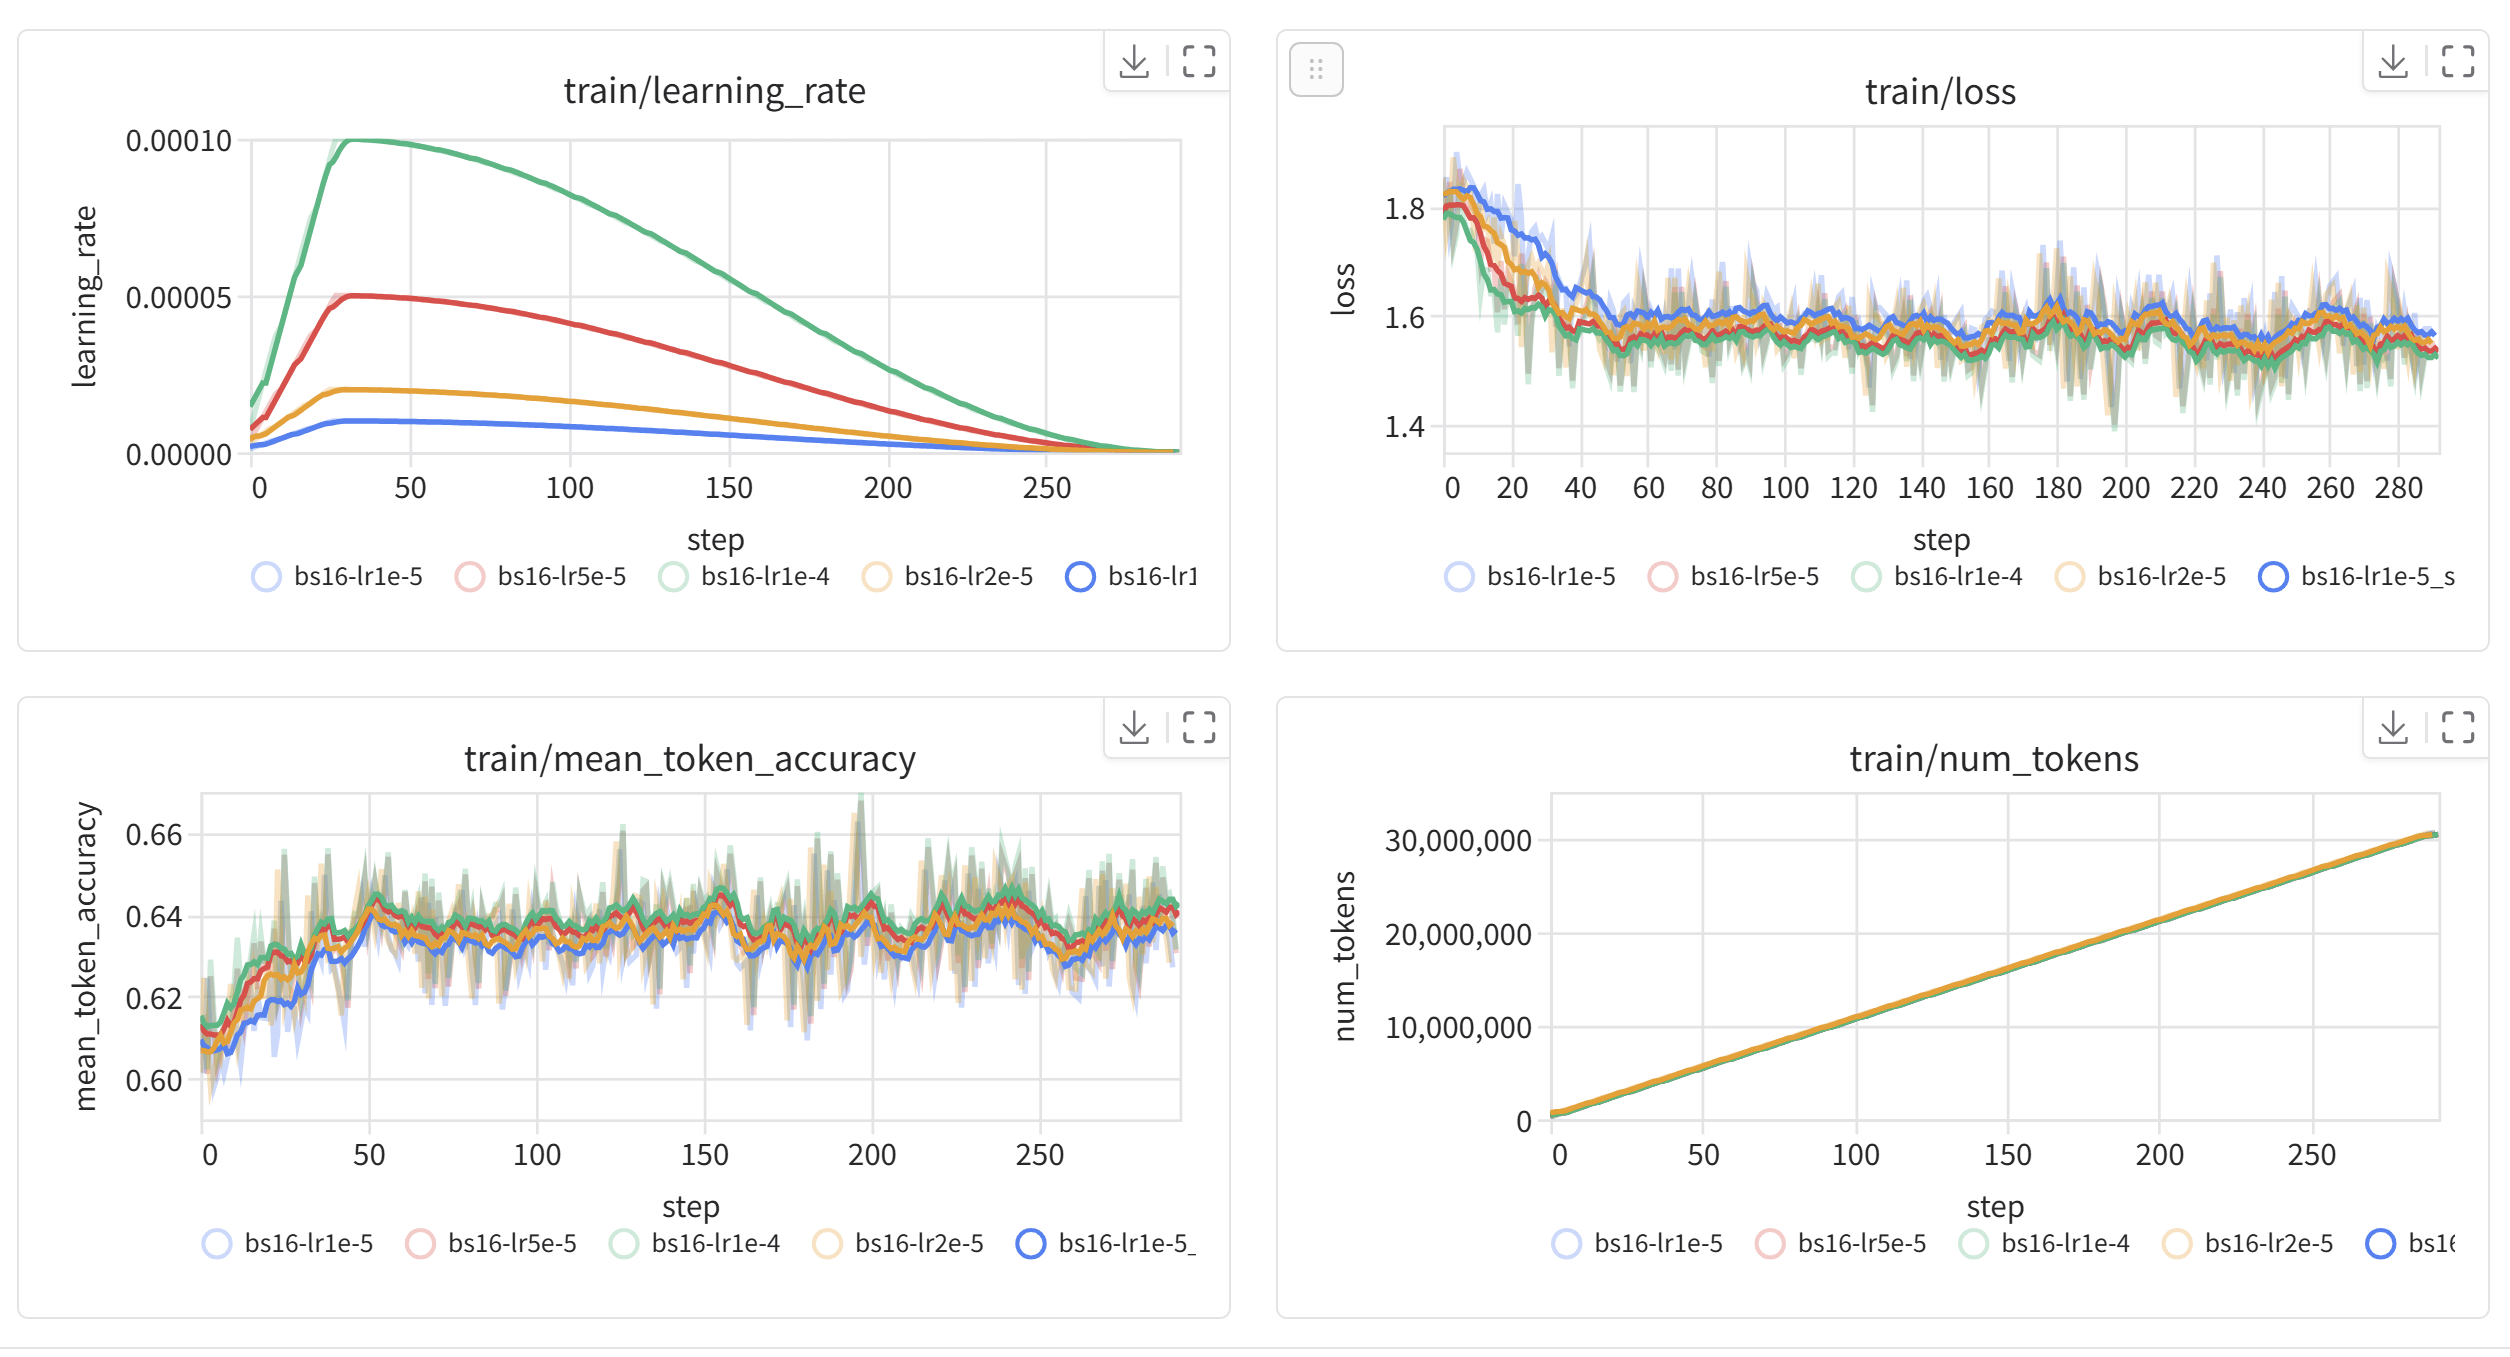
這項 skill 整合了 Trackio,因此你可以即時查看訓練損失下降。工作會以非同步方式執行,你可以關閉終端機,稍後再回來。需要更新時:
How's my training job doing?
然後,agent 會擷取記錄並概述進度。
使用你的模型
訓練完成後,你的模型便會出現在 Hub:
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("username/qwen-codeforces-cots-sft")
tokenizer = AutoTokenizer.from_pretrained("username/qwen-codeforces-cots-sft")
整個流程就是這樣。你用日常英文描述需求,agent 便會處理 GPU 選擇、指令碼生成、工作提交、驗證和持續儲存。整個過程花費約三十美仙。
訓練方法
這項 skill 支援三種訓練方法。瞭解何時採用各種方法,有助取得更佳結果。
監督式微調(SFT)
大部分專案都由 SFT 開始。你提供示範數據,即輸入和預期輸出的範例,訓練便會調整模型,令它符合這些模式。
如果你有想要的行為之高質素範例,便適合使用 SFT。客戶支援對話、程式碼生成配對、特定領域問答等,只要能展示理想答案的例子都適用。
Fine-tune Qwen3-0.6B on my-org/support-conversations for 3 epochs.
Agent 會驗證數據集、選擇硬件(為 7B 模型配搭 LoRA 使用 a10g-large),並設定訓練檢查點及監察功能。
參數量大於 3B 的模型,Agent 會自動使用 LoRA(低秩適配)以減少記憶體需求。這令你可以在單張 GPU 上訓練 7B 或 13B 模型,同時保留大部分完整微調的質素。
直接偏好最佳化(DPO)
DPO 使用偏好配對訓練:一個回應為「chosen」(偏好),另一個為「rejected」(不偏好)。通常在初始 SFT 階段後,以此方法令模型輸出符合人類偏好。
如果你有人工標註者或自動比較產生的偏好標籤,便適合使用 DPO。DPO 直接以偏好回應為目標進行最佳化,無須獨立獎勵模型。
Run DPO on my-org/preference-data to align the SFT model I just trained.
The dataset has 'chosen' and 'rejected' columns.
DPO 對數據集格式有嚴格要求。它必須包含名稱完全相同的
chosen和rejected欄,或包含輸入內容的prompt欄。Agent 會先驗證格式;如果數據集使用其他欄位名稱,也會示範如何對應。
你也可以使用 Skills 在視覺語言模型上執行 DPO!歡迎試用 openbmb/RLAIF-V-Dataset。Claude 會作少量修改,之後便能成功訓練。
羣組相對策略最佳化(GRPO)
GRPO 是一種強化學習任務,已證實適用於可驗證任務,例如解數學題、編寫程式碼,或任何能以程式判定是否成功的任務。
Train a math reasoning model using GRPO on the openai/gsm8k dataset based on Qwen3-0.6B.
模型會生成回應,按正確性取得獎勵,再從結果中學習。這比 SFT 或 DPO 複雜,但設定方式相近。
硬件及成本
Agent 會按模型規模選擇硬件;瞭解當中的取捨,有助你作出更佳決定。
模型規模與 GPU 配對
對於1B 參數以下的極小型模型,t4-small 已足夠。這些模型訓練速度很快,完整訓練預計花費 $1–2。很適合作教學或實驗用途。
對於小型模型(1–3B),可升級至 t4-medium 或 a10g-small。訓練需時數小時,費用為 $5–15。
對於中型模型(3–7B),你需要 a10g-large 或配搭 LoRA 使用的 a100-large。完整微調無法容納,但 LoRA 足以應付這些模型。正式用途預算為 $15–40。
對於大型模型(7B 以上),這項 HF Skills 工作並不適用。
示範與正式訓練
測試工作流程時,先從小規模開始:
Do a quick test run to SFT Qwen-0.6B with 100 examples of my-org/support-conversations.
Coding agent 會設定最低限度的訓練,足以驗證流程可行,而不會產生實際成本。
進行正式訓練時,請清楚説明要求:
SFT Qwen-0.6B for production on the full my-org/support-conversations.
Checkpoints every 500 steps, 3 epochs, cosine learning rate.
正式投入數小時訓練前,務必先執行示範。若示範只花 $0.50,便能發現格式錯誤,可避免一次 $30 的失敗訓練。
數據集驗證
數據集格式是訓練失敗最常見的原因。Agent 可以在你花費 GPU 時間之前先驗證數據集。
Check if my-org/conversation-data works for SFT training.
Agent 會在 CPU 上快速檢查(只需幾分之一美仙),並回報:
Dataset validation for my-org/conversation-data:

SFT: ✓ READY
  Found 'messages' column with conversation format

DPO: ✗ INCOMPATIBLE
  Missing 'chosen' and 'rejected' columns
如果數據集需要轉換,Agent 也會示範方法:
My DPO dataset uses 'good_response' and 'bad_response' instead
of 'chosen' and 'rejected'. How do I fix this?
Agent 會提供對應程式碼,並可直接整合至訓練指令碼。
監察訓練
即時監察有助及早發現問題。這項 skill 預設會設定 Trackio;提交工作後,你可以在以下位置查看指標:
https://huggingface.co/spaces/username/trackio
這裡會顯示訓練損失、學習率及驗證指標。正常訓練時,損失會持續下降。
你可以隨時詢問 Agent 狀態:
What's the status of my training job?
Job abc123xyz is running (45 minutes elapsed)

Current step: 850/1200
Training loss: 1.23 (↓ from 2.41 at start)
Learning rate: 1.2e-5

Estimated completion: ~20 minutes
發生問題時,Agent 會協助診斷。記憶體不足?Agent 會建議減少批次大小或升級硬件。數據集錯誤?Agent 會找出不匹配之處。逾時?Agent 會建議延長時限或使用更快的訓練設定。
轉換成 GGUF
訓練完成後,你可能想在本機執行模型。GGUF 格式適用於 llama.cpp 及 LM Studio、Ollama 等相關工具。
Convert my fine-tuned model to GGUF with Q4_K_M quantization.
Push to username/my-model-gguf.
Agent 會提交轉換工作,合併 LoRA adapters、轉換成 GGUF、套用量化,然後推送至 Hub。
然後在本機使用:
llama-server -hf <username>/<model-name>:<quantization>

# For example, to run the Qwen3-1.7B-GGUF model on your local machine:
llama-server -hf unsloth/Qwen3-1.7B-GGUF:Q4_K_M
下一步
我們已展示 Claude Code、Codex 或 Gemini CLI 等 coding agent 如何處理模型微調的完整流程:驗證數據、選擇硬件、生成指令碼、提交工作、監察進度及轉換輸出。這讓過去需要專業技能的工作,如今可以透過對話完成。
不妨試試:
- 使用自己的數據集微調模型
- 透過 SFT → DPO 建立符合偏好的模型
- 使用 GRPO 在數學或程式碼任務上訓練推理模型
- 把模型轉換成 GGUF,並使用 Ollama 執行
這項skill 以開放原始碼發布。你可以擴展它、按工作流程自訂,或用作其他訓練情境的起點。
資源
來源:Hugging Face Blog · huggingface.co