Amazon Bedrock 如何按 IAM 主體追蹤並限制支出:使用 CUR 2.0 和 AWS Budgets
Tokenomics at scale: Track and cap Amazon Bedrock spend per IAM principal with CUR 2.0 and AWS Budgets
AWS 説明如何透過 Cost Explorer 或 CUR 2.0 查看 Amazon Bedrock 按 IAM 主體劃分的支出,並以 AWS Budgets 設定限制,常見情況毋須編寫應用程式程式碼。
文章示範以 IAM 主體標籤、CUR 2.0 與 AWS Budgets 建立 Amazon Bedrock 身份級成本報表和支出限制,並交代共享角色及帳單更新延遲的影響。
生成式 AI 開支難以歸屬。機構擴大 AI 存取權限前,CFO 和 CTO 通常會想知道三件事:每位用戶或每個團隊的開支是多少、能否設限,以及要投入多少工夫才能做到。
在我們上一篇文章 規模化代幣經濟學:Jamf 如何為 Amazon Bedrock 建立即時開支管控 中,我們介紹了一套自訂管控流程,結合 AWS IAM Identity Center、透過 Amazon Bedrock 模型呼叫記錄取得資料的 Amazon Athena,以及 AWS Lambda。這種方法可實現近乎即時的控制,但需要編寫程式碼,之後亦要由你負責維護和運作。
本文介紹如何只使用 AWS 原生功能,查看每個身份的 Amazon Bedrock 成本,並設定可執行的開支上限;一般情況下無須編寫應用程式程式碼。這個方法依靠三項功能:Amazon Bedrock 自動記錄的 IAM 主體歸屬資訊;用於製作報告的 AWS 成本和用量報告(CUR)2.0 或 AWS Cost Explorer;以及用於執行管控的 AWS Budgets 和預算動作。完成後,你便能按身份查看成本報告,並設定自動防護措施,在超出門檻時限制 Amazon Bedrock 的存取權限。
方案概覽
方案分為三個部分:歸屬、報告和管控。
歸屬。Amazon Bedrock 會自動為每項推理請求記錄 AWS Identity and Access Management (IAM) 主體身份,即 IAM 用戶或 角色,無須更改 Amazon Bedrock 模型推理呼叫。如果多人共用同一個角色,可在承擔角色時傳入工作階段標籤,以加入每位用戶的詳細資料。如果每位用戶或應用程式各自使用不同角色,則只需在角色上設定主體標籤。
報告。將這些標籤啟用為成本分配標籤,然後透過 Cost Explorer 查看資料(只需使用主控台),或使用 CUR 2.0 資料匯出進行詳細的逐項分析和 SQL 查詢。
管控。建立一項範圍限定為 Amazon Bedrock、並按單一身份或標籤值篩選的 AWS Budget,然後附加一項 預算動作,在超出門檻時套用 Deny IAM 政策。
以下各節會配合實作步驟,詳細介紹每個部分。
前置條件
部署此方案需要:
- 已啟用 Amazon Bedrock 模型存取權限的 AWS 帳戶。
- 具備標記 IAM 主體、啟用成本分配標籤、建立資料匯出,以及建立預算和預算動作的權限。
- 透過 IAM 角色或 IAM 用戶存取 Amazon Bedrock。
- 已使用適當憑證設定的 AWS Command Line Interface (AWS CLI)。
- 一項 CUR 2.0 資料匯出,以及用來接收匯出的 Amazon Simple Storage Service (Amazon S3) 儲存貯體。(可選,用於詳細的逐項分析)。
- Amazon Athena。(可選,用於查詢匯出資料)。
AWS Billing Console 的存取權限管理方式與大部分 IAM 權限不同。開始前,請確認你已取得該權限。
操作指南
在設定任何項目之前,先查看現有資料。Amazon Bedrock 會自動記錄每個推理請求的呼叫者身分。開啟 Cost Explorer,將 Service 篩選為 Amazon Bedrock,並按可用的身分或標籤維度分組。若帳戶中每個應用程式或用戶已使用不同的 IAM 角色,這可能已提供所需的所有可見度。
設定更多可見度:
- 步驟 1 提供身分層級的可見度。
- 步驟 2 至 4 加入標籤維度和詳細報告。
- 步驟 5 加入強制執行功能。
步驟 1:決定身分如何對應至用戶
標籤設定方式取決於 IAM 主體的組織方式。
每人或每個應用程式使用一個角色。直接在每個 IAM 角色或用戶上附加主體標籤。這些標籤是靜態的,適用於該主體發出的每個請求。可使用 IAM 主控台或 AWS CLI:
aws iam tag-role \
  --role-name BedrockDeveloperRole-alice \
--tags Key=user,Value=alice@example.com Key=team,Value=platform Key=CostCenter,Value=CC-1001多人共用一個角色,或使用閘道。主體標籤無法區分共用角色上的用戶,因為每個工作階段都帶有相同標籤。請改用工作階段標籤,並在擔任角色時傳入。工作階段標籤是動態的,可因工作階段而異。如果工作階段標籤和主體標籤有相同的鍵,該工作階段會優先採用工作階段標籤。
角色的信任政策必須允許 sts:TagSession。工作階段標籤可透過三種方式傳入:
- 使用
sts:AssumeRole搭配--tags,適用於閘道為每位用戶或租戶擔任角色。 AssumeRoleWithWebIdentity,在 OpenID Connect (OIDC) ID token 的 https://aws.amazon.com/tags 聲明中加入標籤(這是聲明名稱,並非供你瀏覽的網址)。AssumeRoleWithSAML,透過對應身分提供者的安全性聲明標記語言(SAML)聲明中的PrincipalTag:*屬性。
如果你的機構已因其他用途擷取類似 saml:sub 的聲明,這本身不代表該聲明可在此使用。身分提供者必須另外將該屬性對應至 PrincipalTag:* SAML 屬性陳述,而角色的信任政策亦必須允許 sts:TagSession,該屬性才會以工作階段標籤的形式傳入。這兩項整合都使用同一個 SAML 聲明,但須分別設定。常見標籤鍵包括 user、team、Department、CostCenter 和 Environment。每個 IAM 用戶或角色最多可套用 50 個主體標籤或工作階段標籤。
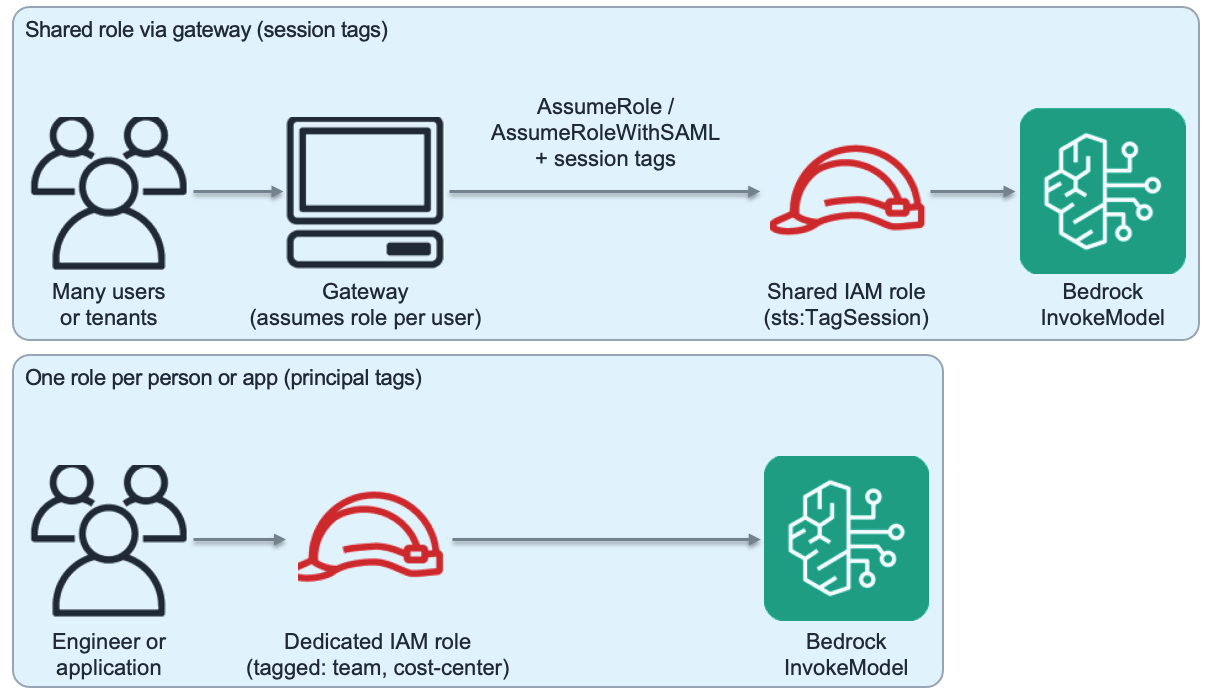
圖 1:使用主體標籤和工作階段標籤進行歸因的比較
步驟 2:啟用成本分配標籤
標籤只有在啟用後才會出現在帳單資料中。
- 開啟 AWS Billing and Cost Management Console。
- 選擇 Cost allocation tags。
- 按類型 IAM principal 篩選。
- 選擇標籤鍵,然後選擇 Activate。
在 AWS 組織中,請在管理帳戶(付款方)啟用 IAM 主體成本分配標籤。成員帳戶無法自行啟用。
請留意兩點:
- 主體至少呼叫過一次 Amazon Bedrock 後,標籤鍵才會出現在這份清單中;因此若清單為空,請先進行測試呼叫。
- 新套用的標籤鍵可能需要最多 24 小時才會顯示為可啟用;啟用後,亦可能再需最多 24 小時才開始填入帳單資料。
標籤預設不會追溯啟用,因此請在需要這些資料之前啟用標籤。
步驟 3:建立包含呼叫者身分的 CUR 2.0 資料匯出
如果 Cost Explorer 已足夠應付你的報告需求,可略過此步驟。
- 在 Billing and Cost Management 主控台中,選擇 Data Exports。
- 選擇 Create,然後建立 CUR 2.0 (Standard) 匯出。
- 在其他匯出內容下,選取包含呼叫者身分(IAM 主體)分配資料。
- 在時間粒度下,選取每小時。
- 在報告資料整合下,選取Amazon Athena。這會將檔案格式設為 Parquet;重要的是,設定指令碼也會連同匯出資料一併放到 S3 儲存貯體。
- 選擇目的地 Amazon S3 儲存貯體。
- 執行隨附的設定指令碼(或其中定義的 Glue 爬蟲/DDL)一次。這一步才會實際建立你在步驟 4 中要查詢的 Glue Data Catalog 資料表。前面的主控台流程不會自動為你建立資料表。
如果你在啟用身分歸屬前已建立 CUR 2.0 匯出,該匯出不會追溯納入身分資料。請建立新的匯出,並選取呼叫者身分選項。在匯出資料中,主體標籤和工作階段標籤會以 iamPrincipal/ 作為欄名前綴,資源標籤則會顯示為 resourceTags/。例如,標籤鍵 team 會顯示為 iamPrincipal/team。AWS 為這種情況提供了一組現成查詢,請參閲aws-samples/sample-cur-iam-principal-bedrock-tracking。
步驟 4:讀取資料
下圖比較讀取資料的兩種方式:只使用主控台,透過 Cost Explorer 查看資料;以及使用 SQL,透過 Amazon Athena 查詢 CUR 2.0 匯出資料。
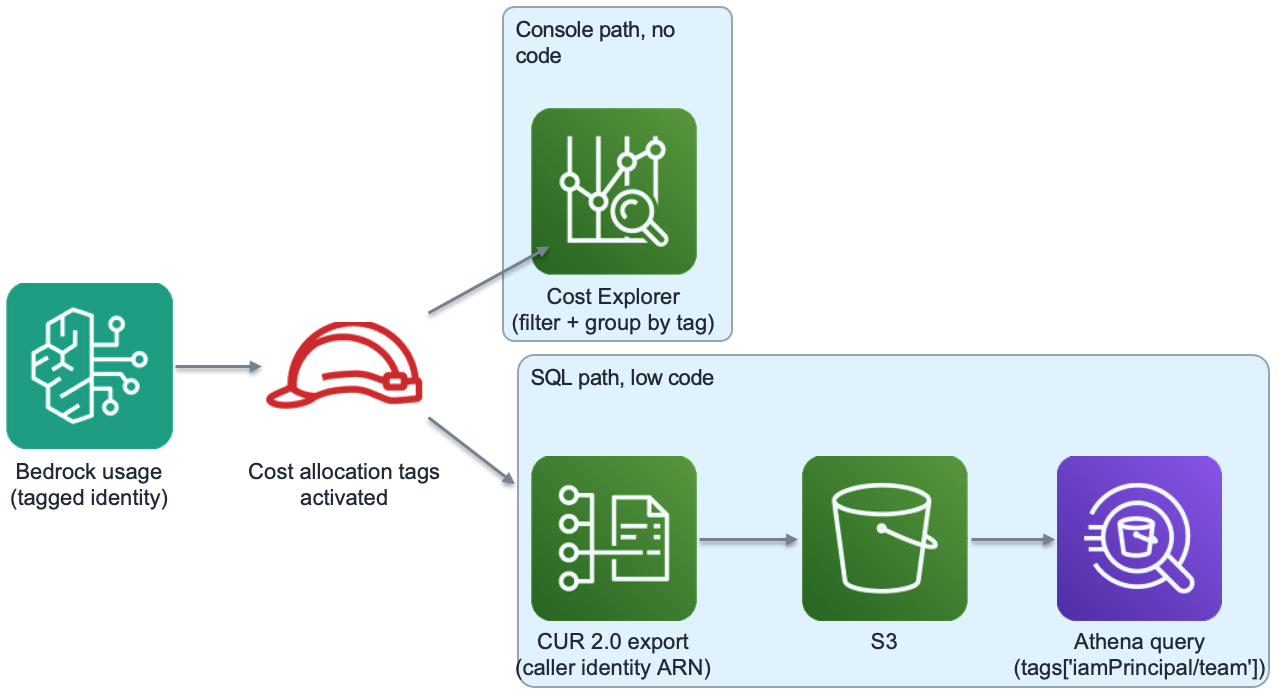
圖 2:使用 Cost Explorer 的報告方式,與使用 CUR 2.0 和 Amazon Athena 的報告方式比較
主控台方式,不需自訂程式碼。在 Cost Explorer 中篩選 Amazon Bedrock,並按你的標籤鍵分組,即可透過圖表和資料表查看各團隊或用戶的開支。這能滿足大部分定期報告需求,而且不需要編寫查詢。
SQL 方式,低程式碼。將 Amazon Athena 指向 CUR 2.0 匯出資料,按 iamPrincipal/team 和用量類型分類開支:
SELECT
    tags['iamPrincipal/team'] AS team,
    line_item_usage_type,
    SUM(line_item_unblended_cost) AS cost
FROM cur2_view
WHERE product_servicecode IN ('AmazonBedrock', 'AmazonBedrockService')
AND billing_period = '2026-09'
GROUP BY 1, 2
ORDER BY 3 DESC
請注意以下事項:
- 服務代碼:Amazon Bedrock 開支可能會記錄在多個
product_servicecode值下,例如AmazonBedrock和AmazonBedrockService。 - 資料表名稱:資料表名稱(
cur2_view)取決於步驟 3 中建立 Glue 資料表時,設定指令碼為它指定的名稱。如果名稱不同,請查看指令碼或 Glue 目錄。無論資料表名稱為何,欄位名稱都與 CUR 2.0 Parquet 結構描述相符。 - 帳單週期欄位。確認匯出資料如何呈現帳單週期。有些匯出使用
billing_period(YYYY-MM);其他匯出則按開始日期或年份/月份欄位分割。
編寫查詢時,有兩點值得留意。
- 計入所有 token 類型:Amazon Bedrock 會按四種 token 類型收費,費率各異:輸入、輸出、快取讀取和快取寫入。每種 token 都是獨立的明細項目,各自有用量類型和單價,因此只加總輸入和輸出會低估開支。大量使用提示詞快取的工作負載,低估幅度最大。如需最新資訊,請參閲 AWS 文件瞭解 CUR 中的 Amazon Bedrock 定價。
- 按明細項目而非模型套用費率:CUR 中 Amazon Bedrock 的定價取決於三項因素:token 類型、服務層級,以及請求是否經跨區域推理路由。同區域與跨區域請求的定價不同,服務層級亦會反映在用量類型中。用量類型會帶有後綴,標示跨區域路由和服務層級;如果工作負載混合使用這些選項,請按每個明細項目套用相應費率,而非為每個模型套用同一費率。如需範例,請參閲CUR 用量類型範例。
步驟 5:使用 AWS Budgets 和預算動作加入管控
AWS Budgets 會執行附加動作,因此這個工作流程不需要自訂程式碼。預算動作會附加至指定的 IAM 用戶、羣組或角色。只有當該人士已有自己的角色時,這樣才能只限制該人士的存取權限。如果多名用戶共用一個角色來傳送 Amazon Bedrock 流量,附加至該角色的 Deny 動作會封鎖所有使用該角色的人,而不只是超出門檻的人。以下圖表説明執行流程。
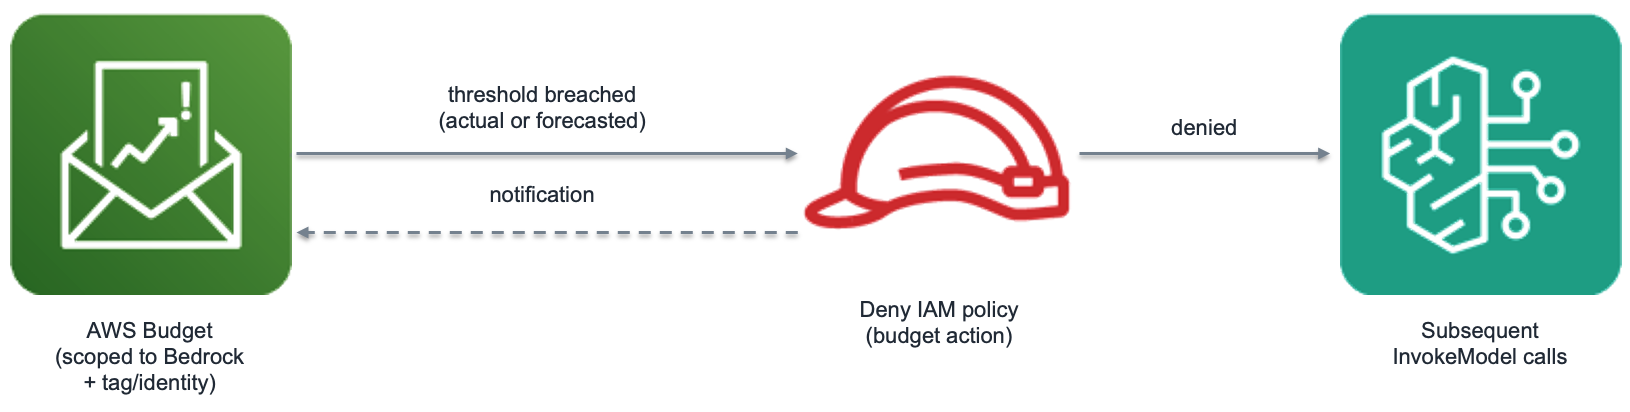
圖 3:透過 AWS Budgets 和預算動作執行限制
AWS Budgets 可在超出門檻時執行動作。可用動作包括套用自訂 IAM 政策、套用服務控制政策 (SCP),以及指定 Amazon Elastic Compute Cloud (Amazon EC2) 或 Amazon Relational Database Service (Amazon RDS) 執行個體。就這個用途而言,相關的是 IAM 政策動作。
首先,建立動作將會附加的 Deny 政策。此例會拒絕使用成本較高的模型,同時保留一個成本較低的模型,讓用戶可以繼續工作:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Deny",
      "Action": [
        "bedrock:InvokeModel",
        "bedrock:InvokeModelWithResponseStream"
      ],
      "Resource": [
        "arn:aws:bedrock:*::foundation-model/[HIGHER-COST-MODEL-ID]"
      ]
    }
  ]
}
將 [HIGHER-COST-MODEL-ID] 替換為你要在環境中拒絕使用的模型 ID。
然後設定權限及預算本身。
這裡涉及兩個不同的角色,而 AWS 受管政策只涵蓋其中一個:
你自己的用戶或角色(負責設定預算的用戶或角色)需要 AWS 受管政策 AWSBudgetsActionsWithAWSResourceControlAccess。此政策會授予 Budgets 權限,以及將預算動作角色交由 AWS Budgets 使用所需、附帶條件的 iam:PassRole。
AWS Budgets 為執行動作而擔任的 IAM 角色,在這個用途下沒有單一、具名的受管政策涵蓋。建立此角色時,請設定信任政策,允許主體 budgets.amazonaws.com 擔任此角色(並以 aws:SourceArn 和 aws:SourceAccount 條件限制範圍);另設定權限政策,授予 iam:AttachRolePolicy 和 iam:DetachRolePolicy(若亦使用 SCP,則還需授予 organizations:AttachPolicy 和 organizations:DetachPolicy)。可授予的權限請參閲 設定 AWS Budgets 執行預算動作所用的角色。
- 建立前文所述的預算動作角色。
- 建立範圍設為 Amazon Bedrock 的成本預算,並按你要設限的身分或標籤值篩選。
- 在 設定提醒 中新增提醒門檻。若要按實際支出執行動作,請選擇 實際值;若要在支出發生前執行動作,請選擇 預測值。
- 在 附加動作 下,選擇 新增動作,選取預算動作角色,然後選擇 IAM 政策動作。選取 Deny 政策,以及要附加該政策的 IAM 用戶、羣組或角色。
- 若要自動執行限制,請選擇 是,讓動作自動執行。選擇 否,則每次執行動作前都必須由人員在 提醒詳細資料 頁面批准。
- 至少設定一項通知,讓受影響的用戶知道存取權限變更的原因。
你可以為單一門檻附加多項動作,也可以為單一預算設定多個門檻。這樣便可建立不同層級:例如,在 80 percent 時拒絕使用高級模型,在 100 percent 時拒絕使用中階模型,但永不拒絕使用成本較低的模型。
只有管理帳戶可以套用 SCP;使用管理帳戶時,亦可將 SCP 套用至其他帳戶。
注意事項
AWS Budgets 並非近乎即時:預算數據每日最多更新三次,因此動作執行前,支出可能已超出門檻。
成本分配標籤不會追溯生效:新套用的標籤鍵最多需 24 小時才會顯示;啟用後,可能還需最多 24 小時才開始填入帳單數據。
CUR 不含每次請求的明細資料:傳統 CUR 和 CUR 2.0 都會按使用類型、操作及定價/資源屬性,以小時或日為單位彙總 Amazon Bedrock 費用。
IAM 主體欄位需要使用 CUR 2.0:舊版 CUR 格式不包含這些欄位。兩種格式均提供按 token 劃分的成本明細。
工作階段標籤會在 AssumeRole 時綁定,而非按每次請求設定。使用該工作階段憑證發出的每個呼叫,其標籤值都相同,而且只會顯示為彙總帳單資料。工作階段標籤不會寫入模型呼叫記錄。記錄會擷取呼叫者的 identity.arn。如要在共用工作階段中按請求區分用戶,請使用每位用戶專屬的 RoleSessionName,或在每次呼叫的請求中繼資料中設定用戶。
預算動作會套用至 IAM 用戶、羣組及角色。如果用戶透過聯合身分登入,而且沒有固定的 IAM 身分,該動作便需要以角色作為目標。因此,這種做法最適合每位用戶或每個應用程式各自擁有一個角色的情況。如果用戶共用角色,或透過聯合身分登入但沒有自己的角色,請參閲我們之前的文章,瞭解按用戶執行管控的方法。
共用閘道角色預設會令歸因無法細分。使用大型語言模型(LLM)閘道時,記錄到的身分會是閘道的執行角色。
新模型需要留意。使用類型因模型而異。啟用新模型時,請確認它有按預期出現在查詢結果及預算篩選條件中,不要假設它已涵蓋在內。
決策框架
| 要求 | 建議做法 |
| 快速報告 | 按身分分組的 Cost Explorer |
| 按團隊報告 | 使用已啟用標籤的 Cost Explorer(步驟 1、2 和 4) |
| 詳細明細分析 | CUR 2.0 匯出(步驟 1 至 4) |
| 執行管控 | 使用預算動作的 AWS Budgets(步驟 1 和 5) |
清理
為避免持續產生費用,請刪除所有已建立的資源。
結論
在本文中,你瞭解到如何只使用 AWS 原生功能,查看 Amazon Bedrock 按身分劃分的費用,並設定可執行的支出上限;一般情況下,無須編寫應用程式程式碼。隨着生成式 AI 的應用規模擴大,能夠勝出的機構,將是能夠有把握地回答 Tokenomics 問題的機構:每位用戶或每個團隊的開支是多少、能否設限,以及要花多少工夫才能做到。
現在輪到你開始探索了。我們樂意提供協助;如需進一步支援,請聯絡AWS Support及你的 AWS 帳戶團隊。
關於作者

Arun Chandapillai
Arun 是資深雲端架構師,熱衷透過以業務為先的雲端採用策略,協助客戶加快 IT 現代化。他專門在 AWS 上建構及部署 AI 和生成式 AI 解決方案,涵蓋 Agent 工作流程以至可投入生產環境的應用程式。Arun 是汽車愛好者,亦熱衷演講,並樂於回饋社會;他相信「付出甚麼,就會得到甚麼」。

Cami Persson
Cami 是 AWS 的首席客戶經理,與獨立軟件供應商合作,透過採用雲端及整合 AI 推動價值創造。她專注於加快合作夥伴的收入增長,並大規模推動平台現代化。Cami 居於明尼阿波利斯,與丈夫同住。

Aditya Mettu
Aditya 是 AWS 的技術客戶經理,負責支援獨立軟件供應商(ISV)客戶。他協助工程團隊在 AWS 上可靠且具成本效益地運行生成式 AI,專注於 AI FinOps:Amazon Bedrock 等服務的成本可視性、治理及優化。他樂於將雲端支出數據轉化為實用的管控措施,讓團隊擴大採用 AI 之餘,避免成本失控。

Andre Bernardo
Andre 是雲端基礎設施、FinOps 與 AI 設計交界的建構者,專門打造可穩妥擴展、又不妨礙工程師工作的系統。他負責建構雲端自動化及生成式 AI 平台,讓 Jamf 能安全地採用 AI,同時不拖慢團隊進度。

Andrew Dunham
Andrew 是 FinOps 工程師,專注於雲端成本優化、自動化及財務治理。他結合金融、經濟學和數據科學背景,以及雲端工程專業知識,協助團隊瞭解、控制及優化 AWS 和生成式 AI 工作負載的成本。

Levi McCormick
Levi 是工程總監,在科技業擁有 25 年以上經驗,涉足電話支援、培訓與指導、架構、應用程式設計及客戶互動。他熱衷於改善開發者體驗,並善用雲端平台,讓每位工程師都能成為效能提升 10 倍的工程師。
來源:AWS Machine Learning Blog · aws.amazon.com