Hugging Face 推出 Inference for PROs,開放精選模型 API 端點
Inference for PROs
Hugging Face 推出 Inference for PROs,為 PRO 用户開放精選模型的專屬 API 端點,並提高免費 Inference API 的使用速率限制。服務提供可直接使用的 HTTP 端點,方便試驗及原型開發;文章指出它不適合重型生產應用,並建議此類用途使用 Inference Endpoints。
文中列出 PRO 可用的精選模型、端點呼叫方式及服務不適用於重型生產應用的邊界,便於評估其原型測試用途。
今天,我們推出專為 PRO 用戶提供的 Inference:社羣方案讓你使用精選端點的 API,體驗部分最令人期待的模型,並為免費 Inference API 用量提供更寬鬆的速率限制。請前往此頁訂閲 PRO。
Hugging Face PRO 用戶現在可使用精選強大模型的專屬 API 端點,並透過 text-generation-inference 享受超高速推理。這是免費 Inference API 以外的額外福利;免費 API 開放予所有 Hugging Face 用戶,方便測試和原型開發,涵蓋 200,000 多個模型。PRO 用戶使用這些模型時享有較高速率限制,並可獨家使用現時部分最佳模型。
內容
支援的模型
除了 Hub 上數以千計的公開模型,PRO 用戶亦可免費使用以下頂尖模型,並享有較高的速率限制:
| 模型 | 規模 | 脈絡長度 | 用途 |
|---|---|---|---|
| Meta Llama 3 Instruct | 8B、70B | 8k token | 最佳聊天模型之一 |
| Mixtral 8x7B Instruct | 45B MOE | 32k token | 效能媲美頂尖專有模型 |
| Nous Hermes 2 Mixtral 8x7B DPO | 45B MOE | 32k token | 以 Mixtral 8x7B MoE 為基礎進一步訓練 |
| Zephyr 7B β | 7B | 4k token | 7B 權重模型中的最佳聊天模型之一 |
| Llama 2 Chat | 7B、13B | 4k token | 最佳對話模型之一 |
| Mistral 7B Instruct v0.2 | 7B | 4k token | 7B 權重模型中的最佳聊天模型之一 |
| Code Llama Base | 7B 及 13B | 4k token | 程式碼自動補全和填入 |
| Code Llama Instruct | 34B | 16k token | 對話式程式碼助理 |
| Stable Diffusion XL | 3B UNet | - | 生成影像 |
| Bark | 0.9B | - | 文字轉音訊生成 |
PRO Inference 讓你毋須在自己的基礎設施部署模型,便能輕鬆試驗及開發新模型原型。PRO 用戶可使用上述所有模型的即用型 HTTP 端點。這項服務並非為繁重的正式環境應用而設;對於這類用途,我們建議使用 Inference Endpoints。PRO Inference 亦支援依賴大型語言模型端點的應用程式,例如使用 VS Code 擴充功能自動補全程式碼,或建立自己的 Hugging Chat 版本。
開始使用 PRO Inference
使用 PRO Inference 很簡單,只需向想執行模型的 API 端點傳送 POST 請求。你亦需要在token 設定頁面取得 PRO 帳戶驗證 token,並在請求中使用。舉例來説,要在終端機工作階段使用 Meta Llama 3 8B Instruct 生成文字,可以如下操作:
curl https://api-inference.huggingface.co/models/meta-llama/Meta-Llama-3-8b-Instruct \
    -X POST \
    -d '{"inputs": "In a surprising turn of events, "}' \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer <YOUR_TOKEN>"
執行後會輸出類似以下內容:
[
  {
    "generated_text": "In a surprising turn of events, 2021 has brought us not one, but TWO seasons of our beloved TV show, \"Stranger Things.\""
  }
]
你亦可使用許多熟悉的 transformers 生成參數,例如 temperature 或 max_new_tokens:
curl https://api-inference.huggingface.co/models/meta-llama/Meta-Llama-3-8b-Instruct \
    -X POST \
    -d '{"inputs": "In a surprising turn of events, ", "parameters": {"temperature": 0.7, "max_new_tokens": 100}}' \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer <YOUR_TOKEN>"
如需瞭解生成參數的詳情,請參閲下文的控制文字生成。
在 Python 中傳送請求時,你可以使用方便易用的 InferenceClient;它是 huggingface_hub Python 函式庫提供的工具:
pip install huggingface_hub
InferenceClient 是實用的封裝工具,方便呼叫 Inference API 和 Inference Endpoints:
from huggingface_hub import InferenceClient

client = InferenceClient(model="meta-llama/Meta-Llama-3-8b-Instruct", token=YOUR_TOKEN)

output = client.text_generation("Can you please let us know more details about your ")
print(output)
如果不想每次建立用戶端時都明確傳入 token,可使用 notebook_login()(Jupyter notebook)、huggingface-cli login(終端機),或 login(token=YOUR_TOKEN)(其他地方)登入一次。之後系統會自動使用這個 token。
除了 Python,你亦可以使用 JavaScript,在 JS 或 Node 應用程式中整合推理呼叫。請參閲 huggingface.js 開始使用!
應用程式
與 Llama 2 和 Code Llama 34B 聊天
為聊天對話而訓練的模型會採用非常特定的聊天範本,並因應所用模型而異。你必須留意模型預期的格式,並在查詢中正確重現。
以下示例取自我們的 Llama 2 網誌文章,當中詳細説明如何以對話方式查詢模型:
prompt = """<s>[INST] <<SYS>>
You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe.  Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.

If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information.
<</SYS>>

There's a llama in my garden 😱 What should I do? [/INST]
"""

client = InferenceClient(model="codellama/CodeLlama-13b-hf", token=YOUR_TOKEN)
response = client.text_generation(prompt, max_new_tokens=200)
print(response)
此示例顯示多輪對話中第一則訊息的結構。請注意,使用 <<SYS>> 分隔符來提供系統提示,指示模型應有何表現;接着,我們把查詢放在 [INST] 分隔符之間。
如要延續對話,必須把模型回應附加至序列,再發出新的後續指示。以下是 Llama 2 所用提示範本的一般結構:
<s>[INST] <<SYS>>
{{ system_prompt }}
<</SYS>>

{{ user_msg_1 }} [/INST] {{ model_answer_1 }} </s><s>[INST] {{ user_msg_2 }} [/INST]
同一格式亦適用於 Code Llama Instruct,可與熟悉程式碼的助理進行技術對話!
詳情請參閲我們的 Llama 2 網誌文章。
使用 Code Llama 填入程式碼
Code Llama 等程式碼模型可沿用前述生成策略完成程式碼:提供一段可能包含程式碼或註解的起始字串,模型便會嘗試以合理內容續寫。程式碼模型亦可用於填入任務:這是一種較專門的工作,提供前綴和後綴序列後,由模型預測中間應有的內容。這非常適合用於 IDE 擴充功能等應用。以下看看如何使用 Code Llama:
client = InferenceClient(model="codellama/CodeLlama-13b-hf", token=YOUR_TOKEN)

prompt_prefix = 'def remove_non_ascii(s: str) -> str:\n    """ '
prompt_suffix = "\n    return result"

prompt = f"<PRE> {prompt_prefix} <SUF>{prompt_suffix} <MID>"

infilled = client.text_generation(prompt, max_new_tokens=150)
infilled = infilled.rstrip(" <EOT>")
print(f"{prompt_prefix}{infilled}{prompt_suffix}")
def remove_non_ascii(s: str) -> str:
    """ Remove non-ASCII characters from a string.

    Args:
        s (str): The string to remove non-ASCII characters from.

    Returns:
        str: The string with non-ASCII characters removed.
    """
    result = ""
    for c in s:
        if ord(c) < 128:
            result += c
    return result
如你所見,填入任務採用以下格式:
prompt = f"<PRE> {prompt_prefix} <SUF>{prompt_suffix} <MID>"
如需瞭解這項任務的運作方式,請參閲https://huggingface.co/blog/codellama#code-completion。
Stable Diffusion XL
PRO 用戶亦可使用 SDXL。端點回應是一段代表生成影像的位元組串流。若使用 InferenceClient,它會自動為你解碼為 PIL 影像:
sdxl = InferenceClient(model="stabilityai/stable-diffusion-xl-base-1.0", token=YOUR_TOKEN)
image = sdxl.text_to_image(
    "Dark gothic city in a misty night, lit by street lamps. A man in a cape is walking away from us",
    guidance_scale=9,
)
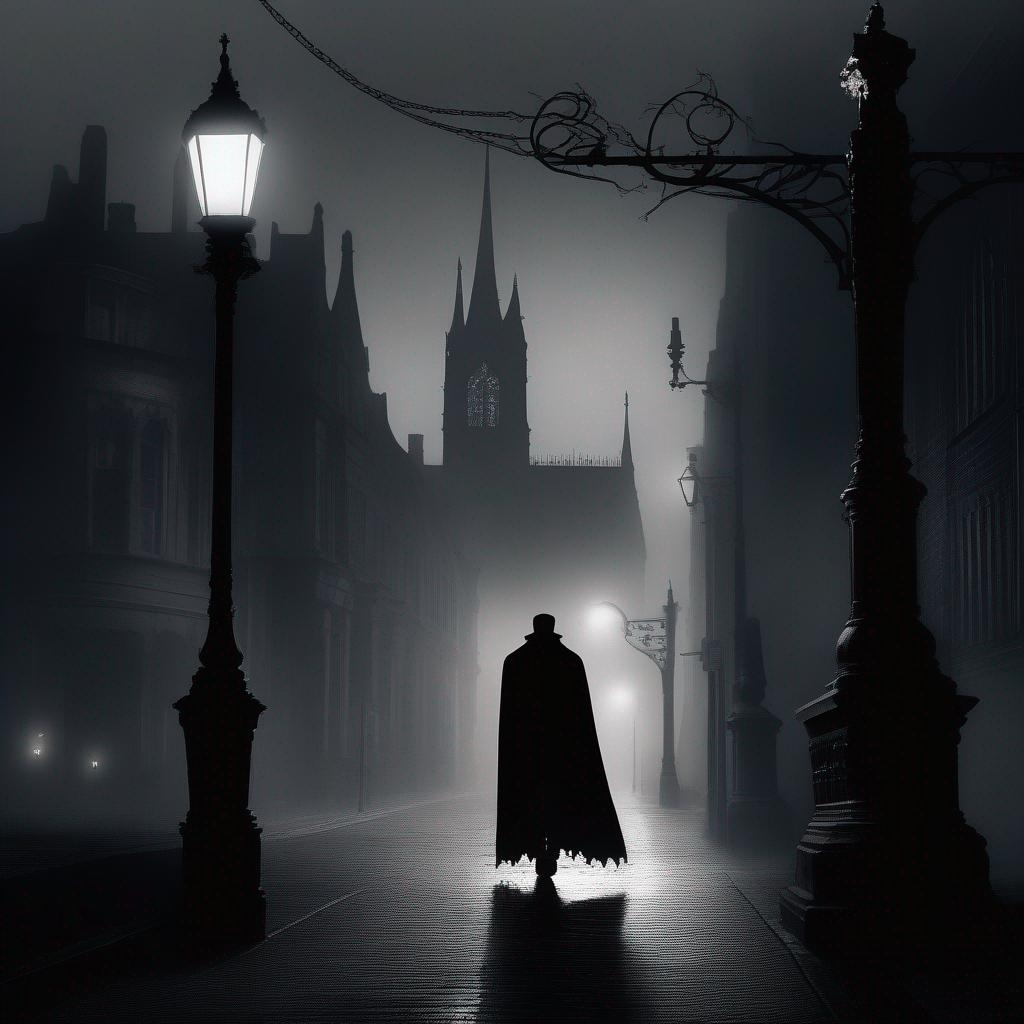
如需瞭解如何控制生成,請參閲本節。
Messages API
所有文字生成模型現在都支援 Messages API,因此相容於 OpenAI 用戶端函式庫,包括 LangChain 和 LlamaIndex。以下程式片段示範如何使用官方 openai 用戶端函式庫搭配 Llama 3.1 70B:
from openai import OpenAI
import huggingface_hub

# Initialize the client, pointing it to one of the available models
client = OpenAI(
    base_url="https://api-inference.huggingface.co/v1/",
    api_key=huggingface_hub.get_token(),
)
chat_completion = client.chat.completions.create(
    model="meta-llama/Meta-Llama-3.1-70B-Instruct",
    messages=[
        {"role": "system", "content": "You are a helpful an honest programming assistant."},
        {"role": "user", "content": "Is Rust better than Python?"},
    ],
    stream=True,
    max_tokens=500
)

# iterate and print stream
for message in chat_completion:
    print(message.choices[0].delta.content, end="")
如需瞭解 Messages API 的用法詳情,請參閲這篇文章。
生成參數
控制文字生成
文字生成涵蓋範圍廣泛,不同用途有不同生成策略。我們推薦閲讀這份出色的概覽。文字生成端點支援多種生成演算法,可以使用以下參數設定:
do_sample:若設為False(預設值),生成方法便是貪婪搜尋,即在你提供的提示之後,選取最可能的續寫序列。貪婪搜尋具有確定性,相同輸入總會產生相同結果。若將do_sample設為True,系統便會按機率分佈抽取 token,因此每次呼叫的結果可能不同。temperature:控制生成結果的變化程度。温度設為0等同貪婪搜尋。只要設定temperature值,系統便會自動啟用do_sample;設定top_k和top_p亦然。執行程式碼相關任務時,我們希望結果較穩定,因此建議使用較低的temperature。對於開放式文字生成等其他任務,則建議使用較高值。top_k:啟用「Top-K」抽樣,模型會從輸入序列之後可能出現、機率最高的K個 token 中選擇。典型值介乎 10 至 50。top_p:啟用「核心抽樣」,模型會選取足夠數量的 token,以涵蓋指定機率質量。如果top_p為 0.9,抽樣時會考慮機率最高的 90% token,並忽略其餘 10%。repetition_penalty:嘗試避免生成序列中重複出現字詞。seed:可配合抽樣使用的隨機種子,方便重現結果。
除了上述抽樣參數,你亦可使用以下參數控制生成的一般設定:
max_new_tokens:要生成的新 token 數量上限。預設值為20;如想生成較長序列,歡迎調高。return_full_text:是否在端點回傳的輸出中包含輸入序列。InferenceClient預設使用False,但端點本身預設使用True。stop_sequences:遇到清單中的序列時,便會停止生成。
控制影像生成
如果想更精細地控制 SDXL 端點生成的影像,可以使用以下參數:
negative_prompt:描述你希望模型避免生成的內容。guidance_scale:控制模型貼合提示的程度。數值較低時準確度較低;數值非常高則可能降低影像品質或產生瑕疵。width和height:指定影像尺寸。SDXL 在 768 至 1024 之間的尺寸表現最佳。num_inference_steps:要執行的去噪步數。步數越多,品質可能越好,但速度會較慢。常見值為 20 至 50 步。
如需瞭解文字生成影像的其他詳情,請參閲 diffusers 函式庫文件。
快取
如果多次執行相同生成任務,會發現 API 每次回傳的結果都相同,即使你使用抽樣而非貪婪解碼也是如此。這是因為系統會快取近期結果。若要每次強製取得不同回應,可以使用 HTTP 標頭,指示伺服器每次都重新生成:x-use-cache: 0。
如果使用 InferenceClient,只需把它加至用戶端的 headers 屬性:
client = InferenceClient(model="meta-llama/Meta-Llama-3-8b-Instruct", token=YOUR_TOKEN)
client.headers["x-use-cache"] = "0"

output = client.text_generation("In a surprising turn of events, ", do_sample=True)
print(output)
串流
Token 串流是指模型生成 token 時,伺服器逐個傳回 token 的模式。這樣使用者可以逐步看到生成內容,不必等待整段內容完成。串流是終端使用者體驗的重要一環,因為它能降低延遲;延遲是流暢體驗最關鍵的因素之一。


要透過 InferenceClient 串流傳送 token,只需傳入 stream=True 並逐一讀取回應。
for token in client.text_generation("How do you make cheese?", max_new_tokens=12, stream=True):
    print(token)

# To
# make
# cheese
#,
# you
# need
# to
# start
# with
# milk
使用 curl 呼叫 generate_stream 端點時,可加入 -N/--no-buffer 旗標,停用 curl 的預設緩衝,讓資料一抵達伺服器便即時顯示。
curl -N https://api-inference.huggingface.co/models/meta-llama/Meta-Llama-3-8b-Instruct \
    -X POST \
    -d '{"inputs": "In a surprising turn of events, ", "parameters": {"temperature": 0.7, "max_new_tokens": 100}}' \
    -H "Content-Type: application/json" \
    -H "Authorization: Bearer <YOUR_TOKEN>"
訂閲 PRO
你今天即可在此註冊 PRO 訂閲,享受更寬鬆的速率限制、最新模型的專屬加速端點,以及新功能的優先體驗權。如果你使用 Inference API 建立了令人期待的專案,或正在尋找 PRO Inference 尚未提供的模型,請在此討論區提出。企業用戶除了 SSO 等其他功能外,亦可使用 PRO Inference API。
常見問題
這會影響免費 Inference API 嗎?
不會。我們仍透過免費 API 提供數以千計的模型,讓大家快速製作原型並探索模型能力。
這會影響企業用戶嗎?
企業訂閲用戶亦可使用精選模型的加速推理 API。
我可以在 PRO Inference API 使用自己的模型嗎?
免費 Inference API 已支援多種函式庫(例如 diffusers、transformers 和 sentence transformers)提供的各類小型和中型模型。如果你有自訂模型或自訂推理邏輯,我們建議使用 Inference Endpoints。
來源:Hugging Face Blog · huggingface.co