Amazon Bedrock AgentCore 如何降低大型 JSON 工作負載的 token 成本與延遲
Reducing token costs and latency in Amazon Bedrock AgentCore JSON workloads
Amazon Bedrock AgentCore 的三項優化策略,令處理 20 MB+ JSON 資料的生產智能體在代表性 23 MB payload 基準測試中,token 用量最多下降 71%,平均延遲最多降低 80%。
文章把狀態外置、列表分頁與字典摘要整合成可組合方案,並以 23 MB 資料測試呈現 token 用量及延遲的變化。
隨着企業使用數十種工具及大型結構化輸入來建構正式環境中的 Agent,Token 用量及延遲便成為影響用戶體驗的主要障礙。當這些 Agent 處理大型 JSON 數據時,每次額外呼叫工具都會把完整負載注入大型語言模型(LLM)的上下文視窗,令 Token 用量及回應延遲急升。在多輪對話中,這種壓力會不斷累積,推高成本並降低迴應質素。有效管理 Agent 系統的上下文視窗壓力,是確保系統在大規模運作時可靠且回應迅速的關鍵。本文分享我們為 Flightscape 建構正式環境 Agent 時採用的三種可組合策略,該 Agent 能處理超過 20 MB 的 JSON 負載。你可以運用這些策略降低 Token 成本及延遲,並在長時間工作階段中維持完整的推理能力。在以具代表性的 23 MB 負載進行基準測試時,這些最佳化措施合共令 Token 用量最多減少 71%,平均延遲最多降低 80%。
解決方案概覽
Flightscape 是一個航空公司營運平台,協助航空公司規劃及管理機組人員、航班和營運。作為 Flightscape 機組人員管理功能的一部分,我們建構了一個訓練排班最佳化 Agent,用以根據業務規則驗證機組人員的訓練排班。這個 Agent 配備 40 多種工具,並處理以 MB 計的大型 JSON 輸入,可回答涉及機組人員排班、日程安排及資源分配的複雜查詢。雖然 Agent 已提供所需功能,但大部分呼叫的平均請求延遲都超過 15 秒。每次工具呼叫都會把完整負載注入模型上下文,令 Token 數量及成本上升。處理較大的數據集時,上下文視窗會在 Agent 完成推理前填滿。下圖(圖 1)詳述 Agent 架構及數據流程:
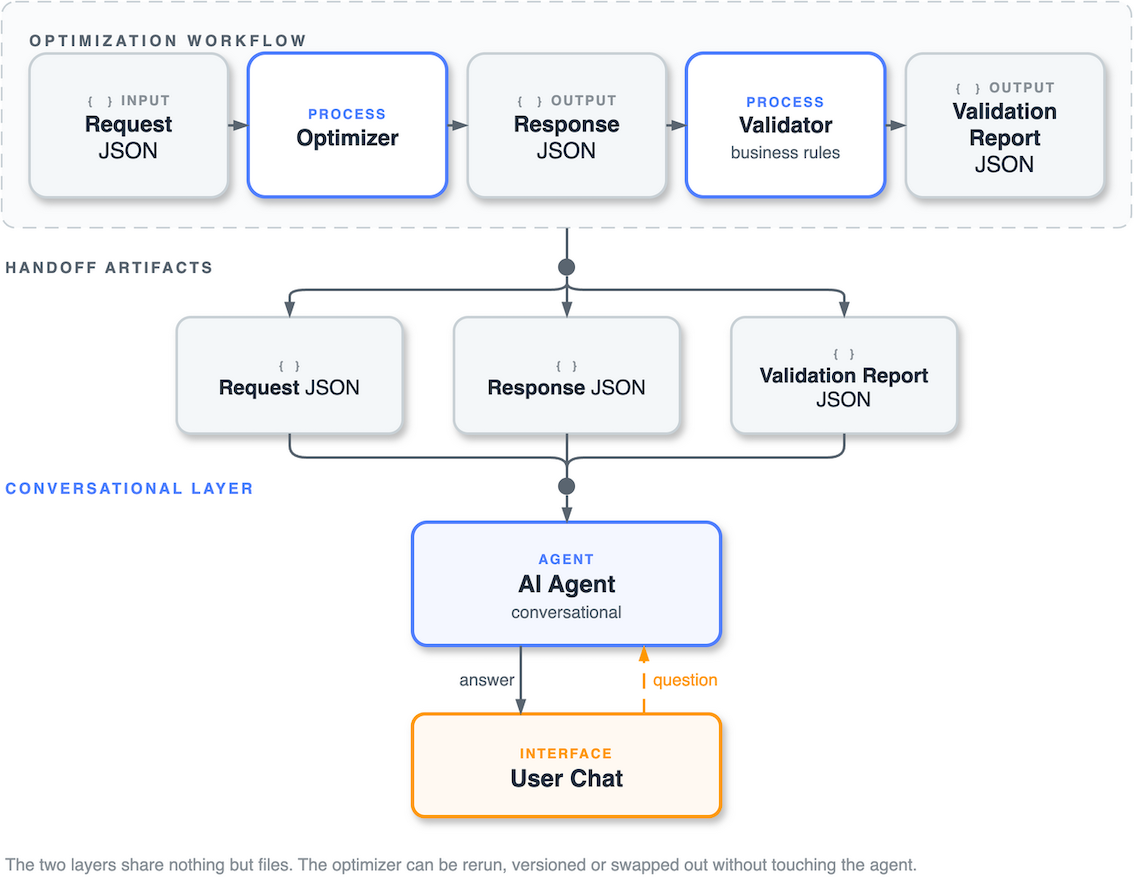
圖 1:Agent 架構及數據流程
在圖 1 中,Optimizer 接收 Request JSON 並產生 Response JSON,之後由 Business Rules Validator 驗證,並產生 Validation Report JSON。AI Agent 會載入這三份 JSON 文件,為用戶提供對話介面,讓用戶查詢最佳化結果、瞭解驗證錯誤,以及查看排班安排。這個 Agent 使用 LangGraph 建構;LangGraph 是 LangChain 推出的開源框架。Agent 在 Amazon Bedrock AgentCore 上運行;這個平台可使用任何框架或模型,大規模建構、連接及最佳化 Agent。Amazon Bedrock Guardrails 可用於驗證及篩選 Agent 的對話回應,協助在正式環境部署中實踐負責任的 AI。我們定義了自訂的 Agent 狀態,用以保存工具所需的資料:最佳化請求 JSON、最佳化回應 JSON,以及驗證報告 JSON。我們亦在狀態中加入基本統計資料及快取資料,以支援更豐富的查詢。Agent 使用 Amazon Bedrock 模型進行推理,並使用 Amazon Bedrock AgentCore memory(Amazon Bedrock AgentCore 的一項功能)保存跨輪次的聊天互動;每一輪都會按照以下流程進行(圖 2):
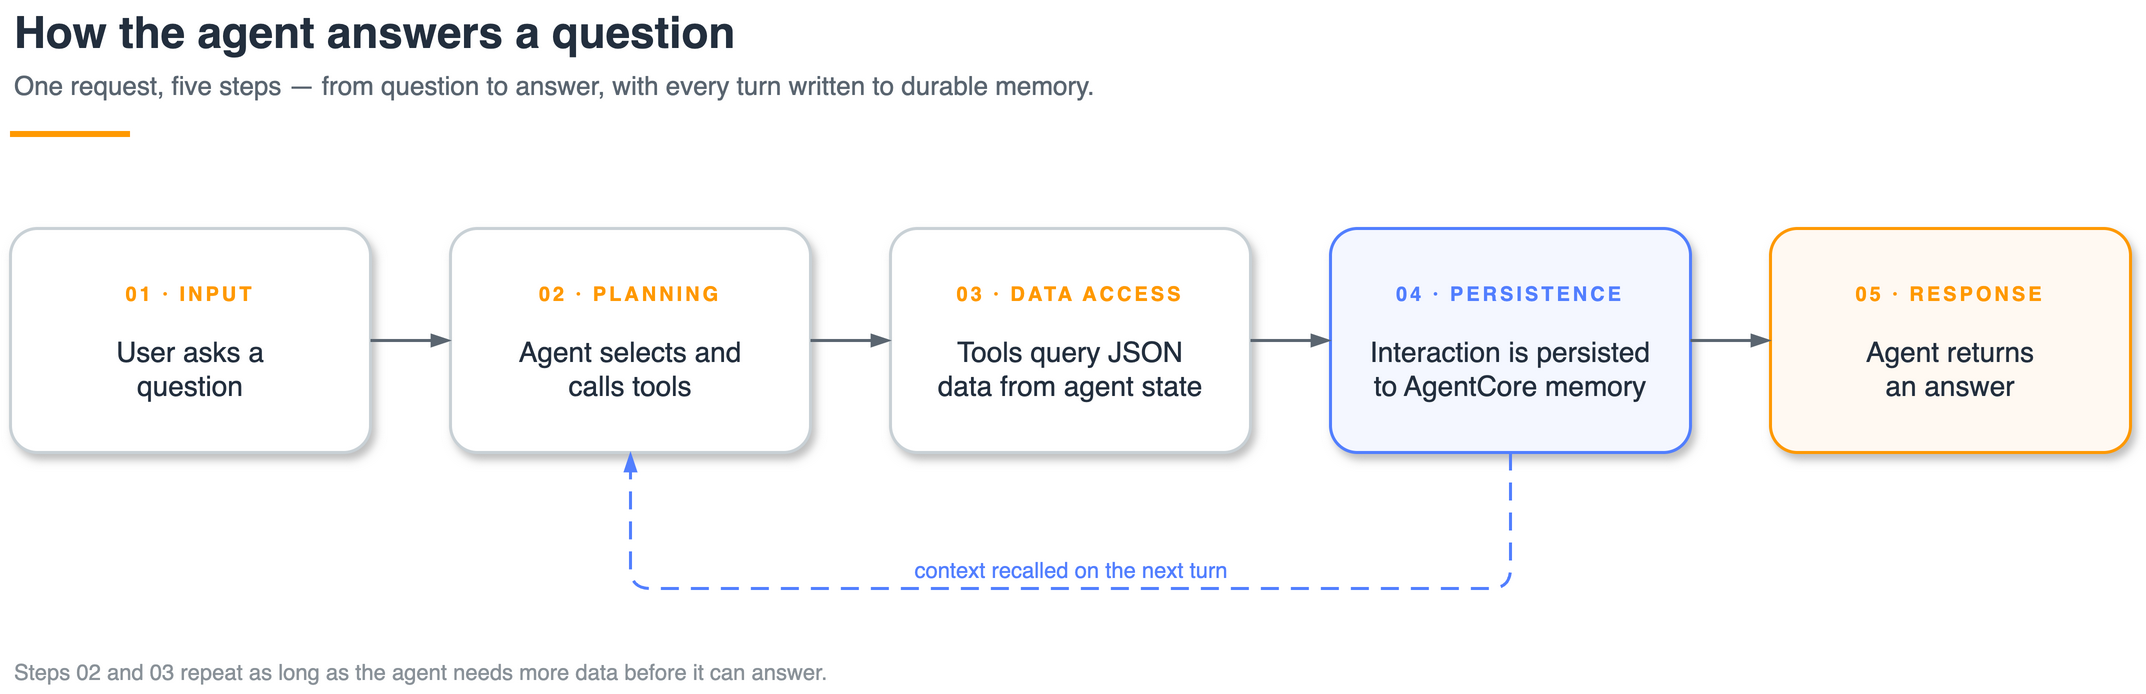
圖 2:Agent 流程
以下是狀態結構。狀態會參照 TOPT(Training Optimizer)請求和回應物件,分別代表機組排班輸入資料及最佳化結果:
class GraphState(TypedDict):
    """LangGraph state that combines messages with application data."""
    # Messages from conversation (managed by add_messages reducer)
    messages: Annotated[List[BaseMessage], add_messages]
    # Application-specific state - parsed domain objects
    request: Optional[TOPTRequest]
    responses: List[TOPTResponse]
    validation_report: Optional[Dict[str, Any]]
    basic_stats: Optional[Dict[str, Any]]
cache_data: Optional[Dict[str, Any]]注意:此狀態最初會將大型資料負載直接內嵌其中。後文會説明我們如何將大型產物移出對話脈絡,以減少 token 用量。
我們實施了三種策略,以降低透過模型脈絡傳遞大型 JSON 資料負載所造成的 token 成本、延遲及記憶體開銷。下圖(圖 3)展示了三種策略如何配合,在單一 Agent 回合中運作。策略 1 會在每個回合開始及結束時執行;策略 2 和策略 3 則會在每次工具傳回結果時執行。
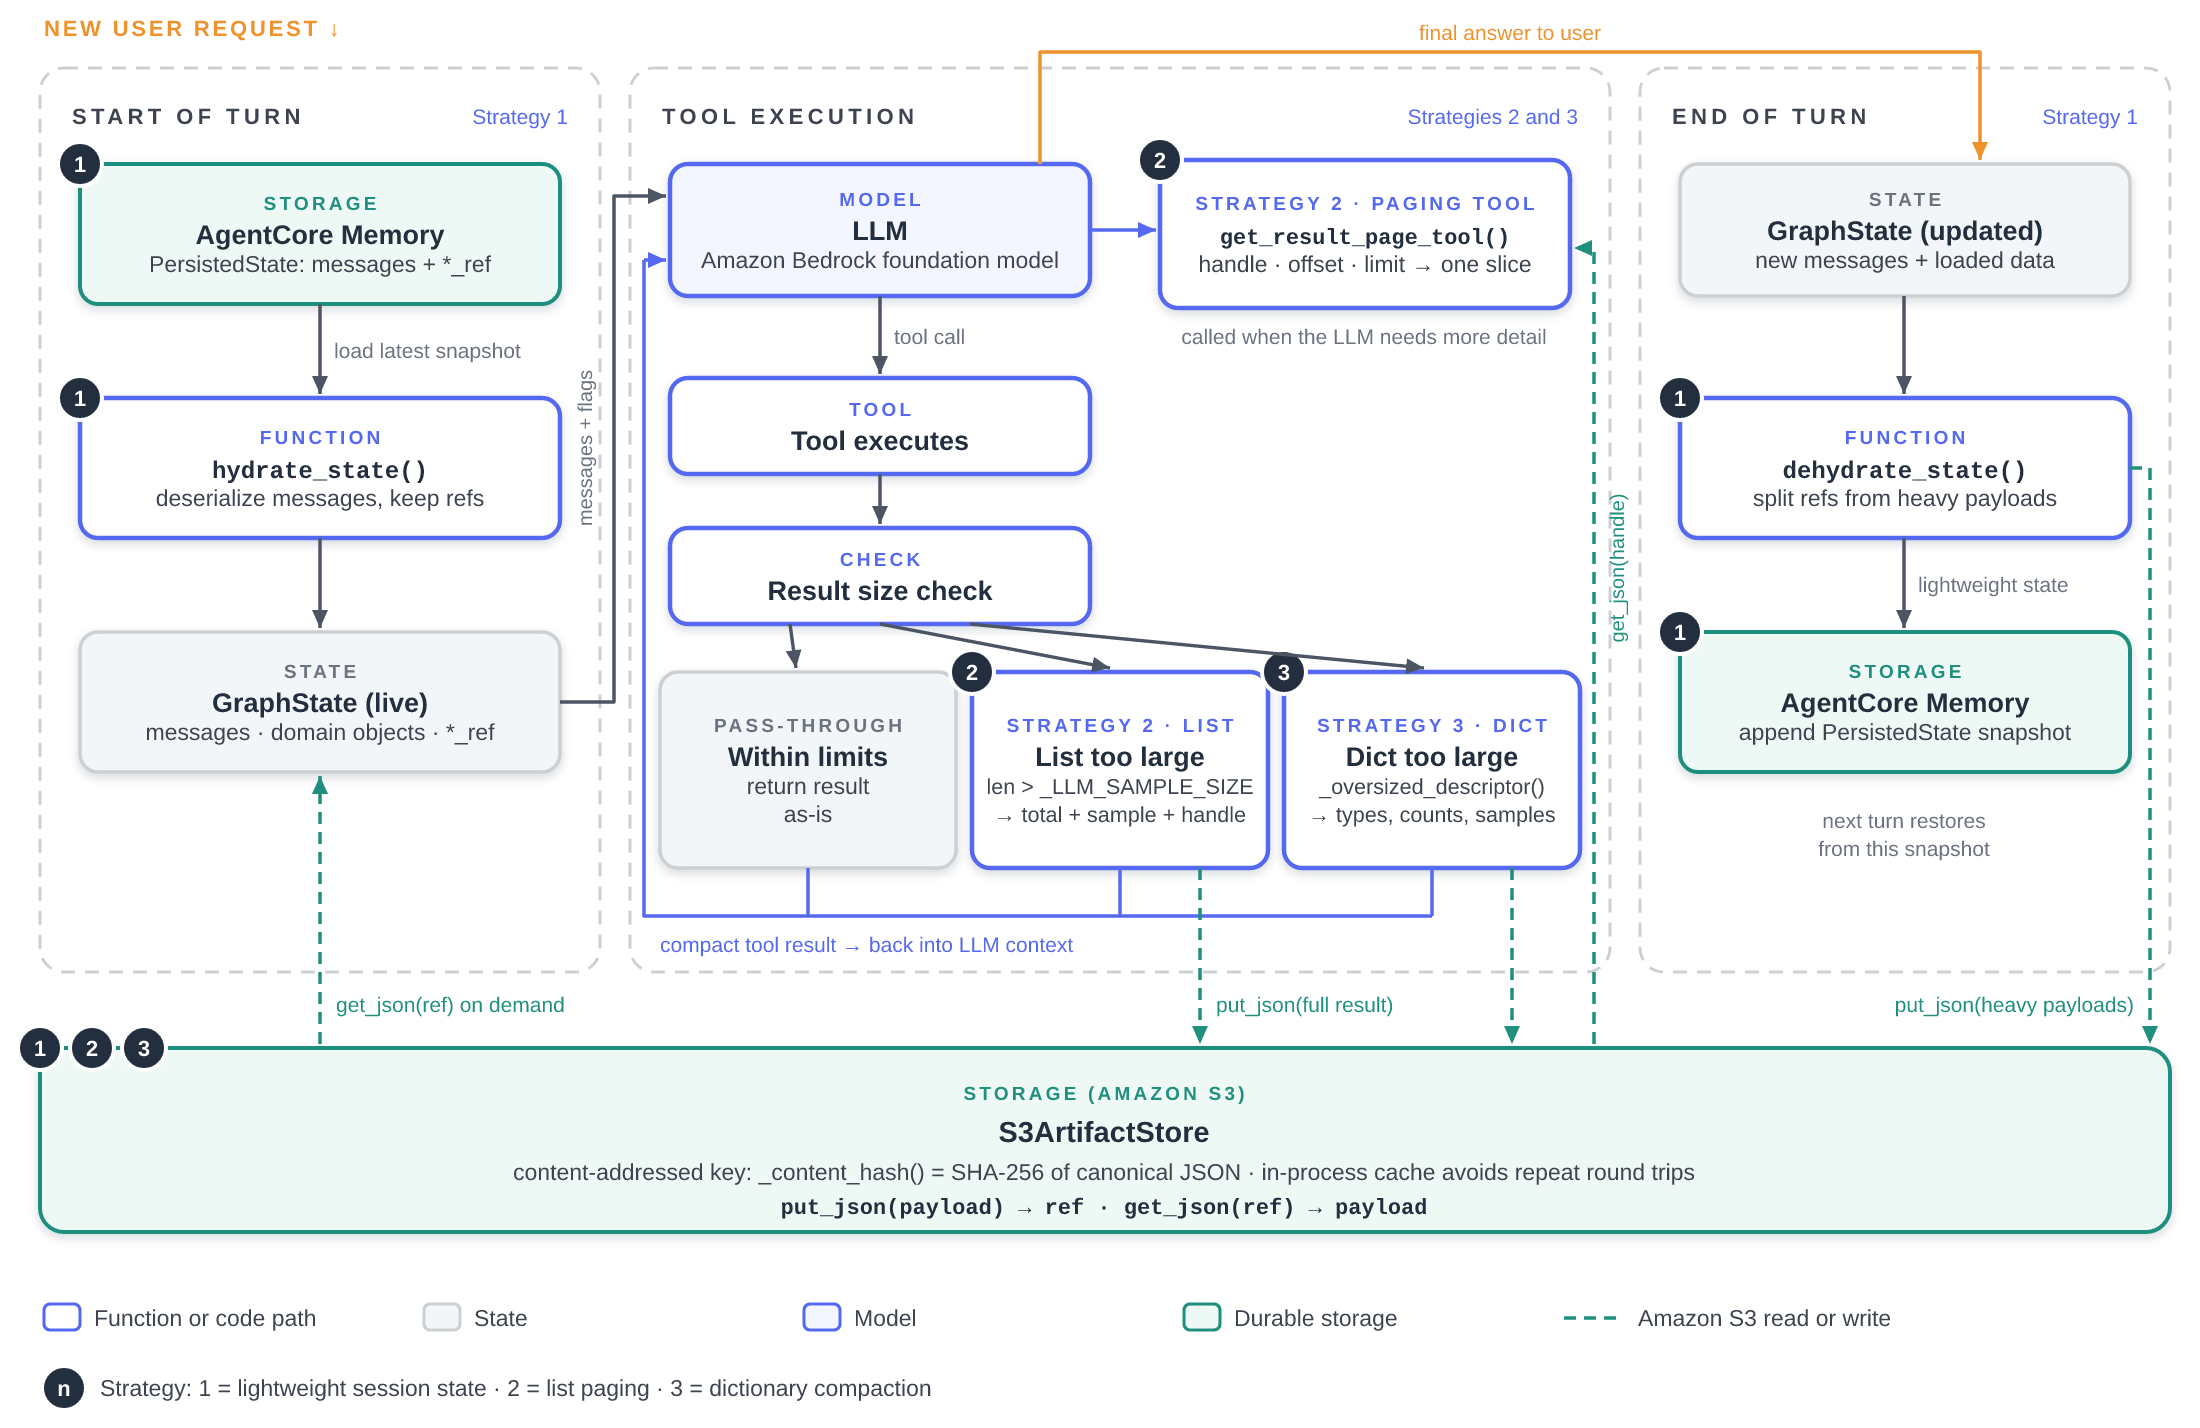
圖 3:單一 Agent 回合中三種最佳化策略概覽
回合開始時,hydrate_state() 函數會從 AgentCore memory 還原輕量的工作階段狀態。當工具傳回過大的清單或字典時,Agent 會將完整結果儲存在 Amazon Simple Storage Service (Amazon S3),並將附有參照代碼的精簡摘要傳給模型。模型之後可以使用 get_result_page_tool() 擷取更多詳細資料。回合結束時,dehydrate_state() 函數會將大型資料負載寫入 S3ArtifactStore,並只將參照儲存至 AgentCore memory。以下各節會詳細説明每種策略。
先決條件
要實施這些策略,請確保具備以下條件:
- 可存取 Amazon Bedrock 及受支援模型的 AWS 帳戶。
- 用於儲存產物的 Amazon S3 儲存貯體。
- 已啟用 Amazon Bedrock AgentCore memory,以持久化工作階段狀態的 Amazon Bedrock AgentCore。
- 支援工具呼叫的 LangGraph 架構 Agent(或同等的圖形協調框架)。
- 已安裝
boto3、langchain-core和langgraph的 Python 3.12+ 環境。
最佳化策略
配套程式碼可在此 GitHub 儲存庫取得。
策略 1:持久化輕量工作階段狀態,將大型產物移出
我們的第一項最佳化是改變持久化工作階段狀態的方式。起初,大型資料負載會儲存在距離對話狀態過近的位置。因此,我們將大型產物(請求 JSON、回應 JSON、驗證資料及其他大型衍生資料負載)移至 Amazon S3。AgentCore memory 只會持久化這些物件的穩定參照,讓工作階段狀態維持輕量。
為此,我們加入了專用的持久化狀態結構描述,只保留輕量欄位及產物參照。執行中的圖狀態仍會包含供工具執行使用的已剖析領域物件,但持久化時則會寫入精簡形式。在執行階段,工具會按需要使用這些參照載入大型資料負載,而非每個回合都載入所有內容。
這個 PersistedState 結構描述就是寫入 AgentCore Memory 的內容:
class PersistedState(TypedDict, total=False):
    """Serialized session state for AgentCore Memory.

    Heavy fields (request, responses) are stored in S3 and referenced by key.
    Lightweight fields are stored inline.
    """
    messages: List[Any]  # LangChain-serialized messages
    request_ref: Optional[str]  # S3 key for raw request JSON
    responses_ref: Optional[str]  # S3 key for raw responses JSON list
    cache_data_ref: Optional[str]  # S3 key for cache_data payload
    validation_report_ref: Optional[str]  # S3 key for validation_report payload
    basic_stats_ref: Optional[str]  # S3 key for basic_stats payload
更新後的 GraphState 會將這些參照與執行中的領域物件一併納入:
class GraphState(TypedDict):
    """LangGraph state that combines messages with application data."""
    messages: Annotated[List[BaseMessage], add_messages]
    # ... (same domain fields as original graph state)
    # Artifact references for persistence
    request_ref: Optional[str]  # S3 key reference for raw request JSON
    responses_ref: Optional[str]  # S3 key reference for raw responses JSON list
    cache_data_ref: Optional[str]  # S3 key ref for cache_data payload
    validation_report_ref: Optional[str]  # S3 key ref for validation_report payload
    basic_stats_ref: Optional[str]  # S3 key ref for basic_stats payload
dehydrate_state 函數會從執行中的狀態移除大型資料負載,並傳回輕量化的持久化形式,以及要上載的產物:
def dehydrate_state(state: GraphState) -> Tuple[PersistedState, Dict[str, Any]]:
    persisted: PersistedState = {
        "messages": [dumpd(m) for m in state.get("messages") or []],
        "request_ref": state.get("request_ref"),
        "responses_ref": state.get("responses_ref"),
        # ... (remaining ref fields)
    }
    artifacts: Dict[str, Any] = {}
    if state.get("request_raw") is not None:
        artifacts["request_ref"] = state["request_raw"]
    # ... (see GitHub repository for full implementation)
    return persisted, artifacts
還原過程會反向執行上述步驟。工作階段恢復時,我們會重建執行中的圖狀態:反序列化 LangChain 訊息、將原始資料負載重新剖析為領域物件,並還原每個參照鍵,讓後續回合能找到相關產物:
def hydrate_state(
    persisted: PersistedState,
    request_raw: Optional[Dict[str, Any]] = None,
    responses_raw: Optional[List[Dict[str, Any]]] = None,
) -> GraphState:
    """Reconstruct a live GraphState from its persisted form."""
    messages = [load(m, allowed_objects="messages") for m in persisted.get("messages") or []]
    request = TOPTRequest.from_dict(request_raw) if request_raw else None
    responses = [TOPTResponse.from_dict(r) for r in (responses_raw or [])]
    return {
        "messages": messages, "request": request, "responses": responses,
        # ... (remaining fields restored from persisted refs, see GitHub repository)
    }
資料精簡與還原過程都依賴產物存放區為每個資料負載提供一致的參照。我們不會隨機產生鍵,而是根據資料負載本身推導參照。這種稱為內容定址的方法,會以排序後的鍵及精簡分隔符號序列化 JSON,並以這些位元組的 SHA-256 摘要作為參照。
_content_hash 輔助函數會從可序列化為 JSON 的資料負載產生確定性的 SHA-256 參照:
def _content_hash(payload: Any) -> str:
    return hashlib.sha256(_canonical_bytes(payload)).hexdigest()
內容定址可令寫入操作具備冪等性。相同的酬載會對應至相同的鍵,因此即使某一回合重新序列化了未有變更的請求 JSON,也會重用儲存貯體中已有的物件,而不會再次上載。由 S3 支援的儲存區提供 put_json 和 get_json 介面。它亦會保留一個小型的程序內快取,因此在目前呼叫期間已讀取或寫入的酬載,無須再次與 S3 往返。
S3ArtifactStore 類別以程序內快取和內容定址鍵,包裝 put_json/get_json 介面:
class S3ArtifactStore:
    """Content-addressed artifact store backed by Amazon S3."""
    def __init__(self, bucket=None, prefix=None, region=None) -> None:
        self.bucket = bucket or os.getenv("SESSION_STATE_BUCKET")
        self.prefix = (prefix or os.getenv("ARTIFACT_STORE_PREFIX", "artifacts")).strip("/")
        # ... (boto3 session setup, see GitHub repository)
        self._cache: Dict[str, Any] = {}

    def put_json(self, payload: Any) -> str:
        ref = _content_hash(payload)
        with self._lock:
            if ref in self._cache:
                return ref  # Identical content already uploaded, skip PUT
            self._s3.put_object(Bucket=self.bucket, Key=self._key(ref), Body=_canonical_bytes(payload))
            # ... (cache update)
            return ref

    def get_json(self, ref: str) -> Any:
        with self._lock:
            if ref in self._cache:
                return self._cache[ref]
        # ... (S3 fetch and cache, see GitHub repository)

artifact_store = S3ArtifactStore()
將大型成品卸載至 S3,並只保存輕量級參照,降低了每回合延遲,以及儲存在 AgentCore 記憶體中的數據量。由於不再直接保存大型酬載,工具呼叫回應成為上下文 token 的主要消耗來源,促使我們引入結果分頁。
策略 2:按需分頁大型結果清單
即使將大型酬載的保存工作移至 Amazon S3,我們在工具回應階段仍面對嚴重的 token 瓶頸。許多工具結果過於龐大,帶來兩個問題。首先,即使模型只需要其中一小部分,我們仍會傳送完整清單,令每個回合更慢、成本更高。其次,這些完整清單酬載會被注入上下文,在多回合對話中迅速耗盡上下文視窗。
在某些情況下,單一工具回應就超過 80,000 個 token,而且用戶繼續與 Agent 互動時,成本還會不斷累積。我們希望保留完整的數據存取能力,同時避免預設傳送所有內容。為此,我們為大型工具輸出引入按需結果分頁。工具現在不再返回完整清單,而是返回精簡酬載,其中包含總數、少量樣本,以及結果控制代碼。
當工具結果超出樣本大小閾值時,完整清單會儲存在 S3,而只向模型返回精簡摘要:
if len(result) > _LLM_SAMPLE_SIZE:
    handle = artifact_store.put_json(result)
    return json.dumps(
        {
            "_oversized": True,
            "_result_handle": handle,
            "total": len(result),
            "sample": result[:_LLM_SAMPLE_SIZE],
        },
        default=str,
    )
控制代碼指向儲存在 S3 的完整結果。當 Agent 需要更多細節時,便會使用控制代碼呼叫分頁工具,並只要求所需的部分,例如指定 offset 和 limit。
get_result_page_tool 函式讓模型可透過控制代碼、offset 和 limit,擷取已儲存結果的其他部分:
def get_result_page_tool(handle: str, field: Optional[str] = None, offset: int = 0, limit: int = 50):
    payload = artifact_store.get_json(handle)
    if isinstance(payload, list):
        return {
            "handle": handle, "offset": offset, "limit": limit,
            "total": len(payload),
            "items": payload[offset: offset + limit],
        }
    # ... (dict field extraction, see GitHub repository)
按需分頁將完整清單保留在 S3,每回合只提供所要求的部分,從而控制上下文增長,並大幅減少 token 用量。不過,並非所有過大的輸出都是清單。有些工具會返回大型字典,需要採用不同的精簡方式。
策略 3:精簡過大的字典輸出
與清單不同,字典輸出包含深層巢狀的結構化數據,這些數據有助推理,但通常成本太高,無法在每個回合逐字納入。我們需要一種精簡表示方式,既能保留結構線索,又能大幅縮減 token 用量。
為此,我們為過大的字典輸出引入基於描述符的精簡處理。不再完整返回過大的字典,而是返回精簡描述符:
- 清單欄位以數量和樣本表示。
- 巢狀字典則以鍵的數量概括。
- 有用的純量值仍會直接保留在回應中。
完整酬載會儲存在工件儲存區,而回應會包含結果控制代碼。當 Agent 需要更深入的細節時,便會使用該控制代碼,只擷取所需數據。這種回應格式讓模型仍可查閲所需內容,同時大幅減少不必要的 token 用量。
_oversized_descriptor 功能會建立字典資料的精簡結構摘要,保留欄位類型和樣本資料,而不包含完整內容:
def _oversized_descriptor(payload: Dict[str, Any], handle: str) -> Dict[str, Any]:
    fields: Dict[str, Any] = {}
    for key, value in payload.items():
        if key.startswith("_"):
            continue
        if isinstance(value, list):
            fields[key] = {"type": "list", "count": len(value), "sample": value[:5]}
        elif isinstance(value, dict):
            fields[key] = {"type": "dict", "keys": len(value)}
        else:
            fields[key] = {"type": "scalar", "value": value}
    return {"_oversized": True, "_result_handle": handle, "fields": fields}
如果序列化後的輸出仍超出字元上限,備用處理方式會儲存完整資料,並以其描述資訊取代回應:
content = json.dumps(llm_view, default=str)
if len(content) > _MAX_TOOL_CONTENT_CHARS:
    if handle is None:
        handle = artifact_store.put_json(full_view)
    content = json.dumps(_oversized_descriptor(full_view, handle), default=str)
return content
透過輕量持久化狀態、按需分頁及字典精簡,token 用量增長變得可預測,即使處理數 MB 的數據集,Agent 仍能保持回應:
結果
為了驗證這三種策略的成效,我們以相同數據集,分別使用優化前和優化後的 Agent,執行同一組問題。然後,我們在 Amazon Bedrock AgentCore Observability(AgentCore 的一項功能)中比較 token 用量和延遲,發現成本和回應速度均有明顯改善。
在一次包含 5 條問題的對話中,token 總用量減少約 71%,由 ~289,500 降至 ~82,900;平均追蹤延遲則減少近 80%,由 15.4 s 降至 3.1 s(圖 4)。在 100 條樣本問題中(圖 5),token 總用量由 23.6 M 降至 8.5 M(64%),平均追蹤延遲則由 7,930 ms 降至 2,461 ms(69%)。
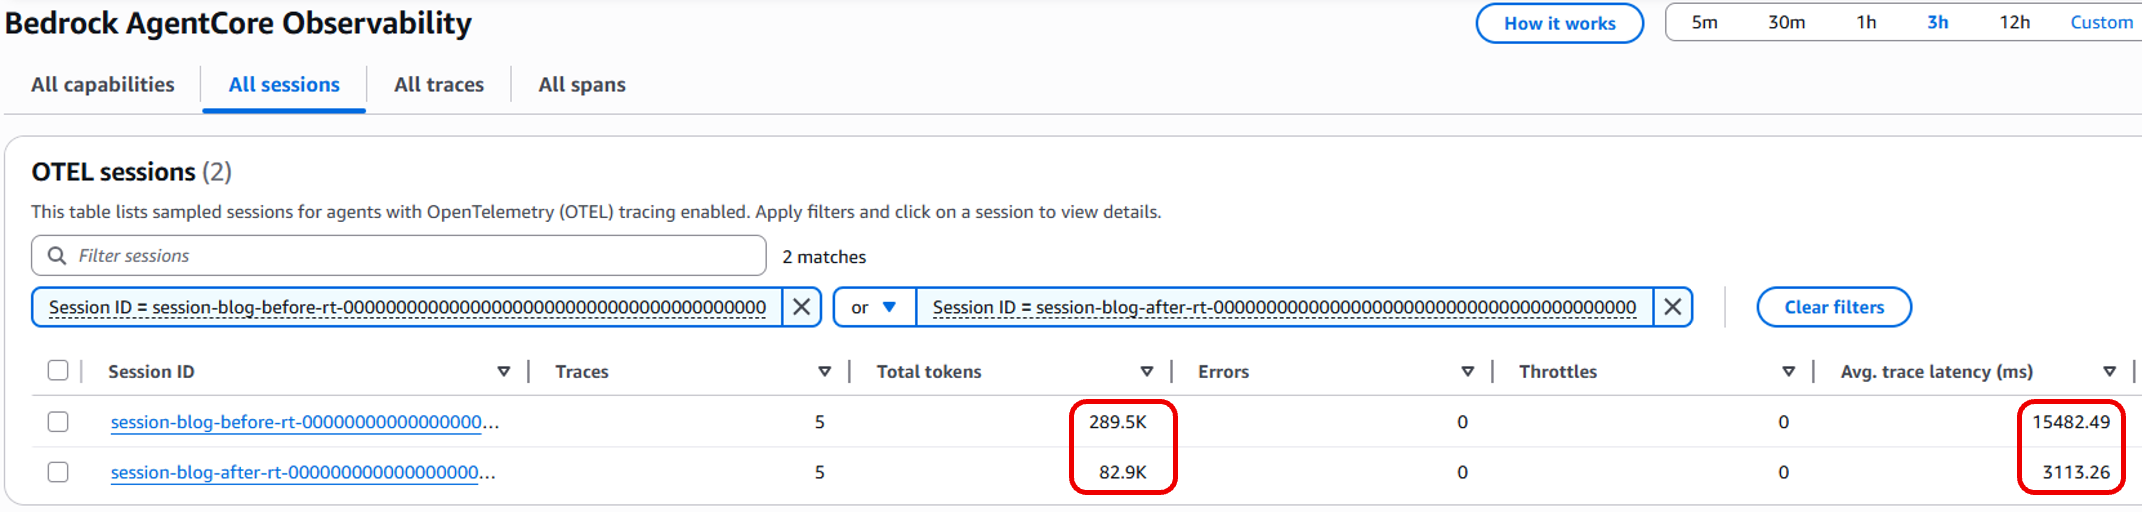
圖 4:OTEL 工作階段比較
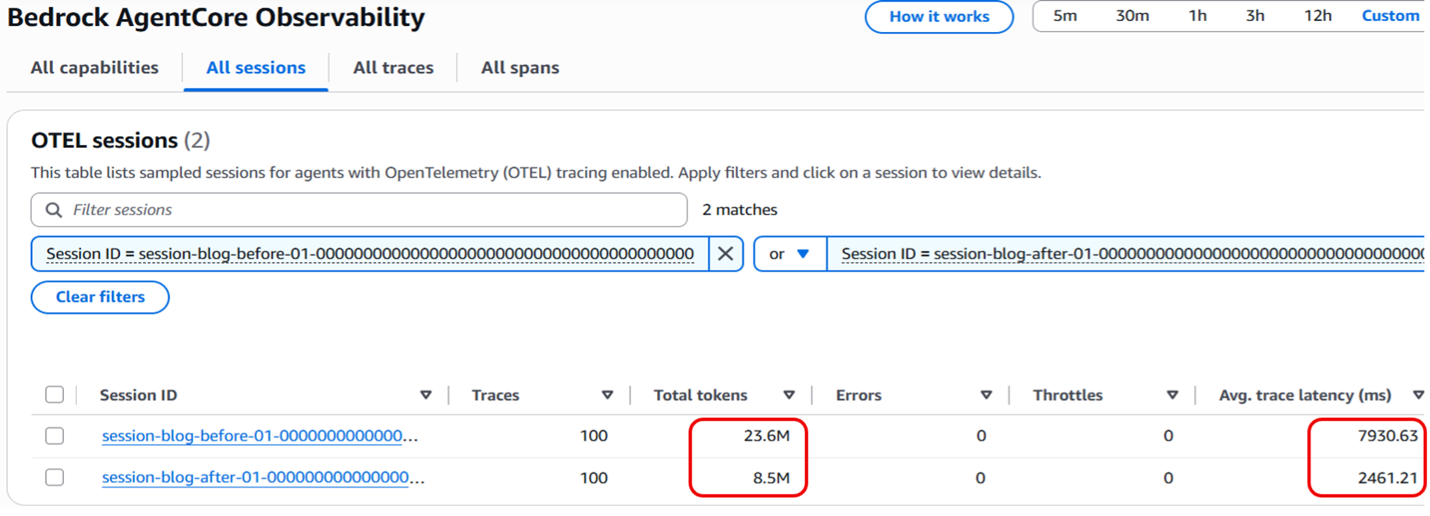
圖 5:100 條樣本問題的 OTEL 工作階段比較
在大型單輪資料負載中,成效最為顯著。表 1 列出負載最重的單一查詢(列出所有驗證類別中有效的機組人員)對每一輪的影響。
| 指標 | 之前 | 之後 | 減幅 |
| 輸入 token | ~32,000 | ~8,000 | 75% |
| 輸出 token | ~2,800 | 477 | 83% |
| 每輪延遲 | ~165 s | 9.9 s | 94% |
表 1:對輸入、輸出和延遲的影響
圖 6 和圖 7 顯示優化前後相應的追蹤詳細資料。
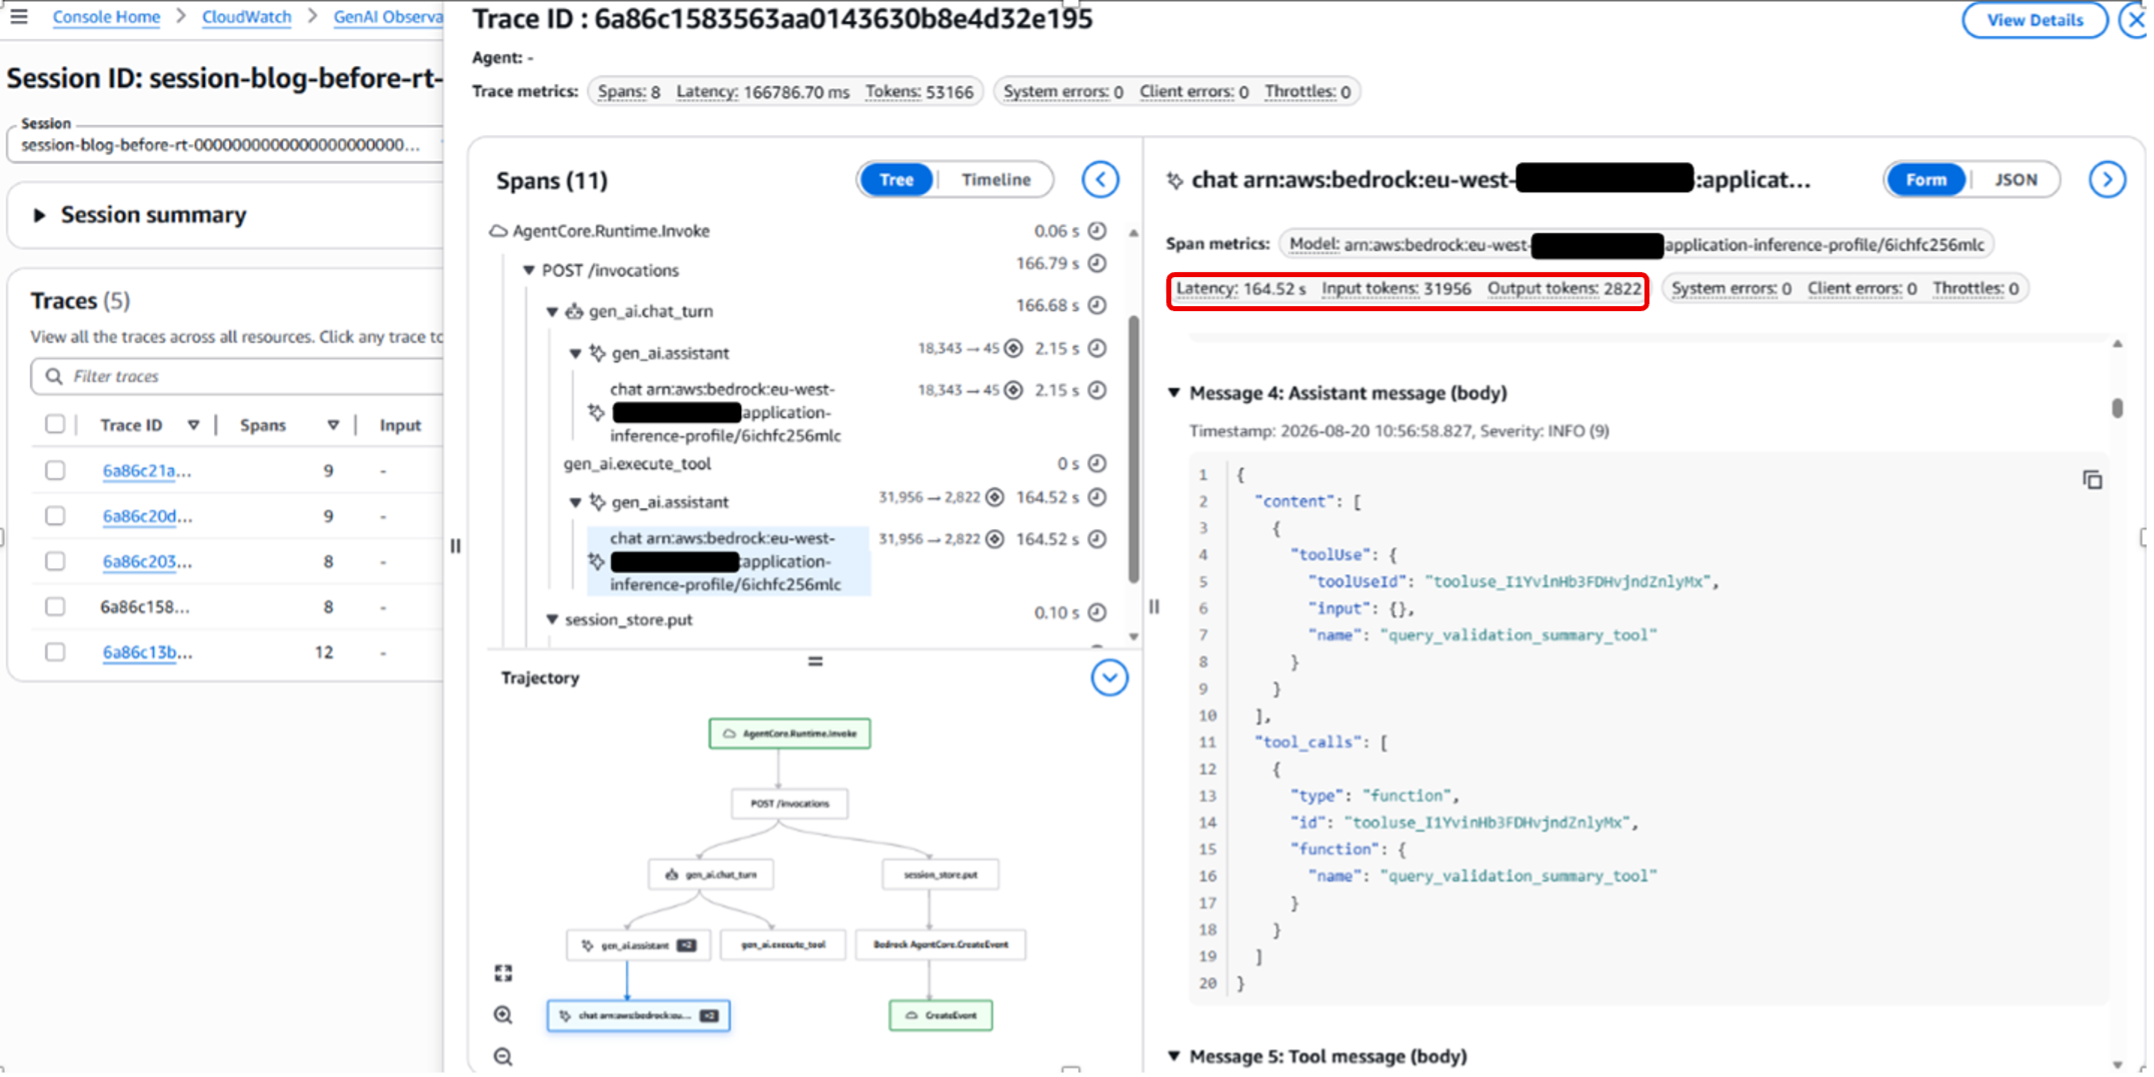
圖 6:優化前的追蹤詳細資料
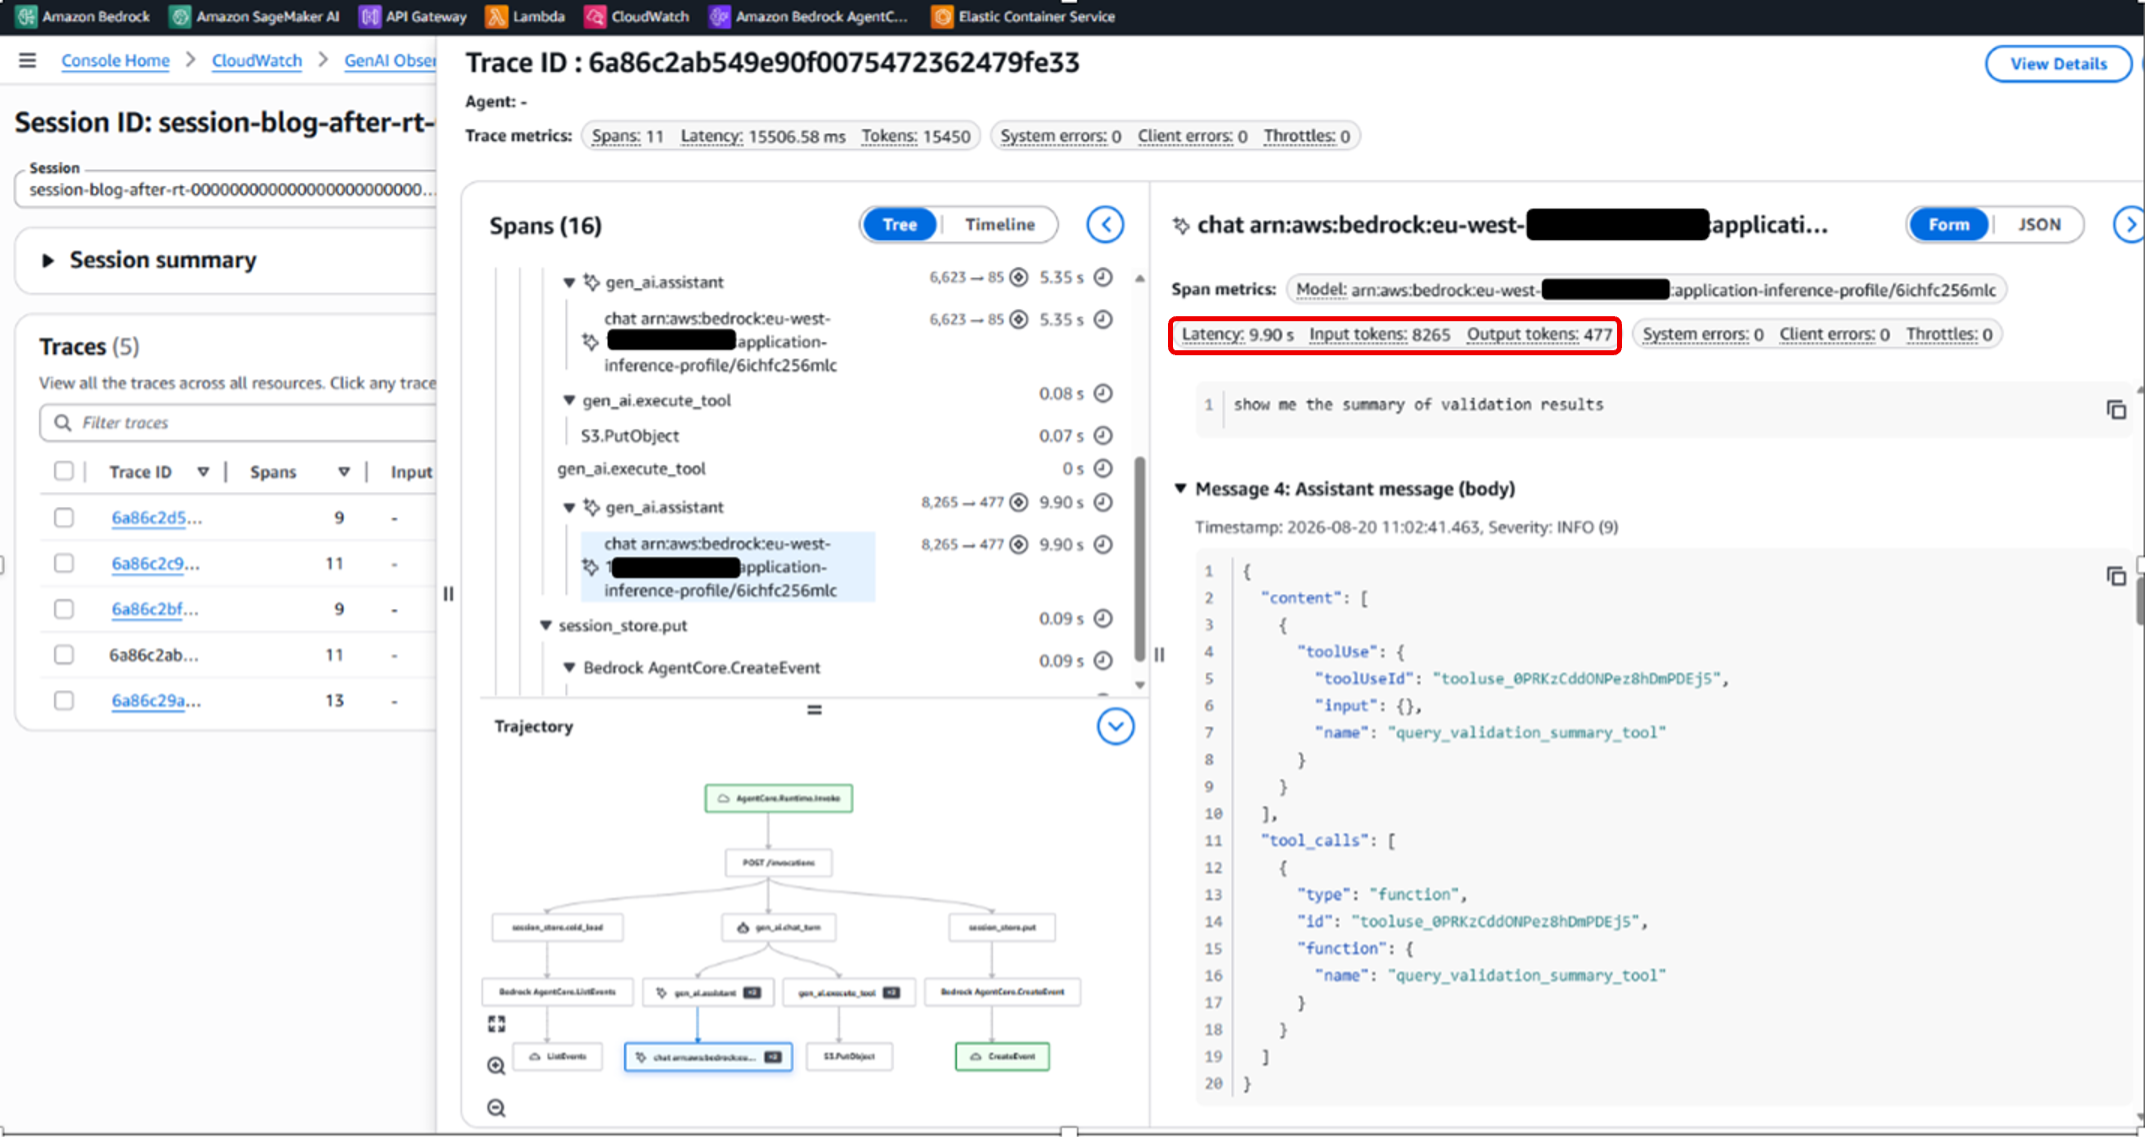
圖 7:優化後的追蹤詳細資料
這些改善主要來自避免在每一輪都將完整資料負載注入模型上下文。現在,模型會先接收精簡摘要,只有在需要時才擷取更多詳細資料。
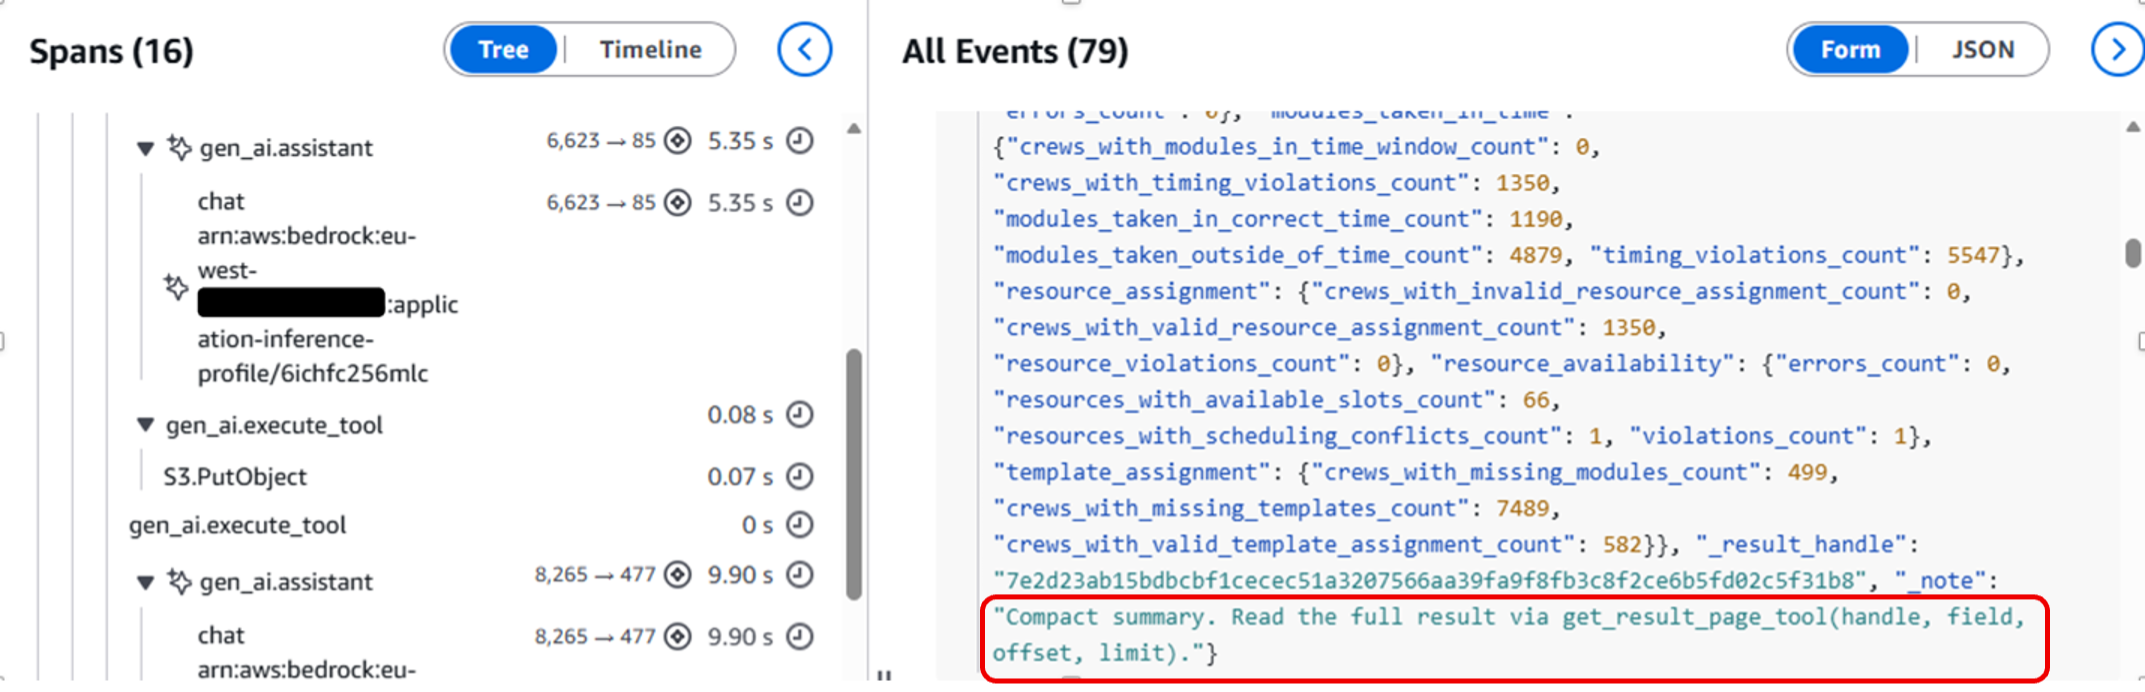
圖 8:精簡摘要事件
追蹤時間軸亦顯示出改善:優化前的一輪對話接近 2 分鐘 46 秒,優化後則約 15 秒便完成(圖 9)。
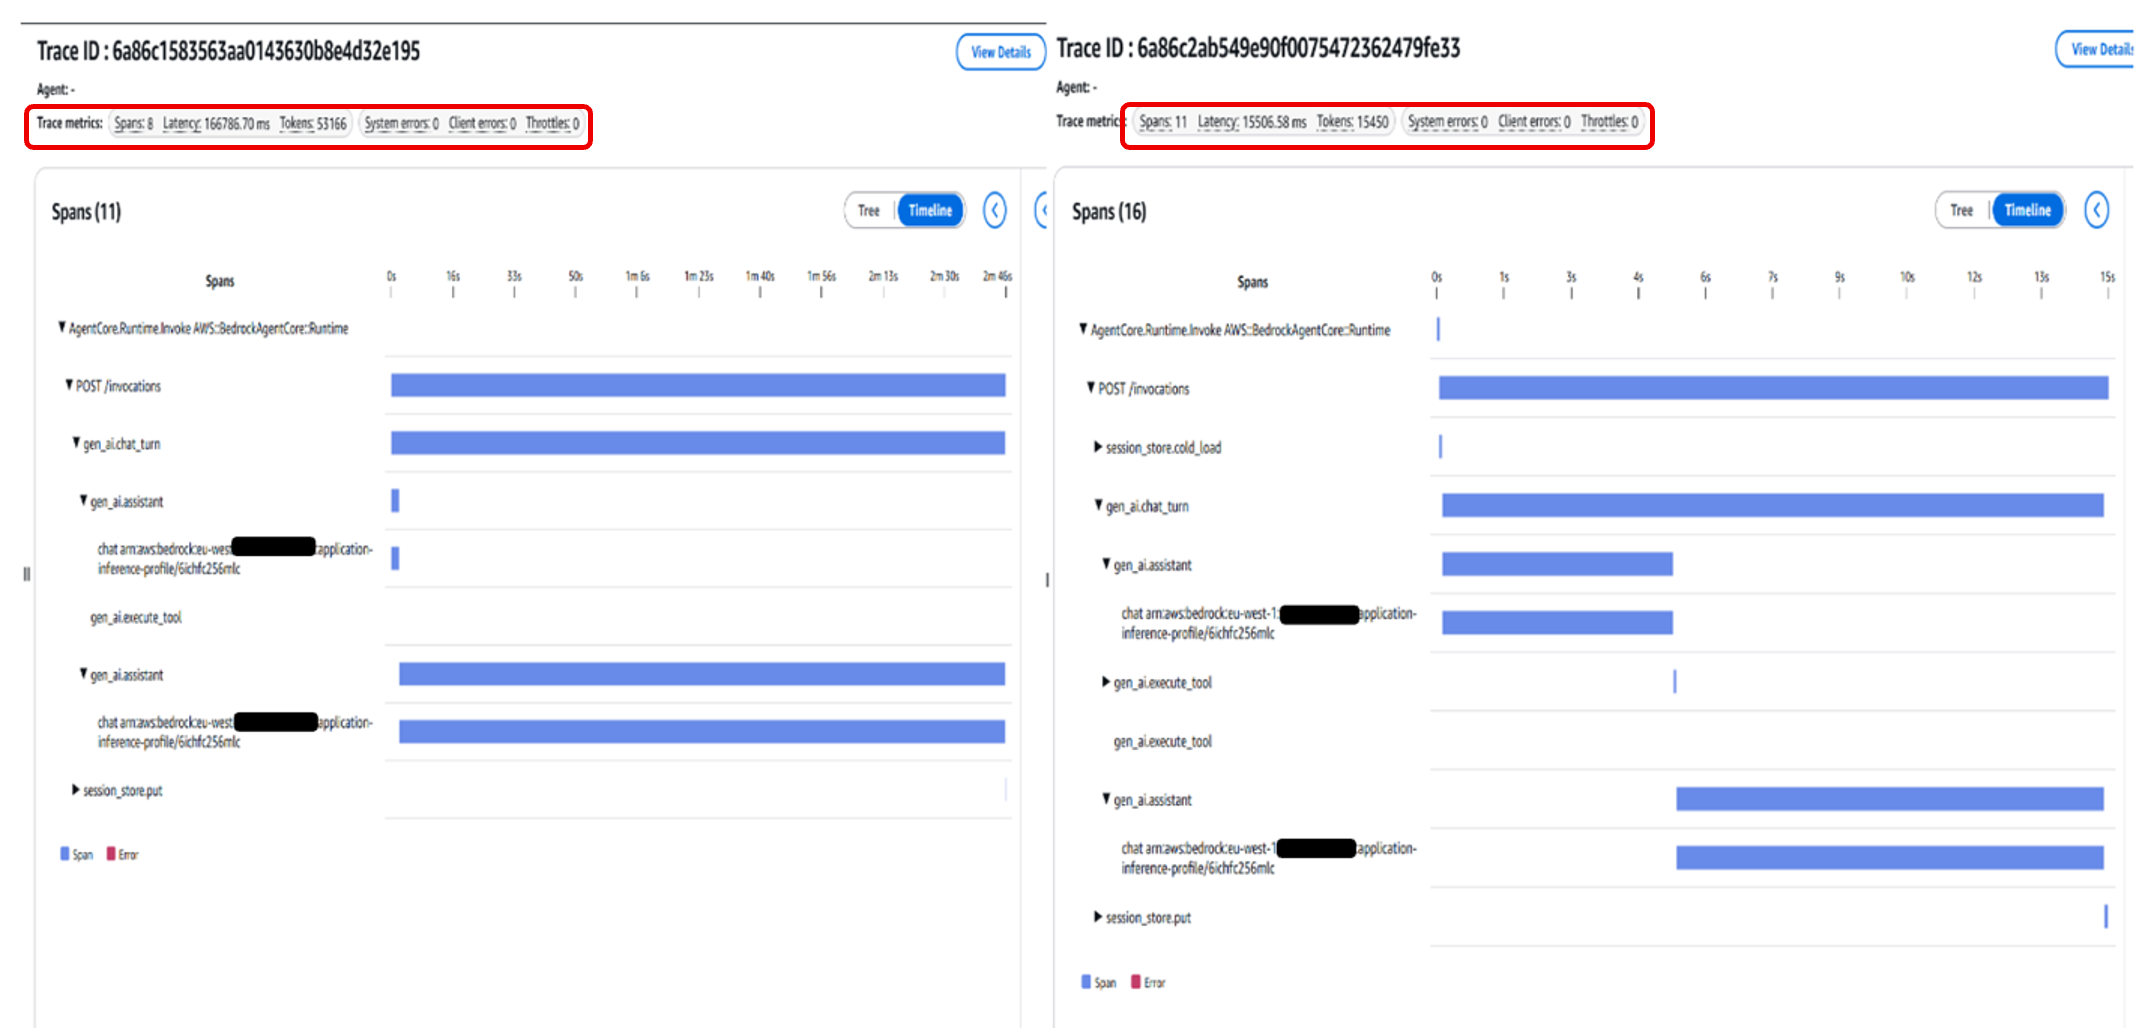
圖 9:優化前後的時間軸
這些改動亦改善了較長對話中的表現。上下文在各輪對話中的增長變得更可預測,即使用戶就大型數據集提出後續問題,Agent 仍能保持回應。在實際使用中,系統由 token 成本不斷累積,轉為更受控、按需求存取的模式。
最重要的是,這些改善並未犧牲功能。完整資料負載仍保存在成品儲存區,需要深入檢視時,可隨時透過控制代碼擷取。在 Flightscape,這種模式為將對話式 AI 功能引入複雜的航空公司營運工作流程奠定基礎,讓底層 AI 體驗具備擴展能力並兼顧成本效益。
清理
為避免持續產生費用,請刪除為本操作示範建立的資源:
- 清空用作成品儲存區的 S3 儲存貯體,並可選擇將其刪除;或者移除成品前綴下的所有物件(例如 artifacts/)。
- 刪除測試期間建立的任何 Amazon Bedrock AgentCore Agent,以及相關的 AgentCore 記憶體工作階段。
- 移除為存取 S3 或 Bedrock 而建立的 AWS Identity and Access Management (IAM) 角色和政策。
- 刪除代理程式執行環境產生的 Amazon CloudWatch 日誌羣組。
- 移除為本教學配置的任何 Amazon Virtual Private Cloud (Amazon VPC) 端點或網絡資源。
結論
如果你的 Amazon Bedrock AgentCore 代理程式會處理大型 JSON 資料,請先找出哪些工具輸出佔用最多上下文視窗。先將產物卸載至 S3(策略 1),因為這為其他最佳化措施奠定基礎;然後按需要加入分頁(策略 2)和精簡(策略 3),以改善代理程式的 token 用量及延遲。若要開始使用,請複製 GitHub 存放庫,並根據自己的代理程式調整這些策略。若要進一步瞭解如何使用 AgentCore 和 LangGraph 建立代理程式,請參閲 Amazon Bedrock AgentCore 文件和 LangGraph 框架文件。
作者簡介

Pallav Gupta
Pallav 是 Flightscape 的軟件工程經理,負責領導 Flightscape AI Labs (FLAI)。該團隊專注於在 Flightscape 的各項解決方案中落實 AI 功能。Pallav 在軟件領域擁有近二十年經驗,曾任首席軟件架構師,負責在 AWS 上建構可擴展且具成本效益的系統。他目前專注於適用於正式環境的 AI 代理程式,尤其重視可擴展性、成本效益和可靠性。他持有 AWS 和 Google Cloud 架構師認證。

Pascal Acquaah
Pascal 是 AWS 的高級解決方案架構師,協助企業客戶透過在 AWS 上建構及現代化架構,實現業務目標。他倡導建立穩固的數據基礎,以充分發揮 AI 的競爭優勢,並協助客戶制定及執行在 AWS 上的數據和 AI 策略。
來源:AWS Machine Learning Blog · aws.amazon.com