Hugging Face Transformers、Accelerate 與 bitsandbytes 的大規模 8-bit 矩陣乘法入門
A Gentle Introduction to 8-bit Matrix Multiplication for transformers at scale using transformers, accelerate and bitsandbytes
Hugging Face 將 LLM.int8() 整合至 Transformers 與 Accelerate,透過混合 INT8/FP16 矩陣乘法降低大型語言模型推理所需的記憶體。
文章串連 LLM.int8() 的離羣特徵處理、效能比較與 Transformers 整合細節,呈現 8-bit 量化降低大型模型記憶體需求的實作脈絡。
簡介
語言模型的規模不斷增大。本文撰寫時,PaLM 有 540B 個參數,OPT、GPT-3 和 BLOOM 約有 176B 個參數,而模型規模仍在持續擴大。下圖展示近期部分語言模型的規模。
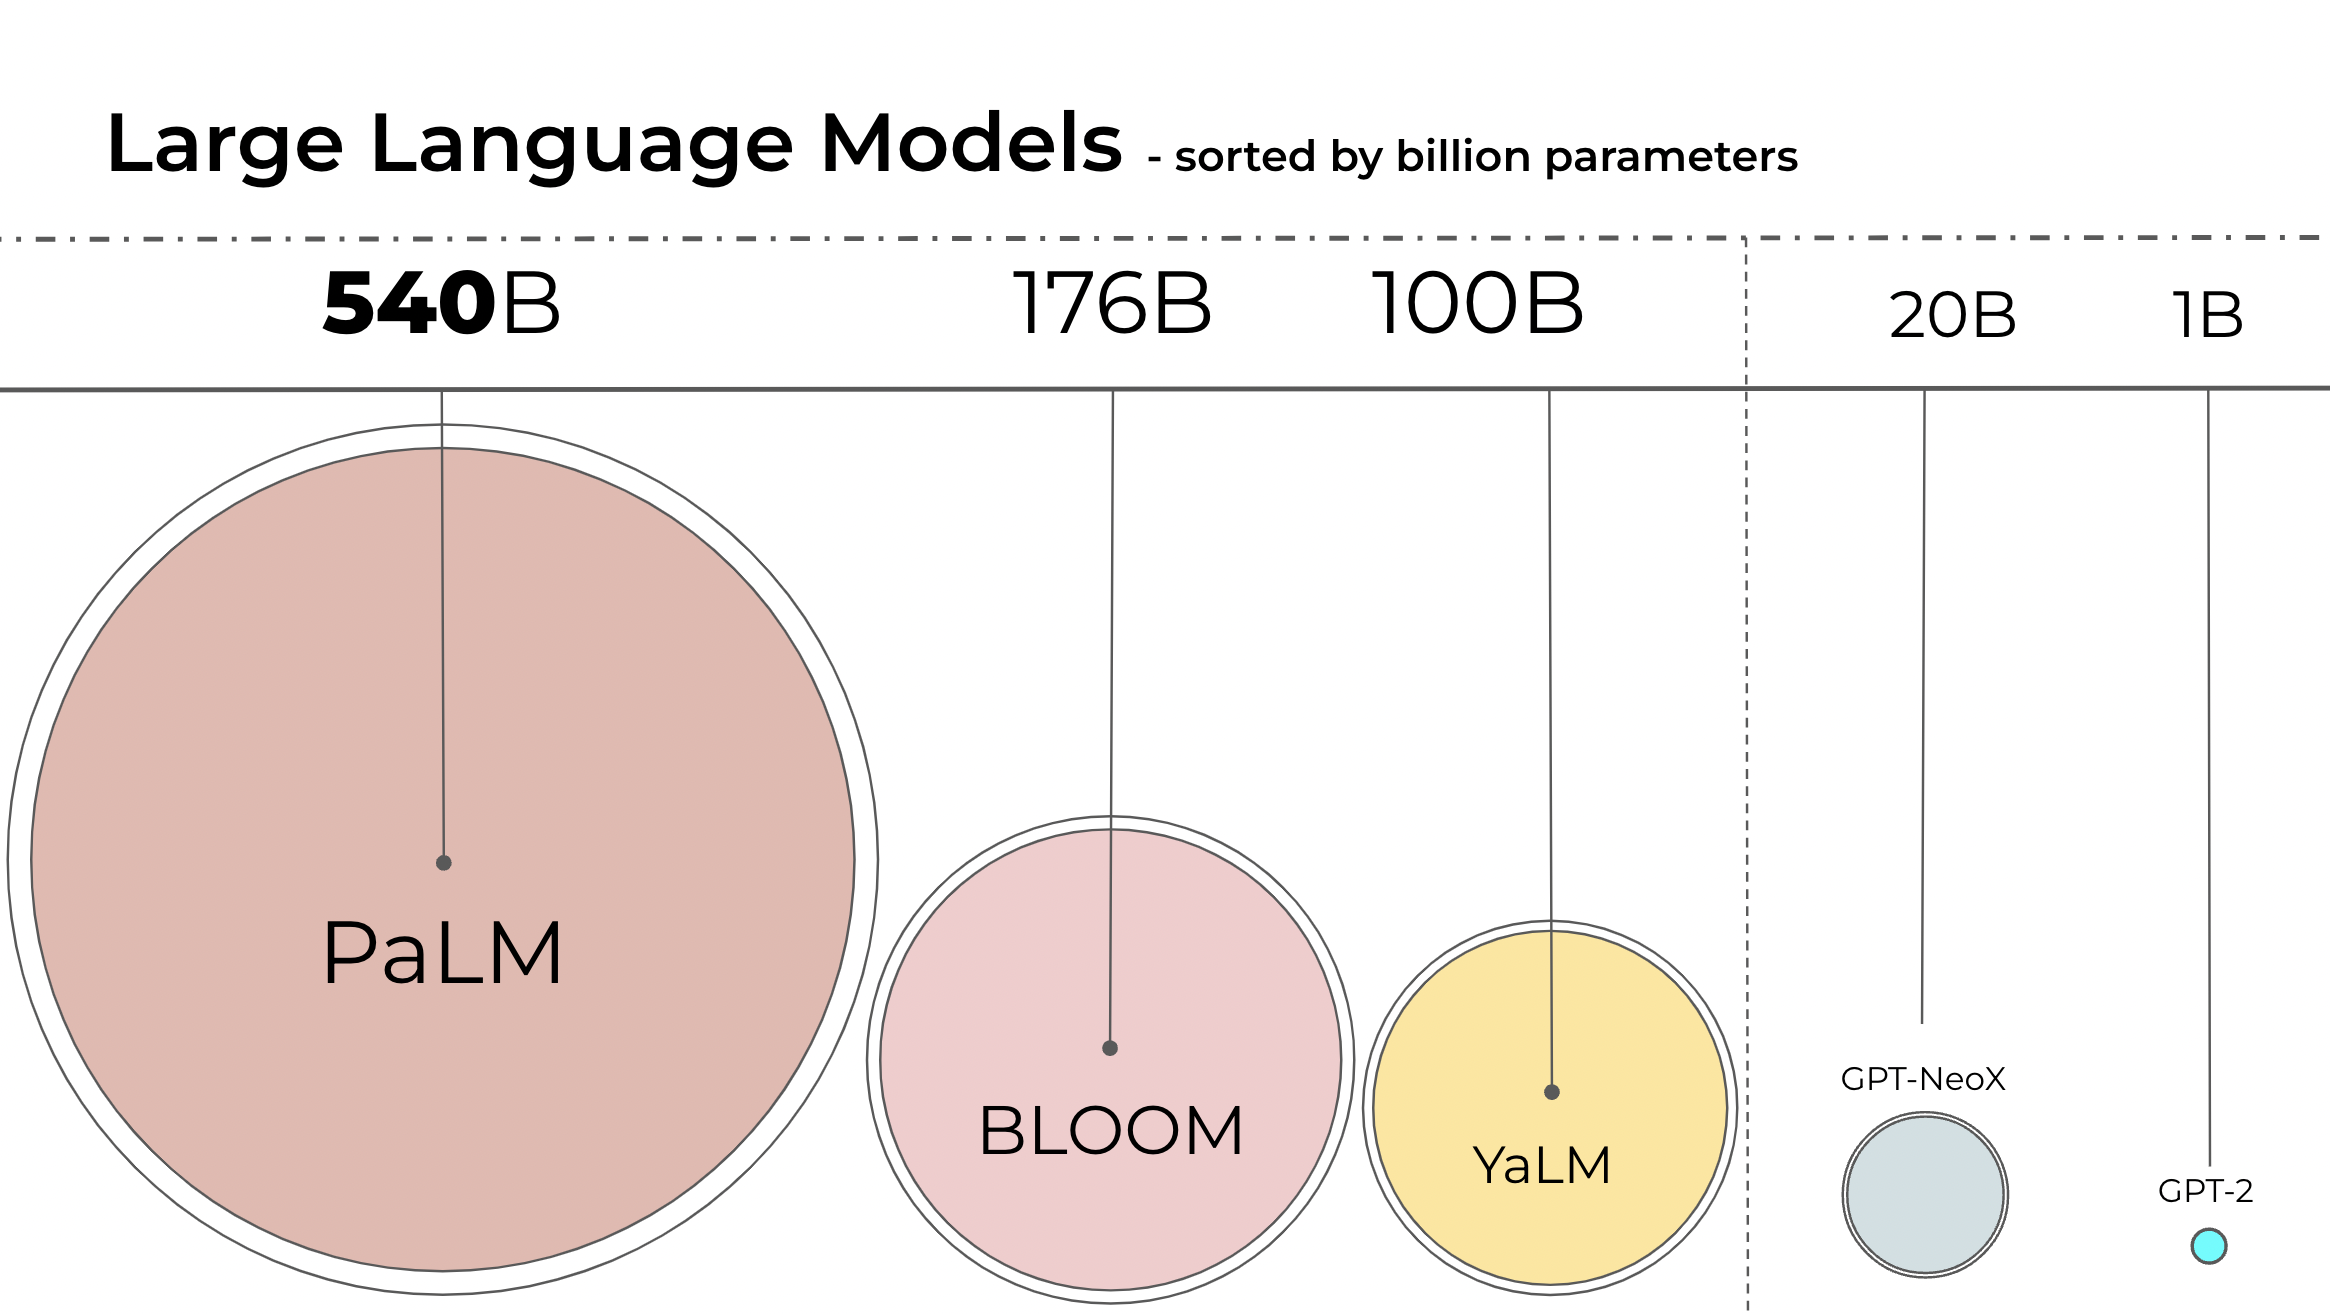
因此,這些模型難以在容易取得的裝置上運行。例如,單是對 BLOOM-176B 進行推理,就需要 8 張 80GB A100 GPU(每張約 15,000 美元)。如要微調 BLOOM-176B,則需要 72 張這類 GPU!PaLM 等更大型模型所需資源更高。
由於運行這些超大型模型需要大量 GPU,我們必須設法降低所需資源,同時保留模型效能。為縮小模型而開發了各種技術,你可能聽過量化和蒸餾,此外還有許多其他方法。
在完成 BLOOM-176B 訓練後,Hugging Face 和 BigScience 團隊開始尋找讓這個大型模型更容易在較少 GPU 上運行的方法。透過 BigScience 社羣,我們得知有關 Int8 推理的研究:它不會降低大型模型的預測效能,並可將大型模型的記憶體佔用縮至原本的 1/2(2 倍縮減)。我們很快便開始合作研究,最終將技術全面整合至 Hugging Face transformers。本文將介紹已整合至所有 Hugging Face 模型的 LLM.int8(),詳情見下文。如想進一步瞭解研究,可閲讀我們的論文 LLM.int8():大規模 Transformers 的 8-bit 矩陣乘法。
本文會概述這項量化技術,説明將其整合至 transformers 程式庫時遇到的困難,並列出這項合作的長期目標。
本文會説明大型模型為何會佔用如此多記憶體,以及 BLOOM 為何有 350GB。讓我們先逐步瞭解幾個基本概念。
機器學習常用數據類型
首先了解不同的浮點數數據類型;在機器學習語境中,這些類型亦稱為「精度」。
模型大小取決於參數數量及其精度,通常採用 float32、float16 或 bfloat16(下圖取自:https://blogs.nvidia.com/blog/2020/05/14/tensorfloat-32-precision-format/)。
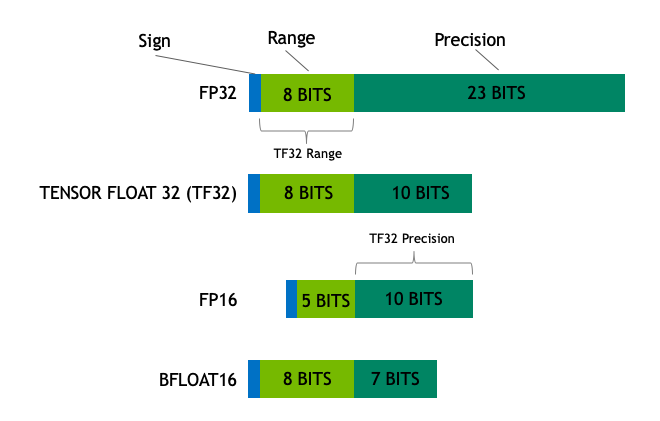
Float32(FP32)是標準化的 IEEE 32-bit 浮點數表示法。這種數據類型可以表示很廣的數值範圍。FP32 中有 8 bits 用於「指數」、23 bits 用於「尾數」,另有 1 bit 表示數值正負號。此外,大部分硬件都支援 FP32 運算及指令。
在 float16(FP16)數據類型中,5 bits 用於指數,10 bits 用於尾數。因此,FP16 可表示的數值範圍遠小於 FP32,容易出現上溢(嘗試表示過大的數值)或下溢(表示過小的數值)。
例如,計算 10k * 10k 會得到 100M,但 FP16 無法表示這個值,因為可表示的最大數值是 64k。結果便會變成 NaN(非數值);如果神經網絡等系統採用連續計算,先前所有運算成果都會失效。
一般會使用損失縮放解決此問題,但並非總是有效。
為避免這些限制,研究人員建立了新格式 bfloat16(BF16)。BF16 中有 8 bits 用於指數(與 FP32 相同),7 bits 用於小數部分。
這表示 BF16 保留了與 FP32 相同的動態範圍,但與 FP16 相比會失去 3 bits 精度。因此,超大數值不再構成問題,但精度會比 FP16 差。
NVIDIA 亦在 Ampere 架構中引入 TensorFloat-32(TF32)精度格式,結合 BF16 的動態範圍和 FP16 的精度,只使用 19 bits。目前它只在特定運算中於內部使用。
在機器學習術語中,FP32 稱為全精度(4 bytes),BF16 和 FP16 則稱為半精度(2 bytes)。 此外,int8(INT8)是一種 8-bit 數據類型,可儲存 2^8 個不同數值(有符號整數範圍為 [-128, 127],無符號則為 [0, 255])。
理想情況下,訓練和推理都應使用 FP32,但其速度比 FP16/BF16 慢兩倍。因此我們會採用混合精度方法:將權重以 FP32 儲存為精確的「主權重」參考值,而前向和反向傳播則以 FP16/BF16 計算,以提升訓練速度。接着使用 FP16/BF16 梯度更新 FP32 主權重。
訓練期間,主權重一律以 FP32 儲存;不過實際上,半精度權重在推理時通常可達到與 FP32 權重相近的品質。只有在模型接收多次梯度更新時,才需要精確的參考值。這表示我們可以使用半精度權重,只用一半 GPU 就達到相同結果。
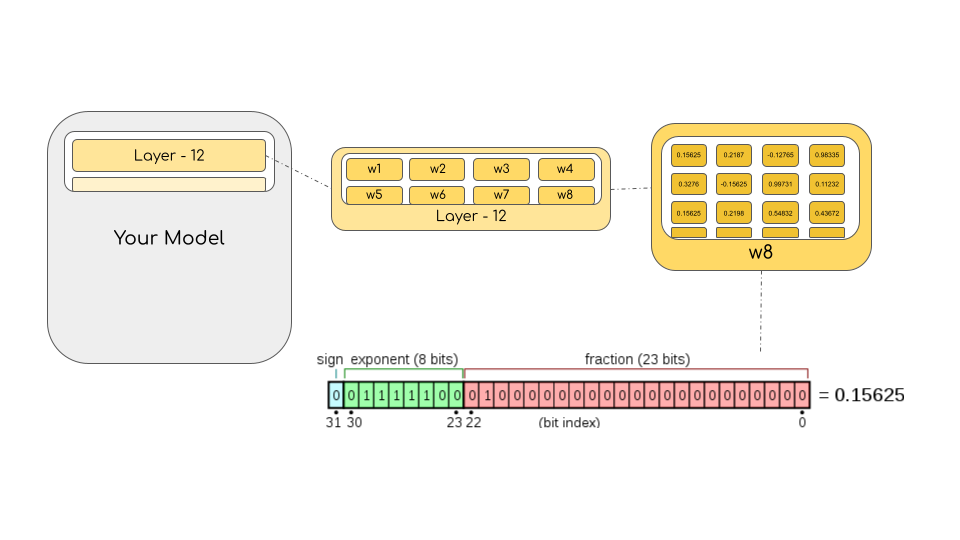
模型大小(bytes)等於參數數量乘以所選精度的每個參數大小。例如,若使用 BLOOM-176B 模型的 bfloat16 版本,便是 176*10**9 x 2 bytes = 352GB!如前所述,要將它放進少數幾張 GPU 並不容易。
但如果改用另一種數據類型,以更少記憶體儲存權重呢?深度學習已廣泛使用一種稱為量化的方法。
模型量化簡介
我們透過實驗發現,相較於 4-byte FP32 精度,改用 2-byte BF16/FP16 半精度,推理結果幾乎相同,模型大小亦可減半。若能再進一步壓縮固然理想,但降低精度後,推理品質便會大幅下降。
為解決這個問題,我們採用 8-bit 量化。它只需原模型大小的 1/4,相當於將精度降至四分之一!不過,做法並非單純再丟棄一半 bits。
量化基本上是將一種數據類型「四捨五入」轉換為另一種。例如,一種數據類型範圍是 0..9,另一種是 0..4,那麼第一種數據類型中的「4」會在第二種數據類型中四捨五入為「2」。如果第一種數據類型中的值是「3」,它介乎第二種數據類型的 1 和 2 之間,通常也會四捨五入為「2」。因此,第一種數據類型中的「4」和「3」在第二種數據類型中都會變成「2」。這説明量化過程會引入雜訊並造成資訊損失,類似有損壓縮。
兩種最常見的 8-bit 量化技術是零點量化及絕對最大值(absmax)量化。兩者都會把浮點數值映射至更精簡的 int8(1 byte)數值。首先,這些方法會以量化常數縮放輸入,進行正規化。
例如,在零點量化中,若數值範圍是 -1.0…1.0,而目標範圍是 -127…127,便要乘以 127,再四捨五入至 8-bit 精度。要還原原值,則需將 int8 數值除以相同的量化係數 127。例如,0.3 會縮放為 0.3*127 = 38.1,四捨五入後得到 38。反向還原可得 38/127=0.2992;此例中的量化誤差為 0.008。這些看似微小的誤差會逐漸累積,並隨模型層傳播而擴大,最終降低效能。
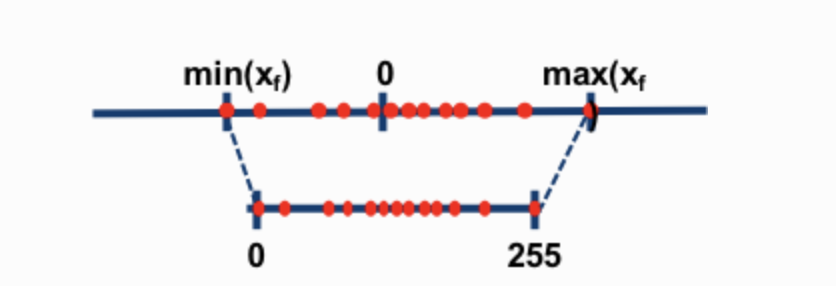
(圖片取自:這篇網誌文章)
現在仔細看看 absmax 量化。要計算 fp16 數值在 absmax 量化中對應的 int8 數值,必須先除以張量的絕對最大值,再乘以數據類型的總範圍。
例如,假設要對向量 [1.2, -0.5, -4.3, 1.2, -3.1, 0.8, 2.4, 5.4] 進行 absmax 量化。先找出其中的絕對最大值,本例為 5.4。Int8 範圍是 [-127, 127],因此用 127 除以 5.4,得到 23.5 的縮放係數。再將原向量乘以此係數,便得到量化向量 [28, -12, -101, 28, -73, 19, 56, 127]。
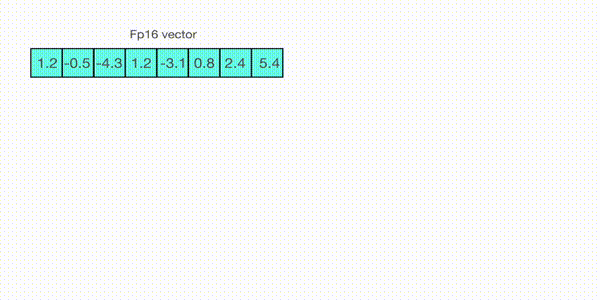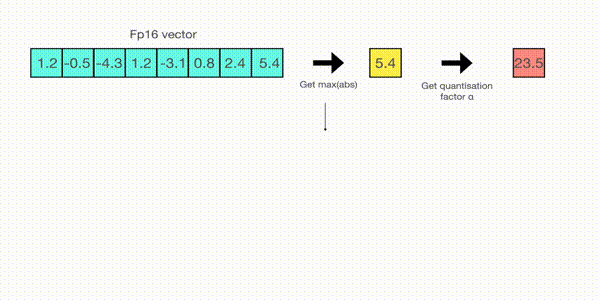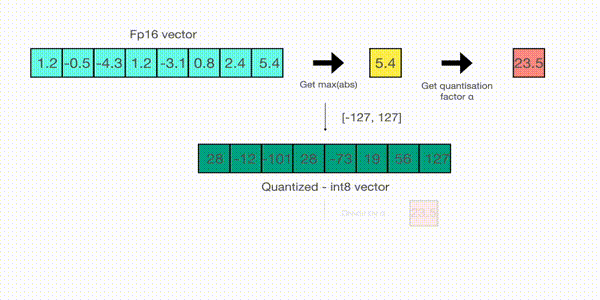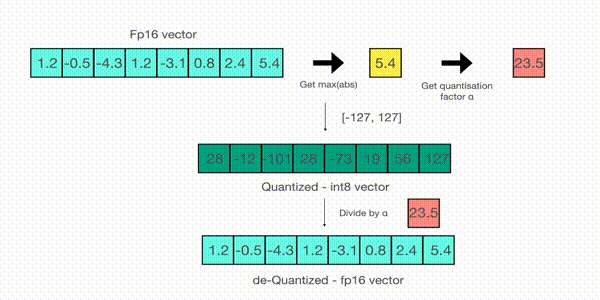
要還原數值,只需用完整精度將 int8 數值除以量化係數;不過,由於以上結果經過「四捨五入」,部分精度會流失。
對於無符號 int8,我們會先減去最小值,再按絕對最大值縮放。這與零點量化相近,也類似 min-max 縮放;但 min-max 縮放會維持數值尺度,令「0」總是以不產生量化誤差的整數表示。
為取得更準確結果,矩陣乘法可組合使用多種技巧,例如逐列或逐向量量化。考慮矩陣乘法 A*B=C,傳統量化會按每個張量的絕對最大值進行正規化;逐向量量化則分別找出 A 每一列及 B 每一欄的絕對最大值,再以這些向量除算 A 和 B,進行正規化。接着計算 A*B 得到 C。最後,為還原 FP16 數值,會計算 A、B 絕對最大值向量的外積,進行反正規化。詳情請參閲 LLM.int8() 論文或 Tim 網誌上的量化與湧現特徵文章。
雖然這些基本技術可用於量化深度學習模型,但通常會降低大型模型的準確度。我們整合至 Hugging Face Transformers 和 Accelerate 程式庫的 LLM.int8() 實作,是首個即使面對 BLOOM 等具有 176B 參數的大型模型,也不會降低效能的技術。
淺談 LLM.int8():大型語言模型的零效能損失矩陣乘法
在 LLM.int8() 中,我們證明要了解傳統量化為何不適用於大型模型,必須掌握 Transformers 隨規模而變的湧現特性。我們指出,效能下降是由離羣特徵所致,下一節會加以説明。LLM.int8() 演算法可概括如下。
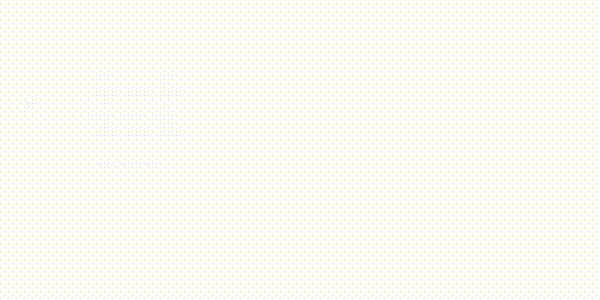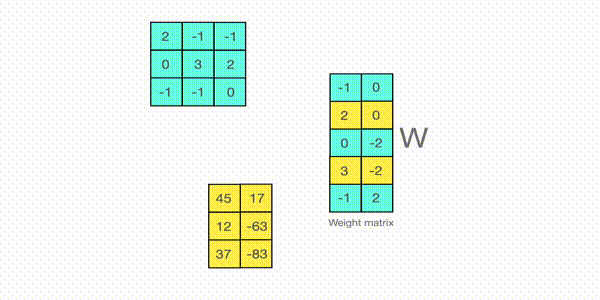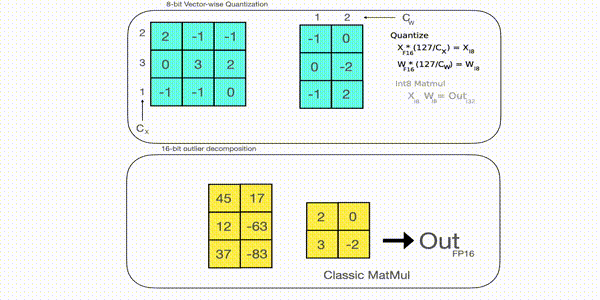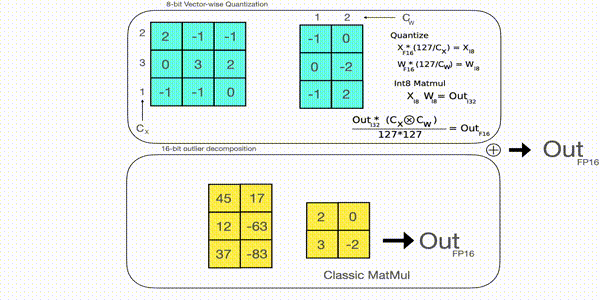
LLM.int8() 基本上分三個步驟完成矩陣乘法計算:
- 按欄從輸入隱藏狀態抽取離羣值(即超過特定閾值的數值)。
- 離羣值以 FP16 執行矩陣乘法,非離羣值則以 int8 執行。
- 對非離羣結果反量化,再將離羣與非離羣結果相加,以取得完整 FP16 結果。
以下動畫概述這些步驟:
離羣特徵的重要性
一般而言,若某數值超出整體數據分佈範圍,便稱為離羣值。離羣值偵測已在現有文獻中廣泛研究;事先了解特徵分佈有助於偵測離羣值。更具體而言,我們觀察到,對參數量超過 6B 的 Transformer 模型而言,大規模使用傳統量化會失效。較小模型亦有大型離羣特徵,但我們觀察到達到某個閾值後,這些離羣值會在各個 Transformer 層中呈現高度系統化的模式。詳情請參閲 LLM.int8() 論文及湧現特徵網誌文章。
如前所述,8-bit 精度限制極大,因此量化含有多個大數值的向量可能產生嚴重錯誤。此外,由於 Transformer 架構的內在特性會將所有元素連繫起來,這些錯誤會在多個層之間傳播並累積。因此,我們開發了混合精度分解方法,以便在存在極端離羣值時仍可高效量化。下一節會介紹此方法。
深入矩陣乘法
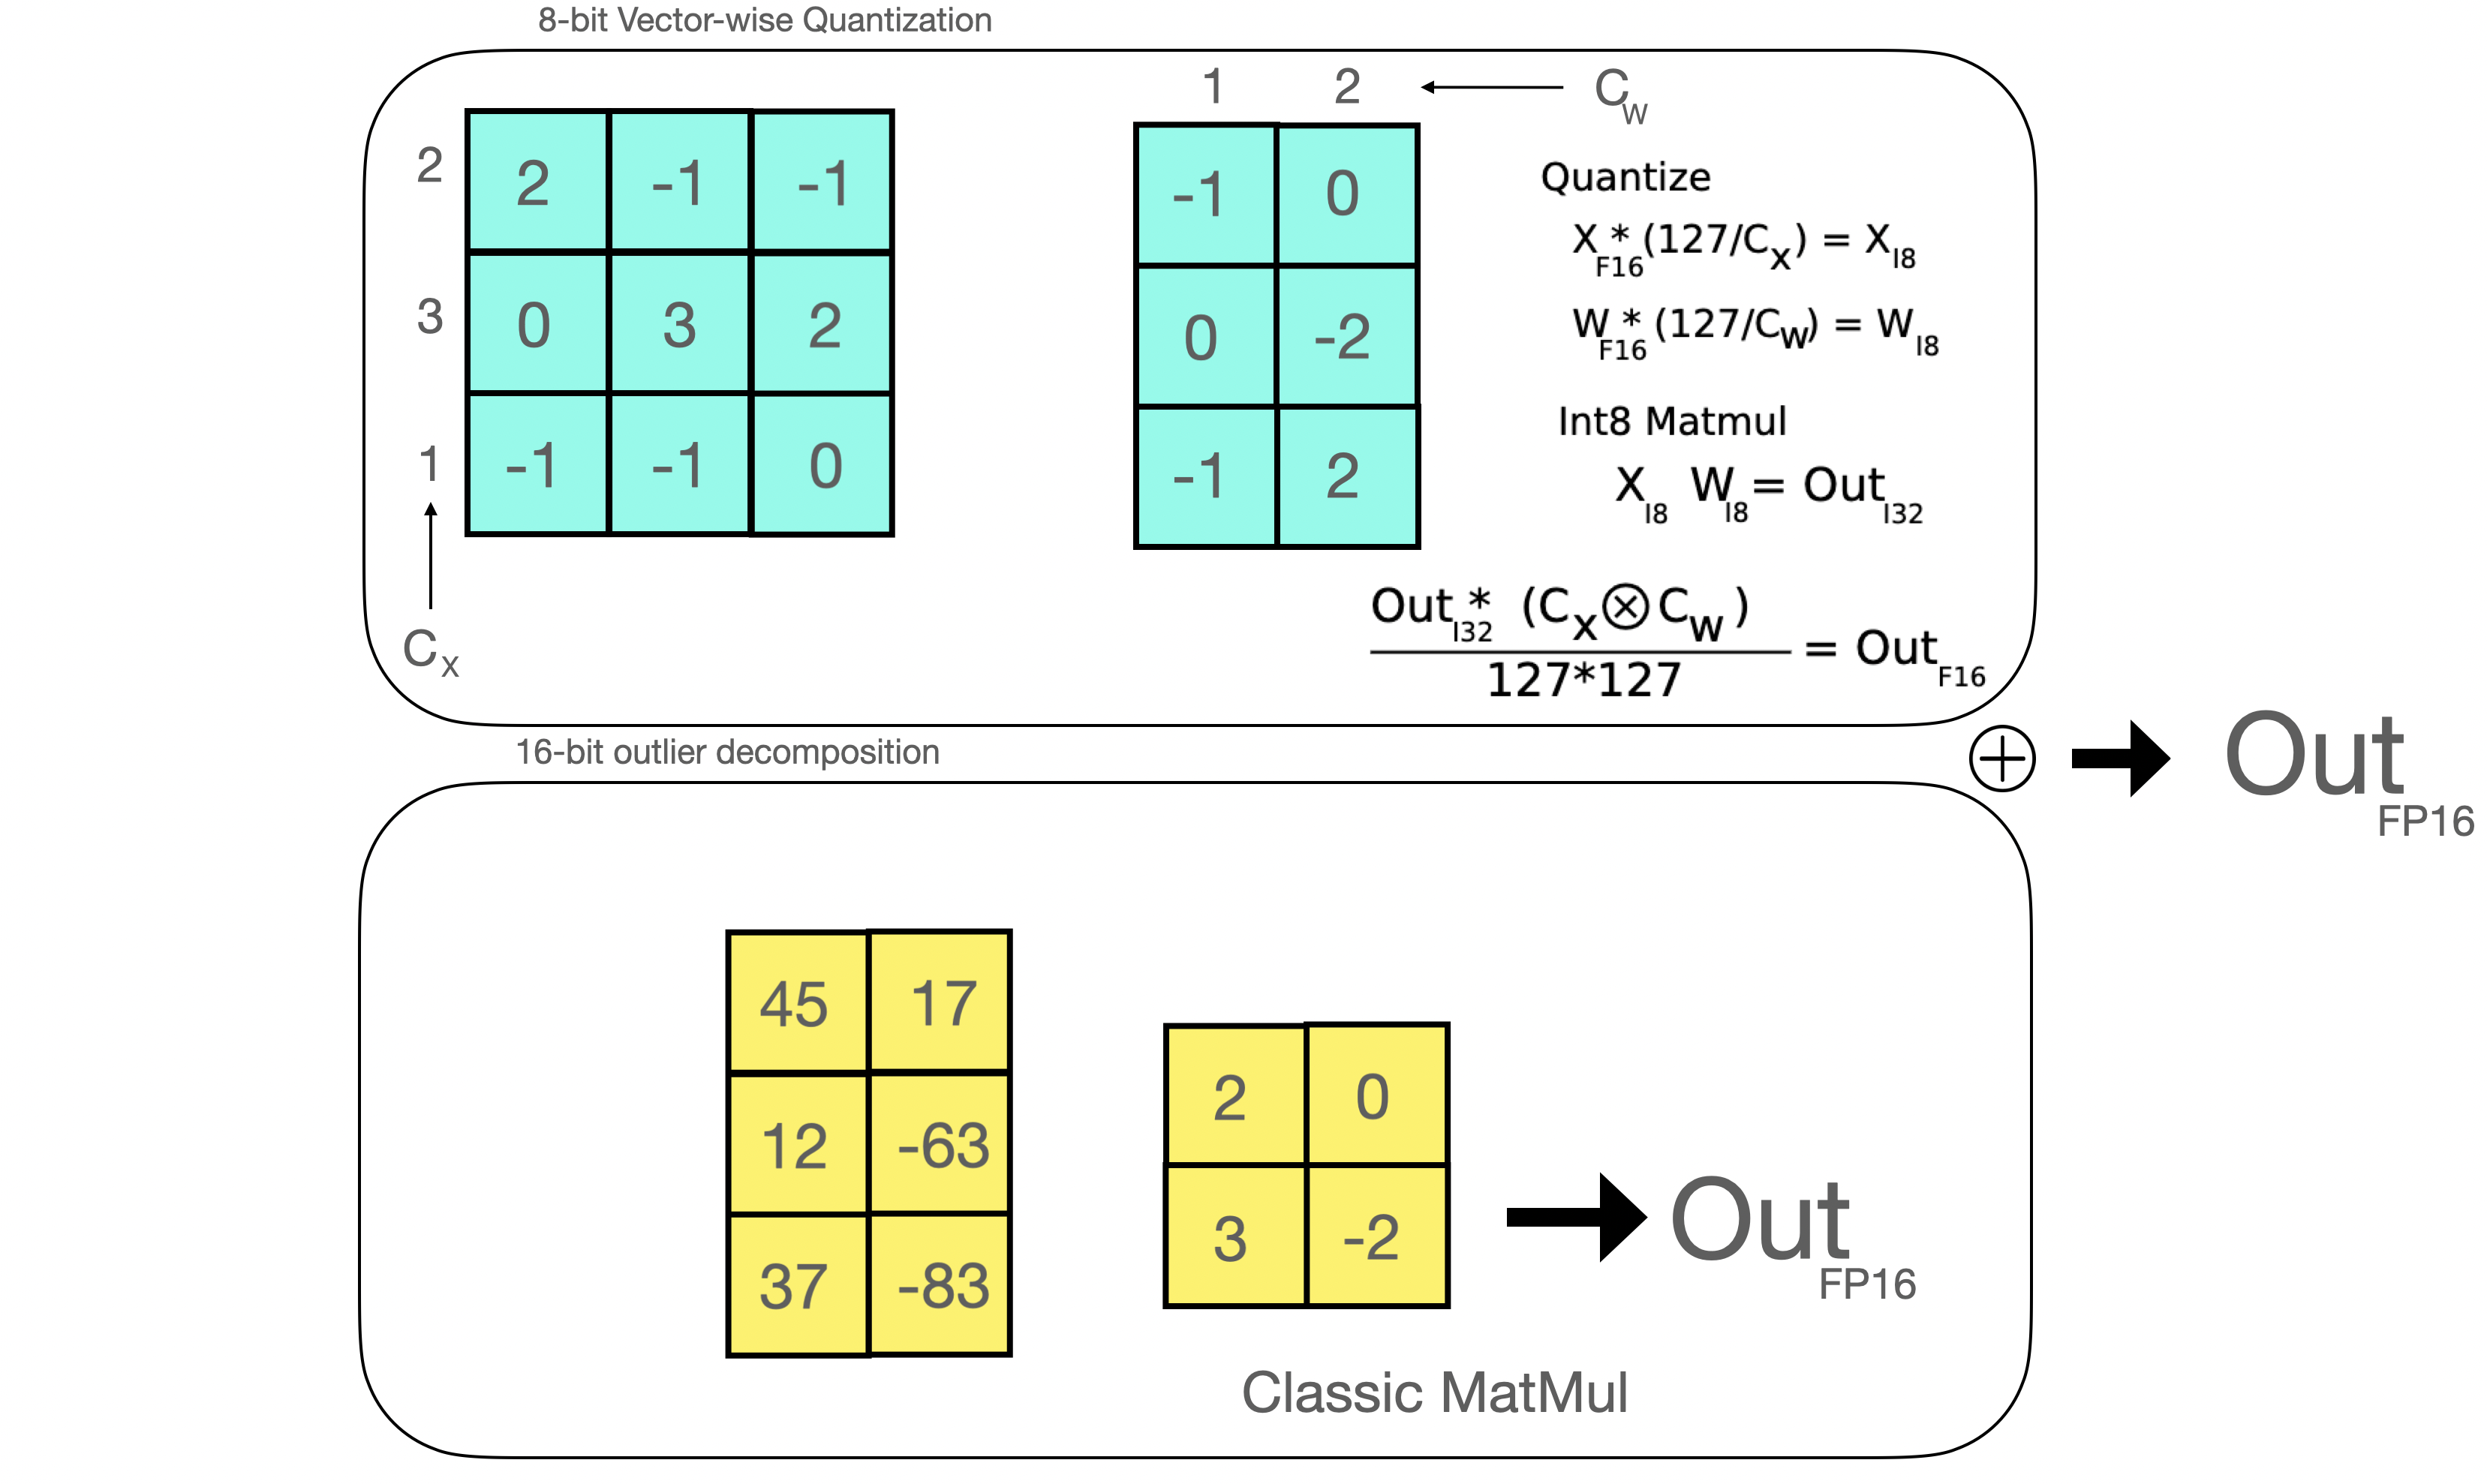
計算出隱藏狀態後,我們會使用自訂閾值抽取離羣值,並如上所述將矩陣分解成兩部分。我們發現,以此方法抽取所有幅度為 6 或以上的離羣值,即可恢復完整推理效能。離羣部分使用 fp16 執行傳統矩陣乘法;8-bit 矩陣乘法則使用逐向量量化,將權重和隱藏狀態量化為 8-bit 精度:隱藏狀態逐列量化,權重矩陣則逐欄量化。 完成這一步後,結果會反量化並以半精度傳回,以便與第一次矩陣乘法的結果相加。
「0 效能損失」是甚麼意思?
如何妥善評估這種方法造成的效能下降?使用 8-bit 模型會令生成品質損失多少?
我們使用 lm-eval-harness,對 8-bit 模型和原生精度模型執行多個常見基準測試,並列出結果。
OPT-175B:
| 基準測試 | - | - | - | - | 差異-數值 |
|---|---|---|---|---|---|
| 名稱 | 指標 | 數值-int8 | 數值-fp16 | 標準誤-fp16 | - |
| hellaswag | acc_norm | 0.7849 | 0.7849 | 0.0041 | 0 |
| hellaswag | acc | 0.5921 | 0.5931 | 0.0049 | 0.001 |
| piqa | acc | 0.7965 | 0.7959 | 0.0094 | 0.0006 |
| piqa | acc_norm | 0.8101 | 0.8107 | 0.0091 | 0.0006 |
| lambada | ppl | 3.0142 | 3.0152 | 0.0552 | 0.001 |
| lambada | acc | 0.7464 | 0.7466 | 0.0061 | 0.0002 |
| winogrande | acc | 0.7174 | 0.7245 | 0.0125 | 0.0071 |
BLOOM-176:
| 基準測試 | - | - | - | - | 差異-數值 |
|---|---|---|---|---|---|
| 名稱 | 指標 | 數值-int8 | 數值-bf16 | 標準誤-bf16 | - |
| hellaswag | acc_norm | 0.7274 | 0.7303 | 0.0044 | 0.0029 |
| hellaswag | acc | 0.5563 | 0.5584 | 0.005 | 0.0021 |
| piqa | acc | 0.7835 | 0.7884 | 0.0095 | 0.0049 |
| piqa | acc_norm | 0.7922 | 0.7911 | 0.0095 | 0.0011 |
| lambada | ppl | 3.9191 | 3.931 | 0.0846 | 0.0119 |
| lambada | acc | 0.6808 | 0.6718 | 0.0065 | 0.009 |
| winogrande | acc | 0.7048 | 0.7048 | 0.0128 | 0 |
我們確實觀察到這些模型有 0 效能下降,因為所有指標的絕對差異均低於標準誤(BLOOM-int8 例外:它在 lambada 上略勝原生模型)。如需與最先進方法進行更詳細的效能評估,請參閲論文!
速度比原生模型快嗎?
LLM.int8() 的主要目的,是讓更多人能使用大型模型,同時避免效能下降;如果方法非常慢,用處便會較少。因此,我們測試了多個模型的生成速度。 我們發現,BLOOM-176B 使用 LLM.int8() 時,比 fp16 版本慢約 15% 至 23%,仍可接受。較小模型(例如 T5-3B 和 T5-11B)的速度下降更明顯。我們努力加快這些小型模型;不到一天,便將 T5-3B 每個 token 的推理時間由 312 ms 降至 173 ms,T5-11B 則由 45 ms 降至 25 ms。此外,相關問題早已識別;在未來版本中,LLM.int8() 很可能會令小型模型進一步加速。目前數據如下表所示。
| 精度 | 參數數量 | 硬件 | 批次大小為 1 時每個 token 的時間(毫秒) | 批次大小為 8 時每個 token 的時間(毫秒) | 批次大小為 32 時每個 token 的時間(毫秒) |
|---|---|---|---|---|---|
| bf16 | 176B | 8xA100 80GB | 239 | 32 | 9.9 |
| int8 | 176B | 4xA100 80GB | 282 | 37.5 | 10.2 |
| bf16 | 176B | 14xA100 40GB | 285 | 36.5 | 10.4 |
| int8 | 176B | 5xA100 40GB | 367 | 46.4 | 記憶體不足(OOM) |
| fp16 | 11B | 2xT4 15GB | 11.7 | 1.7 | 0.5 |
| int8 | 11B | 1xT4 15GB | 43.5 | 5.3 | 1.3 |
| fp32 | 3B | 2xT4 15GB | 45 | 7.2 | 3.1 |
| int8 | 3B | 1xT4 15GB | 312 | 39.1 | 10.2 |
這 3 個模型分別是 BLOOM-176B、T5-11B 和 T5-3B。
Hugging Face transformers 整合要點
接着討論 Hugging Face transformers 整合的細節。讓我們看看使用方法,以及設定時可能遇到的常見問題。
使用方法
負責實現本文所述功能的模組名為 Linear8bitLt,可輕鬆從 bitsandbytes 程式庫匯入。它衍生自標準 torch.nn Module,可透過下文程式碼輕鬆用於你的架構並部署。
以下逐步示範一個使用情境:假設你想透過 bitsandbytes 將小型模型轉換為 int8。
- 首先需要正確匯入以下項目!
import torch
import torch.nn as nn

import bitsandbytes as bnb
from bnb.nn import Linear8bitLt
- 接着可定義自己的模型。請注意,任何精度的檢查點或模型都可轉換為 8-bit(FP16、BF16 或 FP32),但目前模型輸入必須是 FP16,Int8 模組才能運作。因此,此處將模型視為 fp16 模型。
fp16_model = nn.Sequential(
    nn.Linear(64, 64),
    nn.Linear(64, 64)
)
- 假設你已使用喜愛的數據集和任務訓練模型!現在要儲存模型:
[... train the model ...]
torch.save(fp16_model.state_dict(), "model.pt")
- 現在
state_dict已儲存,接着定義 int8 模型:
int8_model = nn.Sequential(
    Linear8bitLt(64, 64, has_fp16_weights=False),
    Linear8bitLt(64, 64, has_fp16_weights=False)
)
此處務必加入 has_fp16_weights 旗標。預設值為 True,用於混合 Int8/FP16 精度訓練。不過,我們需要的是節省記憶體的推理,因此必須使用 has_fp16_weights=False。
- 現在載入 8-bit 模型!
int8_model.load_state_dict(torch.load("model.pt"))
int8_model = int8_model.to(0) # Quantization happens here
請注意,模型設置到 GPU 後,才會在第二行執行量化。如果先列印 int8_model[0].weight(即呼叫 .to 函式之前),結果如下:
int8_model[0].weight
Parameter containing:
tensor([[ 0.0031, -0.0438,  0.0494,  ..., -0.0046, -0.0410,  0.0436],
        [-0.1013,  0.0394,  0.0787,  ...,  0.0986,  0.0595,  0.0162],
        [-0.0859, -0.1227, -0.1209,  ...,  0.1158,  0.0186, -0.0530],
        ...,
        [ 0.0804,  0.0725,  0.0638,  ..., -0.0487, -0.0524, -0.1076],
        [-0.0200, -0.0406,  0.0663,  ...,  0.0123,  0.0551, -0.0121],
        [-0.0041,  0.0865, -0.0013,  ..., -0.0427, -0.0764,  0.1189]],
       dtype=torch.float16)
如果在第二行呼叫後列印,結果則如下:
int8_model[0].weight
Parameter containing:
tensor([[   3,  -47,   54,  ...,   -5,  -44,   47],
        [-104,   40,   81,  ...,  101,   61,   17],
        [ -89, -127, -125,  ...,  120,   19,  -55],
        ...,
        [  82,   74,   65,  ...,  -49,  -53, -109],
        [ -21,  -42,   68,  ...,   13,   57,  -12],
        [  -4,   88,   -1,  ...,  -43,  -78,  121]],
        device='cuda:0', dtype=torch.int8, requires_grad=True)
如前幾節解釋量化時所見,權重數值會遭「截斷」,而且似乎分佈於 [-127, 127]。 你可能也想知道如何取回 FP16 權重,以 fp16 執行離羣值矩陣乘法?只需這樣做:
(int8_model[0].weight.CB * int8_model[0].weight.SCB) / 127
結果如下:
tensor([[ 0.0028, -0.0459,  0.0522,  ..., -0.0049, -0.0428,  0.0462],
        [-0.0960,  0.0391,  0.0782,  ...,  0.0994,  0.0593,  0.0167],
        [-0.0822, -0.1240, -0.1207,  ...,  0.1181,  0.0185, -0.0541],
        ...,
        [ 0.0757,  0.0723,  0.0628,  ..., -0.0482, -0.0516, -0.1072],
        [-0.0194, -0.0410,  0.0657,  ...,  0.0128,  0.0554, -0.0118],
        [-0.0037,  0.0859, -0.0010,  ..., -0.0423, -0.0759,  0.1190]],
       device='cuda:0')
這已足夠接近原始 FP16 數值(見上方前 2 個輸出)!
- 現在,只要確保輸入位於正確的 GPU 並採用 FP16,就可以安全地使用模型進行推理:
input_ = torch.randn((1, 64), dtype=torch.float16)
hidden_states = int8_model(input_.to(torch.device('cuda', 0)))
完整的最精簡程式碼請參閲範例指令碼!
另外請注意,這些模組與 nn.Linear 模組略有不同:其參數來自 bnb.nn.Int8Params 類別,而非 nn.Parameter 類別。稍後會看到,這為我們的整合工作增加了另一項障礙!
現在來看看如何將這些功能整合至 transformers 程式庫!
只需 accelerate
處理超大型模型時,accelerate 程式庫提供多種實用工具。其中 init_empty_weights 方法尤其有用,可作為 context manager 初始化任何規模的模型,而且不會為模型權重配置記憶體。
import torch.nn as nn
from accelerate import init_empty_weights

with init_empty_weights():
    model = nn.Sequential([nn.Linear(100000, 100000) for _ in range(1000)]) # This will take ~0 RAM!
初始化後的模型會放在 PyTorch 的 meta 裝置。這是底層機制,可表示形狀和 dtype,而不配置儲存記憶體。很酷吧?
最初,這個函式會在 .from_pretrained 函式中呼叫,並將所有參數覆寫為 torch.nn.Parameter。這不符合我們的需求,因為如上所述,使用 Int8Params 類別的 Linear8bitLt 模組必須保留原有類別。我們透過這個 PR修正了問題,當中修改了:
module._parameters[name] = nn.Parameter(module._parameters[name].to(torch.device("meta")))
改為
param_cls = type(module._parameters[name])
kwargs = module._parameters[name].__dict__
module._parameters[name] = param_cls(module._parameters[name].to(torch.device("meta")), **kwargs)
現在問題已修正,我們可以善用這個 context manager,以自訂函式在不耗用記憶體的情況下,將所有 nn.Linear 模組替換為 bnb.nn.Linear8bitLt!
def replace_8bit_linear(model, threshold=6.0, module_to_not_convert="lm_head"):
    for name, module in model.named_children():
        if len(list(module.children())) > 0:
            replace_8bit_linear(module, threshold, module_to_not_convert)

        if isinstance(module, nn.Linear) and name != module_to_not_convert:
            with init_empty_weights():
                model._modules[name] = bnb.nn.Linear8bitLt(
                    module.in_features,
                    module.out_features,
                    module.bias is not None,
                    has_fp16_weights=False,
                    threshold=threshold,
                )
    return model
此函式會遞迴替換指定模型內所有 nn.Linear 層(模型在 meta 裝置初始化),並換成 Linear8bitLt 模組。has_fp16_weights 屬性必須設為 False,才能將權重和量化統計資料直接載入 int8。
我們亦會略過部分模組(此處為 lm_head),因為希望它們維持原生精度,以取得更準確、穩定的結果。
不過,工作尚未完成!上述函式在 init_empty_weights context manager 中執行,表示新模型仍會留在 meta 裝置上。
對於在此 context manager 中初始化的模型,accelerate 會手動載入各模組參數,並移至正確裝置。
在 bitsandbytes 中,設定 Linear8bitLt 模組的裝置至關重要(想了解原因,可查看此處的程式碼片段),正如我們在示範程式中看到的情況。
若呼叫兩次,量化步驟便會失敗。我們因此實作了 accelerate 的 set_module_tensor_to_device 函式(名為 set_module_8bit_tensor_to_device),確保不會重複呼叫。下一節會詳細討論!
使用 accelerate 設定裝置時務必小心
在這裡,我們必須在 accelerate 程式庫中小心拿捏!
載入模型並設定至正確裝置後,有時仍須呼叫 set_module_tensor_to_device,透過 hooks 將模型分派至所有裝置。這會在 dispatch_model(來自 accelerate)函式中執行,可能涉及多次呼叫 .to,而這正是我們想避免的。
為達成目標,我們需要 2 個 Pull Request!最初在此處提出的 PR導致部分測試失敗,但這個 PR成功修正所有問題!
總結整合步驟
因此,最終流程如下:
- 使用正確模組,在
meta裝置初始化模型 - 逐一將參數設置至正確的 GPU 裝置,並確保不會重複執行此步驟!
- 在所有正確位置加入新的關鍵字參數,並補上清晰文件
- 加入全面的測試!詳情請參閲此處的測試。 這聽起來或許很簡單,但我們曾一起經歷多次艱難的除錯過程,當中往往涉及 CUDA kernels!
總括而言,這次整合之旅十分有趣;我們深入研究並為不同程式庫做了些「手術」,再協調各部分,令一切順利運作!
現在來看看如何受惠於這項整合,以及如何在 transformers 中成功使用它!
如何在 transformers 中使用
硬件要求
CPU 不支援 8-bit tensor cores。bitsandbytes 可在支援 8-bit tensor cores 的硬件上運行,包括 Turing 和 Ampere GPU(RTX 20 系列、RTX 30 系列、A40-A100、T4 或更新型號)。例如,Google Colab GPU 通常是 NVIDIA T4,其最新一代 GPU 確實支援 8-bit tensor cores。我們的示範以 Google Colab 為基礎,歡迎參閲下方內容!
安裝
只需使用以下指令安裝各程式庫的最新版本(確保使用 python>=3.8),然後執行以下指令試用
pip install accelerate
pip install bitsandbytes
pip install git+https://github.com/huggingface/transformers.git
範例示範:在 Google Colab 執行 T5 11b
歡迎查看在 BLOOM-3B 模型上執行 8-bit 模型的 Google Colab 示範!
以下是執行 T5-11B 的示範。T5-11B 模型檢查點為 FP32,佔用 42GB 記憶體,無法在 Google Colab 上運行。使用我們的 8-bit 模組後只佔用 11GB,輕鬆即可運行:

或可參閲這個執行 BLOOM-3B 的示範:
改進範圍
我們認為,這個方法大幅改善了大型模型的可用性,讓運算資源較少的用戶也能使用以往無法取得的模型,同時不會降低效能。 我們已找出數個未來可改善的方向,進一步提升此方法對大型模型的適用性!
加快小型模型的推理速度
如基準測試章節所示,我們可將小型模型(參數量 <=6B)的執行速度提升近 2 倍。不過,雖然 BLOOM-176B 等大型模型的推理速度穩定,小型模型仍有改善空間。我們已找出問題,並有望恢復與 fp16 相同的效能,或稍微加快速度。這些改動預計在未來幾週內陸續整合。
支援 Kepler GPU(例如 GTX 1080)
雖然我們支援過去四年推出的所有 GPU,但 GTX 1080 等舊型 GPU 仍廣泛使用。這些 GPU 沒有 Int8 tensor cores,卻有 Int8 vector units(一種「較弱」的 tensor core),因此亦可透過 Int8 加速。不過,要實現快速推理,需要完全不同的一套軟件。雖然我們計劃整合 Kepler GPU 支援,讓更多人使用 LLM.int8() 功能,但由於技術複雜,還需要一段時間。
將 8-bit state dict 儲存至 Hub
目前,從 Hub 推送 8-bit state dict 後,無法直接將其載入 8-bit 模型。原因是模型計算所得的統計資料(還記得 weight.CB 和 weight.SCB 嗎?)目前不會儲存,也不會納入 state dict,而 Linear8bitLt 模組尚未支援此功能。
我們認為,若能儲存這些資料並推送至 Hub,將有助提高可用性。
CPU 支援
如本文開首所述,CPU 裝置不支援 8-bit cores。不過,我們能否突破這項限制?讓此模組在 CPU 上運行,亦可大幅提高易用性及普及程度。
擴展至其他模態
目前,超大型模型以語言模型為主。未來數年,隨着大型視覺、音訊及多模態模型愈來愈普及,將此方法應用於這些模型,或有助提升其可用性。
鳴謝
衷心感謝以下人士協助改善本文的可讀性,並參與 transformers 整合工作(按字母順序排列):
JustHeuristic(Yozh)、
Michael Benayoun、
Stas Bekman、
Steven Liu、
Sylvain Gugger、
Tim Dettmers
來源:Hugging Face Blog · huggingface.co