Circle K 如何利用 Amazon Bedrock 將 DevOps 事故排查縮短至 15 分鐘內
How Circle K accelerated DevOps incident triage to under 15 minutes with Amazon Bedrock
Circle K 使用 Amazon Bedrock 建立自動化 DevOps 事故排查系統,將平均排查時間由 45–60 分鐘縮短至 15 分鐘內。系統整合 AWS 資源、OpenSearch 日誌、GitHub 程式碼及知識庫資料,並將結構化摘要送到 Slack;按團隊內部事故應對指標,排查時間減少 67–75 percent。
文章呈現 Circle K 將事故排查由 Amazon Bedrock Flows 遷移至 AgentCore Runtime 的架構調整,並整理日誌預查詢、按線索縮窄程式碼搜尋等實作方法。
本文由 Circle K 雲端 DevOps 工程師 Marek Klatowicz 共同撰寫。
不少 DevOps 團隊都熟悉事件分流的模式:警示觸發後,在有人能夠修復問題之前,工程師往往要花 45–60 分鐘瞭解發生了甚麼事。他們會提取日誌、檢查服務健康狀況,並在幾種工具之間比對各種症狀。這一切都要在開始修復之前完成。
對 Circle K 而言,這項挑戰隨業務規模擴大。公司在 27 個國家經營逾 17,200 間便利店及燃油零售店。在這些門店背後,雲端原生基礎設施支援在 AWS 上運行的銷售點系統、會員獎勵應用程式及電動車 (EV) 充電應用程式。隨着公司擴展數碼營運,分流工作所帶來的額外負擔也隨之增加。服務越多,警示也越多,而每宗警示都需要先經過相同的人工調查,才能開始修復。
為瞭解決這個問題,Circle K 使用 Amazon Bedrock 建立自動化分流系統。這項全受管理服務透過單一 API 提供基礎模型 (FM)。如需瞭解各 AWS 區域可用的模型,請參閲 Amazon Bedrock 各 AWS 區域支援的模型。系統採用代理式 AI 架構,自主調查每宗事故,並在警示觸發後幾分鐘內,向 Slack 提供結構化摘要。值班工程師不再只收到原始警示,而是能取得可據以採取行動的背景資訊,立即着手處理,毋須再花一小時瞭解發生了甚麼事。
部署這套系統後,Circle K 將平均分流時間縮短至 15 分鐘以下。按團隊內部的事故回應指標計算,減幅達 67–75%。
本文會介紹最初採用 Amazon Bedrock Flows 的架構,以及遷移至 Amazon Bedrock AgentCore 的架構,並分享擴展系統時汲取的經驗。
分流工作的額外負擔
Circle K 的 DevOps 團隊使用 Grafana 監察多個 AWS 帳戶中的基礎設施。日常警示包括容器重新啟動、錯誤率上升、延遲突增及部署失敗。每項警示都是有用的訊號,但隨着系統擴展,團隊希望協助值班工程師迅速判斷哪些訊號需要處理,並取得適當的背景資訊。
警示觸發後,分流工作會涉及一連串熟悉的人工步驟:在 Amazon CloudWatch 查看近期日誌、在 Amazon OpenSearch Service 檢視應用程式層級的追蹤資料、檢查 Amazon Elastic Container Service (Amazon ECS) 任務狀態,並在 GitHub 內部操作手冊中查找相關症狀。這些步驟能提供工程師所需的資訊,但也顯示隨着更多服務接入系統,重複收集背景資訊的工作量會有多大。
團隊認為,及早投入資源有助改善兩方面的問題。第一,每宗事故都要重複執行相同的日誌查詢、健康檢查及操作手冊查閲。第二,分流的深入程度和速度可能因值班工程師對受影響服務的熟悉程度而有所不同。隨着警示數量和服務負責範圍增加,每次調查都要在多種工具之間切換,可能拖慢回應速度,也令團隊更難以一致地落實最佳做法。
因此,Circle K 的 DevOps 團隊啟動了一項研究與開發(R&D)計劃,探索 AI 如何協助監察及事件分流。目標是自動化重複的背景資料蒐集工作,並提供有條理且可供採取行動的分析結果,同時在調查期間支援工程師作出營運判斷。
Circle K 選擇 Amazon Bedrock 的原因
在着手建置前,團隊評估了多種方案,包括在自行管理的基礎設施上使用開源 Agent 框架。採用這種方案,團隊便需要自行負責模型託管、提示詞版本管理、工具協調及安全控制。
使用 Amazon Bedrock,團隊無需承擔這些額外工作。他們可透過單一 API 存取基礎模型,並在無需重寫程式碼的情況下更換基礎模型。由於 Circle K 已在 AWS 上運行,Amazon Bedrock 可配合現有的 AWS Identity and Access Management (IAM) 政策、Amazon Virtual Private Cloud (Amazon VPC) 設定及日誌管道。
兩項受管理功能分別負責協調及檢索。Amazon Bedrock 協助進行 Agent 協調,讓 Agent 可原生使用工具呼叫 AWS API、查詢資料庫及擷取文件,無需編寫自訂協調程式碼。Amazon Bedrock Knowledge Bases 是全受管理的檢索增強生成(RAG)功能,負責匯入及檢索內部產品卡,因此團隊毋須另外運行向量資料庫。這讓 DevOps 團隊可以專注於提示詞設計及工具定義。
資料私隱是最後一項考量。Circle K 的事件資料包括營運指標、基礎設施詳情,以及可能包含敏感資訊的日誌。Amazon Bedrock 不會與模型供應商分享客戶資料,也不會使用這些資料訓練基礎模型。對於會將正式環境日誌及內部服務詳情輸入系統的團隊而言,這種資料處理方式符合 Circle K 的安全要求。
方案概覽
本節介紹團隊以 Amazon Bedrock Flows 建置的初始架構。後續章節會介紹遷移至 AgentCore 的過程。
方案使用 Amazon Bedrock Flows 作為協調層,協調多個專責 Agent,各自負責分析的不同部分。當 Grafana 警示向 Amazon Simple Notification Service (Amazon SNS) 發佈通知後,流程便會啟動;Amazon SNS 會將通知轉發至 Amazon Simple Queue Service (Amazon SQS) 佇列。AWS Lambda 函數會輪詢佇列、擷取警示內容,並呼叫 Flow。
在 Flow 內,兩個 Agent 會平行執行。AWSResourceExplorerAgent 會查詢由 AWS Organizations 管理的多個工作負載帳戶中的基礎設施,檢查 Amazon ECS 任務狀態、Application Load Balancer 目標的健康狀況,以及 CloudWatch 指標和日誌。同時,OpenSearchExplorerAgent 會查詢 Amazon OpenSearch Service,取得應用程式層級的日誌及分散式追蹤資料。由於 OpenSearch 會傳回大量日誌資料,因此這個 Agent 會獨立運行,以保持每個 Agent 的上下文視窗在可管理範圍內。此外,只有這個 Agent 可以存取知識庫;知識庫內含介紹各項服務及其相依關係的產品卡。
兩個 Agent 均回報調查結果後,GitHubExplorerAgent便會執行。它會接收前兩個 Agent 的輸出,並找出受影響服務的 GitHub 存放庫。接着,它會搜尋存放庫中的應用程式程式碼、基礎設施定義及最新提交,以找出問題根源並提出具體修正方案。在平行執行的 Agent 完成後才執行這個步驟,便能準確知道要搜尋甚麼,而毋須進行廣泛搜尋。
三項輸出均會傳送至 AnalysisPrompt 節點。這個節點只會進行一次模型呼叫,不附帶任何工具。它會接收 AWS 資源資料、OpenSearch 日誌及 GitHub 背景資料,然後產生結構化摘要,包括可能的根本原因、佐證、受影響的服務及負責人,以及建議的補救步驟。提示詞輸出採用一致格式,當值團隊可在 2 分鐘內快速閲覽。
Flow 會將摘要傳回呼叫它的 Lambda 函數,由該函數在 Slack 頻道發布摘要。整個流程由發出警報到 Slack 訊息發布,需時 5–15 分鐘,視乎事故的複雜程度而定。
下圖展示整個架構,由最初的 Grafana 警報到最終的 Slack 摘要。

圖 1:使用 Amazon Bedrock Flows 的 Circle K 自動化事故分流架構
分流示例
Grafana 警報:某服務的 HTTP 5xx 錯誤率連續 3 分鐘超過 5%。
AWSResourceExplorerAgent 檢查目標帳戶中的 ECS 任務健康狀態,發現資料庫連線池已耗盡,而 ECS 服務正嘗試重新啟動。OpenSearchExplorerAgent 傳回應用程式日誌,顯示服務連線至其後端 PostgreSQL 資料庫時出現「連線遭拒」錯誤。它亦從知識庫擷取受影響服務的產品卡片;卡片記錄了該服務對這個資料庫的依賴。GitHubExplorerAgent 搜尋該服務的存放庫及基礎設施檔案,找到 Amazon Relational Database Service (Amazon RDS) 定義。它發現該服務每次收到請求都會開啟新的資料庫連線,而不是重用現有連線。
AnalysisPrompt 接收全部三項結果。它將問題發生時間與警報前 10 分鐘開始的預定市場推廣活動互相對照,並結合 GitHubExplorerAgent 的發現,建議具體的程式碼層面修正方案,而不是臨時補救措施。
最終的 Slack 訊息如下:
Summary: XYZ Service 5xx errors caused by connection pool exhaustion
Root cause: Scheduled marketing campaign drove traffic spike; connection pool max (50) insufficient for load
Evidence: OpenSearch logs show "connection refused" at 14:32 UTC; ECS shows 3 task restarts since 14:30
Owner: XYZ team (backend)
Next steps: Add Amazon RDS Proxy to pool connections, or update the service to reuse existing connections instead of opening a new one per request; consider an Auto Scaling rule for future campaigns
擴展至 Amazon Bedrock AgentCore
Amazon Bedrock Flows 架構運作良好數月,簡單事故可在 10 分鐘內完成分流。隨着時間推移,數據量及每次調查所需的背景資訊不斷增加,服務種類則維持不變。部分事故所需的分析時間,超出了單一 Flow 節點可完成的範圍。
團隊首先在現有設計內作出最佳化,包括更嚴格地篩選日誌、縮短上下文視窗,以及將部分服務拆分到不同的 Flow 中。這些措施有所幫助,但日誌量和知識庫仍持續增長。
Amazon Bedrock AgentCore 正好滿足這項需求。AgentCore 是一個平台,可配合任何框架或模型,大規模建構、連接及最佳化 AI Agent。對這項工作負載而言,AgentCore Runtime 是關鍵功能:整個調查會在單一工作階段中執行,因此每個步驟都可按其數據所需的時間進行。AgentCore Runtime 支援長達 8 小時的工作階段,遠超目前調查所需時間。團隊將 Agent 邏輯容器化,並部署至 AgentCore Runtime。
以下示意圖顯示遷移至 Amazon Bedrock AgentCore 後的正式環境架構。
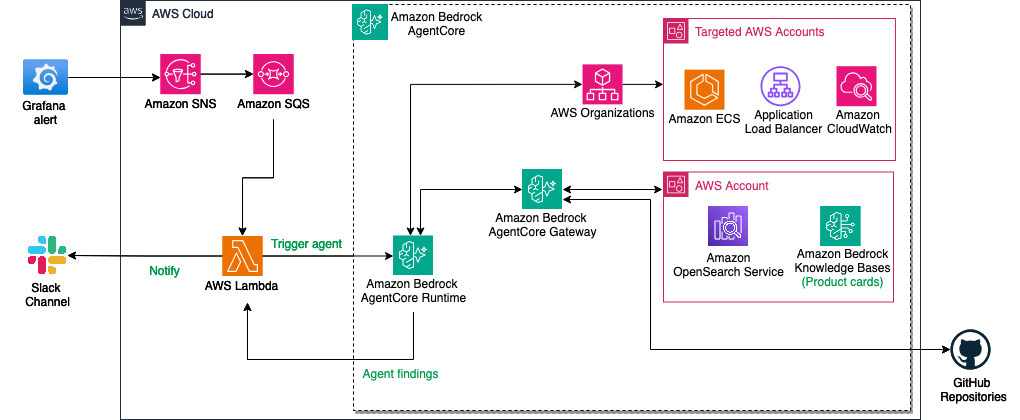
圖 2:使用 Amazon Bedrock AgentCore Runtime 和 AgentCore Gateway 的正式環境架構
分析邏輯維持不變,但執行方式有所改變。Flows 版本中的三個專門代理,現在整合為一個在 AgentCore Runtime 工作階段中執行的代理。Lambda 函數會啟動工作階段,而代理則執行與以往相同的步驟:查詢多個帳戶中的 AWS 資源、從 Amazon OpenSearch Service 擷取日誌、搜尋 GitHub,並從知識庫擷取產品卡片。代理會在 15 分鐘內將分析結果傳回 Lambda 函數,沒有超出 Lambda 函數的最長逾時時間。然後,Lambda 函數會將結構化摘要發佈至 Slack。
Amazon Bedrock AgentCore Gateway 是 Amazon Bedrock AgentCore 的一項功能,負責管理代理對其資料來源的存取,包括 Amazon OpenSearch Service、Amazon Bedrock Knowledge Bases 和 GitHub。Gateway 將每個資料來源公開為代理可呼叫的工具,集中管理存取控制,並讓團隊更容易新增或更改資料來源。
AgentCore Runtime 如何支援團隊不斷擴大的規模
除了可執行更長時間的工作階段外,Amazon Bedrock AgentCore Runtime 還新增了三項支援團隊不斷擴大規模的功能:工作階段持續性、基於 OpenTelemetry 的可觀測性,以及框架靈活性。
工作階段持續性:代理會在整個調查過程中保留中間狀態。如果代理在初步檢視日誌時有所發現,便可在不遺失已建立的背景資訊下,再進行一次更具針對性的檢視。這符合調查複雜多服務事故時反覆迭代的方式。
可觀測性:AgentCore 使用 OpenTelemetry 標準擷取每個工作階段的追蹤資料,並透過 CloudWatch 呈現。團隊可以查看每個步驟所需的時間、代理執行了哪些知識庫查詢,以及瓶頸出現的位置。這些洞察會直接用於提示詞調校。
框架靈活性:使用 AgentCore Runtime,團隊可以部署以多種框架建置的容器化代理。隨著需求改變,團隊可以調整代理邏輯、新增分類步驟,或重新安排代理的推理方式,全部都可在同一個 Runtime 上進行。
AgentCore 架構現已在正式環境中運行,可處理各類事故,從簡單的單一服務警示,到涉及多個服務的大型調查。
結果
Circle K 在 2026 年 4 月部署了 AgentCore 版本的事故分類系統。根據團隊內部的事故回應指標,平均事故分類時間由 45–60 分鐘降至 15 分鐘以下,減少 67–75%。簡單事故可在 5–8 分鐘內收到摘要。以往需要超過一小時手動分類的複雜多服務事故,現在可在 15 分鐘內完成。
工程師現在可直接從摘要着手,而不必自行收集背景資訊。團隊發現事故處理方式有三項改變:
分類結果一致。無論值班工程師對受影響服務有多熟悉,每位工程師收到的都是相同格式的摘要,包含相同的日誌摘錄、知識庫參考資料和建議後續步驟。
更快升級處理。當問題需要其他團隊支援時,摘要會向值班工程師提供相關背景資訊,讓他們能及時且掌握充分資訊地升級處理。
更快處理誤報。如果分析結果顯示服務運作正常,且沒有相關錯誤,工程師便可確認警示,繼續處理其他工作。
經驗教訓
建立這套系統經歷了多次迭代。以下四項經驗尤其值得注意,適用於建立類似方案的團隊。
直接在提示詞中加入日誌內容。早期版本只傳入日誌羣組名稱和時間範圍,之後代理程式會嘗試透過動作羣組查詢 CloudWatch。這會增加延遲,而且經常傳回太多資料,難以處理。Circle K 改為由 Lambda 函數預先查詢日誌,並將相關行直接傳給代理程式,結果更理想。代理程式能直接讀取實際錯誤訊息時,推理速度更快。
按使用情境調校檢索和生成設定。檢索設定對知識庫的結果質素有顯著影響。測試各種可用選項後,Circle K 團隊發現,採用預設設定的 Amazon Bedrock Knowledge Base 最適合他們的資料。在整個流程中,Amazon Bedrock 會處理嵌入、索引和向量儲存,因此團隊需要維護的元件較少。在生成方面,設計完善的系統提示詞和經調校的 temperature 設定,讓 Slack 上的摘要更一致。
根據日誌的分析結果,縮小程式碼搜尋範圍。在沒有線索的情況下搜尋服務的程式碼儲存庫,會得到太多結果,難以派上用場。團隊會在分析 AWS 資源和日誌後才執行 GitHub 搜尋,因此代理程式已知道要尋找哪個錯誤、元件或近期變更。在範例分流中,代理程式正是透過這種方式發現,該服務每次收到請求都會開啟新的資料庫連線。
讓分析邏輯與編排層分開。資料量增加會延長分析時間,因此應預計調查所需時間會逐漸增加。團隊將提示詞、工具定義和分析步驟與流程結構分開。這樣一來,團隊便可將它們整合至 AgentCore Runtime 上的單一代理程式,而無須重寫分流邏輯。
下一步
目前,分流系統會找出可能的根本原因並建議修復方法,再由工程師執行修復。下一步,團隊計劃整合 AWS DevOps Agent,讓系統也能處理簡單的修復操作,例如重新啟動工作、擴展服務或回復部署。每項操作執行前,都會由工程師在 Slack 中批准。
團隊亦計劃為代理程式提供更多背景資料:
- Jira:將每宗事故連結至相關工單,並追蹤後續工作。
- Confluence:加入內部文件,補充代理程式目前已讀取的程式碼和日誌。
- 在知識庫中加入操作手冊,讓代理程式將症狀與已知故障模式及以往奏效的修復方法配對,而非只依賴產品卡片。
結論
Circle K 團隊透過自動化收集原本由工程師手動整理的背景資料,將事故分流時間由 45–60 分鐘縮短至不足 15 分鐘。系統會收集日誌、AWS 資源和程式碼中的資料,讓代理程式據此推理,再向 Slack 提交結構化摘要。
團隊使用 Amazon Bedrock Flows 和 Amazon Bedrock Knowledge Bases 建立第一個版本。隨着調查規模擴大,團隊改用 Amazon Bedrock AgentCore Runtime 上的單一代理程式,並透過 AgentCore Gateway 存取資料來源。
如果團隊在事件應變上花費的大部分時間都用於收集背景資料,而非解決問題,這個模式便直接適用。要開始使用,請瀏覽 Amazon Bedrock AgentCore 和 Amazon Bedrock Knowledge Bases。如需實作指引,或想與 AWS 專家討論你的使用案例,請瀏覽 Amazon Bedrock 入門頁面,或聯絡 AWS。
我們想了解你如何處理事件分流。歡迎在留言中分享你的經驗。
作者簡介

Marek Klatowicz
Marek 是 Circle K 的雲端 DevOps 工程師,負責與 AWS 合作,為企業終端客戶設計和改進雲端服務。最近,他大部分時間都投入 AI,建構能帶來實際業務價值的方案。他相信簡單而有效的方案。

Sefat Noor Orni
Sefat 是 Amazon Web Services 的解決方案架構師,協助企業客戶在 AWS 上建構由 AI 驅動的營運工具。她專長於生成式 AI 應用程式、代理架構和 DevOps 自動化。工作以外,她喜歡嘗試烹飪、音樂和家居自動化項目。
來源:AWS Machine Learning Blog · aws.amazon.com