大語言模型能否可靠判斷研究構想是否新穎?
Can we trust LLMs to judge whether a research idea is novel?
Ai2 發佈《Old Ideas, Novel Problems》研究及基準,發現大語言模型判斷研究構想新穎性的結果會因評估設定而大幅變動。以 GPT-5.4 評估人類與 AI 生成構想的配對時,僅更改提示詞便令準確率由 93.5% 降至 40.9%,並改變逾半配對的判斷。
研究從 ICLR 2026 評審中抽取明確談及原創性的案例,建立可比較人類與 AI 生成構想的基準,呈現提示詞變動對評估結果的影響。
今天我們發佈 Old Ideas, Novel Problems,一項探討大型語言模型能否可靠評估科研構想新穎性的新研究。除論文外,我們亦公開一套基準測試、數據及程式碼,供測試新穎性評估器使用,並提供一套自動化流程,讓研究人員建立新的評估集。
在 Ai2,我們一直致力開發支援科學發現不同環節的 AI 系統。DataVoyager 協助研究人員探索和分析結構化數據,AutoDiscovery 會產生和測試假設,而 Theorizer 則綜合大量文獻中的證據,形成候選科學理論。這些項目連同 Asta,展現了系統如何協助研究人員從理解過往研究,進一步提出、測試和完善新構想。
然而,產生研究構想只是自動化科學發現其中一項挑戰。這些構想也必須帶來真正的新貢獻,意味著這些系統需要有方法,分辨真正新穎的研究方向與主要只是重新包裝既有研究的方向。
這類判斷通常交由另一個 LLM 負責,我們稱之為新穎性評估器。新穎性評估器會評估研究構想相對於過往研究是否新穎,可以獨立評估,也可以與另一個構想比較。目前沒有建立這類評估器的標準方法;研究團隊會自行選擇模型、提示詞、評估形式、推理預算,有時還會選用文獻檢索系統。這些選擇可能大幅影響評估結果。然而,這些評估器往往只以人類撰寫的論文作驗證,而非它們實際需要評估的 AI 生成構想。
我們的新基準測試結果顯示,新穎性評估本身遠稱不上可靠。在六個 LLM 評估器——GPT-5.1、GPT-5.2、GPT-5.4、Claude Sonnet 4.5、Claude Opus 4.5 和 Claude Opus 4.6——之中,只要稍微改動評估設定,對同一批構想的判斷便會大幅不同。在一項實驗中,只需改動提示詞中的幾個字,模型判斷兩個構想中哪個較新穎的準確率便會相差超過 50 個百分點。檢索資料和增加推理並不能穩定改善判斷;兩個專為新穎性評估而設的系統,表現更不及只使用簡單提示詞的 Claude Opus 4.6 基準。
如果 AI 要在科學發現中發揮更大作用,我們便需要更可靠的方法,判斷它是否真的提出了新構想。我們的研究提供了研究這個問題的工具,同時亦顯示仍有許多問題尚未解決。
建立新穎性評估器的基準測試
要測試新穎性評估器能否可靠地分辨新穎程度較高和較低的研究構想,我們首先需要找到一些案例,當中有充分證據判斷相關科學貢獻的原創性。
因此,我們以 ICLR 2026 的同行評審為基礎,建立了一套自動化流程。我們沒有把論文獲接納與否當作新穎性的替代指標,而是從評審內容中找出評審明確討論某項貢獻原創性的段落。這個區分十分重要:只要論文在其他方面足夠出色,即使不算特別新穎,也可能獲接納。同樣,論文即使有原創貢獻,也可能因其他不足而被拒。
我們建立了一個包含 154 個人類撰寫研究構想的 高新穎度組:從各自 ICLR 研究領域中評分最高的 10% 論文裏,挑選已獲接納、審稿人明確肯定其新穎性,而且沒有任何審稿人提出質疑的論文。我們採用相反條件建立 低新穎度組:從評分最低的 10% 論文裏,挑選 145 個構想;這些論文已被拒絕,審稿人提出原創性疑慮,而且沒有任何審稿人明確肯定其新穎性。在另一項針對審稿意見挖掘流程的檢查中,標註員在 50 個案例中有 47 個認同抽取出的新穎性訊號方向;其餘分歧均不會改變我們是否把審稿人歸類為肯定或質疑論文的新穎性。
這兩個組別構成我們的第一個評估設定 Human-Only,用來測試新穎度評估者能否區分有充分證據顯示新穎度較高或較低的人類撰寫構想。但在實際應用中,新穎度評估者愈來愈常用來評估 AI 生成的構想。因此,我們建立了第二個設定 Human+Generated。
在這個組別中,我們把同一批經驗證的人類構想(154 個),與簡單的大型語言模型生成器產生的 154 個構想配對。我們假設生成的構想不及相應的人類撰寫構想新穎;這些只是弱標籤,並非對每個構想都經過驗證的判斷。生成器只會收到一個研究領域,以及提出新穎構想的指示,沒有進行文獻搜尋、使用工具、反覆修訂或接收回饋。這讓我們能保守地比較基本生成器產生的構想,與審稿人明確肯定其原創性的 ICLR 評分前 10% 論文所作出的貢獻。
作為額外檢查,一位專家獨立評估了 30 組 Human+Generated 配對,其中大部分是我們最強的評估者判斷錯誤的案例;我們亦把人類及 AI 生成的構想改寫成相同結構,以測試評估者是否只因寫作風格差異而作出判斷。專家在全部 30 組配對中都較偏好人類構想,並認為生成的構想沒有一個具新穎性。
重要的是,我們許多核心研究結果並不取決於標籤本身。如果兩種合理的評估設定對同一組構想得出相反答案,這種分歧本身就反映了不穩定性。
細微改動也可能導致截然不同的判斷
我們使用人類撰寫及 AI 生成的研究構想,測試六個大型語言模型評估者——GPT-5.1、GPT-5.2、GPT-5.4、Claude Sonnet 4.5、Claude Opus 4.5 及 Claude Opus 4.6——透過逐項評分(即新穎度絕對評分)及成對比較(即比較兩個構想,找出較新穎的一個)評估新穎度的能力。我們每次只改變一個因素:提示詞、推理預算、評估者能否查看相關論文、構想的格式、合併多少個評估結果來得出最終判斷,以及(針對 AI 生成的構想)生成構想所用的模型。
表現變化最大,取決於我們如何提示模型評估新穎度。
例如,我們向 GPT-5.4 展示相同的 Human+Generated 配對——每組各包含一個經驗證由人類撰寫的構想,以及一個 AI 生成的構想——並使用兩種提示詞。其中一種提示詞告訴模型,評審認為每組配對中恰好有一個構想具新穎性,並要求模型指出是哪一個;另一種則只問哪個構想具新穎性。改用較簡單的提示詞後,準確率由 93.5% 跌至 40.9%,低於隨機猜測水平;而且模型對超過一半的相同配對改變了判斷。
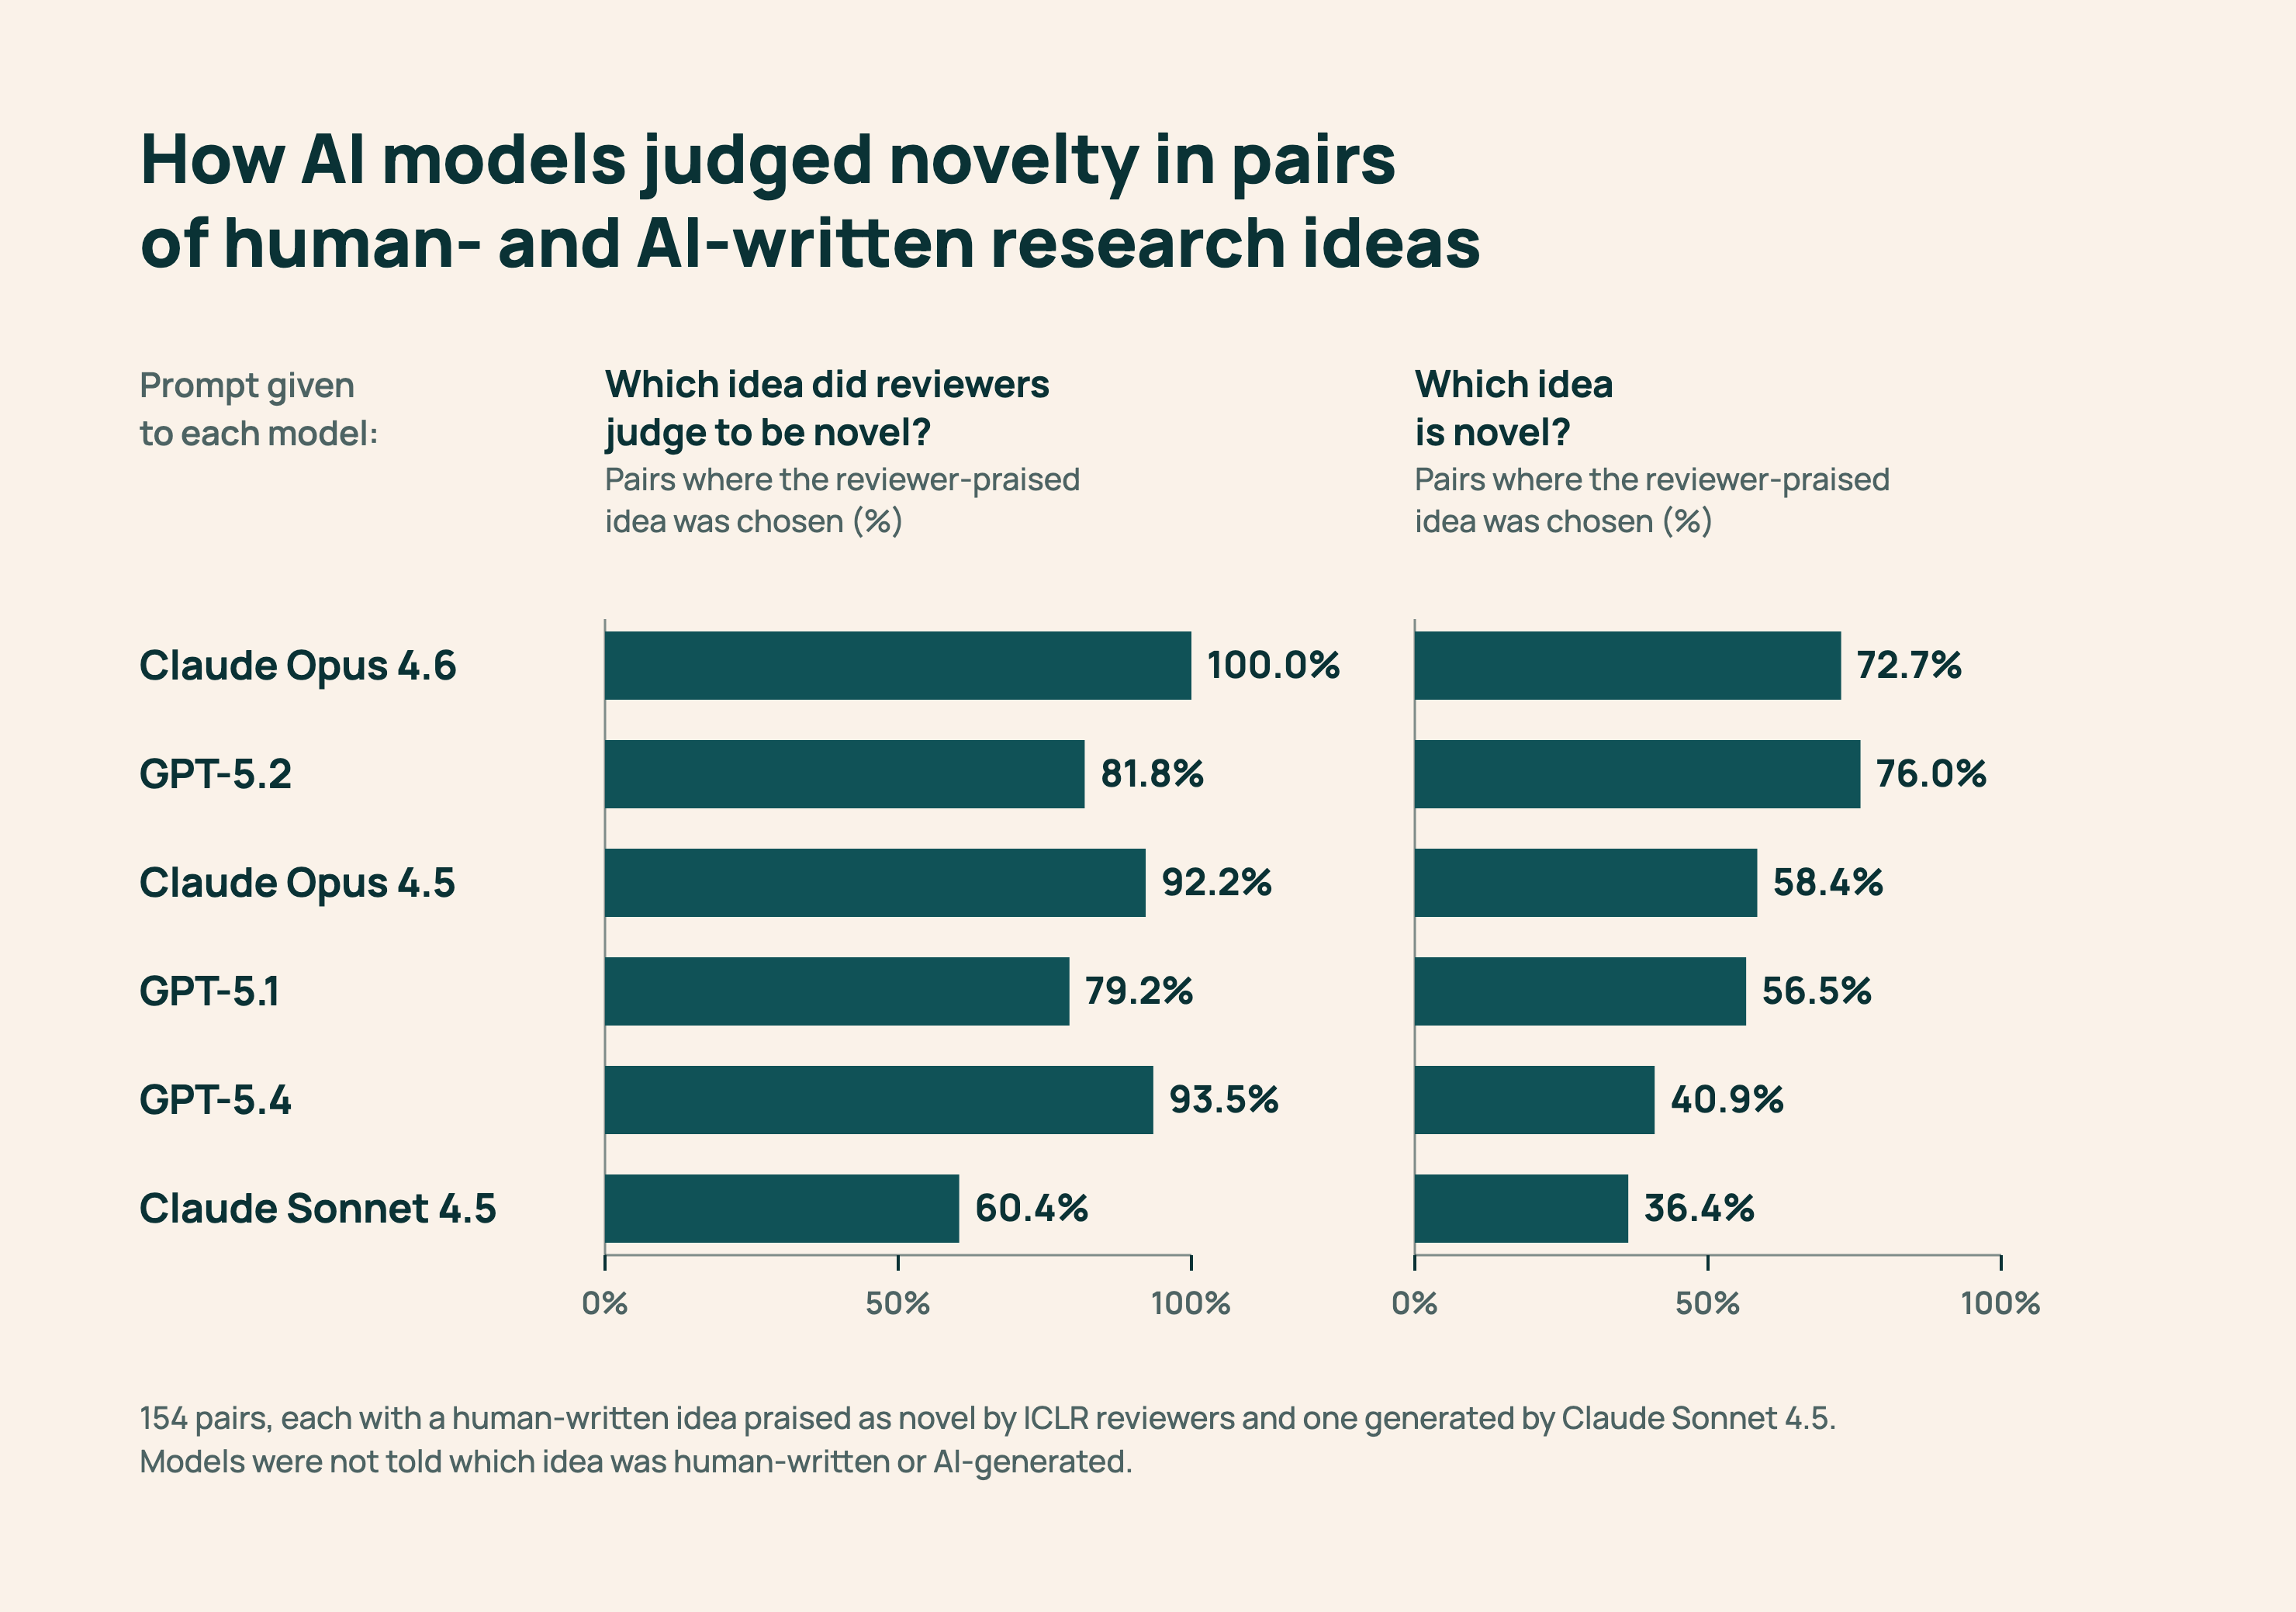
相比之下,在 Human-Only 數據集上,相同的提示詞變化只令準確率相差約七個百分點。這個數據集將人類撰寫的構想與新穎性證據較強或較弱的構想配對。這表明,新穎性評判模型在評估人類撰寫的研究時看來相對穩定,但在評估 AI 生成的構想時,表現可能大不相同。
話雖如此,人類撰寫的構想也並非不受影響。我們在 Human-Only 數據集上也觀察到明顯變化;相同的改動令 Claude Opus 4.6 的準確率相差 21 個百分點。只是這些變化沒有 AI 生成構想上的那麼嚴重。
此外,也沒有一種提示詞在所有情況下都較好。例如,逐一評估構想時,刪去一項提醒評判模型不要把瑣碎或漸進式的貢獻視為新穎的指示,令部分模型的準確率提高,卻令其他模型的準確率下降。換言之,對某個模型效果良好的提示詞,未必適用於另一個模型。
我們也測試了新穎性評判模型的一種常見用途:比較兩個 AI 生成器產生的構想。我們將 Claude Opus 4.5 的構想與 Claude Sonnet 4.5 的構想配對,並將 GPT-5.4 的構想與 GPT-5.1 的構想配對。在測試過的提示詞變化中,六個評判模型的判斷平均約有四分之一至三分之一齣現改變。即使不假設哪個生成器產生的構想較新穎,也可以量度這種判斷分歧,從而顯示評判模型所用的提示詞會如何影響不同構想生成系統之間的比較。
更多搜尋和推理未必能帶來更好的新穎性判斷。我們為 GPT-5.6 Sol 提供特高的推理預算,以及僅限搜尋 arXiv 的即時迭代搜尋,再將它與使用標準檢索的評判模型比較;後者各自會看到五篇預先檢索的摘要。(這項比較中的所有評判模型,都在 Human+Generated 數據集上對每個構想評估一次。)具 Agent 能力的評判模型取得 0.78 的 macro-F1,比 Claude Opus 4.6 的 0.89 低 11 個百分點;其表現大致與較簡單的 Claude Opus 4.5 和 GPT-5.4 設定相若,但按目前的 API 價格,每次判斷的成本約高出 10×。(在此情況下,macro-F1 衡量評判模型識別新穎及非新穎構想的能力;分數越高越好。)
專門設計的評估器也沒有更準確,儘管成本高出不少。在 Human+Generated 數據集上,使用低推理設定的簡單 Claude Opus 4.6 提示詞,透過三次呼叫的多數表決,取得 0.854 的 macro-F1,總評估成本為 $2.59。相比之下,以文獻為基礎的檢索及重新排序流程 Idea Novelty Checker 得分為 0.642,成本為 $30.66;Sakana AI 的 AI Scientist 則透過新穎性評估器反覆搜尋 Semantic Scholar,得分為 0.772,成本為 $82.05。(兩個專用評估器均使用 Claude Opus 4.6,每次判斷呼叫一次。)
換言之,簡單的提示詞基準不但更準確,成本也遠低於兩個專用系統。
綜合而言,這些結果顯示,新穎性評估在 AI 生成的構想上尤其不穩定,而這些系統正日益被要求評估這類構想。
邁向更可靠的新穎研究評估
我們的結果顯示,以大型語言模型為基礎的新穎性評估仍是一個重大未解難題。對人類撰寫的研究看似可靠的評審模型,在評估 AI 生成的構想時可能表現不同;有助於某個模型的提示詞,可能會令另一個模型表現變差;而增加搜尋或運算資源,也不一定能帶來更一致的判斷。
未來的研究應在評審模型實際會評估的構想類型上測試它們,衡量它們對提示詞及模型的敏感度,改善納入既有文獻的方式,並建立能隨科學文獻增長及 AI 系統進步而更新的基準。我們的基準及可重用數據流程只是起點——研究人員可以將它們應用於新的同行評審、其他科學社羣,以及新一代新穎性評審模型。
自動化構思不只要生成看似合理的研究方向,我們還需要方法判斷這些構想是否真正新穎。透過讓現有新穎性評審模型的弱點更易衡量,我們希望這次發布能協助研究人員建立更可靠的方法,評估 AI 生成的研究構想。
來源:Hugging Face Blog · huggingface.co