Natera 如何以 Amazon Bedrock AgentCore 設計實驗室運維智能體系統
How Natera designed an agentic AI system for lab ops with Amazon Bedrock AgentCore
Natera 與 AWS 使用 Amazon Bedrock AgentCore 建置 SWARM,為實驗室運維支援工單自動生成診斷報告。在 90 天生產評估中,平均首次回應時間由 17.4 小時降至約 8 分鐘,約快 130 倍;96.2% 的工單在工程師查看前收到自動診斷報告。
文章拆解 SWARM 的雙運行時、技能庫、資料管線與持續評估設計,並提供實驗室工單自動診斷的實測數據,呈現一套可參考的運維智能體建置路徑。
在Natera,這家無細胞 DNA (cfDNA) 檢測領域的領先企業,維持實驗室儀器正常運作至關重要,因為設備停機會中斷樣本處理。由 Ariel Jirau 領導的 Natera 實驗室工程團隊與 AWS 合作,建立 SWARM (Systematic Workflow Analytics and Resolutions Manager),這是一套用於實驗室營運的 Agentic AI 系統。
本文介紹 Natera 團隊如何利用 Amazon Bedrock AgentCore 建立用於實驗室營運的 Agentic AI 系統,以大規模擷取並應用機構知識。文章詳述完整架構,從建構知識庫到自動化系統部署及評估,讓你可以將相同模式應用於自己的營運工作流程。
SWARM 將首次回應速度提升約 130 倍,支援工單的自動化覆蓋率達 96.2%,讓工程師在工單送達時即可即時取得機構知識。
挑戰:知識延續
Natera 的實驗室營運依賴多種精密儀器,涵蓋多個設備系列,各自有不同的故障模式、供應商文件及解決問題的模式。負責維護這些基礎設施的服務工程團隊,以個人深厚的專業知識為核心,而非依循標準化作業指南。當一位多年來負責診斷某個儀器系列的資深技術人員離職時,他所掌握的機構知識實際上也隨之流失。當時沒有任何系統可以大規模擷取、整理或應用這些專業知識。
每天超過 65 張工單分流至三個 Jira 佇列,首次回應時間平均為 17.4 小時;儀器停機會延誤實驗室樣本處理及病人報告。增聘工程師也無法應付需求。SWARM 必須在數分鐘內回應,為各類設備提供準確診斷,並透過有系統的評估循環持續改進。
Natera 為何選擇 Amazon Bedrock AgentCore
Natera 團隊選擇在 Amazon Bedrock AgentCore 上建構 SWARM。這是 AWS 提供的全受管理、可擴展服務,旨在讓用戶大規模建立、部署、連接、保障安全及營運 AI Agent。這項決定主要基於三項核心要求:
- 無需人工介入,自主處理大量支援工單。
- 與 Jira 和 Confluence 等現有營運工具深入整合。
- 具備內置安全性及可觀測性(加密、AWS Identity and Access Management (IAM) 整合及分佈式追蹤),而團隊無需自行建立和維護自訂基礎設施。
Jirau 説:「我們需要一個受管理的執行環境,讓我們能把工程資源集中用於提升診斷準確度,而不是處理基礎架構的繁瑣工作;AgentCore 提供了這一點,還內置身份管理功能,並讓我們可以更換模型而無需重寫 Agent 邏輯。」
AgentCore 原生支援與多項服務整合,包括Amazon DynamoDB(全受管理的 NoSQL 資料庫服務)、Amazon Simple Queue Service (Amazon SQS),以及AWS X-Ray(Amazon CloudWatch 的一項功能)。
SWARM 的運作方式:兩個 Agent,共用一個技能庫
SWARM 使用兩個互相配合、共用同一個技能庫的執行環境。swarm-agent 會在工程師開啟工單前自主產生結構化診斷報告;工程師則使用 swarm-hive 即時互動、上載圖片,並探索其他疑難排解途徑。
「系統不會取代工程師——它會在工單送達的一刻,讓他們即時存取機構知識的全部內容。」Jirau 説。
四個層面連接整個架構:
- 事件層透過 Amazon EventBridge 和 Amazon SQS 路由 Jira 工單。
- 代理程式層負責運行 swarm-agent、swarm-hive 和技能庫,並將診斷報告送回工程師。
- 上下文層參照供應商手冊、歷史工單和營運數據。
- 可觀測性與交付層會收集追蹤資料、日誌和指標。
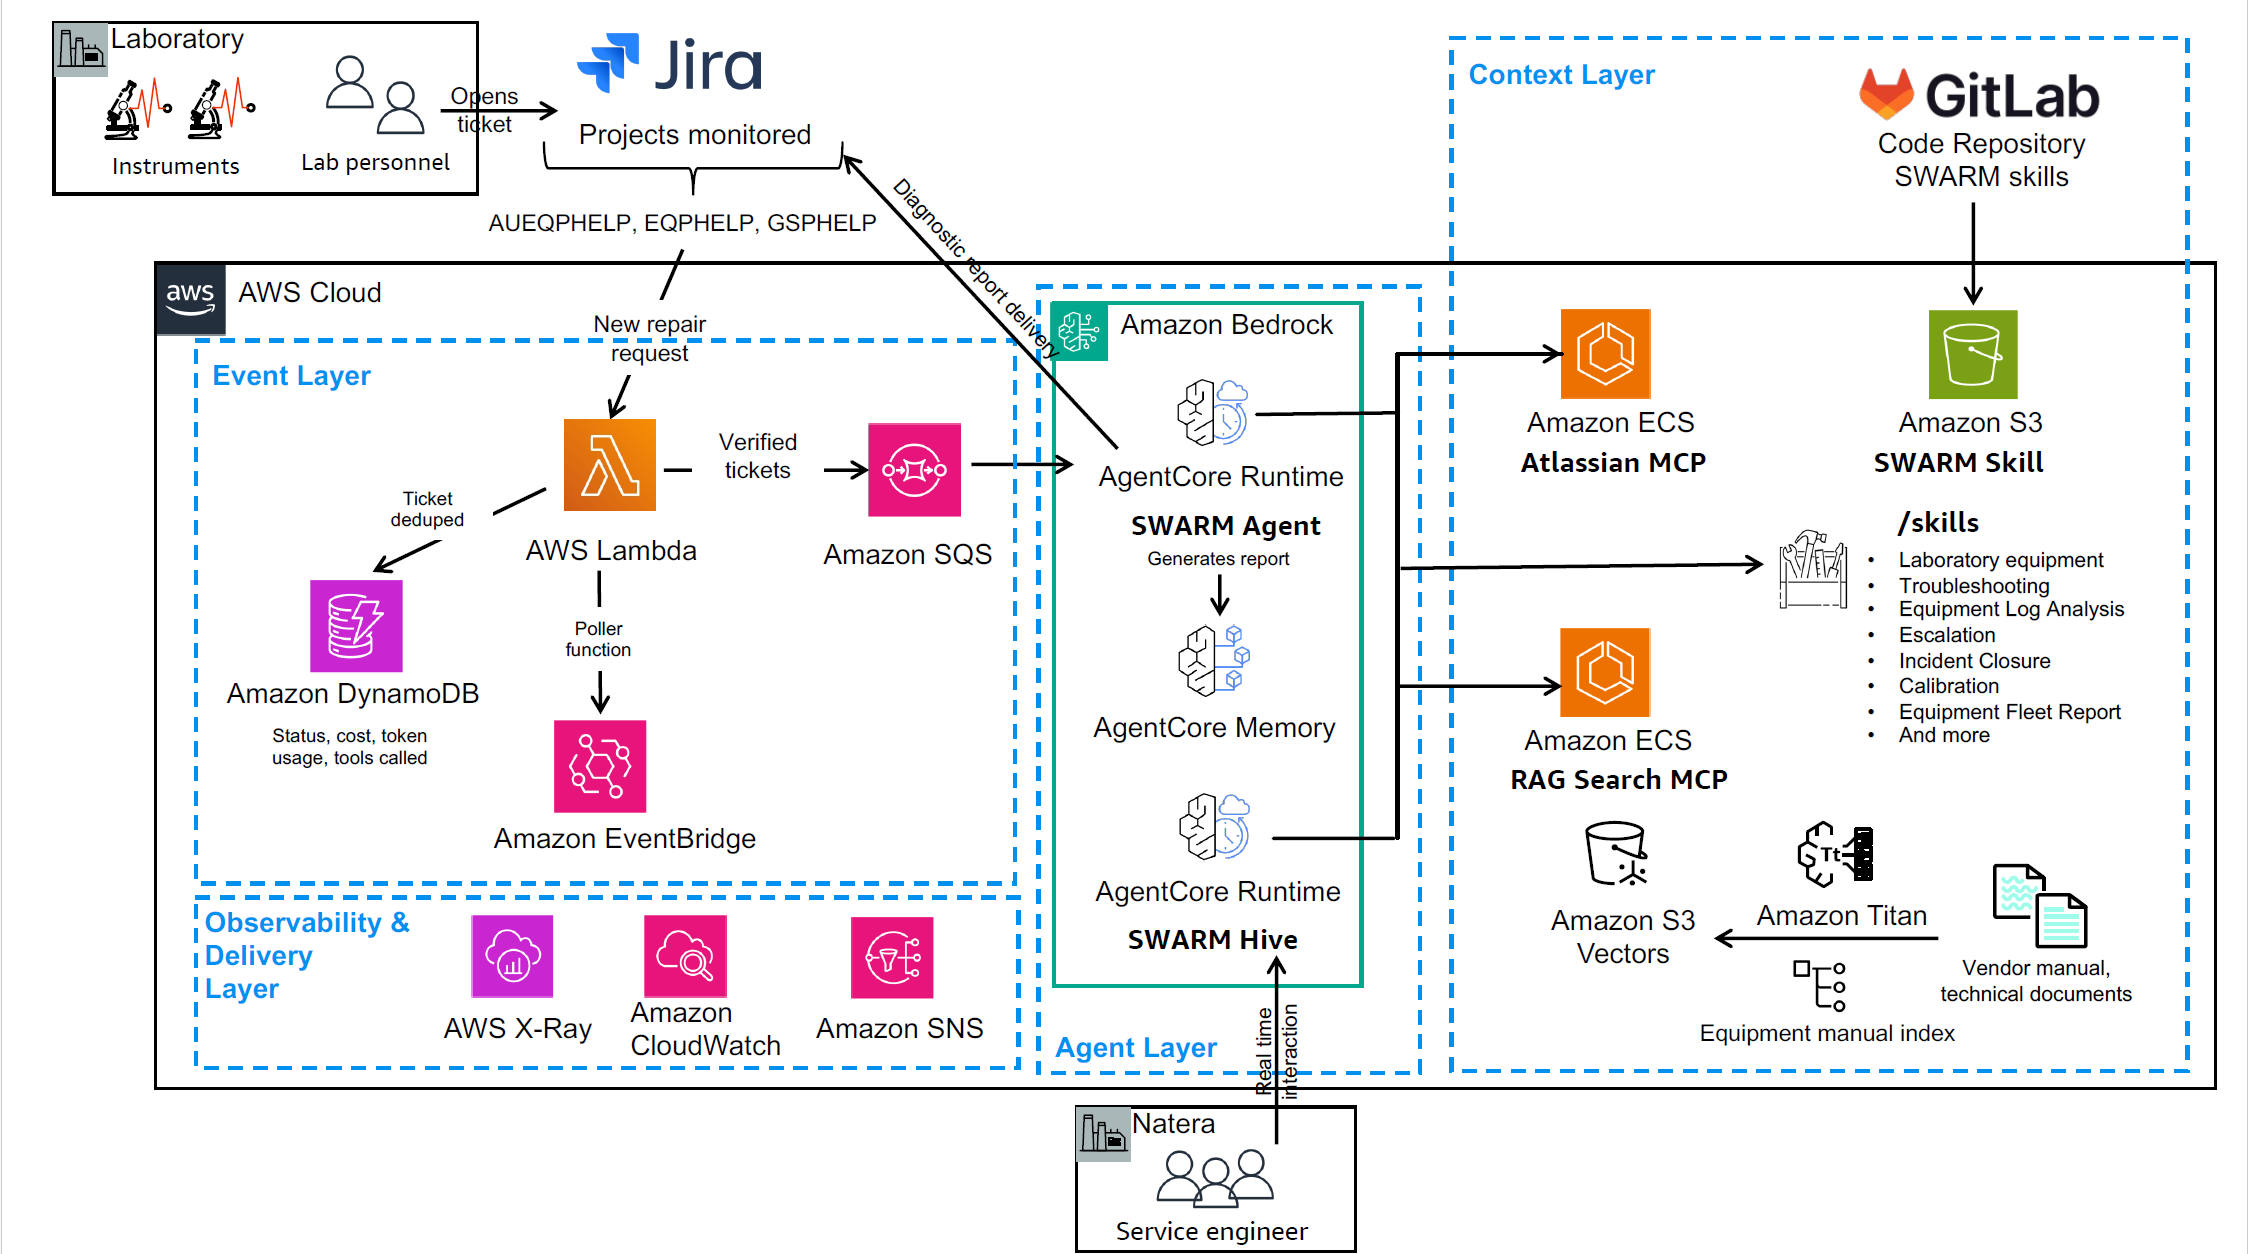
圖 1:Natera 在 Amazon Bedrock AgentCore 上的 SWARM 架構
安全架構
Natera 團隊在架構設計上的首個決定,是在哪裏運行代理程式。團隊需要一個受管理的執行環境,負責處理容器編排、擴展和安全性,同時無須團隊維護自訂基礎設施。他們選擇了 AgentCore runtime(Amazon Bedrock AgentCore 的一項功能),因為它能在安全且受管理的環境中運行 swarm-agent 和 swarm-hive,並內置身份管理和監控功能,免卻自行建構和運作自訂代理程式執行層的需要。無論選用哪個框架,你都可以採用這種模式。
團隊選擇無金鑰部署模式,因為 SWARM 在臨牀環境中運行,不能接受憑證外洩。OpenID Connect (OIDC) 和 AWS 安全權杖服務 (AWS STS)會產生按每次部署限定範圍的臨時憑證,管道中不會存放長期有效的金鑰。AWS 身份與存取管理 (IAM)會在元件層級執行最低權限原則。使用私有子網和 VPC 端點的Amazon Virtual Private Cloud (Amazon VPC)可確保流量不經公用互聯網。AWS Secrets Manager會按自動設定的 30 天週期輪替少數仍在使用的憑證。
GitLab CI 執行器會向帳戶中已設定的 IAM 身份提供者提交 OIDC 權杖,以驗證 AWS 身份。AWS STS 會將權杖交換為權限限定於部署角色的短期憑證(管道中不會存放長期有效的存取金鑰)。設定詳情請參閲IAM OIDC 提供者文件。
以下範例説明此模式:GitLab CI 的 IAM OIDC 信任政策採用以下結構:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Federated": "arn:aws:iam::ACCOUNT_ID:oidc-provider/gitlab.com"
      },
      "Action": "sts:AssumeRoleWithWebIdentity",
      "Condition": {
        "StringEquals": {
          "gitlab.com:sub": "project_path:YOUR_PROJECT:ref_type:branch:ref:main"
        }
      }
    }
  ]
}
這些基礎設施層級的安全控制會與 SWARM 的數據治理政策協同運作。兩者共同構成在受監管的臨牀環境中運作 AI 系統所需的完整合規架構。
合規與數據治理
SWARM 使用符合 HIPAA 資格的 AWS 服務,並受業務夥伴協議(BAA)規範,反映 Natera 作為臨牀實驗室營運者所承擔的責任。每次代理程式呼叫都會記錄在審計日誌中(這是可搜尋的記錄,符合資料存取可追溯性要求)。不會有任何可識別患者身份的資料進入向量索引或語言模型。工單只包含設備和工作流程中繼資料。依據 HIPAA 或類似監管框架建置系統的團隊,在設計知識庫資料管道前,應先確認 BAA 涵蓋範圍和資料分隔要求。
知識庫及文件管道建構
由於早期原型採用通用檢索方式,沒有使用設備專屬中繼資料,結果並不一致,因此 Natera 團隊建立了專為技術設備文件設計的自訂文件處理管道。Amazon Titan Text Embeddings 會產生向量表示,以供語義搜尋使用;Amazon Bedrock Knowledge Bases 則提供全代管的檢索增強生成(RAG)服務,將文件轉換為嵌入向量,再以每批 100 個的方式儲存;這個批次大小旨在平衡索引處理量與 API 速率限制。對於包含表格和圖表、結構繁複的來源文件,投資建立自訂解析管道,而非依賴預設分塊方式,能在每次診斷中持續提升準確度。
Amazon Titan Text Embeddings 在內的 Amazon Bedrock 服務,以及 Amazon Bedrock AgentCore,均在多個 AWS 區域提供。最新資訊請參閲Amazon Bedrock 支援的區域和Amazon Bedrock AgentCore 支援的區域。
Natera 團隊使用 tiktoken 分詞器和 cl100k_base 編碼來測量分塊邊界。以下範例説明瞭相關模式,分塊設定則遵循標準結構:
# Document chunking configuration
chunk_size = 1000  # tokens
chunk_overlap = 150  # tokens
encoding = tiktoken.get_encoding("cl100k_base")
batch_size = 100 # documents per embedding API call有關批次擷取模式的更多資訊,請參閲Amazon Bedrock Knowledge Bases 文件。
「診斷準確度首先是資料品質問題,」Jirau 説。「為最低分的儀器系列補上缺失的供應商手冊後,準確度由 71% 提升至 75%,而模型沒有任何變更。」
這形塑了 Natera 團隊的改進方針:當準確度停滯不前時,團隊會先檢查資料涵蓋範圍,再調整模型,因為供應商文件缺漏是最常見的漏診原因。管道會重新處理新增或更新的文件,並更新向量索引,而不會影響現有運作。
技能庫架構
Natera 團隊面對一項重要的架構抉擇:將邏輯直接嵌入 Agent 提示詞,還是建立獨立且設有版本管理的技能庫。Natera 選擇了技能庫方案,因為這讓 SWARM 更容易接受審核和改進。
「當診斷有誤時,我們需要指出具體是哪項技能出了問題,而不是除錯整個系統——因此我們從一開始便建立了設有版本管理的技能庫,」Jirau 説。
技能庫包含 33 項技能:24 項專用於儀器的技能,涵蓋 Natera 支援的所有設備系列;另有 9 項跨工作流程技能,適用於各類工單。每項技能都有明確定義的介面,可獨立測試,並按照與整體系統相同的標準評估;這些技能被視為正式環境軟件,而非嵌入式提示詞邏輯。
技能架構採用明確分工:Python 負責解析 Jira 欄位或整理 HTML 報告等確定性任務;大型語言模型(LLM)技能則負責語言推理,例如解讀症狀、配對供應商文件,以及撰寫診斷説明。對於正在建構多技能 Agent 的團隊而言,將確定性 Python 技能與由 LLM 驅動的推理技能分開,是影響最大的決策之一。
Agent 執行階段部署
Natera 將診斷工作分成兩種不同的執行環境,因為自主背景分析與互動式工程協作對延遲及上下文的需求截然不同。swarm-agent 專為處理量而設。它會按設備類型及症狀選取技能、查詢知識庫,並產生結構化 HTML 報告,列出主要原因假設、按優先次序排列的故障排除步驟,以及信心程度標籤。報告會在數分鐘內傳送至 Amazon Simple Storage Service (Amazon S3),並連結至 Jira 工單。swarm-hive 則以深入分析為設計重點:工程師可以進行互動式跟進、上載圖片及探索其他處理方向,而 AgentCore memory(Amazon Bedrock AgentCore 的一項功能)會保留每位工程師跨工作階段的對話上下文。
由於 swarm-hive 接受工程師以自由格式輸入的內容,提示詞會經由 Amazon Bedrock Guardrails進行內容過濾。
事件驅動的 Jira 整合
SWARM 透過 Amazon EventBridge Scheduler及輪詢式 AWS Lambda 函數與 Jira 整合。AWS Lambda 是一項無伺服器運算服務,可在事件發生時執行程式碼,毋須設定 webhook。通過驗證的工單會進入 Amazon SQS 佇列,以確保可靠傳送。DynamoDB 使用工單 ID 作為分區鍵,並以存留時間(TTL)為基礎設定到期機制,處理重複資料;同時儲存每次執行的中繼資料,例如狀態、成本及 token 用量,供評估迴圈使用。這個 EventBridge-to-SQS 模式將代理程式執行環境與工單系統的可用性解耦。
以下範例展示這種模式。用於去重的資料表採用最精簡的結構,並以 TTL 為基礎設定到期機制:
dynamodb.create_table(
    TableName='swarm-deduplication',
    KeySchema=[
        {'AttributeName': 'ticket_id', 'KeyType': 'HASH'}
    ],
    AttributeDefinitions=[
        {'AttributeName': 'ticket_id', 'AttributeType': 'S'}
    ],
    TimeToLiveSpecification={
        'Enabled': True,
        'AttributeName': 'ttl'
    }
)
可觀測性設計
若沒有每次呼叫的追蹤,包含多個互動元件的代理式系統便難以除錯,因此 Natera 團隊在首次正式部署前,已將可觀測性納入 SWARM 的設計。若你在正式環境運行代理程式,每次呼叫的追蹤不可或缺:沒有追蹤,要找出錯誤診斷的原因,就只能猜測是哪項技能出錯。
在臨牀實驗室環境中,儀器停機會直接影響患者報告的出具,因此追蹤、監察警示及審核每項代理程式操作的能力,並非「有了更好」,而是監管及營運上的要求。
SWARM 的可觀測性技術組合使用 Amazon CloudWatch,為每次執行記錄可搜尋的日誌,清楚呈現系統的營運狀況。AWS X-Ray 會追蹤每次執行從接收工單到產生診斷報告的整個過程,並記錄每次工具呼叫所需的時間及成本,讓團隊在遇到緩慢或成本高昂的情況時,能找出相關的具體技能,而不必猜測。Amazon Simple Notification Service會透過電郵發送失敗警示,而 Slack 追蹤工具則讓整個團隊即時掌握代理程式的活動。
持續評估方法
SWARM 採用持續評估循環,而非只在部署時測試一次;對於處理不斷變化的文件或持續演進的工作流程的系統,這一點尤其重要。每處理一張工單,代理程式都會提供主要成因假設、按優先次序排列的疑難排解步驟,以及自行評定的信心標籤。工程師會記錄調查結果和修復內容,評估器則按儀器系列分類,將每個回覆評為「準確」、「部分準確」或「錯誤」。團隊會檢視結果,找出代理程式表現欠佳之處,採取修正措施(通常是更新知識庫),然後重新執行評估集,以確認表現有所改善。
SWARM 自行評定的信心標籤,與實際準確度呈現一定的關聯趨勢。標記為高信心的工單,在 154 個已評估個案中準確率達 74%;中等信心和低信心工單的準確率則同為 65%,分別涵蓋 78 個和 37 個個案。請注意,中等信心和低信心目前的準確率相同。低信心組別只有 37 個個案,樣本數太少,未能得出具統計意義的結論;Natera 團隊預期,隨着評估數據集擴大,兩個級別的差異會逐漸顯現。
高信心組別與其餘級別之間的差距,為工程師提供了有用訊號,讓他們在閲讀診斷報告時判斷應給予各項診斷多少權重。
SWARM 的表現
Natera 團隊評估了 SWARM 處理 524 張支援工單的表現,以建立效能基準。在評估集的 524 張工單中,有 269 張獲標記為高、中等或低信心,並有相應的工程師核實解決方案可供比較。其餘工單則標記為「無」,或在分析時尚未有經核實的解決方案。
首次回覆時間由 17.4 小時降至約 8 分鐘(快約 130 倍)。這些數據取自為期 90 日的正式環境評估期間的 Jira 工單中繼資料。覆蓋率同樣重要:96.2% 的工單會自動收到首次回覆,無需工程師啟動診斷流程。覆蓋率是按在工程師檢視前收到 SWARM 生成的診斷報告的來件工單百分比計算。
在正式環境中構建代理式 AI 的經驗
SWARM 的多項架構決策,對構建類似系統的團隊同樣適用。
- 將區塊大小和重疊量視為可調整參數。合適的數值取決於來源文件的結構。
- 從一開始便在技能庫中建立可追溯性。診斷出錯時,你應能指向特定技能,而不必為整個系統進行除錯。
- 如果工作負載同時包含批次處理和互動式查詢,應將兩者分開,使用不同的執行環境。
開始使用
你可以透過 AgentCore 範例儲存庫、在 AWS 上構建代理式系統,或 Amazon Bedrock AgentCore 入門指南,親自嘗試這些模式;指南亦介紹如何安全地大規模部署代理程式。面對機構知識流失、大量營運工作流程或臨牀合規要求等類似挑戰的醫療保健及生命科學機構,會發現 Natera 團隊為 SWARM 開發的架構模式,為在 AWS 上構建代理式 AI 系統提供了可複製、經正式環境測試的基礎。
作者簡介

Ariel Jirau
Ariel 是 Natera 的首席軟件工程師,負責企業級應用所需的技術實施及基礎設施決策,並監督 SWARM 的系統架構和正式環境部署。

Veronica Rule
Veronica 是 AWS 的高級客戶解決方案經理,在支援醫療保健及生命科學領域的客戶採用雲端方面擁有超過 10 年經驗。她專長於引導機構採用 AI/ML、制定代理式 AI 策略,以及推行雲端轉型計劃。她熱衷於連繫先進 AI 能力與醫療保健及生命科學領域的實際成果。

Tamara Gagliardi
Tamara 是 AWS 的高級解決方案架構師,在科技領域擁有超過 15 年經驗,曾涉足金融服務、零售及製造業等行業。近年來,她專注於醫療保健及生命科學領域,與醫療器材及生物診斷客戶緊密合作,加快他們的雲端轉型。作為值得信賴的技術顧問,Tamara 協助機構將複雜的業務挑戰轉化為可擴展且安全的技術方案,並特別重視生成式 AI,指導客戶找出影響深遠的應用場景,並設計智能工作流程。
來源:AWS Machine Learning Blog · aws.amazon.com