Amazon SageMaker Inference 回顧 2026 年 14 項更新(第二部分)
Amazon SageMaker Inference: 2026 launches in review, part 2
Amazon SageMaker Inference 第二部分回顧 14 項 2026 年更新,涵蓋託管端點與 HyperPod Inference 的模型配置、GPU 利用率、多節點服務、路由及部署後監察。
文章按部署後的配置、GPU 利用率、多節點服務及跨區路由等問題梳理 14 項更新,並以假設的支援團隊案例説明各項功能所對應的運作情境。
由首個端點到全球機羣:受管端點及 HyperPod Inference 再推出 14 項功能
9 月的文章 Amazon SageMaker Inference: 2026 year-to-date launches in review 回顧了 13 項推出項目,讓模型投入正式環境提供服務的流程更快捷。大部分項目都回答了一個問題:如何讓這個模型快速、可靠地提供服務?本文介紹其後推出的 13 項功能,令 2026 年的推出項目總數增至 26 項。
模型投入正式環境後,團隊關心的問題便會改變。他們想知道,流量數據反映實際情況後,模型目前應採用哪種配置;如何在已付費的 GPU 上部署更多模型;下一個模型大到無法在一部機器上運行時應怎麼辦;為甚麼某個區域的請求需要等候,另一個區域的 GPU 卻閒置;以及為甚麼沒有人作出變更,延遲卻有所上升。本文按團隊通常遇到這些問題的次序逐一探討。
對於 HyperPod Inference,文章列出更多路由策略、更廣泛支援模型服務框架,以及擴展多區域網絡。Inference Gateway 和 Global Inference Gateway 帶來路由及多區域功能,而受管 NVIDIA Dynamo 則是新的服務框架。至於受管端點,發展方向是與 AWS AI 生態系統的其他部分進一步整合。現在可透過 Amazon SageMaker AI Studio、SageMaker Python SDK,以及工程師已在使用的編碼代理程式執行推理建議;端點也可以跨區域及帳戶路由請求。
為了讓各部分內容更具體,我們會在本文中跟隨一個假想團隊的經歷。春季時,他們根據第 1 部分介紹的推出項目,在單一 SageMaker AI 端點上部署了一個以 70B 參數模型為基礎的客戶支援助手。到了秋季,他們需要支援更多產品線、採用更大型的推理模型、在第二個區域服務客戶,並維持 GPU 開支不變。
各項推出一覽

圖 1:本文的五個階段及各階段的推出項目
無論在哪個工作環境,都能選擇合適的配置
團隊在 4 月根據一次基準測試選定了首個配置。此後,他們新增了四個 LoRA(低秩適配)適配器,每個產品線各一個;產品團隊亦訂下目標,要求高峯負載下的首個 token 時間(TTFT)為 500 毫秒。團隊從未使用這兩項新條件測試 4 月選定的配置。負責重新分析的工程師會使用筆記本及編碼代理程式工作,而其中很少人會使用主控台。
推理建議於 4 月以 API 形式推出。其後四次更新令團隊可在更多工作環境中使用這項功能,並讓它回答兩個更複雜的問題:端點可承載多少個適配器,以及在未達到延遲目標前可支援多少並行請求。新增的代理程式技能,則讓編碼代理程式也能運用同樣的專業能力。
SageMaker AI Studio 中的推理建議(2026 年 7 月)
網誌: 在 Amazon SageMaker AI 推出生成式 AI 推理建議使用者介面
4 月推出的功能透過 API 自動選擇執行個體、容器及最佳化方式。現在亦可在 SageMaker AI Studio 使用推理建議功能,透過引導式低程式碼工作流程完成操作。在 Studio 中,選擇 工作,然後選擇 推理最佳化。選擇用途設定檔(互動、生成、摘要或自訂)、最佳化目標(盡量降低延遲、盡量提高吞吐量或盡量降低成本),以及 SageMaker JumpStart、Amazon Simple Storage Service (Amazon S3)、Model Registry 或現有 SageMaker 模型中的模型。
SageMaker AI 會在實際 GPU 基礎設施上使用 NVIDIA AIPerf 對候選配置進行基準測試,並套用符合目標的技術,例如透過推測解碼提升吞吐量,或透過核心調校降低延遲。你可以比較按 TTFT、token 間延遲、吞吐量及成本排序的結果,然後直接在 Studio 將選定配置部署至即時端點。
SageMaker Python SDK v3 的推理建議(2026 年 8 月)
網誌:Amazon SageMaker Python SDK 的 LLM 最佳化整合
以往,基準測試及建議功能需要透過 SageMaker AI Studio 或直接呼叫 Boto3 才能使用。現在,這些功能已納入 SageMaker Python SDK v3(3.17.0 及後續版本),與團隊用於訓練及部署的介面一致,讓工作流程能融入筆記簿、CI pipeline 及 MLOps 工作流程。你可以根據工作負載流量對線上端點進行基準測試,按延遲、吞吐量或成本目標產生排序建議,並透過單次呼叫將排名最高的配置部署至即時端點。
SDK 亦支援較長的工作流程。你可以平行執行建議工作,比較 LMI 和 vLLM 等服務框架;亦可以從已完成的工作繼續,讓部署在另一個筆記簿或 pipeline 階段進行,而無須重新執行基準測試。
推理建議支援 LoRA adapter(2026 年 9 月)
開發人員指南:取得支援 LoRA adapter 的模型建議
不少團隊會使用 LoRA adapter,讓同一個基礎模型適用於多種用途。每個保留在 GPU 記憶體中的 adapter 都會減少端點可處理的並行請求數目;合適的配置則取決於執行個體類型、adapter 數目及流量模式。
現在,推理建議功能接受以 Model Package Amazon Resource Name (ARN) 提供的 adapter(適用於由 SageMaker 微調產生的 adapter),或以 S3 URI 提供的 adapter(適用於 Hugging Face PEFT 等外部 pipeline 產生的 adapter)。SageMaker AI 會在實際 GPU 基礎設施上,針對不同 adapter 數目及並行度組合進行基準測試,並按你的工作負載提供排序結果。輸出會列出每個 adapter 的兩種格式。建議的部署方式會使用 SageMaker Inference Components,為基礎模型及每個 adapter 各設一個元件,讓你新增、更新或移除 adapter 時,不會影響基礎模型或其他 adapter。
以 SLA 為基礎的並行度搜尋(2026 年 9 月)
網誌: 透過 Amazon SageMaker AI 的並行度掃描,為生成式 AI 端點調整合適規模
為端點調整合適規模,指找出端點能夠持續承受的最高並行度,同時不超出延遲或錯誤率目標。以往,你需要手動選擇並行度、執行掃描、根據服務水平協議(SLA)檢查結果,並在模型或執行個體變更時縮小範圍後重複測試。
推理建議現已加入搜尋功能,可直接找出該界線。將 search_recipe 設為 max-concurrency-under-sla,並為最大 TTFT、每個輸出 token 的最長時間、最大端到端延遲及最高錯誤率中的任意組合設定目標。基準測試引擎(AIPerf)會從較大的範圍開始,根據各項探測測試是否通過來縮小範圍,並以少於線性掃描的迭代次數收斂。結果會回報可通過測試的最大並發數(feasible_max);若沒有任何級別符合條件,則回報未通過的最小級別(infeasible_min)。
這項搜尋使用與並發掃描相同的 CreateAIWorkloadConfig 和 CreateAIBenchmarkJob API。選用參數(concurrency_min、concurrency_max、search_max_iterations 和 search_initial_points)可限制成本並加快收斂。
適用於最佳化生成式 AI 推理的 Agent 技能(2026 年 10 月)
網誌: 全新 Agent 技能:適用於編碼 Agent 的 Amazon SageMaker 最佳化生成式 AI 推理
工程師愈來愈常詢問他們的編碼 Agent,應使用哪個執行個體和容器。若缺乏有根據的知識和實際基準測試,Agent 只能猜測;選錯執行個體,之後便可能無法達到延遲目標,或造成開支浪費。
透過 Agent Toolkit for AWS 提供的 aws-ai-ml skill,讓 Kiro 等編碼 Agent 具備內置的 SageMaker AI 推理專業知識。工程師只需用日常語言描述需求,Agent 便可:
- 找出合適的執行個體。 為存放在 Amazon S3、SageMaker JumpStart 或 Hugging Face Hub 的模型,提供按排名排列的部署選項及實測吞吐量、延遲和 TTFT。
- 為即時端點進行基準測試。 根據實際負載產生報告,涵蓋吞吐量、P50 和 P99 延遲、token 間延遲,以及支援的並發數。
- 比較執行結果。 列出每項指標的百分比變化,顯示設定變更是否有幫助。
回覆以實測效能為依據,並以 SageMaker Python SDK v3 程式碼形式提供,工程師可先審閲,再使用自己的憑證執行。設定約需 10 分鐘。這項 skill 適用於任何支援 Model Context Protocol(MCP)的 Agent,也可在 SageMaker AI Studio JupyterLab 空間使用。
對支援團隊而言,一項包含全部四個適配器的建議工作,接着以 500 毫秒 TTFT 目標進行並發搜尋,便可取代他們在 4 月進行的手動掃描。負責這項工作的工程師可從筆記本啟動工作,或要求編碼 Agent 執行。
讓每張 GPU 容納更多模型
支援助手並非單獨運作。嵌入模型、重排序模型,以及負責分流工單的小型分類器都在同一帳戶中運作,而且各自只使用部分 GPU 資源。在標準端點上,每個模型副本仍會佔用整個加速器,因此團隊的可用部署位置已經用完,GPU 記憶體卻仍未充分使用。
SageMaker AI 主控台中的 Inference Components(2026 年 10 月)
開發人員指南: SageMaker AI 主控台中的 Inference Components
使用 Inference Components,你可以在同一端點上託管多個模型,並分別設定和擴展各個模型。此前,這項功能只能透過 SDK 和 AWS Command Line Interface(AWS CLI)使用。每次建立、調整規模及設定擴展政策都必須編寫指令碼,而且沒有統一介面可檢視各模型使用的資源。
現在,你可以在 SageMaker AI 主控台建立、檢視、更新及刪除推理元件:
- 建立及編輯。 建立包含推理元件的端點,之後新增或刪除元件,並調整各元件的加速器、CPU、記憶體和副本數。
- 為每個模型調整資源規模。為每個元件設定自動擴展政策,最多可縮減至零個副本,讓閒置模型停止佔用加速器資源。
- 監察。在同一頁面查看警報和各元件指標。
主控台呼叫的 SageMaker AI API 與 SDK 和 CLI 使用的相同,因此團隊可以先從主控台開始,之後再自動化;亦可以透過主控台以視覺化方式管理以指令碼設定的元件。
使用 NVIDIA Multi-Instance GPU 進行 GPU 分割(2026 年 10 月)
網誌: SageMaker Inference 現支援 Multi-Instance GPU,提升模型端點的 GPU 使用率
GPU 分割採用 NVIDIA Multi-Instance GPU (MIG) 技術,視乎加速器而定,可將一個實體 GPU 分成最多七個分割區。每個分割區均有專用的 GPU 運算資源和記憶體,並具備完整的硬件隔離。建立用於推理元件的端點時,你可以定義分割配置,並為每個元件選擇分割區類型。應用程式仍按推理元件名稱呼叫模型,因此用戶端程式碼毋須更改。
MIG 可隔離不同分割區的 GPU 運算資源和記憶體。同一個執行個體上的模型仍會共用主機 CPU、主機記憶體、網絡、儲存空間和端點路由。你須按整個執行個體小時支付標準費率,因此節省成本的方式是在每個執行個體上放置更多模型,而非降低每小時價格。
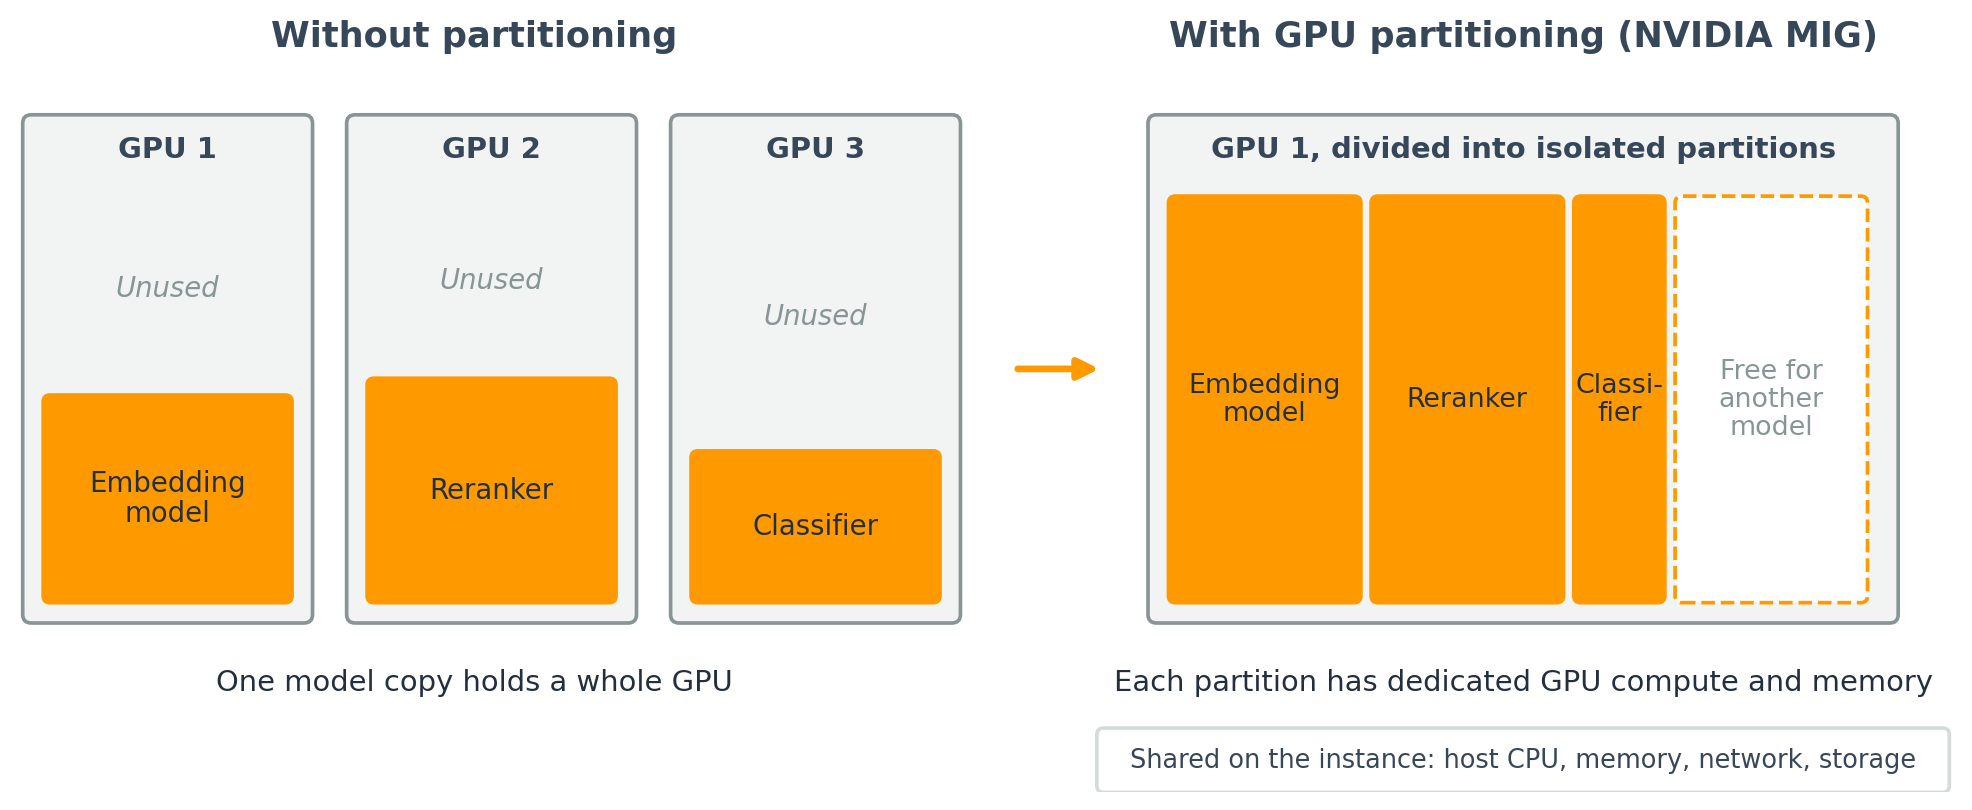
圖 2:三個小型模型分別在三個 GPU 上執行,與相同模型分別在同一個 GPU 的分割區中執行的比較
對支援團隊而言,嵌入模型、重排序模型和分類器現在分別在單一端點上一個 GPU 的不同分割區中執行;團隊可從主控台管理每個元件,包括助理及其適配器。
為超出單一執行個體容量的模型提供服務
團隊的下一個模型是推理模型,單是其權重所需的記憶體,已超出任何單一執行個體的 GPU 記憶體容量。他們亦留意到,檢索密集型提示詞會拖慢端點上其他所有用戶的 token 生成速度。對於這種規模的模型,他們會將工作負載轉移至 HyperPod Inference,使用專用叢集和 Kubernetes 原生控制。支援助理則繼續使用受管端點。
在 HyperPod Inference 上使用受管 NVIDIA Dynamo(2026 年 11 月)
網誌: Amazon SageMaker HyperPod Inference 上的受管 NVIDIA Dynamo
第 1 部分介紹了 HyperPod 上大型模型的兩項基礎技術:Inference Operator v3.2 中的解耦式預填充與解碼,以及受管分層 KV 快取中的 KV 感知路由。這次推出的功能加入多節點服務,並改變了整套技術堆疊的操作方式。NVIDIA Dynamo 是開源推理框架,提供多節點分片式服務、解耦式預填充與解碼,以及 KV 感知路由。團隊之前已可在自己的 Kubernetes 叢集上執行 Dynamo,但必須自行建置和操作周邊的一切:將副本的所有節點配置在一起、連接 Elastic Fabric Adapter (EFA) 網絡,讓預填充階段能以硬件速度將 KV 快取交給解碼階段、維護服務映像檔,以及在某個節點故障導致多節點副本停止運作時進行復原。
推出這項功能後,Dynamo 會在 HyperPod 上以受管服務引擎的形式執行。Dynamo 會負責作出服務決策:如何將模型分片、如何拆分預填充和解碼,以及將每項請求路由至何處。HyperPod 則提供這些決策所需的條件:
- 容量和網絡。自動配置並連接 GPU 容量和 EFA 網絡。
- 節點復原。監察節點健康狀態並替換節點;節點故障時,會自動重新排程多節點工作者。
- 端點操作。自動擴展、端點註冊、TLS 及可觀測性。
- 統一的安裝及升級流程。Inference Operator 附加元件會將 Dynamo、服務映像檔,以及 Grove 和 KAI 排程器作為一個整體安裝,並一併升級。
Dynamo 為 HyperPod 帶來以下功能:
- 多節點(分片)推論服務。同一個模型副本橫跨多個節點,讓你可以為無法由任何單一執行個體容納的模型提供服務。
- 分離式預填充與解碼。提示詞處理和 token 生成會在不同的 GPU 資源池中執行,每個資源池使用適合其工作的執行個體類型,因此長提示詞不再拖慢其他用戶的回應。
- KV 感知路由。每項請求都會傳送至已持有其 KV 快取的工作者,從而縮短 TTFT。
有三種啟動方式。在自主管理 Kubernetes 上執行 Dynamo 的團隊,可以大致不作修改地沿用現有的 DynamoGraphDeployment(DGD)部署清單。已使用 HyperPod Inference 的團隊可以更新附加元件,並將簡短的 dynamoSpec 區塊加入現有的 InferenceEndpointConfig;HyperPod 會將其轉換為 DGD,而現有端點會繼續提供服務。尚未使用這兩者的團隊,可以透過主控台建立已啟用附加元件和 Dynamo 的叢集。無論採用哪種方式,用戶端都會呼叫標準的 OpenAI 相容端點,因此毋須更改用戶端程式碼。
Managed Dynamo 支援 vLLM、SGLang 和 TensorRT-LLM,並於Amazon SageMaker HyperPod提供服務的區域推出。
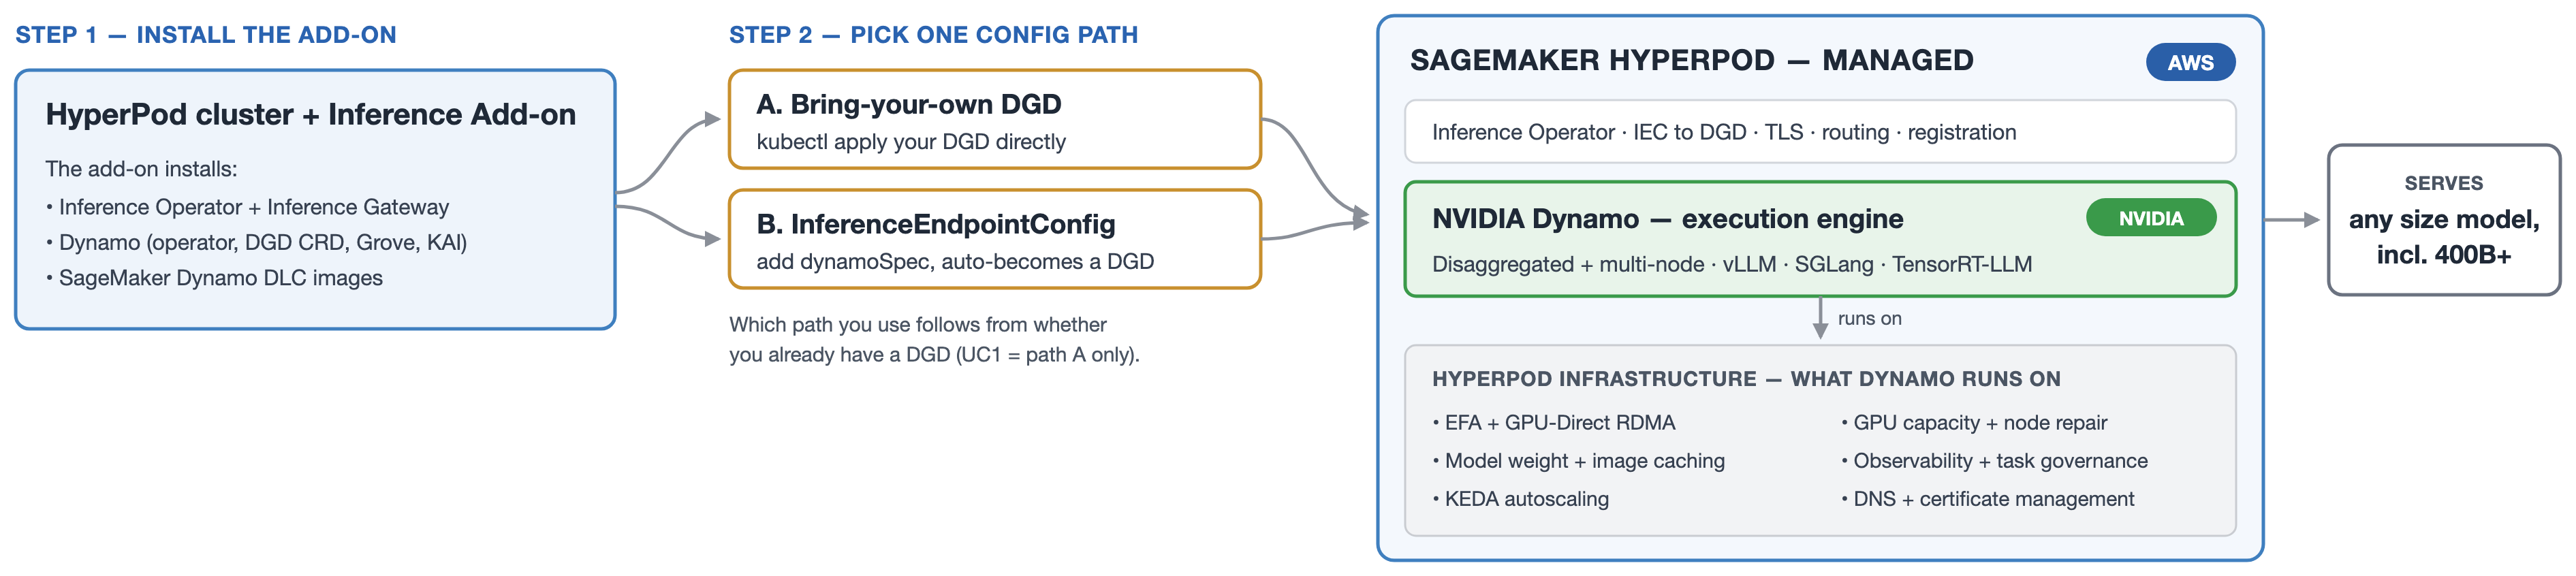
圖 3:HyperPod Inference 上的受管 NVIDIA Dynamo
對支援團隊而言,推理模型會以一個分片副本的形式在多個節點上執行,並使用獨立的預填充和解碼資源池。節點故障時,HyperPod 會替換該節點並重新排程副本,毋須通知值班工程師。
將每項請求傳送至可為其提供服務的 GPU
支援助理現已為北美和歐洲的客戶提供服務,因此團隊在兩個區域執行端點和 HyperPod 叢集。美國早上繁忙時段,請求在美國區域排隊等候,團隊已付費使用的 GPU 卻在歐洲閒置。部分歐洲流量亦必須留在歐洲。
路由決定團隊擁有的容量能否發揮作用。路由分為四個層級,以下推出的功能各涵蓋其中一個層級:在端點內由哪個執行個體處理請求、在 HyperPod 叢集內由哪個 Pod 處理請求、在資源羣組中使用哪個叢集,以及在不同區域和帳戶之間使用哪個區域端點。

圖 4:兩種部署路徑中的跨區域路由,以及各端點或叢集內部的路由
端點的 KV 快取感知路由(2026 年 11 月)
網誌:Amazon SageMaker AI 即時端點現已支援 KV 快取感知路由
提示詞較長或包含多輪對話的應用程式,會在多項請求中重複使用大段相同的前綴。模型伺服器可以重用相符的 KV 快取,但前提是下一項請求送達持有該快取的執行個體。第 1 部分介紹的前綴感知路由會為每個提示詞的開頭建立指紋,並將相符的提示詞傳送至同一個執行個體。由於它根據請求記錄運作,隨着模型伺服器新增及淘汰快取項目,它對各執行個體快取狀態的掌握會變得較不準確。
KV 快取感知路由會使用模型容器回報的快取狀態。容器會將快取建立及淘汰事件發佈至中央快取索引,而 SageMaker AI 會把每項請求路由至符合條件、持有最長匹配快取前綴的執行個體。這可提高長上下文提示詞、多輪對話,以及共用動態提示詞前綴的工作負載的快取重用率。
此功能適用於單一模型端點,以及使用推論元件(包括 LoRA 配接器)的端點。它支援 InvokeEndpoint、InvokeEndpointWithResponseStream,以及用於 Completions 和 Chat Completions 請求內容的 OpenAI 相容 API。你可在端點設定中啟用此功能。首個版本要求使用經 AWS 驗證的模型容器,並實作快取事件、分詞、指標及 OpenAI 相容介面。你可在詳細推論可觀測性中追蹤 KV 快取命中率。
應使用哪一種。前綴感知路由適用於任何容器,無需修改容器。KV 快取感知路由則需要經驗證的容器,並會追蹤實際快取;當前綴變化較大或快取快速更替時,這種方式尤其有用。
Inference Gateway for HyperPod (September 2026)
網誌: 推出 Amazon SageMaker HyperPod Inference Gateway
在 HyperPod 叢集內,容量和需求很少能完全配合。一個 Pod 可能正在處理長上下文請求,KV 快取幾乎已滿;另一個 Pod 卻閒置,或已載有下一項請求所需的提示詞前綴或 LoRA 配接器。若無法掌握這些 GPU 狀態,新請求便會排在忙碌的 Pod 後面,而團隊為了維持延遲表現,會額外加入 GPU,而非善用現有資源。每個模型也各自使用不同端點,因此用戶端必須為每個模型追蹤一個端點。
Inference Gateway 是一款可感知 GPU 狀態的路由器,會隨 HyperPod Inference Operator 附加元件一同安裝,並為每個叢集的所有模型提供一個 OpenAI 相容端點。處理每項請求時,它會讀取每個模型 Pod 的即時訊號,並選擇最合適的 Pod;你可按工作負載調整以下項目的權重:
- KV 快取使用率。避開快取接近滿載的 Pod。
- 佇列深度及執行中的請求。避開有待處理請求的 Pod,並平衡目前工作量。
- 前綴快取命中率。優先選擇可能已載有提示詞前綴的 Pod。
- LoRA 配接器駐留情況。優先選擇已載有所需配接器的 Pod,避免交換延遲。
與循環式路由相比,在混合 GPU 世代環境下,P99 TTFT 最多降低 97%;在突發流量下則最多降低 98%。所有提供 SageMaker HyperPod 的區域均可使用此功能。
Global Inference Gateway for HyperPod (November 2026)
網誌: 推出 Amazon SageMaker HyperPod Global Inference Gateway
Inference Gateway 會在叢集內進行路由,而每個叢集只能處理傳送至該叢集的請求。某個區域的叢集可能已飽和,令請求需要等待;與此同時,另一個區域的 GPU 卻處於閒置狀態。用戶端必須自行選擇叢集;若叢集發生故障,工程師便要手動轉移流量。
Global Inference Gateway 會為團隊在每個已註冊的叢集提供一個由 SageMaker 管理的端點。每次收到請求時,它會根據佇列深度、可用 KV 快取、與呼叫方的距離及近期錯誤率為各叢集評分,然後透過 AWS 私有骨幹網絡將請求傳送至評分最高的叢集。該叢集中的 Inference Gateway 仍會負責選擇 Pod。請求使用 SigV4 和 IAM 進行驗證。當叢集容量飽和或狀態不健康時,流量會在 30 秒內轉至次佳叢集,用戶端無須採取任何操作;叢集恢復後便會重新加入資源池。路由權重可調整;如未設定,系統會使用預設值。
新增或移除模型或叢集,不會影響呼叫該端點的應用程式。叢集只有在發佈後才可連線,而已發佈的資源會保留在你的帳戶中。Global Inference Gateway 可在AWS 文件所列的區域使用。

Amazon SageMaker AI 中的 Cross-Region Inference Routing
網誌: 透過 Amazon SageMaker AI 的 Cross-Region Inference Routing,在區域容量不足時維持推理服務運作
在受管理端點上,同一概念以 Cross-Region Inference Routing 的形式實現。這是一種受管理的路由方式,可將即時及非同步請求傳送至團隊已部署的區域端點,這些端點可以位於同一帳戶或不同帳戶。你可將提供相同模型服務的端點組成一個路由目標,讓應用程式呼叫該目標,而非特定的區域端點。路由器不會增加容量、複製模型或部署端點,而現有的呼叫路徑仍可正常運作。
路由器取代了團隊目前自行建構的容錯切換邏輯:
- 單一呼叫路徑。 SageMaker 會先嘗試本機端點;如果本機端點無法處理請求,便會將流量轉至另一個已註冊的端點。
- 單一路由政策。 該政策結合端點指標與服務端容量訊號,包括客戶無法自行觀察到的容量不足錯誤。
- 私有連線。 跨區域流量會透過 AWS PrivateLink 傳送,並採用受管理的跨帳戶授權機制,因此路由至其他區域或帳戶時,無須使用互聯網或 NAT 閘道。
- 流量溢出及資料駐留限制。 端點擁有者可限制備援端點可接收的跨區域流量上限,而應用程式則可限制哪些區域可以處理請求。
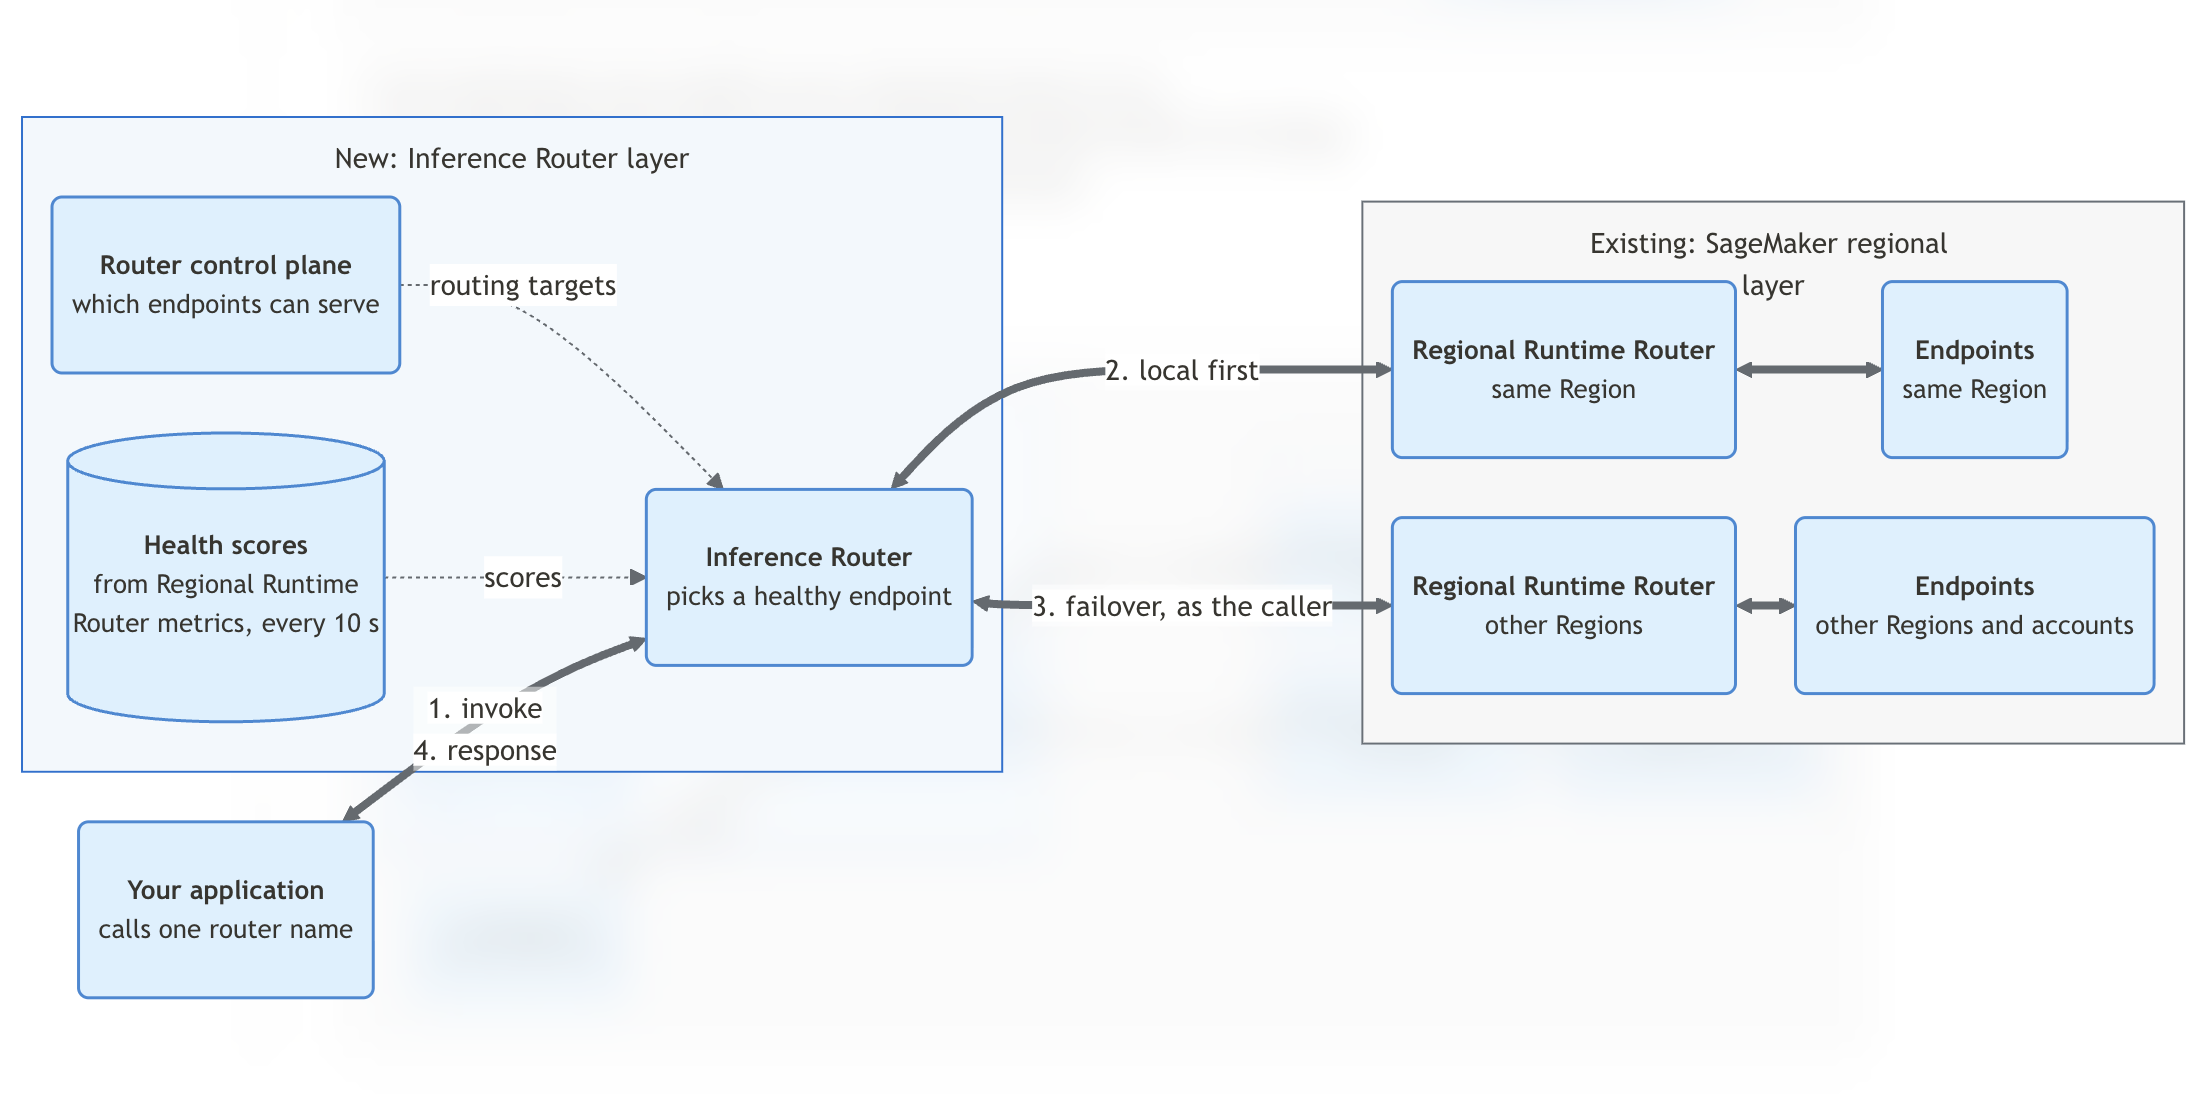
圖 5:Cross-Region Inference Router 請求流程
兩項跨區域功能的推出,將同一概念應用於各自的部署路徑。團隊繼續管理自己的叢集和端點,而 SageMaker 則提供路由、私有連線及容錯切換功能。
| Global Inference Gateway | Cross-Region Inference Router | |
| 部署路徑 | HyperPod Inference | 受管理端點 |
| 路由範圍 | 任何區域中已註冊的 HyperPod 叢集 | 跨區域及帳戶的已註冊區域端點 |
| 連線方式 | AWS 私有骨幹網絡、SigV4 和 IAM | AWS PrivateLink、受管理的跨帳戶授權 |
| 容錯切換 | 自動執行,30 秒內完成 | 本機端點無法處理請求時自動執行 |
| 擁有者控制項目 | 叢集只有在發佈後才可連線 | 可為每個備援端點設定流量溢出上限,並為每個應用程式設定區域限制 |
對支援團隊而言,現時美國早上的流量高峯在兩條路徑上都會轉由歐洲的可用容量承接;必須留在歐洲的請求,則會在路由器政策中限制至歐洲區域。
上線後持續調校端點
遷移兩個月後,團隊為支援助理加入檢索功能,平均提示詞長度大約增至兩倍。TTFT 現在比上線時高,但系統沒有故障,因此所有警報仍然顯示正常。團隊找到更好的設定後,需要把它推出至大型 GPU 執行個體;這類執行個體很難取得更多。
持續效能監控(2026 年 11 月)
網誌:Amazon SageMaker AI 現可偵測推論端點的延遲漂移、GPU 閒置及錯失的最佳化機會
Amazon SageMaker AI 現會持續監控生成式 AI 推論端點,並在變更有助提升效能或降低成本時通知你。SageMaker AI 推論端點預設會啟用監控,無須設定;你亦可選擇為個別端點停用監控。SageMaker AI 只會查看運作訊號:延遲、GPU 使用率及端點的服務設定,不會讀取你的請求或回應。當某項發現達到信心門檻時,AWS Management Console 會顯示通知;對於在筆記本和 CLI 中工作的團隊,同一則訊息亦會透過電郵送達。建議採取的動作會在 SageMaker AI Studio 中開啟 SageMaker AI 的代理式體驗,並預先填入該項發現,讓分析、比較及部署變更都在同一段對話中完成。套用變更前不會部署任何內容,而且你可以隨時關閉監控。
發現項目分為三類:
- 流量變更後的延遲漂移。當檢索功能等變更令提示詞變長時,TTFT 便會上升。此發現會按週量化效能退化幅度,並建議根據近期流量重新執行推論建議,找出可降低 TTFT 的設定。
- 部署以來一直存在的設定差距。端點從未針對其工作負載妥善調校,此發現會指出可填補差距的變更。
- 閒置的 GPU 容量。當容量連續多星期未被使用,此發現便會指出縮減端點規模、降低成本的機會。
原地滾動模型更新(2026 年 11 月)
標準滾動更新會一次替換一批端點,而每批都會使用新配置的執行個體。對大型 GPU 機羣而言,這代表每個步驟都要尋找新的容量;如果下一批執行個體無法取得,更新便可能中途失敗。每個釋出的執行個體也必須完成清理才能再次使用,令推出速度變慢。
SageMaker AI 現可原地更新模型。更新開始時,系統會配置一小批額外執行個體,把流量轉移至該批執行個體,然後更新釋出的執行個體,並重用它們將變更逐步推出至機羣其餘部分。更新仍會分階段推出,但只需取得一次新容量。以 20 個執行個體、批次大小為 2 的機羣為例,更新只需取得 2 個新執行個體,而非 20 個。客戶無須作任何變更。與第 1 部分的容器快取一樣,這項改進會自動套用於滾動模型更新。
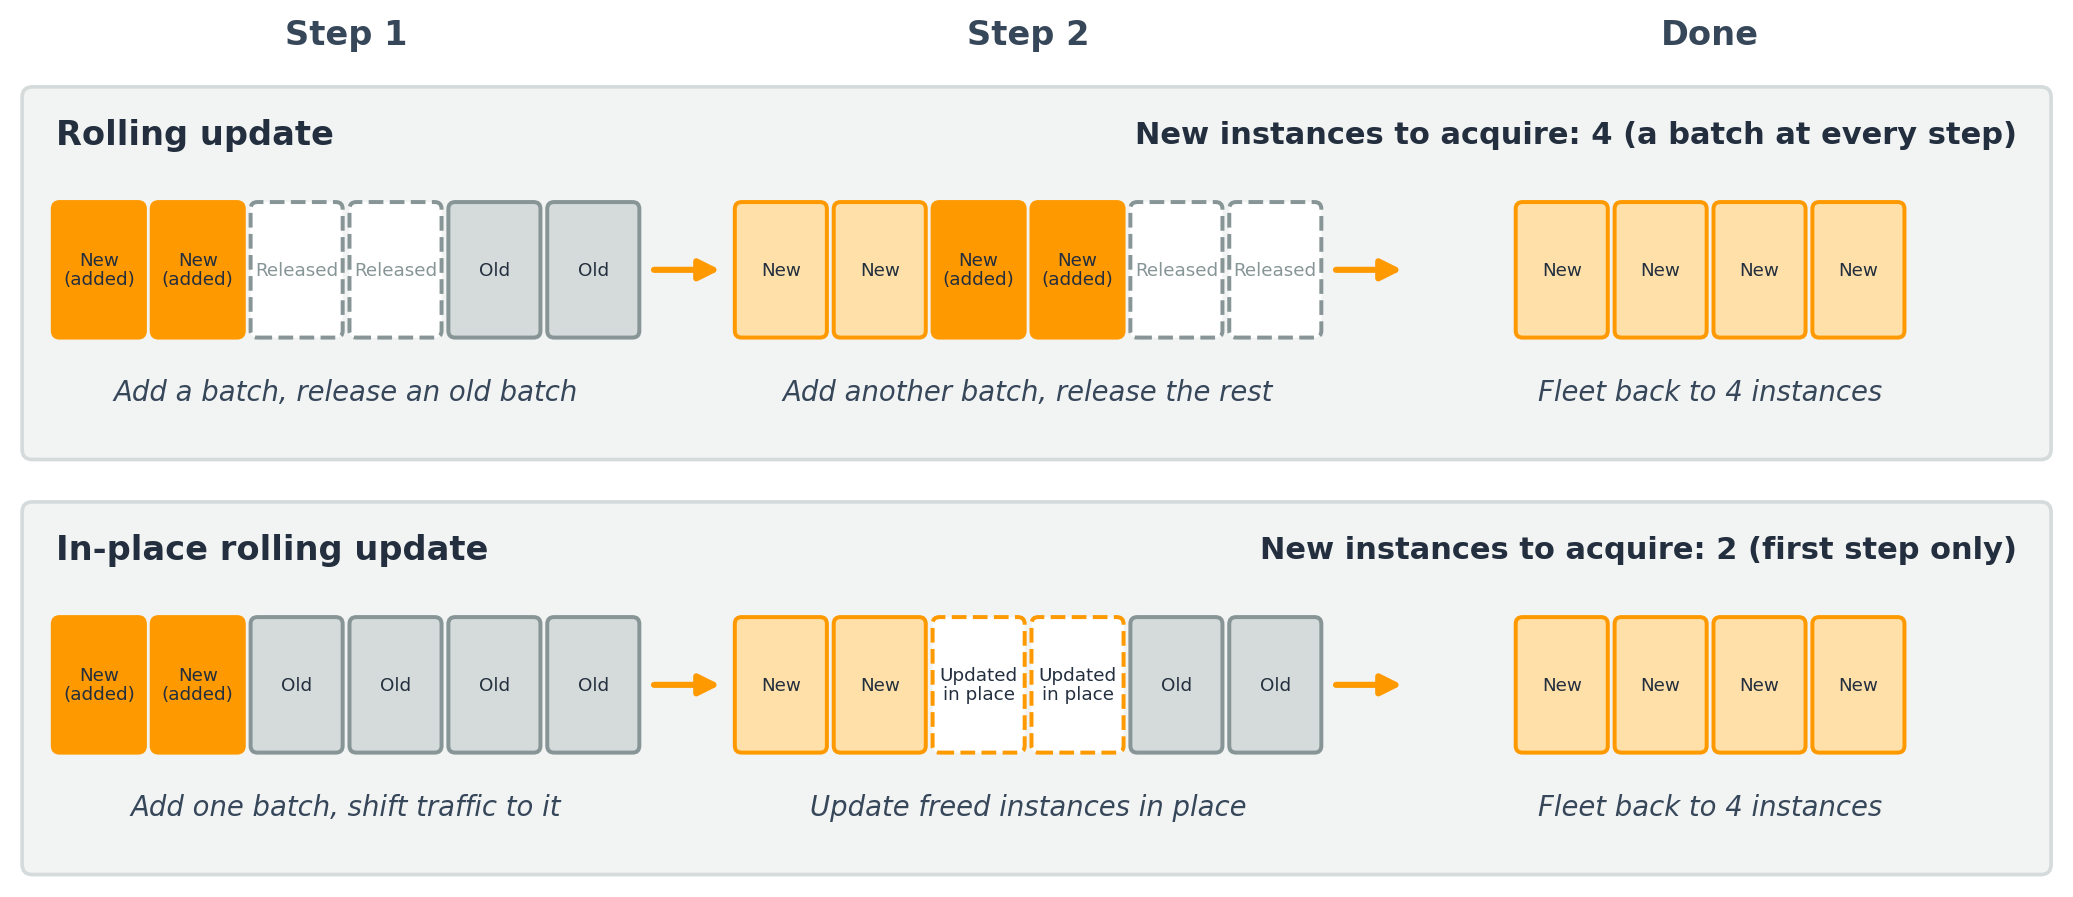
圖 6:標準滾動更新在每個步驟都會取得新執行個體。原地滾動更新則在開始時取得一批執行個體,並重用機羣其餘部分
對支援團隊而言,Drift Watch 檢測結果會量化 TTFT 回退幅度,並針對近期流量啟動新的推薦工作。他們只需一批額外執行個體,便可推出更新後的模型,無須為整個機羣中的每個執行個體尋找新的 GPU 容量。
摘要:14 項發布,接續第 1 部分
編號接續第 1 部分的 13 項發布。
14. SageMaker AI Studio 中的推理建議(2026 年 7 月)。引導式低程式碼工作流程,可取得經排名和基準測試的組態,並直接從 Studio 部署。
15. SageMaker Python SDK v3 中的推理建議(2026 年 8 月)。可從筆記本或管道進行基準測試、取得建議及部署,並支援平行執行和可恢復的工作。
16. 推理建議支援 LoRA adapter(2026 年 9 月)。根據併發量對 adapter 數量進行基準測試,並將 adapter 部署為推理元件。
17. 以 SLA 為基礎的併發量搜尋(2026 年 9 月)。找出符合 TTFT、延遲及錯誤率目標的最高併發量。
18. 用於最佳化生成式 AI 推理的 Agent 技能(2026 年 10 月)。透過兼容 MCP 的程式編寫 Agent 選擇執行個體、進行基準測試及比較執行結果。
19. SageMaker AI 主控台中的 Inference Components(2026 年 10 月)。無須指令碼,即可在多模型端點上建立、擴展及監控各個模型。
20. 使用 NVIDIA MIG 劃分 GPU(2026 年 10 月)。每個 GPU 最多可劃分為七個互相隔離的分區,並逐個指派給推理元件。
21. HyperPod Inference 上的受管理 NVIDIA Dynamo(2026 年 11 月)。支援多節點及分離式服務,由 HyperPod 在底層管理平台。
22. KV 快取感知路由(2026 年 11 月)。根據容器發出的快取事件,將每個請求路由至保留最長已快取前綴的執行個體。
23. HyperPod 的 Inference Gateway(2026 年 9 月)。每個叢集只需一個端點,提供 GPU 感知路由;與輪詢相比,P99 TTFT 最多降低 97%。
24. HyperPod 的 Global Inference Gateway(2026 年 9 月)。跨叢集及區域使用單一端點,並可在 2 分鐘內完成容錯移轉。
25. Cross-Region Inference Router。透過 PrivateLink 跨區域及跨帳戶端點路由流量,並設有流量溢出及資料駐留防護措施。
26. 持續效能監控。偵測延遲漂移、組態缺漏及閒置容量,並在 SageMaker AI Studio 提供引導式修正方法。
27. 原地滾動更新模型(2026 年 11 月)。推出模型更新時,一開始先加入一批額外執行個體,然後在整個機羣中重用現有執行個體。
到年底時,支援團隊以一個基礎模型支援四條產品線,在共用 GPU 上執行小型模型,提供無法由單一執行個體容納的推理模型服務,並在設有資料駐留控制的情況下跨兩個區域路由流量。為此,團隊無須自行建置基準測試工具、容錯移轉邏輯或漂移監控。
第 1 部分指出,AI 推理的優勢來自運作高效的推理技術堆疊。這 13 項發布將這個觀點延伸至產品上線後的數月。AWS Experience-Based Acceleration 計劃可透過基準測試你的工作負載,並根據 SLA 和成本目標設定推理技術堆疊,協助團隊應用這些成果。
接下來是甚麼?
在受管端點上,我們計劃於 2027 年初擴展原地滾動更新,加入先縮減再更新的方式,令模型更新期間無需額外執行個體。
本文所述每項功能的説明文件和入門指南,均載於 Amazon SageMaker AI Developer Guide。請先閲讀與目前問題相符的章節。如果自部署以來流量有所變化,請重新執行推論建議。如果可供配置的槽位不足,請將小型模型移至分割 GPU 上。如果請求排隊等候,但您擁有的容量閒置,請註冊叢集和端點,以啟用跨區域路由。
參考資料
- Amazon SageMaker 推論:2026 年至今推出功能回顧
- 全新 Agent 技能:供程式碼 Agent 使用的 Amazon SageMaker 最佳化生成式 AI 推論
- 介紹 Amazon SageMaker HyperPod Inference Gateway
- 最新消息:SageMaker AI 的 GPU 分割功能
作者簡介

Aryaman Kothari
Aryaman 是 Amazon SageMaker AI 的資深產品經理,負責領導 Amazon SageMaker HyperPod 上的 AI 推論,協助企業大規模執行 AI 模型,以應付生產工作負載。Aryaman 畢業於 Chicago Booth,之前負責 Quantiphi 對話式 AI 業務的產品及市場推廣。工作以外,他喜歡踢足球、沖泡 chai 和遠足。

Apoorva Chandra
Apoorva 是 Amazon SageMaker AI 推論團隊的資深產品經理,專注於端點和託管體驗。她與在生產環境部署生成式 AI 模型的客戶合作,讓他們更容易取得加速運算能力,以更具成本效益的方式執行工作,並令營運更易預測。工作以外,Apoorva 喜歡遠足、探索咖啡店,以及與朋友共度時光。

Vivek Singh
Vivek Singh 是 AWS 的資深產品經理,負責生成式 AI 推論最佳化產品,並與在生產環境執行應用程式的客戶合作。工作以外,他喜歡長時間散步、園藝和烹飪。

Kareem Syed-Mohammed
Kareem 是 AWS 的首席產品經理,專注於在 Amazon SageMaker HyperPod 上支援生成式 AI 模型的開發和治理。此前,他在 AWS Quick Sight 負責嵌入式分析和開發人員體驗。除了 Quick Sight,他亦曾在 AWS Marketplace 和 Amazon 零售部門擔任產品經理。Kareem 的職業生涯始於呼叫中心技術開發工作,曾為 Expedia 開發 Local Expert 和 Ads,並曾任 McKinsey 管理顧問。

Vineet Sharma
Vineet 是 AWS 的資深科技產品市場推廣經理,專注於 Amazon SageMaker AI。他專長於市場推廣策略、產品發布,以及把複雜的 AI 和 ML 服務轉化為具吸引力的客戶價值。他熱衷於透過清晰而具感染力的訊息,為客戶創造出色的體驗。
來源:AWS Machine Learning Blog · aws.amazon.com