如何利用 AgentCore 和 OpenClaw 構建具上下文感知能力的 AI 助手
Building a context-aware AI assistant on AgentCore and OpenClaw
文章示範如何以 OpenClaw 和 Amazon Bedrock AgentCore 建構可累積上下文的 AI 助手,並以 Sprout 園藝助手展示整體架構。
文章以 OpenClaw 和 AgentCore 示範記憶檢索、用戶資料隔離及提示詞快取的設計,並整理可移植至其他領域的智能體部署方法。
現成的 AI 助理很擅長回答個別問題,但在另一個層面有所不足:延續性。今天問一個無狀態助理有關你的花園的問題,它完全不知道你三星期前提過排水很快的高架種植牀、你只用有機肥料,或你的矮牽牛在熱浪期間生長不佳。每次對話都從零開始,重新交代背景的負擔落在用戶身上。
問題不在於答案的質素,而在於助理對你沒有記憶。這篇文章會展示如何利用 OpenClaw(一個開源 Agent 系統)建置能累積背景資訊的個人助理,並在 Amazon Bedrock AgentCore 的一項功能 AgentCore runtime 上運行。Amazon Bedrock AgentCore 的一項功能 AgentCore memory,能將短暫的聊天轉化為持久知識。你亦會看到如何使用結構化中繼資料為這些記憶加上標籤,以便檢索與當前問題相關的記錄。
我們以園藝助理 Sprout 為例,但這套架構不受領域限制。只要更換角色設定和技能清單,同一套流程便可用於支援機械人、健身教練或內部服務台。整個系統都包含在單一 AWS CloudFormation 範本中,只需一條命令即可部署;系統按用量計費,個人輕度使用每月只需數美元。我們亦會分享可應用於在這個技術堆疊上建置的助理的設計指引。
解決方案概覽
AgentCore 是一個可使用任何框架或模型,大規模建置、連接及最佳化 Agent 的平台。下圖展示端對端請求流程:由傳入的 Telegram webhook,經過 AgentCore runtime,以及支援該流程的 AWS 服務。

圖 1:Telegram webhook 和 Amazon EventBridge 排程都會呼叫同一個 AgentCore runtime Agent,由它協調 OpenClaw gateway、AgentCore memory 和 Amazon Bedrock
兩個入口點匯聚至同一個 Agent。Telegram 訊息經由 Amazon API Gateway 和負責處理 webhook 的 AWS Lambda 函數傳入;早上澆水提醒等定時工作則經由 Amazon EventBridge Scheduler 和負責 cron 工作的 Lambda 函數傳入。兩者都會呼叫 AgentCore runtime 上的 InvokeAgentRuntime API;在該處,一個精簡的 server.py 程序負責協調 OpenClaw gateway、AgentCore memory 和 Amazon Bedrock Converse API。Amazon Simple Storage Service (Amazon S3) 提供工作區儲存空間,AWS Key Management Service (AWS KMS) 負責加密,AWS Secrets Manager 儲存機械人 Token,而 Amazon CloudWatch 則收集日誌和指標。
先決條件
如要使用「Launch Stack」按鈕或 scripts/deploy.sh(「自行建置」一節有説明)部署自己的版本,你需要:
- 具備 Amazon Bedrock AgentCore 的存取權,包括 AgentCore runtime 和 AgentCore memory。
- 你需要獲批存取計劃路由至的模型:文字用途使用 Claude Haiku 4.5,視覺用途使用 Claude Sonnet 4.5(或帳戶中可用的同等模型)。
- 支援
linux/arm64建置功能的 Docker,以及已完成設定的 AWS Command Line Interface (AWS CLI)。只有在計劃自行建置並推送映像檔時才需要這項條件。 - 用作助理入口的 Telegram 機械人 Token(由 BotFather 提供)。
- 對 Agent 編排概念和 CloudFormation 有基本認識。
架構:在 AgentCore runtime 上運行的無伺服器 Agent
所有元件都包含在單一 CloudFormation 範本中,啟動時無需任何建置工具。以下各節會説明其中的關鍵設計決策。
AgentCore 執行環境:只為實際使用的運算付費
Agent 會在 AgentCore 執行環境的容器中運行,該環境採用按用量計費。你只需為 Agent 實際使用的運算資源付費,而非按連續運行時間計費;等待 I/O(例如模型回應)時則無須付費。對於短時間間歇使用的個人助理,這代表每月基礎費用約為 $1–2,若使用持續運行的 Amazon Elastic Compute Cloud (Amazon EC2) 執行個體,則每月約為 $35。以上數字是截至 2026 年 7 月、按輕度個人使用量估算。現行收費請參閲 AgentCore 定價。
執行環境要求容器遵守最低限度的介面規範:在連接埠 8080 監聽,並提供 GET /ping 作健康檢查端點,以及 POST /invocations 作為 Agent 進入點。我們的容器是 linux/arm64,以官方 OpenClaw 映像為基礎,採用多階段建置並加入 Python 層。
OpenClaw 作為 Agent 基礎架構
OpenClaw 提供 Agent 運作迴圈、工具使用功能及技能系統。它會執行一個包裝器(server.py),使其符合 AgentCore HTTP 協定合約:
- 容器啟動時,
server.py會以子程序方式啟動openclaw gateway run,並對其進行健康檢查。 GET /ping會快速回報健康狀態,因此 AgentCore 的就緒探測可以通過。POST /invocations負責實際工作:剖析負載、讀取記憶、組合上下文、將這一輪對話轉交給 gateway,並儲存結果。有一點需要注意:AgentCore 可能會解凍一個子程序已結束的凍結容器。因此,呼叫流程不會假設 gateway 仍在運作,而會呼叫ensure_openclaw_ready()輔助程式,在轉交這一輪對話前重新檢查健康狀態(如有需要,亦會重新啟動 gateway)。
這種包裝器模式也適用於其他用途。任何以本機程序方式運行的 Agent 框架,都可以用相同方式配合 AgentCore 執行環境,而無須修改框架本身。
按任務路由至兩個模型
文字對話和圖片理解在成本與品質方面各有取捨,因此助理會在 Bedrock 上使用不同的 Claude 模型處理:
- 文字使用 Claude Haiku 4.5:速度快、成本低,適合處理日常使用中佔大多數的高流量對話回合。
- 視覺任務使用 Claude Sonnet 4.5:多模態推理能力較強,適合處理較少見但難度較高的任務,例如根據植物照片作出診斷。
文字回合會經由 OpenClaw 閘道傳送,該閘道提供技能和工作階段狀態。圖像回合則從 server.py 直接呼叫 Bedrock 的大型語言模型(LLM),並將圖像位元組作為多模態內容區塊傳遞。我們刻意讓圖像繞過閘道:容器內的 OpenClaw 版本會在內容部分抵達 Bedrock 前捨棄 image_url 內容部分,因此直接從 server.py 呼叫 Converse API,可確保模型看到實際像素。兩條路徑共用相同的系統提示詞(角色設定加記憶),因此體驗保持一致。
模型 ID 是環境變數(MODEL_ID、VISION_MODEL_ID),因此可在不同部署中替換模型,無須重建映像。
技能作為可重用的功能單位
能力會以技能形式宣告於 community-skills.json 清單檔中。部署時執行的指令碼會將技能內容寫入容器,並在建置映像前於 OpenClaw 設定中註冊這些技能。本文發佈時,Sprout 提供天氣、提醒事項和植物筆記技能。替換清單檔,同一套流程便可服務不同領域。這正是整套方案可重用、而不只適用於單一聊天機械人的原因。
Telegram 作為無伺服器入口
Telegram 是個人助理的實用通訊渠道,因為它以 webhook 為基礎,而且整個系統都採用無伺服器架構。它無需開發用戶端,可在用戶已有的所有裝置上使用,並透過簡單直接的 bot API 支援文字、圖片及豐富格式。BotFather 會發出 bot token,並將其儲存在 Secrets Manager。部署時會註冊 webhook,將 Telegram 指向 API 閘道端點。用戶發送訊息後,Telegram 會將訊息傳送至 webhook Lambda 函數,以驗證 payload 並呼叫 InvokeAgentRuntime。回覆則會透過 Telegram Bot API 傳回。
有一點格式處理上的經驗值得注意:Telegram 舊版的 Markdown 格式對未跳脱的字元毫不寬容;模型回覆中只要多出一個底線,就可能令整則訊息無法傳送。以 HTML 呈現回覆則可靠得多,因此助理會先將模型輸出轉換為 Telegram 可接受的 HTML,再傳送出去。
記憶:將短暫對話轉化為持久知識
目前介紹的架構是功能完善、低成本的無伺服器 Agent,但單靠它本身,仍會在不同對話之間忘記你。記憶正是改變這一點的關鍵。想像一下,你幾星期前提過自己採用有機方式耕種;今天,助理建議一種處理方法,並主動補充説,它選擇了有機方案,因為你不使用合成肥料。無狀態模型無法做到這一點。
概念模型:短期事件、長期提取
AgentCore memory 分為兩層。短期記憶會透過 CreateEvent,將每一輪對話儲存為事件,並以 actorId(Telegram 聊天 ID)和 sessionId作為鍵值。這就是原始對話紀錄。長期記憶則會透過受管理的提取策略異步產生,並儲存為持久且結構化的記錄。我們設定了三種策略:
USER_PREFERENCE:園丁明確説出的選擇(「我只使用有機肥料」)。SEMANTIC:推斷出的事實(「在 Corten 耐候鋼高架花牀中種植墨西哥矮牽牛」)。SUMMARIZATION:情節式工作階段摘要(「討論了熱浪期間下層葉片變黃的情況」)。
命名空間:每位園丁各自一個花園
Sprout 會將記錄分別存入每位用戶專屬的命名空間,確保不同對話不會混在一起:
sprout/{chat_id}/long_term:偏好和語義事實。sprout/{chat_id}/episodic/{session_id}:工作階段摘要。
聊天 ID 是唯一會變動的部分,因此隔離機制容易理解和測試:每位不同的園丁只會對應一個命名空間,而且不同園丁之間不會發生衝突。
檢索、組裝和注入流程
每一輪對話中,Agent 都會檢索相關的長期記錄、為記錄排序,並將其注入系統提示詞。以下是每則訊息傳來時,server.py內的處理流程:
- 檢索。呼叫
RetrieveMemoryRecords查詢sprout/{chat_id}/long_term,以用戶訊息作為搜尋查詢,結果上限為 50 筆,時限為 3 秒。若檢索逾時或發生錯誤,系統會妥善降級處理,在不使用記憶的情況下回答,而不會直接失敗。
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
片段 1:檢索當前對話回合所需的長期記錄(代表性範例。完整原始碼請參閲程式碼儲存庫)。
組裝函數會加入額外的自訂邏輯。我們希望明確偏好排在推斷事實之前、各類別內的排序保持穩定,並在注入前限制結果數量:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
片段 2:組裝步驟會將明確偏好排在推斷事實之前。
中繼資料:在命名空間內細分記憶
命名空間説明一筆記錄屬於誰的記憶,元資料則説明它涉及甚麼。在sprout/{chat_id}/long_term中,對「我的矮牽牛正在枯萎」進行語義搜尋,會找出所有意義相近的內容。對園藝愛好者而言,這表示三月份的肥料偏好和無花果樹修剪備註,都會與真正相關的記錄一同列入排名。結構化元資料則有助我們在記憶內容進入提示詞前縮小搜尋範圍。
此處每項決策都受一條規則支配。只有將元資料鍵宣告為索引鍵,才能在伺服器端用作篩選。詳情請參閲 在 Amazon Bedrock AgentCore Memory 中使用元資料篩選結構化記憶。在這個例子中,Sprout 使用三個索引鍵:
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
Type: STRINGLIST每個項目會指定一個鍵;該鍵必須與某個索引鍵相符,才能用作篩選,並會將extractionType設為STRICTLY_CONSISTENT(沿用事件中的值),或LLM_INFERRED(從對話中擷取)。對於推斷鍵,擷取設定可將值限制為固定清單中的項目。Sprout 正是如此設定,因此兩種寫入路徑都會建立相同的詞彙集合;無論記錄由哪個部分建立,篩選條件的含義都相同。
儲存本輪對話,完成閉環
模型回覆後,server.py會呼叫CreateEvent,並一併傳入用戶回合和助理回合。這個新事件會送入擷取策略,為長期記憶儲存區補充資訊,供下次使用。
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
片段 3:儲存本輪對話,讓擷取策略以非同步方式充實長期記憶。
擷取作業以非同步方式進行,因此本次工作階段提及的事實,通常要到之後的工作階段才可檢索。設計時須考慮這種延遲:短期工作階段事件涵蓋目前對話,長期記錄則涵蓋此前的一切。
整合流程:個人化澆水計劃
經過幾次對話,你便能逐一以淺白文字記錄花園裏的所有植物。每次提及都會成為一個事件。擷取策略會把有關植物、所在位置及日照情況的資訊寫入sprout/{chat_id}/long_term。今天早上,用戶問道:「你還記得我花園裏的其他植物嗎?」檢索會取回記錄,組裝程序會為記錄排序,然後將它們加入系統提示詞。助理的回答會包含用戶所在位置、日照情況、種植牀構造、土壤特性和植物清單;這些資訊都未出現在該訊息本身。
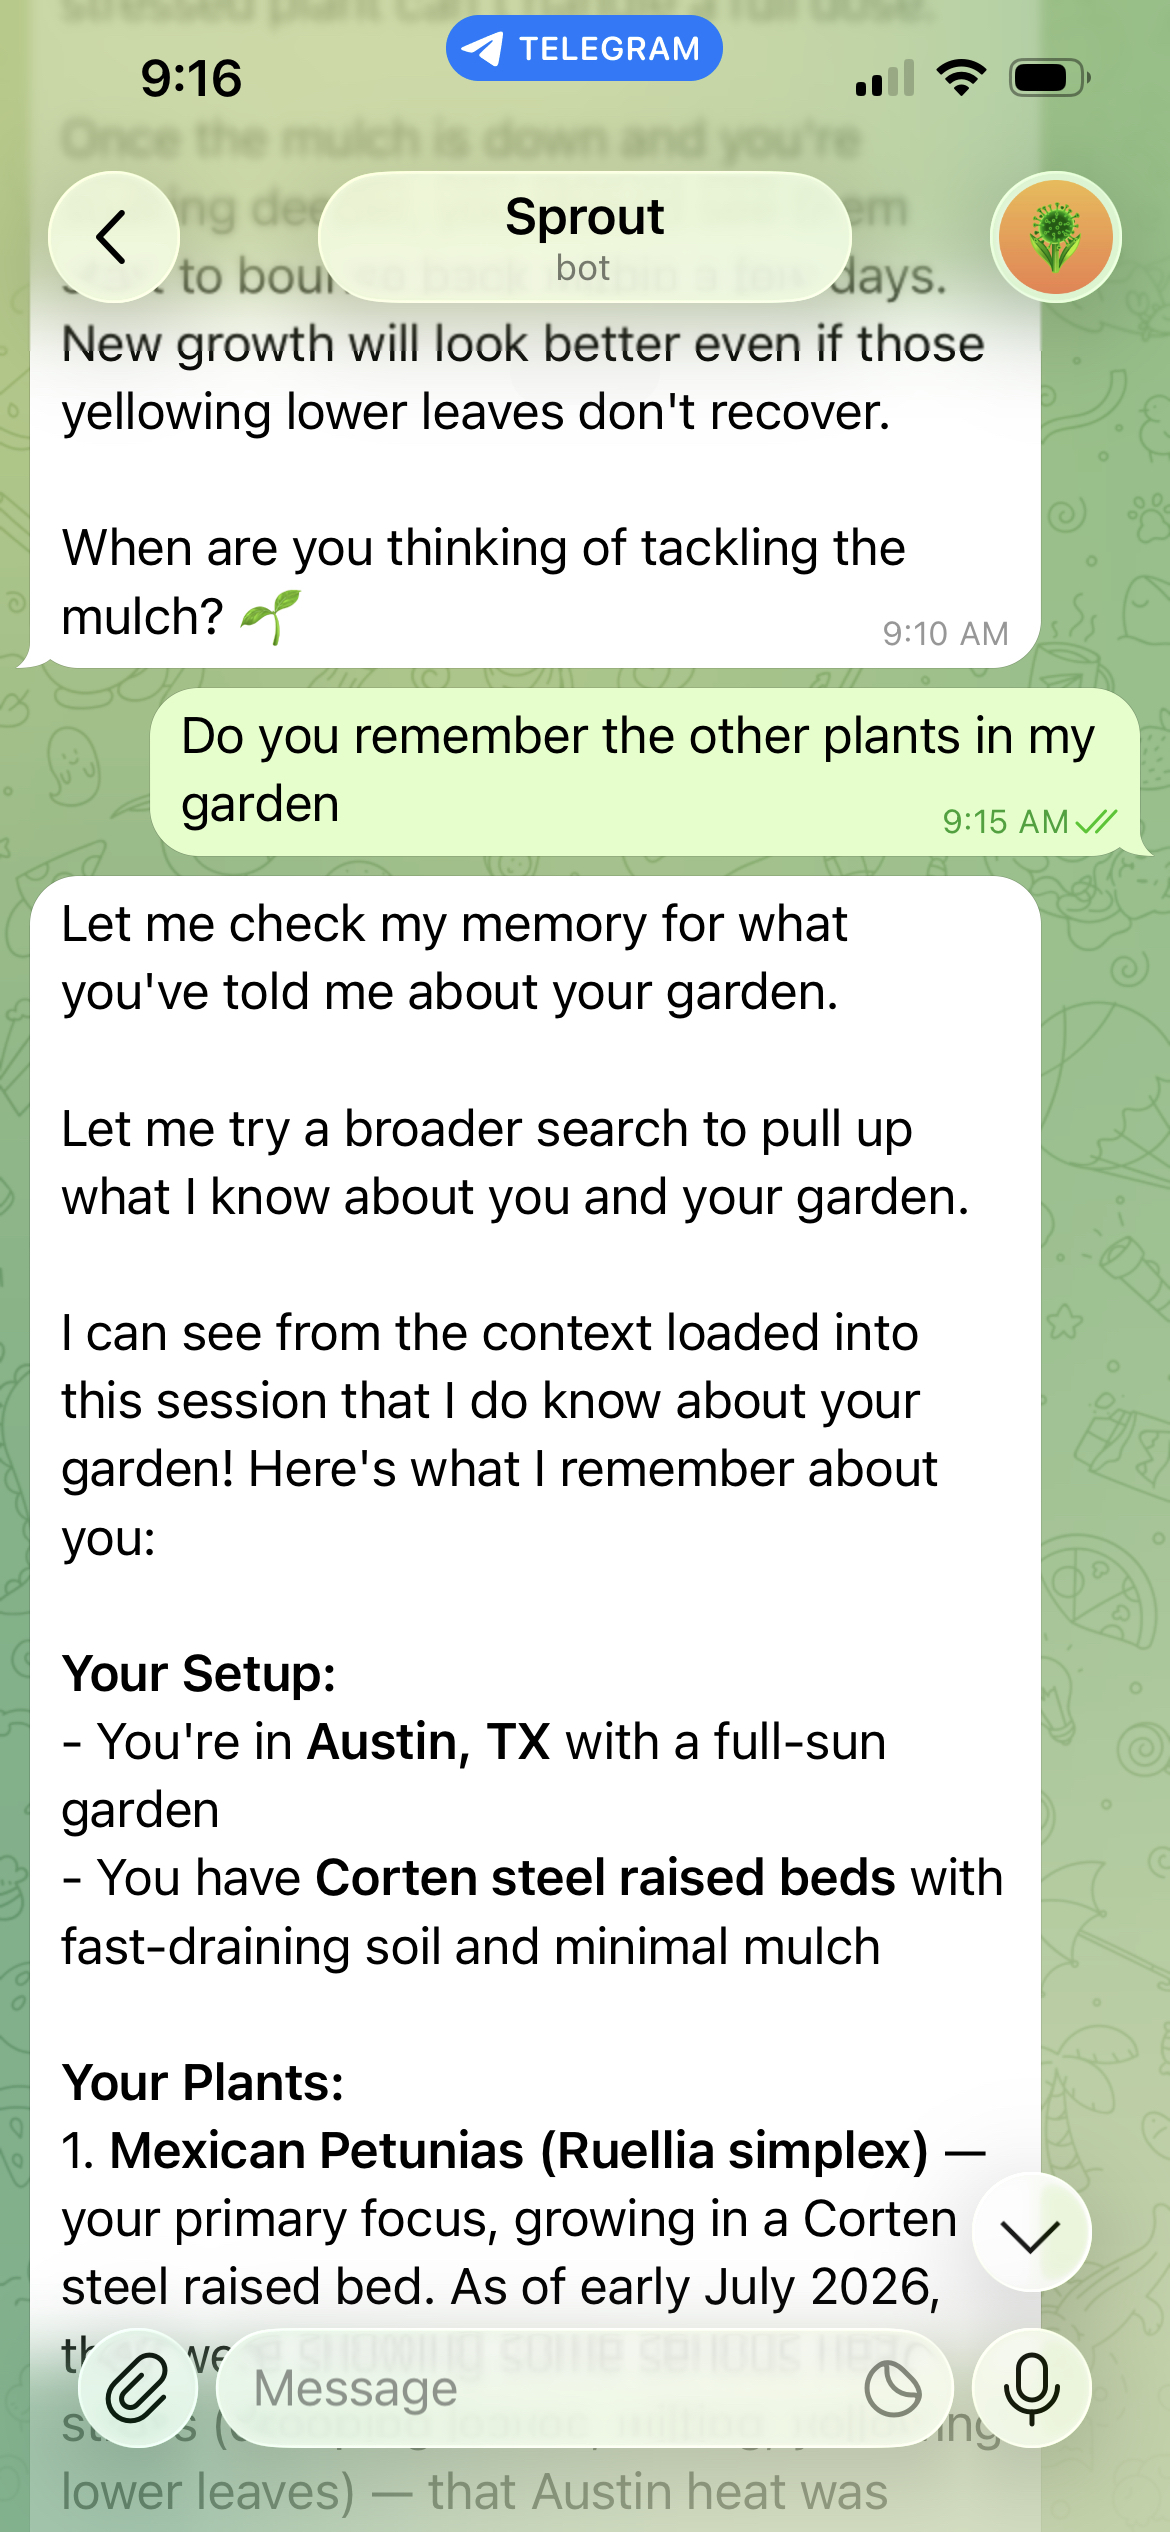
圖 2:Sprout 透過回憶已儲存的植物清單和種植條件,回答有關花園的問題
使用 Amazon EventBridge → Cron 路徑上的排程器技能,Sprout 亦可將計劃轉化為主動提醒(「香草植物可先不澆水,土壤仍留有昨天的濕氣」),並會在即將下雨或出現熱浪時,參照天氣技能調整提醒。
記憶和視覺功能也會相互增益。用戶傳送一張正在枯萎的植物照片時,圖像會傳送給 Claude Sonnet 4.5,而系統提示詞仍會帶有記憶層掌握的所有資訊。助理會把照片中的植物與用戶已儲存的植物清單中的墨西哥矮牽牛比對,並結合背景資訊診斷萎蔫壓力,而非在毫無背景資訊的情況下分析一張不明植物照片。
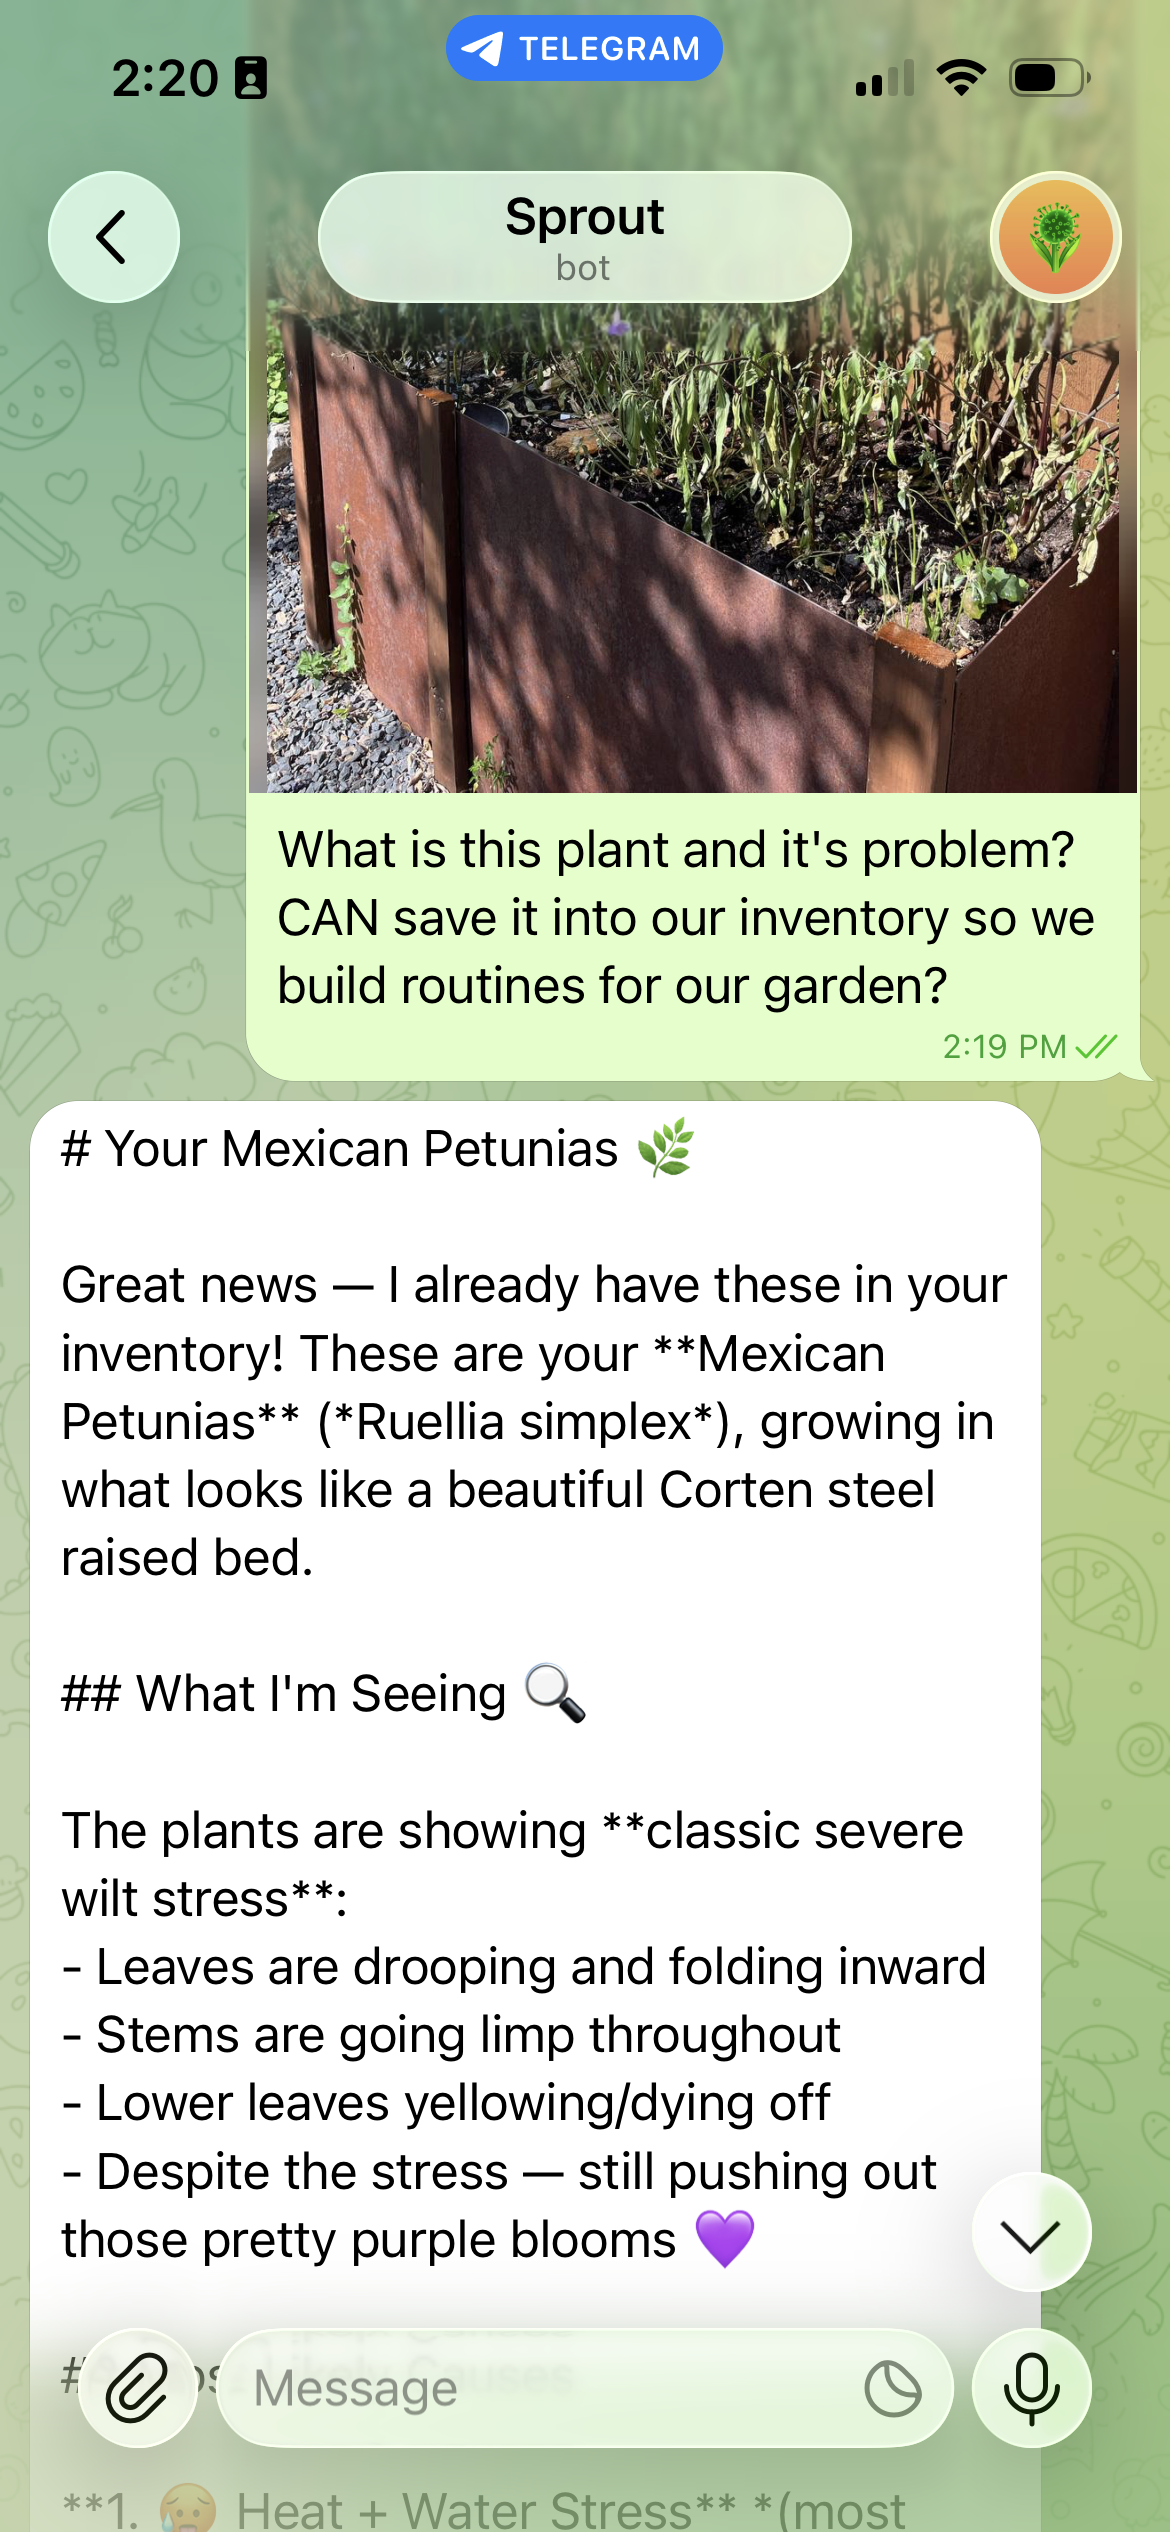
圖 3:視覺與記憶功能協同運作。照片會傳送給視覺模型,系統提示詞則帶有用戶已儲存的花園背景資訊
視覺模型並非萬無一失。此前在沒有庫存資料的情況下進行的一次對話中,模型同樣信心十足地把這株植物認作牽牛花;牽牛花是一種開有相似喇叭形紫色花朵的植物。以用戶自行儲存的庫存資料為視覺模型提供依據,才把聽起來合理的猜測變成正確且個人化的診斷,這也很好地説明記憶為何能提升準確度,而不只是改善語氣。
透過提示詞快取降低推理成本
每一輪對話都注入記憶,會令系統提示詞變得很長;如果採用簡單直接的實作方式,每次請求都要為這些 Token 付費。Amazon Bedrock 的提示詞快取功能可以解決這個問題。助理會按以下方式編排提示詞:先放穩定前綴,包括角色設定及組合而成的記憶區塊,最後放易變的用戶訊息。Bedrock 會在不同請求之間快取已處理的前綴,因此同一對話中的後續輪次無須重新計算未變動的部分。對支援的模型而言,提示詞快取最多可降低 90 percent 的成本,並最多縮短 85 percent 的延遲。
排序規則比任何單一設定都重要:先放穩定內容,最後放易變內容,並讓記憶區塊內部的排序保持確定性(前述組裝函式有助於做到這點),確保不同請求的前綴完全一致。
使用 AgentCore 和 OpenClaw 建構時的設計指引
Sprout 是一個助理,但背後的設計決策同樣適用於其他情境。如果你正在使用這套技術堆疊建構自己的助理,以下是我們認為適用於任何領域的指引。
- 以包裝層配合,不要分支修改框架。透過精簡的 HTTP 包裝層,讓 Agent 框架符合 AgentCore 的容器契約,而不是修改框架本身。這項契約很簡單:使用連接埠 8080,並配合
/ping和/invocations;包裝層則能讓你繼續沿用框架的升級路徑。 - 儲存任何資料之前,先設計好命名空間。記憶命名空間是你的隔離邊界。將用戶 ID 設為唯一可變部分,並從你已信任的頻道原生 ID 中選取,例如聊天 ID。多租戶設計遲早會面對審計和刪除要求。清晰的命名空間規劃能讓兩者都變得輕而易舉。
- 把記憶視為增強功能,而非必要依賴。每項記憶操作都應能在失敗時妥善處理。檢索失敗時,應在不阻礙回覆的情況下提供不依賴記憶的答覆。用戶對某一輪答覆沒有記起資訊的容忍度,遠高於對回覆失敗的容忍度。
- 按任務分配模型。對大量文字處理使用快速、具成本效益的模型,並只在需要多模態能力的對話輪次使用更強大的多模態模型。將模型 ID 存放在環境變數中,讓模型路由變更只需調整設定,不必改動程式碼。
- 按快取需求安排提示詞順序。先放穩定的角色設定和記憶,最後放易變的用戶輸入,並全程維持確定性排序。大部分推理成本節省都來自這個結構安排。
- 預留記憶提取所需的時間。長期記憶會以非同步方式提取,因此不要承諾在同一工作階段內能回想起新事實。讓短期工作階段事件涵蓋目前對話,長期記錄則涵蓋先前的對話。
- 從第一天起就設定預算。按用量計費的 Agent 原本成本不高,但重試迴圈或頻繁發訊息的用戶都可能令成本上升。將 AWS Budgets 警示設為每月上限的 80 percent 和 100 percent,無須付費,亦可及早發現意外支出。
- 技能應保持精簡,並各自只負責一項工作。技能應只處理用戶能用一句話説明的一件事,例如查詢天氣或設定提醒。精簡的技能可以獨立測試、獨立替換,也能讓模型輕易正確選用。包辦一切的技能會迫使模型猜測你想用它的哪項功能。
自行培植
兩種種植方式,同一片園地:
- 單步啟動堆疊:CloudFormation 範本會指向公開的 Amazon Elastic Container Registry (Amazon ECR) 映像,因此部署時只需提供 Telegram 機械人 token。
- 自行建置:scripts/
deploy.sh指令碼會驗證範本、建置 ARM64 映像並推送至你的私人 Amazon ECR 儲存庫、部署堆疊,以及註冊 Telegram webhook,讓建置版本完全可自訂。
截至 2026 年 7 月,輕度個人用途每月約需 $5–9(基礎設施約 $2、Haiku 文字處理約 $1–3、Sonnet 視覺處理約 $2);系統內置 AWS Budget,當支出達到你設定的上限之 80% 及 100% 時會發出提示。
完整原始碼可在 sample-agentcore-memory-openclaw GitHub 儲存庫中取得。
清理
完成實驗後,請刪除所有資源,以免繼續產生費用。由於整個系統由一個 CloudFormation 堆疊構成,清理時大致只需刪除一個堆疊:
- 刪除 CloudFormation 堆疊。這會移除 AgentCore 執行階段代理程式、API Gateway、Lambda 函數、Amazon EventBridge 排程,以及相關的 AWS Identity and Access Management (IAM) 角色。
- 刪除 AgentCore 記憶儲存庫(及其命名空間),以免保留任何用戶記錄。
- 刪除你推送至私人 ECR 儲存庫的映像;如不再需要,也請刪除儲存庫本身。
- 如你在堆疊以外建立了 AWS Budget 提示,請將其移除。
- 撤銷 Telegram 的 webhook(或透過 BotFather 刪除機械人);如不再需要,也請撤銷 Bedrock 模型存取權限。
總結
這個方案可重用的核心,是 Amazon Bedrock AgentCore 上具備技能系統及受管理記憶功能的無伺服器代理程式。AgentCore 記憶功能免去建置自訂向量儲存庫及資料擷取管道的需要,同時讓你完全掌控代理程式記住及忘記哪些內容;按用量計費的運算資源加上提示詞快取,讓真正個人化的助理每月只需數美元;而 OpenClaw 技能資訊清單則令整套模式可移植至不同領域。個人化效果亦會隨互動累積:用戶互動愈多,助理就愈有用。
如要進一步拓展,可先從單一領域開始,例如澆水提醒,再逐步擴大記憶範圍;亦可探索情節記憶,讓代理程式引用過往的特定對話(「上次我們談到無花果樹時,你決定暫緩施肥」);或者 fork 儲存庫,換上自己的角色設定及技能,打造所需的助理。
如欲瞭解更多,請參閲 AgentCore 説明文件。以下相關文章會更深入介紹各個基礎組件:
- Amazon Bedrock AgentCore 記憶功能:建構具備情境感知能力的代理程式
- 打造更智能的 AI 代理程式:深入剖析 AgentCore 長期記憶
- 在 Amazon Bedrock 上有效運用提示詞快取
- 在 Amazon Bedrock AgentCore 執行階段安全地啟動及擴展代理程式與工具
作者簡介

Thiago Verney
Thiago 是 Amazon One MHS 團隊的前端工程師,專門運用 React、TypeScript 和現代化聯合式微前端架構,打造由 AI 驅動的介面。他為 FC 營運主管打造以用戶為本的介面,並運用過往在 AWS 的 Amazon Q Developer(現稱 Kiro)團隊工作的經驗。他熱衷創新,致力設計務實方案,解決用戶面對的實際問題。閒暇時,他喜歡園藝、旅行,亦喜歡與妻子在德克薩斯州奧斯汀一起培養新嗜好。

Sathya Balakrishnan
Sathya 是 Amazon Web Services(AWS)專業服務團隊的首席雲端架構師,專門提供數據及機器學習(ML)方案。他為美國聯邦金融客戶提供服務。他熱衷打造務實方案,解決客戶的業務問題。閒暇時,他喜歡與家人看電影和遠足。

Akarsha Sehwag
Akarsha 是 Amazon Bedrock AgentCore 市場推廣團隊的資深 生成式 AI 數據科學家。她在 AI/ML 領域擁有超過 7 年專業經驗,曾在生成式 AI、深度學習和電腦視覺領域,為不同客戶羣建立可供生產環境使用的企業級方案。工作以外,她喜歡遠足、踩單車和打羽毛球。
來源:AWS Machine Learning Blog · aws.amazon.com