Google 發佈程式碼大語言模型 CodeGemma
CodeGemma - an official Google release for code LLMs
Google 發佈面向程式碼的大語言模型家族 CodeGemma,推出 2B base、7B base 和 7B instruct 三種版本。模型以 Gemma checkpoint 為基礎,額外訓練 500 billion tokens,三款模型均採用 8K token 上下文窗口。
文章交代 CodeGemma 三種版本的用途,並列出 HumanEval 表現及 Hugging Face 的部署與量化整合,方便比較版本定位、基準表現和使用路徑。
CodeGemma 是一系列專為程式碼而設、可開放取用的 Gemma 版本。我們很高興與 Google 合作推出此模型,盡可能令更多人可以使用。🤗
CodeGemma 提供三種版本:
- 專為填補程式碼和開放式生成而設的 2B 基礎模型。
- 以程式碼填補和自然語言資料訓練的 7B 基礎模型。
- 可供用戶就程式碼進行對話的 7B 指示模型。
我們與 Google 合作,確保模型能最佳整合至 Hugging Face 生態系統。三款可開放取用的模型已在 Hub 上準備就緒,可供使用。此次推出的功能和整合包括:
- Hub 上的模型,附有模型卡和授權條款。當中包括供 transformers 程式庫使用的版本、可配合 Google 原始程式碼庫使用的檢查點,以及社羣可進行量化的全精度 GGUF 檔案。
- Transformers 整合
- 與 Google Cloud 整合
- 與 Inference Endpoints 整合
- 程式碼基準測試
目錄
甚麼是 CodeGemma?
CodeGemma 是 Google 推出的程式碼專用大型語言模型系列,建基於預訓練的 2B 和 7B Gemma 檢查點。CodeGemma 進一步以額外 500 billion 個 Token 訓練,資料主要包括英文、數學和程式碼,以提升邏輯和數學推理能力,適用於程式碼補全和生成。
CodeGemma 2B 專門以程式碼填補資料訓練,適合快速補全和生成程式碼,尤其適用於延遲和/或私隱至關重要的情境。CodeGemma 7B 的訓練資料混合了程式碼填補資料(80%)和自然語言,可用於程式碼補全,以及程式碼和語言理解與生成。CodeGemma 7B Instruct 則在 CodeGemma 7B 基礎上經指示遵循微調,適用於對話,尤其是程式碼、編程或數學推理相關主題。所有模型的 Token 脈絡長度都與前代相同,為 8K。
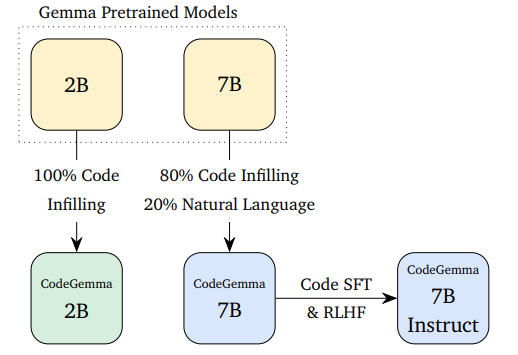
此圖片來自原始報告
評估結果
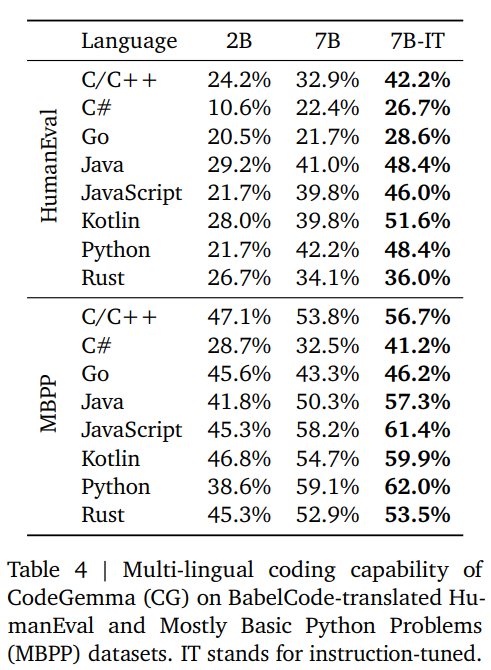
在熱門程式碼模型基準測試 HumanEval(以 Python 評估程式碼模型)上,CodeGemma-7B 的表現優於相若規模的 7B 模型,DeepSeek-Coder-7B 除外。MultiPL-E 是 HumanEval 的翻譯版本,用於評估 Java、JavaScript 和 C++ 等其他程式語言,結果亦相同。根據技術報告,在 7B 模型中,該模型於 GSM8K 表現最佳。指示版本 CodeGemma-7B-it 在 HumanEval 和 MBPP 的最常見程式語言評估中都取得提升(參見論文表 5)。詳情可查看 BigCode 排行榜或以下部分指標。
| 模型 | 預訓練規模[Token 數量] | Python | JavaScript |
|---|---|---|---|
| 10B+ 模型 | |||
| StarCoder 2 15B | 4,000B+ | 44.15 | 44.24 |
| Code Llama 13B | 2,500B | 35.07 | 38.26 |
| 7B 模型 | |||
| DeepSeek Coder 7B | 2,000B | 45.83 | 45.9 |
| CodeGemma 7B | 額外訓練 500B | 40.13 | 43.06 |
| Code Llama 7B | 2,500B | 29.98 | 31.8 |
| StarCoder 2 7B | 3,500B+ | 34.09 | 35.35 |
| StarCoderBase 7B | 3,000B+ | 28.37 | 27.35 |
| <3B 模型 | |||
| CodeGemma 2B | 額外訓練 500B | 27.28 | 29.94 |
| Stable Code 3B | 1,300B | 30.72 | 28.75 |
| StarCoder 2 3B | 3,000B+ | 31.44 | 35.37 |
| 模型 | 預訓練規模[Token 數量] | Python | JavaScript |
|---|---|---|---|
| 10B+ 模型 | |||
| Code Llama 13B | 2,620B | 50.6 | 40.92 |
| Code Llama 13B | 2,620B | 42.89 | 40.66 |
| 7B 模型 | |||
| CodeGemma 7B | 500B | 52.74 | 47.71 |
| Code Llama 7B | 2,620B | 40.48 | 36.34 |
| Code Llama 7B | 2,620B | 25.65 | 33.11 |
以下是原始報告中按語言分類的表格。
提示格式
CodeGemma 2B 和 CodeGemma 7B 使用程式碼填補(程式碼、註解、文件字串、匯入陳述式)來完成程式碼。CodeGemma 透過填補中間部分(FIM)目標訓練此任務:提供前綴和後綴作為待補全內容的脈絡。以下 Token 用來分隔輸入的不同部分:
<|fim_prefix|>表示待補全內容之前的脈絡。<|fim_suffix|>表示後綴。必須將此 Token 放在編輯器中游標所在的準確位置,因為模型會從該處開始補全程式碼。<|fim_middle|>是提示模型開始生成的 Token。
此外還有 <|file_separator|>,可提供多檔案脈絡。我們會在使用 transformers一節示範如何使用。
CodeGemma 7B Instruct 使用與 Gemma 指示微調基礎版本相同的提示格式,採用以下對話結構:
<bos><start_of_turn>user
knock knock<end_of_turn>
<start_of_turn>model
who is there<end_of_turn>
<start_of_turn>user
LaMDA<end_of_turn>
<start_of_turn>model
LaMDA who?<end_of_turn>
與 Gemma 一樣,重現這種格式最簡單的方法,是使用 transformers 中提供的聊天模板。
使用 CodeGemma
示範
你可以在 這個 Space 輕鬆試用 CodeGemma 模型(70 億個參數!),或使用下方嵌入的聊天機械人:
這個示範平台在幕後使用 Transformers 實作。你亦可複製 Space 自行使用;它是自包含的,因此你可以檢視原始碼並按需要修改!
使用 Transformers
在 Transformers 4.39 版中,你可以使用 CodeGemma,並善用 Hugging Face 生態系統中的各種工具,例如:
- 訓練和推論指令碼及範例
- 安全檔案格式(
safetensors) - 與 bitsandbytes(4-bit 量化)、PEFT(參數高效微調)和 Flash Attention 2 等工具整合
- 使用模型執行生成的工具和輔助函式
- 匯出模型以供部署的機制
與 Gemma 模型一樣,CodeGemma 亦相容於 torch.compile(),可大幅加快推論。
額外福利:我們為你準備了 Colab 筆記本,只需按一下按鈕便可試用模型,按此查看。
如要在 transformers 中使用 CodeGemma,請確保使用最新 版本:
pip install --upgrade transformers
以下程式碼片段示範如何使用 codegemma-2b 配合 transformers 補全程式碼。以 float16 精度運行約需 6 GB RAM,非常適合消費級 GPU 和裝置端應用。
from transformers import GemmaTokenizer, AutoModelForCausalLM
import torch

model_id = "google/codegemma-2b"
tokenizer = GemmaTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16
).to("cuda:0")

prompt = '''\
<|fim_prefix|>import datetime
def calculate_age(birth_year):
    """Calculates a person's age based on their birth year."""
    current_year = datetime.date.today().year
    <|fim_suffix|>
    return age<|fim_middle|>\
'''

inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
prompt_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=100)
print(tokenizer.decode(outputs[0][prompt_len:]))
請留意,<|fim_suffix|> Token 會放在編輯器中的遊標位置,標示生成內容的起點。<|fim_prefix|> 提供遊標之前的脈絡,而直至 <|fim_middle|> 之前的部分則提供遊標之後的額外脈絡。如果遊標位於檔案開首或結尾,其中一部分可以留空。
前述程式碼可能會返回類似以下內容:
age = current_year - birth_year<|file_separator|>test_calculate_age.py
<|fim_suffix|>
    assert calculate_age(1990) == 33
    assert calculate_age(1980) == 43
    assert calculate_age(1970) == 53
    assert calculate_age(1960) == 63
    assert calculate_age(1950) == 73
請注意,正確補全內容後可能還有額外文字。CodeGemma 7B 尤其如此;它較冗長,完成補全後往往會再提供程式碼或註解。程式碼填補時,必須忽略 FIM Token 或 EOS Token 之後出現的所有內容。使用 transformers 時,可像以下例子一樣向 generate 函式提供終止符清單,提早停止生成:
FIM_PREFIX = '<|fim_prefix|>'
FIM_SUFFIX = '<|fim_suffix|>'
FIM_MIDDLE = '<|fim_middle|>'
FIM_FILE_SEPARATOR = '<|file_separator|>'

terminators = tokenizer.convert_tokens_to_ids(
    [FIM_PREFIX, FIM_MIDDLE, FIM_SUFFIX, FIM_FILE_SEPARATOR]
)
terminators += [tokenizer.eos_token_id]

outputs = model.generate(
  **inputs,
  max_new_tokens=100,
  eos_token_id=terminators,
)
此設定下,一旦找到第一個分隔符便會停止生成:
age = current_year - birth_year<|file_separator|>
精度説明
原始 CodeGemma 檢查點以 bfloat16 精度發布。如果載入模型時未指定 torch_dtype,PyTorch 會將它們升級為 float32。使用 float16 精度完全沒有問題,而且在某些硬件上速度可能比 bfloat16 快得多。如要達到最高精度,我們建議使用 bfloat16,而非 float32。
你亦可自動量化模型,以 8-bit 或 4-bit 模式載入。CodeGemma 7B 以 4-bit 載入時,運行約需 9 GB 記憶體,因此適用於許多消費級顯示卡和 Google Colab 的所有 GPU。以下示範如何以 4-bit 載入生成管道:
pipeline = pipeline(
    "text-generation",
    model=model,
    model_kwargs={
        "torch_dtype": torch.float16,
        "quantization_config": {"load_in_4bit": True}
    },
)
與 Google Cloud 整合
你可以透過 Vertex AI 或 Google Kubernetes Engine(GKE),使用 Text Generation Inference 和 Transformers,在 Google Cloud 上部署及訓練 Gemma。
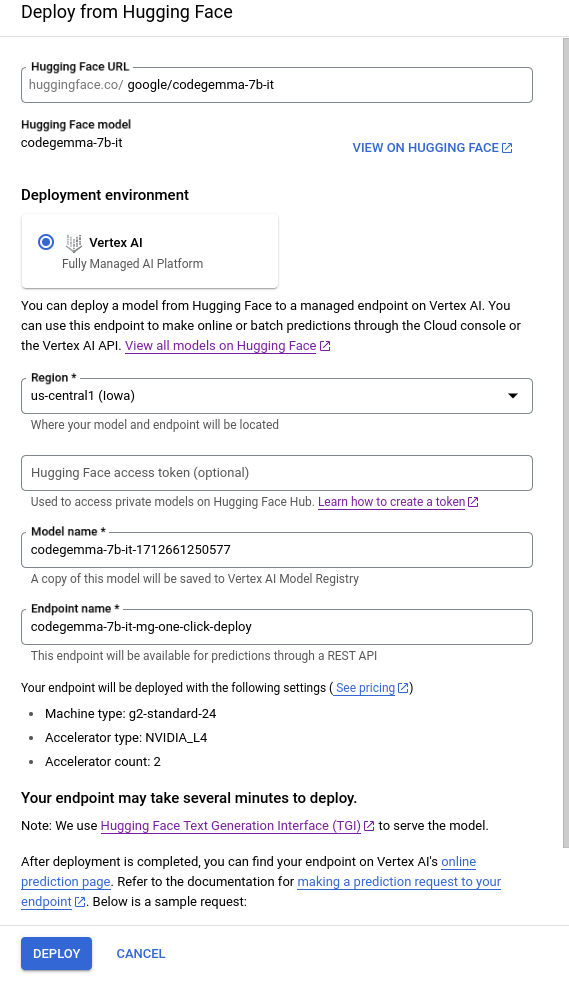
如要從 Hugging Face 部署 CodeGemma 模型,請前往 模型頁面 並按下部署 -> Google Cloud。接着會開啟 Google Cloud Console,你可以一鍵在 Vertex AI 或 GKE 部署 CodeGemma,並以 Text Generation Inference 為後端。
你亦可直接透過 Vertex AI Model Garden 使用 CodeGemma。
與 Inference Endpoints 整合
你可以在 Hugging Face 的 Inference Endpoints 部署 CodeGemma,並以 Text Generation Inference 作為後端。Text Generation Inference 是 Hugging Face 開發、可供生產環境使用的推論容器,方便部署大型語言模型。它具備連續批次處理、Token 串流、支援多張 GPU 快速推論的張量平行處理、生產級日誌和追蹤等功能,並以 Apache 2 授權發布。
如要部署 CodeGemma 模型,請前往 模型頁面 並按下 部署 -> Inference Endpoints 小工具。如欲瞭解更多,請參閲之前的網誌文章:使用 Hugging Face Inference Endpoints 部署 LLM。請注意,T4 不支援 bfloat16 格式,因此你需要選用其他 GPU。
from huggingface_hub import InferenceClient

client = InferenceClient(model=IE_ENDPOINT)

prompt = """\
<|fim_prefix|>import <|fim_suffix|>

if __name__ == '__main__':
  sys.exit(0)<|fim_middle|>\
"""

client.text_generation(prompt=prompt)
其他資源
來源:Hugging Face Blog · huggingface.co