UAEF:用於 AI 智能體閉環評估的跨框架系統
UAEF: A framework-agnostic system for closed-loop evaluation of AI agents
AWS 介紹開源的 UAEF,這套跨框架評估系統將不同框架的 AI 智能體執行軌跡轉為統一格式,並以 36 項內置指標評估 7 個品質維度。
文章把跨框架軌跡標準化、指標評估、基線比較和資料集準備串成一套流程,並提供各支援框架的可執行 notebooks,呈現 UAEF 的實際使用路徑。
在 AWS 上開發 AI Agent 的團隊會使用多種框架,包括 LangGraph、LangChain、Strands Agents 和 Amazon Bedrock AgentCore。每個框架記錄 Agent 執行過程的方式各有不同,因此訊息、工具呼叫和 Agent 之間交接的結構也各不相同。評估工具往往也受同樣限制:團隊會根據單一框架的追蹤記錄格式建立指標、評分邏輯和結果儲存機制;切換框架或在多個框架上執行 Agent 時,就必須重新建立這些工具。
這種依賴令一個基本的開發問題更難回答:提示詞、模型或工具的改動有沒有改善 Agent?要回答這個問題,必須在不同版本的 Agent 之間使用一致的指標,並共用過往結果記錄以作比較。Agent 的品質亦涉及多個層面,單一準確度評分無法全面反映,包括工具呼叫、回應品質、負責任 AI、效能、多輪對話、多 Agent 協調和推理。
本文介紹 Universal Agent Evaluation Framework (UAEF)。電訊、醫療保健和金融服務行業中,來自 12 個機構的客戶使用 UAEF,以一套一致的指標評估其 AI Agent,並在發布前比較不同版本。UAEF 是一套不依賴特定框架的評估系統:它透過轉接器將各框架的追蹤記錄轉換為通用格式,再以 7 個層面的 36 項內置指標為這些記錄評分。它會將結果儲存在 Amazon DynamoDB 和 Amazon Simple Storage Service (Amazon S3),並生成報告和洞察,為 Agent 的下一輪迭代提供參考。本文將介紹 UAEF 的運作方式,提供選擇指標和準備資料集的指南,並列出各個支援框架的可執行筆記本。
UAEF:為 Agent 框架提供統一評估層
UAEF 是一套不依賴特定框架的 AI Agent 評估系統。它會對團隊現有的 Agent 進行評分,並確保在各個支援的框架和執行環境中採用一致的方式。UAEF 接收兩項輸入:受測 Agent,以及用來執行測試的資料集。資料集會提供每個測試案例的輸入,也可以包含標準答案,即每項輸入預期產生的輸出。標準答案屬於選填資料,只有會將 Agent 的回應與參考答案比較的指標才會使用。若要評估工具呼叫,標準答案亦必須列出每個測試案例預期的工具呼叫:Agent 應呼叫哪些工具、按甚麼次序呼叫,以及使用哪些引數。此後的所有工作都會在 UAEF 內完成。
圖 1 展示單次評估的流程,從輸入資料到報告和分析結果。首先,轉接器會讀取代理程式的原生執行紀錄,包括訊息、工具呼叫,以及代理程式之間的交接,並將其標準化為一份統一的追蹤紀錄,讓後續步驟不論代理程式使用哪個框架建立,都完全相同。接着,UAEF 會在資料儲存前,檢查追蹤紀錄是否包含個人身份識別資料(PII),例如電郵地址、電話號碼和信用卡號碼。然後,評估引擎會從涵蓋 7 個質素維度的 36 項內置指標中,選取部分指標為追蹤紀錄評分。儲存一次執行結果時,UAEF 會在 Amazon DynamoDB 和 Amazon S3 中將其記錄為一項實驗:Amazon DynamoDB 儲存用於列出和比較實驗的個別實驗中繼資料,Amazon S3 則儲存完整結果。儲存執行結果後,團隊可以將某個代理程式版本與基準版本比較,以偵測退化情況,並產生報告和分析結果,説明哪些地方有所改變及其原因。這些報告讓整個流程形成閉環:團隊評估代理程式,瞭解哪些方面退步或改善,再修改提示詞、模型或工具,然後再次評估。
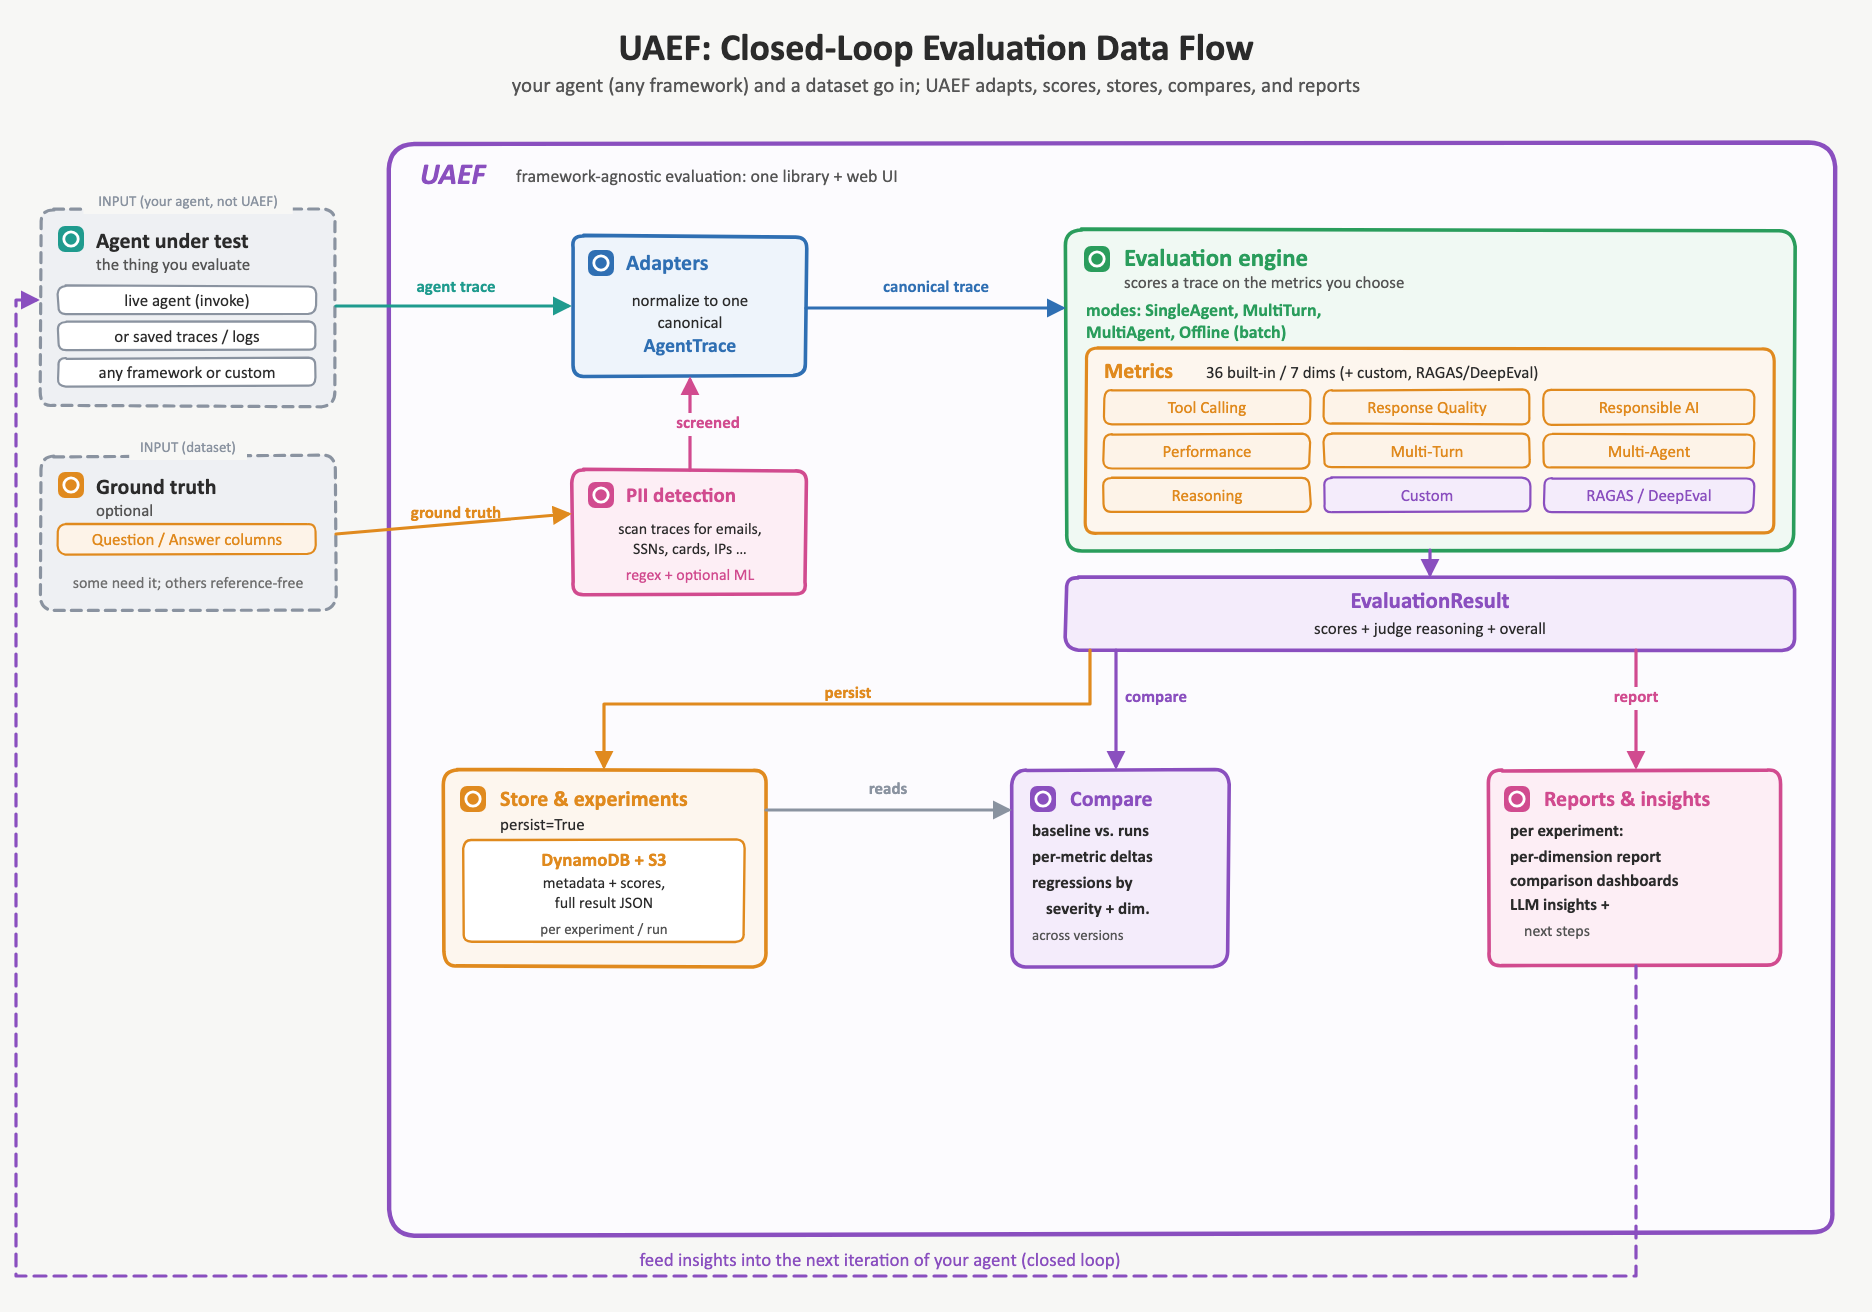
圖 1:UAEF 閉環評估數據流程
本節其餘部分會依照此流程逐一介紹:令 UAEF 不受框架限制的轉接器、評估引擎及其指標、PII 偵測、實驗儲存與比較,以及讓整個流程形成閉環的報告。
標準追蹤紀錄與轉接器
轉接器令 UAEF 不受框架限制。轉接器會讀取代理程式的執行紀錄,包括訊息、工具呼叫,以及代理程式之間的交接,並將紀錄轉換成一種稱為 AgentTrace 的統一表示形式;UAEF 其餘部分只會對這種表示形式評分。透過這項轉換,無論代理程式使用哪個 SDK 建立(例如 LangGraph、LangChain 或 Strands Agents),UAEF 都能與之配合。代理程式可以在本機執行、透過 HTTP 端點執行,或在 Amazon Bedrock AgentCore 等受管理執行環境中執行;追蹤資料可以存放在 Langfuse,也可以完全不作記錄。UAEF 為上述每種情況提供轉接器,而這些轉接器會產生相同的 AgentTrace,因此各種情況下的指標、評分和比較都能保持一致。
追蹤紀錄有兩種方式可以傳送至 UAEF。如果追蹤紀錄已經存在,例如來自過往執行、日誌或可觀測性儲存庫,便會交由 UAEF,再由相應的轉接器將其標準化。如果追蹤紀錄尚不存在,UAEF 會代你呼叫代理程式:只要提供執行環境的 Amazon 資源名稱(ARN)或 HTTP 端點,UAEF 便會針對數據集中的每項輸入呼叫代理程式、收集回應,並在同一個步驟中將其轉換。無論採用哪種方式,輸出都是相同的 AgentTrace。
每項指標、模式和報告都是根據 AgentTrace 運作,而非任何框架的原生格式,因此後續評分不論追蹤紀錄來自何處,都完全相同。這種先標準化、再評分的分工,讓團隊可以在同一套尺度上比較分別以不同框架建立的代理程式。
評估引擎
評估引擎會根據 7 個質素維度為標準追蹤紀錄評分;每個維度都反映代理程式行為的一個不同方面,而這些方面無法單靠一個準確度數字呈現。工具呼叫維度會衡量代理程式是否選用正確工具、按合理次序呼叫工具,以及傳入有效的引數。回應質素維度則會衡量最終答案是否切題、完整、準確,並以所提供的內容為依據,而非憑空捏造。
負責任 AI 維度衡量安全性、偏見、毒性,以及抵禦提示詞注入的能力。效能維度衡量延遲、Token 用量及吞吐量等營運成本。多輪對話維度衡量 Agent 維持對話的能力,包括跨輪次保留上下文、保持連貫,以及完成目標的能力。多 Agent 維度衡量協作 Agent 系統的協調能力,例如委派任務及分工。推理維度衡量 Agent 思維鏈的內在邏輯,包括一致性及避免謬誤的能力。
每個維度由 36 個內置指標中的一個或多個計算得出。每項指標均會回傳介乎 [0, 1] 的標準化評分,1 代表最佳,因此各維度及整體結果採用相同的評分尺度。指標分為兩類。確定性指標根據執行軌跡及標準答案直接計算評分,重複執行時結果完全一致。大型語言模型(LLM)評審指標則用於評分難以明確定義的特質,例如回應相關性或安全性;這類指標會在 Amazon Bedrock 上提示評審模型。你也可以加入自訂指標,或使用 RAGAS 和 DeepEval 整合。
由於評審指標會將 Agent 自身的輸出回饋至提示詞,該內容會被視為不可信輸入:能影響評審模型的 Agent,也能影響自己的評分。評分準則會與內容分開傳送,而內容會經過跳脱處理,避免逸出分隔符,並被當作指令讀取。系統會嚴格解析每個評審回應,並要求其引用所評分內容中的原文片段。若找不到評分所依據的證據,該評分便會被拒絕,而不會記錄。評審評分是評估訊號,不是安全決策,不應用作安全控制的閘門。如要在執行階段對 Agent 本身實施限制,請在其獨立的呼叫路徑中套用 Amazon Bedrock Guardrails。完整模型載於 SECURITY.md。
實驗管理與比較
UAEF 會將每次評估記錄為一項實驗,方便日後比較不同 Agent 版本的結果。使用 persist=True 呼叫 evaluate() 或 batch_evaluate() 會建立一項新實驗,並可為實驗指定名稱和目標;實驗會寫入兩個用途互補的儲存區。Amazon DynamoDB 會為每項實驗儲存一列資料,當中包含用於清單顯示及比較的中繼資料:評估數量、每項指標的平均評分,以及整體平均分。Amazon S3 則會儲存一個 JSON 檔案,內含完整評估結果,包括各項指標的評分及評審的推理過程。處理敏感資料的團隊可以啟用個人資料遮蔽,處理儲存的副本。
Python 程式庫亦會以更細緻的結構記錄資料。一項實驗包含多次執行,而每次執行都會記錄受測 Agent 的設計:框架、模型、工具、系統提示詞及參數。執行記錄亦可包含設定快照及 Git 提交版本。你可以將某次執行標記為該實驗的基準版本。這樣便能將每項評分連繫至帶來變更的項目,無論是新提示詞、不同模型,還是新增工具。
比較會以已儲存的各指標平均值為基礎。對於兩次執行共有的每項指標,比較引擎會計算其絕對變化及百分比變化,然後根據可設定的門檻將指標分類為退步、改善或沒有變化;預設門檻為 5%。單次呼叫即可將多次執行與同一個基準進行比較。退步偵測器亦會為每項退步評定嚴重程度:輕微(5–10%)、中等(10–20%)或嚴重(超過 20%)。它會按維度歸類退步,例如顯示提示詞變更是否影響工具呼叫,但沒有影響回應質素。
在網頁介面的 Compare 分頁中,你可以查看已儲存的實驗,並按框架或數據集篩選。選取兩個或以上的實驗後,第一個會作為基準;介面會顯示各項指標的評分,並標示退步及改善之處。介面會呼叫同一個程式庫的比較引擎,因此結果與 Python API 傳回的結果一致。
報告及洞察生成
評估結果儲存後,UAEF 會從三個層面提供報告,各自回答不同問題:這次執行表現如何?為何會取得這個分數?與較早版本相比如何?
結果檢視。評估完成後,網頁介面會顯示實驗摘要,包括整體評分、已評估的測試案例數目、框架,以及未能執行的查詢。介面會顯示各指標的平均值、維度雷達圖及指標長條圖。表格會列出每個測試案例的查詢、Agent 的回應、預期答案及評分。展開資料列即可查看完整回應,以及各維度和指標的評分。對於多輪對話,介面會顯示每一輪的評分及 Agent 呼叫的工具。
詳細報告。你可以在結果檢視或實驗清單中,按需要生成統計報告。UAEF 會從 Amazon S3 載入已儲存的結果,並在新的瀏覽器分頁中開啟報告。報告會按維度及指標細分結果,並顯示每項指標的信賴區間和離羣值、評分分佈、指標之間的相關性、負責任 AI 摘要,以及有回報失敗的測試案例。報告最後會提供建議,指出評分最低的維度,以及在不同測試案例之間變化最大的指標。報告只根據評分計算,不使用 LLM,因此相同的結果會產生相同的報告。
LLM 生成的洞察。在 Python 程式庫中,你可以將報告傳送至 Amazon Bedrock 上的模型進行分析。分析單次執行時,內容涵蓋優勢、關鍵弱點、對根本原因的假設,以及按優先次序排列的建議。比較多次執行時,內容則涵蓋整體趨勢、退步和改善的可能原因、每項退步帶來的風險,以及後續步驟。這些洞察會指出在下次評估前,可以如何修改提示詞、模型或工具。
兩種使用方式
你可以透過兩種方式使用 UAEF,兩者共用同一評估引擎。使用 Python 程式庫,你可以在筆記本、指令碼,以及持續整合及持續交付 (CI/CD) 管道中透過程式碼評估 Agent。你也可以使用可部署的 AWS 服務,透過低程式碼網頁介面評估 Agent。你只需上載數據集、選擇框架和指標、執行評估,然後查看評分。兩種方式都會執行完全相同的評估引擎,並寫入相同的儲存區,因此評估結果不會因採用哪種方式而有所不同。你可以先使用網頁介面,再轉用程式碼,而無須更改結果的評分或比較方式。
使用 UAEF 評估 Agent:實用指南
瞭解 UAEF 可以衡量甚麼,並不代表知道應該衡量甚麼。旅遊預訂 Agent 和政策問答 Agent 的失效方式各有不同;若在每個維度都為兩者評分,便會浪費時間和 Amazon Bedrock 呼叫次數。你可以參考本指南,為 Agent 選擇合適的指標,並在出現新問題時再加入其他指標。
開始使用
UAEF 在 Apache 2.0 license 下以開源方式發布,並存放於 GitHub 存放庫 awslabs/uaef。它包括 Python 程式庫、框架介接器、內置指標、用於可部署服務的 AWS Cloud Development Kit (AWS CDK) 基礎架構、網頁介面,以及各個支援框架的可執行筆記本。安裝指南涵蓋所需條件、從已建置套件安裝,以及開發環境設定。
服務部署指南涵蓋如何將 UAEF 部署為附有網頁介面的服務、設定參考,以及如何移除部署。
實際示範
在 UAEF 網頁介面中完成整個評估流程,從上載標準答案到查看各維度的評分。
選擇指標
請先考慮你的應用情境,而非指標清單。找出符合你的 Agent 的欄,並從該欄已勾選的指標開始。「需要標準答案」一欄會顯示哪些指標需要與參考答案或預期工具呼叫進行比較。
| 維度 | 指標 | 需要標準答案 | 應用情境 | |||||||
| RAG/知識問答 | 一般問答 | 使用工具的 Agent | 多輪對話 | 推理 | 安全與合規 | 多 Agent | 生產環境監察 | |||
| 回應質素 | answer_relevance | ✓ | ✓ | ✓ | ||||||
| accuracy | ✓ | ✓ | ✓ | |||||||
| completeness | ✓ | ✓ | ✓ | |||||||
| hallucination_score | ✓ | |||||||||
| ragas_faithfulness | ✓ | |||||||||
| ragas_context_precision | ✓ | ✓ | ||||||||
| ragas_context_recall | ✓ | ✓ | ||||||||
| 工具呼叫 | tool_selection_accuracy | ✓ | ✓ | ✓ | ||||||
| tool_sequence_correctness | ✓ | ✓ | ✓ | |||||||
| parameter_quality | ✓ | ✓ | ||||||||
| mcp_compliance | ✓ | |||||||||
| 多輪對話 | context_retention | ✓ | ||||||||
| coherence | ✓ | ✓ | ||||||||
| conversation_completeness | ✓ | ✓ | ||||||||
| user_satisfaction | ✓ | |||||||||
| turn_efficiency | ✓ | |||||||||
| 推理 | chain_of_thought_coherence | ✓ | ||||||||
| logical_consistency | ✓ | |||||||||
| reasoning_step_correctness | ✓ | |||||||||
| fallacy_detection | ✓ | |||||||||
| 負責任 AI | safety_score | ✓ | ✓ | ✓ | ||||||
| toxicity_score | ✓ | |||||||||
| bias_score | ✓ | |||||||||
| prompt_injection_detection | ✓ | |||||||||
| 多 Agent | workflow_completion | ✓ | ✓ | |||||||
| delegation_quality | ✓ | |||||||||
| agent_utilization | ✓ | |||||||||
| coordination_efficiency | ✓ | |||||||||
| 效能 | latency_score | ✓ | ||||||||
| token_efficiency | ✓ | |||||||||
| cost_efficiency | ✓ | |||||||||
| throughput | ✓ | |||||||||
此表列出各應用情境建議優先採用的指標。如要查看所有支援的指標,請參閲指標目錄。
將你選取的指標作為 metrics 參數,傳入 evaluate() 或 batch_evaluate()。如需實作示例,請參閲下文的 Example notebooks 一節。工具呼叫和效能等確定性指標會直接根據執行軌跡計算,其他指標則會呼叫 LLM 評審。沒有標準答案時,UAEF 會自動略過需要參考答案的指標,因此部分已標註的資料集和未標註的正式環境流量仍值得評估。
選擇評估流程
指標決定要衡量甚麼。評估的執行方式則由六項互不相關的選擇決定。請根據每一列的問題作出選擇。
| 選項 | 請問自己 | 然後使用 | 程式碼示例 |
| 被動式或主動式 | 我是否已有執行軌跡,還是需要在受控條件下產生? | 被動式:評估已有的執行軌跡。主動式:呼叫 invoke_* 輔助函式,讓 UAEF 執行代理。 | evaluate(trace=recorded, adapter=“langgraph”) 或 raw = invoke_http_agent_for_framework( ENDPOINT, query, “strands”) |
| 單一執行軌跡或資料集 | 我是在除錯單一個案,還是衡量某個版本的表現? | 使用 evaluate() 評估單一執行軌跡或對話。使用 batch_evaluate() 評估資料集。 | evaluate(trace=trace) 或 batch_evaluate(traces=traces, max_workers=4) |
| 單輪或多輪a | 是否有任何測試個案需要依賴較早的對話輪次? | 多輪:在資料集加入 session_id 和 turn_id,並將每個輪次傳給轉接器,由轉接器組合成各段對話。 | sessions = adapter.transform_to_canonical( turn_payloads) batch_evaluate(traces=sessions) |
| 單一代理或多代理 | 是否有多個代理處理同一個請求? | 無需設定。轉接器會傳回 AgentTrace 或 MultiAgentTrace,而 UAEF 會選取相應的評估器。 | adapter = get_adapter(FRAMEWORK) trace = adapter.transform_to_canonical(raw) |
| 離線或線上 | 我是在發佈前測試,還是在監察正式環境? | 離線:在開發和 CI 中使用已準備好的資料集。線上:逐輪評分即時對話。 | batch_evaluate(…) 或 OnlineEvaluator().evaluate_response( trace=trace) |
| 暫存或持久化b | 我會否將這次執行結果與之後的結果比較? | 持久化:設定 persist=True,並指定實驗名稱。否則,請使用傳回的結果。 | batch_evaluate(traces=traces, persist=True, experiment_name=“Support agent v2”) |
a 多輪對話 –詳情請參閲多輪評估流程指南。
b 只有持久化的執行結果可以比較。
準備資料集
在 CSV 或 XLSX 檔案中為每個測試個案提供一列。只需要 Question。
| 欄位 | 必填 | 用途 |
Question |
是 | 傳送給代理的輸入 |
Answer |
否 | 預期回應 |
context |
否 | 用於檢索式評估的參考文件 |
expected_tool_calls |
否 | 以 JSON 陣列表示的預期工具呼叫 |
session_id |
僅限多輪對話 | 將多列歸入同一段對話 |
turn_id |
僅限多輪對話 | 為對話中的輪次排序,從 1 開始 |
Question 和 Answer 比對時不區分大小寫,亦接受 Query 和 Expected_Output 等常見別名,因此現有測試檔案通常無需重新命名即可使用。
多輪數據集。共用同一個 session_id 的資料列會依序傳送至同一個 Agent 工作階段,因此較後的輪次可以依賴較早的輪次。你的 Agent 端點必須自行維持對話狀態,因為 UAEF 會在每一輪請求中附上工作階段 ID,而不會重播對話記錄。請使用小寫 session_id 和 turn_id。否則,系統會將檔案視為單輪資料進行評估。
保護敏感資料。分享或保存取自真實流量的數據集前,請使用 uaef.security.PIIDetector 偵測並遮蓋電郵地址、電話號碼和信用卡號碼等個人識別資料。
範例筆記本
如要查看更多範例,請查看我們的 notebooks/ 資料夾。這些筆記本涵蓋批次評估、多輪對話、多 Agent,以及實驗管理等情境,並適用於 LangGraph、Strands Agents 和 Amazon Bedrock AgentCore 等框架。
| 筆記本 | 涵蓋內容 |
00_langgraph.ipynb |
LangGraph:單輪、批次、多輪及多 Agent 評估 |
02_langchain.ipynb |
LangChain Agent |
04_json.ipynb |
透過通用 JSON 介面卡支援自訂框架 |
05_strands.ipynb |
Strands Agents,包括多 Agent 評估 |
06_agentcore.ipynb |
Amazon Bedrock AgentCore,包括多 Agent 評估 |
07_langfuse.ipynb |
已在 Langfuse 收集的追蹤資料 |
01_langgraph_ragas_deepeval.ipynb |
RAGAS 和 DeepEval 整合 |
08_experiment_management.ipynb |
實驗、基準測試及回歸偵測 |
10_reporting_pipeline.ipynb |
根據已儲存結果產生報告和儀錶板 |
11_pii_detection.ipynb |
追蹤資料中的個人識別資料偵測與遮蓋 |
清理
程式庫本身不會在執行時建立任何資源,但儲存一次執行結果會將實驗中繼資料寫入 Amazon DynamoDB,並將完整結果寫入 Amazon S3。不再需要已儲存的實驗時,請刪除兩者。預設名稱為 uaef-experiments 和 uaef-results,可透過 UAEF_DYNAMODB_TABLE 和 UAEF_S3_BUCKET 環境變數覆寫。刪除儲存貯體前,必須先將其清空。
如果你已部署服務,服務部署指南列出了兩種部署模式的拆除程序。在認定拆除程序已完成前,請先閲讀當中的資源保留説明:DynamoDB 資料表、S3 儲存貯體和 Amazon Cognito 用戶集區均採用保留政策,因此刪除堆疊後,這些資源及其內容仍會保留。這是刻意安排的,目的是避免拆除程序破壞已儲存的實驗;但這亦表示這些儲存資源會持續產生費用,直至你自行將其移除。
結論
UAEF 將 Agent 評估與建立該 Agent 的框架分開。介面卡會將 LangGraph、LangChain、Strands Agents、Amazon Bedrock AgentCore 和 Langfuse 的追蹤資料轉換為通用格式,而通用 JSON 介面卡則支援其他框架。無論團隊如何建立 Agent,都可套用相同的 7 個維度、共 36 項內置指標。UAEF 會評估個別追蹤資料,或對歷史追蹤資料進行批次評估,然後按實驗將結果儲存在 Amazon DynamoDB 和 Amazon S3。團隊隨後可以比較不同 Agent 版本的執行結果、偵測回歸問題,並利用系統產生的報告和洞察,決定下一輪要作出哪些改動。網頁介面和 Python 程式庫共用同一個評估引擎,因此團隊可以先採用低程式碼方式,再轉用程式碼,而無須更改評分或儲存方式。
如要開始使用,請參閲開源程式碼庫。
關於作者

Samaneh Aminikhanghahi
Samaneh 是 AWS Forward Deployed Engineer (FDE) 團隊的應用科學家,與不同行業的客戶合作,加快他們採用生成式 AI。她專門研究 Agentic AI 框架、建構穩健的評估系統,以及落實負責任 AI 實踐,以推動可持續的業務成果。

Yuxuan Zhou
Yuxuan 是 AWS Forward Deployed Engineer (FDE) 團隊的數據科學家,協助企業客戶建構及擴展生成式 AI 解決方案。她曾為 AWS 在金融服務、保險、製造、醫療保健,以及媒體及娛樂業的客戶交付項目。她專門研究 Agentic 檢索增強生成 (RAG)、支援長上下文推理的上下文工程,以及 AI Agent 評估框架。她的研究亦涵蓋大型語言模型校準,以及多模態視覺語言模型。

Tristan Sylvain
Tristan 是 AWS Forward Deployed Engineer (FDE) 團隊的應用科學家,與客戶合作設計及部署生成式 AI 解決方案。他曾在金融服務、物流及工業等領域交付項目。他的研究專長涵蓋大型語言模型應用、表徵學習、電腦視覺及醫療數據中的泛化,以及時間序列預測。

Amulya Cherian
Amulya 是 AWS Professional Services 的副交付顧問,專長於 AI/ML。她曾為 AWS 在多個行業的客戶交付生成式 AI 項目,包括金融、媒體及娛樂,以及醫療保健。

Elaine Wu
Elaine 是 AWS Forward Deployed Engineer (FDE) 團隊的深度學習架構師,專門為大型企業建構穩健的 RAG 及 Agentic AI 解決方案。她為 AWS 在製造、能源、醫療保健、零售、企業軟件及金融服務等行業的客戶解決實際業務難題。加入 AWS 前,Elaine 在 University of Illinois Urbana-Champaign 取得資訊科學碩士學位。

Vidya Sagar Ravipati
Vidya 是 AWS Forward Deployed Engineer (FDE) 團隊的應用科學經理,運用他在大規模分散式系統方面的豐富經驗,以及對機器學習的熱忱,協助 AWS 不同行業的客戶加快採用 AI 及雲端技術。

Meghana Ashok
Meghana 是 AWS Forward Deployed Engineer (FDE) 團隊的高級機器學習工程師,工作範疇涵蓋工程、研究及生成式 AI 解決方案。她專門設計及建構可擴展的 AI 架構,連接前沿生成式 AI 研究與可投入生產環境的系統。Meghana 熱衷於將複雜的生成式 AI 概念轉化為穩健、可部署的解決方案,並結合深厚的技術工程專長與前瞻的思維,推動 AI 驅動的自動化及智能系統創新。
來源:AWS Machine Learning Blog · aws.amazon.com