Amazon Polly 推出語音複製功能,讓品牌建立專屬聲音
Amazon Polly launches voice cloning: A unique voice for your brand
Amazon Polly 的語音複製功能已正式推出,目前採受限開放,只有部分客戶已獲啟用。用戶可提供 1–10 段經説話者同意的錄音,通常 5–10 分鐘即可完成聲音建立,功能支援七種語言。建立聲音免費,合成語音則按用量收費;聲音只屬建立它的 AWS 帳戶及區域,並可透過 Amazon Polly API 用於即時或長篇語音合成。
文章除介紹功能外,也列出建立流程、説話者同意、權限管理及區域配額,呈現將語音複製整合至應用程式時的實務環節。
Amazon Polly 的語音克隆功能現已正式推出,採取受限開放形式。提供幾分鐘已取得講者同意用於克隆其聲音的錄音,Amazon Polly 就會以該講者的聲線為你建立專屬的克隆語音。克隆語音使用 Amazon Polly 生成式引擎運作,其自然度和準確度與其他生成式語音相若。Amazon Polly 語音克隆功能推出時支援七種語言:英語、西班牙語、德語、法語、意大利語、葡萄牙語和印地語。每個克隆語音均會使用錄製時所用的語言説話。克隆語音會自動加密並設有存取控制:只有你可以存取自己的克隆語音。
Amazon Polly 語音克隆功能適用於所有支援 Amazon Polly 生成式引擎的 AWS 區域,包括 AWS GovCloud (US) Region。部分 Amazon Polly 客戶已獲開通存取權限。其他客戶可聯絡 AWS 帳戶團隊,或申請存取權限。
新增此功能後,你可以將語音克隆的整個生命週期整合至 AWS 應用程式。Amazon Polly 客戶建立克隆語音毋須付費;使用克隆語音則按用量付費,詳情請參閲 Amazon Polly 定價頁面。
親自聽聽效果
按下播放:開首幾秒是真人錄音,之後便會由克隆語音接替,讀出講者從未錄製過的內容。
- From recordings to TTS voice. A few minutes of our science lead Trevor’s source audio, and the resulting generative voice.
- 錄音:「你好,我是 Trevor,來自 Science。」克隆語音:「第一句是我的真實聲音。這是我的克隆語音,由幾分鐘的錄音製作而成。它可以讀出你提供的任何文字。」
- Supports seven languages. Hear Jonas, one of the authors, speaking German in his recording and then in his cloned voice:
- 錄音:「Hallo, ich bin Jonas. Das ist meine echte Stimme.」(你好,我是 Jonas。這是我的真實聲音。)克隆語音:「Und das ist meine geklonte Stimme! Gleiche Stimme, neue Worte: Diesen Satz habe ich geschrieben, aber nie aufgenommen.」(這就是我的克隆語音!聲音相同,內容全新:這句話是我寫的,但從未錄製過。)
- Use in a variety of applications. Here’s Trevor in a new job he hasn’t had: a non-player character in a game.
- 「是誰在過我的橋?哦,又是你。規矩跟上次一樣:答對我的謎語,否則就把三文治交出來。」
- Expand your voice library with voice cloning. Hear this audio sample from AWS Chief Evangelist Jeff Barr: a real recording, then his cloned voice.
- 錄音:「你好,我是 Jeff,這就是我真實的聲音。」克隆語音:「這就是我的克隆語音讀出一個我從未錄製過的句子時的聲音。」
- Hannah: a real recording, then her cloned voice on a support line.
- 錄音:「你好,我是 Hannah。這是我的真實聲音。」克隆語音:「感謝致電 AnyCompany。你的訂單 4471 9902 今天寄出,預計於星期四上午 9 AM 至 1 PM 送達。你的確認碼是 K-7-Q-2-X-9。」
- Joely: a real recording, then her cloned voice narrating a lesson.
- 錄音:「你好,我是 Joely,這就是我真實的聲音。」克隆語音:「在這個模組中,我們會探討神經網絡如何學習。首先,它會作出猜測,然後計算猜測的誤差,再逐步作出調整。」
可建立的應用
跨渠道保持一致的品牌聲音
建立一種容易辨認的聲音,並將它應用於互動語音應答(IVR)系統、級聯語音 Agent、流動應用程式、店內廣播、廣告和連接裝置。無須依賴通用的預設語音,也不用每次更改稿件時重新預約錄音,你可以按需要生成符合品牌形象的音訊,並在所有渠道保持一致的聲音。
聯絡中心
在自助服務流程中維持鮮明且符合品牌形象的語音風格;當優惠和政策有變時,可更新提示詞,無需重新安排錄音室錄製。你可以根據來源文字建立提示詞,在推出前進行測試,並在問候、路由及通知體驗中使用同一語音。
大規模製作媒體與內容
創作者、出版商及錄音室可以使用多種自訂語音製作有聲書、課程、Podcast、遊戲角色和影片,提升聆聽體驗,並快速製作後續章節或更新內容。
以一致的角色形象進行本地化
在整個內容庫中維持鮮明且一致的語音身份,令旁白在不同作品和更新內容之間保持連貫。每個複製語音只會説出錄製時使用的語言。如要提供多語言體驗,請為每種支援語言建立並審核獲批語音。
無障礙功能與個人化
為閲讀體驗、輔助工具及個人化互動提供自然、近似真人的語音。每次建立語音時,你都會確認説話者已同意。
語音複製的運作方式
使用語音複製,你可以根據單一説話者的錄音建立自訂 Amazon Polly 語音,然後透過 Amazon Polly 生成式引擎合成該語音。整個流程分為四個步驟,由錄製説話者的聲音開始,到使用完成的語音為止:
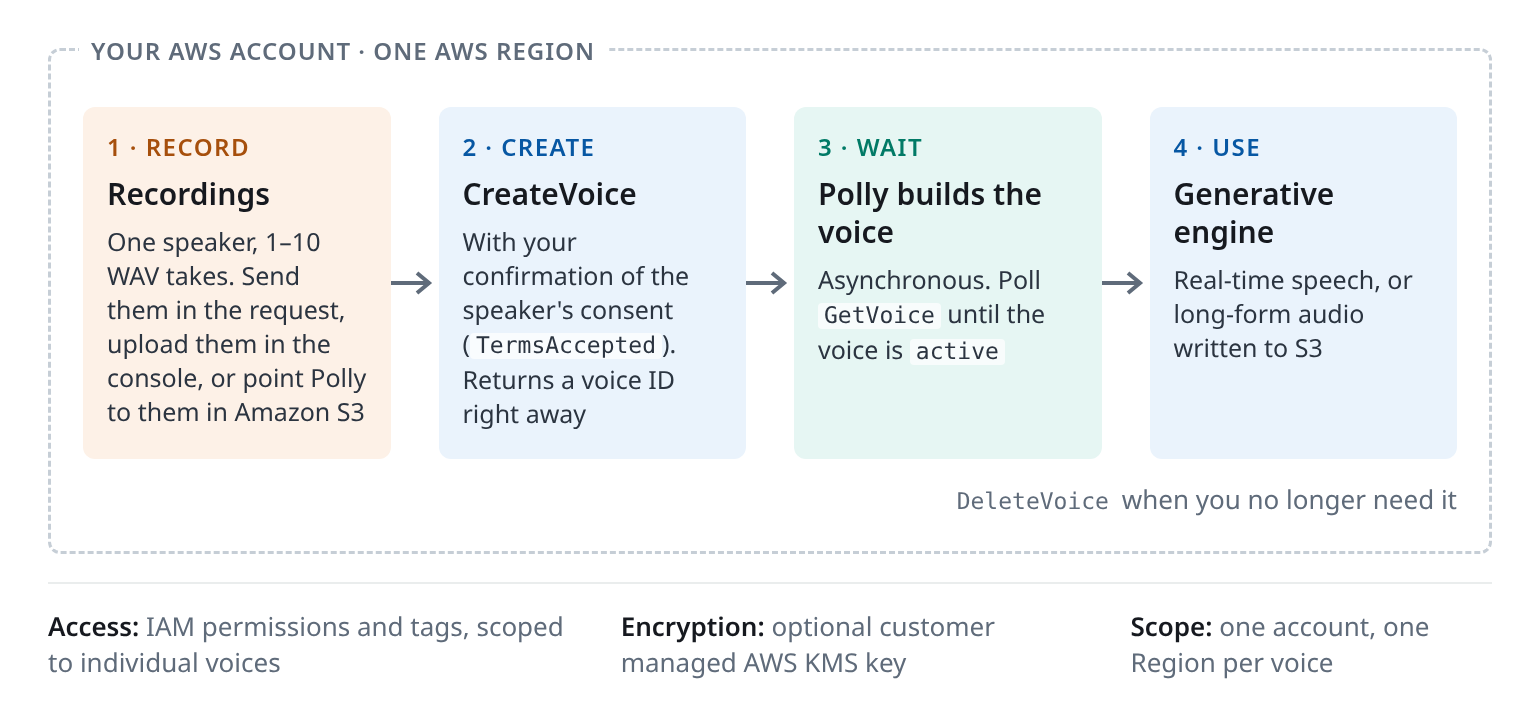
圖 1:語音複製的生命週期,由錄製説話者的聲音到使用完成的語音
複製語音分為四個步驟:
- 錄製。錄製一位説話者的聲音(請參閲下方的錄音提示)。你可以在
CreateVoice請求中直接傳送錄音,或在主控台上載錄音。你也可以將錄音存放在語音所屬 AWS 區域的 Amazon Simple Storage Service (Amazon S3) 儲存貯體中,並將其位置提供給 Amazon Polly。 - 建立。你呼叫
CreateVoice,提供 1-10 段錄音、錄音所用的語言,以及TermsAccepted=True,確認你已取得説話者的同意。Amazon Polly 會即時返回語音 ID(vc-…),並在背景建立語音。 - 等待。建立程序以非同步方式進行,通常需時 5-10 分鐘。在此期間,Amazon Polly 亦會檢查文字轉語音 (TTS) 語音的品質,以及語音與説話者的相似程度。你需要持續呼叫
GetVoice,直到狀態由pending變為active或failed。 - 使用。你可以將語音 ID 傳入
SynthesizeSpeech以取得即時音訊,或傳入StartSpeechSynthesisTask以產生寫入 S3 的長篇音訊,並使用Engine="generative",方式與呼叫 Amazon Polly 中其他生成式語音相同。不再需要該語音時,請呼叫DeleteVoice。
同意與控制
複製語音是根據一個人的錄音建立。你須確認已取得説話者對所有錄音的同意,並且能控制誰可使用該語音,以及何時刪除該語音。
- 每次建立語音時,你都須確認已取得同意。在主控台建立語音,或在 API 中使用
TermsAccepted=True建立語音時,你須確認已取得建立及使用複製語音所需的一切權利和同意。使用語音複製須遵守 AWS 服務條款、生物特徵通知及同意條款、AWS 負責任 AI 政策及 AWS 可接受使用政策。 - 生成的語音帶有浮水印。Amazon Polly 會在使用複製語音生成的文字轉語音音訊中加入浮水印。
- 只有你的帳戶可以使用該語音。複製的語音只限建立它的 AWS 帳戶使用,而你可以透過 AWS Identity and Access Management (IAM) 控制存取權限。你可以使用自己的 AWS Key Management Service (AWS KMS) 金鑰加密語音,並為語音加上標籤。
- 你可以決定何時刪除語音。語音啟用後或建立失敗後,均可透過一次
DeleteVoice呼叫或在主控台刪除語音。 - 建立語音後,Amazon Polly 不會保留你的語音錄音副本,也不會用它們訓練 Amazon Polly 模型。Amazon Polly 只會保留合成語音所需的語音資料,並以加密方式儲存。你可以使用自己的 AWS KMS 金鑰進行加密,而
DeleteVoice會立即移除資料。
我們建議你:
- 保留每位講者同意的紀錄。
- 如果講者撤回同意,請刪除該語音。
- 在適當情況下,告知聽眾他們聽到的是合成語音。
- 只向需要使用語音的人員和系統授予語音權限。
如要了解預期用途和限制,請參閲 Amazon Polly AI Service Card 和 AWS Responsible Use of AI 指引。
錄音最佳做法
複製的語音會從錄音中學習,包括你不希望它學到的部分:手提電腦風扇聲、房間迴音,以及會議應用程式的降噪功能。
- 錄製兩至十分鐘的自然説話內容,分成每段最多一分鐘的錄音。每個語音最多可提交 10 段錄音,音訊總長度最多為 15 分鐘。音質比長度重要:增加音訊未必會改變語音的聽感。
- 一位講者、安靜的房間,並與麥克風保持相同距離。使用 USB 麥克風,或可以錄製 WAV 的手機應用程式。由一開始便以單聲道 WAV、16-bit、24 kHz 格式錄音,避免日後需要轉換。Amazon Polly 接受其他音訊格式,但我們建議使用 WAV。如需瞭解支援的格式和限制,請參閲 Amazon Polly Developer Guide。
- 避免使用會議應用程式和瀏覽器錄音工具。它們的迴音消除和降噪功能會改變語音,而複製的語音也會學到這些變化。
- 每段錄音都要採用你希望語音呈現的風格。複製的語音會沿用錄音中的風格,而且無法融合多種風格,因此,分別錄製歡快、悲傷和憤怒的內容,不會讓複製的語音同時具備這三種風格。
- 以語音應使用的語言錄音。語音複製功能已使用美式英語、德語、美式西班牙語、法語、意大利語、巴西葡萄牙語和印地語錄音進行測試。這些語言的其他口音,例如英式英語或加拿大法語,也可以使用,但測試較少,因此請用自己的內容測試語音。
開始使用
在主控台:帳戶啟用語音複製功能後(請參閲「可用性」),展開左側面板並選擇 語音複製,上載最多 10 段錄音或從 Amazon S3 選取錄音,確認條款,再選擇 建立。每個上載檔案最多可有 5 MB。語音準備就緒後,可在其詳細資料頁面試用。
使用程式碼時,你需要:
- boto3 的最新版本(
pip install --upgrade boto3)。 polly:CreateVoice、polly:GetVoice、polly:DescribeVoices、polly:SynthesizeSpeech和polly:DeleteVoice的 IAM 權限。處理長篇音訊時,亦須在輸出儲存貯體上具備polly:StartSpeechSynthesisTask、polly:GetSpeechSynthesisTask和s3:PutObject權限。- 以下 Amazon S3 範例的要求:錄音需存放在建立語音所在區域的儲存貯體中,並向呼叫
CreateVoice的 IAM 角色或用戶授予s3:GetObject權限。
import time

import boto3

# Use the Region of your S3 recordings.
polly = boto3.client("polly", region_name="us-east-1")

# 1. Create a voice from recordings of a speaker who has given consent.
#    Use 1-10 clean WAV takes of up to a minute each.
takes = [
    "s3://amzn-s3-demo-bucket/brand-voice/take-1.wav",
    "s3://amzn-s3-demo-bucket/brand-voice/take-2.wav",
    "s3://amzn-s3-demo-bucket/brand-voice/take-3.wav",
]
voice = polly.create_voice(
    Name="MyBrandVoice",    # letters, digits, - and _, up to 64 characters
    LanguageCode="en-US",   # the language spoken in the recordings
    TermsAccepted=True,     # you confirm the speaker's consent and the terms of use
    VoiceCreationData={
        "Recordings": [{"Format": "wav", "Data": {"S3Url": url}} for url in takes],
    },
    Tags={"consent-record": "speaker-0042"},  # optional: the ID of your own consent record, e.g. a signed release
    # Optional: encrypt the voice with your own KMS key (symmetric, same Region).
    # Callers who create or use the voice need kms:DescribeKey,
    # kms:GenerateDataKey and kms:Decrypt on the key.
    # CustomerManagedEncryption={
    #     "KmsKeyArn": "arn:aws:kms:us-east-1:111122223333:key/EXAMPLE"
    # },
)["Voice"]
voice_id = voice["Id"]      # for example "vc-0123456789"

# 2. Check the status every 30 seconds until the voice is active or failed
#    (usually a few minutes). Stop with an error after 20 minutes.
deadline = time.monotonic() + 20 * 60
while voice["Status"] not in ("active", "failed"):
    if time.monotonic() > deadline:
        raise TimeoutError(f"{voice_id} is still {voice['Status']}")
    time.sleep(30)
    voice = polly.get_voice(VoiceId=voice_id)["Voice"]
if voice["Status"] == "failed":
    # Check the recordings, delete this voice and create a new one.
    raise RuntimeError(f"{voice_id}: {voice.get('StatusReason', 'creation failed')}")

# 3. Synthesize speech with your new voice.
speech = polly.synthesize_speech(
    VoiceId=voice_id,
    Engine="generative",
    LanguageCode="en-US",
    OutputFormat="mp3",
    Text="Hello! This is my very own Amazon Polly voice.",
)
with open("my-voice.mp3", "wb") as f:
    f.write(speech["AudioStream"].read())

# When you no longer need the voice:
# polly.delete_voice(VoiceId=voice_id)
如果 Python 顯示 Polly 物件沒有 create_voice 屬性,請升級 boto3。
對於有聲書章節或課程單元等較長文字,請使用非同步合成任務,將音訊寫入 S3:
from pathlib import Path

task = polly.start_speech_synthesis_task(
    VoiceId=voice_id,
    Engine="generative",
    LanguageCode="en-US",
    OutputFormat="mp3",
    OutputS3BucketName="amzn-s3-demo-bucket",
    OutputS3KeyPrefix="narration/chapter-01",
    Text=Path("chapter-01.txt").read_text(encoding="utf-8"),
    # SnsTopicArn="arn:aws:sns:us-east-1:111122223333:polly-tasks",  # notify instead of polling
)["SynthesisTask"]
print(task["TaskId"], task["OutputUri"])  # poll get_speech_synthesis_task until "completed" or "failed"
如要進一步瞭解可透過 Amazon Polly 建置的端到端 Speech AI 應用程式,包括語音複製功能,例如級聯式語音 Agent 和即時語音翻譯器,請前往 Amazon Polly GitHub 儲存庫。
正式環境考量
預先建立語音
建立語音需要幾分鐘,因此應將其視為資源配置步驟,而非用戶請求的一部分。小型工作流程(例如 AWS Step Functions 或工作佇列)可以呼叫 CreateVoice,每隔 30 秒檢查 GetVoice,直至語音處於啟用狀態,然後將語音 ID 儲存在設定中。CreateVoice 和 DeleteVoice 共用每秒 1 個請求的限制,因此應將大量建立和刪除操作加入佇列。
維護清單
DescribeVoices 會將複製語音與 Amazon Polly 內置語音一併列出。複製語音的 Origin 設為 customer。請為每個語音儲存語音 ID、區域、語言、同意參考資料和負責人,並為每個語音指定唯一的 Name。如果 CreateVoice 呼叫逾時或傳回伺服器錯誤,該語音可能已經存在,而 SDK 的自動重試可能會建立第二個。再次嘗試前,請先在 DescribeVoices 中搜尋該名稱。
預備處理錯誤
如果超出與 DeleteVoice 共用的每秒 1 個請求限制,CreateVoice 會傳回 ThrottlingException;如果帳戶在該區域已達到複製語音配額,則會傳回 ServiceQuotaExceededException。使用仍在建立中的語音進行合成或將其刪除,會傳回 ConflictException。如果語音使用自己的 KMS 金鑰,沒有該金鑰存取權的呼叫者會收到存取遭拒錯誤。建立失敗時,StatusReason 只會提供一般訊息,因此請根據前文所述的錄音最佳做法檢查錄音,然後刪除失敗的語音並重新建立。
將權限範圍限定於語音
複製語音是 IAM 資源,因此可以授予處理服務流量的角色權限,讓其使用指定的一個語音進行合成。如果語音使用自己的 KMS 金鑰,該角色亦須有權存取該金鑰。請將 polly:CreateVoice 和 polly:DeleteVoice 留給獨立的資源配置角色使用。以下是服務角色的政策範例:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "polly:SynthesizeSpeech",
      "Resource": "arn:aws:polly:us-east-1:111122223333:voice/vc-0123456789"
    }
  ]
}
透過 aws:ResourceTag 條件,可使用同一規則一次套用至整組語音。亦請檢查現有政策:允許對所有資源 ("Resource": "*") 執行 polly:SynthesizeSpeech 的陳述式,也會涵蓋帳戶中的所有複製語音。
規劃配額和區域
每個帳戶在每個區域的初始配額為 10 個複製語音。如要申請提高配額,請聯絡您的帳戶團隊或 AWS Support。語音只存在於建立它的帳戶和區域中。如要在另一個區域或帳戶提供服務,請使用相同錄音在該區域重新建立語音,並確保説話者的同意涵蓋每個副本。
使用實際稿件進行測試
語音正式上線前,請聆聽它朗讀自己的內容:產品名稱、數字、地址,以及最長的句子。同一段文字在不同請求中生成的語音可能略有不同。對於電話問候語等固定提示詞,請只生成一次音訊,由説話者和品牌團隊核准,然後提供已儲存的檔案。如果名稱或術語讀錯,請在文字中採用不同拼法,或使用語音合成標記語言 (SSML) <phoneme> 標籤。音素標籤適用於英文、法文、意大利文、德文和西班牙文的複製語音。請參閲 支援的 SSML 標籤。
須知事項
| 可用性 | 語音複製功能按 AWS 帳戶啟用。如果你在 Amazon Polly 主控台看到「語音複製」(展開左側面板,查看是否列出「語音複製」),即表示此功能已為你的帳戶啟用。如果沒有,你可以聯絡 AWS 客戶團隊,或申請使用權限。支援的 AWS 區域與生成式引擎相同:美國東部(維吉尼亞北部)、美國西部(俄勒岡)、歐洲(法蘭克福)、歐洲(蘇黎世)、歐洲(倫敦)、亞太地區(悉尼)、亞太地區(首爾)、亞太地區(新加坡)、亞太地區(東京)、加拿大(中部),以及 AWS GovCloud (US-West)。複製語音會保存在建立它的 AWS 區域。 |
| 語言 | 英語、德語、西班牙語、法語、意大利語、葡萄牙語和印地語。已測試的錄音語言地區:美國英語(en-US)、德語(de-DE)、美國西班牙語(es-US)、法語(fr-FR)、意大利語(it-IT)、巴西葡萄牙語(pt-BR)和印地語(hi-IN)。這些語言的其他口音也適用,但測試較少。每種語音都會説出錄製時使用的語言。 |
| 錄音 | 每種語音可使用 1-10 段錄音,總時長最多 15 分鐘。建議使用 WAV 格式:單聲道、16 位元、取樣率為 24 kHz 或 44.1/48 kHz。Amazon Polly 亦接受其他音訊格式。透過主控台上載的檔案,每個檔案不得超過 5 MB。較大的檔案請使用 Amazon S3。 |
| 資料處理 | 建立語音後,Amazon Polly 會刪除錄音副本,亦不會使用錄音訓練 Amazon Polly 模型。Amazon Polly 只會保留合成語音所需的語音資料,並以加密方式儲存(你可以使用自己的 AWS KMS 金鑰),直至你呼叫 DeleteVoice。 |
| 建立時間 | 建立 TTS 語音通常需時 5-10 分鐘,並以非同步方式進行。 |
| 合成延遲 | 與 Amazon Polly 的生成式語音相同。 |
| 配額 | 每個 AWS 區域的每個帳戶初始可建立 10 個複製語音。如需提高配額,請聯絡 AWS Support。CreateVoice和DeleteVoice共用每秒 1 個請求的上限。 |
| 合成 | 複製語音須遵守 Amazon Polly 的生成式語音配額,包括每個請求及每項合成工作的文字長度限制。請參閲Amazon Polly 配額。 |
| 定價 | 建立複製語音免費。Amazon Polly 按用量收費,計算複製語音的使用費用。請參閲Amazon Polly 定價。 |
| API | 使用CreateVoice、GetVoice、DeleteVoice和DescribeVoices管理語音。使用SynthesizeSpeech和StartSpeechSynthesisTask搭配Engine="generative"來使用語音。請參閲Amazon Polly API 參考。 |
總結
Amazon Polly 的語音複製功能可為你的應用程式提供一種讓人熟悉的聲音:只需錄製一次,取得説話者同意後,即可透過 Amazon Polly API 使用。如要在主控台開始使用,請確認你的帳戶已啟用語音複製功能,準備好錄音及所需的同意,開啟Amazon Polly 主控台,並建立你的第一個複製語音。如果你是新客戶並希望啟用語音複製功能,請聯絡 AWS 客戶團隊,或申請使用權限。
如需開發人員指南,請參閲Amazon Polly 文件。如需定價資訊,請參閲Amazon Polly 定價頁面。如要了解更多可使用 Amazon Polly 建立的語音 AI 應用場景,包括語音複製,請查看GitHub 儲存庫。
我們期待聽聽你創作的成果。
感謝 Trevor Wood、Jonas Rohnke、Suyin Wang、Hannah Barrett、Nikie Xiong、Jeff Barr 和 Joely Huang 借出聲音。
關於作者

Suyin Wang
Suyin 是 AWS 的資深生成式 AI 解決方案架構師。她多年來致力建立以數據為本的應用程式及機器學習應用程式,解決現實問題。她樂於協助客戶找出值得解決的問題,並建立能創造業務價值的生成式 AI 解決方案。閒暇時,她喜歡唱歌,或在廚房試做新食譜。

Jonas Rohnke
Jonas 是 Amazon Polly 的資深技術項目經理。他將科學、工程和產品工作結合起來,讓研究成果中的新語音能夠送到客戶手上,包括本文提及的複製語音。他喜歡簡單明瞭的計劃,也喜歡真正能讓人聽到的產品發布。工作以外,他會操控無人機在英格蘭鄉郊上空拍攝短片,也會製作辣椒油,辣度比他承認的高得多。

Nikie Xiong
Nikie 是 Amazon Polly 的資深技術產品經理,在 AI、語音技術,以及推動創新產品從構思到推出方面,於消費者及企業市場累積了 10+ 年經驗。她具備產品設計和媒體娛樂製作背景,熱衷於打造令客戶欣喜的產品和體驗。工作以外,她會創作互動藝術,也喜歡 techno 音樂。
來源:AWS Machine Learning Blog · aws.amazon.com