在 Amazon SageMaker HyperPod 上偵測及恢復靜默數據損壞
Detecting and recovering from silent data corruption on Amazon SageMaker HyperPod
文章示範在 Amazon SageMaker HyperPod 的 PyTorch DDP 訓練流程加入三項檢查,以偵測靜默數據損壞並定位可疑 GPU。流程涵蓋非有限梯度檢查、跨節點 ring replay 和權重指紋比對,並説明如何隔離及替換可疑節點,再從可疑窗口前的檢查點恢復。
文章將靜默數據損壞的偵測、定位及節點恢復連成 DDP 實作流程,並説明各項檢查的覆蓋範圍與效能成本。
靜默數據損毀(SDC)是指硬件(例如 GPU)傳回錯誤但看似合理的數值,而且不會發出錯誤訊息。在分散式訓練中,錯誤數值可能流入每個副本的梯度和權重。損失值可能連續數小時看起來正常;等到團隊發現無法解釋的偏差或模型效能較弱時,計算資源已經耗用。這種情況在大規模運算時也會發生:在長達 54 天、使用多達 16K 部 H100 GPU 進行的 Llama 3 405B 預訓練期間,Meta 將 419 次意外作業中斷中的 6 次歸因於靜默數據損毀;而這些只是造成作業中斷、並經追查確認為 SDC 的個案。
Amazon SageMaker HyperPod 已會更換回報故障的節點:健康監控代理程式會監察 GPU 錯誤,深度健康檢查會對節點進行壓力測試,自動節點復原則會換走故障硬件。SDC 卻能避過所有這些功能,因為硬件根本不會回報任何問題。檢測必須由訓練作業本身進行。
在本文中,我們在 PyTorch DistributedDataParallel (DDP) 訓練迴圈中加入三項檢查,以偵測 SDC。檢查觸發時,我們會找出可疑 rank 所屬的節點,控制損毀範圍,並讓 SageMaker HyperPod 更換該節點。每項檢查涵蓋故障可能出現的不同位置:
- 非有限梯度檢查會在故障發生的步驟中,捕捉 GPU 前向或反向傳播時出現的 NaN、Inf 和溢位,以及梯度 all-reduce 引入的 NaN 或 Inf。
- 環形重播稽核會捕捉有限但錯誤的數值。在稽核步驟中,每部 GPU 都會重新計算來自另一個節點的一個微批次,並逐位元比較損失值,再以指紋比較梯度。
- 權重指紋比較會在更新後比較每個副本的權重,以捕捉最佳化器步驟及儲存權重中的損毀。
我們在一個 SageMaker HyperPod 叢集上測試這些檢查,並透過軟件注入故障;該叢集有 4 個 ml.p5.48xlarge 執行個體(32 部 NVIDIA H100 GPU)。我們在三個執行個體上重複每項測試,這是這些檢查所需的最低數量。此方案的完整程式碼載於隨附的 GitHub 存放庫。
靜默數據損毀如何發生,以及為何常見檢查無法偵測
SDC 源於製造缺陷(例如未被供應商篩選發現的裕度不足電晶體),以及特定計算單元的矽晶老化。故障最常出現在張量核心中的乘積累加運算通道,而這正是模型訓練會大量使用的硬件。這種裕度不足的電路大部分時間都能正確運算,只會在高温、電壓驟降或特定運算元模式等壓力情況下出錯。由於算術邏輯路徑沒有 ECC 或同位檢查(與記憶體不同),錯誤結果(例如 4.0000 變成 4.0001)不會被標示出來,並會經由啟動值和梯度流入每個副本的權重。
SDC 難以捕捉的原因,是它出現在計算路徑中,而你現有的每項完整性檢查防護的都是不同邊界:
| 檢查項目 | 防護對象 | 為何無法偵測 SDC |
| ECC | 記憶體 | 可捕捉記憶體中的位元翻轉,卻無法捕捉錯誤運算。張量核心的運算結果沒有 ECC 保護。 |
| Xid 錯誤 (NVRM) | GPU 驅動程式/硬件故障 | GPU 偵測到故障時會觸發 Xid。按定義,SDC 不會觸發任何錯誤,因此不會有任何內容寫入 /aws/sagemaker/Clusters/ HMA 記錄。 |
| DCGM 深度健康檢查 | 硬件故障 | 無法偵測只有在特定工作負載的運算元、熱狀態或時序下才會出現的缺陷。檢查會在閒置節點上執行,不屬於你的作業。 |
| NVLink / PCIe / EFA 檢查碼 | 傳輸 | 檢查位元組是否按傳送時的內容到達,而非檢查它們是否計算正確。 |
| 檢查點校驗和 | 儲存往返測試 | 遭污染但內容一致的檢查點,校驗和仍會通過。 |
要捕捉 SDC,就要檢查計算本身的結果。
解決方案概覽
整個流程分為四個步驟。你的訓練工作負載負責頭兩步,後兩步則使用 Kubernetes 和 SageMaker HyperPod 的功能:
步驟 1. 偵測:訓練迴圈中的三項檢查會透過比較數據並行副本,指出可疑的 GPU。
步驟 2. 定位:在由 Amazon Elastic Kubernetes Service (Amazon EKS) 編排的 SageMaker HyperPod 叢集中,Kubernetes 節點名稱包含執行個體 ID,因此只需查找即可將可疑的 rank 對應至節點。
步驟 3. 隔離並關聯:停止工作負載、封鎖該節點,並在 SageMaker HyperPod 可觀測性儀錶板查看該節點的 GPU 指標。
步驟 4. 確認並復原:警報含糊時進行確認;檢查後更換節點,並從可疑時段之前儲存的檢查點繼續執行。
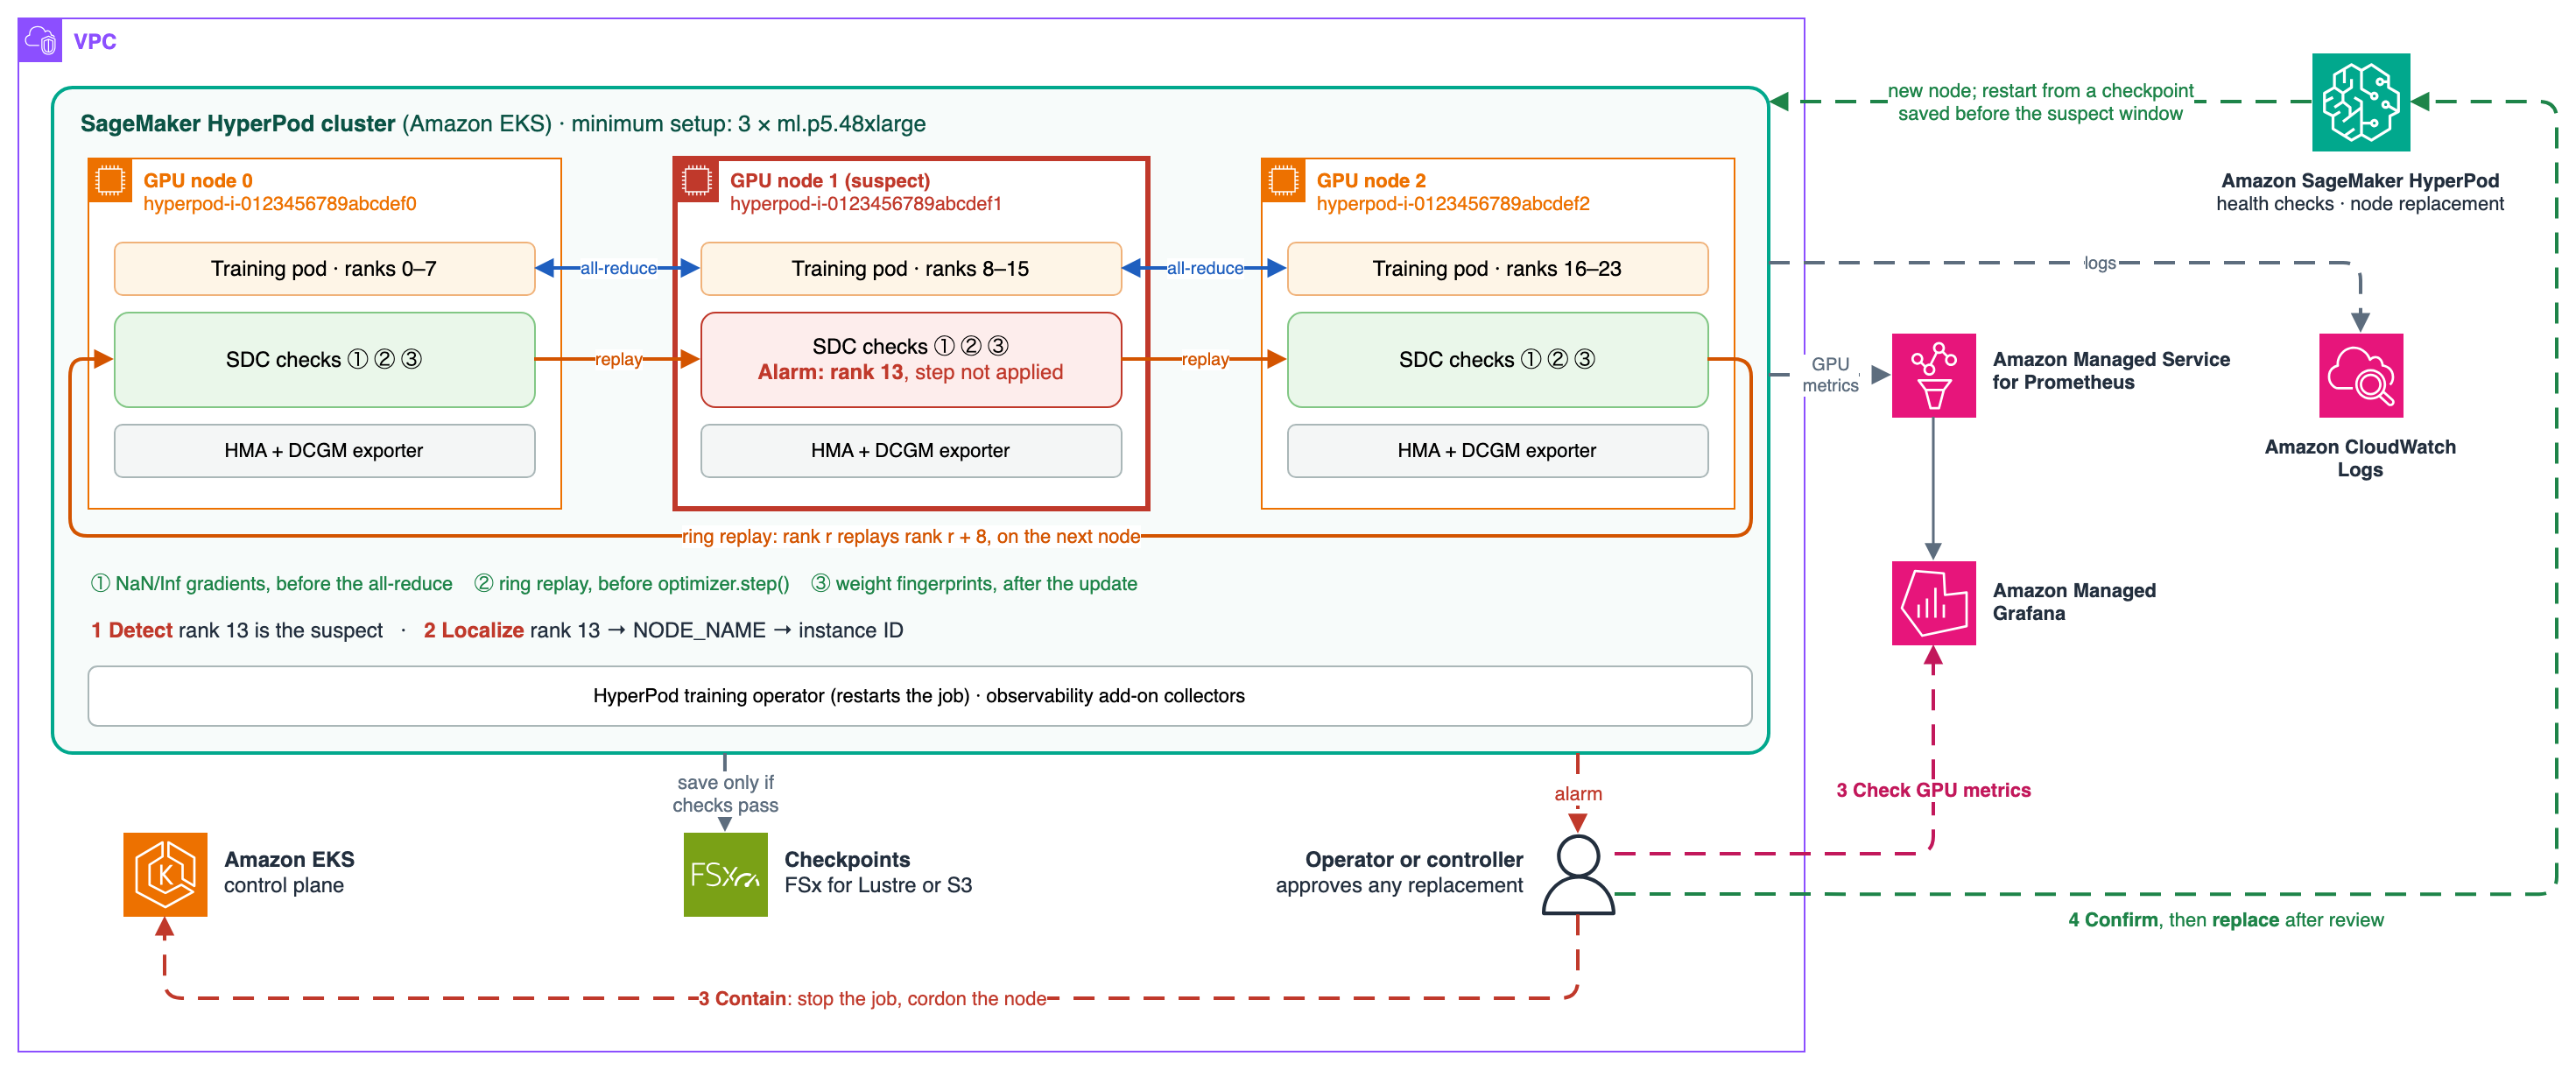
圖 1:一個 SageMaker HyperPod EKS 叢集,包含三個執行訓練 Pod 和 SDC 檢查的 p5 節點。節點 1 對 rank 13 發出警報;建議的步驟是封鎖該節點、檢查 GPU 指標、更換節點,然後重新開始訓練
把整個流程視為由多個層面組成會更容易理解,每個層面都帶來不同作用:
| 層面 | 來源 | 作用 | 能否偵測真正靜默的 SDC? |
| 1. 非有限梯度檢查 | 你的訓練指令碼 | 在 all-reduce 之前,指出本地梯度為 NaN 或 Inf 的 GPU;若歸約後的梯度為 NaN 或 Inf,便會停止該步驟 | 只偵測會導致 NaN、Inf 或溢位的故障 |
| 2. 環形重播稽核 | 你的訓練指令碼 | 每個 GPU 都會重新計算另一個節點的 micro-batch,並比較損失的位元模式和梯度指紋 | 可以,適用於會改變損失或梯度的有限值計算路徑故障,但只在稽核步驟執行 |
| 3. 權重指紋比較 | 你的訓練指令碼 | 在更新後,指出權重與嚴格多數不同的副本 | 可以,適用於單一副本上的最佳化器步驟故障和儲存權重故障;無法偵測計算路徑故障或分片權重 |
| 4. 定位 | 你的訓練指令碼,使用 SageMaker HyperPod 節點名稱 | 從 Kubernetes 節點名稱取得執行個體 ID,將可疑的 rank 對應至執行個體 | 不適用:只負責定位 |
| 5. DCGM 關聯分析 | HyperPod 可觀測性附加元件 | 查看警報前後可疑 GPU 的 DCGM 指標 | 只有在故障也反映於硬件計數器時才能確認故障。遙測數據正常,亦不能排除節點有問題。 |
| 6. 深度健康檢查 | StartClusterHealthCheck (DCGM L4) |
在可疑節點上按需執行的硬件診斷 | 可偵測其自身測試模式會觸發的硬件缺陷。用於分流診斷,而非作為證明 |
| 7. 重複故障節點記錄 | 你根據保留的警報和遙測數據建立的查詢 | 反覆發出警報的節點 | 部分可以:及早找出值得檢查的節點 |
只有層面 1–3 能偵測靜默 SDC,而且它們都在你的訓練程式碼中。層面 4 會把警報轉換成執行個體 ID,而 HyperPod 層面則會佐證警報並完成整個處理流程。
先決條件
如要跟著操作,你需要:
- 一個由 Amazon EKS 編排、至少有三個 GPU 節點的 SageMaker HyperPod 叢集。環形稽核每次要確認比較結果,都需要三個不同的節點;權重比較則需要每個權重都有三個副本,才能判定哪個副本與眾不同。請參閲 使用 Amazon EKS 編排 SageMaker HyperPod 叢集。
- PyTorch DDP 訓練工作中的每個副本都會各自執行優化器步驟,並使用能按指定步驟重建任何 rank 的微批次的資料管線,例如帶有種子的取樣器。
- 檢查點儲存在共享儲存空間、Amazon FSx for Lustre 或 Amazon Simple Storage Service (Amazon S3) 上。更換節點會清除其根磁碟區及次要磁碟區,包括本機 NVMe 上的所有資料。
- 用於關聯步驟的 SageMaker HyperPod observability add-on。如需 ECC、NVLink 及節流計數器,請啟用進階 DCGM 指標。
- 透過
kubectl存取叢集,並具備sagemaker:StartClusterHealthCheck和sagemaker:BatchReplaceClusterNodes的 AWS Identity and Access Management (IAM) 權限。請參閲 Manually quarantine, replace, or reboot a node。
步驟 1:在訓練迴圈中透過三項檢查進行偵測
資料並行會同時訓練多個模型副本。每個副本都會使用批次中不同的一部分資料進行訓練。每次反向傳播後,all-reduce 會對各副本的梯度取平均,而每個副本都會在 optimizer.step() 中套用相同的平均梯度。以下展示學習率為 0.1 時,三個副本中的同一個權重:
| 副本 0 | 副本 1 | 副本 2 | ||
| 起始權重 | 0.500 | 0.500 | 0.500 | 相同 |
| 本地梯度 | 0.20 | 0.40 | 0.30 | 不同(資料不同) |
| 平均梯度 | 0.30 | 0.30 | 0.30 | 相同,經 all-reduce 後 |
| 步驟後的權重 | 0.470 | 0.470 | 0.470 | 相同 |
本地梯度各不相同,因為每個副本看到的資料不同。而在優化器步驟後,各副本的權重必須逐位元完全相同。
故障發生的位置決定哪項檢查能偵測到它。如果副本 1 算出的本地梯度是 4.00,而不是 0.40,all-reduce 就會把錯誤傳播至所有副本:三個副本都會套用相同的錯誤更新,但它們的權重仍然相同。只有副本 1 的本地梯度看起來不同,而且只在 all-reduce 之前如此。相反,如果副本 1 在優化器步驟期間或之後破壞了某個權重,其權重就會與其他副本不一致。例外情況是:如果某個副本的權重中出現 NaN 或 Inf,下一次 all-reduce 會將它傳至所有副本,之後各副本又會恢復一致。all-reduce 本身出現故障,例如某部 GPU 將部分總和計算錯誤,也會以完全相同的方式影響所有副本。
因此,必須在優化器步驟前捕捉計算路徑故障,這時仍可丟棄錯誤梯度;而更新過程或更新後儲存權重中的故障,則須在步驟後捕捉。有限但錯誤的數值需要重新計算:比較各副本的梯度範數只能偵測 NaN 和 Inf(請參閲 為甚麼不比較本地梯度範數?)。因此,每個 DP rank 都要在每個訓練步驟中依固定次序執行以下三項檢查:
- 非有限梯度檢查 – 在 all-reduce 前,標記任何本地梯度為 NaN 或 Inf 的 rank。這項檢查會在 GPU 前向或反向傳播中出現數值爆增的當個步驟即時偵測,並指出是哪部 GPU。all-reduce 後、更新前,也要檢查歸約後的梯度是否含有 NaN 或 Inf。
- 環狀重播審核 – 在審核步驟中、優化器步驟前,每個 rank 都會重新計算另一個節點上某個 rank 的微批次。它會逐位元比較損失值;使用確定性核心時,也會比較每個參數的梯度指紋。這項檢查能偵測計算路徑中有限但錯誤的數值。
- 權重指紋比較 – 在優化器步驟後,每隔 N 步及每次儲存檢查點前,比較每個副本的權重指紋。這項檢查能偵測優化器步驟及已儲存權重中的故障。
此步驟中的程式碼適用於 PyTorch DDP。至於張量、流水線或上下文並行,請參閲 Beyond DDP。
執行次序
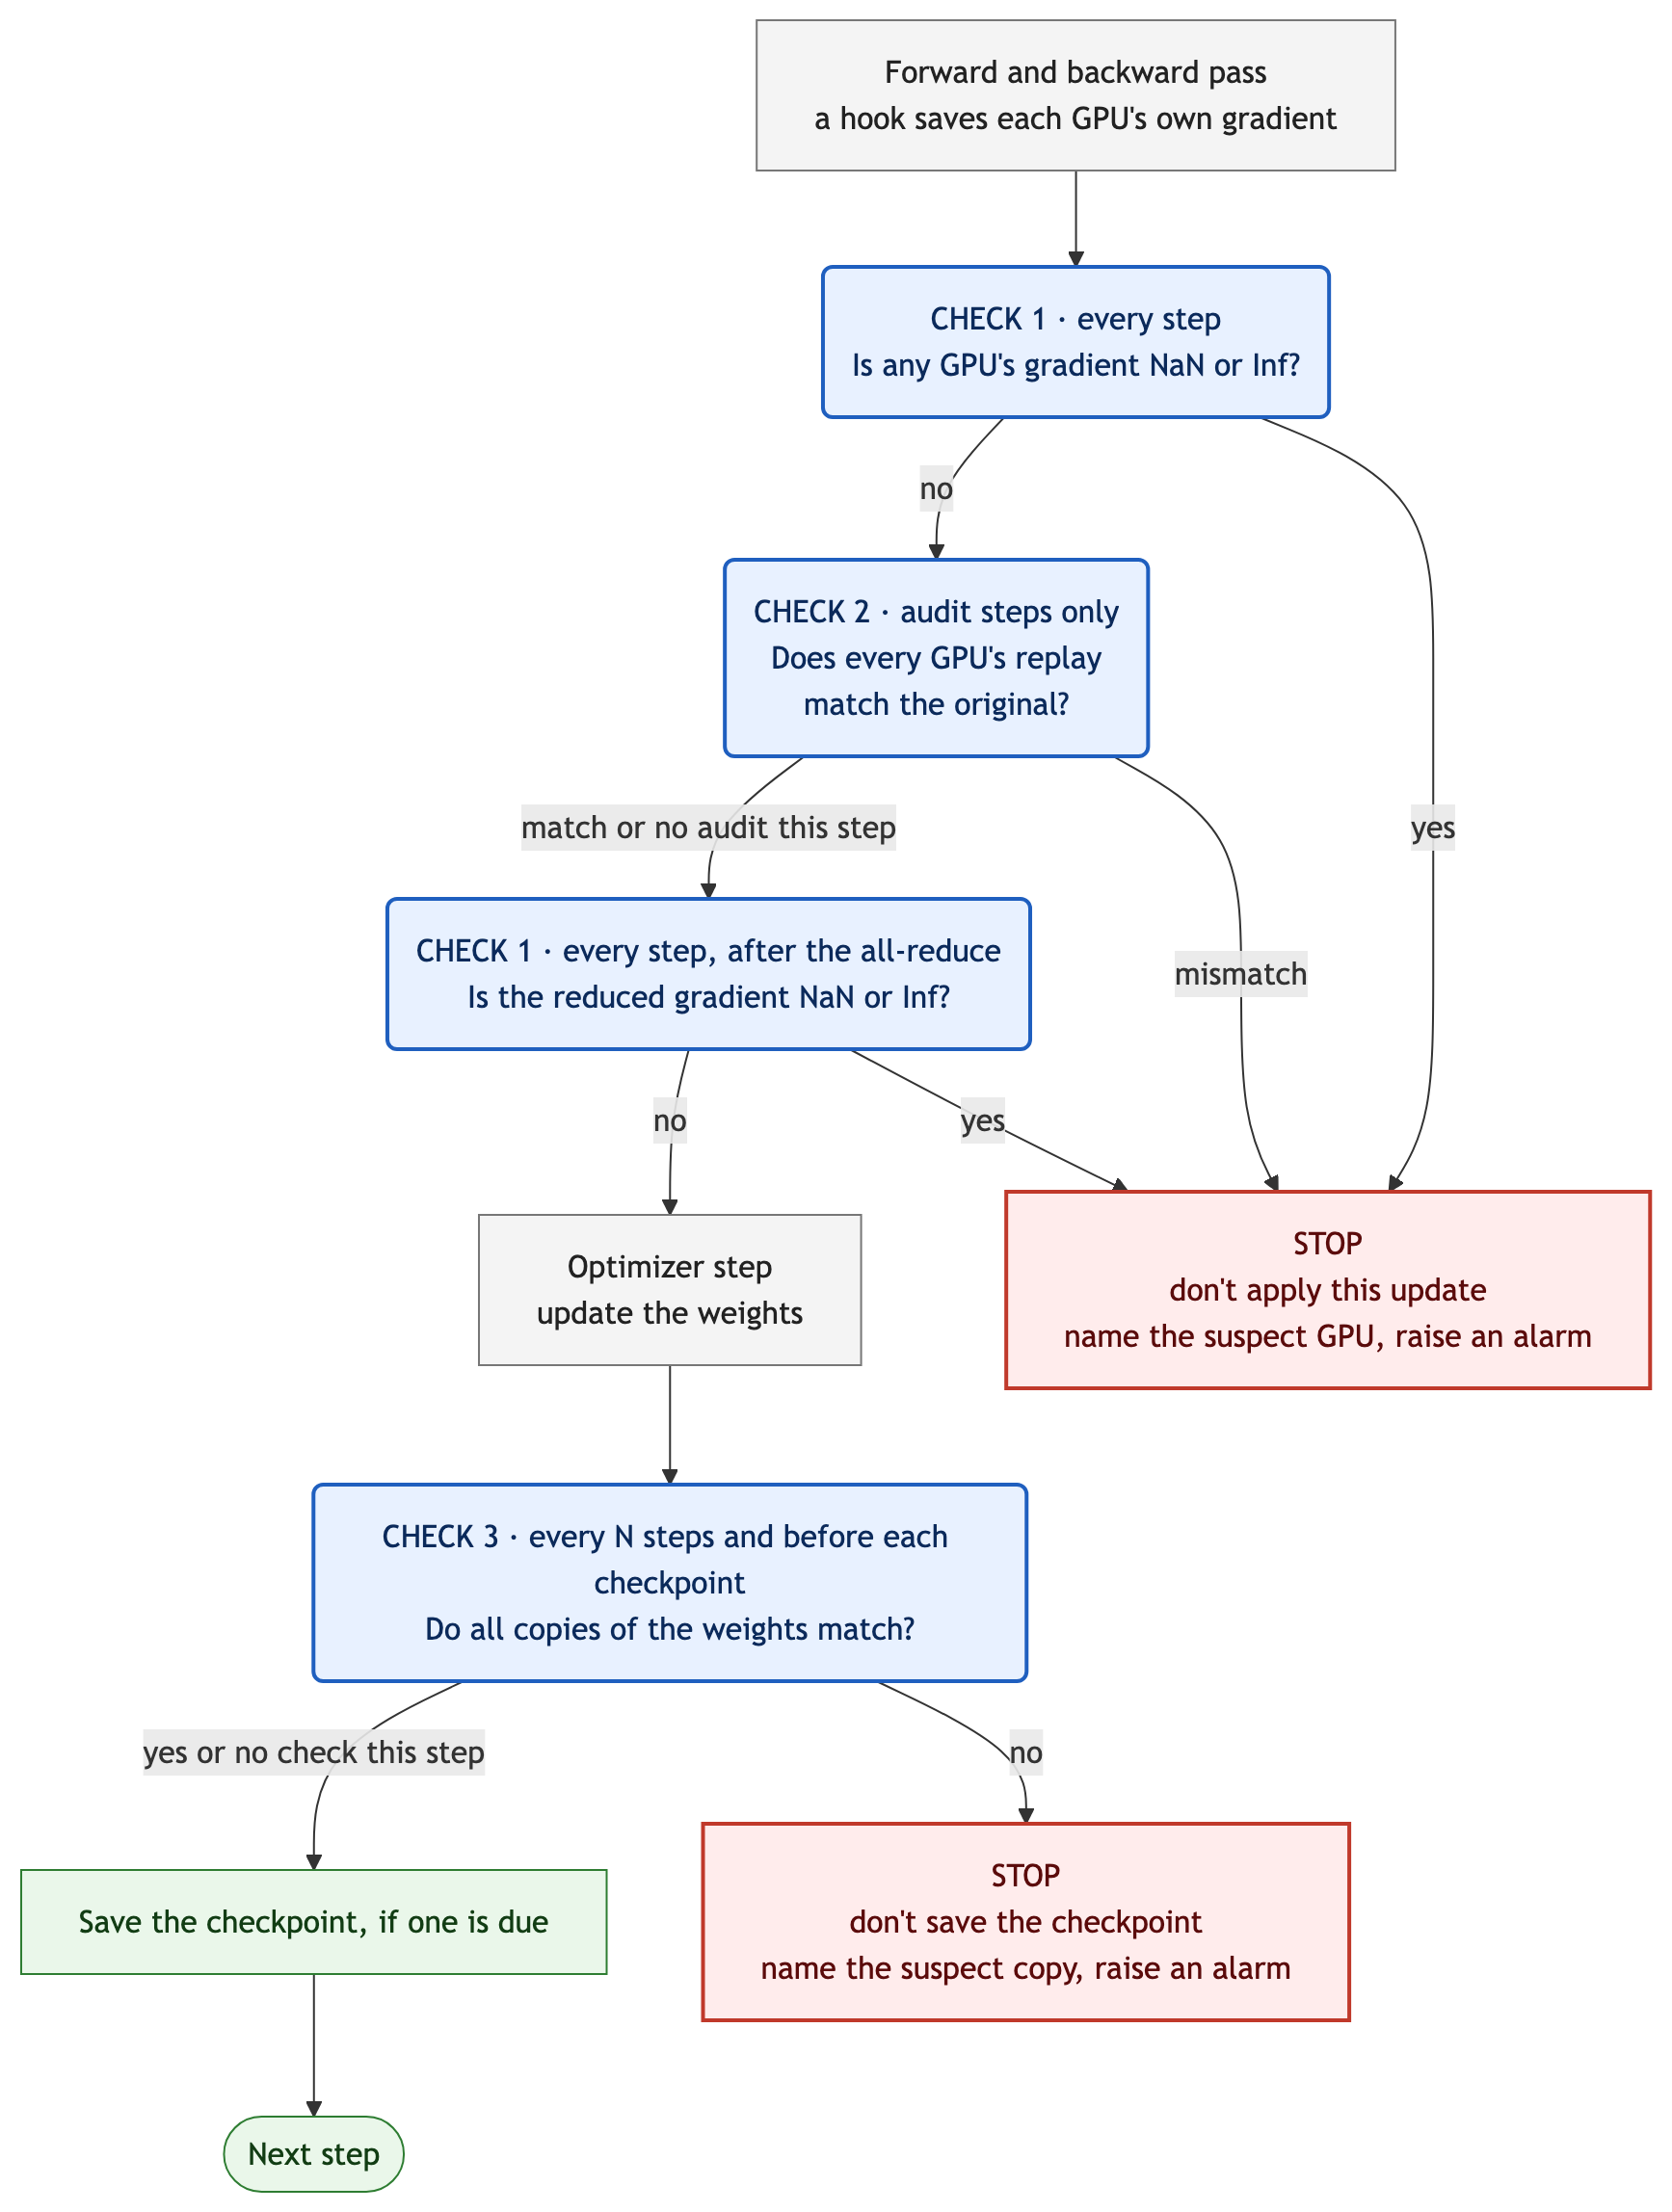
圖 2:一個訓練步驟的流程圖。檢查 1(all-reduce 前後的 NaN/Inf 梯度)和檢查 2(在審核步驟執行的環形重播)會在優化器步驟前執行;如果觸發,便會停止該步驟。檢查 3(權重指紋)則在該步驟後執行,並會阻止儲存檢查點
為甚麼不比較本地梯度範數?
一種自然的初步設計,也是我們最初採用的方法,是標記本地梯度範數與該步驟中位數相差超過 k 個中位數絕對偏差(MAD)的 rank。我們記錄了使用 32 張 H100 訓練一個有 953-million 個參數模型時,4 個實例上三次無故障執行的每個步驟中,各 rank 的本地梯度範數(共 22,800 個步驟,見 無故障執行),結果發現這項測試行不通:
- 健康狀態下的差異太大 – 每個 rank 接收的資料各不相同,因此在最初 800 個步驟中,健康狀態下的本地範數已相差達 224 個 MAD;計算所有健康步驟後,更達 1,240 個 MAD。
- 寬鬆的門檻無法識別有限值故障 – 若將 k 設為 336(即最初 800 個健康步驟中的最高分數的 1.5 倍),在其餘 22,000 個健康步驟中仍會誤報 11 次。有限值故障的分數則遠未達到這個門檻:即使將一個活化值乘以 10,000,故障 rank 的分數也從未超過 6.9。
透過指紋比較
檢查 2 和檢查 3 會比較不同 GPU 上的張量。傳送完整張量的成本太高,因此會把每個張量轉換成指紋:對其原始位元模式計算兩個 64-bit 總和,一個不加權,另一個按位置加權。對於元素少於 2³² 個、每個元素最多 4 bytes 的張量,任何一或兩個元素的變化都會改變指紋。這涵蓋了我們注入的所有權重故障。更大範圍的變化理論上可能互相抵銷,因此指紋相同是張量相同的有力證據,但不能作為證明。按位置加權的總和十分重要:在我們的測試中,交換兩個權重值,再對另外兩個值作出補償性改動,會令不加權的總和保持不變,只有加權總和能識別這些變化。
_INT_VIEW = {1: torch.uint8, 2: torch.int16, 4: torch.int32, 8: torch.int64}

@torch.no_grad()
def fingerprints(tensors, chunk=1 << 24):
    # ... picks the device and allocates out: one row of two int64 per tensor
    for k, t in enumerate(tensors):
        if t is None:
            continue
        bits = t.detach().contiguous().view(-1).view(_INT_VIEW[t.element_size()])
        for i in range(0, bits.numel(), chunk):  # chunked to bound temporary memory
            b = bits[i:i + chunk].to(torch.int64)
            pos = torch.arange(i + 1, i + 1 + b.numel(), dtype=torch.int64, device=dev)
            out[k, 0] += b.sum()
            out[k, 1] += (b * pos).sum()
    return out
檢查 1:all-reduce 前後的 NaN/Inf 梯度
DDP 通訊掛鈎會在梯度取平均前,記錄每個 rank 的本地梯度。它會儲存每個梯度桶的平方範數,並在確定的審核步驟中儲存每個參數梯度的指紋(供檢查 2 使用)。然後,它會將梯度桶交給 PyTorch 的標準 all-reduce。
反向傳播後,nonfinite_ranks會收集每個 rank 的一個純量,並回傳本地梯度範數為 NaN 或 Inf 的 rank。首個被標記的 rank 就是故障 rank。如果套用該步驟,NaN 便會在下一個步驟傳到每個 rank。
def local_stats_hook(stats, bucket):
    stats.sq.append(bucket.buffer().float().pow(2).sum())
    if stats.record_fingerprints:  # per parameter, before allreduce_hook divides in place
        rows = [stats.row[p.data_ptr()] for p in bucket.parameters()]
        stats.fp[rows] = fingerprints(bucket.gradients())
    return allreduce_hook(stats.dp_group, bucket)

def attach(ddp_model, dp_group):
    stats = LocalStats(dp_group, list(ddp_model.module.parameters()))
    ddp_model.register_comm_hook(state=stats, hook=local_stats_hook)
    return stats

def nonfinite_ranks(stats):
    """After backward: global ranks whose local gradient norm is NaN or Inf."""
    local = torch.stack(stats.sq).sum().sqrt().reshape(1)
    n = dist.get_world_size(stats.dp_group)
    gathered = [torch.empty_like(local) for _ in range(n)]
    dist.all_gather(gathered, local, group=stats.dp_group)
    bad = ~torch.isfinite(torch.cat(gathered).cpu())
return [dist.get_global_rank(stats.dp_group, r) for r in bad.nonzero().flatten().tolist()]train()亦會檢查 all-reduce 後的梯度。若 NaN 或 Inf 在歸約過程中產生,便會以相同方式傳到每個副本,因此各副本仍然相符,檢查 3 也會讓它們通過。若沒有這項檢查,NaN 便會令每個副本上的權重都變成 NaN;若該步驟需要儲存檢查點,檢查點便會連同這些權重一併儲存,並被標記為通過。clip_grad_norm_已經會計算歸約後梯度的範數,因此這項檢查每個步驟只需額外進行一次只含一個元素的 all-reduce。歸約中的有限值錯誤仍會通過所有檢查。
如果你使用 fp16 訓練並配合梯度縮放器,請排除縮放器已跳過的溢位步驟。bf16 沒有這類步驟。
檢查 2:環形重播,在優化器步驟前
每個副本都會持有相同的權重,直到 optimizer.step() 為止。因此,在反向傳播與優化器更新步驟之間,任何 rank 都可以重新計算其他 rank 的微批次;使用確定性核心時,所得位元必須完全一致。
在審核步驟中,每個 rank r 都會重新計算 rank r + 8 的微批次:領先 8 個位置;在 p5 執行個體上,這代表相隔一個節點。它會使用未包裝的模組,因此不會進行 all-reduce;之後會還原梯度、模組的緩衝區,以及隨機數狀態。每次重播都會阻塞整個工作,不論有多少個 rank 進行重播都一樣,因此審核所有 rank 所需的實際時間,與只審核一個 rank 相同。
每個 rank 因而會出現在兩項比較中:由另一個 rank 重播的自身微批次,以及它替其他 rank 重播的微批次。
- 兩項比較都不匹配:該 rank 在兩項比較中都計算錯誤,因此它就是問題來源。
- 只有一項不匹配:任一方都有可能出錯。
confirm會就地確認:位於第三個節點、比目標領先 8 個位置的 GPU,以及目標本身,會再次重播目標的微批次。這也能分辨持續性故障與暫時性故障:目標會重現前者,但不會重現後者。
def ring_audit(module, compute_loss, rebuild_batch, step, stats, local_loss, offset, with_grads):
    # ... g is the DP group, n its size, and me this rank's position in it
    target = dist.get_global_rank(g, (me + offset) % n)
    replay = _replay(module, compute_loss, rebuild_batch(step, target), with_grads)
    # ... v = [this rank's own loss bits and gradient fingerprints, its replay of target]
    dist.all_gather_into_tensor(out, v, group=g)
    table = out.view(n, 2, -1).cpu()  # per DP rank: [own result, its replay of its target]
    pairs = [(dist.get_global_rank(g, (r + offset) % n), dist.get_global_rank(g, r))
             for r in range(n) if not torch.equal(table[(r + offset) % n, 0], table[r, 1])]
    return pairs, table

def localize(pairs):
    hits = Counter(r for p in pairs for r in p)
    culprits = sorted(r for r, c in hits.items() if c >= 2)
    ambiguous = [p for p in pairs if not set(p) & set(culprits)]
    return culprits, ambiguous

def confirm(module, compute_loss, rebuild_batch, step, pair, table, stats, offset, with_grads):
    # ... the third GPU (target + offset) and the target replay the target's micro-batch again
    third_r, self_r = v.cpu()
    orig, peer = table[ti, 0], table[ri, 1]
    if torch.equal(third_r, orig):
        return {"pair": pair, "third": third, "suspect": replayer, "kind": "replayer computed wrong"}
    if torch.equal(third_r, peer):
        kind = ("persistent" if torch.equal(self_r, orig) else
                "transient" if torch.equal(self_r, third_r) else "unclear")
        return {"pair": pair, "third": third, "suspect": target, "kind": kind}
    return {"pair": pair, "third": third, "suspect": None, "kind": "unattributable"}
只有當三張 GPU 分別位於三個不同的節點時,這項確認才具獨立性。check_topology會在訓練開始前,根據每個 pod 的 NODE_NAME,驗證每一對 GPU 是否符合條件;否則會引發錯誤。
選擇審核模式:
- 預設核心:只比較損失。這需要前向傳播的損失能以位元級精度重現;我們的測試結果符合這項要求:健康的重播結果與原始損失逐位元一致。梯度無法以這種方式比較,因為注意力機制的預設反向傳播並非確定性運算。此模式可偵測會改變損失的前向傳播故障。
- 確定性核心(
deterministic_audits=True):整個審核步驟都會使用確定性演算法和數學注意力核心。因此,梯度指紋也會一致,審核亦可偵測隻影響反向傳播的故障。若某項運算沒有確定性實作,系統會引發錯誤,而不是產生誤報。在我們的模型上,確定性審核步驟的耗時是預設審核步驟的 2.4 倍。
切勿只在可疑 rank 上重播該 rank 的工作。有持續性缺陷的 GPU 可能會重現自己的錯誤結果。
檢查 3:優化器更新步驟後的權重指紋
在 optimizer.step() 之後,每個副本的權重都必須完全一致,因此無須調整容差。每個 rank 都會為每個權重張量產生指紋,並收集所有 rank 的指紋。
只有當某個 rank 的張量副本與嚴格多數(超過一半的副本)不同時,才會指出該 rank。若只有兩個副本,或分歧後沒有嚴格多數,比較結果只會報告不一致,而不會指出任何 rank。
def find_divergent_ranks(params, dp_group):
    local = fingerprints(params).flatten()
    # ... all-gathers every rank's fingerprints into table: [dp_size, num_tensors, 2]
    differs = (table != table[0]).any(dim=2).any(dim=0)
    if not differs.any():
        return {"diverged": False, "suspects": []}
    suspects = set()
    for k in differs.nonzero().flatten().tolist():
        copies = [tuple(row) for row in table[:, k].tolist()]
        value, count = Counter(copies).most_common(1)[0]
        if 2 * count <= n:
            return {"diverged": True, "suspects": None}  # no strict majority for tensor k
        suspects.update(r for r, c in enumerate(copies) if c != value)
    return {"diverged": True,
            "suspects": sorted(dist.get_global_rank(dp_group, r) for r in suspects)}
每隔 N 個步驟執行一次,並在每個檢查點步驟執行。這是唯一會在更新後執行的檢查,因此只有它能阻止系統以損壞的副本寫入檢查點。在我們的測試中,一次更新後立即損壞的權重,在下一個檢查點步驟被偵測到,因此沒有進行儲存。若沒有強制檢查,系統便會使用損壞的副本完成儲存;環形審核則要到五個步驟後的下一次審核才會發現問題。
在一個 953 百萬參數的模型上,每次檢查耗時 31.1 ms:每 10 個步驟執行一次時,相當於一個步驟耗時的 2%。
將檢查加入訓練迴圈
train 按照圖 2 的順序逐步執行,並在首次觸發警報時停止。它會在前向傳播前判斷該步是否為稽核步驟,因為確定性比較也要求原始計算具備確定性。檢查 1 或 2 觸發時,它會將梯度歸零並直接返回,不進行梯度裁剪或套用更新,因此不良梯度不會影響權重或優化器狀態,而且仍會保留原狀態以供確認。梯度裁剪後,它會檢查縮減後的梯度是否為 NaN 或 Inf;如果是,便會在更新前返回。只有在沒有任何檢查觸發時,才會儲存檢查點。
def train(ddp_model, stats, optimizer, batches, compute_loss, rebuild_batch, save_checkpoint,
          sched, start_step=0):
    # ... setup, including check_topology(dp_group, sched.peer_offset)
    for step, batch in enumerate(batches, start_step):
        audit = step % sched.audit_every == 0  # 0. decide first
        det = audit and sched.deterministic_audits
        # ... resets the hook's per-step state
        with deterministic() if det else nullcontext():
            loss = compute_loss(ddp_model, batch)  # 1. forward, backward
            loss.backward()
        nonfinite = nonfinite_ranks(stats)  # 2. non-finite check
        pairs, table = [], None
        if audit or nonfinite:  # 3. ring replay
            pairs, table = ring_audit(module, compute_loss, rebuild_batch, step, stats,
                                      loss, sched.peer_offset, with_grads=det)
        if nonfinite or pairs:  # 4. gate
            optimizer.zero_grad(set_to_none=True)  # step not applied
            culprits, ambiguous = localize(pairs)
            verdicts = [confirm(module, compute_loss, rebuild_batch, step, p, table, stats,
                                sched.peer_offset, with_grads=det) for p in ambiguous]
            return {"step": step, "check": "compute", "nonfinite": nonfinite,
                    "mismatched_pairs": pairs, "culprits": culprits, "verdicts": verdicts,
                    "suspect_window": _window(last_audit, step, start_step),
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        if audit:
            last_audit = step
        grad_norm = torch.nn.utils.clip_grad_norm_(params, sched.max_grad_norm)
        bad = (~torch.isfinite(grad_norm)).to(torch.int32).reshape(1)  # reduced gradient
        dist.all_reduce(bad, op=dist.ReduceOp.MAX, group=dp_group)
        if bad.item():
            optimizer.zero_grad(set_to_none=True)  # step not applied
            return {"step": step, "check": "reduced gradient", "suspect_window": [step, step],
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        ckpt = step % sched.ckpt_every == 0
        if step % sched.check_every == 0 or (ckpt and sched.check_on_checkpoint):
            wc = find_divergent_ranks(params, dp_group)  # 5. weight check
            if wc["diverged"]:
                return {"step": step, "check": "weights", "suspects": wc["suspects"],
                        "suspect_window": _window(last_weights, step, start_step),
                        "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
            last_weights = step
        if ckpt:  # 6. checkpoint
            save_checkpoint(step, tags={"last_audit_pass": last_audit,
                                        "last_weight_check_pass": last_weights})
    return None
警報中的 suspect_window 是自上次通過觸發警報的檢查以來涵蓋的步數範圍。若故障從開始起每一步都持續存在,便是在這個範圍內開始。間歇性故障可能更早已存在,而未被任何檢查發現的故障則可能出現在任何檢查點。因此,應把標籤視為該步通過檢查的紀錄,而非所儲存狀態沒有問題的證明。
訓練指令碼的呼叫方式如下:
# ... imports, and the model, optimizer, and dataset setup
import sdc_order as S

stats = S.attach(ddp_model, dp_group)  # registers the comm hook, once
sched = S.Schedule(audit_every=10, deterministic_audits=True, check_every=10,
                   ckpt_every=100, peer_offset=8)  # 8 = GPUs per node

def compute_loss(model, batch):  # used for training AND replay
    x, y = batch
    with torch.autocast("cuda", dtype=torch.bfloat16):
        logits = model(x)
    return F.cross_entropy(logits.float().flatten(0, 1), y.flatten())

def rebuild_batch(step, rank):  # exactly the micro-batch `rank` trained on
    return dataset.micro_batch(step, rank)

# ... batches(start) yields this rank's micro-batches and sets the learning rate
alarm = S.train(ddp_model, stats, optimizer, batches(start), compute_loss, rebuild_batch,
                save_checkpoint, sched, start_step=start)
if alarm is not None:
    report_sdc(alarm)  # metric + log line; Step 2 maps the rank to a node
    sys.exit(3)
重播依賴以下條件:
- 完全相同的微批次:
rebuild_batch(step, rank)必須傳回該 rank 訓練時使用的完全相同微批次,例如使用已設定隨機種子的採樣器。 - 相同的損失函數:
compute_loss必須是訓練和重播時使用的同一個函數,包括 autocast;函數內任何隨機性(例如 dropout)也必須按每個步驟及 rank 設定隨機種子。 - 模型中不可有集體通信操作或影響輸出的狀態:確認重播只會在兩個 rank 上執行,即目標 GPU 和第三部 GPU,因此,如果模型在前向或反向傳播中呼叫集體通信操作(例如 SyncBatchNorm),在警報原因不明時便會卡住。前向傳播會同時讀取及更新的緩衝區,亦會令正常重播結果出現差異。
- 確定性設定:在訓練程序啟動前設定
CUBLAS_WORKSPACE_CONFIG=:4096:8,並確保模型中的每個操作都有確定性實作。 - 同儕偏移量:按節點逐一為 DP rank 編號,這樣當
peer_offset等於每個節點的 GPU 數量時,每個重播程序都會位於另一個節點。若配置不符合這個條件,check_topology會拒絕該配置。 - 此處未經測試:未使用的參數、梯度累積、BatchNorm,以及帶有副作用的前向傳播掛鈎。若有未使用的參數,請設定
deterministic_audits=False;此設定只會比較損失。
audit_every 是成本與穩健性之間的主要取捨設定:
- 偵測延遲:若持續存在的有限值故障亦出現在稽核執行的 kernel 中,便會在
audit_every步內被捕捉。確定性稽核會執行確定性 kernel 和數學注意力 kernel,因此,如果故障只出現在其他步驟使用的預設 kernel 中,便永遠不會被稽核。 - 受污染的更新:稽核捕捉故障前,最多可能已套用
audit_every− 1 次受污染的更新。這些更新都在警報的suspect_window範圍內。 - 一次性故障:若有限值故障只在單一非稽核步驟出現一次,之後不再重現,便完全不會被捕捉。
將 ckpt_every 設為 audit_every 和 check_every 的公倍數,這樣每個檢查點步驟都會在更新前接受稽核,並在更新後記錄指紋。
我們在 953M 模型和 32 張 H100 上,按每種排程連續執行 1,000 步,量度端到端的平均每步時間。所有啟用檢查的排程也會每 10 步執行一次權重檢查:
| 排程 | 平均每步時間 | 相對純 DDP |
| 純 DDP,不執行檢查 | 157.4 ms | — |
| 執行檢查,不進行稽核 | 169.0 ms | +7.4% |
| 每 10 步進行一次確定性稽核 | 211.9 ms | +34.7% |
| 每 10 步進行一次預設 kernel 稽核 | 177.0 ms | +12.5% |
| 每 100 步進行一次確定性稽核 | 173.3 ms | +10.1% |
| 每 100 步進行一次預設 kernel 稽核 | 169.3 ms | +7.6% |
每種排程的成本中,約 7 個百分點與審核無關:每一步都執行的梯度 hook 和兩項 NaN/Inf 檢查,以及每 10 步執行一次的權重檢查。用於正式環境的一個合理起點,是每 100 步進行一次確定性審核;在此情況下,成本為 10%。這仍能在 100 步內捕捉持續性故障,包括只在反向傳播時出現的故障;代價是最多需要回復 99 次受污染的更新。如需更快偵測,例如在新算力容量的試運行期間,或監察可疑節點時,可每 10 步審核一次。請在自己的模型上量度成本:確定性注意力會使用數學運算核心,其成本會隨序列長度的平方增長。
在沒有故障的執行中,15,320 個審核步驟和 3,080 次權重檢查均沒有觸發警報;以 95% 信心水平計算,誤報率上限約為每 5,100 個審核步驟一次。
第 2 步:將可疑 rank 定位至節點
rank 是邏輯 ID。要採取行動,你需要知道執行個體和實體 GPU。在 HyperPod EKS 上,Kubernetes 節點名稱是加上 hyperpod- 前綴的執行個體 ID。使用 Kubernetes downward API 將它傳給 Pod:
env:
- name: NODE_NAME  # on HyperPod EKS, spec.nodeName is "hyperpod-<instance-id>"
  valueFrom:
    fieldRef:
      fieldPath: spec.nodeName
在工作開始時,記錄一個表格,列出每個 rank 對應的節點、執行個體和 GPU UUID:
import os
import torch
import torch.distributed as dist

node = os.environ["NODE_NAME"]  # "hyperpod-i-0123456789abcdef0"
instance_id = node.removeprefix("hyperpod-")  # "i-0123456789abcdef0", what the Replace API takes
gpu_uuid = "GPU-" + str(torch.cuda.get_device_properties(torch.cuda.current_device()).uuid)
info = {"rank": dist.get_rank(), "node": node,
        "instance_id": instance_id, "gpu_uuid": gpu_uuid}
table = [None] * dist.get_world_size()
dist.all_gather_object(table, info)
if dist.get_rank() == 0:
    print("rank_map", table)  # log at every job start
如果工作已在執行,但沒有使用 downward API,你可以在外部使用 kubectl get pod <pod> -o jsonpath='{.spec.nodeName}' 將 Pod 對應至其節點。
第 3 步:控制損害並檢查 GPU 指標
警報觸發時,先停止工作。然後在調查期間將可疑節點設為 cordon 狀態,避免新工作排到該節點:
kubectl cordon <node-name> # marks the node unschedulable; existing pods keep running接着,在 SageMaker HyperPod observability add-on 中開啟 GPU 健康狀態儀錶板,篩選可疑節點和 GPU,並查看警報觸發的時間。如果該 GPU 的可修正 ECC 錯誤、PCIe 重播、節流或温度有所上升,會增加硬件故障的可能性。儀錶板沒有異常,並不能證明節點沒有問題:純粹的 SDC 往往不會在硬件遙測中留下痕跡。
第 4 步:確認後更換節點
執行第 1 步的檢查時,警報已會指出可疑 GPU。如果出現沒有警報的症狀(例如 loss 飆升),或想在更換任何硬件前排除軟件問題,先從成本較低的可能原因着手。大多數 loss 飆升都不是 SDC;如果問題其實是資料錯誤,卻追查 SDC,會浪費數天:
Loss anomaly / suspected corruption
- Reproduces with the same seed on DIFFERENT nodes? -> deterministic bug, not SDC
- Goes away, or follows one node, when you move the job? -> strong SDC candidate
- DP replicas that must be bitwise identical disagree? -> strong SDC signal
- One rank's step replayed on another node gives different bits? -> strong SDC signal
- One rank's pre-all-reduce gradient is NaN or Inf? -> SDC candidate (use the first step it fired)
- Fleet-wide and gradual? -> likely recipe or optimizer
- Started at a data, config, or library change? -> usually software, but not proof
區分 SDC 與軟件問題的方法,是看問題是否會隨硬件移動:
- 可重現的故障也不能排除 SDC – Meta 將一個故障工作負載固定在某個核心上;對於特定輸入,每次都得到相同的錯誤答案。
- 故障在軟件變更後才開始,也不能排除 SDC – Google 將一次事故追溯至一次正確無誤的程式庫更新;該更新開始在有缺陷的核心上使用罕用指令。
- 不要期望全域 loss 能指出問題所在 – 前向故障首先會改變故障 rank 自身的 loss,接着 all-reduce 會將其梯度傳播至每個副本。按 rank 檢查及重播可助你定位問題。
判斷警報的含義
| 警報 | 含義 | 建議行動 |
check == "weights", suspects == [r] |
更新後,rank r 的副本與嚴格多數不一致 | 繼續將 r 所在節點設為 cordon 狀態。審查後更換該節點 |
check == "weights", suspects is None |
副本彼此不一致,但沒有嚴格多數 | 情況不明:繼續將涉及的節點設為 cordon 狀態。檢查 DCGM 並執行深入健康檢查 |
culprits == [r] |
r 的兩項環狀比較均不匹配。這假設互相重播的 GPU(本機索引相同的 GPU)之中,最多隻有一個故障 GPU。若有兩個,健康的 GPU 可能會被指認為故障對象 | 維持不可排程狀態。經審核後,或故障再次出現後,更換節點 |
| 判定:持續性故障 | 目標 GPU 再次產生相同的錯誤答案,而第三個 GPU 認同重播 GPU 的結果 | 維持不可排程狀態。經審核後更換節點 |
| 判定:暫時性故障 | 目標 GPU 重試後得出正確結果,並與第三個 GPU 一致。間歇性故障也可能呈現相同情況 | 維持不可排程狀態,直至以該節點為目標的稽核或深度健康檢查通過。如再次發生,請更換該節點 |
| 判定:重播 GPU 計算錯誤 | 出錯的是重播 GPU,而非目標 GPU | 將重播 GPU 列為疑似故障對象,並再次確認 |
| 非有限值情況,沒有不匹配的配對 | 反向傳播中出現損失值未顯示的 NaN 或 Inf,或梯度範數超出 float32 的範圍(高於約 1.8 × 10¹⁹) | 情況不明:以疑似故障對象為目標進行稽核,或檢查 DCGM 並執行深度健康檢查 |
check == "reduced gradient" |
all-reduce 後梯度變成 NaN 或 Inf,儘管每個 rank 的本機梯度都是有限值。沒有指明任何 rank | 情況不明:保持工作停止,檢查 DCGM,並對工作中的每個節點執行深度健康檢查,然後從警報步驟之前儲存的檢查點恢復 |
| 判定:無法歸因或不明確 | 三個 GPU 的結果對不上 | 情況不明:檢查 DCGM,並對相關節點執行深度健康檢查 |
在正式環境中,每次更換都應保留人工審批,直至有證據證明這些檢查在自身工作負載上的準確度。我們這類合成測試不足以證明這一點。
確認不明確的警報
深度健康檢查是處理不明確警報的主要工具。其壓力測試能找出硬件會回報的故障,但細微且依賴數據的故障往往能通過測試。若要在疑似故障的執行個體羣組上執行深度健康檢查:
aws sagemaker start-cluster-health-check \
    --cluster-name <cluster-name> \
    --deep-health-check-configurations '[{"InstanceGroupName":"<instance-group>","InstanceIds":["i-0123456789abcdef0"],"DeepHealthChecks":["InstanceStress"]}]'
更換節點
準備好更換節點時,有兩個選項。兩者都會觸發相同的 SageMaker HyperPod 復原程序,詳見手動隔離、更換或重新啟動節點。
若已啟用自動節點復原功能,你可以為節點加上標籤,讓 SageMaker HyperPod 更換節點,方便自動化:
kubectl label node <node-name> \
    sagemaker.amazonaws.com/node-health-status=UnschedulablePendingReplacement --overwrite
若要改用 API,請執行:
aws sagemaker batch-replace-cluster-nodes --cluster-name <cluster-name> --node-ids <instance-id>在使用 Karpenter 進行自動擴縮的叢集中,BatchReplaceClusterNodes會終止節點,但只有在有待處理的 Pod 需要替代節點時才會建立替代節點。替代節點加入後,訓練工作會透過 SageMaker HyperPod 訓練運算子或工作的重新啟動政策重新啟動,而訓練指令碼會從警報的 suspect_window 開始前儲存的最新檢查點恢復。載入檢查點後、第一個步驟開始前,立即呼叫 find_divergent_ranks。更換節點會清除節點的根磁碟區和次要磁碟區,因此請將檢查點保存在共用儲存空間。
將工作流程自動化
這些手動步驟旨在説明流程。在正式環境中,請將它們包裝在一個小型控制器中,並在你自己的叢集和帳戶中執行:
- 觸發: 訓練工作會將警報回報為 Kubernetes 事件、小型自訂資源(例如 SDCReport{rank, job, step, check}),或基於
sdc_nonfinite_grad、sdc_replay_mismatch和sdc_divergent_tensors等指標的 Amazon CloudWatch 警報。 - 解析: 控制器透過 Kubernetes API 將 rank → pod → node 對應起來,然後移除
hyperpod-前綴,將 node 對應至執行個體 ID。 - 隔離: 控制器會將該節點設為不可排程。
- 判定: 套用第 4 步的表格。環形稽核已在原位確認模糊配對,因此警報會附帶判定結果。若結果模糊,便會執行一次限定於單一節點的深度健康檢查。
- 復原: 如需替換,會先要求人工批准,然後呼叫
BatchReplaceClusterNodes;若已啟用自動節點復原,則會設定節點健康標籤。接著便依靠訓練 operator 和你的檢查點重新載入程序,並在 CloudWatch 記錄每個步驟。
可將它建構為輕量級 Kubernetes operator,或設定 CloudWatch 警報觸發 Amazon EventBridge 規則,再呼叫 AWS Lambda 函數。
使用案例:在 SageMaker HyperPod 上測試檢查
我們在一個由 Amazon EKS 編排的 SageMaker HyperPod 叢集上執行了兩次測試,先後使用 4 個及 3 個 ml.p5.48xlarge 執行個體;每個執行個體配備 8 張 NVIDIA H100 80GB HBM3 GPU,並使用 AWS Deep Learning Containers 訓練映像中的 PyTorch 2.9.0 (CUDA 13.0)。模型是一個 Llama 風格的解碼器,共有 953-million 個參數、16 層、2,048 的隱藏維度、16 個注意力頭、32,000 個 token 的詞彙表,以及長度為 2,048 個 token 的序列。每張 GPU 每步處理 2 個序列(32 張 GPU 每步處理 131,072 個 token),權重、梯度及優化器狀態均使用 fp32,並以 bf16 autocast 進行計算。我們使用 AdamW 訓練,學習率為 3 × 10⁻⁴,並在 100 步線性預熱後開始使用;betas 為 (0.9, 0.95),weight decay 為 0.1,gradient clipping 為 1.0。資料是合成的:一項使用 Zipf 分佈 token 的複製任務,當中前半部分會重複;每個 rank 和步驟均會設定隨機種子,因此可重建任何 micro-batch。
故障情境
故障注入於其中一層:16 個解碼器區塊中的第 8 個區塊之 MLP 下投影層,並在選定的 rank 和步驟上進行:
- 前向傳播故障會改變該層的輸出,但保留梯度路徑,例如前向傳播中的乘法運算出錯。
- 僅影響反向傳播的故障會改變該層輸入或權重的梯度。
- 權重故障會在優化器步驟完成後,改變一張 GPU 所儲存的權重副本:例如位元翻轉、交換兩個值,或對兩個值作出相互抵銷的改動。
- 持續性故障會在故障 GPU 計算的所有內容中重現,包括它為其他 rank 執行的重播。一次性故障只會觸發一次。
每個情境都會從完成 400 步預熱後拍攝的快照重新開始,步數由該快照起計。除非另有説明,稽核每 10 步執行一次,並使用確定性核心;權重每 10 步檢查一次,每 20 步建立一個檢查點。表格列出使用 4 個執行個體的結果。使用 3 個執行個體時,每個情境都會在相同步驟、由相同檢查觸發相同警報,並指出相同的 rank。只有對端 rank 不同。
| 注入的故障 | 結果 | 檢出方式 |
| rank 13 的前向輸出中有一個元素為 NaN,僅在第 25 步發生(不是稽核步驟) | 第 25 步觸發警報並指出 rank 13。環形重播亦有執行。rank 21 和 rank 13 確認:rank 13 發生一次性故障。第 25 步未套用。疑似故障區間:第 21–25 步 | 檢查 1 |
| rank 13 的前向輸出中有一個元素乘以 1,000,從第 23 步起每步都發生 | 第 23–29 步通過檢查 1 並已套用。第 30 步的稽核發現 (13, 5) 和 (21, 13) 不匹配,並指出 rank 13。第 30 步未套用。疑似故障區間:第 21–30 步 | 檢查 2 |
| 相同的 ×1,000 僅在第 30 步稽核時發生 | 一組配對不匹配:(13, 5)。rank 21(位於第三個節點)和 rank 13 確認:rank 13 發生一次性故障 | 檢查 2 |
| rank 5 上持續出現的 ×1,000,該 rank 重播 rank 13 的微批次 | 配對 (13, 5) 和 (5, 29) 不匹配。定位到 rank 5。單次由 rank 5 重播 rank 13 的微批次,會錯誤地判定健康的 rank 13 有問題 | 檢查 2 |
| rank 13 上其他前向傳播故障,從第 23 步起的每一步:一個元素 ×10,000、整個輸出有 10% 乘法雜訊、一個 bf16 元素的第 3 位元翻轉,以及一個輸出欄 ×1.1 | 每項故障均在第 30 步定位到 rank 13。使用預設核心的審核也偵測到位元翻轉和 ×1.1 的欄 | 檢查 2 |
| 從第 23 步起的每一步,流入 rank 13 該層的梯度中一個元素,或其權重梯度中的一個元素,×1,000(僅限反向傳播) | 僅根據梯度指紋,在第 30 步定位到 rank 13 | 檢查 2 |
| 上述權重梯度故障,並使用預設核心審核 | 50 步內沒有警報。第 20 步和第 40 步的檢查點均標記為審核及權重檢查通過,因為損失未受影響,而且每個副本都套用了相同的損壞更新 | 未有偵測到 |
| rank 13 和 rank 22 同時持續出現前向傳播 ×1,000 | 配對 (13, 5)、(21, 13)、(22, 14) 和 (30, 22) 不匹配。定位到 rank 13 和 rank 22 | 檢查 2 |
| 第 31 步更新後,rank 0 的一個 fp32 權重元素中第 22 位元翻轉,每 5 步建立一個檢查點 | 第 35 步檢查點的強制權重檢查指出 rank 0,儲存未有進行。疑似故障區間:第 31–35 步 | 檢查 3 |
同上,使用 check_on_checkpoint=False |
第 35 步仍使用 rank 0 的損壞副本進行儲存。其標記顯示最後一次通過的權重檢查在第 30 步。第 40 步的環形審核根據配對 (8, 0) 和 (0, 24) 指出 rank 0 | 檢查 2 |
| 第 31 步更新後,在沒有審核的情況下,rank 0 的一個權重張量中兩個數值互換,或兩個數值的位元模式分別加上 +4,096 和 −4,096;每 10 步進行權重檢查 | 兩種情況都在第 40 步的權重檢查中定位到 rank 0,儘管該張量的純位元總和沒有改變 | 檢查 3 |
| 還原快照(作為載入檢查點的替代操作)後,rank 7 的一個注意力權重中第 22 位元翻轉 | find_divergent_ranks 在第一步前執行,定位到 rank 7 |
檢查 3 |
無故障執行
為了量度誤報率,我們在兩種叢集規模上進行無故障訓練,各使用三種排程。每種排程每 10 步進行一次權重檢查,且不儲存檢查點;每次執行的時間長度固定,因此每步進行審核的兩種排程佔了大部分審核步數:
| 實例 | 審核 | 分鐘 | 步數 | 審核步數 | 權重檢查 | 警報 |
| 4 | 確定性,每步 | 45 | 4,600 | 4,600 | 460 | 0 |
| 4 | 預設核心,每步 | 22.5 | 5,400 | 5,400 | 540 | 0 |
| 4 | 確定性,每 10 步 | 45 | 12,800 | 1,280 | 1,280 | 0 |
| 3 | 確定性,每步 | 15 | 1,600 | 1,600 | 160 | 0 |
| 3 | 預設核心,每步 | 7.5 | 2,000 | 2,000 | 200 | 0 |
| 3 | 確定性,每 10 步 | 15 | 4,400 | 440 | 440 | 0 |
| 總計 | 150 | 30,800 | 15,320 | 3,080 | 0 |
在 15,320 個審核步數中出現 0 次警報,按三法則計算,每個審核步驟的誤報率 95 percent 上限為 3 / 15,320,即約每 5,100 個審核步數 1 次。無故障的步驟也沒有觸發 NaN/Inf 檢查。為甚麼不比較局部梯度範數?中的梯度範數分析只使用 4 個實例的執行結果。
DDP 以外
權重比較不限於 DDP。find_divergent_ranks 可接受任何數據並行羣組,因此也適用於張量、流水線及上下文並行、HSDP 和混合專家;這些配置都會為每個權重保留獨立副本。在 ZeRO-1 或完整 FSDP 分片模式下則無法提供幫助,因為每個分片的更新只會在一個 rank 上計算。本文中的檢查和訓練迴圈只在 DDP 下測試。
如要在另一種配置中使用,請以存放同一分片副本的羣組呼叫 find_divergent_ranks。如果只有兩個副本,它可以偵測到不一致,但無法指出哪個副本有問題。
如果你希望由服務代為檢查節點,SageMaker HyperPod 亦提供 MultiNodeTraining 深度健康檢查。這項檢查會在一批 GPU 節點上執行簡短且固定的分散式訓練任務,無需更改程式碼;如果訓練損失變成 NaN 或 Inf、出現發散,或未能在時限內完成,便會替換相關節點。建立執行個體羣組時,可選擇這項檢查,並同時選擇 InstanceStress 和 InstanceConnectivity;你亦可使用 StartClusterHealthCheck 按需執行。這項檢查可配合本文介紹的檢查:先用它篩查新節點及替換節點,確保任務不會被派到有問題的節點上;再用任務內檢查,找出你自己的訓練過程中出現、但不會變成 NaN 或 Inf 的錯誤數值。詳情請參閲 SageMaker HyperPod 深度健康檢查。
清理
為避免持續產生費用,請刪除測試時建立的資源。如果你建立了 HyperPod 叢集,請使用 aws sagemaker delete-cluster --cluster-name <cluster-name> 將其刪除。這只會移除 HyperPod 資源。請在刪除 HyperPod 叢集後,另外刪除 EKS 叢集、其附加元件,以及任何 Amazon FSx 磁碟區。請參閲 刪除 SageMaker HyperPod 叢集。
總結
本文介紹如何偵測數據並行訓練中的靜默數據損壞,以及如何將可疑節點交由 SageMaker HyperPod 替換。三項檢查涵蓋故障可能出現的三個位置:檢查每個 rank 的梯度及歸約後梯度是否含有 NaN/Inf;透過環形重播,比較每個 GPU 的運算結果與另一節點上的 GPU;以及在更新後比較權重指紋。請在執行最佳化器步驟前進行首兩項檢查,不要套用未能通過檢查的步驟,並在每次建立檢查點前比較權重。在 SageMaker HyperPod EKS 叢集中,節點名稱可將可疑 rank 對應至執行個體 ID。然後隔離該節點,回復至可疑時段之前的檢查點,並由節點健康標籤或 Replace API 完成復原。
如要開始使用,請參閲 適用於 Amazon EKS 的 SageMaker HyperPod 韌性功能,並試用配套儲存庫。如要深入瞭解,請參閲深度健康檢查及可觀測性附加元件。
作者簡介

Siddharth Senger
Siddharth 現任 Amazon Web Services (AWS) SageMaker HyperPod 團隊的高級軟件開發工程師。Siddharth 擁有近十年的軟件開發經驗,曾參與 Amazon 旗下多個團隊的工作,包括 Retail、Amazon Rekognition、Amazon Textract 及 Amazon SageMaker。他熱衷於建構可靠、可擴展且高效的分散式系統,協助客戶加快大型機器學習及 AI 創新。

Roy Allela
Roy 是 AWS 首席 AI/ML 專業解決方案架構師。他與 AWS 客戶合作,協助初創企業以至大型企業在 AWS 上高效訓練及部署基礎模型。他具有微處理器工程背景,熱衷於計算最佳化問題,以及提升 AI 工作負載的效能。

Nilesh PS
Nilesh 是 AWS 的高級軟件開發工程師,負責 Amazon SageMaker HyperPod。他專注於 Kubernetes 上大規模分散式 ML 工作負載的 Ray 叢集管理、訓練韌性及可觀測性。

Pradeep Cruz
Pradeep 是 AWS 的資深軟件開發經理,負責領導 SageMaker HyperPod 基礎設施,涵蓋企業級 AI、訓練、推理及模型自訂。他擁有逾 20 年經驗,曾在 AWS、T-Mobile 和 Ericsson 推動關鍵 AI/ML 平台從 0 到 1 的規模化發展。他是分散式系統和基礎設施專家,並持有 Michigan Ross 的 MBA 學位。
來源:AWS Machine Learning Blog · aws.amazon.com