如何在 Amazon Bedrock 上優化每項任務成本並衡量智能體投資回報
Optimizing cost per task and proving agent ROI on Amazon Bedrock
AWS Machine Learning Blog 提出一套在 Amazon Bedrock 上按任務而非 token 核算成本、優化智能體支出及衡量投資回報的方法。
文章把每項任務成本、成功率與人工投入納入同一評估框架,並説明如何以人類基線和 holdout 測試核算智能體投資回報。
這個系列的第 1 部分建立了用來管控 Amazon Bedrock支出的營運模式:透過 AWS Identity and Access Management (IAM) 主體標籤及 Cost and Usage Report 2.0 進行歸因、透過模型呼叫記錄進行可觀測性、分三個層級執行管控,以及設定審視週期。這一層能回答誰花了這筆錢,也讓你可以制止他們。但它無法告訴你這筆支出是否花得其所。
這篇文章會回答兩個第 1 部分刻意留下未解的問題。第一:這個工作流程為甚麼成本高昂?答案在於要考慮每項任務的成本,而非每個 token 的成本。第二:這個 Agent 是否比人類做得更好?答案需要基準、受控實驗,以及與決策掛鈎的評分表。
本文會介紹一套計算模型實際成本的框架(包括定價頁面沒有顯示的四個隱藏成本因素)、透過快取、路由及輸出限制降低每項任務成本的技巧,以及一套以人類工作基準、留出組實驗和五個維度的評分表衡量 Agent 投資回報率的方法。本文適合兩類讀者:負責優化手段的應用程式及平台工程師,以及需要向管理層證明 Agent 支出合理的產品負責人和 FinOps 夥伴。
每項任務的成本,而非每個 token 的成本
每個 token 的價格方便快速比較,但並未反映你實際支付的費用。公佈的價格反映單一 token 的成本;你的帳單反映完成一項任務的成本。任務是應用程式要求模型完成的一個完整工作單位:處理一封支援電郵、從一張發票擷取欄位,或回答一位用戶的問題。任務由收到請求開始,直到產生可用結果為止,無論過程中需要多少次模型呼叫。
標價較低的模型,運行成本未必較低。較便宜的模型可能會把你的文字拆分成更多 token、在回覆中加入填充內容、誤讀工具的結構描述並反覆修正,或在回答前消耗數千個推理 token。這些成本都不會顯示在Bedrock 定價頁面上。
四個隱藏成本因素
四項模型特性會決定公佈的價格在你的工作負載上實際要花多少成本。
Tokenizer 效率
Token 不等於一個字,而且不同模型的 token 也不相同。每個模型系列都採用不同的 tokenizer 和詞彙表。同一段文字、程式碼或 JSON 資料,在不同模型下會拆分成不同數量的 token。如果 Model A 的標價低 15%,但處理你的資料需要多 40% 的 token(結構描述和數值陣列等情況很常見),那麼 Model B 的成本反而較低。非英文文字的差距更大:許多 tokenizer 會把非拉丁文字拆分成比相應英文多兩至三倍的 token。
輸出遵從度與冗長程度
輸出 token 的成本通常是輸入 token 的 3–5 倍(比例因模型系列而異。請參閲Bedrock 定價頁面)。如果模型不理會「只回傳原始 JSON」等格式限制,你就得為那些填充文字支付較高的輸出成本。嚴格遵從格式指示的模型,會產生較少這類成本更高的輸出 token,從而節省費用。
Agent 工作循環效率
Agentic 工作流程會徹底改變成本計算方式。工具使用(函數呼叫)讓模型呼叫外部函數,並需要經過多輪循環:分析提示詞、決定是否呼叫工具、等待觀察結果,再生成答案。每一輪都會把完整對話記錄和工具結果重新作為輸入 token 傳送。模型若需要四輪(每輪都重新傳送更大的上下文資料),成本遠高於一次完成。
推理開銷
許多模型支援延伸思考,會先按思維鏈推理,再生成可見的答案。推理 token 會按輸出 token 收費,因此,模型若在回答 200 個 token 前先思考 2,000 個 token,你便要為 2,200 個 token 付費。有些模型會隱去推理內容,但仍會收取相關費用。先關閉推理功能,只有在基準測試顯示品質差距足以抵銷成本時才啟用。
每項任務的成本:實例説明
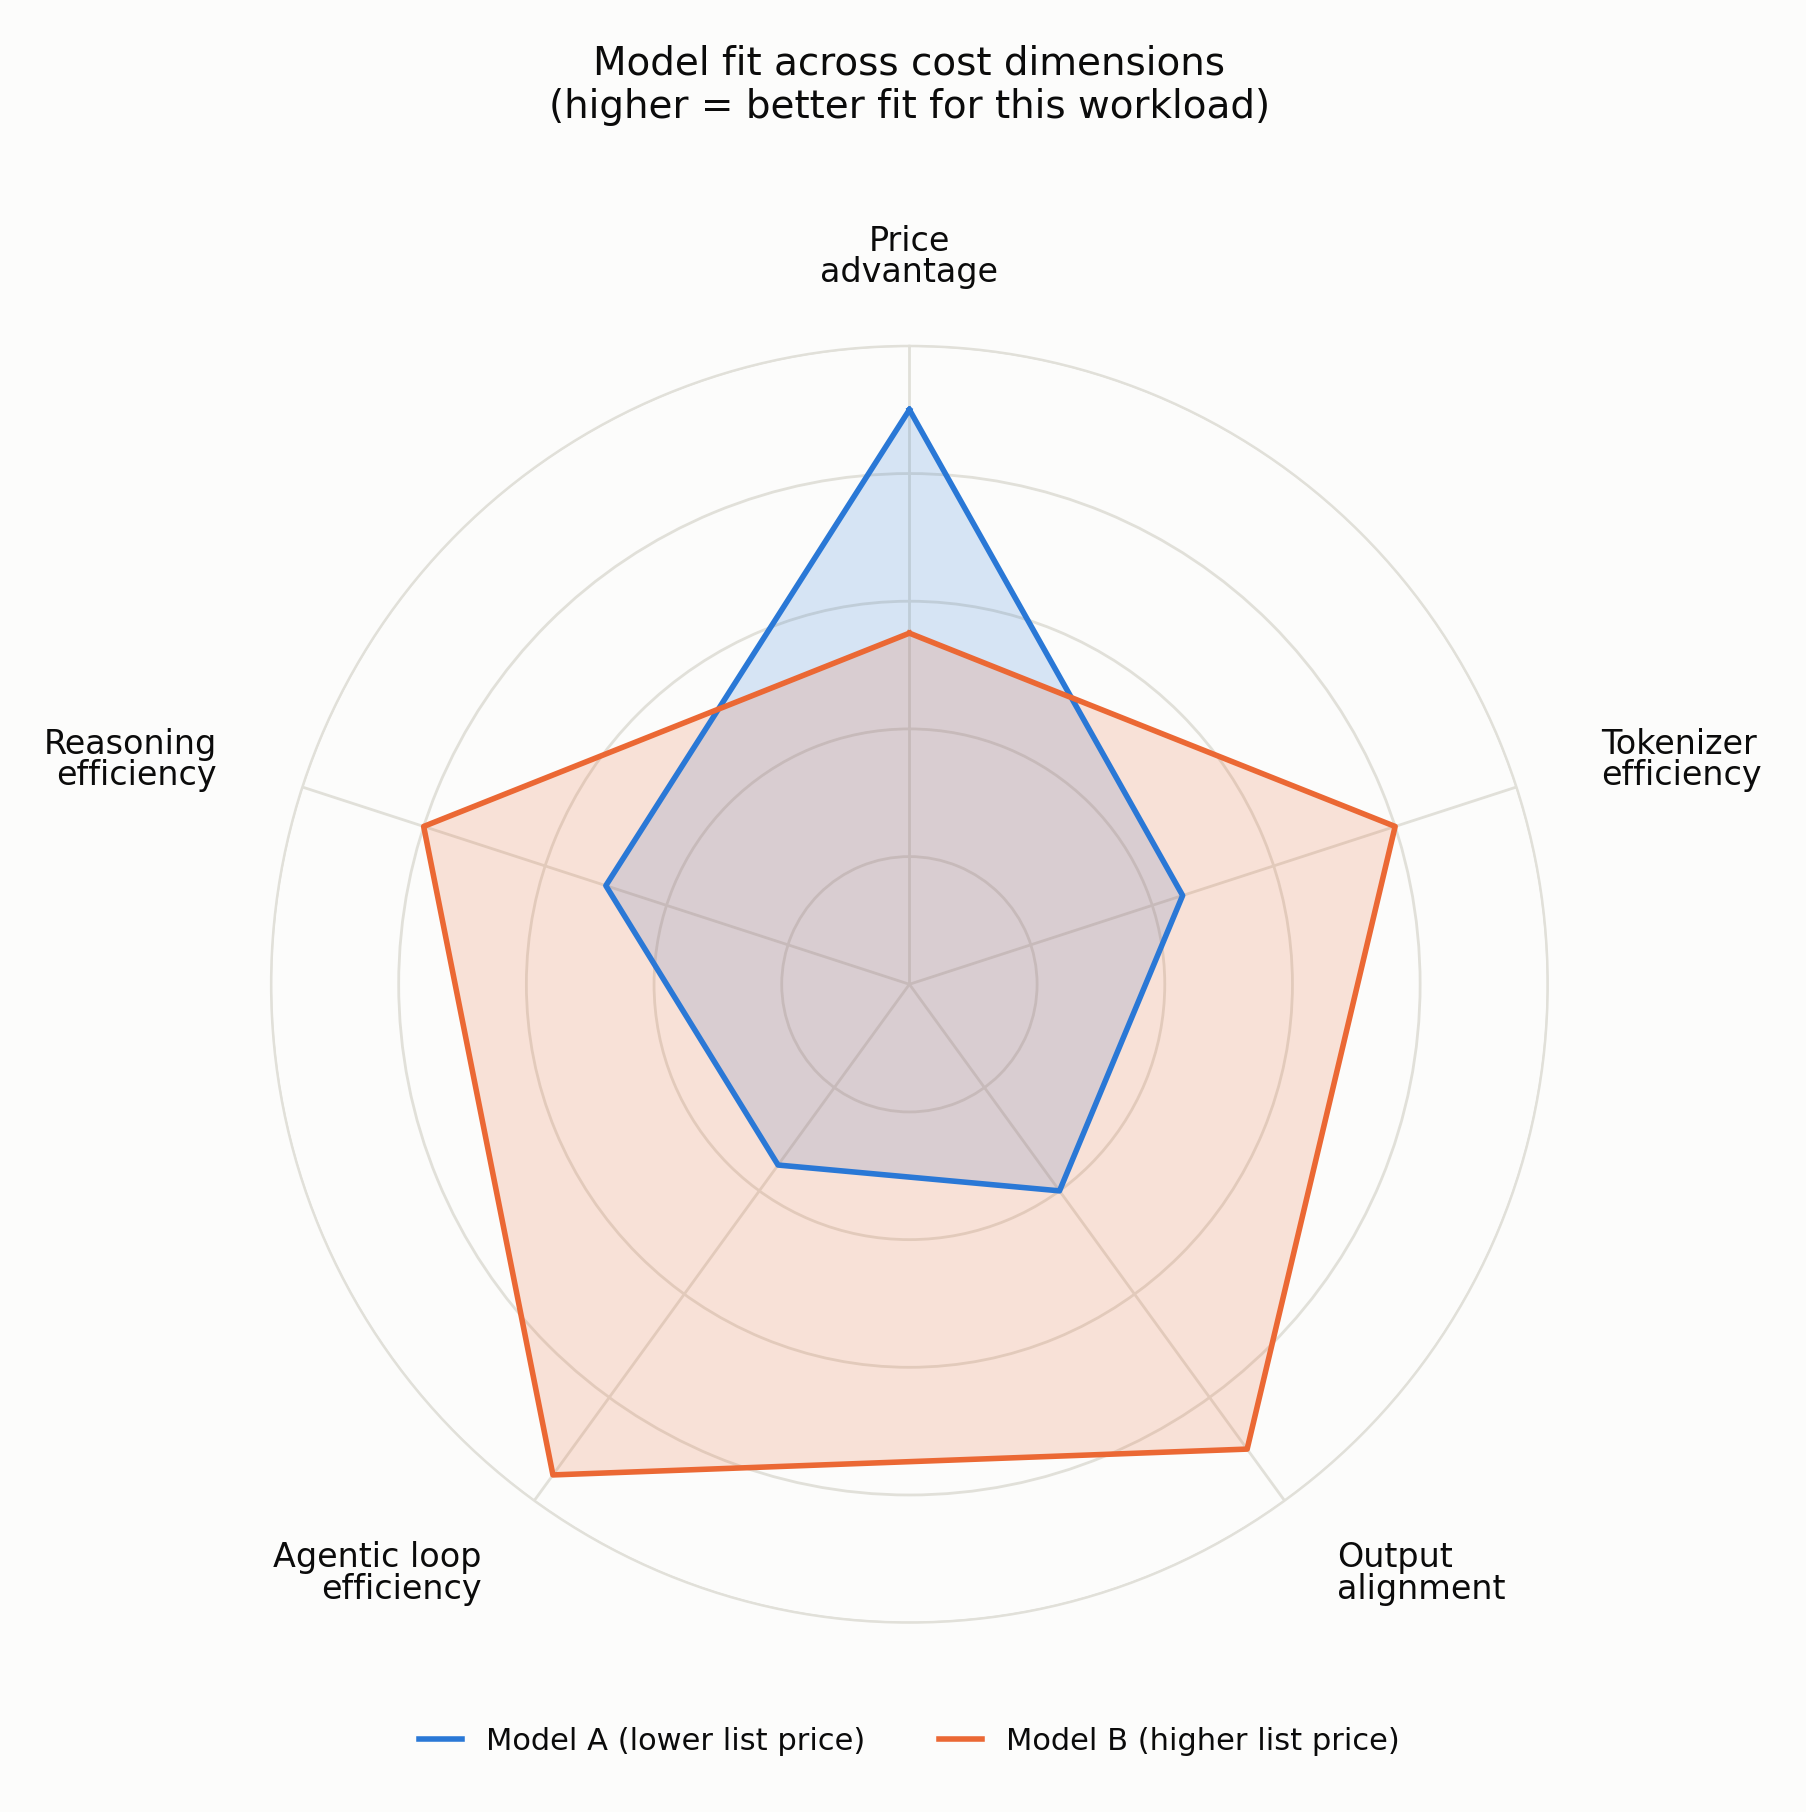
圖 1:比較兩個模型在五個成本維度上的表現。標價只是決定實際成本的五項因素之一
以一個 Agent 工作流程為例:讀取一封 750 字的客戶電郵、擷取實體、呼叫 API 核實帳戶狀態,並輸出符合嚴格格式要求的 JSON。以下比較採用示例價格(請務必以自己的數據和最新的Bedrock 定價進行基準測試):
| 指標 | 模型 A(標價較低) | 模型 B(標價較高) |
| 輸入標價 | $0.50 / 1M tokens | $1.00 / 1M tokens |
| 輸出標價 | $1.50 / 1M tokens | $3.00 / 1M tokens |
| 分詞器效率(第 1 輪輸入) | 1,500 tokens | 1,000 tokens |
| 輸出冗長度(最終回應) | 450 tokens | 150 tokens |
| 所需 Agent 循環 | 3 輪(錯誤修正) | 1 輪(零樣本) |
| 累計輸入 token 數(所有輪次) | 6,150 | 1,000 |
| 累計輸出 token 數(所有輪次) | 750 | 150 |
| 每項任務總成本 | $0.0042 | $0.00145 |
模型 A:(6,150 x $0.50 + 750 x $1.50) / 1,000,000 = $0.0042
模型 B:(1,000 x $1.00 + 150 x $3.00) / 1,000,000 = $0.00145
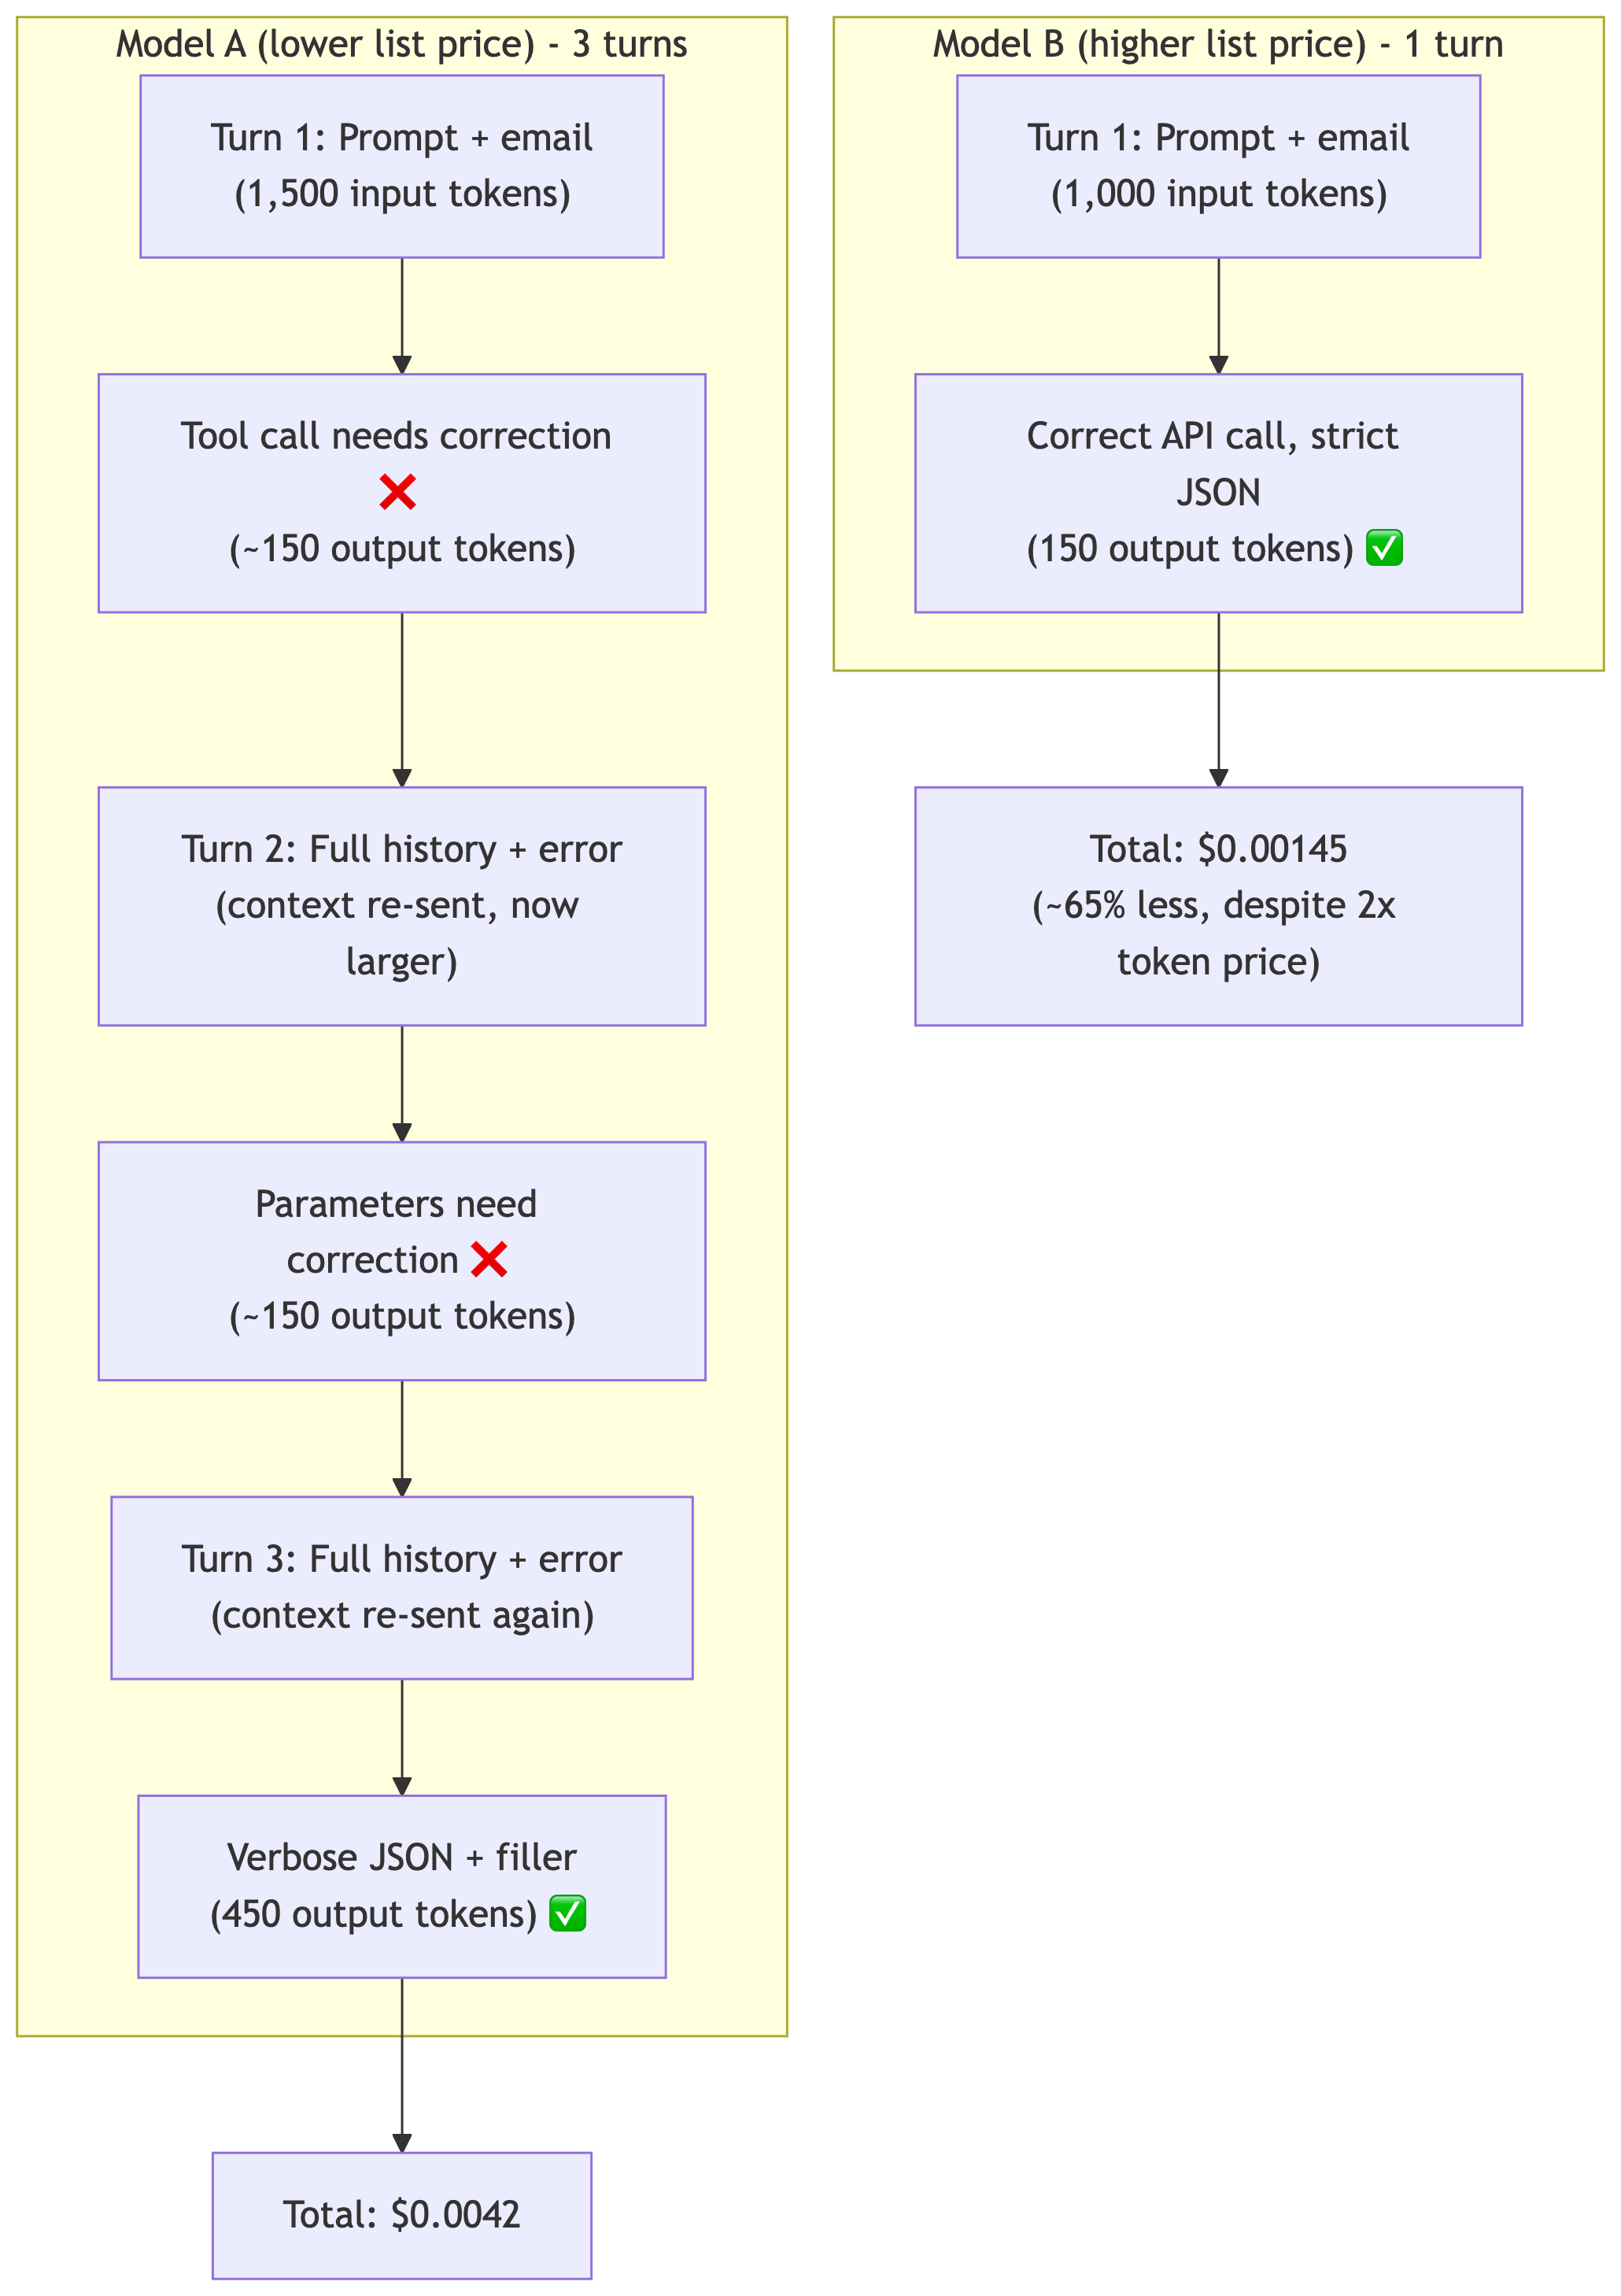
圖 2:為何標價較高的模型反而便宜 65%。每增加一輪,都會重新傳送不斷增長的上下文資料,令費用層層累積
標價高出 2 倍的模型為何反而便宜 65%:三個因素相互疊加。模型 A 的分詞器把電郵拆分成多出 50% 的 token,令每次輸入資料都變得更大。它在 JSON 中加入冗餘內容,令輸出 token 數增加至三倍。它也無法配合工具結構描述,因此需要兩輪修正,每輪都會重新傳送不斷增長的對話記錄。
每項成功任務的成本
以上例子假設兩個模型最終都能成功。在實際環境中,模型不一定成功,而失敗通常也會產生費用。計算公式如下:
適用於重試直至成功的工作流程:
cost per successful task = cost per attempt / success rate
適用於失敗時升級處理的工作流程:
cost per successful task = cost per attempt + (1 - success rate) x escalation cost
啟用提示詞快取後,輸入會進一步分為三類:按基本費率收費的未快取輸入、按低於基本費率收費的快取讀取,以及按高於基本費率收費的快取寫入。
以自己的工作負載進行量度
要確定哪個模型實際上較便宜,只有以自己的數據進行基準測試才看得出來。Amazon Bedrock 模型評估是一項託管功能,可評估品質方面的表現:設定評估準則、上載提示詞數據集,然後取得評分結果;評估會使用自動指標,亦可選擇人手審核,而且毋須自訂基礎架構。
不過,單靠品質分數並不能計算費用。Bedrock 另外三項功能會提供 token 數和輪次數,讓你據此計算費用:
- CountTokens 會傳回指定模型就指定 payload 收取的輸入 token 數量,而且不會執行推理。這是你在花費任何生成成本之前,比較不同候選模型 tokenizer 效率(因素 #1)最廉宜的方法。
- 模型呼叫回應會包含一個
usage區塊,內有inputTokens、outputTokens、cacheReadInputTokens和cacheWriteInputTokens。把單一任務各輪的這些數值累加起來,就能得出上一個每次嘗試成本公式中的四個項目。有一點要留意:啟用快取時,inputTokens只會計算未快取的 token,因此輸入 token 總量是inputTokens + cacheReadInputTokens + cacheWriteInputTokens。把它們相加以瞭解總用量,但要分開計價,因為三者的收費率各有不同。在整個過程中多次評估這些數值,並根據當前實際負載設定快取檢查點。隨着應用程式運作,工具會逐漸過時,快取檢查點亦會漂移。這意味着漂移發生後,3 個月後你需要寫入快取的內容會更多。持續評估數據以確保快取使用最佳化,會成為降低成本的主要手段。 - 模型呼叫記錄會把每次呼叫的 token 數量寫入 Amazon Simple Storage Service (Amazon S3) 或 Amazon CloudWatch Logs,讓你可根據實際正式環境流量,而非樣本,衡量完成任務所需的輪數。為呼叫加上 請求中繼資料標籤,即可按團隊、功能或實驗篩選記錄中的 token 數量。不過,這些是日誌欄位,而不是成本分配標籤,而且不會出現在 AWS Cost Explorer 或 Cost and Usage Report 中。應用程式推理設定檔則會同時反映在兩者中,粒度為每日每種用量類型一筆。這種粒度適合分攤費用,但不足以計算每項任務的成本。把記錄的 token 數量乘以公佈的費率,可得出接近即時的估算,而非發票金額。除非你把承諾用量、批次定價或預置輸送量納入模型,否則估算不會反映這些因素。在把估算當作帳單之前,請先與 Cost and Usage Report 對帳。
降低每項任務的成本:四項手段
四個成本因素各有相應的手段,而且都有詳細説明。提示詞快取可減少重複傳送的上下文,解決令 Model A 成本高昂的問題,因此在 Agent 工作流程中效益最大。智能提示詞路由會把簡單請求交給同一系列中較便宜的模型。使用 工具結構描述並設定 maxTokens 上限,比起用文字指示更可靠地控制輸出冗長程度;只有在基準測試證明延伸思考能帶來足以抵銷成本的效益後,才啟用它。批次推理可把大量單輪工作的費率減半,但不支援工具呼叫和多輪交流。
證明 Agent 的投資回報:描述人手基準
效率高不代表有價值。Agent 即使已完全最佳化,仍可能不值得運行。決定預算的關鍵問題是:Agent 是否比以往的人手處理方式更好?
先記錄人手流程
評估 Agent 投資回報時,最大的錯誤是在未有先描述人手工作流程的情況下,就嘗試證明其價值。在建構或擴展 Agent 之前,先以營運角度記錄現行流程:工作由甚麼觸發、涉及哪些人手崗位、交接環節在哪裏,以及如何界定工作已完成。這聽起來像繁文縟節,實際上卻是測量設計。之後每項儀表化決策(如何界定一次執行、如何界定成功,以及人手時間花在哪裏)都可由這份描述推導出來。
在 Agent 推出前量度基準
按照所述流程,在具代表性的時段內量度人手基準:完成所需時間、排隊時間、實際人手投入時間、重開率、升級率、每項任務成本,以及成果質素。必須在智能代理正式投入運作前量度基準,而非事後憑記憶重構。事後回溯建立的基準會系統性地美化智能代理的表現:人們會記得一般個案,卻忘記處理得很快的個案。
為工作流程加入實驗監測
建立基準後,從第一天起便以實驗方式為智能代理工作流程加入監測。每次執行都會取得一個追蹤 ID,而且每個重要步驟都可供觀察。工作流程執行記錄會將模型呼叫之前的所有資料整合為單一可分析單位:
{
  "runId": "run-8f3a2c",
  "workflow": "renewal-risk-summary",
  "agent": "renewal-agent",
  "principalArn": "arn:aws:sts::123456789012:assumed-role/BedrockRuntimeRole/gw-alex",
  "team": "sales-ai",
  "costCenter": "CC-2041",
  "experiment": {
    "variant": "treatment",
    "holdout": False,
    "promptVersion": "v14",
    "policyVersion": "2026-07"
  },
  "ops": {
    "latencyMs": 41200,
    "retries": 1,
    "toolCalls": 6,
    "humanApprovals": 1,
    "humanMinutes": 35,
    "escalations": 0
  },
  "econ": {
    "inputTokens": 48210,
    "outputTokens": 3105,
    "cacheReadTokens": 31500,
    "estCostUsd": 0.87
  },
  "outcome": {
    "status": "success",
    "accepted": True,
    "reopened": False,
    "revenueEventId": "opp-44121"
  }
}
三個欄位尤其值得注意:
實驗組別:在建立執行記錄時寫入,並傳遞至 Bedrock 請求中繼資料,令模型層級與工作流程層級的記錄能準確連接。
humanMinutes:這是大多數團隊會省略、但又最需要的欄位。缺少這項資料,「智能代理完成了工作」這種説法便會在不知不覺間忽略人手花在檢查上的 35 分鐘。
revenueEventId:這是日後進行收入歸因的關鍵連接點。記錄這項資料不費分毫,而且事後無法重構。
原則:如果工作流程遙測資料無法回答業務問題,代表監測工作並不完整。
將成本與成果連結
呼叫日誌存入 Amazon S3(第 1 部分),而工作流程執行記錄則存放在分析資料庫中,兩者只要連接一次,便可得出重要指標。Amazon Bedrock 日誌記錄的是 token 數量,而非金額,因此首先要建立一個檢視,根據 token 數量及模型費率表為每次呼叫定價,並按執行 ID 彙總。然後使用 Amazon Athena 查詢:
SELECT
  w.workflow,
  w.variant,
  COUNT(*) AS runs,
  SUM(IF(w.outcome_status = 'success', 1, 0)) AS successes,
  ROUND(SUM(c.est_cost_usd) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS cost_per_success,
  ROUND(SUM(w.retries) * 1.0 /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS retries_per_success,
  ROUND(SUM(w.human_minutes) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 1)
    AS human_min_per_success
FROM workflow_runs w
JOIN invocation_costs_by_run c ON c.run_id = w.run_id
GROUP BY w.workflow, w.variant
ORDER BY cost_per_success DESC注意:上述查詢中的欄位名稱及連接鍵只作示例。請根據實際的呼叫日誌結構及工作流程遙測資料儲存區核實,兩者可能因實作方式而異。
每項成功成果的成本、每次成功所需的重試次數,以及每次成功所需的人手分鐘數,這三個數字才經得起持懷疑態度的 CFO 審視。每次呼叫成本會令反覆循環的智能代理看起來更划算;每次成功成本則不會。請留意變體分組:同一查詢按實驗組別拆分後,便可比較 ROI。
正確比較智能代理與人手
最具公信力的評估方法是 A/B 測試或留出組測試。透過受控的實驗組和對照組,比較智能代理輔助的工作流程與人手基準,避免將結果與市場、季節或組織變化混為一談。
對於面向客戶或與收入相關的工作流程,應按訪客、潛在客戶、帳戶或個案層級隨機分組。對於內部工作流程(支援營運、編碼助理),則應使用配對羣組,例如團隊、儲存庫羣組或小組。
比較涵蓋四個層面:
效率:完成所需時間、騰出的工時、排隊時間縮短幅度。
質素:錯誤率、批核率、重開率、升級率。
成本:每項任務成本、每項成功成果的成本、總服務成本。
業務價值:轉換率提升、留存率提升、擴展率、每位銷售代表或每個工作流程的收入。
如果智能代理改善一個層面,卻令另一個層面明顯變差,結果便難以定論,部署亦需要調校。
收入:最難衡量的指標
效率提升是最容易證明的投資回報部分。收入影響較難衡量,而這正是管理層據以決定資金投放的指標。在與收入相關的工作流程中,應衡量 Agent 是否提升轉換率、縮短回應時間、推進交易進度,或增加每名銷售代表帶來的收入。留出組測試是最可靠的方法,可將歸因於 Agent 的增量收入與一般業務增長區分開來。
當收入確實有所提升,討論的方向便會改變。機構不再追問 Bedrock 帳單是否增加,而會開始探討額外開支能否換來顯著的業務產出增長。
評分表
根據我們與客戶合作時的觀察,健全的營運模式不需要五十項指標。實際有效的做法,是為每個投入生產環境的 Agent 制定一份與決策掛鈎的精簡評分表,並定期檢視。
以下門檻只是起點,並非硬性規定。請根據自身的 Agent 羣組數據和機構背景調整。
| 範疇 | 指標 | 綠色 | 黃色 | 紅色 |
| 採用情況 | 活躍用戶/目標用戶 | >70% | 40-70% | <40% |
| 品質 | 無需返工即可完成的任務 | >90% | 75-90% | <75% |
| 效率 | 每週節省的工時 | >目標 | 目標的 50-100% | <目標的 50% |
| 成本 | 每項成功成果的成本 | ≤預算 | 預算的 1-1.5 倍 | >預算的 1.5 倍 |
| 業務影響 | 相較基準的 KPI 提升幅度 | 顯著 | 輕微 | 沒有提升或呈負面 |
綠色代表可以擴大規模:Agent 的表現優於基準,同時符合成本和品質門檻。黃色代表需要調整:前景不錯,但仍有待改善。紅色代表應停用或重新設計:Agent 帶來成本,卻沒有足夠的可量度價值。願意真正停用評為紅色的 Agent,才能令整份評分表更具公信力。
結語
本文介紹瞭如何計算模型的真實成本,包括四項隱藏成本因素(分詞器效率、輸出對齊、Agent 循環效率和推理開銷);如何透過提示詞快取、模型路由、輸出限制和批次推理降低每項任務的成本;以及如何量度人工基準、把工作流程設計成實驗並加入量測、將成本與成果對應,以及進行留出組比較,藉此證明 Agent 的投資回報。
成本優化部分回答「為甚麼成本這麼高,以及如何改善」。投資回報部分則回答「Agent 是否比人手錶現更好」。再加上第一部分介紹的營運模式(歸因、觀察、強制執行、優化、營運),便構成一套完整框架:你可以知道開支由誰產生、瞭解原因、減少浪費,並為剩餘開支提出理據。
要開始評估,請使用 Amazon Bedrock 模型評估,以自己的提示詞為基準測試首選模型候選項目;從 usage 區塊或呼叫日誌擷取 token 數和輪次;按目前的 Bedrock 定價計算成本,再除以成功率。如要量度投資回報,請參閲 Well-Architected Agentic AI Lens,瞭解 Agent 成本管治的最佳做法。
如果你發現其他能降低每項任務成本或量度 Amazon Bedrock 上 Agent 投資回報的方法,歡迎在留言中告訴我們。
作者簡介

Majd Arbash
Majd Arbash 是 AWS 的企業解決方案架構師,常駐多倫多,協助企業客戶建立安全、可擴展的雲端解決方案,並採用生成式 AI。Majd 是 Serverless and Generative AI Technical Field Communities 的成員,專注於應用程式現代化、安全,以及親身試驗生成式 AI。

Aswath Ram A Srinivasan
Aswath 是 Bedrock 的資深專業解決方案架構師,專注於 Bedrock 核心模型、功能,以及成本最佳化/歸因。他協助 ISV 及策略性客戶解決挑戰,並與企業團隊合作設計推理架構,以負責任的方式兼顧效能、成本及營運簡便性。閒暇時,他是攝影師,亦喜歡研讀神經符號式 AI 和負責任 AI 相關的科學期刊論文。

Ajit Mahareddy
Ajit 是一位經驗豐富的產品及市場推廣(GTM)領導者,在產品管理、工程及市場推廣方面擁有逾 20 年經驗。在現職之前,Ajit 曾在 Uber、Turing 及 eHealth 等領先科技公司帶領產品管理工作,打造 AI/ML 產品。他熱衷於推動生成式 AI 技術發展,並以生成式 AI 帶來實際影響。
來源:AWS Machine Learning Blog · aws.amazon.com