Matryoshka Embedding 模型入門:訓練、使用與效能比較
🪆 Introduction to Matryoshka Embedding Models
Hugging Face Blog 介紹 Matryoshka Embedding 模型的訓練與使用方法,並比較向量截短後與一般嵌入模型的表現。
文章把 Sentence Transformers 訓練方式與 STSBenchmark 實測相連,量化向量縮至原大小 8.3% 後仍保留 98.37% 表現。
這篇網誌會介紹 Matryoshka Embeddings 的概念,解釋其用途,討論這些模型在理論上如何訓練,以及如何使用 Sentence Transformers 訓練。
此外,我們會提供實用指引,説明如何使用 Matryoshka Embedding 模型,並比較 Matryoshka 嵌入模型和一般嵌入模型。最後,歡迎試用我們的互動示範,瞭解這些模型的能力。
目錄
- 認識嵌入
- 🪆 Matryoshka Embeddings
- 🪆 Matryoshka 娃娃
- 為何要使用 🪆 Matryoshka Embedding 模型?
- 如何訓練 🪆 Matryoshka Embedding 模型?
- 如何使用 🪆 Matryoshka Embedding 模型?
- 結果
- 示範
- 參考資料
認識嵌入
嵌入是自然語言處理中用途最廣泛的工具之一,能協助實務工作者處理各種任務。本質上,嵌入是較複雜物件(例如文字、圖像、音訊等)的數值表示。
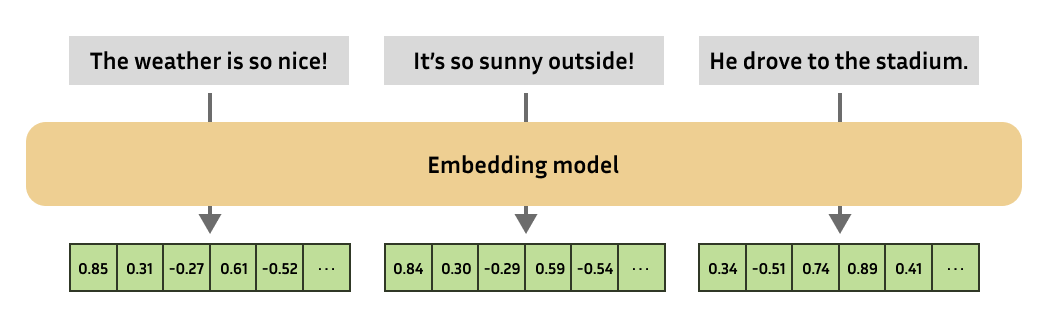
嵌入模型會一律輸出固定大小的嵌入。之後,你可以計算各自嵌入之間的相似度,藉此比較複雜物件的相似程度!
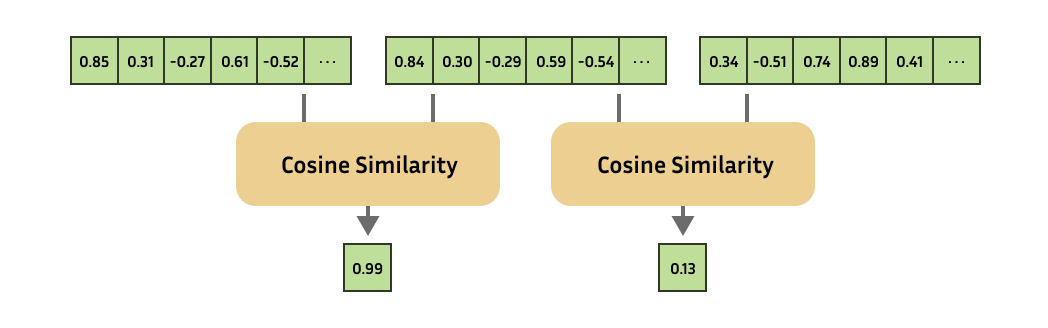
嵌入用途非常廣泛,也是推薦系統、檢索、單樣本或少樣本學習、離羣值偵測、相似度搜尋、意譯偵測、分羣、分類等應用的基礎!
🪆 Matryoshka Embeddings
隨着研究進展,新一代最先進的(文字)嵌入模型開始輸出維度愈來愈高的嵌入,即每段輸入文字會以更多數值表示。雖然這能提升效能,卻會降低下游搜尋或分類等任務的效率。
因此,Kusupati 等人(2022)受到啟發,開發出可合理縮短嵌入、而不會嚴重影響效能的模型。
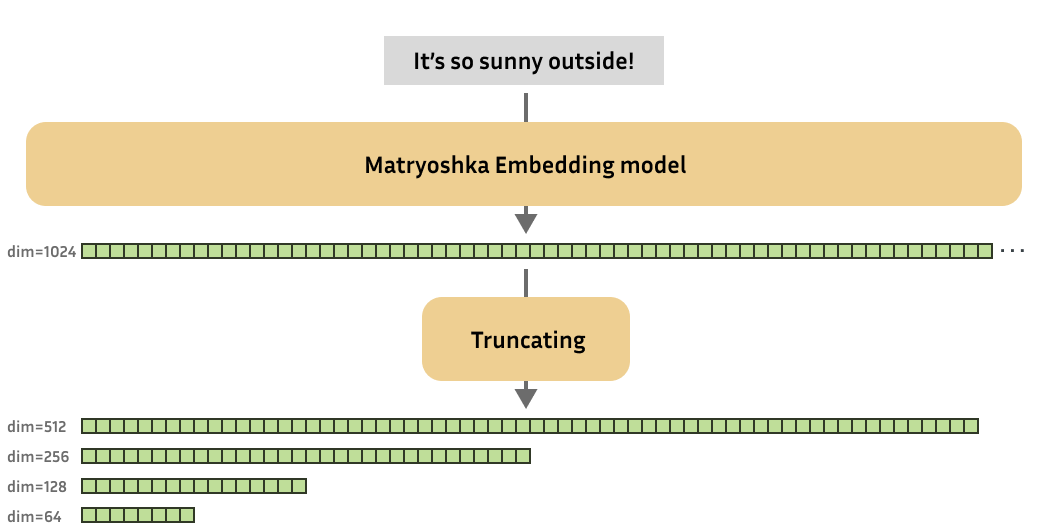
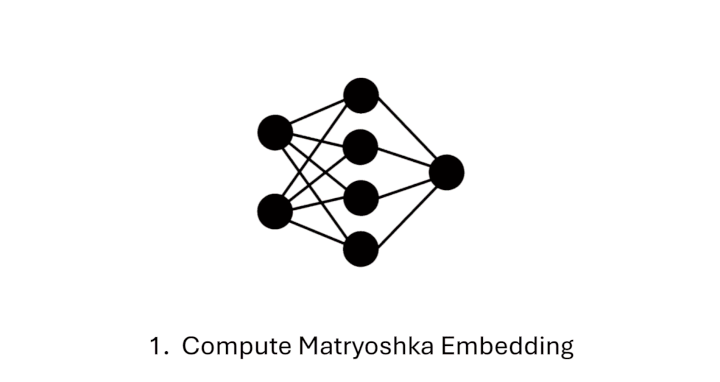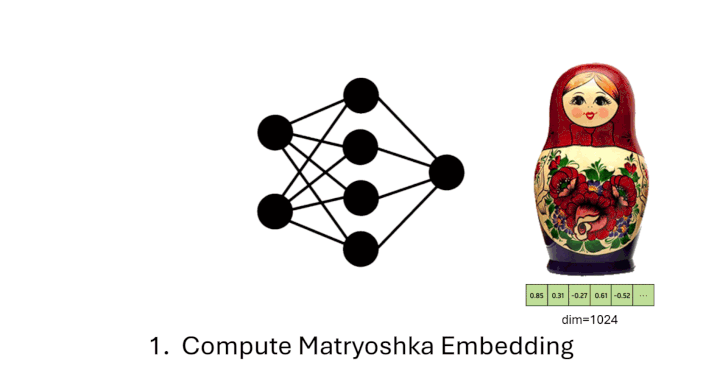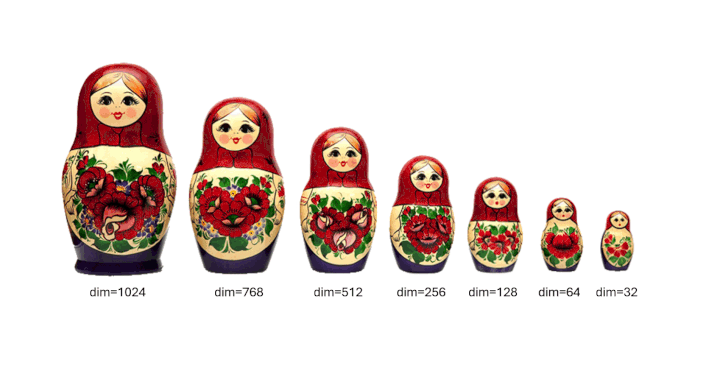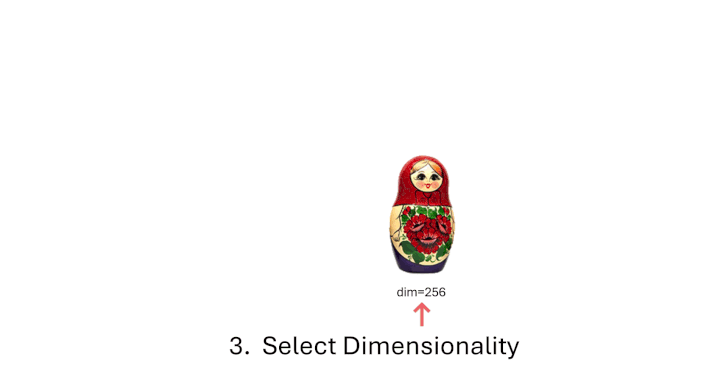
Matryoshka 嵌入模型的訓練方式,令截短後的小型嵌入仍然有用。簡單來説,Matryoshka 嵌入模型可輸出多種維度、各自有用的嵌入。
🪆 Matryoshka 娃娃
如果你不熟悉「Matryoshka 娃娃」,它們又稱「俄羅斯套娃」,是一套大小依次遞減、可以互相套疊的木製娃娃。類似地,Matryoshka 嵌入模型會把較重要的資訊放在前面的維度,較不重要的資訊放在後面的維度。這項特性讓我們可以截短模型輸出的原始大型嵌入,同時保留足夠資訊,以在下游任務中維持良好表現。
為何要使用 🪆 Matryoshka Embedding 模型?
這類可變大小的嵌入模型對實務工作者很有價值,例如:
- 初步篩選和重新排序:毋須以完整嵌入執行下游任務(例如最近鄰搜尋),可以先縮短嵌入,以極高效率進行「初步篩選」。之後再以完整維度處理餘下的嵌入。
- 取捨彈性:Matryoshka 模型讓你按所需的儲存成本、處理速度和效能,調整嵌入方案的規模。
如何訓練 🪆 Matryoshka Embedding 模型?
理論原理
Matryoshka Representation Learning(MRL)方法幾乎可套用至所有嵌入模型訓練框架。一般而言,嵌入模型的一個訓練步驟會先為訓練批次(例如一批文字)生成嵌入,再使用損失函數產生損失值,以表示這些嵌入的品質。訓練期間,最佳化器會調整模型權重,降低損失值。
Matryoshka Embedding 模型的訓練步驟同樣會為訓練批次生成嵌入,但損失函數不只會衡量完整嵌入的品質,也會衡量不同維度嵌入的品質。例如,輸出維度可以是 768、512、256、128 和 64。各維度的損失值會相加,得出最終損失值,最佳化器再嘗試調整模型權重以降低這個數值。
實際上,這會鼓勵模型把最重要的資訊放在嵌入的前段,這樣即使嵌入被截短,重要資訊仍會保留下來。
在 Sentence Transformers 中使用
Sentence Transformers是常用的嵌入模型訓練框架,最近已加入 Matryoshka 模型支援。使用 Sentence Transformers 訓練 Matryoshka 嵌入模型相當簡單:我們不只對完整嵌入套用損失函數,也會對截短後的嵌入部分套用相同損失函數。
例如,原始嵌入維度為 768 的模型,現在可在 768、512、256、128 和 64 維上訓練。各項損失會相加,亦可選擇加上不同權重:
from sentence_transformers import SentenceTransformer
from sentence_transformers.losses import CoSENTLoss, MatryoshkaLoss

model = SentenceTransformer("microsoft/mpnet-base")

base_loss = CoSENTLoss(model=model)
loss = MatryoshkaLoss(
    model=model,
    loss=base_loss,
    matryoshka_dims=[768, 512, 256, 128, 64],
    matryoshka_weight=[1, 1, 1, 1, 1],
)

model.fit(
    train_objectives=[(train_dataset, loss)],
    ...,
)
使用 MatryoshkaLoss 訓練不會帶來明顯的時間開銷。
參考資料:
以下完整指令碼示範如何實際套用 MatryoshkaLoss:
- matryoshka_nli.py:此示例使用
MultipleNegativesRankingLoss配合MatryoshkaLoss,以自然語言推理(NLI)資料訓練強大的嵌入模型。這是對NLI文件的改編。 - matryoshka_nli_reduced_dim.py:此示例使用
MultipleNegativesRankingLoss配合MatryoshkaLoss,訓練最高輸出維度只有 256 的強大嵌入模型。它使用自然語言推理(NLI)資料訓練,並改編自NLI文件。 - matryoshka_sts.py:此示例使用
CoSENTLoss配合MatryoshkaLoss,在STSBenchmark資料集的訓練集上訓練嵌入模型。這是對STS文件的改編。
如何使用 🪆 Matryoshka Embedding 模型?
理論原理
實際上,從 Matryoshka 嵌入模型取得嵌入的方法與一般嵌入模型相同。唯一差別是取得嵌入後,可以按需要把它截短至較小維度。請注意,如果嵌入經過正規化,截短後便不再是正規化結果,因此你可能需要再次正規化。
截短後,你可以直接用於所需用途,或儲存起來以便日後使用。畢竟,向量資料庫中的嵌入較小,應可大幅提升速度!
請記住,雖然使用較小嵌入執行檢索、分羣等下游任務會更快,但從模型取得較小嵌入的速度,與取得較大嵌入一樣快。
在 Sentence Transformers 中使用
在 Sentence Transformers 中,你可以像載入其他模型一樣載入 Matryoshka Embedding 模型,但可使用 truncate_dim 參數指定所需嵌入大小。之後,可使用 SentenceTransformers.encode 函式進行推論,嵌入便會自動截短至指定大小。
我們來試用一個以 matryoshka_nli.py 搭配 microsoft/mpnet-base 訓練的模型:
from sentence_transformers import SentenceTransformer
from sentence_transformers.util import cos_sim

matryoshka_dim = 64
model = SentenceTransformer("tomaarsen/mpnet-base-nli-matryoshka", truncate_dim=matryoshka_dim)

embeddings = model.encode(
    [
        "The weather is so nice!",
        "It's so sunny outside!",
        "He drove to the stadium.",
    ]
)
print(embeddings.shape)
# => (3, 64)

# Similarity of the first sentence to the other two:
similarities = cos_sim(embeddings[0], embeddings[1:])
print(similarities)
# => tensor([[0.8910, 0.1337]])
歡迎試用 matryoshka_dim 的不同數值,觀察它們如何影響相似度。你可以在本機或雲端執行這段程式碼(例如使用Google Colab),也可以試用示範。
參考資料:
按此瞭解如何使用 Nomic v1.5 Matryoshka 模型
注意:Nomic 特別要求在截短嵌入前執行 F.layer_norm。因此,以下程式片段會手動把嵌入截短至指定維度。其他所有模型均可使用建構函式中的 truncate_dim 選項,如上例所示。
from sentence_transformers import SentenceTransformer
from sentence_transformers.util import cos_sim
import torch.nn.functional as F

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1.5", trust_remote_code=True)

matryoshka_dim = 64
embeddings = model.encode(
    [
        "search_query: What is TSNE?",
        "search_document: t-distributed stochastic neighbor embedding (t-SNE) is a statistical method for visualizing high-dimensional data by giving each datapoint a location in a two or three-dimensional map.",
        "search_document: Amelia Mary Earhart was an American aviation pioneer and writer.",
    ],
    convert_to_tensor=True,
)
# The Nomic team uses a custom architecture, making them recommend Layer Normalization before truncation
embeddings = F.layer_norm(embeddings, normalized_shape=(embeddings.shape[1],))
embeddings[..., :matryoshka_dim]  # Shrink the embedding dimensions

similarities = cos_sim(embeddings[0], embeddings[1:])
# => tensor([[0.7154, 0.4468]])
結果
介紹 Matryoshka 模型後,讓我們看看這類嵌入模型與一般嵌入模型的實際預期效能。這次實驗中,我訓練了兩個模型:
- tomaarsen/mpnet-base-nli-matryoshka:使用
matryoshka_nli.py配合microsoft/mpnet-base訓練。 - tomaarsen/mpnet-base-nli:使用修改版的
matryoshka_nli.py訓練,損失函數只使用MultipleNegativesRankingLoss,而非在MatryoshkaLoss上再疊加MultipleNegativesRankingLoss。基礎模型亦使用microsoft/mpnet-base。
這兩個模型都使用 AllNLI 資料集訓練。該資料集由SNLI和MultiNLI資料集串接而成。我使用多種嵌入維度,在STSBenchmark測試集評估模型。以下圖表展示結果:
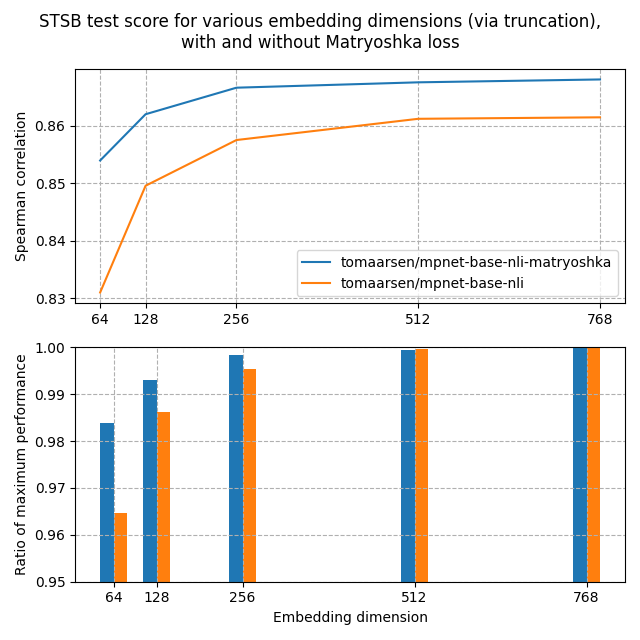
從上方圖表可見,Matryoshka 模型在所有維度下的 Spearman 相似度都高於標準模型,顯示它在這項任務中表現更佳。
此外,Matryoshka 模型的效能下降速度遠低於標準模型。第二幅圖清楚展示此結果,圖中比較各嵌入維度相對於最高效能的表現。即使嵌入大小隻有 8.3%,Matryoshka 模型仍保留 98.37% 的效能,遠高於標準模型的 96.46%。
這些結果顯示,截短 Matryoshka 模型的嵌入可:1) 大幅加快檢索等下游任務;以及 2) 顯著節省儲存空間,同時不會明顯降低效能。
示範
在這個示範中,你可以動態縮短nomic-ai/nomic-embed-text-v1.5 Matryoshka 嵌入模型的輸出維度,並觀察對檢索效能的影響。所有嵌入都會使用🤗 Transformers.js在瀏覽器中計算。
參考資料
- Kusupati, A., Bhatt, G., Rege, A., Wallingford, M., Sinha, A., Ramanujan, V., ... & Farhadi, A. (2022). Matryoshka representation learning. Advances in Neural Information Processing Systems, 35, 30233-30249. https://arxiv.org/abs/2205.13147
- Matryoshka Embeddings — Sentence-Transformers 文件。(無日期)https://sbert.net/examples/training/matryoshka/README.html
- UKPLab。(無日期)。GitHub。https://github.com/UKPLab/sentence-transformers
- Unboxing Nomic Embed v1.5:運用 Matryoshka Representation Learning 建立可調整大小的正式環境嵌入。(無日期)https://blog.nomic.ai/posts/nomic-embed-matryoshka
相關網誌
以下文章介紹如何使用 Matryoshka Representation Learning 訓練嵌入模型,或把它與 Sentence Transformers 的其他技術結合:
- 使用 Sentence Transformers 訓練和微調嵌入模型:端到端訓練指南,涵蓋
MatryoshkaLoss和其他損失函數。 - 使用 Sentence Transformers 訓練和微調重新排序模型:Cross Encoder 模型,可在 Matryoshka 嵌入截短後產生候選清單時用作第二階段。
- 使用 Sentence Transformers 訓練和微調稀疏嵌入模型:SPLADE 訓練。
- 使用 Sentence Transformers 建立多模態嵌入和重新排序模型:説明如何在推論時使用多模態嵌入模型。
- 使用 Sentence Transformers 訓練和微調多模態嵌入和重新排序模型:示範如何在多模態視覺文件檢索模型中套用 Matryoshka 訓練,並提供各維度的保留率數據。
- 使用 Sentence Transformers 將靜態嵌入模型訓練速度提升 400 倍:透過 Matryoshka 損失訓練,模型截短後仍可保留大部分品質。
- 二元和純量嵌入量化,大幅加快並降低檢索成本:量化截短後的 Matryoshka 向量,讓兩種縮減方式同時生效。
來源:Hugging Face Blog · huggingface.co