Postman 如何在 Amazon Bedrock 上為 40 million 名開發者運行 Agent Mode
How Postman runs Agent Mode for 40 million developers on Amazon Bedrock
Postman 分享如何透過 Amazon Bedrock 為 40 million 名開發者運行 Agent Mode,並歸納將成熟產品接入 AI 智能體的生產架構經驗。核心做法包括按任務動態篩選工具、以結構化資料支援查詢,以及為不同實體建立專用上下文處理器;修改應用程式狀態前仍須用戶批准。Agent Mode 亦使用模型選擇、跨區域推理、為支援模型設定的零數據保留,以及分層提示詞快取。
文章拆解 Postman 如何按任務動態配置工具、以結構化資料查詢及專用上下文設計,處理成熟產品接入智能體的工程難題。
為示範而建立 AI Agent,與為 4,000 萬名開發人員提供可實際使用的 Agent,是截然不同的工程問題。Postman 著手打造 Agent Mode,讓用戶以 AI 原生方式處理 API 測試、文件、探索及實作。團隊原以為,模型質素和提示詞設計會是最棘手的問題。更深層的挑戰,來自將 Agent 整合到成熟產品之中:這款產品經過多年發展,累積了不少以介面操作為前提的假設,涵蓋範圍廣泛,亦包含專門概念。
在本文中,Postman 和 AWS 説明如何在打造成熟產品的過程中,讓 AI Agent 理解產品。過程中形成的架構模式包括控制工具過度擴張、提供基於結構描述的讀取功能,以及將上下文而非功能視為首要瓶頸。
我們亦會説明 Agent Mode 如何使用 Amazon Bedrock,以靈活選用模型、按地理區域範圍限制跨區域推理、按模型設定零資料保留,以及採用多層提示詞快取。這些經驗有助團隊將正式環境中的 Agent 推進至原型階段以外。
Postman 為何打造 Agent Mode
Agent Mode 是 Postman 讓用戶以 AI 原生方式使用產品的入口,涵蓋測試、文件、探索及實作。Postman 經過 11 年發展,開發人員和用戶已學會透過介面尋找資訊,例如展開側邊欄、查看分頁和開啟請求。要讓 Agent 掌握這些資訊位置,便揭示出產品 API、用戶體驗及產品知識分佈方面的結構性假設。Agent 會根據數據推理,而非瀏覽畫面。圖 1 展示 Agent Mode 如何直接操作應用程式。
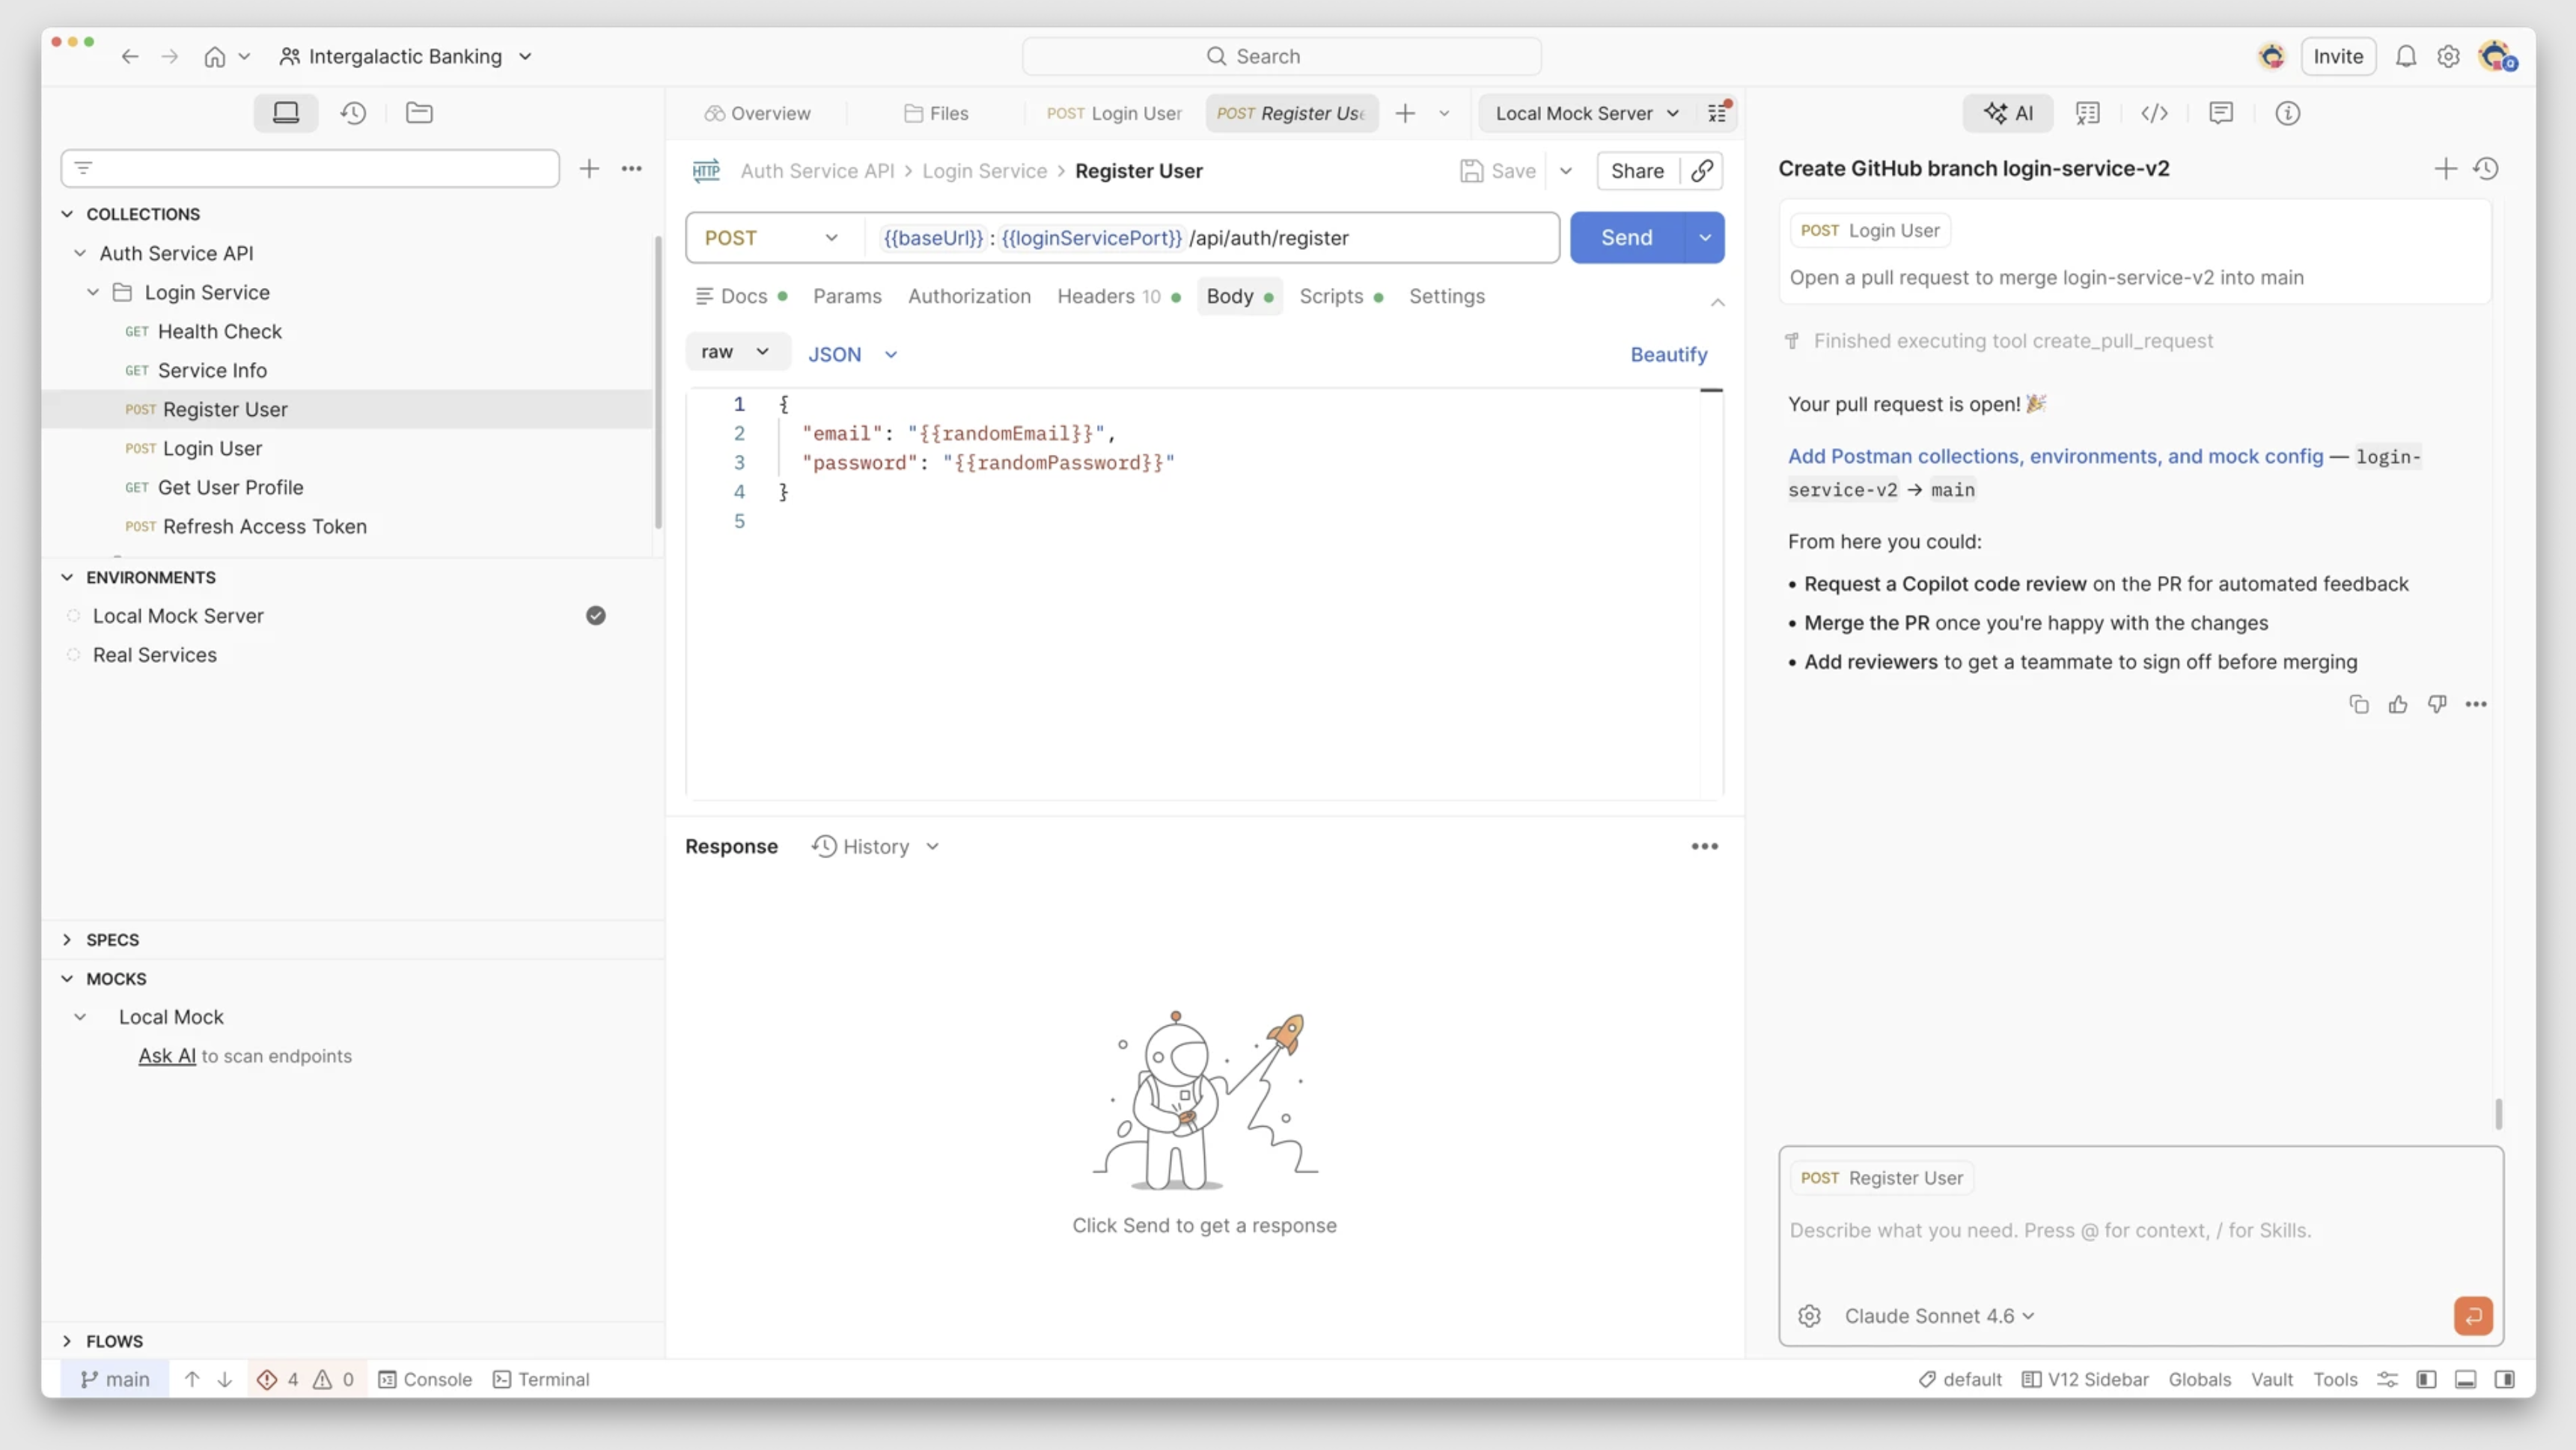
圖 1:Agent Mode 直接操作 Postman 應用程式。在此例中,它會開啟一個拉取請求並提出後續步驟,無需用戶在介面中逐步操作
Agent Mode 在 Amazon Bedrock 上運行,後者為 Agent 背後的基礎模型提供受管理的存取服務。服務全球開發人員社羣的 Postman 面對需求波動、對延遲敏感且流量時有急升的情況。使用 Amazon Bedrock,Postman 無需自行營運模型服務基礎架構,便可擴展這項正式環境工作負載,同時保留模型選擇的靈活性,並掌控吞吐量、處理地區及成本。圖 2 概述正式環境架構;下文將逐一探討各個組成部分。
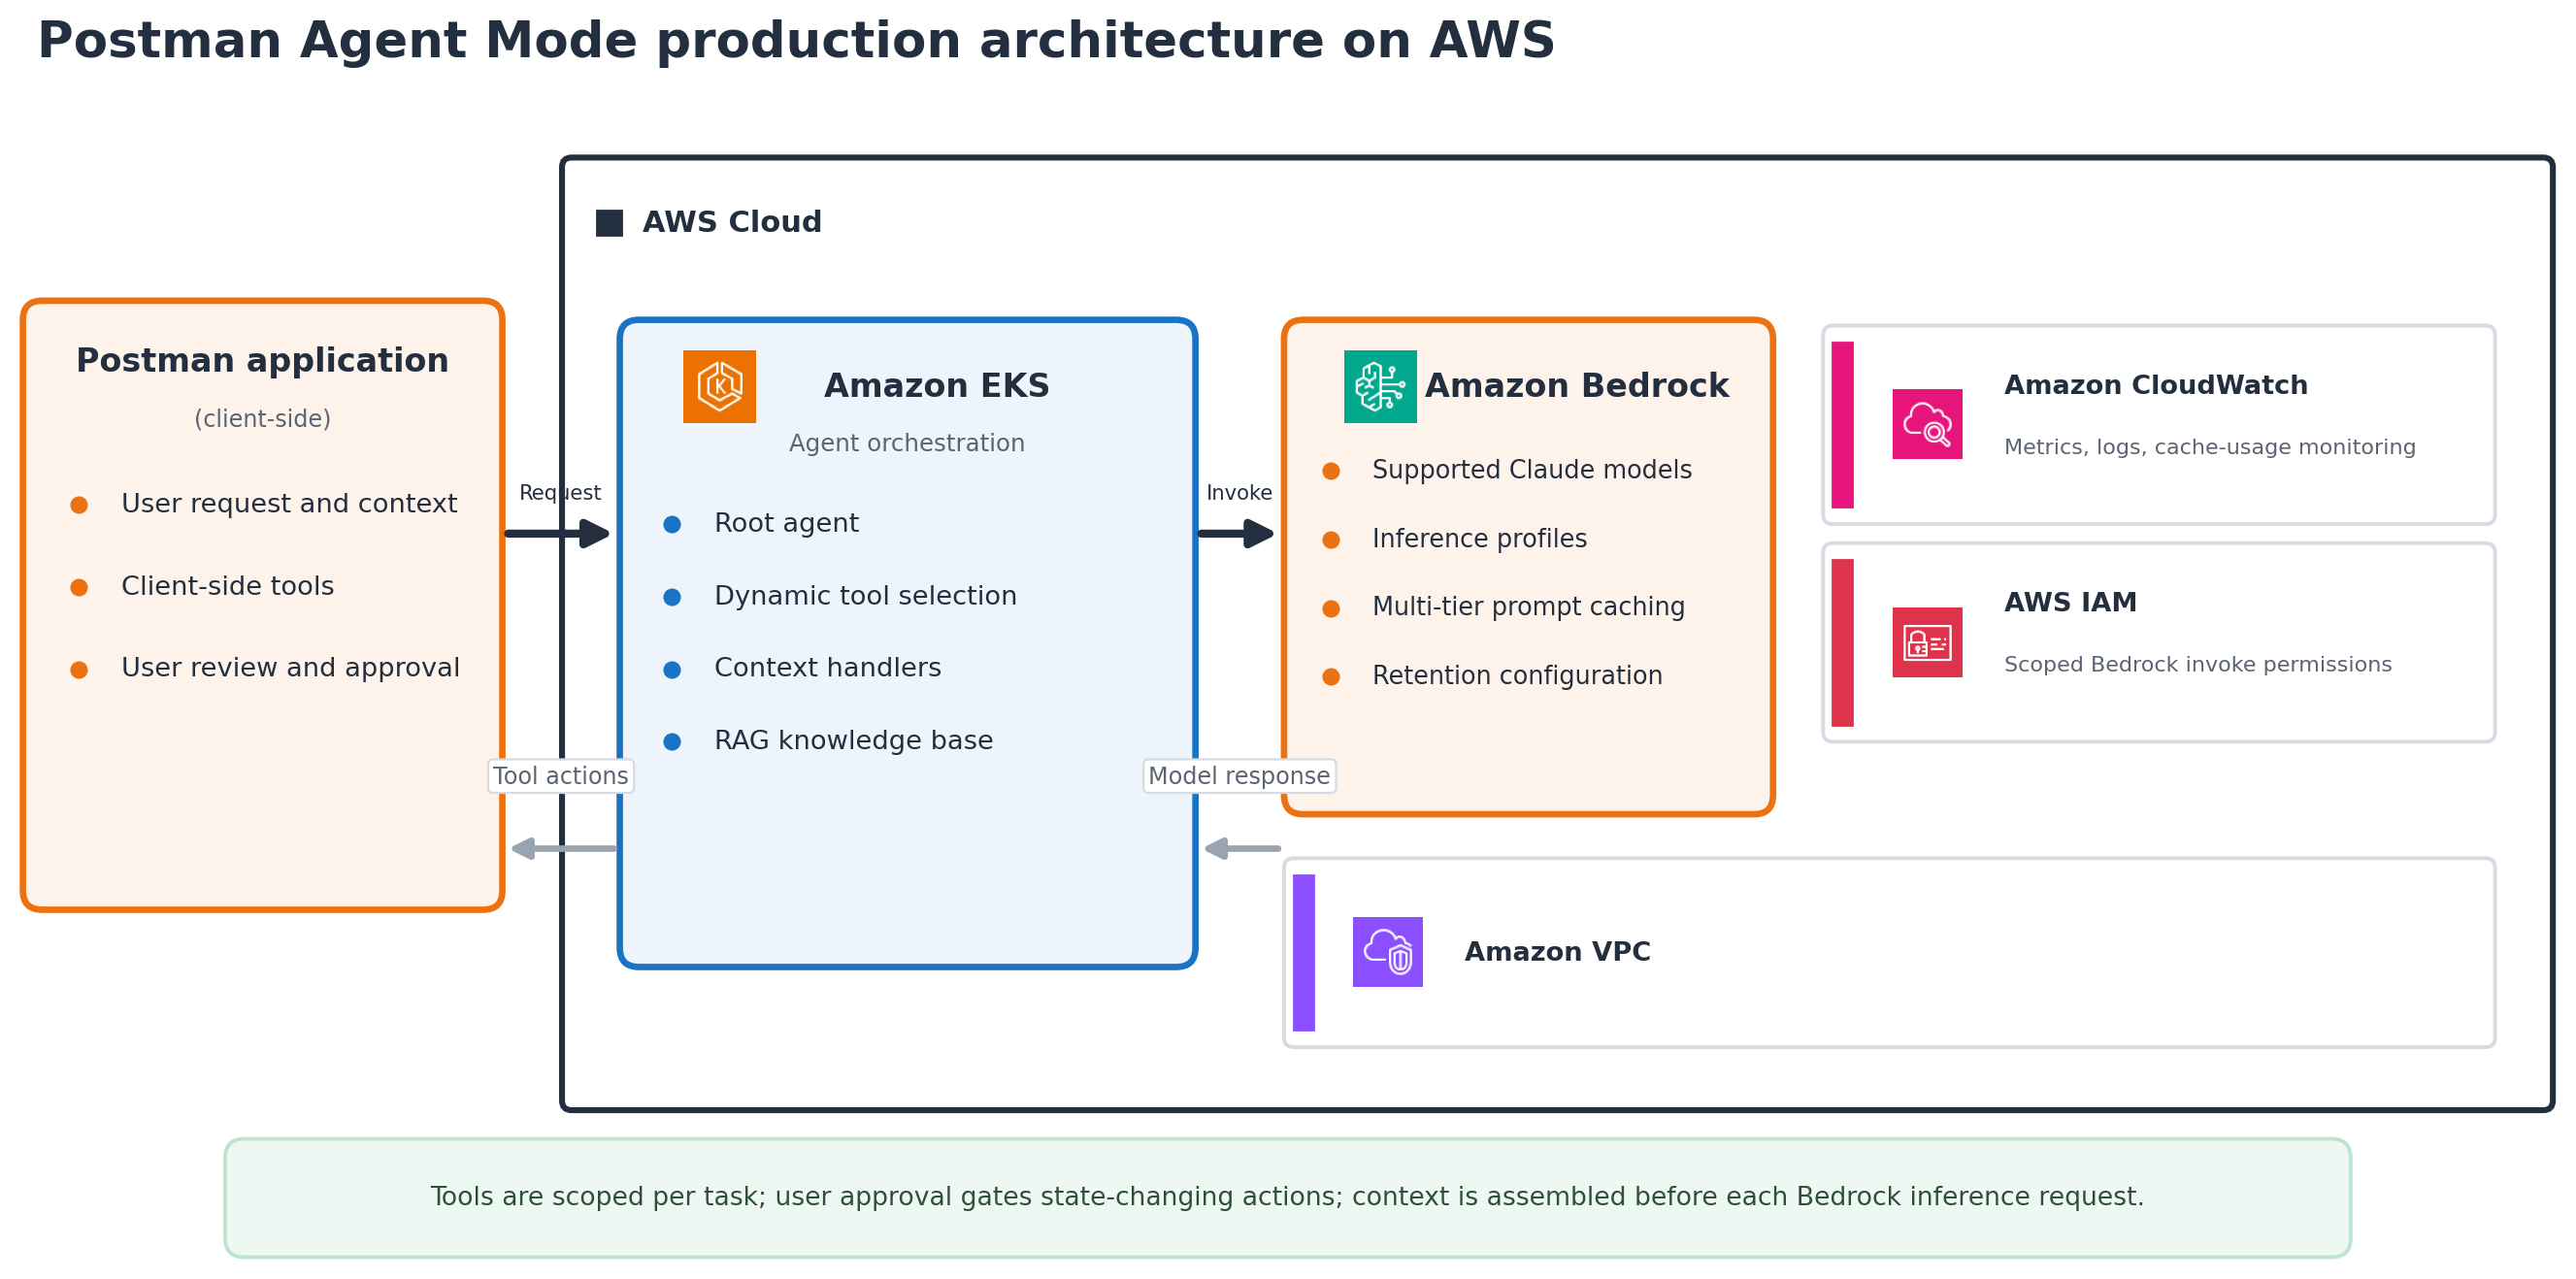
圖 2:Postman Agent Mode 結合用戶端工具、Agent 協調機制、專門設計的上下文,以及 Amazon Bedrock 模型推理。工具按任務限定;修改應用程式狀態的操作仍須用戶批准
人為監督是正式環境設計的一部分。Agent Mode 在執行會修改應用程式狀態的操作前,必須取得用戶批准。Postman 亦會按任務限定可用工具、選用專門設計的上下文,並按模型設定資料保留選項。這些控制措施可減少非預期操作和不必要的資料暴露,但仍有必要進行正式環境測試和監察。作為負責任 AI 的一項控制措施,Postman 使用 Amazon Bedrock Guardrails,在個人識別資料傳送至底層大型語言模型(LLM)前將其遮蔽。企業管理員可在 Agent Mode 的防護欄設定中啟用此功能。
處理工具過度擴張
在 Agent Mode 中,工具決定代理程式在 Postman 內如何執行操作。早期團隊傾向採用高度原子化的工具:例如開啟請求、更新單一欄位,或擷取特定中繼資料等細小而精確的操作。這種做法在早期迭代中有助確保正確性和控制能力,但也暴露了幾個問題。
許多真實工作流程都需要連續呼叫工具多次。即使每個步驟都很快,整體體驗仍然緩慢,因為每項操作完成後都必須先返回模型,下一步才能開始。用戶只能看着代理程式逐步執行操作,而他們心中早已把這些操作視為一項整體任務。
在 Postman 的測試中,當可見工具集超過約 40 個,工具選擇錯誤便會增加。代理程式可能呼叫不存在的工具、在結構描述有效的情況下仍傳入錯誤引數,或選擇語意上似乎合理、但在當前情境中並不適用的工具。較大型或較新的模型能減少這類情況,但無法完全消除。
工具集超過一定規模後,向代理程式公開更多工具反而可能降低其效能。目前的架構會根據需求和情境選擇工具,並隔離各個執行緒。模型只會看到與當前任務相關的工具。圖 3 展示了這種動態選擇流程。
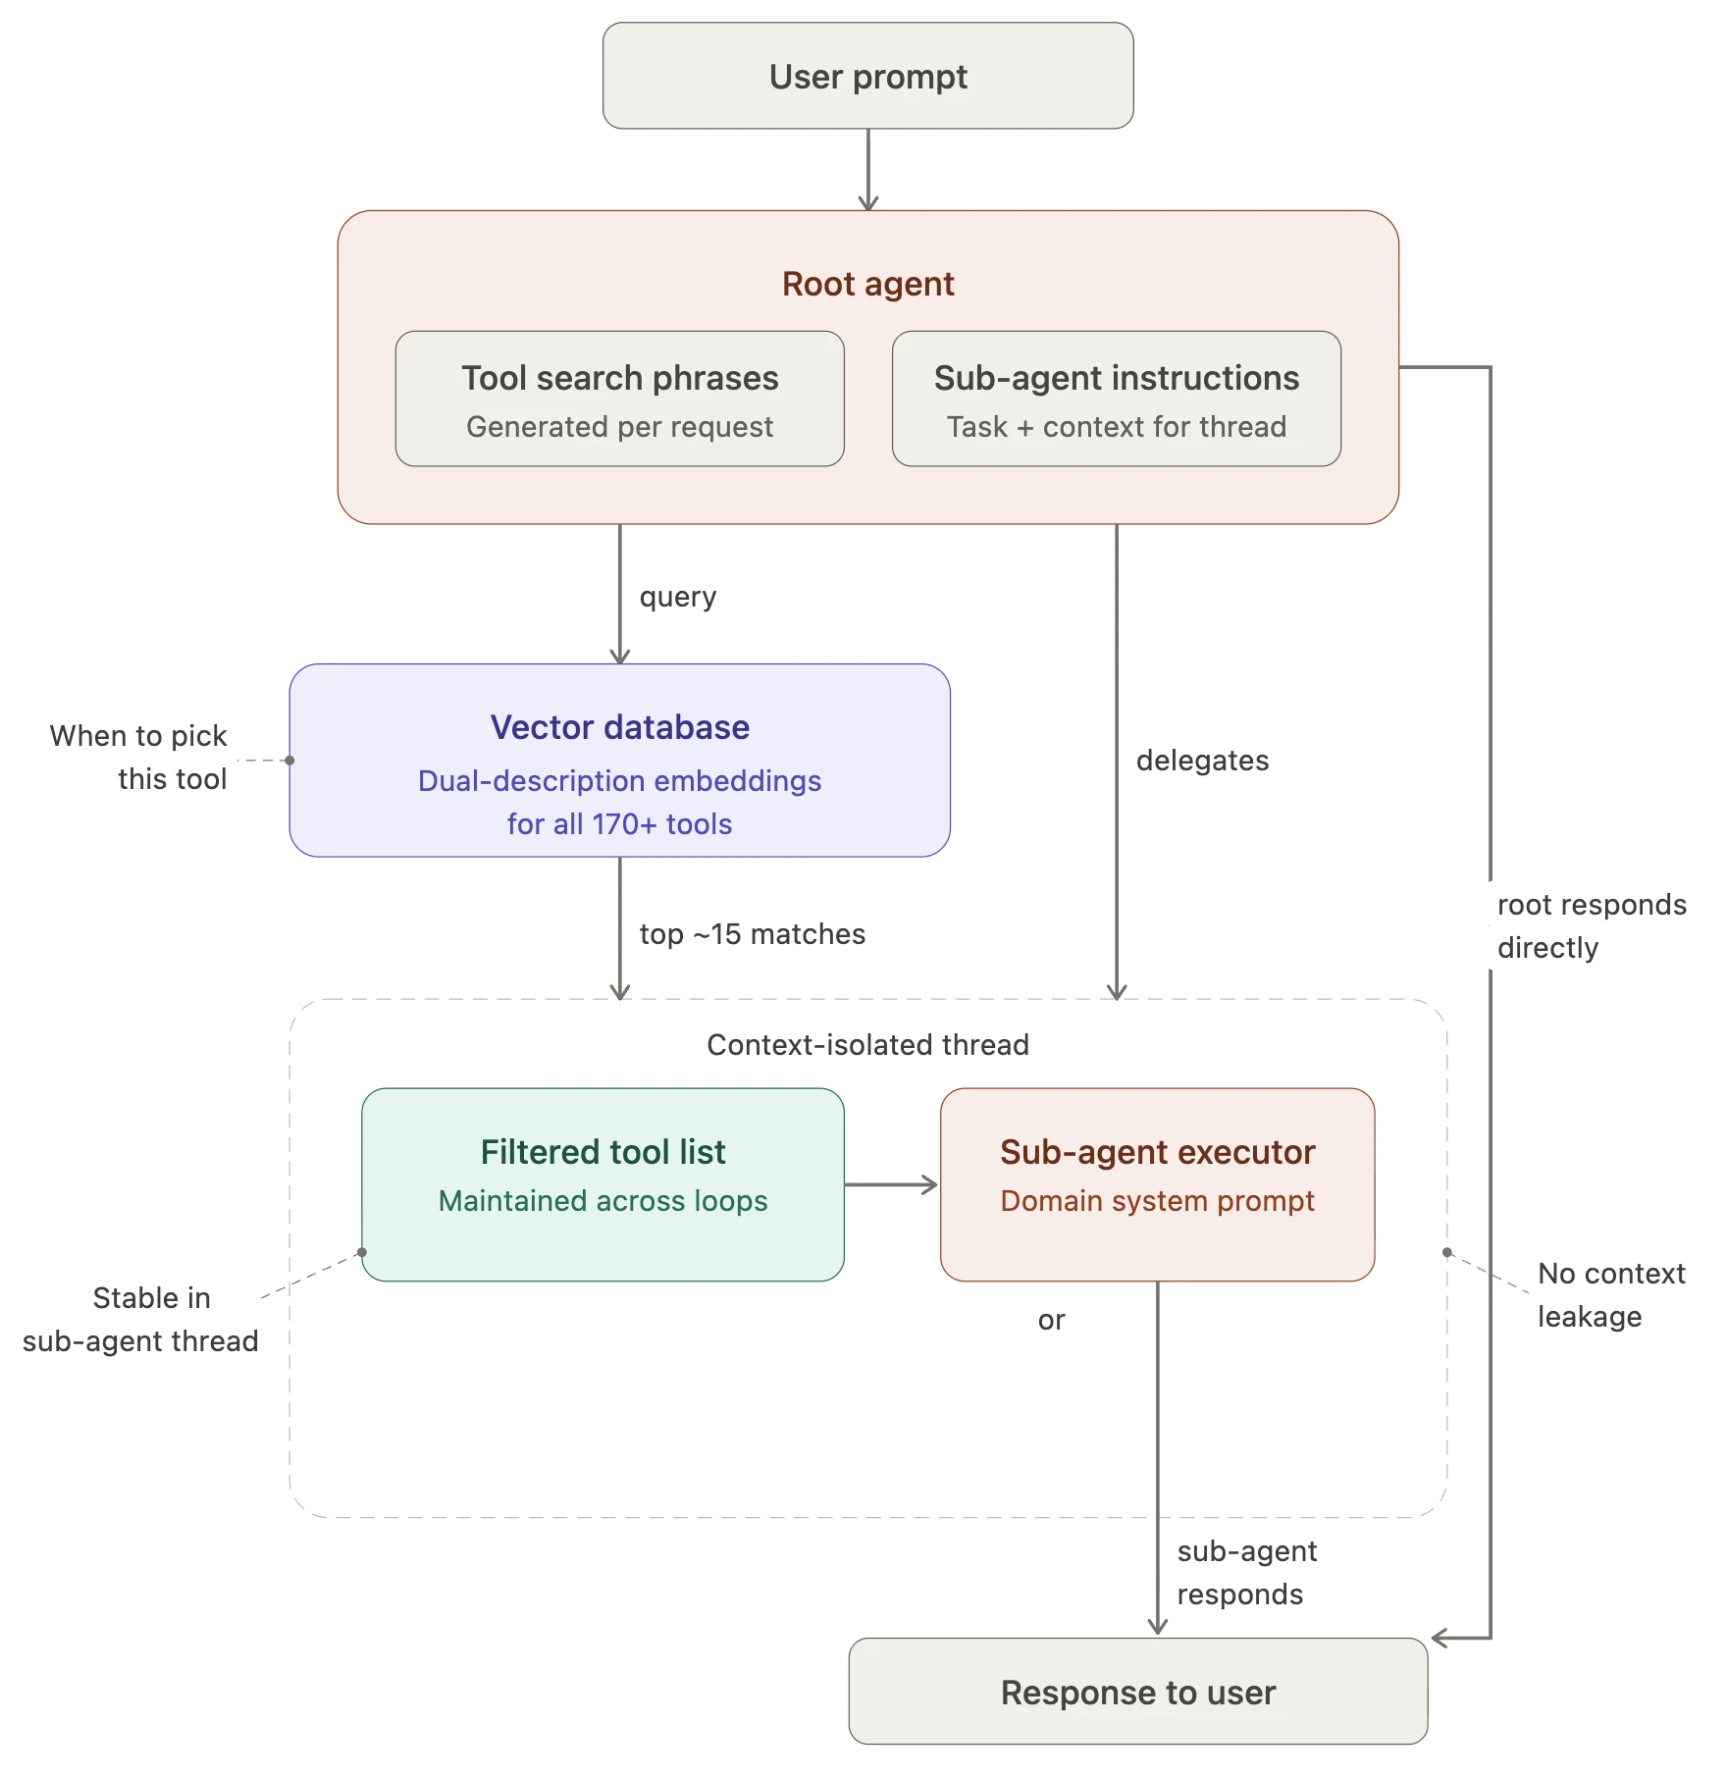
圖 3:根代理程式查詢工具嵌入向量資料庫,從 170 多個工具中篩選出約 15 個與請求相關的工具,然後將這些工具交給上下文隔離的子代理程式,讓模型只看到完成任務所需的工具
另一個較不明顯的問題是,許多用戶端 API 都隱含地依賴介面狀態。修改請求的工具需要某些項目處於開啟狀態,而其他工具則會在執行時順帶開啟新分頁。代理程式必須先開啟請求分頁才能讀取內容,結果只是模仿介面操作,而非根據資料進行推理。Postman 正積極令工具擺脱對分頁的依賴,其 Native Git 功能便廣泛採用這種做法。例如,Agent Mode 現在可以在背景傳送請求,無須開啟分頁,但仍須取得用戶批准。
給建構者的啟示:應把工具目錄視為上下文預算的一部分。按每項任務動態限定向模型公開的工具,並將「代理程式能做甚麼」與「使用者介面剛好開啟了甚麼」分開。
提供基於結構描述的讀取功能
對於 API Catalog 等產品,Postman 將多個範圍狹窄的檢視整合成單一查詢工具。這些產品會呈現多項服務的結構化資料,例如服務正常運作時間、測試結果和端點回應時間。
只要提供底層 ClickHouse 資料表的結構描述,代理程式便能生成包含 JOIN 和 WHERE 子句的複雜查詢。這大幅減少了回答分析問題所需的不同工具數量:
SELECT toString(service_id) AS service_id,
    countMerge(total_events_state) AS total_requests,
    countMerge(error_events_state) AS total_errors,
    round(countMerge(error_events_state) * 100.0
        / countMerge(total_events_state), 4) AS error_rate_pct,
    avgMerge(avg_latency_state) AS avg_latency_ms,
    quantileMerge(0.95)(p95_latency_state) AS p95_latency_ms
FROM http_events_summary_1d
WHERE service_id IN ('...list of service IDs')
    AND bucket_1d >= today() - 7
GROUP BY service_id
HAVING p95_latency_ms < 100
    AND total_requests > 0
ORDER BY error_rate_pct DESC;採用這種做法後,工程工作的重點便由為每個問題建立一個工具,轉為一次過妥善建模資料。之後,代理程式便能生成遠多於團隊以個別工具逐一列舉的各種查詢。
給建構者的啟示:如果你有結構良好的資料,應讓代理程式以具備結構描述感知能力的方式唯讀存取查詢引擎,而非不斷增加用途單一的讀取工具。這種做法以資料建模取代工具數量,能帶來更理想的擴展效能。
真正的瓶頸在於上下文
Postman 最初認為,缺少 工具會是最大的阻礙。實際上,缺少或不完整的上下文造成的失敗,比缺少功能更多。
上下文是代理對用戶在 Postman 中所處位置、目前作用中的實體,以及已確立狀態的理解。上下文有誤或缺失時,即使工具正確,也無法有效發揮作用。圖 4 區分了提供給代理的兩種上下文。
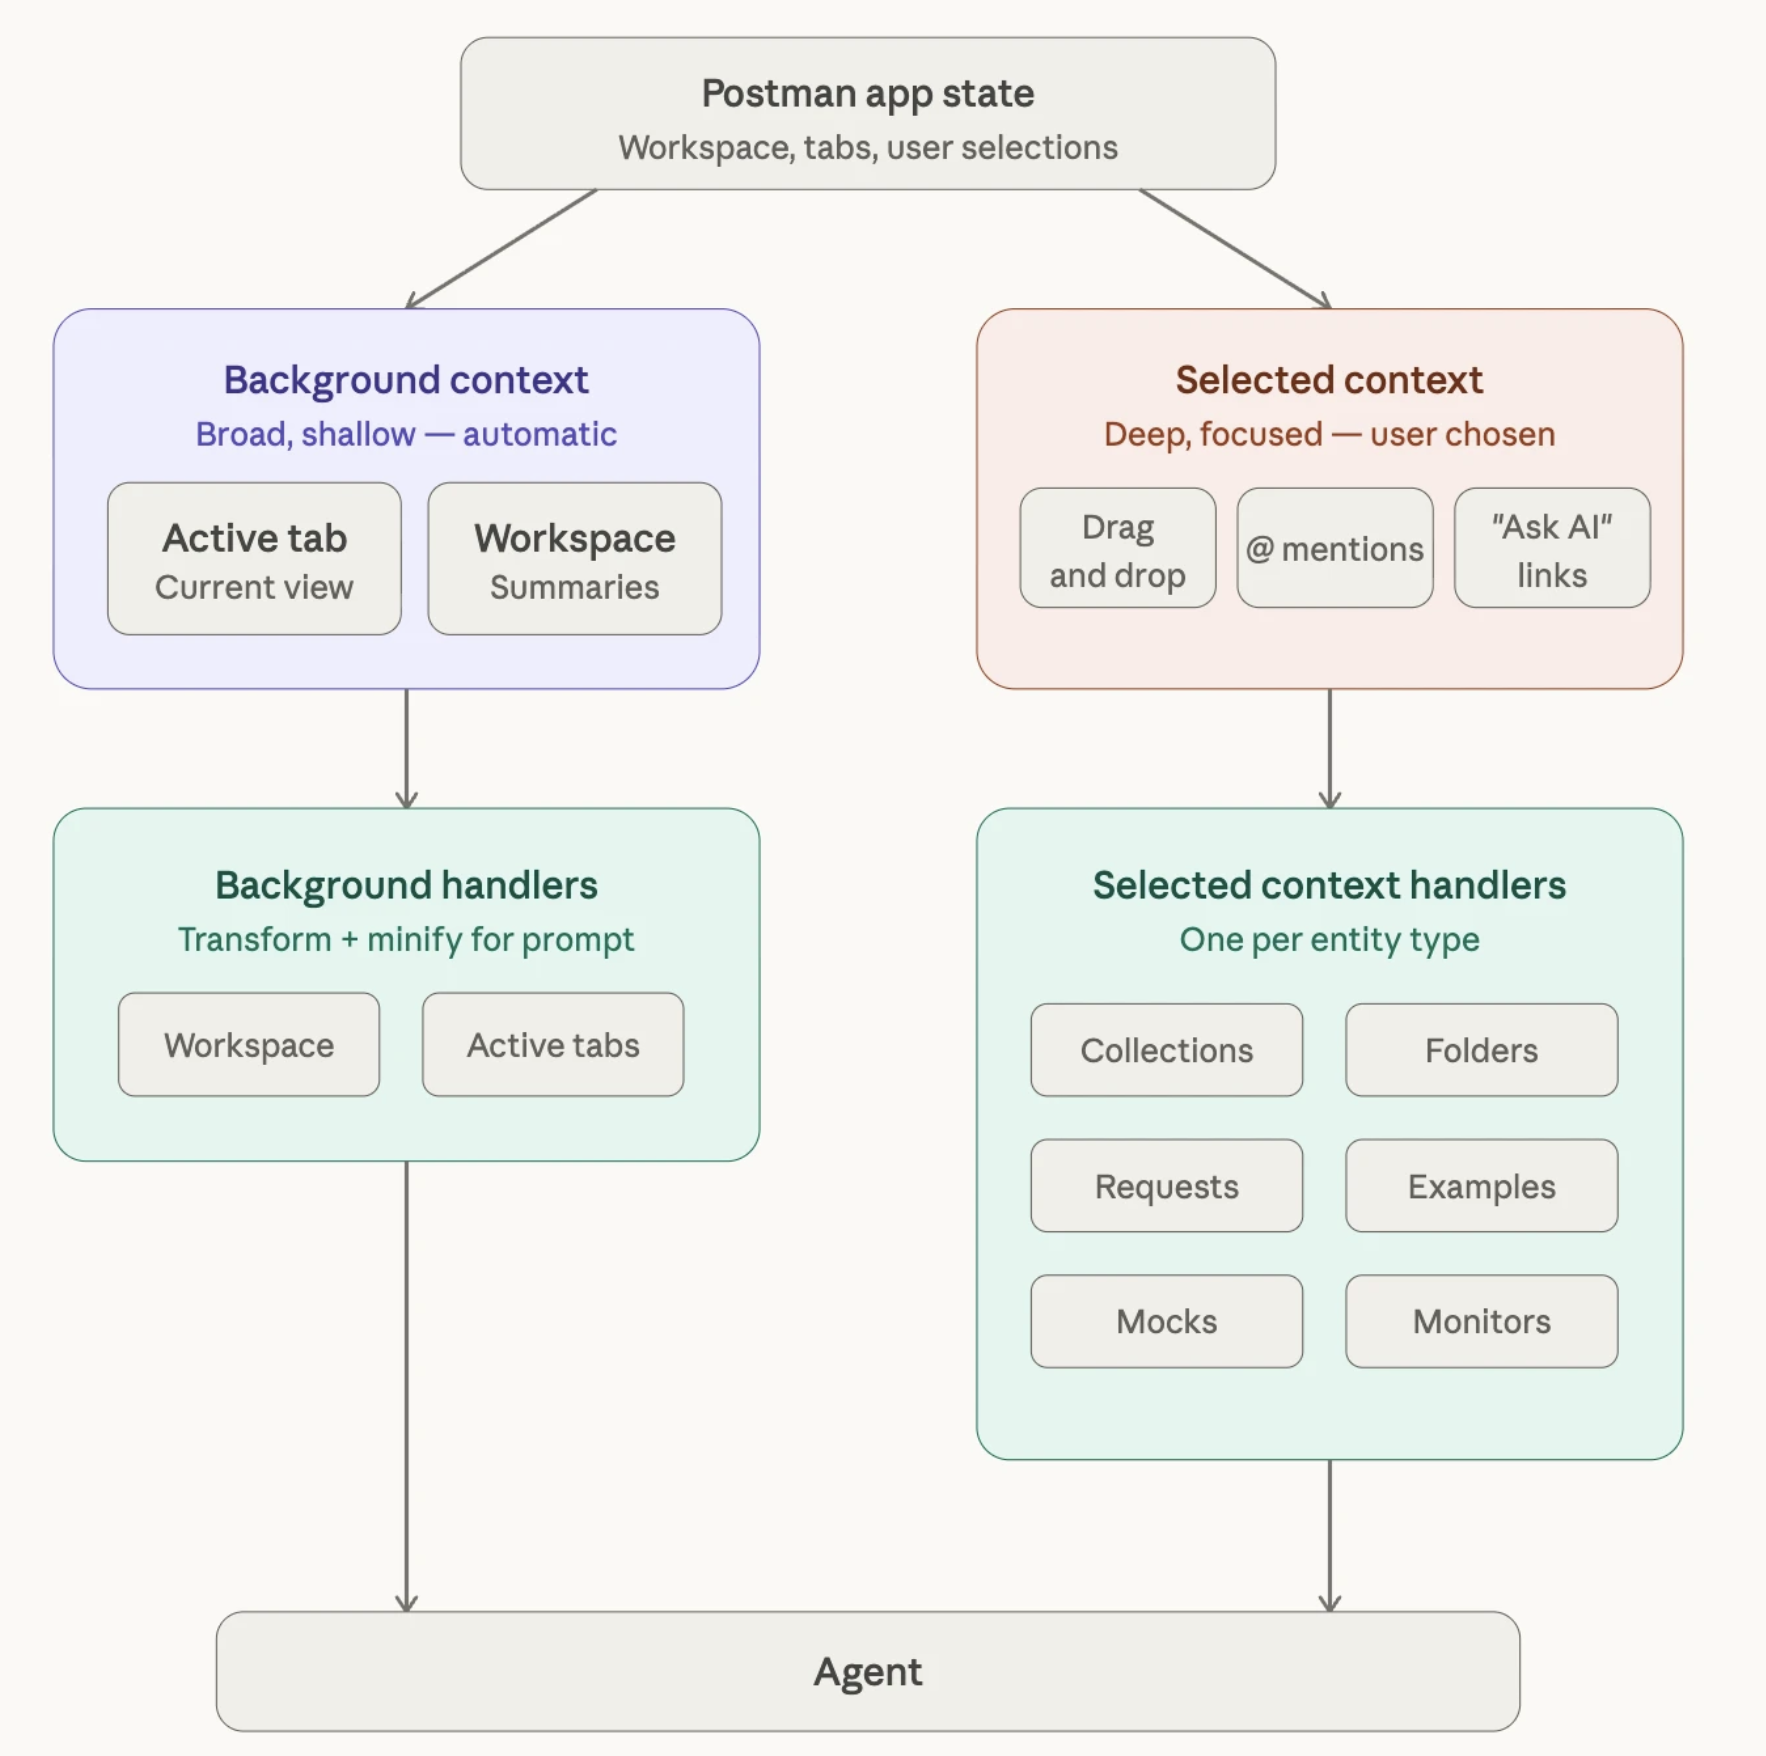
圖 4:兩種上下文會提供給代理。廣泛但淺層的背景上下文會自動收集,並精簡後放入提示詞。深入、聚焦的已選取上下文則由用戶選擇,再透過各實體類型專用的處理器傳遞。每個處理器都會提煉實體資訊,保留代理所需的內容
這是一項結構性挑戰。11 年來,開發者和用戶一直透過介面尋找資訊。要讓代理掌握這些資訊,需要經過多次迭代,才能判斷每個工作流程中哪些內容重要、哪些屬於雜訊。直接序列化現有介面的數據模型,無法產生有用的上下文,因為這些物件是為呈現和數據傳輸而設計,而非供推理使用。因此,Postman 建立了專用的上下文處理器,提煉各實體資訊,保留代理需要知道的內容。
隨着更多物件加入處理器,截斷內容成為下一個問題。許多欄位都包含開放式用戶生成資料,包括請求描述、OpenAPI 規格和請求負載。這些資料可能會佔滿上下文視窗。在大規模應用時,妥善管理上下文預算至關重要,也有助實現團隊正在探索的以檔案系統為後端的方法,讓每個處理器都無須自訂截斷和擴展邏輯。
建構者要點:不要把用於呈現的數據模型直接提供給模型。應建立按用途設計的上下文處理器,並把上下文視窗視為有限資源,主動管理其預算。模型尚未達到上限前,雜訊早已會擠走重要資訊。
整合各部分
隨着 Agent Mode 不斷演進,系統必須整合三個各自解決不同問題的組成部分,這一點已變得清晰。
- 用戶端工具位於 Postman 應用程式內,代表代理最終可執行的操作,例如開啟請求、修改設定、執行集合,以及檢查驗證設定。Agent Mode 亦會使用伺服器端工具執行網頁搜尋和管理代理循環等功能,但大多數工具都是在 Postman 應用程式中運作。
- 通用代理指示用來界定系統層級的行為,包括 Agent Mode 應有多主動、如何表達不確定性,以及具備哪些基本產品知識。
- 知識庫採用檢索增強生成(RAG)方法。Postman 涵蓋範圍廣泛,包括多種請求協定、模擬伺服器、監控器、文件、API Network、工作區治理、變數、輔助工具、程式碼生成、請求設定和集合執行。
將所有這些內容編入靜態提示詞並不可行,而且大部分內容與個別查詢無關。為初步填充知識庫,團隊使用 Postman Learning Center 生成簡潔、針對個別功能的文章。執行時,Agent Mode 會根據收到的查詢和可用上下文選取知識文章。舉例來説,用戶選取模擬伺服器時,Agent Mode 會自動加入相關文章。這樣可令代理程式預設保持輕量,需要時再提供深入資訊。知識庫會隨應用程式演進,因此團隊可隨新功能一併推出 Agent Mode 文件。
在 Amazon Bedrock 上執行 Agent Mode
之前描述的三個元件最終都對應至同一項執行時操作:向基礎模型(FM)發出推理呼叫。以 Postman 的規模而言,流量呈突發性,並由開發者活動驅動。路由、快取和地理處理控制機制有助 Postman 應對流量突增、管理推理成本,以及滿足特定工作負載的處理要求。Amazon Bedrock 提供四項在此最重要的能力。
Claude 系列模型的靈活選擇
Agent Mode 並不侷限於單一模型。透過 Amazon Bedrock 模型推理 API,Postman 可以使用受支援的 Anthropic Claude 模型,並為每項工作負載選用合適的模型。較快的模型可處理大量且對延遲敏感的互動;較大的模型則可處理複雜推理,適用於品質比成本更重要的情況。在受支援的 Claude 模型之間切換,主要只需更改設定,無須重新整合。這種靈活性直接有助應對前文所述的工具過度分散和上下文挑戰。Postman 的測試顯示,較新、規模較大的模型可減少工具幻覺;Postman 亦可採用受支援的模型,而無須重新建構整合。請參閲 Amazon Bedrock 各 AWS 區域支援的模型。
透過跨區域推理提升吞吐量
開發者流量時有突增,在單一 AWS 區域預留資源以應付需求高峯可能成本高昂。Agent Mode 使用 Amazon Bedrock 跨區域推理,在推理設定檔所定義的目的地區域之間自動路由要求。執行時,應用程式會將所選推理設定檔的 ID 或 Amazon 資源名稱(ARN)作為 modelId 傳入 Converse 或 InvokeModel。推理設定檔、適用的 AWS Identity and Access Management (IAM) 和服務控制政策,以及配額,都必須允許 Bedrock 可能選取的每個目的地區域。
- 地理推理設定檔只會在指定地理範圍內的支援區域之間路由要求,例如美國或歐盟。此選項結合更高吞吐量與已設定的地理處理邊界。
- 全球推理設定檔可在全球各個支援的目的地區域之間路由要求,在流量突增時提供額外吞吐量。只有在工作負載不要求地理範圍受限的處理邊界時,才適合使用這類設定檔。
Postman 可按工作負載選擇推理設定檔:若要取得可用的最高吞吐量,便選用全球設定檔;若處理必須限制在設定檔定義的地理範圍內,則選用地理推理設定檔。每個 Bedrock 推理要求所使用的 modelId 都會明確指定這項選擇。
# Schematic Converse request
response = bedrock_runtime.converse(
    modelId="<geographic-inference-profile-id-or-arn>",
    messages=messages,
    system=system_blocks,
)
資料駐留與企業控制措施
對企業客戶而言,獲準處理資料的地理範圍可能與吞吐量同樣重要。地理推理設定檔會限制 Bedrock 的路由範圍,使其只路由至所選地理範圍內、該設定檔支援的目的地區域。這不代表推理是在 Postman 自身的 AWS 環境中執行。Amazon Bedrock 會在該設定檔適用的 AWS 區域處理請求,資料在傳輸期間及靜態儲存時均會加密。AWS 表示,Bedrock 不會使用提示詞和生成內容訓練 AWS 模型,也不會向第三方分發這些內容。Postman 已為支援的 Agent Mode 模型設定零資料保留,並將 data_retention_mode 設為 none。可用性和行為視乎模型而定,因此每個正式環境使用的模型都必須根據最新的 Amazon Bedrock 資料保護及保留説明文件進行核實。
透過提示詞快取控制成本
正式環境中的 Agent 每次對話都會重新傳送大量穩定內容,包括系統指示、一般 Agent 行為、核心工具集、已選取的知識,以及對話脈絡。每次請求都重新處理未有變動的提示詞前綴,會帶來不必要的延遲和成本。
Agent Mode 使用 Amazon Bedrock 提示詞快取重用穩定的提示詞前綴。近乎不變的核心內容,包括系統提示詞、Agent 指示及核心工具定義,會使用一小時的快取檢查點。變動較頻繁的內容則使用五分鐘的檢查點,並會在快取命中時重新計時。Bedrock 要求較長效的檢查點必須排在較短效的檢查點之前。較短效的層級適合互動式工作階段,因為閒置的脈絡會過期;一小時層級則可透過多次讀取,分攤較高的快取寫入價格。快取效益和支援的 TTL 視乎所選模型而定。團隊可透過 cacheReadInputTokens 和 cacheWriteInputTokens 使用量欄位核實快取行為,並以自身工作負載量度首個 token 的產生時間。
# Schematic cache checkpoints in Converse content blocks
{"cachePoint": {"type": "default", "ttl": "1h"}}  # stable core
{"cachePoint": {"type": "default", "ttl": "5m"}} # variable layer開發者須知:應把推理視為路由和快取問題,而不只是模型選擇。按工作負載選擇 Claude 模型,挑選合適的跨區域推理設定檔,並為穩定的提示詞前綴設定符合各層變動頻率的 TTL。
在正式環境擴展 Agent 的最佳做法
從 Postman 的歷程提煉,供使用 Amazon Bedrock 的開發者參考:
- 工具預算與 token 同樣要審慎規劃。按工作任務動態選擇要提供的工具。Postman 測試發現,可見工具集愈大,工具選擇錯誤就愈多。
- 優先採用具備結構描述感知能力的讀取方式,而非增加工具數量。妥善建立資料模型,讓 Agent 查詢資料。
- 將 Agent 操作與介面狀態分開。如果工具要求分頁保持開啟,代表 Agent 正在操作介面,而不是直接對資料進行推理。
- 有意識地設計脈絡。專門設計的脈絡處理器,效果勝過每次都將渲染模型序列化。
- 把脈絡視窗視為有限資源管理。截斷和擴展策略是首要的設計問題,不應留待最後才處理。
- 功能推出時一併提供説明文件。只有與產品同步更新,RAG 知識庫才能持續發揮作用。
- 在 Bedrock 上進行路由和快取。按工作負載配對合適的 Claude 模型,根據吞吐量和地理要求選擇跨區域推理,並為穩定的提示詞前綴採用分層快取。
結論
建構 Agent Mode 令 Postman 必須正視大型語言模型的能力與成熟產品架構之間的差距:介面假設、彼此耦合的用戶端、龐大的工具目錄,以及分散在文件和不同團隊之間的知識。在規模龐大的 Postman 開發者社羣中,動態工具選擇、基於結構描述的讀取,以及有意識的上下文工程,逐漸形成可重複應用的模式。Amazon Bedrock 提供受管理的模型存取、跨區域推理、視乎模型而定的保留控制措施及提示詞快取,支援這套生產環境架構。
無論你正在建構首個 Agent,還是擴展現有 Agent,這些模式都可協助團隊避免常見的 Agent 整合及擴展挑戰。
如欲瞭解更多,請參閲 Amazon Bedrock 文件,當中包括有關跨區域推理、提示詞快取及資料保護與保留的指引。如需相關實作指引,請閲讀 AWS Machine Learning Blog 上的 在 Amazon Bedrock 上有效使用提示詞快取及 Amazon Bedrock 宣佈推出全域跨區域推理,以提高吞吐量。如欲瞭解產品,請參閲 Postman Agent Mode 文件。
Postman 的生產環境實作屬專有內容,並未以公開範例程式碼存放庫形式提供。
關於作者

Srinivas Kini
Srinivas 是 Postman AI 團隊的資深工程師,致力於建構企業級 Agent,工作範疇涵蓋分散式系統與 AI 基礎設施。他專注於核心 Agent 架構,確保 Agent 在大規模運作時仍然可靠而準確。

Shubham Gupta
Shubham 是駐印度班加羅爾的 AWS 解決方案架構師,負責支援獨立軟件供應商(ISVs)。他與工程及領導團隊合作,在 AWS 上設計、建構及營運產品,從初步架構設計到投入生產,並深入專注於生成式 AI 及大規模韌性。工作以外,Shubham 熱愛遠足,並將山徑上同樣的準備和堅持,帶到建構持久耐用的系統之中。
來源:AWS Machine Learning Blog · aws.amazon.com