BMW Group 如何治理服務數千名開發者的數百個智能體
How the BMW Group governs hundreds of agents across thousands of developers
BMW Group 分享如何治理服務數千名開發者的數百個智能體,並將治理要求納入建置、部署及運行流程。其研發團隊有逾 12,500 名開發者,治理規則以 IaC 編碼,並透過 CI/CD 執行安全、驗證及評估檢查。架構以 MCP 工具、技能和流程構成三層組合,中央登記庫負責資產發現、審批、安全檢查及重複能力識別。
文章把治理落實到架構、CI/CD 與運行階段,具體展示如何透過分層組合及自動化檢查,兼顧團隊自主和企業管控。
當數百個 Agent 為數千名開發人員提供服務,企業管治不能事後才考慮。
在 BMW Group 研發部門,超過 12,500 名開發人員負責約 5 億行車輛軟件程式碼。BMW Connected Vehicle 後端是一套以雲端為基礎的系統,包含超過 1,300 個微服務,為 2,400 萬輛已投入使用的車輛提供數碼服務。在受監管的行業中,對(軟件)質素、穩定性及管治合規的要求極高。
雖然現時已有研究成果、框架及指引,令建構 Agent 更容易,但要以高效、可擴展的方式將高質素 Agent 工業化並投入運作,仍是一項重大挑戰。
要在大型機構內擴展代理式 AI,不能只靠個別團隊。這需要各方共同努力、由團隊自主推動實驗,以及在企業內積極分享知識,因而形成根本的管治矛盾:開發團隊需要自由快速創新,企業則必須執行安全、防護、可組合性及成本效益方面的標準。若未能取得平衡,機構便有可能形成互不相通的 AI 孤島,並付出高昂代價重複工作。BMW Group 內有數百個分佈全球的團隊正建構 Agent,這無疑是一項實際挑戰。
本文詳細介紹支援 BMW 研發團隊大規模建構、管治及運作 Agent 的實踐方式和模式,同時不犧牲速度、質素或合規性。
方案
我們的基本理念很直接:從一開始便建構能夠互相協作的 Agent。這需要一種架構,令多樣性可組合、可管治及可自動化,同時毋須依賴單一框架或工具鏈。
這種架構的核心是 Agent harness,即圍繞大型語言模型(LLM)構建的執行階段層。它為自主運作提供執行循環、工具分派、記憶體管理及可觀測性掛鈎。
正如 AWS Well-Architected Framework 為雲端基礎架構設計制定標準,代理式系統也需要相應模式和可重用藍圖,從一開始便將管治、可組合性及營運最佳實踐融入其中。
自 2023 年起,我們便一直在企業規模下建構及運作代理式系統,並以此實踐經驗為基礎,圍繞五項相互配合的實踐方式組織方案。每項實踐均以基礎架構即程式碼(IaC)形式編碼,讓各團隊可以重複採用、審核及執行,同時不妨礙 DevOps 的交付速度。
主動管治,而非事後補救
管治必須從一開始便融入系統結構,並貫穿整個生命週期。我們認為,有效的代理式管治具備三項特質:
不受框架限制,並且外置:驗證、授權、速率限制及內容過濾等管治規則,均在整合層執行。這包括 Model Context Protocol(MCP)閘道、中央 Agent 登錄庫及協調邊界,而不是放在個別 Agent 的程式碼庫內。這樣一來,即使轉換框架、更換模型或重組團隊,管治措施仍然有效。
按領域調整,並分級處理:Agent 的各項操作風險並不相同:草擬文件、更新客戶記錄,以及將資料寫入正式環境資料庫,所需的監督程度截然不同。我們透過為每個步驟設定自主程度級別,實施分級信任:
- 第 0 級(人類介入循環):每項操作都需要人類明確批准。這是新 Agent 和高風險操作的起點。
- 第 1 級(人類監督循環):Agent 自主執行操作,但會提交決策,供人類其後審核。適用於輸入、輸出及回復選項均已明確界定的中風險任務。
- 第 2 級(在防護措施範圍內自主運作):Agent 在嚴格界定的政策邊界內獨立運作,並以確定性方式執行這些邊界,而非依靠提示詞指令(見下文)。此級別僅適用於低風險、已充分了解且有經驗證往績的操作。
應按步驟而非按 Agent 指派信任級別。單一工作流程可包含三個級別的步驟,讓團隊可以先採取審慎做法,並在信心逐步提升時循序增加自主程度;信心須以可量度的評估數據為依據,而非假設。
以確定性方式執行:管治機制以確定性程式碼在 Agent 的推理循環之外運作。實際上,這主要在 CI/CD 管道中進行。權限檢查、policy-as-code 規則及合規性驗證會在每次部署前於該處設置關卡,確保 Agent 尚未進入正式環境。由於這些檢查獨立於 Agent 運作,Agent 和其提示詞都無法凌駕這些檢查。輸出流量控制(例如收件人允許清單及外傳機密資料掃描)有助防止持有機密資料的 Agent 透過原本合法的呼叫洩露資料。
持續進行監測、驗證及評估
Agent 系統的可觀測性超越傳統應用程式監控。真正的問題已不再是服務有否回傳 HTTP 200 狀態碼,而是 Agent 有否產生忠實且符合政策的輸出,以及如何透過可觀測的執行軌跡證明這一點。要回答這個問題,便需要一個涵蓋常見查詢及邊界情況的真值資料集。從第一天起便會使用這個資料集進行評估,因此品質是以具代表性且受適當管治的評估數據集衡量,而非以合成提示詞衡量。
這套基礎設施不能事後補建,必須納入初始設計。持續整合與持續交付(CI/CD)管道會強制執行這項要求,因此缺乏監測工具的 Agent 會在評估開始前,於驗證階段遭到拒絕。
我們建議從三個方面加入監測工具:
- 意圖追蹤:記錄每次執行中可觀測的 Agent 軌跡(推理步驟、工具呼叫及檢索的上下文)。OpenTelemetry spans 會建立可供查詢的關聯脈絡,追蹤從用戶請求到最終輸出的整個流程。
- 以 CI 進行驗證及評估:Agent 的任何變更(提示詞修改、加入工具或更換模型)都會觸發管道。首先進行驗證,以自動化回歸測試涵蓋 Agent 元件及其互動。由於大部分 harness 元件都是確定性的,這些測試執行快速,而且可完全自動化。其次進行評估,根據真值資料集為非確定性輸出評分,並以品質門檻作為關卡。這個先後次序經過刻意安排:驗證是關卡,因此只有通過的建置版本才會進入評估。
- 模型分級與路由遙測:當 Agent 在不同模型之間路由時,應記錄路由決策及其理據,而不只是結果。模型層級的指派根據各任務類型的評估結果而定,表現欠佳的結果則會回饋,成為新的評估案例。
先聚焦,再以可組合性為設計原則
對於分散式雲端系統,業界透過採用微服務或服務網格等架構模式,解決端到端工作流程的複雜問題。Agent 系統的演進也需要沿着類似的路徑,從單體式通用 Agent 轉向多個互相協作的專門 Agent。
團隊應先界定問題,再考慮 Agent 的功能。在編寫任何協調邏輯之前,應先製作五項具體成果:
- 明確的範圍界定:説明 Agent 應該及不應該做甚麼。
- 互動模式:説明用戶及其他 Agent 如何呼叫它。
- 明確無歧義的工具定義:精確定義每項工具及其參數。
- 真值數據集:上述評估所用的參考資料,須在開始任何實作之前建立。
- 評估準則:列明衡量 Agent 表現所依據的品質門檻及基準。
這種嚴謹做法可避免我們觀察到最常見的失效模式:承擔過多職責的 Agent 會累積冗長的提示詞,令準確度下降、延遲增加。
單一 Agent 的範圍界定清晰後,便須將它設計成可組合的構件。因此,我們定義了三層組合架構:
- MCP 工具是原子級的整合合約。每項工具只封裝一項能力(例如 API 呼叫或資料庫查詢),不包含任何工作流程假設。這是穩定且可重用的一層。
- 技能是由 MCP 工具組成、針對特定領域的組合。例如,程式碼審查技能可串連靜態分析工具、程式碼風格檢查工具,以及以 LLM 為基礎的推理步驟。技能承載領域邏輯,但仍可在不同工作流程中移植使用。
- 流程是技能的端到端協調,代表完整的業務流程(例如完整的 PR 審查流程,或從需求到部署的週期)。
每一層都會在 CI/CD 流程中獨立驗證。元件測試涵蓋工具和技能,互動測試則涵蓋它們組合成流程的情況。
各層透過開放標準連接:用於工具整合的 MCP 和 Agent Skills、用於 Agent 之間通訊的協定,以及用於觀察由此產生的互動的 OpenTelemetry。
圖 1 展示三層如何逐層建立,從底層的個別 MCP 工具到頂層的完整流程。
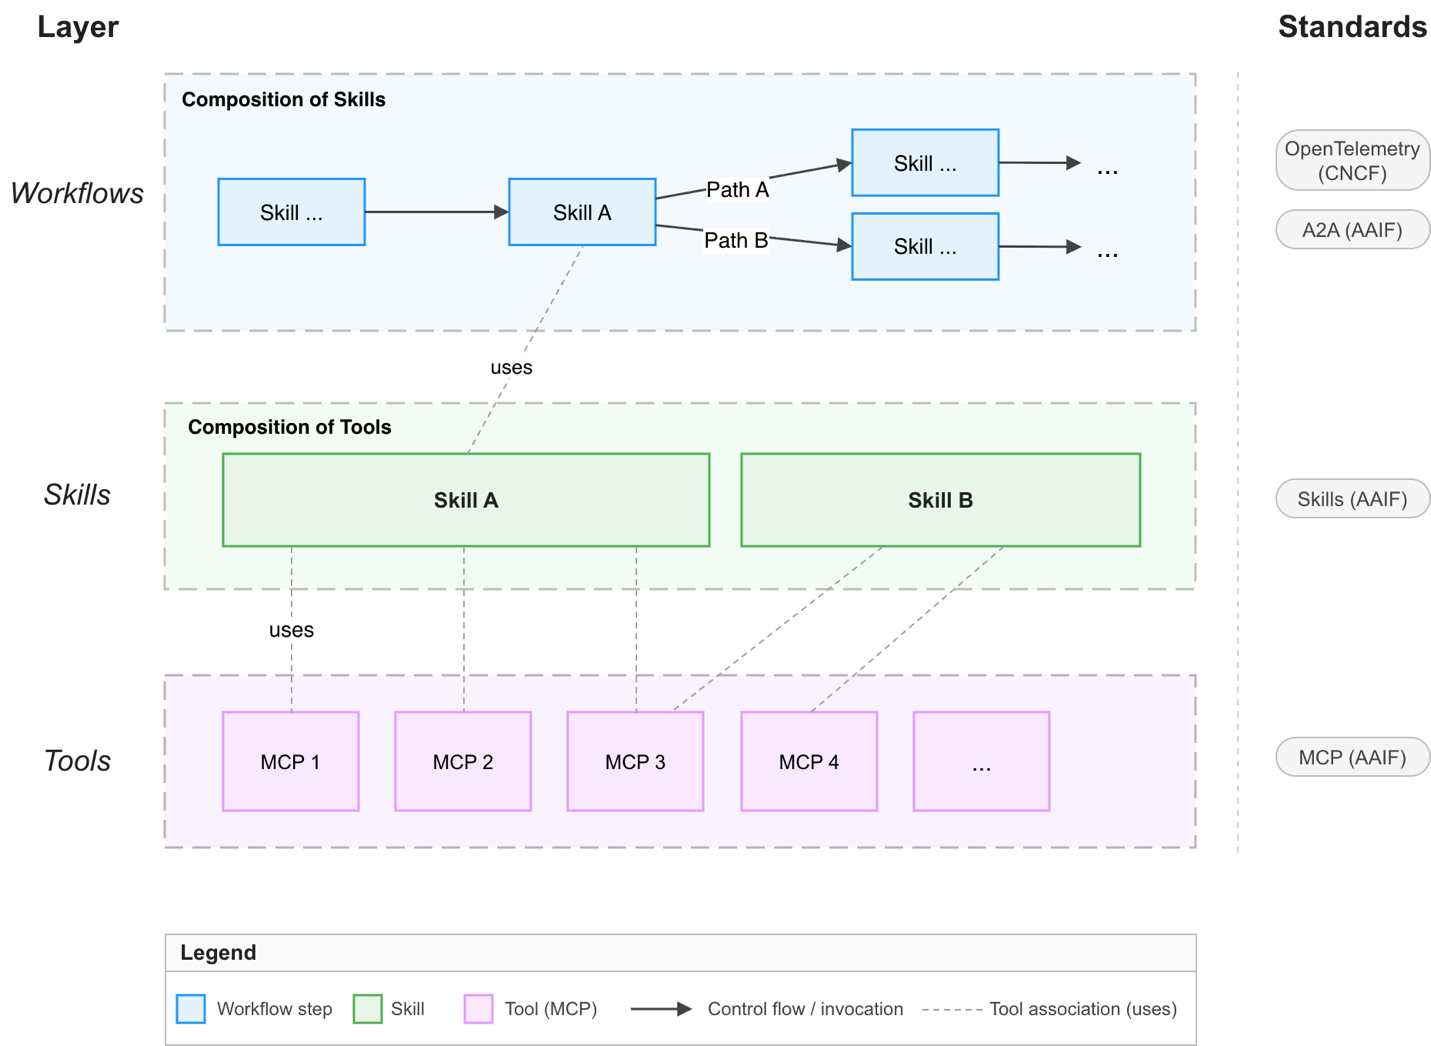
圖 1:用於建構可組合 Agent 的三層系統
在學習過程中逐步專門化
在正式環境中,即使範圍界定清晰的 Agent,也可能因實際使用情況偏離設計時的預期而失效:查詢模式轉變、工具選擇邏輯難以應對,效能亦會以難以預料的方式下降。
正確的做法是把複雜的 Agent 拆分成多個專門 Agent,讓每個 Agent 的指示更清晰、工具集更簡單、推理更聚焦。這樣做的好處很具體:
- 獨立演進:更新需求工程 Agent,毋須改動編碼 Agent。
- 可個別擴展:當範圍和介面界定清晰時,個別 Agent 可獨立擴展,無須重新部署或調整整體系統規模。
- 將影響範圍降至最低:一個 Agent 發生故障或產生幻覺,不會波及整個工作流程。
- 節省成本:範圍狹窄的 Agent 通常可使用較小型的模型,從而降低推理和託管成本。
可從兩個方面降低複雜度:
- Agent 內部:將能力拆分為技能,因為工具和少樣本示例每次呼叫時都會佔用上下文,同時降低準確度並增加成本。透過實證確定拆分粒度:合併 Agent 很少選用的技能,並拆分會因輸入不同而產生不同行為的技能。
- Agent 之間:若工作超出某個 Agent 的範疇,應透過 A2A 協定交由專門的同儕 Agent 處理,而非擴展現有 Agent。Agent 應提升能力,而非增加上下文。
重要的是,由於每個專門的 Agent 只能存取履行職責所需的資料和工具,這種架構有助從設計上落實最小權限原則;這是受監管行業的合規要求。
然而,要實現這些優點,Agent 必須能夠互相尋找並互通。為避免形成 AI 孤島,我們維護一個中央 Agent、工具和技能登錄庫。這個登錄庫具備以下功能:
- 探索機制:根據建置期間儲存的中繼資料,編目可用的 Agent、工具和技能。
- 管治檢查點:確認資產類型已獲批准投入生產使用,並保存審核記錄。
- 安全檢查點:在批准前執行自動安全檢查,例如檢查提示詞注入等問題。
- 去重保障:識別其他團隊已維護的同等功能,以免重複工作。系統會在登記時自動執行這項檢查,並在批准前標示重複項目。
透過程式碼化擴展
從管理個別 Agent 轉向管治整個 Agent 羣組,需要將 Agent 架構程式碼化。團隊使用 Terraform 或 AWS CloudFormation 等基礎架構即程式碼框架,以與管理任何生產系統同樣嚴謹的方式配置及管理 Agent 基礎架構:
- 精細的最小權限角色:按 Agent 或工具設定權限範圍。
- CI/CD 管線:在不同帳戶和地區進行一致且經驗證的部署;如測試失敗或指標惡化,系統會自動停止部署。
- 政策即程式碼:透過規則(例如 AWS Config、Open Policy Agent)掃描已部署的 Agent,檢查是否符合組織標準。
三者均作為管線閘門強制執行,並在登記前驗證,而非事後審核。
採用模式刻意採取自下而上,並由中央統籌管理。各團隊建立技能和 MCP 工具,以解決眼前問題。所有團隊都可透過登錄庫分享資產,作出貢獻。中央團隊會在 CI 管線中建立自動化管治檢查,以維持標準。為支援開發團隊並推動 shift-left,中央團隊亦會提供管治即程式碼模組等基礎元件。
這種平衡既避免由中央統一規定架構,也避免無人管理的實驗。因此,出現新的營運考量時,團隊可以擴展現有模式,而毋須重新設計架構。
在 Agent 生命週期中落實最佳做法
只有將架構模式和管治標準融入團隊在 Agent 建置及運作前後所使用的工作流程,這些模式和標準才會有效。
部署前
管治工作在編寫任何協調邏輯之前便已開始。團隊會獲提供參考架構模式,以及從註冊庫中選取的範例。這些預先驗證的藍圖涵蓋常見的 Agent 配置、工具整合模式及組合結構,既可加快開發,也能納入經驗證的預設設定。在任何內容進入正式環境之前,標準化的 CI/CD 控制措施會確保這些做法得到落實。圖 2 展示參考管線的四個階段,依次由左至右執行。
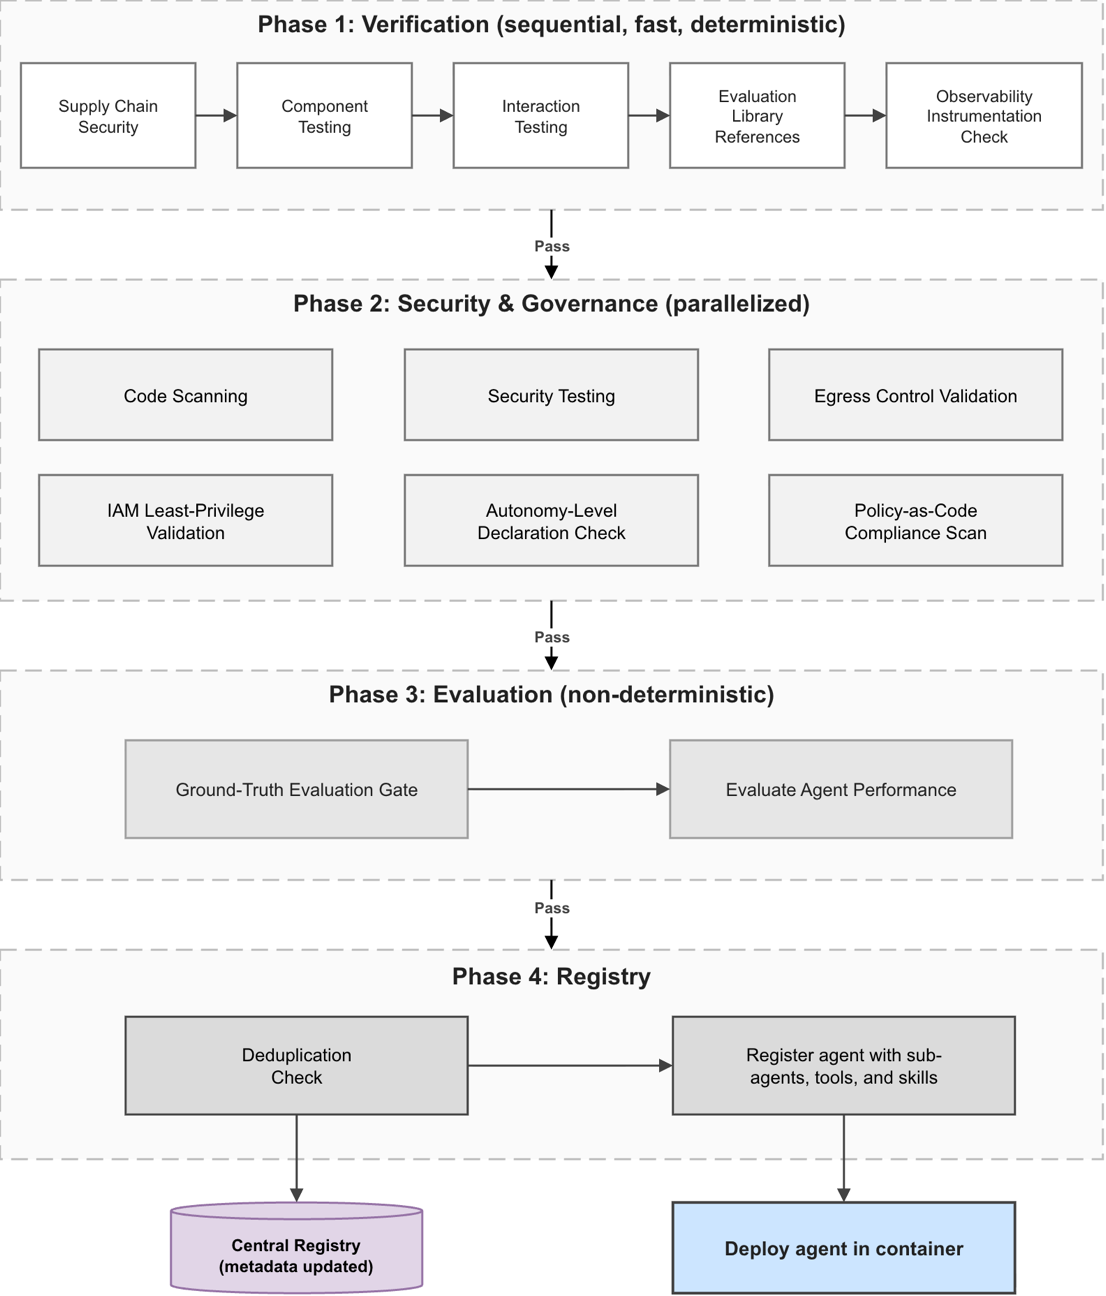
圖 2:四階段 Agent 部署管線的參考模式
圖 2 的 第 1 階段會快速執行確定性檢查:供應鏈安全(只允許使用已核准的登錄庫)、元件及互動測試、評估程式庫參照項目,以及可觀測性儀器配置。
第 2 階段會並行執行安全及管治檢查。靜態分析會掃描程式碼以找出問題,而安全測試則會在隔離的預備環境中測試 Agent。管線亦會驗證輸出流量控制及最低權限。另有兩項檢查會確認 Agent 宣告的自主程度與其實際權限相符,以及其配置符合政策即程式碼規則。治理 Agent 會將 Agent 與既定標準進行比對,並標示結果供人工審核,從而加快審計,例如:
- 範圍蔓延:超出原先界定的用途或權限。
- 提示詞膨脹:指示中存在不必要的複雜內容。
- 工具誤用:在預定用途以外呼叫工具。
- 效能下降:準確度、延遲或成本效益下滑。
圖 3:治理 Agent 工作流程範例
這項評估會提出具體且可即時採取行動的措施,讓團隊可以立即應用,而非只提供抽象建議。圖 3 展示治理 Agent 用於評估 Agent 成熟度的控制面板。治理 Agent 會提供證據和可行建議,而管治決策則由負責任的人員作出。建議須經人工確認後才會套用,以維持問責所需的四眼原則。評估結果會更新註冊庫中 Agent 的管治狀態,而完整詳情則會另行記錄於中央知識庫,以便審計和追蹤。
第 3 階段會評估正在執行的 Agent 系統:真實值評估關卡(根據設計階段制定的基準為輸出評分),以及 Agent 效能(延遲、Token 消耗量)。圖 4 詳細列出各項指標、評分準則及它們之間的關係。
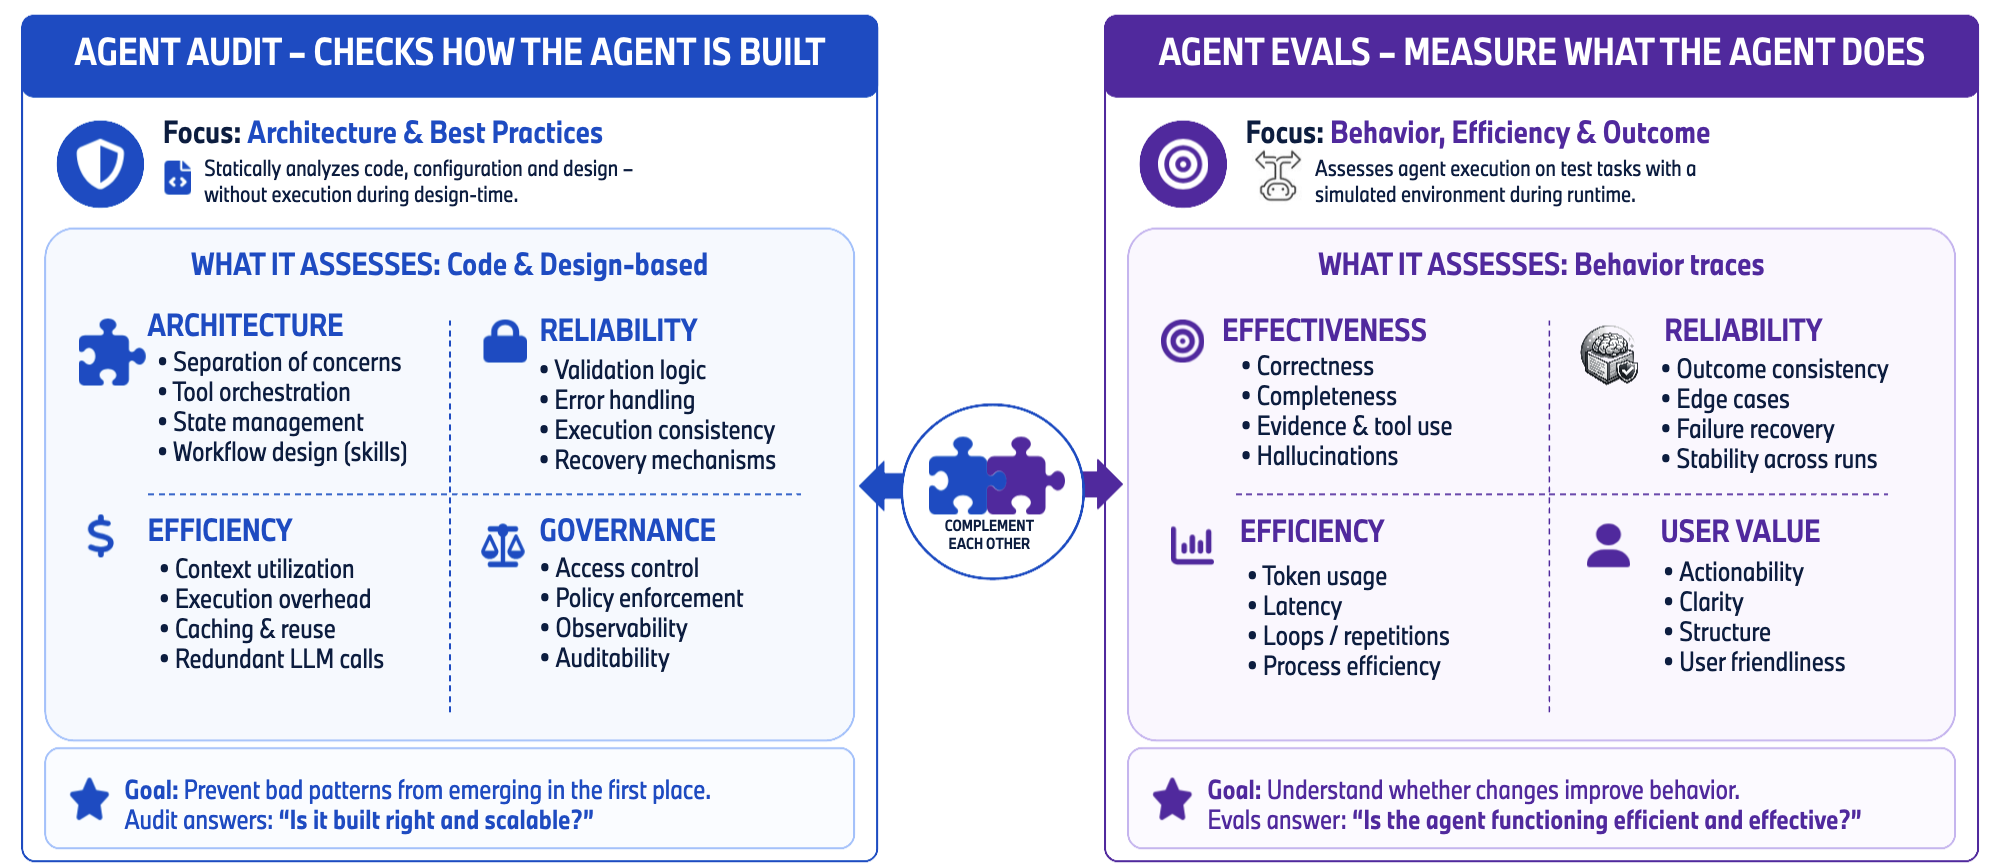
圖 4:評估指標概覽
第 4 階段會在註冊 Agent、其子 Agent、工具及技能之前檢查有否重複。下表列出註冊庫中每個 Agent 所儲存的中繼資料欄位。
| Agent 中繼資料 |
Core data:
|
Service level agreement data:
|
Data governance flags:
|
表 1:登錄庫中儲存的 Agent 中繼資料範例
若任何步驟失敗或指標惡化,部署程序便會停止,並保留日誌以供根本原因分析。若所有檢查均通過,Agent 便會封裝並以容器化工作負載形式部署,確保部署一致且可重現。這可防止未受治理的 Agent 進入生產環境、自動化合規檢查,並確保登錄庫資料準確。
執行時
在執行時,可觀測性必須捕捉兩類漂移。資料漂移會表現為用戶查詢模式出現新模式或變化,或上游 API 有所改動。模型漂移則會表現為錯誤率上升或工具選擇準確度下降。客戶標記某個回應時,也會觸發調查。若出現漂移、分佈變化、評估分數下降或客戶直接標記等情況,系統便會發出警示並分階段應對。這些事件會記錄下來,並轉交人工審核。此外,團隊可持續執行治理 Agent,標示漂移及營運問題,供相關團隊調查。
總結
大規模建構及營運 Agent 是一項工程實踐,而非實驗性工作。
有效的治理必須從一開始便融入架構、外置、因應領域而定,並以確定性方式執行。我們引入了三層組合階層(MCP 工具、技能及流程),作為建構可重用、可組合及可互通 Agent 的架構基礎,並將工作拆分給專門 Agent,以控制複雜程度和範圍。我們展示瞭如何在每次 CI/CD 執行中進行驗證及評估,令品質保證成為日常開發的一部分;亦展示瞭如何將 Agent 基礎架構定義為程式碼,讓團隊對整個 Agent 羣組中的每個 Agent 套用相同的治理規則。最後,我們將這些模式落實於 Agent 生命週期各階段,涵蓋預先驗證的參考架構、結構化管道,以及持續評估已部署 Agent 的執行時治理 Agent。
我們的經驗顯示,這些做法帶來多方面的效益。可重用範本和共用基礎架構降低了開發成本。標準互動模型和自動化部署亦讓團隊更快將 Agent 投入生產環境。由於管道在生命週期的每個階段強制採用經驗證的模式,品質亦有所提升。
在整個業界大規模推行 Agent 治理已刻不容緩。AI 及生成式 AI 支援的工作流程自動化,已開始重塑工程組織的運作方式。能夠勝出的,是那些超越實驗階段,並建立起大規模治理自主 Agent 網絡所需規範的組織。落實這些做法後,BMW 工程師便可專註解決重要問題:打造終極駕駛機器。
如要將這些理念應用於自己的 Agent,請先參考 AWS Well-Architected Framework。本文以此作為可重用 Agent 藍圖的範本。如要了解 BMW 如何在其 AWS 環境中制定管治標準,請閲讀 BMW Group 如何運用自動化,在 AWS 上大規模實現端到端合規。
展望及下一步
本文介紹的模式和實踐是基礎,而非終點。我們正積極從多方面加以拓展:
- 改善架構指引:發佈最佳實踐指南,説明架構取捨、組合模式及反模式,供建構 Agent 的團隊參考。
- 擴展基礎架構即程式碼範本:提供可用的 IaC 模組形式的 Agent 藍圖,並預設內置安全及管治標準。
- 深化管治合規測試:加入 CI/CD 測試案例,以驗證是否符合管治要求。
- 自動化標準執行:在部署前及執行階段擴展自動檢查和受管理的合規掃描規則。
- 拓展 Agentic FinOps:管治模型及工具呼叫的適當規模配置。
- Agent 用戶指引:將本文介紹的模式整合至 Archimedes(BMW 的架構指引 Agent),以提供符合情境的架構建議。
鳴謝
作者謹此向以下人士致謝(按英文字母順序排列):Alexander Stark、Alexander Zimmer、Dr. Céline Laurent-Winter、Dominik Segl、Florian Seidel、Hugo Lerias、Dr. Lars Lewerenz、Mark Neumann、Ralf Bottesch、Ramona Weber、Satish Vasireddy、Samuel Voss、Xagarey-Louis Meyer。
作者簡介

Dr. Jens Kohl
Jens 是 BMW Group 的科技領袖及實踐者,目前正共同領導一項 BMW 研發部門的 AI 計劃,旨在為超過 12,000 名工程師優化軟件 DevOps 工作流程。他曾領導軟件開發、機器學習及跨職能團隊超過 10 年,為數以百萬計的汽車打造正式環境 AI 解決方案,並優化服務全球 24M 輛 BMW 汽車的雲端後端。Jens 持有慕尼黑工業大學電腦科學博士及碩士學位,並定期透過技術網誌、演講及會議分享其工作成果。

Dr. Lukas Stappen
Lukas 是 BMW Group 生成式 AI 領域的科技領袖及實踐者。目前,他正推動 Agentic Software Development,為 BMW 的軟件工程師設計 Agent 工具及平台,以自動化軟件開發生命週期中的工作。他創立了 BMW Group Research 的 LLM Lab,並推出首個基於 LLM 的車載語音助理,部署於超過 100,000 輛汽車中。Lukas 持有奧格斯堡大學博士學位。

Dr. Martin Haubold
Martin 是 BMW Group 的企業架構師,專注於 AWS 和 Azure 上的 AI 管治及 Agent 架構。他專長於治理即程式碼、AI 安全,以及在 AWS 上建構雲端原生系統。此前,他曾花七年負責 BMW 自主運輸機械人平台背後的雲端基礎設施,並使用 Terraform、Helm 和 Kafka 管理正式環境的 Kubernetes 叢集。Martin 持有慕尼黑工業大學博士學位。

Dr. Veit Wenninger
Veit 是 BMW Group 的企業架構師及 Agentic 治理主管,負責為公司的未來 IT 架構制定方向。在過往職位中,他制定並擴展了 BMW Autonomous Driving Platform、BMW IoT Platform 及全球 Shopfloor Connectivity Platform。Veit 領導軟件開發團隊已有超過 10 年。他持有慕尼黑工業大學的 Ph.D. 學位。

Brendan Jones
Brendan 是 AWS 的資深解決方案架構師,負責與 BMW Group 合作。他協助汽車業客戶設計高度可擴展且具韌性的雲端架構,為業務帶來實際成效。他的工作涵蓋互聯汽車平台、開發人員生產力及成本優化。近期,他的工作範圍亦擴展至軟件開發生命週期各階段的 Agentic AI。Brendan 與 BMW 工程團隊緊密合作,從早期架構決策一直到正式投產。

Vadim Omeltchenko
Vadim 是一位資深 AI/ML 解決方案架構師,熱衷於協助 AWS 客戶在雲端創新。他過往的 IT 經驗主要來自本地部署環境。

Aishwarya Lakshmi Krishnan
Aishwarya 是 AWS Automotive 的首席客戶解決方案經理,工作範疇涵蓋業務與技術。她與客戶緊密合作,將複雜的業務挑戰轉化為優雅的技術方案,並推動方案落地,實現實際成效。她對新興技術和 AI 充滿熱忱,也同樣熱衷於用 LEGO 動手創作,以及探索太空相關的一切;她始終保持好奇,並熱愛探究事物的運作原理。
來源:AWS Machine Learning Blog · aws.amazon.com