蛋白質深度學習入門:遷移學習與摺疊預測
Deep Learning with Proteins
Hugging Face Blog 説明如何將語言模型的遷移學習應用於蛋白質序列,先以大量蛋白質序列預訓練,再遷移至摺疊和分類等任務。文章指出,ESMFold 類似 AlphaFold2,但執行時毋須外部資料庫或搜尋步驟。文中亦提供 PyTorch 和 TensorFlow 的蛋白質模型微調範例,以及目前僅支援 PyTorch 的 ESMFold 筆記本。
文章以語言模型遷移學習作類比,説明蛋白質序列預訓練如何延伸至摺疊及分類任務,並提供微調筆記本作實作起點。
我寫這篇文章時,心裏有兩類讀者:一類是想入門機器學習的生物學家,另一類是想了解生物學的機器學習從業者。如果你對生物學和機器學習都不熟悉,仍然歡迎閲讀,不過有些地方可能會令人困惑!如果兩方面你都已熟悉,這篇文章大概就不太需要看了;直接跳到我們的範例 notebook,看看這些模型的實際效果即可:
- 微調蛋白質語言模型(PyTorch、TensorFlow)
- 使用 ESMFold 摺疊蛋白質(目前只支援PyTorch,因為有
openfold相依項目)
給生物學家的引言:語言模型到底是甚麼?
處理蛋白質的模型深受 BERT 和 GPT 等大型語言模型啟發。要理解這些模型如何運作,我們不妨回到約 2016 年,也就是它們尚未出現的時候。Donald Trump 還未當選,Brexit 尚未發生,而深度學習(DL)是每天都打破紀錄、備受矚目的新技術。DL 成功的關鍵,在於使用人工神經網絡學習數據中的複雜模式。不過,DL 有一個重大問題:它需要大量數據才能運作良好,而許多任務根本沒有足夠數據。
假設你想訓練一個 DL 模型,以英文句子為輸入,判斷文法是否正確。你先整理訓練數據,內容如下:
| 文本 | 標籤 |
|---|---|
| 法官告訴陪審員要仔細思考。 | 正確 |
| 法官告訴説,陪審員要仔細思考。 | 不正確 |
| … | … |
理論上,當時完全可以完成這項任務:只要把這類訓練數據輸入 DL 模型,模型便能學會預測新句子的文法是否正確。但實際效果不太理想,因為在 2016 年,大多數人會為每項任務隨機初始化一個新模型。換言之,模型只能從訓練數據中的例子學會所需的一切!
要體會這有多困難,請想像自己是機器學習模型,而我正提供某項任務的訓練數據給你學習。內容如下:
| 文本 | 標籤 |
|---|---|
| Is í an stiúrthóir is fearr ar domhan! | 1 |
| Is fuath liom an scannán seo. | 0 |
| Scannán den scoth ab ea é. | 1 |
| D’fhág mé an phictiúrlann tar éis fiche nóiméad! | 0 |
我在這裏選了一種希望你從未見過的語言,因此你大概不太確定自己是否已學會這項任務。也許看過數百或數千個例子後,你會開始留意輸入中反覆出現的詞語或模式,並作出比隨機猜測更好的推斷;但即使如此,新詞或不尋常的措辭仍肯定會令你出錯。不巧的是,這大概就是當時 DL 模型的表現!
現在用英文再做一次相同任務:
| 文本 | 標籤 |
|---|---|
| 她是世界上最好的導演! | 1 |
| 我討厭這部電影。 | 0 |
| 這是一部極出色的電影。 | 1 |
| 我看了二十分鐘便離開戲院! | 0 |
現在就簡單了:任務只是預測影評是正面(1)還是負面(0)。只看兩個正面例子和兩個負面例子,你大概就能以接近 100% 的準確度完成任務,因為你早已具備大量英文詞彙和文法知識,以及電影和情感表達相關的文化背景。沒有這些知識,情況便會像第一項任務一樣:你必須讀過大量例子,才能開始察覺輸入中的表面模式;即使花時間研究數十萬個例子,猜測準確度仍遠不及只看四個英文例子後的表現。
關鍵突破:遷移學習
在機器學習中,我們把把既有知識轉移到新任務的概念稱為「遷移學習」。約在 2016 年,如何讓 DL 實現這種遷移學習,是整個領域的重要目標。截至 2016 年,已有預訓練詞向量(這很有趣,但超出本文範圍!)可把部分知識轉移到新模型;但這種知識轉移仍相當表面,模型要表現良好,依然需要大量訓練數據。
這種情況一直持續到 2018 年,當時有兩篇重要論文相繼發表,推出 ULMFiT 和其後的 BERT。這是首批成功讓自然語言遷移學習真正發揮效用的論文,而 BERT 尤其標誌着預訓練大型語言模型時代的開始。兩篇論文的共同訣竅,是善用深度學習人工神經網絡的內部結構:先用大量數據充足的文本任務長時間訓練神經網絡,再把整個神經網絡複製到新任務,只改動對應網絡輸出的少數神經元。
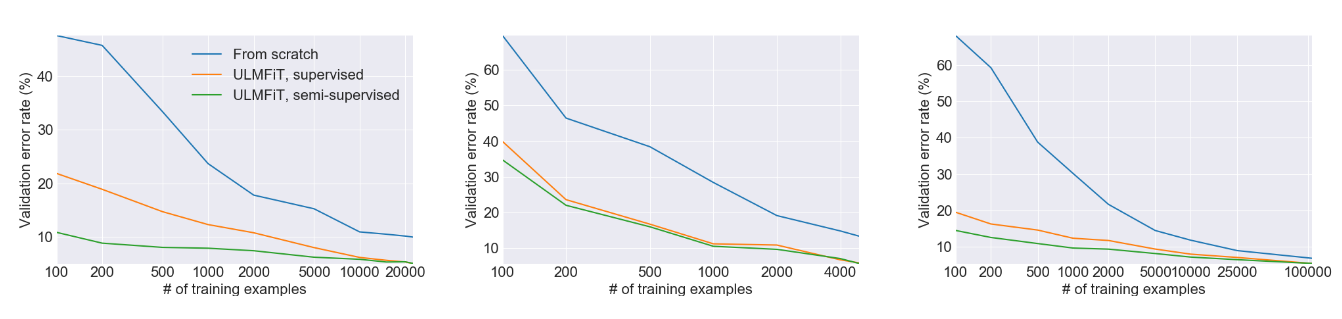
這張取自 ULMFiT 論文的圖,展示了在三項不同任務中使用遷移學習,相較從零開始訓練模型所帶來的巨大效能提升。許多情況下,遷移學習的表現相當於訓練數據多出 100 倍以上。別忘了這是 2018 年發表的成果;現代大型語言模型還可以做得更好!
這種方法奏效,是因為神經網絡在解決任何非簡單任務時,都會學到輸入數據的許多結構:視覺網絡根據原始像素學會辨認線條、曲線和邊緣;文本網絡則根據原始文本學會文法結構的細節。不過,這些資訊並非任務專屬;遷移學習之所以有效,關鍵在於解決任務所需的許多知識,並非該任務獨有!分類電影評論時,你不需要深入瞭解電影評論本身,但需要大量英文知識和文化背景。選擇一項訓練數據充足的任務,就能令神經網絡學會這類「領域知識」,之後再應用於我們關心、但訓練數據可能較難取得的新任務。
希望現在你已瞭解遷移學習,以及大型語言模型其實就是以大量文本數據訓練的大型神經網絡,因此很適合遷移至新任務。下文會介紹如何把相同技術應用於蛋白質;不過我先要為另一半讀者補上背景。已熟悉這部分的話,可以跳過下一節!
給機器學習從業者的引言:蛋白質到底是甚麼?
要用一句話概括整個學位課程:蛋白質負責許多工作。有些蛋白質是酵素,能催化化學反應。人體把營養轉化為能量時,從食物到肌肉活動的每個步驟,都由酵素催化。有些蛋白質則負責結構功能,提供穩定性和形狀,例如結締組織。你若看過美容產品廣告,大概見過膠原蛋白、彈性蛋白和角蛋白等名稱;它們都是構成皮膚和頭髮許多結構的蛋白質。
其他蛋白質對健康和疾病至關重要,想必大家都記得 COVID-19 病毒的刺突蛋白曾出現在無數新聞報道中。COVID 刺突蛋白會與人體細胞表面的 ACE2 蛋白結合,令病毒進入細胞並注入其 RNA。由於這種作用對感染至關重要,疫情期間,蛋白質及其交互作用的建模成為重要研究方向。
蛋白質由多個氨基酸組成。氨基酸是相對簡單的分子,具有共同的分子骨架;骨架的化學特性令氨基酸可以彼此連接,形成長鏈。關鍵是,氨基酸種類不多:標準氨基酸有 20 種;視乎生物種類,可能還有少數罕見、特殊的種類。蛋白質之所以有極大多樣性,是因為氨基酸可以按任何次序組合,形成形狀和功能大不相同的蛋白質鏈;鏈的不同部分會彼此黏合並摺疊。可以把文本當作比喻:英文只有 26 個字母,但想想用這 26 個字母可以組成多少不同內容!
事實上,氨基酸種類很少,因此生物學家可以為每種氨基酸指定一個獨特英文字母。這表示蛋白質可以像文本字串一樣書寫!例如,一條蛋白質鏈包含 Methionine、Alanine 和 Histidine。這些氨基酸的對應字母分別是 M、A 和 H,因此整條鏈可寫成「MAH」。不過,大部分蛋白質都含有數百甚至數千個氨基酸,而非只有三個!
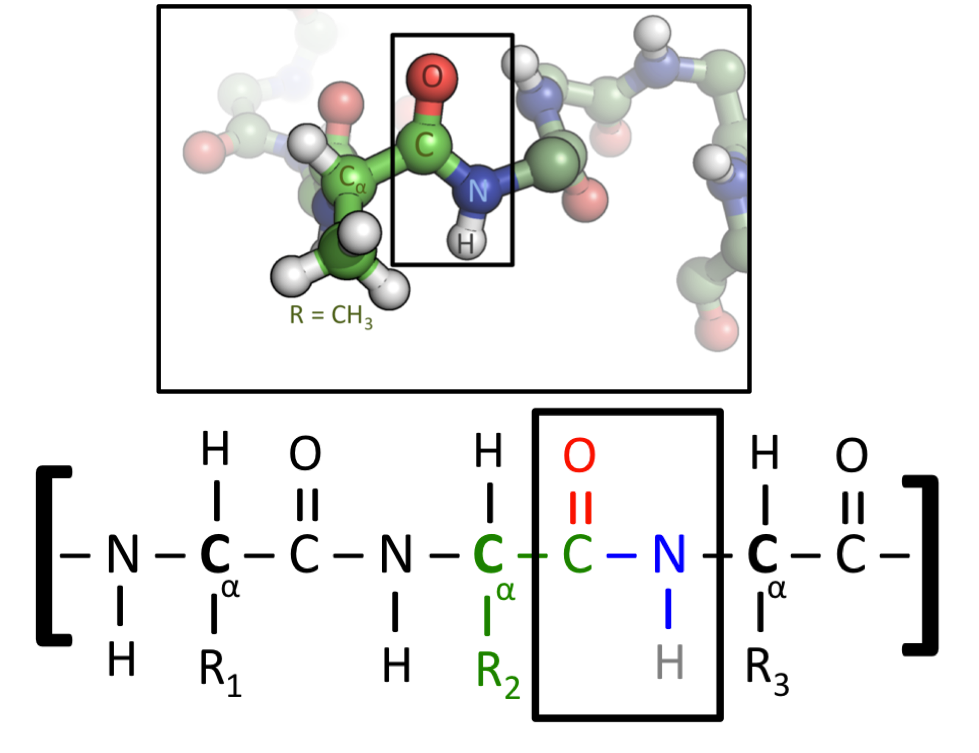
這張圖展示蛋白質的兩種表示方式。所有氨基酸都含有 Carbon-Carbon-Nitrogen 序列。氨基酸融合成蛋白質後,這種重複模式會延伸至整條蛋白質鏈,稱為蛋白質的「主鏈」。不過,氨基酸的「側鏈」各有不同;側鏈是連接在 C-C-N 主鏈上的原子。下圖以 R1、R2 和 R3 標示通用側鏈,代表任何一種氨基酸。上圖中,中央氨基酸的 CH3 側鏈表明它是 Alanine,以字母 A 表示。(圖片來源)

雖然可以把蛋白質寫成文本字串,但它們並非真正的「語言」,至少不是 Noam Chomsky 會認可的語言。不過,從機器學習角度來看,它們具備幾種類似語言的特性,因此與文本屬於相近領域:蛋白質是由有限小型字母表組成的長字串;理論上任何字串都可能出現,但實際上只有極少數字串「有意義」。隨機文本是亂碼,隨機蛋白質則只會形成沒有形狀的團塊。
此外,若只孤立地考慮蛋白質的一部分,也會遺失資訊;這就像從較長文本抽出單一句子閲讀,資訊同樣會流失。蛋白質某個區域可能只有在其他能穩定和修正其形狀的部分存在時,才會摺疊成自然形態!因此,要正確建模蛋白質,遠距交互作用非常重要,而全域自我注意力正好能有效捕捉這類交互作用。
讀到這裏,希望你已大致瞭解蛋白質是甚麼,以及生物學家為何如此重視蛋白質。儘管氨基酸「字母表」很小,蛋白質的結構和功能卻千變萬化;只看氨基酸「字串」便能理解和預測其結構與功能,將會是極有價值的研究工具。
融會貫通:蛋白質機器學習
現在我們已瞭解語言模型的遷移學習方式,也認識了蛋白質。有了這些背景,下一步並不困難:把相同的遷移學習概念應用於蛋白質即可!我們不再以英文文本任務預訓練模型,而是以蛋白質作為輸入,選擇訓練數據充足的任務進行訓練。完成後,希望模型已學到大量蛋白質結構知識,就像語言模型學會許多語言結構一樣。因此,預訓練蛋白質模型非常適合遷移至各種蛋白質相關任務!
生物學家關心哪些蛋白質機器學習任務?最廣為人知的是蛋白質摺疊:給定類似「MLKNV…」的氨基酸鏈,預測蛋白質最終會摺疊成甚麼形狀。這項任務極其重要,因為準確預測蛋白質形狀和結構,有助深入瞭解蛋白質的功能及其運作方式。
早在現代機器學習出現之前,人們已研究這個問題;Folding@Home 等早期大型分散式運算計劃,運用驚人的空間和時間精度進行原子層級模擬,研究蛋白質摺疊。此外,還有整個蛋白質晶體學領域,透過 X 射線繞射觀察從活細胞分離出的蛋白質結構。
不過,與許多其他領域一樣,深度學習的出現改變了一切。AlphaFold,尤其是 AlphaFold2,運用 Transformer 深度學習模型並加入多項蛋白質專用功能,只根據原始氨基酸序列便能出色地預測新蛋白質結構。如果你對蛋白質摺疊感興趣,我們強烈建議查看ESMFold notebook。ESMFold 是類似 AlphaFold2 的新模型,但它更接近「純」深度學習模型,執行時不需要外部數據庫或搜尋步驟。因此,設定過程簡單得多,模型執行速度也快得多,同時仍保有出色準確度。
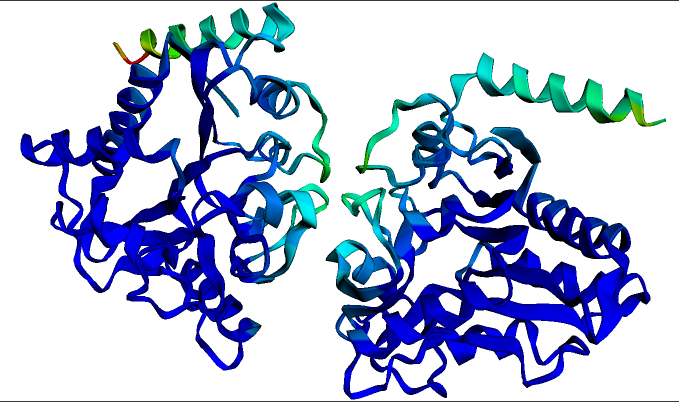
圖中顯示同源二聚體 P. multocida 蛋白質 Glucosamine-6-phosphate deaminase 的預測結構。使用上方連結的 ESMFold notebook,只花數秒便生成此結構和視覺化結果。較深的藍色代表結構信心度最高的區域。
蛋白質摺疊並非唯一有趣的任務!生物學家還可能想對蛋白質進行多種分類,例如預測蛋白質會在細胞哪個部分運作,或預測蛋白質生成後,哪些氨基酸會接受特定修飾。在機器學習中,若要分類整個蛋白質(例如預測其亞細胞定位),這類任務稱為序列分類;若要分類每個氨基酸(例如預測哪些氨基酸會接受轉譯後修飾),則稱為token 分類。
最重要的結論是,蛋白質雖與語言十分不同,幾乎完全相同的機器學習方法仍可用於兩者:先在大型蛋白質序列數據庫上進行大規模預訓練,再透過遷移學習應用至多種感興趣的任務;這些任務的訓練數據可能稀少得多。某些方面甚至比 BERT 等大型語言模型簡單,因為蛋白質不需要複雜的詞語切分和解析:蛋白質沒有「詞語」界線,因此最簡單的方法是將每種氨基酸轉換成一個輸入 token。
聽起來不錯,但我不知道從何入手!
如果你已熟悉深度學習,會發現微調蛋白質模型的程式碼與微調語言模型的程式碼非常相似。我們提供 PyTorch 和 TensorFlow 範例 notebook,歡迎查看;你亦可從 UniProt 等開放蛋白質數據庫取得大量已標註數據。這些數據庫提供 REST API 和易用的網頁介面。你最大的難題可能是尋找有趣的研究方向,這超出本文範圍;不過我相信有許多生物學家樂意與你合作!
另一方面,如果你是生物學家,可能已想到幾個想嘗試的方向,但會有點卻步,不敢深入機器學習程式碼。別慌!我們設計的範例 notebook(PyTorch、TensorFlow)把數據載入部分設計得相當獨立。因此,只要你想處理序列分類或token 分類任務,就只需建立蛋白質序列清單及相應標籤清單,再以任何可載入或生成這些清單的程式碼,替換我們的數據載入程式碼即可。
連結中的範例使用 ESM-2 作為基礎預訓練模型,因為它是目前最先進的模型。不過,業界人士可能也熟悉 Rost lab;該實驗室早期推出的同類模型包括 ProtBERT(論文連結),並受到生物資訊學社羣熱烈關注。只要將 checkpoint 路徑由 facebook/esm2... 改成類似 Rostlab/prot_bert 的路徑,就能把連結範例中的大部分程式碼改為使用 ProtBERT。
總結
深度學習與生物學的交集,未來幾年將會是非常活躍且成果豐碩的領域。不過,深度學習之所以能快速發展,其中一個原因是研究人員可以迅速重現結果,並調整新模型供自己使用。秉持這個精神,如果你訓練出對社羣有用的模型,請分享出來!上方連結的 notebook 附有將模型上載至 Hub 的程式碼,其他研究人員可免費存取並在此基礎上繼續研究。這不但有助推進領域發展,也能提高相關論文的曝光度和引用數。你甚至可以使用 Spaces 建立即時網頁示範,讓其他研究人員輸入蛋白質序列並免費取得結果,完全無須編寫程式碼。祝你好運,願 Reviewer 2 對你手下留情!
來源:Hugging Face Blog · huggingface.co