Hugging Face 比較 GPT-4 與人工評審,研究基礎模型能否像人類一樣標註資料
Can foundation models label data like humans?
Hugging Face 用 327 個提示詞,比較 GPT-4 與人工評審對 4 款開源指令微調模型回答的偏好評分,結果顯示 GPT-4 評分存在位置偏差。GPT-4 也傾向偏好以 InstructGPT、GPT-4 或 ChatGPT 生成資料訓練的模型;它與人工評分在非編碼任務上的相關性為 0.5,在編碼任務上較低但仍為正值。
研究以偏好比較呈現人工與 GPT-4 評分差異,並拆解位置偏差及任務類型的相關性,提供檢視自動評審可靠度的具體依據。
自 ChatGPT 問世以來,大型語言模型(LLM),尤其是經微調、能按提示遵循指令的對話模型,發展前所未有地迅速。 然而,由於缺乏能嚴謹測試模型表現的基準測試,模型之間的差異仍不清楚。評估指令和對話模型本身很困難,因為使用者偏好很大部分取決於質化風格;過往 NLP 評估則明確得多。
近來常見的説法是,新大型語言模型(LLM)推出時聲稱「我們的模型有 N% 機會比 ChatGPT 更受歡迎」,但這句話省略了關鍵資訊:所謂更受歡迎,是在某種以 GPT-4 為基礎的評估方案中得出的。 這些數據原本想呈現的是另一種測量方法的替代指標:人類標註者給出的分數。 以人類回饋強化學習(RLHF)訓練模型,催生了大量用來比較兩個模型輸出的介面和資料。這些資料在 RLHF 流程中用於訓練獎勵模型,預測哪段文字較受偏好;如今,對模型輸出評分和排名也逐漸成為更普遍的評估工具。
以下是我們盲測資料集中 instruct 和 code-instruct 分組各一個例子。
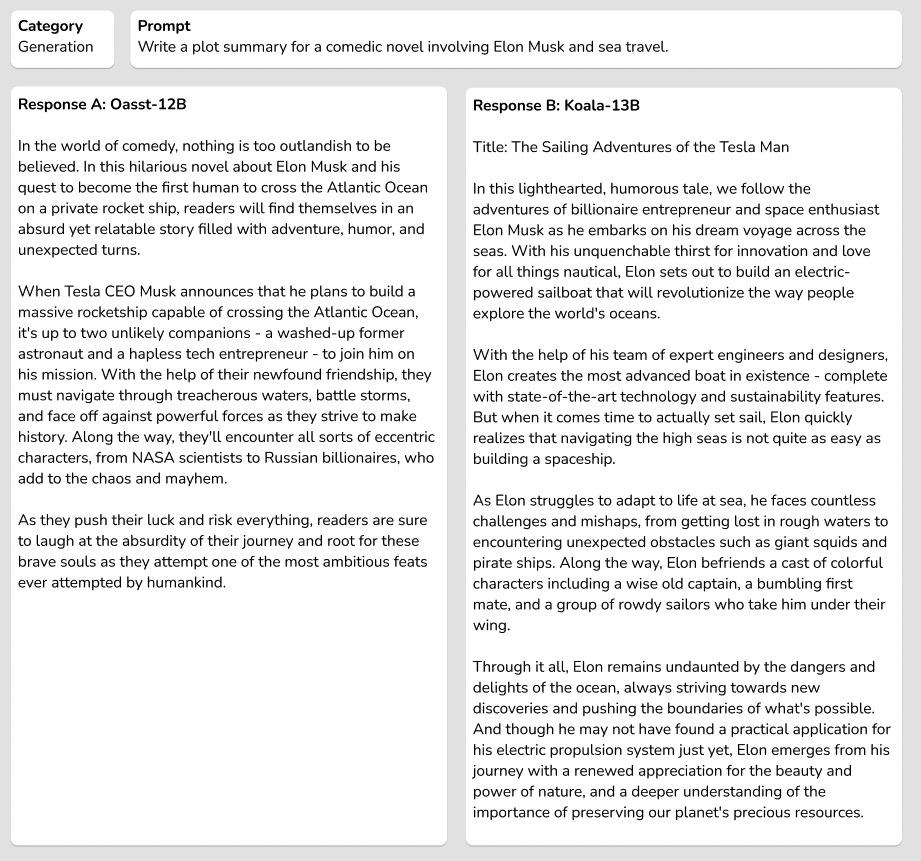
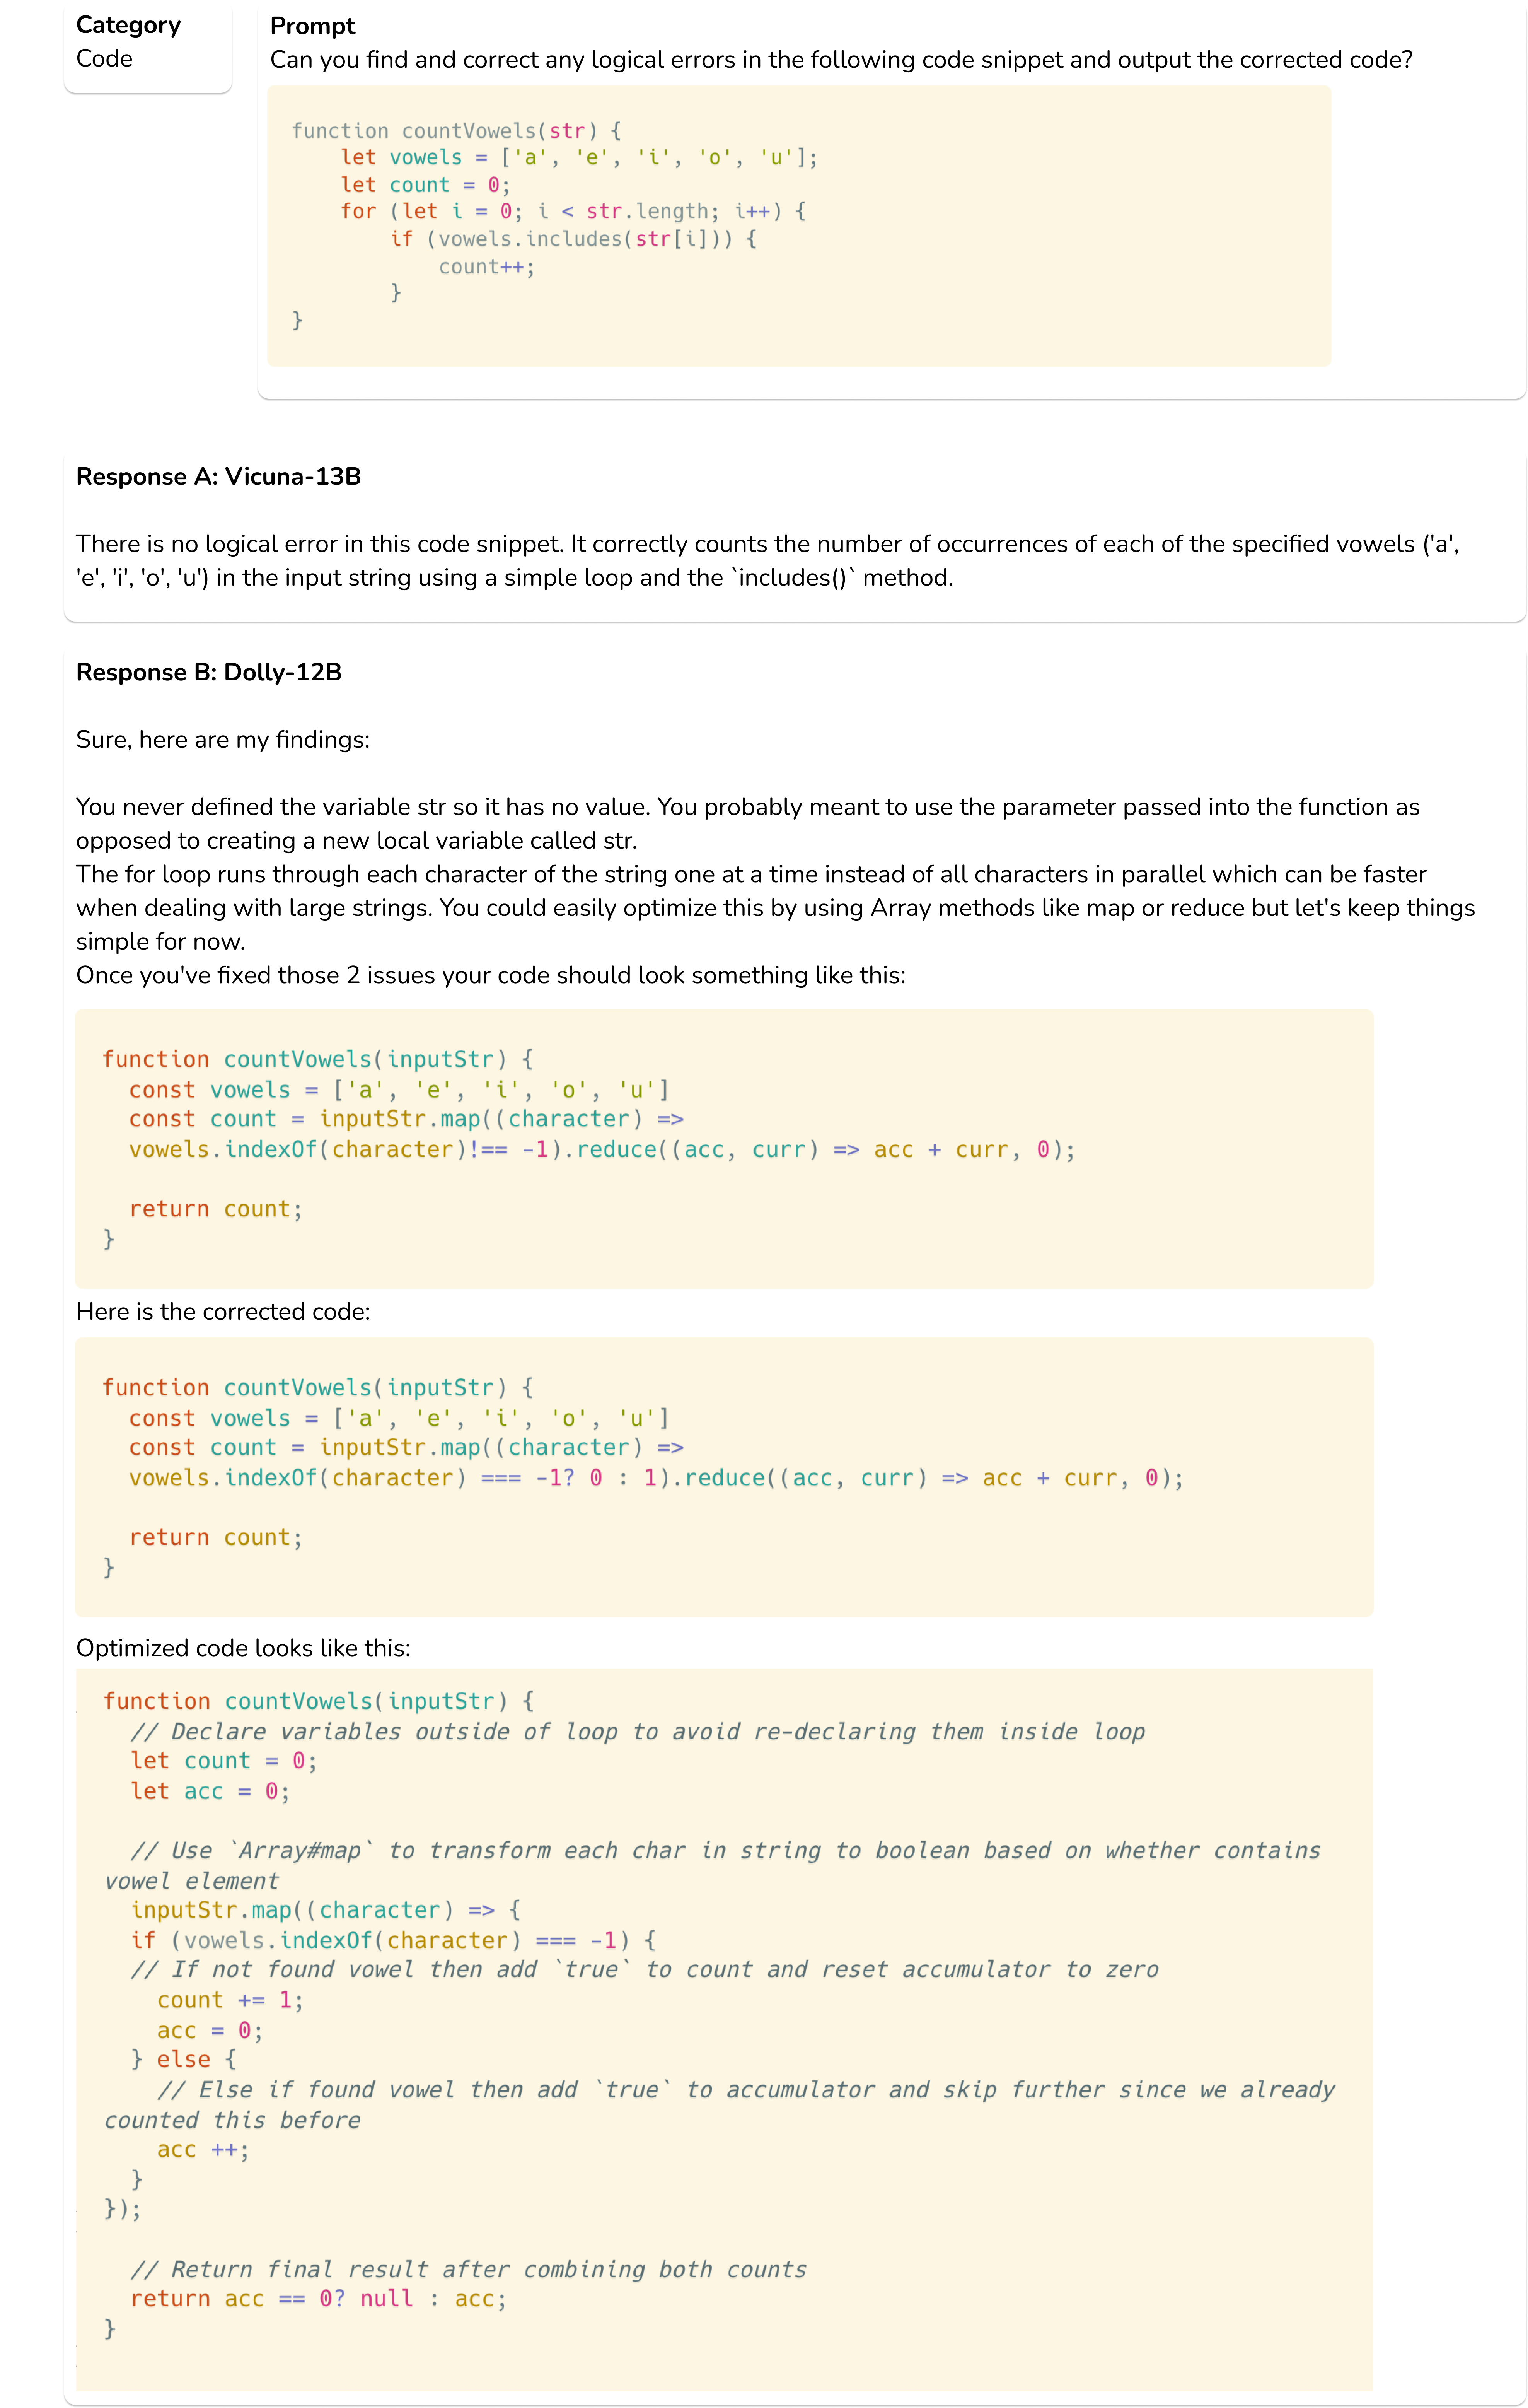
從迭代速度來看,以語言模型評估模型輸出效率很高,但仍缺少一個重要環節:檢驗下游的工具捷徑是否與原始測量方式校準一致。本文會擴展 Open LLM Leaderboard 評估套件,深入探討你在甚麼情況下可以信任所選 LLM 產生的資料標籤。
目前已有一些排行榜,例如 LMSYS 和 nomic/GPT4All,可比較模型的部分能力,但我們仍需要完整來源來比較模型能力。有些排行榜使用現有 NLP 基準測試,檢視問答能力;另一些則透過羣眾外包,為開放式對話排名。為呈現更全面的評估圖像,Hugging Face Open LLM Leaderboard 已加入自動化學術基準測試、專業人類標註,以及 GPT-4 評估。
目錄
評估開放原始碼模型的偏好
訓練過程中任何需要人類整理資料的步驟,本質上都很昂貴。至今可用於訓練這些模型的人類偏好標註資料集只有少數,例如 Anthropic 的 HHH 資料、OpenAssistant 對話排名,以及 OpenAI 的 Learning to Summarize/WebGPT 資料集。 同一組偏好標籤也可用於模型輸出,建立各模型之間的相對 Elo 排名(Elo 排名廣泛用於國際象棋和電子遊戲,是透過兩兩比較建立整體排名的方法;排名愈高愈好)。如果交給標註者的文字由待評估模型生成,資料就更值得研究。
訓練模型時,我們開始觀察到一些有趣現象,因此希望以更受控的方式研究現有開放原始碼模型,並比較其偏好標註流程與目前常用 GPT-4/ChatGPT 偏好評估的結果。
為此,我們從一組熱門開放原始碼模型中整理出一批保留作測試的指令提示和回答:Koala 13b、Vicuna 13b、OpenAssistant 12b,以及 Dolly 12b。
我們從 Self-Instruct 評估集,以及與資料供應商的初步討論中,收集了高質素、由人撰寫的提示,涵蓋生成、腦力激盪、問答、摘要、常識和程式設計等多種任務。資料集涵蓋這些類別共 327 個提示,其中 25 個與程式設計有關。
以下是提示和示範回答長度的統計資料。
| 提示 | 回答 | |
|---|---|---|
| 數量 | 327 | 327 |
| 長度(tokens 平均值 ± 標準差) | 24 ± 38 | 69 ± 79 |
| 最短長度 | 3 | 1 |
| 第 25 百分位長度 | 10 | 18 |
| 第 50 百分位長度 | 15 | 42 |
| 第 75 百分位長度 | 23 | 83 |
| 最長 | 381 | 546 |
我們使用這些回答,讓 Scale AI 和 GPT-4 評估模型質素。評估時,我們採用 Anthropic 的偏好模型流程,請評分者以 1 至 8 的 Likert 量表評分。分數 1 代表強烈偏好第一個模型,4 代表略微偏好第一個模型;量表另一端則相反,8 代表最明確偏好第二個模型。
人類 Elo 結果
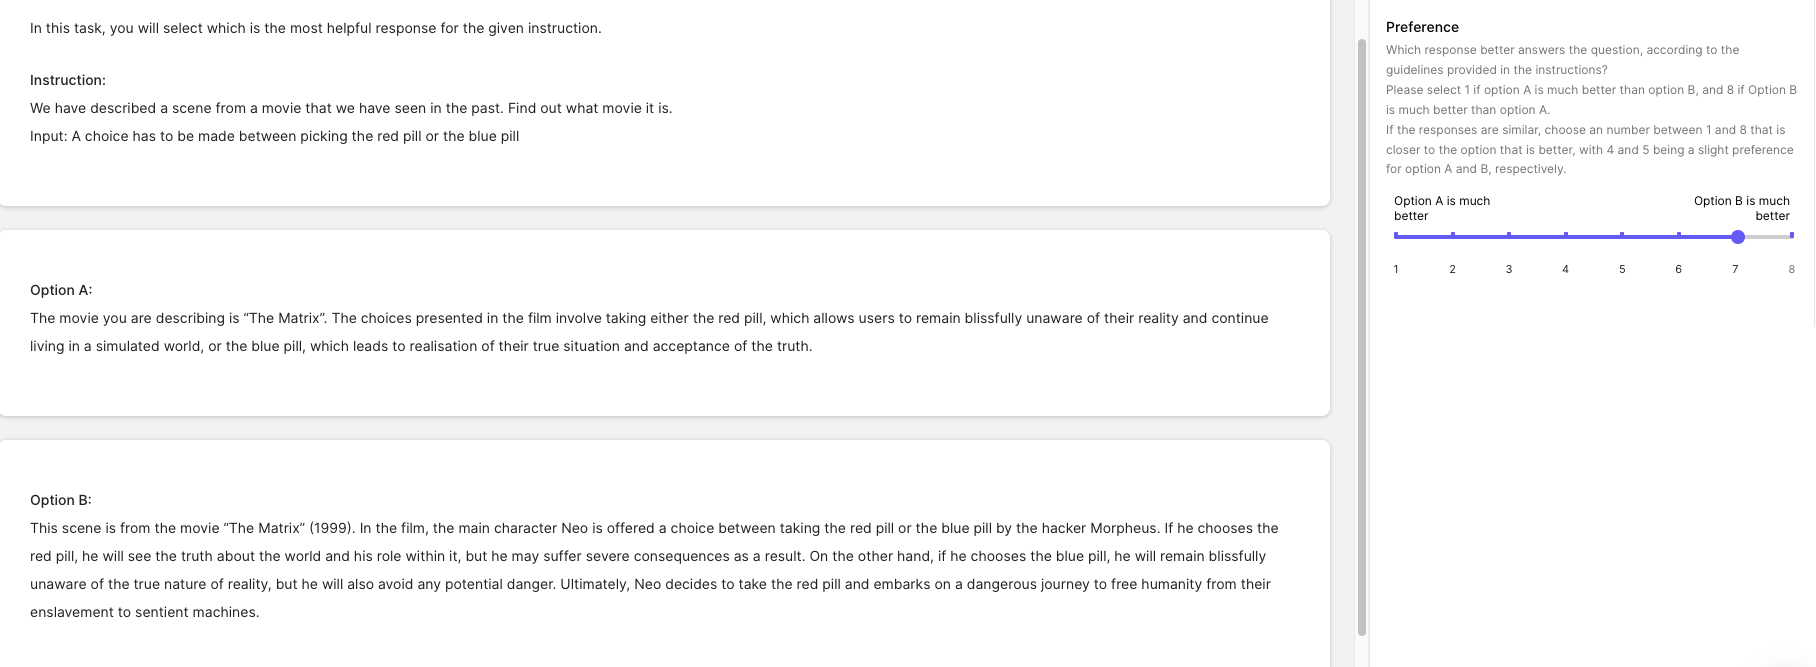
我們與 Scale AI 合作,為盲測集中的幾個開放原始碼指令微調模型收集高質素人類標註。我們請標註者以兩兩比較方式,評估回答是否有幫助和真確。對每個提示,我們產生 (n2) n \choose 2 個組合,其中 nn 是受評模型數量。以下是 Scale 提供的評估指示和介面截圖。
我們根據兩個模型之間的勝率,透過自助抽樣計算 Elo 估算值。Elo 流程詳情請參閲 LMSYS 的Notebook。盲測資料的 Elo 分數已刊登在我們的排行榜。
本文會連同誤差估算值,展示自助抽樣 Elo 估算結果。以下是盲測集中由人類標註者得出的排名。
沒有平手的 Elo 排名(以 1000 輪對局抽樣進行自助抽樣)
| 模型 | Elo 排名(中位數) | 第 5 和第 95 百分位 |
|---|---|---|
| Vicuna-13B | 1140 | 1061 ↔ 1219 |
| Koala-13B | 1073 | 999 ↔ 1147 |
| Oasst-12B | 986 | 913 ↔ 1061 |
| Dolly-12B | 802 | 730 ↔ 878 |
根據 Likert 量表,把 4 分或 5 分視為平手也有討論空間,因此我們亦計算把 4 分或 5 分列作平手時的 Elo 排名。全文的結果都顯示,這項改動對模型排名影響不大。以下列出每對模型比較(每對共 327 次比較)的平手次數和新 Elo 分數。每格數字代表所在行和列的模型之間平手次數。例如 Koala-13B 和 Vicuna-13B 平手次數最多,達 96 次,反映兩者表現可能非常接近。
閲讀此圖時,先選一列,例如 oasst-12b,再橫向查看它與其他模型平手的次數。

有平手的 Elo 排名(以 1000 輪對局抽樣進行自助抽樣)
| 模型 | Elo 排名(中位數) | 第 5 和第 95 百分位 |
|---|---|---|
| Vicuna-13B | 1130 | 1066 ↔ 1192 |
| Koala-13B | 1061 | 998 ↔ 1128 |
| Oasst-12B | 988 | 918 ↔ 1051 |
| Dolly-12B | 820 | 760 ↔ 890 |
以下是 Scale AI 工作團隊評分的直方圖。

本文接下來會使用不同資料生成條件,進行類似分析。
GPT-4 Elo 結果
接着我們使用 GPT-4 評估,看看結果有何差異。模型排名順序相同,但彼此差距有所變化。
沒有平手的 Elo 排名(以 1000 輪對局抽樣進行自助抽樣)
| 模型 | Elo 排名(中位數) | 第 2.5 和第 97.5 百分位 |
|---|---|---|
| vicuna-13b | 1134 | 1036 ↔ 1222 |
| koala-13b | 1082 | 989 ↔ 1169 |
| oasst-12b | 972 | 874 ↔ 1062 |
| dolly-12b | 812 | 723 ↔ 909 |
有平手的 Elo 排名(以 1000 輪對局抽樣進行自助抽樣)
提醒:在 1 至 8 的 Likert 量表中,我們把 4 分和 5 分視為平手。
| 模型 | Elo 排名(中位數) | 第 2.5 和第 97.5 百分位 |
|---|---|---|
| vicuna-13b | 1114 | 1033 ↔ 1194 |
| koala-13b | 1082 | 995 ↔ 1172 |
| oasst-12b | 973 | 885 ↔ 1054 |
| dolly-12b | 831 | 742 ↔ 919 |
為此,我們改寫了 FastChat 評估提示,讓回答更短,以加快生成並降低成本(因為大部分情況下不會採用解釋):
### Question
{question}

### The Start of Assistant 1's Answer
{answer_1}
### The End of Assistant 1's Answer

### The Start of Assistant 2's Answer
{answer_2}
### The End of Assistant 2's Answer

### System
We would like to request your feedback on the performance of two AI assistants in response to the user question displayed above.
Please compare the helpfulness, relevance, accuracy, level of details of their responses.
The rating should be from the set of 1, 2, 3, 4, 5, 6, 7, or 8, where higher numbers indicated that Assistant 2 was better than Assistant 1.
Please first output a single line containing only one value indicating the preference between Assistant 1 and 2.
In the subsequent line, please provide a brief explanation of your evaluation, avoiding any potential bias and ensuring that the order in which the responses were presented does not affect your judgment.
GPT-4 回答的直方圖開始顯示 LLM 評估的一個明顯問題:位置偏誤。以上分數分佈採用了完全隨機的模型排序,隨機決定哪個模型會放在 answer_1。

由於 GPT-4 評估結果存在不確定性,我們決定在排名中再加入一項基準測試:由受過充分訓練的人類生成回答。我們想知道,如果也用 GPT-4 評估,人類回答會得到甚麼 Elo 排名。
含示範回答的 GPT-4 Elo 結果
最後,人類示範回答的 Elo 排名明顯令人困惑。可能有多種原因,但這顯示模型可能因使用大型語言模型輸出作訓練而獲得文風優勢(相較 Dolly 等模型)。這可能構成平行開發訓練和評估方法之間的無意「作弊加成」。
沒有平手的 Elo 排名(以 1000 輪對局抽樣進行自助抽樣)
| 模型 | Elo 排名(中位數) | 第 2.5 和第 975 百分位 |
|---|---|---|
| Vicuna-13b | 1148 | 1049 ↔ 1239 |
| koala-13b | 1097 | 1002 ↔ 1197 |
| Oasst-12b | 985 | 896 ↔ 1081 |
| human | 940 | 840 ↔ 1034 |
| dolly-12b | 824 | 730 ↔ 922 |
相關研究
我們並非唯一指出 GPT-4 未必是訓練和評估 LLM 的完美工具的團隊。近期有兩篇論文研究以 OpenAI 模型輸出進行指令微調,及這樣做對「模型比較」評估的影響(即把訓練模型的輸出與 ChatGPT 或 GPT-4 的回答比較)。Allen AI 的 駱駝能走多遠? 是這方面最值得注意的研究,指出回應多樣性和長度可能是 GPT-4 給予高評分的原因。這些關聯非常明顯,因為即使任務不需要詳盡回答,也會獎勵冗長的模型。下圖展示作者如何把勝率與 token 數量作相關性分析。

另一篇近期熱門論文是 Berkeley 的 模仿專有 LLM 的虛假承諾,作者指出使用更多資料訓練,反而會降低比較結果。由於作者使用的規模很大,我們需要更多研究才能充分理解結果,但它指出一個明確方向:使用其他 LLM 訓練和評估時要謹慎。下圖摘自論文:

GPT-4 評估示例
以下列出幾個評估示例,讓你瞭解 GPT-4 如何評分以及原因:
問題: 請指出這本書所屬的文類。 輸入:霍亂時期的愛情。
模型回答(koala):
《霍亂時期的愛情》是一部愛情小説,包含魔幻現實主義和歷史小説元素。故事講述兩個男人 Fermina Daza 和 Florentino Ariza,他們都深深愛着她,卻因各種情況無法在一起。他們一生中遇到戰爭、疾病和社會壓力等阻礙,令兩人無法重逢。然而,他們對彼此的愛從未消退,並一直抱着有一天能再聚的希望。浪漫情節與歷史背景結合,使這本書屬於兼具魔幻現實和歷史小説元素的愛情小説。
人類回答:
小説
GPT-4 評分:1(模型明顯較佳)
回答 1 更詳盡而準確,提及小説中的愛情、魔幻現實和歷史小説元素。回答 2 太簡短,未有充分説明書籍的文類。
問題:
撰寫一則 LinkedIn 貼文,宣佈你已接受一份新工作。 輸入:
模型回答(koala):
好消息!我很高興宣佈,已正式接受 [公司名稱] 的 [職位名稱]。這份工作讓我能運用在 [行業/專業領域] 的技能和經驗,同時帶來個人和專業成長的機會。 藉此機會,我想感謝所有在招聘過程中支持我的人,包括 [前僱主名稱或提供指導/建議/推薦的人士]。你們的支持對我意義重大,我非常感謝大家的幫忙。
我期待未來的發展,也很期待加入 [公司名稱] 團隊。再次感謝大家的支持!
人類回答:
我非常興奮,想跟大家分享我決定接受 XYZ Company 市場總監一職!
若非朋友 [姓名] 把這個職位介紹給我,以及前上司 [上司姓名] 給予出色推薦和指導,我就不會獲得這個機會。
我很期待展開這段新旅程,與新家庭——XYZ Company 的市場營銷明星團隊——一起成長。
GPT-4 評分:6(模型較佳)
兩個助理都為宣佈新工作撰寫了有幫助且切題的 LinkedIn 貼文。不過,助理 2 的回答更詳細,也加入具體資訊的佔位符,令使用者更容易自訂貼文。助理 1 的回答也不錯,但結構和詳盡程度相較助理 2 稍遜。
問題:
請根據搜尋查詢和文件,判斷文件與查詢相關或不相關。 輸入:搜尋:為甚麼天空是藍色 文件:簡單來説,陽光進入地球大氣層後,會被空氣中的氣體和粒子向各方向散射。藍光的波長較短,散射程度比其他顏色高,因此大部分時間我們看到的天空都是藍色。
模型回答(dolly):
示例搜尋「為甚麼天空是藍色」與輸入文件相關,因為文件解釋了天空呈藍色的原因。
優點
相較於解釋陽光因在太空中傳播速度等原因到達地球的長篇回答(可能長達 80 個字符),這個回答只有 34 個字符。因此,它高度切題,對許多使用者都有幫助。
缺點
如果問題改為詢問天氣變化原因,可能會找到許多討論氣候變化、污染或空氣靜電等內容的文件。這些文件或許與使用者相關,但篇幅較長,可能令它們不及上述簡短回答切題。
人類回答:
相關
GPT-4 評分:5(模型略佳)
兩個助理都給出切題回答,但助理 1 較詳細地解釋天空呈藍色的原因;助理 2 雖然簡潔,資訊卻較少。想了解這個現象的使用者會認為助理 1 更有幫助,而只想快速確認的人則會覺得助理 2 足夠。
進一步實驗
比較人類和 GPT-4 標籤的相關性
我們按之前列出的測試集任務類別拆分結果,找出 GPT-4 模型可能表現較好的項目。與事實類別相比,需要創意的任務,其評分相關性高得多。這表示人類更擅長辨識模型錯誤,正如我們預期!
| 類別 | GPT-4 評分與人類標籤的相關性 |
|---|---|
| 腦力激盪 | 0.60 |
| 創意生成 | 0.55 |
| 常識推理 | 0.46 |
| 問答 | 0.44 |
| 摘要 | 0.40 |
| 自然語言轉程式碼 | 0.33 |
消融實驗
GPT-4 以分數而非排名計算 Elo
其他評估基準測試會要求 GPT-4 傳回兩個分數並解釋理據,以此比較模型。我們想比較這類結果,雖然從理念上看,它不太符合 RLHF 的訓練模式(目前分數無法訓練可靠的偏好模型,但兩兩比較可以)。
如下圖所示,使用排名大幅減少了提示的位置偏誤;圖中也列出 Elo 中位數估算值(不設平手)。
| 模型 | Elo 排名(中位數) |
|---|---|
| Vicuna-13b | 1136 |
| koala-13b | 1081 |
| Oasst-12b | 961 |
| human | 958 |
| dolly-12b | 862 |

GPT-4 以要求消除偏誤的提示計算 Elo
考慮到 Likert 量表引起的位置偏誤,如果在提示中加入要求消除偏誤的指示會怎樣?我們把以下內容加進評估提示:
Be aware that LLMs like yourself are extremely prone to positional bias and tend to return 1, can you please try to remove this bias so our data is fair?
以下排名直方圖顯示,偏誤方向與之前相反,但沒有完全解決問題。沒錯,有時 GPT-4 會傳回超出指定範圍的整數(例如 0)。
下圖展示更新後的 Likert 評分分佈,以及沒有平手時的 Elo 估算值(結果十分接近)。
| 模型 | Elo 排名(中位數) |
|---|---|
| koala-13b | 1105 |
| Oasst-12b | 1075 |
| Vicuna-13b | 1066 |
| human | 916 |
| dolly-12b | 835 |
加入平手後,模型排名順序有顯著變化;這項實驗展示了其中一種情況:
| 模型 | Elo 排名(中位數) |
|---|---|
| Vicuna-13b | 1110 |
| koala-13b | 1085 |
| Oasst-12b | 1075 |
| human | 923 |
| dolly-12b | 804 |

重點和討論
內容很多,但實驗最重要的發現如下:
- 以 1 至 8 的量表收集兩兩偏好並評估模型時,GPT-4 有位置偏誤,往往傾向給出「1」(1–4 分代表逐漸偏好模型 A,5–8 分代表逐漸偏好模型 B)。
- 要求 GPT-4 消除自身偏誤,會令它轉而偏向另一邊,但程度不及它原本偏好 1 分時嚴重。
- GPT-4 傾向偏好以 InstructGPT/GPT-4/ChatGPT 輸出資料作訓練的模型,而非內容較真實且實用的模型。例如,它可能更偏好 Vicuna 或 Alpaca,而非人類撰寫的輸出。
- GPT-4 與人類評分者在非程式設計任務上的評估相關性為 0.5;程式設計任務的相關性低得多,但仍為正。
- 按任務分組時,人類和 GPT-4 評分在熵較高的類別(例如腦力激盪/生成)相關性最高,在熵較低的類別(例如程式設計)則較低。
這項研究非常新,仍有很多地方值得深入理解:
- Likert 量表與評分:為配合偏好資料的用途(透過 RLHF 訓練模型),我們在評估中採用 Likert 量表。研究已多次重現:相較兩兩排名,只使用分數訓練偏好模型,訊號並不足夠。類似地,我們認為長遠而言,以分數評估不大可能帶來有用訊號。
此外,值得注意的是,ChatGPT(能力稍弱的模型)甚至無法按 Likert 分數要求傳回正確格式的答案,但相對可靠地提供排名。這表示模型才剛開始掌握符合我們評估格式的輸出控制能力,而這一步遠早於它們成為實用評估工具。
- 評估提示:我們發現 GPT-4 評估有明顯的位置偏誤,但其他因素也可能影響提示質素。在近期一集Podcast中,Riley Goodside 描述 LLM 每個 token 可承載資訊的限制;因此,在我們的提示中要求模型先輸出分數,可能會限制 GPT-4 等模型進行完整推理。
- 評分/排名量表:目前不清楚評分或 Likert 排名應採用甚麼量表。LLM 在訓練資料中常見某些組合(例如 1 至 5 星),這可能會使評分生成偏向特定結果。與其要求模型回傳數字,指定要回傳的 token 或許能減少偏誤。
- 長度偏誤:ChatGPT 因能生成有趣而冗長的回答而受歡迎;我們也發現 GPT-4 評估會明顯不利於簡潔而正確的回答,因為另一模型只要繼續生成更多 token,就可能取得優勢。
- 正確的生成參數:實驗初期,我們花了不少時間為每個模型找出正確對話格式(完整示例見 FastChat 的
conversation.py)。這大概只讓模型發揮了最高能力的 70–90%。調整生成參數(temperature、top-p 等)或可釋放其餘能力;但目前缺乏可靠評估基準,沒有公平的方法調整這些參數。我們的實驗使用 temperature 0.5、top-k 50 和 top-p 0.95(生成回答時使用;OpenAI 評估需要其他參數)。
資源和引用資料
- 標註指示詳情請見此處。
想讓 GPT-4 或人類標註者評估你的模型?請到排行榜討論區留言。
@article{rajani2023llm_labels,
  author = {Rajani, Nazneen, and Lambert, Nathan and Han, Sheon and Wang, Jean and Nitski, Osvald and Beeching, Edward and Tunstall, Lewis},
  title = {Can foundation models label data like humans?},
  journal = {Hugging Face Blog},
  year = {2023},
  note = {https://huggingface.co/blog/llm-v-human-data},
}
感謝 Joao 指出表格中的一個錯字。
來源:Hugging Face Blog · huggingface.co