如何在 Amazon EKS 和 SageMaker HyperPod EKS 上以 NVIDIA Nemotron 模型加速智能體 AI
Accelerate agentic AI with NVIDIA Nemotron models on Amazon EKS and SageMaker HyperPod EKS
AWS Machine Learning Blog 介紹如何在 Amazon EKS、EKS Auto Mode 和 SageMaker HyperPod EKS 上部署 NVIDIA Nemotron 模型,以支援智能體 AI 工作流程。
文章以並行度測試比較聚合與分離式部署,並示範如何根據 TTFT、ITL 和吞吐量規劃容量及判斷擴展方向。
NVIDIA Nemotron 3.5 Super VL 加入已在 AWS 提供的 NVIDIA Nemotron 3 Nano、Nano Omni、Super、Ultra 及 Nemotron 3.5 Lightning 等模型之列。這是一個擁有 120B 個參數的專家混合(MoE)模型,每個 token 會啟用 12B 個參數。它結合推理和工具使用能力,並能理解文字、圖像、文件及影片,讓單一模型同時處理文字及視覺任務。本文會探討其架構和應用場景,並展示如何在 Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon EKS Auto Mode 及 Amazon SageMaker HyperPod EKS 上部署。
關於 Nemotron 3.5 Super VL
NVIDIA Nemotron 3.5 Super VL 是一個從 Nemotron 3 Ultra 蒸餾而來的開放式多模態模型。NVIDIA 會發布模型權重、訓練數據集及後訓練配方,讓你可以按特定領域的工作負載自訂模型,並在由你掌控的基礎設施上運行。模型詳情:
- 總參數量為 120B,每個 token 啟用 12B 個參數。
- 採用混合式 Mamba-2、MoE 及注意力層,並配備 RADIO 視覺編碼器。
- 上下文長度最高達 1M 個 token。
- 輸入:文字、圖像、文件及影片。
- 輸出:文字。
- BF16 和 NVFP4 檢查點。
NVIDIA 表示,模型在 Hermes Bench 上取得 63.44% 的成績,在 LangChain Agent 評測中取得 87.05%,並在 CharXiv 圖表推理基準上取得 80.8%。(技術報告)
模型架構
Nemotron 3.5 Super VL 採用混合式 Mamba-Transformer MoE 架構,交替使用 Mamba-2、注意力及專家層。稀疏路由會為每個 token 啟用 120B 個參數中的 12B 個,因此每個 token 的計算量與小得多的模型相若,但 GPU 記憶體仍須容納完整權重。生成期間,Mamba-2 層會維持固定大小的狀態,因此其記憶體用量不會像 KV cache 一樣隨序列長度增加,令長上下文處理的成本維持可負擔。遞迴共享的多 token 預測(MTP)預測頭支援原生推測解碼。
應用場景
Nemotron 3.5 Super VL 支援結合推理和視覺理解的 Agent 工作流程:
- 編碼:測試及驗證程式碼、分析錯誤並建議修正方法。
- 網上研究:交叉比對並核實搜尋工具找到的來源。
- 文件智能:讀取表格、圖表及頁面版面,以產生摘要。
- 網絡安全:識別漏洞並對威脅進行分流處理。
- 影片理解:影片搜尋、內容審查及事故分析。
Nemotron 3.5 Super VL 透過 NVIDIA 參考實作、教學指南及 NVIDIA Agent Toolkit,整合多個主流開放式 Agent 框架及編排系統。支援框架的完整清單,請參閲 NVIDIA 開發者網誌。
最低 GPU 配置
| vLLM(GPU 型號/最低數量) | BF16 | NVFP4 |
| B200/GB200 | 8 | 2 |
| B300/GB300 | 4 | 1 |
| H200 | 8 | 4 |
| H100 | 16 | 8 |
在 AWS 上部署
本節概述架構、驗證及效能評估方法。部署 Nemotron 3.5 Super VL 和 Nemotron 3 Ultra 的詳細指南可在 aws-do-eks 專案中找到,內容包括先決條件、建立叢集、下載模型權重、部署、測試、效能基準測試及清理。相同模式亦可套用於 NVIDIA Nemotron 系列的其他模型。
部署架構
參考實作可在標準 Amazon EKS、EKS Auto Mode 及 SageMaker HyperPod EKS 上執行。使用 EKS Auto Mode 時,AWS 會代為管理叢集的擴展、GPU 及 EFA 支援。各種協調器選項所用的模型部署 Kubernetes 資訊清單相同。每個叢集都設有託管 Kubernetes API 的控制平面,以及由 CPU 和 GPU 節點組成的數據平面。CPU 節點負責執行系統及測試 Pod,GPU 節點則負責執行模型。Amazon Elastic Container Registry (Amazon ECR) 用於儲存容器映像檔,共用的 Amazon FSx for Lustre 磁碟區用於存放模型權重,而 Elastic Fabric Adapter (EFA) 則連接 GPU 節點。下圖展示標準 Amazon EKS 叢集。
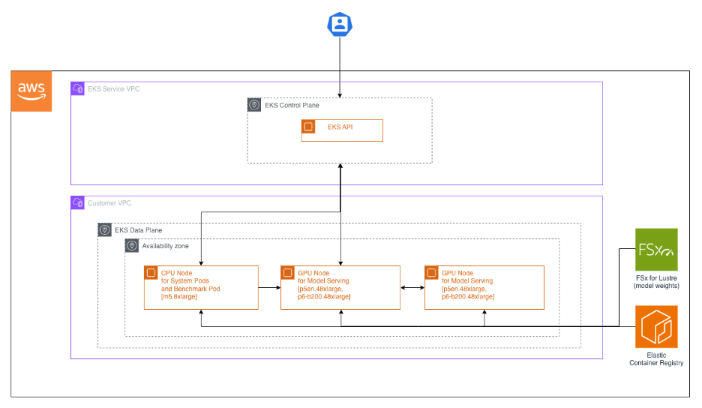
圖 1:用於提供 NVIDIA Nemotron 模型服務的標準 Amazon EKS 叢集架構
NVIDIA Dynamo 可在單一節點上以聚合式架構提供模型服務,亦可採用分離式架構,在不同節點上執行預填充和解碼。對於視覺語言模型,圖像/影片編碼階段亦可採用分離式架構,在獨立節點上執行。
驗證及效能
此架構已在 p6-b200.48xlarge(8 x NVIDIA B200 GPUs)和 p5en.48xlarge(8 x NVIDIA H200 GPUs)執行個體上完成驗證。你可以透過 NVIDIA Collective Communications Library (NCCL) 全歸約微基準測試,驗證叢集及其網絡。
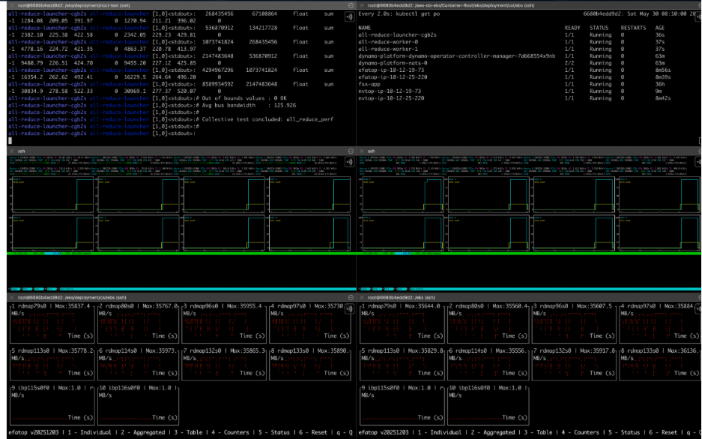
圖 2:NCCL 全歸約驗證測試期間的 GPU 和 EFA 使用情況
在 NCCL 測試執行期間,觀察到所有 GPU 均有使用,而且所有 EFA 介面卡均有流量,即可確認叢集運作正常。
你可以使用 NVIDIA aiperf 工具,量度已部署模型在叢集上的效能。
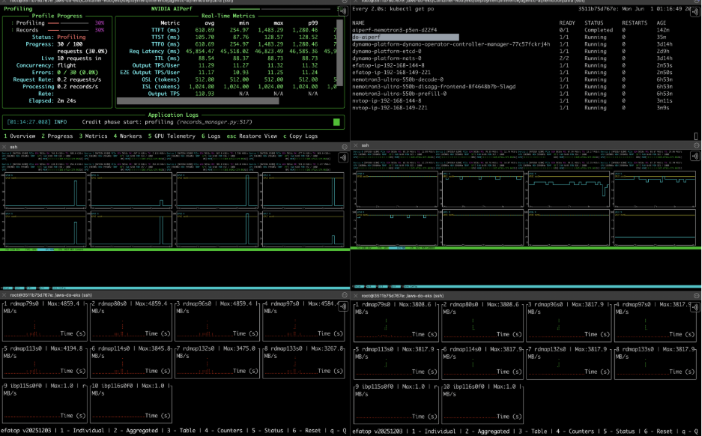
圖 3:已部署模型的 aiperf 效能指標
左上方窗格中的 aiperf 輸出會顯示重要效能指標 (KPI),例如首個 token 時間 (TTFT)、token 間延遲 (ITL),以及每秒 token 吞吐量 (TPS)。透過在不同並發程度下進行這些測量,我們可以研究延遲和吞吐量如何隨並發請求數量而變化。這些資訊對審慎規劃容量及模型部署拓撲至關重要。aws-do-eks 容器提供自動化功能,可視化 GPU 和 EFA 使用情況,並以單一指令執行 aiperf 和並發數掃描。
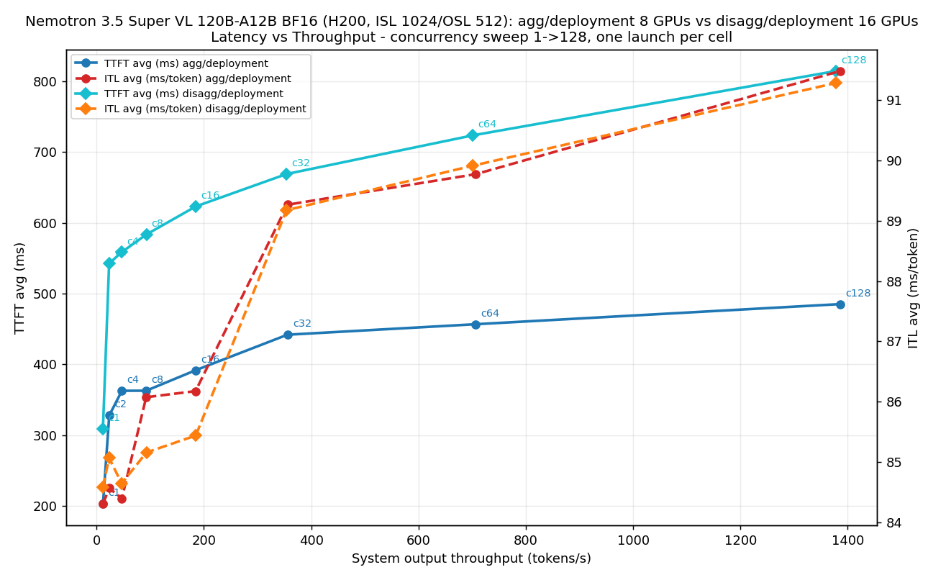
圖 4:比較聚合式與分離式部署的並發數掃描
上述並發數掃描圖表顯示,在兩節點上進行聚合式及分離式部署時,Nemotron 3.5 Super VL 的推理 TTFT 較低,而 ITL 大致相同。
製作部署決策時,這類圖表很有用。把延遲預算畫成水平線,例如 TTFT 低於 600 ms(約 1 秒),以及每個 token 的 ITL 低於 100 ms。同時低於兩條線的最右端點,代表這種拓撲的一個副本在符合服務等級目標(SLO)的情況下可提供的吞吐量;此處為 c32,即每秒約 320 個 token。規劃容量時,把目標每秒 token 數除以單個副本的吞吐量,就能得出要部署多少組預填充-解碼配對。每次變更後(例如精度、TP/PP 配置、採用聚合或非聚合架構,或推出新版 Dynamo 或 vLLM),重新執行相同的掃描測試,便能即時看出取捨。曲線向右下方移動即代表改善。由於 TTFT 和 ITL 分開繪製,圖表也能指出應擴充哪一端的容量:ITL 上升表示應增加解碼容量,TTFT 上升則表示應增加預填充容量。
結論
本文介紹如何使用 NVIDIA Dynamo 和 vLLM,在 Amazon EKS、EKS Auto Mode 及 SageMaker HyperPod EKS 上服務 NVIDIA Nemotron 模型的架構及效能評估模式。若要開始,請使用參考實作,在自己的帳戶中部署 Nemotron 3.5 Super VL。AI on EKS 專案亦提供更多推理藍圖。若要進一步實際體驗在 EKS 上進行推理,請報名參加即將舉辦的工作坊。
致謝
作者謹向參與本文開發、驗證、審閲及發布的所有人士致以特別謝意,包括但不限於:Eliuth Triana、Jiahong Liu、Kshitiz Gupta、Abhijeet Patil、Mike Stefaniak、Chris Splinter、Sheetal Joshi、Aditya Ramakrishnan、Natarajan Kumar、Anish Maddipoti。
作者簡介

Alex Iankoulski
Alex 是 AWS 全球專家組織的首席解決方案架構師,專注於使用容器協調 AI/ML 工作負載。Alex 是 do-framework 的作者,亦是 Docker Captain,熱衷於運用容器技術加快創新步伐,應對全球最重大挑戰。過去 10 年,Alex 致力協助客戶在 AWS 上做得更多、推動 AI 和 ML 普及、應對氣候變化,並讓出行更安全、醫療保健更完善、能源更智能。

Anton Alexander
Anton 是 AWS 生成式 AI 資深專家,專注於運用 Amazon SageMaker HyperPod 擴展大型訓練和推理工作負載。作為資深 CUDA 程式設計師及 Kubernetes 專家,他協助企業整合 NVIDIA 技術以進行分散式訓練,專長是 EKS 和 Slurm 實作。Anton 與中東及北非地區和政府部門的客戶緊密合作,協助他們優化生成式 AI 解決方案。他有一項機器學習邊緣運算系統相關專利正在申請中。工作以外,Anton 是巴西柔術及大學拳擊冠軍,亦喜歡駕駛飛機。

Leah Tucker
Leah 是資深 AI/ML 專家解決方案架構師,專注於在 EC2 和 EKS 上使用開源模型進行自我管理的即時推理。她專長於推理工程、模型基準測試、生產環境架構設計,以及從冷啟動到持續吞吐量的效能優化。她近期的工作包括在 EKS 上建置開源 TTS 推理技術堆疊,以及為 G 和 P 執行個體系列開發 GPU 基準測試工具。

Curt Lockhart
Curt 是 NVIDIA 的 AI 解決方案架構師,協助客戶處理 AI 技術堆疊各個環節的工作,從推理和訓練到 Agent 工作流程。他本身熱愛教學,樂於讓複雜的 AI 概念變得易於理解。

Abdullahi Olaoye
Abdullahi 是 NVIDIA 的高級 AI 解決方案架構師,專門將 NVIDIA AI 程式庫、框架及產品與雲端 AI 服務及開源工具整合,以優化 AI 模型部署、推理及生成式 AI 工作流程。他與雲端服務供應商合作,提升 AI 工作負載效能,並推動採用由 NVIDIA 技術支援的 AI 及生成式 AI 解決方案。

Wenhan Tan
Wenhan 是 NVIDIA 的解決方案架構師,協助客戶大規模採用 NVIDIA AI 解決方案。他的工作重點是加速深度學習應用,並應對推理及訓練方面的挑戰。
來源:AWS Machine Learning Blog · aws.amazon.com