Hugging Face Hub 上 5 個常被忽略的工具及實作示例
The 5 Most Under-Rated Tools on Hugging Face
Hugging Face Blog 介紹 Hugging Face Hub 上 5 項常被忽略的工具,並以 Reddit 資料展示自動更新的視覺化語義搜尋流程。
文章以每日更新的 Reddit 資料為例,拆解 Hugging Face Hub 五項工具如何協作,從資料抓取、嵌入向量處理與事件觸發,直到視覺化語義搜尋。
重點摘要:Hugging Face Hub 有不少常被忽略的工具和整合功能,可讓你更輕鬆建立各類 AI 解決方案。
Hugging Face Hub 託管超過 850K 個公開模型,每月新增約 50k 個,而且數量似乎不斷攀升。我們亦提供 Enterprise Hub 訂閲,解鎖合規、安全和治理功能,並為生產級推論提供更多 Inference Endpoints 運算資源,以及更多 Spaces 示範硬件選項。
Hugging Face Hub 提供多種硬件,讓你廣泛使用服務,並可在 Docker Spaces 執行幾乎任何工作。我留意到有不少功能鮮為人知(如下所列)。建立 Hugging Face Hub 語義搜尋應用程式時,我運用了這些功能實作方案的不同部分。我認為最終應用程式(詳見這個組織 reddit-tools-HF)很有吸引力,也希望藉此示範如何把這些功能用於自己的專案。
- ZeroGPU - 如何免費使用 GPU?
- 多程序 Docker - 如何在 1 個 Space 解決 2(n)個問題?
- Gradio API - 如何讓多個 Spaces 協同運作?
- Webhooks - 如何根據 Hub 變更,在 Space 觸發事件?
- Nomic Atlas - 功能豐富的語義搜尋(支援視覺和文字)
使用場景
免費提供可視化功能、會自動更新的動態資料源語義搜尋
以下場景都很適合使用這類工具:
- 需要按商品描述或回報問題管理大量產品的電子商務平台
- 需要搜尋法律文件或法規的律師事務所和合規部門
- 必須追蹤最新進展,並尋找相關論文或文章的研究人員
以下示範會使用 subreddit 作為資料來源,並透過 Hub 處理其他部分。實作方法有很多:我可以把所有內容放在 1 個 Space,但會很混亂;另一方面,方案包含太多元件也有自身挑戰。最後,我選擇了一種設計,既能介紹 Hub 上一些鮮為人知的功能,也能示範如何有效運用它們。架構見圖 1,整套方案均以 Spaces、datasets 和 webhooks 託管於 Hugging Face。為了讓更多人使用,我採用的每項功能都是免費的。服務需要擴展時,可考慮升級至Enterprise Hub。
 |
|---|
| 圖 1:專案流程 此處有可點擊版本 |
如圖所示,我以 r/bestofredditorupdates 作為資料來源,每日有 10–15 篇新貼文。我每天透過 Reddit Application 和 PRAW 使用其 API 抓取資料,再存進原始資料集(reddit-tools-HF/dataset-creator-reddit-bestofredditorupdates)。儲存新資料後會觸發 webhook,再由資料處理 Space 接手。資料處理 Space會取用原始資料集並加入欄位,例如透過 Gradio client 從嵌入模型 Space取得的特徵嵌入。然後,資料處理 Space會把處理後資料存入已處理資料集,並建立資料探索器工具。請注意,資料來源決定了內容被視為 not-for-all-audiences。詳情請見道德考量。
| 元件 | 詳情 | 位置 | 補充資訊 |
|---|---|---|---|
| 資料來源 | 來自 r/bestofredditorupdates 的資料 | 因為這是我最喜愛的 subreddit!使用 PRAW 和 Reddit API 抓取 | |
| 資料集建立 Space | 把新的 Reddit 資料匯入資料集 | reddit-tools-HF/dataset-creator-reddit-bestofredditorupdates(Space) | - 排程擷取資料集工作 - 透過 Log Visualization 監察程序 1 |
| 原始資料集 | r/bestofredditorupdates 最新彙整資料 | reddit-tools-HF/dataset-creator-reddit-bestofredditorupdates(資料集) | |
| 資料處理 Space | 在原始資料集中新增嵌入欄位,用於語義比較 | reddit-tools-HF/processing-bestofredditorupdates | 同時顯示處理記錄和 Nomic Atlas 地圖 |
| 嵌入模型 Space | 託管嵌入模型 | reddit-tools-HF/nomic-embeddings | 使用 nomic-ai/nomic-embed-text-v1.5* |
| 已處理資料集 | 包含嵌入資料的最終資料集 | reddit-tools-HF/reddit-bestofredditorupdates-processed(資料集) | |
| 資料探索器 | 視覺和文字語義搜尋工具 | Nomic Atlas 地圖 | 以 Nomic Atlas 建立:提供強大的篩選和縮小搜尋範圍工具 |
*我使用 nomic-ai/nomic-embed-text-v1.5 生成嵌入,原因如下:
- 能良好處理長 context(8192 tokens)
- 效率高,只有 137M 參數
- 在 MTEB leaderboard 排名靠前
- 可配合 nomic-atlas 作語義搜尋
ZeroGPU
現代模型的一項挑戰是通常需要 GPU 或其他高規格硬件才能執行。這些設備體積不小,常要承諾租用一年,成本也很高。Spaces 讓你以低廉成本使用所需硬件,但硬件不會自動啟動和關閉(當然你可以用程式控制)。ZeroGPU 是 Spaces 的全新硬件類型。免費用戶有一定配額,PRO 用戶則享有更高配額。
它有兩個目標:
- 為 Spaces 提供免費 GPU 存取
- 讓 Spaces 能使用多張 GPU 執行
 |
|---|
| 圖 2:ZeroGPU 的幕後運作 |
它的實現方式是按需讓 Spaces 高效佔用和釋放 GPU(不像傳統 GPU Space 一直連接 GPU)。ZeroGPU 底層使用 Nvidia A100 GPU(每個工作負載可使用 40GB vRAM)。
應用
我使用 ZeroGPU,在自己的嵌入模型 Space託管出色的 nomic 嵌入模型。這非常方便,因為我只需偶爾、增量式執行推論,不需要專用 GPU。
使用方式極其簡單:只需把所有 GPU 程式碼放進一個函式,再加上 @spaces.GPU decorator。
import spaces

model = SentenceTransformer("nomic-ai/nomic-embed-text-v1.5", trust_remote_code=True, device='cuda')

@spaces.GPU
def embed(document: str):
    return model.encode(document)
多程序 Docker
 |
|---|
| 圖 3:資料處理 Space |
企業最常提出的要求之一,是整合功能 X 或工具 Y。Hugging Face Hub 的一大優勢,是提供功能強大得出乎意料的 API,基本上能與任何事物整合。另一個常見解法是使用 Spaces。這裏我會採用空白的Docker Space,執行任意 Docker container 和所選硬件(我的例子使用免費 CPU)。
我最主要的難題,是如何在單一 Space 執行 2 種截然不同的工作。大部分 Spaces 都有單一用途,例如展示 diffusers 模型或生成音樂。以資料集建立 Space為例,我需要:
- 執行一些程式碼,從 Reddit 抓取資料並存入原始資料集
- 這是大部分不可見的程序
- 由
main.py執行
- 把以上程式碼的記錄視覺化,方便了解執行狀況(見圖 3)
- 由
app.py執行
- 由
請注意,這兩項工作應在不同程序中執行。我遇過不少需要顯示記錄的場景,這樣做確實非常實用,也很重要。它是很好的除錯工具;在沒有自然使用者介面的情況下,畫面也更美觀。
應用
我使用 supervisord 函式庫採用多程序 Docker 方案;它是一套程序控制系統,能簡潔地管理多個獨立程序。Supervisord 讓我可在單一 container 執行多項工作,適合 Docker Space。請注意,Spaces 只允許公開單一 port,這可能會影響你選擇的方案。
Supervisor 是 Python 套件,安裝相當簡單。
pip install supervisor
你需要撰寫 supervisord.conf 檔案設定配置。完整示例見supervisord.conf,內容相當清晰。請注意,我不想記錄 program:app 的輸出,因為 app.py 只負責顯示記錄,不會產生記錄,因此我把輸出導向 /dev/null。
[supervisord]
nodaemon=true

[program:main]
command=python main.py
stdout_logfile=/dev/stdout
stdout_logfile_maxbytes=0
stderr_logfile=/dev/stderr
stderr_logfile_maxbytes=0
autostart=true

[program:app]
command=python app.py
stdout_logfile=/dev/null
stdout_logfile_maxbytes=0
stderr_logfile=/dev/stderr
stderr_logfile_maxbytes=0
autostart=true
autorestart=true
最後,啟動 supervisord.conf 才能執行 2 個程序。在我的 Dockerfile 中,只需執行:
CMD ["supervisord", "-c", "supervisord.conf"]
Gradio API
在資料處理 Space中,我需要取得貼文的嵌入;如果把嵌入模型放在另一個 Space,就會遇到問題:該如何呼叫它?
建立 Gradio app 後,預設可把任何互動當成 API 呼叫。也就是説,Hub 上所有精彩 Spaces都有 API(如果作者啟用,Spaces 也可透過 API 呼叫 Streamlit 或 Docker Spaces)!更棒的是,我們提供了易用的 client呼叫 API。
應用
我在資料處理 Space使用 client,從部署在嵌入模型 Space的 nomic 模型取得嵌入。相關程式碼位於utilities.py;以下摘錄本文所需部分:
from gradio_client import Client

# Define the Client
client = Client("reddit-tools-HF/nomic-embeddings")

# Create an easy to use function (originally applied to a dataframe)
def update_embeddings(content, client):
    # Note that the embedding model requires you to add the relevant prefix
    embedding = client.predict('search_document: ' + content, api_name="/embed")
    return np.array(embedding)

# Consume
final_embedding = update_embeddings(content=row['content'], client=client)
現在還有很棒的API recorder,讓你使用 GUI 的同時,記錄每個步驟並轉為 API 互動。
Webhooks
 |
|---|
| 圖 4:專案 Webhooks |
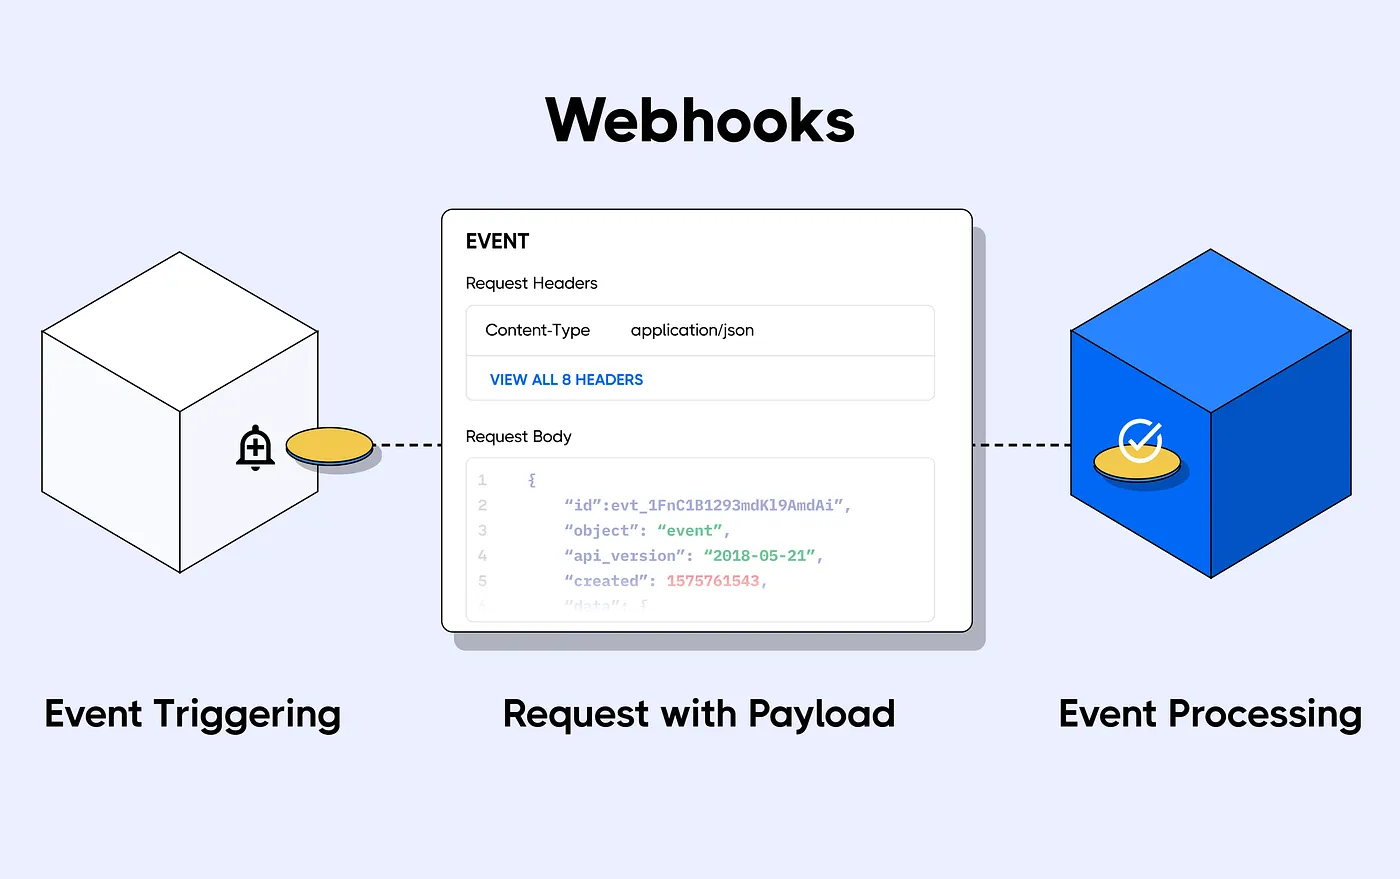
Webhooks 是 MLOps 功能的基礎,可監聽特定 repo 或某組使用者/組織旗下所有 repo 的新變更(不只限於你自己的 repo)。
你可以用它們自動轉換模型、建立社羣機械人、為模型、資料集和 Spaces 建立 CI/CD 等,應用還有很多!
應用
在我的使用場景中,每當原始資料集更新,我都希望重新建立已處理資料集。完整程式碼在此。為此,我需要新增一個 webhook,在原始資料集更新時觸發,並把 payload 傳至資料處理 Space。可能出現多種類型的更新,例如其他 branch 的變更或討論區活動。我的觸發條件是:repo 的 main branch 上,README.md 和另一個檔案都更新;因為資料集有新 commit 時,這些檔案會同時變更(此處有示例)。
# Commit cleaned up for readability
T 1807	M	README.md
T 52836295	M	data/train-00000-of-00001.parquet
把這套方法套用到自己的場景時,必須仔細決定觸發條件。
首先,在設定中建立 webhook。建議按照這份指南操作,並確保 endpoint 名稱一致(我使用 /dataset_repo)。
另外,webhook URL 是在 Direct URL 後加上 /webhooks。要找到Direct URL,請按 Space 上方的三點按鈕,並選擇 Embed this Space。我也設定了webhook secret於資料處理 Space,確保安全。
以下是建立 webhook 時的輸入示例。別把我的 secret 告訴別人 😉。
目標儲存庫:datasets/reddit-tools-HF/dataset-creator-reddit-bestofredditorupdates
Webhook URL:https://reddit-tools-hf-processing-bestofredditorupdates.hf.space/webhooks/dataset_repo
Secret(可選):Float-like-a-butterfly
接下來要在 Space 中接收 webhook。方法會包括:
- 如何設定 webhook server
- 如何只觸發我們關心的更新
- 必須是
repo變更 - 必須發生在 main branch:
refs/heads/main - 必須是更新,而且不能只有
README.md有變更
- 必須是
如何設定 webhook server
首先接收 payload。我們可透過 接收 webhook payload;huggingface_hub 函式庫已內建相關功能。如圖所示,我用 @app.add_webhook 定義一個與建立 webhook 時設定相符的 endpoint,然後再定義函式。
請注意,必須在 30s 內回覆 payload 請求,否則會收到 500 錯誤。因此我使用 async 函式先回覆,再啟動實際工作,而不是在 handle_repository_changes 函式中直接處理。詳情請參閲background task 文件。
from huggingface_hub import WebhookPayload, WebhooksServer

app = WebhooksServer(ui=ui.queue(), webhook_secret=WEBHOOK_SECRET)

# Use /dataset_repo upon webhook creation
@app.add_webhook("/dataset_repo")
async def handle_repository_changes(payload: WebhookPayload, task_queue: BackgroundTasks):

    ###################################
    # Add selective trigger code here #
    ###################################

    logger.info(f"Webhook received from {payload.repo.name} indicating a repo {payload.event.action}")
    task_queue.add_task(_process_webhook, payload=payload)
    return Response("Task scheduled.", status_code=status.HTTP_202_ACCEPTED)


def _process_webhook(payload: WebhookPayload):
    #do processing here
    pass
選擇性觸發
由於我關心 repo 層級的任何變更,可使用 payload.event.scope.startswith("repo") 判斷是否需要處理收到的 payload。
# FILTER 1: Don't trigger on non-repo changes
if not payload.event.scope.startswith("repo"):
    return Response("No task scheduled", status_code=status.HTTP_200_OK)
可透過 payload.updatedRefs[0] 取得 branch 資訊。
# FILTER 2: Dont trigger if change is not on the main branch
try:
    if payload.updatedRefs[0].ref != 'refs/heads/main':
        response_content = "No task scheduled: Change not on main branch"
        logger.info(response_content)
        return Response(response_content, status_code=status.HTTP_200_OK)
except:
    response_content = "No task scheduled"
    logger.info(response_content)
    return Response(response_content, status_code=status.HTTP_200_OK)
判斷哪些檔案有變更會複雜一點。我們可在 commit_files_url 取得一些 git 資訊,但之後還需要解析,格式有點像 .tsv。
步驟:
- 取得 commit 資訊
- 把它解析為
changed_files - 按條件採取行動
from huggingface_hub.utils import build_hf_headers, get_session

# FILTER 3: Dont trigger if there are only README updates
try:
    commit_files_url = f"""{payload.repo.url.api}/compare/{payload.updatedRefs[0].oldSha}..{payload.updatedRefs[0].newSha}?raw=true"""
    response_text = get_session.get(commit_files_url, headers=build_hf_headers()).text
    logger.info(f"Git Compare URl: {commit_files_url}")

    # Splitting the output into lines
    file_lines = response_text.split('\n')

    # Filtering the lines to find file changes
    changed_files = [line.split('\t')[-1] for line in file_lines if line.strip()]
    logger.info(f"Changed files: {changed_files}")

    # Checking if only README.md has been changed
    if all('README.md' in file for file in changed_files):
        response_content = "No task scheduled: its a README only update."
        logger.info(response_content)
        return Response(response_content, status_code=status.HTTP_200_OK)
except Exception as e:
    logger.error(f"{str(e)}")
    response_content = "Unexpected issue :'("
    logger.info(response_content)
    return Response(response_content, status_code=status.HTTP_501_NOT_IMPLEMENTED)
Nomic Atlas
客戶和合作夥伴常遇到的難題之一,是資料理解和協作不容易。要解決 AI 使用場景,通常首先要了解資料。我最喜歡透過視覺化探索資料,但處理語義資料時常缺乏合適工具。發現 Nomic Atlas 時,我非常欣喜。它提供多項資料探索功能:
- 使用 nomic-ai/nomic-embed-text-v1.5 進行語義搜尋(目前為 beta)
- 功能豐富的篩選
- 關鍵字搜尋
- 圈選搜尋(可以自行畫出邊界!!)
應用
我在資料處理 Space中建立 Nomic Atlas。流程中已建立已處理資料集,現在只差把它視覺化。可在build_nomic.py查看如何使用 nomic 建立。我會像之前一樣,摘錄本文相關部分:
from nomic import atlas
from nomic.dataset import AtlasClass
from nomic.data_inference import NomicTopicOptions

# Login to nomic with a Space Secret
NOMIC_KEY = os.getenv('NOMIC_KEY')
nomic.login(NOMIC_KEY)

# Set because I do want the super cool topic modeling
topic_options = NomicTopicOptions(build_topic_model=True, community_description_target_field='subreddit')

identifier = 'BORU Subreddit Neural Search'
project = atlas.map_data(embeddings=np.stack(df['embedding'].values),
                         data=df,
                         id_field='id',
                         identifier=identifier,
                         topic_model=topic_options)
print(f"Succeeded in creating new version of nomic Atlas: {project.slug}")
由於 nomic 的運作方式,每次執行 atlas.map_data 都會在你的帳戶下建立新的 Atlas Dataset。我希望持續更新同一個資料集,目前最好的做法是刪除舊資料集。
ac = AtlasClass()
atlas_id = ac._get_dataset_by_slug_identifier("derek2/boru-subreddit-neural-search")['id']
ac._delete_project_by_id(atlas_id)
logger.info(f"Succeeded in deleting old version of nomic Atlas.")

#Naively wait until it's deleted on the server
sleep_time = 300
logger.info(f"Sleeping for {sleep_time}s to wait for old version deletion on the server-side")
time.sleep(sleep_time)
功能
 |
|---|
| 圖 5:Nomic 截圖 |
Nomic Atlas 的使用方式相當直觀,詳情可參閲文件。不過我會先簡單介紹,方便展示一些較少人知道的功能。
主畫面上的點代表嵌入後的文件。文件愈接近,彼此內容愈相關。結果會受多項因素影響,例如嵌入模型處理資料的效果,以及從高維空間壓縮至 2D 表示的過程等,因此結果只供參考。左側可搜尋和查看文件。
在圖 5的紅色方框中,可看到 5 個不同搜尋方式的方框。各項條件會逐步套用,很適合用來「逐步縮小範圍」。例如,可先按日期或其他欄位搜尋,再使用文字搜尋。最酷的是最左方的神經搜尋,有 3 種用法:
- 查詢搜尋:輸入簡短描述,尋找與之相符的(長篇)嵌入文件
- 文件搜尋:提供長篇文件,尋找與之相符的嵌入文件
- 嵌入搜尋:直接使用嵌入向量搜尋
探索已上載文件時,我通常使用查詢搜尋。
在圖 5的藍色方框中,可清楚看到我上載的資料集每一列。我很喜歡它能視覺化 HTML 的功能,因此可以自行控制顯示方式。Reddit 貼文使用 Markdown,很容易轉成 HTML 後顯示。
道德考量
以上資料來源包含標示為「不適合在工作場所瀏覽」(NSFW)的內容,與我們所稱的「不適合所有受眾」(NFAA)相近。Hub 不禁止此類內容,但我們希望以恰當方式處理。此外,近期研究指出,未經篩選而直接從互聯網取得的內容,可能含有兒童性虐待材料(CSAM),尤其是未整理性內容比例較高的來源。
要評估這項資料集整理工作的風險,可以先查看來源資料的彙集流程。原始故事(彙整前)會先經過版主審核,而更新內容通常也會放在有版主的 subreddit。有時更新會上載至原發文者的個人頁面。最後版本會上載到 r/bestofredditorupdates,該版有嚴格的審核制度,因為遭遇羣體圍攻的風險較高。總括而言,資料至少經過 2 次審核,通常是 3 次,其中一個版面以審核嚴格見稱。
本文撰寫時,有 69 個故事標示為 NSFW。我已手動檢查,當中沒有 CSAM。我也限制了含 NFAA 內容的資料集存取。為方便使用 Nomic 視覺化,我會在建立 Atlas 時建立篩選後資料集,從 dataframe 移除含有「NSFW」的貼文。
總結
希望透過介紹 Hugging Face Hub 中這些較少人認識的工具和功能,啟發你跳出框框思考,建立自己的 AI 解決方案。無論你採用本文的使用場景,還是提出全新想法,這些工具都能協助你建立更高效、更強大、更創新的應用程式。立即開始,發揮 Hugging Face Hub 的全部潛力!
參考資料
- Fikayo Adepoju,Webhooks 教學:初學者使用 Webhooks 指南,2021
- philipchircop,逐步縮小範圍,2012
來源:Hugging Face Blog · huggingface.co