ArisGlobal 如何在 Amazon Bedrock 上透過提示詞快取擴展生成式 AI 推理
How ArisGlobal scaled generative AI inference on Amazon Bedrock
ArisGlobal 調整 Amazon Bedrock 請求順序,改為快取跨請求重用的共用提示詞前綴,以降低 NavaX 的推理成本。生產請求中,約 65% 的輸入 token 以較低費率從快取讀取,令有效輸入成本約下降 50%;在每月超過 19 billion tokens 的用量下,整體月度推理支出約下降 40%。此設計亦支援約 15% 更多企業租戶進駐,而 EU 跨區域推理路由維持不變。
案例展示多租戶工作負載如何按跨請求重用程度安排快取前綴,而非優先快取單次個案的大型文件,並提供部署與監測要點。
ArisGlobal 是生命科學科技供應商,業務涵蓋藥物安全監測、法規事務、醫療事務、臨牀及品質職能。該公司以 Amazon Bedrock 為基礎,開發了專為生命科學領域打造的 AI 引擎 NavaX,用於自動處理不良事件個案。ArisGlobal 選用 Amazon Bedrock,是因為它提供託管式基礎模型存取服務、歐盟地區跨區域推理,以及託管式提示詞快取。隨着企業客戶加入不同的合規要求,共享提示詞前綴在 6 個月內增長了約 150%,每宗個案的推理成本則上升超過 200%。
ArisGlobal 起初為每份來源文件設定快取,因為它在請求中佔據最大部分。這令不斷增長的共享提示詞前綴未能納入快取。ArisGlobal 調換次序,改為快取共享提示詞前綴,從而降低有效輸入成本,並支援更多租戶,而成本不會按比例增加。
ArisGlobal 是哪家公司?
ArisGlobal 是 LifeSphere 的創建者。LifeSphere 是一個統一的 SaaS 平台,涵蓋藥物安全監測、法規事務、品質及醫療資訊。LifeSphere 服務全球製藥公司,包括多間按收入計位列 Top 20 的製藥機構(來源:ArisGlobal 新聞稿)。整個系統均在 AWS 上運行。
LifeSphere NavaX 是 ArisGlobal 的 AI 引擎,將藥物安全由記錄系統轉化為策略優勢系統。ArisGlobal 於 2025 年 3 月,透過 Amazon Bedrock with Anthropic’s Claude,將首個生成式 AI 解決方案投入正式運作。根據 ArisGlobal 內部正式環境的遙測數據,該公司已在受規管的製藥環境中處理超過 1 million 宗真實交易,並在多個企業租戶中處理數十億個 token。模型供應情況因區域而異。請參閲 各 AWS 區域的模型支援情況。
NavaX 如何處理不良事件個案
當製藥公司收到不良事件報告時,報告通常是多頁 PDF,描述病人對藥物的反應。NavaX 的動態資料擷取(DDE)Agent 會擷取約 130 個欄位,包括病人基本資料、疑似藥物、通報者資料、事件時間線、嚴重程度準則及法規分類。由於這些內容包括受保護的健康資訊,ArisGlobal 將負責任 AI 控制措施作為正式環境部署的標準部分。該公司會運用 Amazon Bedrock Guardrails 等功能來篩選內容,以及偵測或遮蔽敏感資訊。擷取的欄位亦會根據結構描述進行驗證,並以來源文件為依據。
這項擷取工作會透過向模型發出的多個連續請求完成。每個請求都針對個案表格的不同部分,並包含:
- 系統指示 — 模型行為規則、輸出格式規格及法規遵循限制。
- 客戶專屬規則 — 各租戶的擷取邏輯、欄位對應及業務規則,會因製藥公司而異。
- 擷取結構描述 — 約 130 個目標欄位及其類型、驗證規則和少樣本範例。
- 來源文件 — 不良事件 PDF(通常為 10–200 頁)。
兩項輸入會在不同範圍內重複出現。共享提示詞前綴包括系統規則、擷取結構描述及少樣本範例。使用相同 Agent 時,這些內容會在不同請求、個案及租戶之間重複。來源文件則只會在與同一宗個案相關的請求中重複。
提示詞膨脹問題
NavaX 推出首個企業租戶時,系統提示詞相當精簡。隨着 ArisGlobal 導入更多製藥公司,每家公司都帶來特定要求:
- 自訂欄位對應(租戶 A 與租戶 B 對反應發作時間的對應方式不同)。
- 監管司法管轄區規則(EU ICSR、FDA MedWatch 及 PMDA 格式要求之間的差異)。
- 各公司專屬的嚴重程度評估及因果關係判定業務邏輯。
- 按各公司過往個案校準的每租戶少樣本示例。
在 6 個月內,共用提示詞前綴由約 72,000 個 token 增至 180,000 個 token,增幅達 150%。由於每宗個案需要多次連續請求,每宗個案的推理成本增加超過 200%。
前綴隨每個租戶加入而增長,而且每次請求都會重新處理,因此提示詞增長的影響會隨交易量增加而加劇。
表 1 比較原本以文件為先的請求次序,與正式環境採用的提示詞優先設計。
| 方面 | 第一種做法 | 正式環境設計 |
| 請求次序 | 每宗個案文件、快取檢查點、共用提示詞前綴 | 共用提示詞前綴、快取檢查點、每宗個案文件 |
| 已快取的前綴 | 每宗個案都不同的文件 | 在各請求中重複使用的共用提示詞前綴 |
| 重用範圍 | 只限同一宗個案的其餘請求 | 使用相同 Agent 的不同個案及租戶之間的請求 |
| 成本影響 | 不斷增長的提示詞會以完整輸入費率重複處理 | 全系統重用提示詞,令成本增長低於線性增幅 |
| EU 路由 | EU 地區之間的跨區域推理保持不變 | EU 地區之間的跨區域推理保持不變 |
Amazon Bedrock 提示詞快取策略
Amazon Bedrock 提示詞快取會快取從請求開首至快取檢查點的一段連續提示詞前綴,從而減低延遲及輸入 token 成本。後續請求若使用相同前綴,便可按較低費率讀取已快取的 token,而毋須再次處理。快取項目設有存留時間(TTL),成功命中快取後會重設。
快取以提示詞前綴為基礎,而非以區塊為基礎。請求各部分會依次評估:工具、系統,然後是訊息;因此,若較前面的部分有所變更,之後相符的內容便會失效。
快取檢查點(手動控制)
使用手動快取檢查點時,你可以選擇確切的前綴邊界。支援的 Claude 模型每個請求最多可設定四個檢查點。
- 將每個檢查點設於穩定、可重用的前綴之後。
- 符合各模型的最低前綴大小要求。Claude Sonnet 4.5 的最低要求為 1,024 個 token(參閲支援的模型及區域)。
- 檢查點會按以下次序評估:工具、系統及訊息。
- 較前面的部分如有變更,會令之後部分的快取匹配失效。
- 預設 TTL 為 5 分鐘。部分型號支援 1 小時 TTL,可透過設定
"ttl": "1h"啟用。TTL 較長的項目必須排在 TTL 較短的項目之前。
簡化快取管理(自動化)
使用簡化快取管理時,你只需在靜態內容之後設定一個檢查點。Amazon Bedrock 會從該位置向前搜尋,找出最長的相符前綴,最多約 20 個內容區塊。
- 系統會自動透過一個檢查點找出最長的相符前綴。
- 若穩定內容超出向前搜尋範圍,請使用手動檢查點。
ArisGlobal 快取了甚麼,以及刻意沒有快取甚麼
ArisGlobal 在共用提示詞前綴之後立即設定一個手動檢查點,並先傳送該前綴。每宗個案文件則放在檢查點之後,並在每次請求中處理。
這改變了最初的請求次序。由於只有前綴可以快取,排列次序決定哪些內容可以重用。
初始設計:優先重用文件
第一個設計會把 10–200 頁的來源文件放在每個請求的開首,並在文件之後放置檢查點。共用提示詞前綴和針對特定章節的問題則放在檢查點之後。
{
  "modelId": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "text": "[Full adverse event PDF content]..." // <-- Document sent FIRST
        },
        {
          "cachePoint": {"type": "default"} // <-- Checkpoint right after the document
        },
        {
          "text": "[System instructions + compliance rules + schema +
          few-shot examples + customer-specific prompt]..."
          // <-- After the checkpoint: never cached
        },
        {
          "text": "Extract fields for Section 3: Suspect Drug Information"
        }
      ]
    }
  ]
}
這個設計會在同一個個案內重用文件:首個請求會將文件寫入快取,之後該個案的請求便會以較低費率讀取文件。
下一個個案會使用不同文件,因此需要重新寫入快取;文件重用從未延伸至不同個案或租戶之間。
更重要的是,共用提示詞前綴仍放在檢查點之後,每個請求都會按完整輸入費率處理。推高成本曲線的內容並未納入快取。
演進後的正式環境設計:優先重用共用前綴
正式環境的設計改為調整次序,而非新增另一個檢查點:先放置共用提示詞前綴,接着是檢查點,最後才是文件。
同一個檢查點現在會建立可供整個系統重用的快取項目:
- 之前 — 快取中的文件前綴只供單一個案使用,而共用提示詞從未被快取。
- 之後 — 使用相同 Agent 的請求、個案和租戶都會重複使用快取中的共用提示詞前綴。
ArisGlobal 放棄了在單一個案內有限度地重用文件,換來在整個系統重用提示詞。新增客戶時,共用前綴亦會隨之增長。
更新後的實作
{
  "modelId": "anthropic.claude-sonnet-4-5-20250929-v1:0",
  "system": [
    {
      "text": "[Shared system instructions + compliance rules +
      base extraction schema + few-shot examples]..."
    },
    {
      "cachePoint": {"type": "default"} // <-- Checkpoint after the stable prompt
    }
  ],
  "messages": [
    {
      "role": "user",
      "content": [
        {
          "text": "[Full adverse event PDF content — sits after the
          checkpoint, not cached]..."
        },
        {
          "text": "Extract fields for Section 5: Event Assessment"
          // <-- Only this changes per request
        }
      ]
    }
  ]
}
對大部分活躍帳戶而言,每個租戶約每 5 分鐘便會有個案送達,而且多個租戶會同時運作。這些流量可在辦公時間維持共用前綴的快取有效,因為每次快取命中都會重設 TTL。
同時快取提示詞和文件
在文件之後新增第二個檢查點,便可快取由共用提示詞和該個案文件組成的合併前綴。該快取項目仍只會供單一個案使用。
因此,ArisGlobal 優先選擇讀取效益可由整個系統分攤的前綴。共用提示詞前綴可跨個案和租戶擴展,個案專屬的文件則不能。
在正式環境中,典型請求有 65% 的輸入 token 由共用提示詞快取提供。圖 1 顯示,快取讀取量持續高於快取寫入量。
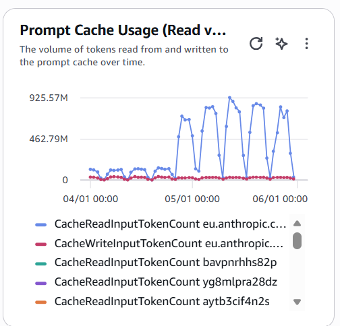
圖 1:Amazon CloudWatch 提示詞快取用量。在正式環境流量時段,藍色的快取讀取數列升至快取寫入數列約 10 倍
成效
在維持 EU 地理跨區域推理設定檔的同時,快取共用提示詞前綴帶來以下成效:
- 65% 的輸入 token 由快取提供,並以較低讀取費率計算。
- 快取命中的正式環境請求,端對端延遲最多降低 25%。
- 有效輸入成本降低約 50%。
- 每月處理超過 190 億個 token 時,每月整體推理開支降低約 40%。
- 可多接納約 15% 的企業租戶,而成本不會按比例增加。
- EU 地理路由維持不變。提示詞快取在現有推理設定中運作。
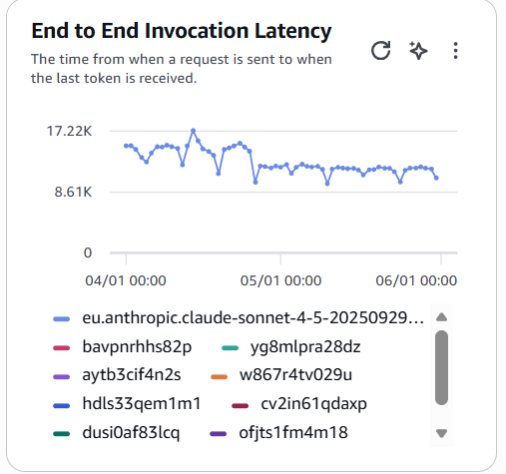
圖 2:端對端調用延遲。圖表顯示採用提示詞快取後,延遲範圍較低且更穩定
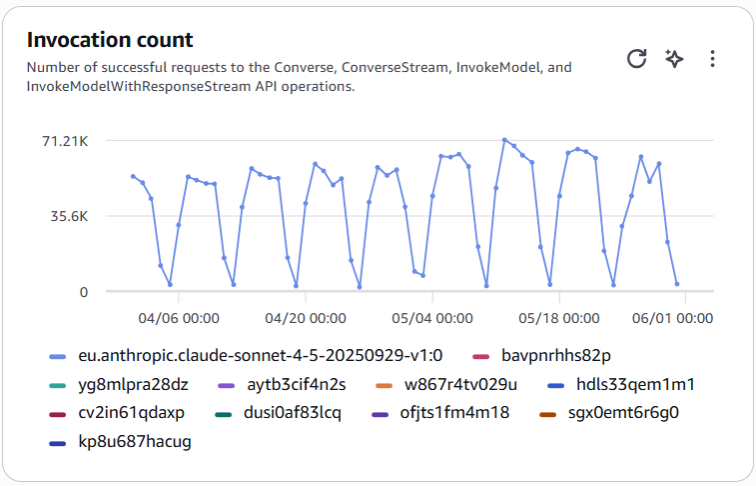
圖 3:調用次數。圖表顯示正式環境請求量持續維持高位,而推理開支的增幅低於請求量增幅
根據 ArisGlobal 的生產環境帳單數據,將 65% 的輸入 token 由快取提供,令有效輸入成本降低約 50%。每月 token 用量超過 190 億,推理開支整體每月因此節省約 40%。
注意:本節所有效能及成本數據均反映 ArisGlobal 向 AWS 報告的生產環境指標。實際結果會因提示詞結構、流量模式及快取命中率而異。
生產環境實踐心得
ArisGlobal 的經驗為許多包含大量重複提示詞前綴的工作負載提供指引:
快取重複內容,而非最大型的內容。 每宗個案的大型文件重用機會有限,而位元組完全相同的共用提示詞前綴則可供整個服務集羣的請求使用。
把穩定內容放在前面。 在檢查點之前排列工具定義、系統指示、結構描述及範例;租戶識別碼、個案資料及每次請求的問題則放在後面。
利用整個服務集羣的流量分攤快取寫入成本。 使用同一 Agent 的租戶請求可讀取相同前綴,而快取命中會重設 TTL。對於零星流量,請評估支援模型的 1 小時 TTL。
減少可避免的呼叫。 每次呼叫仍會處理未快取的文件,因此在輸出限制及結構描述要求容許的情況下,應把連續問題合併處理。
確保前綴的位元組完全相同。 時間戳記、請求 ID、租戶名稱及重新排序的工具定義都可能導致快取未命中。所有動態元素都應移至檢查點之後。
監察生產環境基準。 在 CloudWatch 追蹤快取讀取、快取寫入及輸入 token 總數。若快取命中率持續低於正常的 65% 基準,便發出警示,而非使用不適用的 80% 門檻。
查看各模型的限制。 前綴最低 token 數要求及 TTL 選項會因模型而異。Claude Sonnet 4.5 的快取檢查點至少需要 1,024 個 token。
結論
ArisGlobal 把 EU 地理區域跨區域推理,與針對合適內容的提示詞快取結合。快取穩定的共用前綴,而非每宗個案各異的文件,令有效輸入成本降低約 50%,促成推理開支整體每月節省約 40%,並支援約 15% 更多企業租戶,而成本沒有按比例增加。
關鍵經驗是,快取的價值取決於重用程度,而非大小。對於多租戶 Agent 工作負載,每次個案都會改變的大型文件,價值可能不及重複使用的共用提示詞前綴。
如欲瞭解更多,請參閲 Amazon Bedrock 提示詞快取文件、跨區域推理指南,以及 AWS 網誌文章 在 Amazon Bedrock 上有效使用提示詞快取。
作者簡介

Hitesh Sharma
Hitesh 是一位科技領袖,在軟件工程及產品創新方面擁有 25 年經驗,其中 20 年在生命科學行業。他專注於運用生成式 AI、AI/ML 及雲原生技術,解決藥物安全監測、藥物安全、法規遵循及患者安全等領域的複雜挑戰。Hitesh 曾領導開發可擴展的 AI 平台,為業務創造價值。他熱衷於 GenAI、創新,以及建立高效能團隊,推動生命科學技術發展。

Rakesh Kumar Sharma
Rakesh Kumar Sharma 是一位 AI/ML 領導者及研究人員,在生成式 AI、Agentic AI 及企業級 AI 架構方面擁有深厚專業知識。他專長於運用 LLM、AI 代理、RAG 及現代機器學習框架,設計和部署可擴展的 AI 解決方案,促進智能自動化、以知識為本的決策,以及可投入生產環境的 AI 平台。他的工作重點是構建結合推理、檢索、工具及自主工作流程的代理式系統,以解決複雜的企業挑戰。

Shubham Gupta
Shubham 是 AWS 的解決方案架構師,常駐印度班加羅爾,負責支援獨立軟件供應商(ISV)。他與工程團隊及管理層合作,協助他們在 AWS 上設計、構建和運行產品,涵蓋從初步架構設計到投入生產的各個階段,並專注於生成式 AI 及大規模環境下的韌性。工作以外,Shubham 熱愛遠足,並把行山時的同等準備和毅力帶到持久系統的構建工作中。

Vibhu Pareek
Vibhu 是 AWS 的資深 解決方案架構師。自 2016 年起,他一直以架構完善且可重複採用的模式,指導客戶採用雲端服務。憑藉在數據庫、數據分析及 AI 方面的專業知識,他熱衷於把複雜挑戰轉化為創新解決方案。工作以外,他喜歡短途遠足,以及羽毛球、足球和游泳等運動。
來源:AWS Machine Learning Blog · aws.amazon.com