Amazon SageMaker HyperPod 推出 Global Inference Gateway,支援跨區域及跨叢集的單一端點
Introducing Amazon SageMaker HyperPod Global Inference Gateway: One endpoint across Regions and clusters
Amazon SageMaker HyperPod 推出 Global Inference Gateway,透過單一 SageMaker 管理端點,在已註冊的叢集之間(包括跨 AWS 區域)路由請求。
Global Inference Gateway 將 HyperPod 跨叢集及跨區域推理路由整合至單一端點,並以容量、佇列、區域距離和錯誤率分流,呈現減少手動路由與故障切換工作的實作方式。
流量高峯期間,當一個 HyperPod 叢集已飽和,請求可能在佇列中等候;與此同時,另一個叢集(有時位於另一個 AWS 區域)的 GPU 卻閒置。你已為這些容量付費,請求卻無法使用它們。
在介紹 Amazon SageMaker HyperPod Inference Gateway一文中,我們介紹了 Inference Gateway 如何為每個 Amazon SageMaker HyperPod 叢集提供一個具備 GPU 感知能力的端點。它會讀取 KV 快取使用率和佇列深度等即時訊號,將每項請求傳送至最合適的 Pod。這解決了單一叢集內的路由問題,但未能處理跨叢集路由。
今天,SageMaker HyperPod 推出 Global Inference Gateway。這是一個由 SageMaker 管理的閘道,可在你註冊的所有叢集之間進行路由,無論它們位於同一個區域還是不同區域。閘道會選擇叢集,並透過 AWS 骨幹網絡傳送請求,同時支援自動容錯移轉,並透過 AWS Signature Version 4 (SigV4) 和 AWS Identity and Access Management (IAM) 進行驗證。在每個叢集內,Inference Gateway 仍會照常選擇 Pod。Global Inference Gateway 是我們在第 1 部分介紹的架構中的第二層。
挑戰:分散在不同叢集和區域的容量
模型規模不斷擴大,而用於服務這些模型的 GPU 容量愈來愈難取得。為了取得足夠容量,你需要將資源分散到更多叢集和區域。
假設一個團隊在兩個區域的五個 HyperPod 叢集中提供四個模型服務。沒有 Inference Gateway 時,用戶端需要管理 20 個端點:每個模型在每個叢集各有一個。Inference Gateway 可將端點數目減至五個,即每個叢集一個。但每個用戶端仍須自行選擇叢集。
這種做法有以下代價:
- 負載不均。流量高峯期間,請求在一個區域排隊等候,另一個區域的 GPU 卻閒置。
- 手動容錯移轉。叢集故障時,工程師需要修改設定,將流量轉離該叢集。
- 自建網絡設施。要將流量分散到不同區域,你必須自行建置和維護負載平衡器、DNS 及跨區域網絡。
團隊需要一個端點,將每項請求傳送至最合適的叢集,並在叢集故障時自動轉移流量。
主要優點
Global Inference Gateway 可助你更充分利用現有的 GPU 容量,同時減少營運管理工作。
- 讓閒置的 GPU 發揮作用。流量高峯期間,請求會溢流至同一區域或其他區域中仍有可用容量的叢集,而不是在已飽和的叢集排隊等候。
- 自動容錯移轉。叢集故障時,閘道會將該叢集的流量轉移至次佳叢集。用戶端無須作出任何更改。
- 所有服務共用一個端點。用戶端只需呼叫一個由 SageMaker 管理的端點,無須逐一管理每個叢集或每個模型的端點。
- 無需自建網絡。你無須自行建置或維護負載平衡器、DNS 或跨區域網絡。
- 預設保持私有。每項請求都會透過 SigV4 和 IAM 進行驗證,並且只會透過 AWS PrivateLink 傳送至你的叢集。
客戶意見回饋
「在 Bagelcode,我們在 AWS 上運行自家的 LLM 推理服務,協助公司各團隊(包括遊戲團隊)運用 AI 改善工作方式。在 Beta 測試中,Amazon SageMaker HyperPod 的 Global Inference Gateway 透過單一端點,將請求路由至兩個 AWS 區域;即使其中一個叢集無法再提供模型服務,服務仍能繼續運作。這讓我們的小型平台團隊無須自行建立或維護路由層,便能實現跨區域容錯移轉。」
— Jinhyung Park,Bagelcode AI 平台副總裁
運作方式
設定閘道只需作出兩項決定:要開放哪些叢集供路由使用,以及要將哪些叢集編組至同一個閘道後方。
- 發佈叢集。每個叢集只需執行一次。在叢集現有的
InferenceGatewayConfig中啟用spec.globalRouting區塊。接着,HyperPod Inference 控制器會從你自己的帳戶私下發佈該叢集。 - 建立閘道。每個閘道只需執行一次。呼叫
CreateGlobalInferenceGateway,並提供要進行路由的叢集;SageMaker 會傳回一個端點。
只有發佈叢集後,才能連線至該叢集。發佈叢集時,控制器會在叢集的 Inference Gateway 前方建立 Network Load Balancer,在其上發佈虛擬私有雲(VPC)端點服務,並將監聽器的憑證上載至你的 TLS 儲存貯體。這些資源都位於你的帳戶中。如果你在發佈叢集之前,便將它列入閘道,該呼叫會失敗,並顯示指出需要修正事項的訊息。
請求流程
圖 1 顯示每個請求的路徑:(1) 用戶端使用 SigV4 為請求簽署,並將請求傳送至閘道的區域端點。(2) 閘道驗證呼叫者的身分,並挑選最佳叢集。(3) AWS PrivateLink 將請求傳送至該叢集,無論它位於同一個區域還是另一個區域;(4) 叢集的 Inference Gateway 再像現時一樣,將請求路由至模型 Pod。
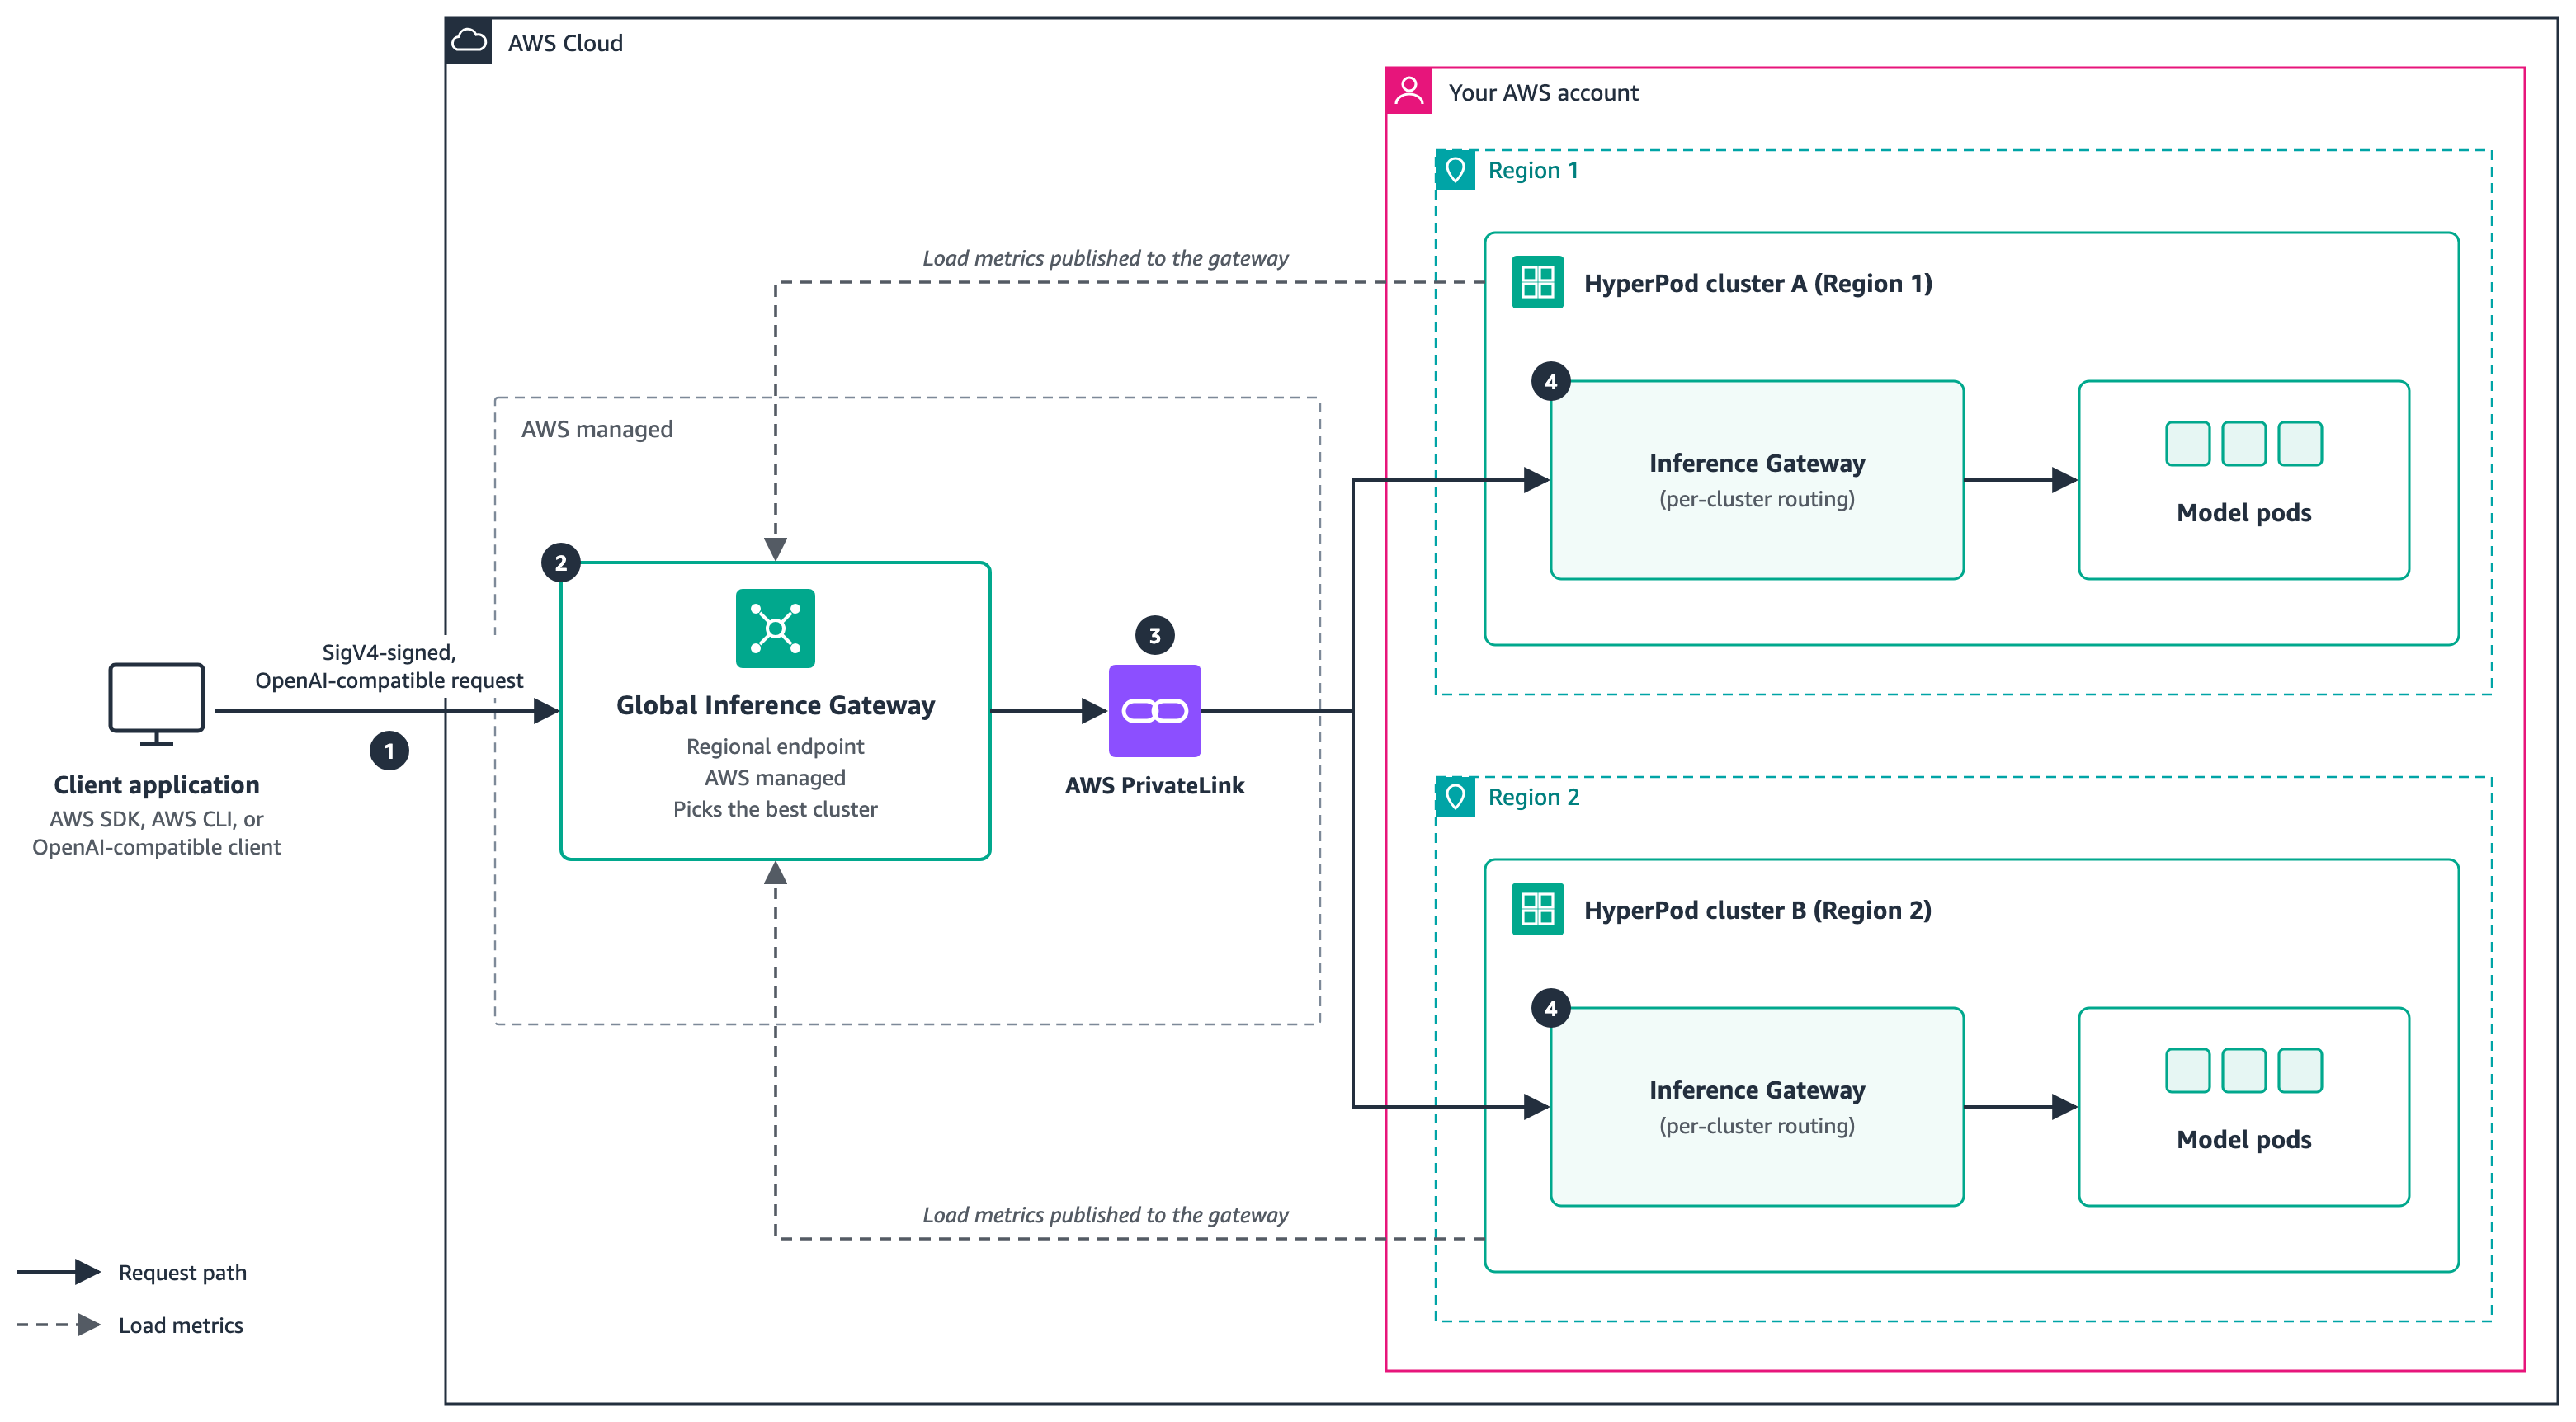
圖 1:Global Inference Gateway 在單一區域端點接收每個請求,並透過 AWS PrivateLink 將請求轉送至最佳的 HyperPod 叢集;該叢集的 Inference Gateway 隨後會將請求路由至模型 Pod。每個叢集都會將其負載回報至閘道。
AWS 負責運作的部分
你可以決定要發佈哪些叢集、要將哪些叢集編組至同一個閘道後方,以及如何設定路由權重。其餘部分由 AWS 負責運作:
- 路由伺服器羣組。SageMaker 會佈建並運作伺服器羣組,負責終止 TLS、驗證呼叫者、為叢集評分,以及轉發每個請求。
- 私有連線。SageMaker 會為每個叢集建立一個私有端點,並透過 AWS 骨幹網絡傳送流量,支援區域內及跨區域連線。
- 憑證與驗證。服務會使用你建立的執行角色,讀取每個叢集的 VPC 端點服務名稱、憑證及區域,因此你無須手動複製這些資料。服務會在路由流量前先檢查這些資料。
- 健康狀態與容錯移轉。閘道會對每個叢集進行健康狀態檢查,並在叢集故障時自動將流量切離。詳情請參閲「操作閘道」一節。
- 驗證與速率限制。閘道會檢查 SigV4 簽章、IAM 權限及速率限制,並在任何叢集收到請求前拒絕未通過檢查的請求。
每個叢集上都有一個由服務管理、具備自身 IAM 角色的指標發佈器,負責將叢集負載傳送至閘道。
閘道如何挑選叢集
每個請求都會由閘道根據四項訊號為所有運作正常的叢集評分,並將請求傳送至得分最高的叢集。每個叢集的指標發佈器會提供負載訊號。
你可以透過路由權重控制各訊號所佔比重。每個權重的值介乎 0.0 至 1.0,權重為 0 代表關閉該訊號。若設定權重,必須設定全部四項,而且總和必須為 1.0。若不設定,則會套用下表中的預設值。
| 權重 | 評分項目 | 預設值 |
KVHeadroom |
叢集上可用的 KV 快取和 GPU 記憶體 | 0.20 |
QueueDepth |
叢集的積壓程度 | 0.25 |
RegionProximity |
叢集與閘道所在 Region 之間的距離 | 0.40 |
ErrorRate |
叢集近期的失敗請求 | 0.15 |
預設值會優先選擇靠近閘道所在 Region 的叢集,同時仍會把流量導向有可用容量的叢集,並避開發生故障的叢集。若你的工作負載更重視韌性而非距離,請提高 ErrorRate 並降低 RegionProximity。例如,以下路由區塊將近期錯誤的權重設為 0.7:
{"Weights": {"KVHeadroom": 0.1, "QueueDepth": 0.1, "RegionProximity": 0.1, "ErrorRate": 0.7}}你可在 CreateGlobalInferenceGateway 的 Routing 參數中傳入權重,之後亦可使用 UpdateGlobalInferenceGateway 更改。
選擇你的起點
你的部署方式取決於目前的運作方式。若你透過單一叢集提供服務,請繼續使用該叢集的 Inference Gateway 端點。新增第二個叢集後,便可改用 Global Inference Gateway。
| 起點 | 操作 | 結果 |
| Inference Gateway 在每個叢集上運作,例如在 us-east-1 和 us-west-2 的五個叢集上執行四個模型 | 更新附加元件、發佈每個叢集,並建立閘道 | 所有叢集共用一個端點。遷移用戶端期間,各叢集端點仍會繼續提供服務。 |
| 已安裝 HyperPod Inference 附加元件,但 Inference Gateway 已關閉 | 只需更新一次附加元件,並為每個叢集設定一次 InferenceGatewayConfig,即可啟用 Inference Gateway;為每個模型新增一個排程器,然後按照第一列的步驟操作 |
每個模型各自的端點整合為一個 |
| 在兩個 Region 擁有 GPU 容量,但尚未設定 HyperPod Inference | 在每個 Region 建立一個 HyperPod 叢集,並安裝 HyperPod Inference 附加元件;部署模型、啟用 Inference Gateway,然後按照第一列的步驟操作 | 從第一天起即有單一端點,流量路由可微調;即使某個 Region 發生問題,服務仍會繼續提供 |
開始使用
如要設定 Global Inference Gateway,請先準備每個叢集、建立執行角色,然後呼叫 CreateGlobalInferenceGateway。接著,向閘道端點傳送以 SigV4 簽署、兼容 OpenAI 的請求。如需逐步指示,包括 IAM 角色和政策,請參閲 AWS 説明文件。
安全與存取
每個傳送至閘道的請求都必須以 SigV4 簽署,並透過 IAM 授權。呼叫端必須獲準呼叫閘道,而串流請求則使用專屬操作:
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Action": [
      "sagemaker:InvokeGlobalInferenceGateway",
      "sagemaker:InvokeGlobalInferenceGatewayWithResponseStream"
    ],
    "Resource": "arn:aws:sagemaker:<region>:<account-id>:global-inference-gateway/<gateway-id>"
  }]
}
將此政策附加至每個發出請求的 IAM 身分。如要允許使用帳戶中的所有閘道,請將 global-inference-gateway/* 用作資源。
執行角色遵循最小權限原則。它只能查詢你列出的叢集,只能存取這些叢集的 Amazon Elastic Kubernetes Service (Amazon EKS) API,並且只可讀取 TLS 儲存貯體中 gig/ 前綴下、標記為由 HyperPod Inference 建立的路由憑證。
身分權杖。如果你的叢集會檢查 JSON Web Token(JWT),請使用 --customer-identity-token 傳送權杖(X-Amzn-SageMaker-Customer-Identity-Token 標頭),不要加上 Bearer 前綴。權杖會隨 SigV4 簽章傳送,因此未簽署的權杖會被拒絕並返回 403,而重複的權杖則會返回 400。所有提供模型服務的叢集都必須啟用 JWT 檢查,或全部都不啟用,避免請求在一個叢集成功、在另一個叢集失敗。
如圖 1 所示,請求只會經由 AWS PrivateLink 到達你的叢集。閘道不會記錄或儲存提示詞或生成內容。
操作閘道
以下是設定閘道的步驟。
新增叢集
按照文件所述,準備新叢集,並在該叢集上建立執行角色的 EKS 存取項目。此外,將新叢集加入執行角色權限政策中 Resource 清單。然後在閘道所在的區域呼叫 AddInferenceGateway,即使新叢集位於另一個區域也一樣:
aws sagemaker add-inference-gateway \
  --identifier <gateway-name> \
  --region <region> \
  --cluster-arn arn:aws:sagemaker:<region-3>:<account-id>:cluster/<cluster-id-3> \
  --name <gateway-config-name-3> \
  --namespace inference-gateway
閘道會驗證叢集,並在叢集狀態正常後開始向其路由流量。端點、其他叢集和用戶端均不受影響。
卸離叢集
在閘道所在的區域呼叫 RemoveInferenceGateway:
aws sagemaker remove-inference-gateway \
  --identifier <gateway-name> \
  --region <region> \
  --cluster-arn arn:aws:sagemaker:<region-3>:<account-id>:cluster/<cluster-id-3> \
  --name <gateway-config-name-3> \
  --namespace inference-gateway
閘道會停止向該叢集傳送新請求,讓在途請求完成,並移除私有端點。閘道至少會保留一個叢集。若要完全撤出該叢集,請在其 InferenceGatewayConfig 中設定 globalRouting.enabled: false,然後重新套用。
刪除閘道
呼叫 DeleteGlobalInferenceGateway:
aws sagemaker delete-global-inference-gateway \
  --identifier <gateway-name> --region <region>
閘道端點會停止提供服務,而每個叢集的端點會繼續提供服務。刪除閘道後,請使用 globalRouting.enabled: false 撤出每個叢集,然後刪除執行角色,以及你為全域路由新增的 IAM 權限。
下表概述常見事件和變更對流量的影響。
| 事件 | 會發生甚麼事 | 你要做甚麼 |
| 閘道建立失敗 | 閘道狀態會變為 FAILED,而 FailureReason 會説明失敗原因,例如憑證名稱不符 |
修正原因。若要查看每個叢集的狀態,請呼叫 ListInferenceGateways。 |
| 叢集故障 | 流量會轉至次佳叢集;故障叢集恢復後,流量會逐步迴流至該叢集。除非請求已開始串流,否則失敗的請求會在另一個叢集上重試一次。如果沒有健康的叢集,閘道會返回 503。 | 無需採取任何措施。用戶端無須作出任何變更。 |
| 變更路由權重 | 新請求會採用新權重,而在途請求則會按舊權重完成。不會重新佈建任何資源。 | 呼叫 UpdateGlobalInferenceGateway |
| 新增叢集 | 叢集狀態正常後便會開始路由流量。其他方面不會有任何變更。 | 請參閲「新增叢集」 |
| 卸離叢集 | 閘道會停止傳送新請求,並讓在途請求完成 | 請參閲「卸離叢集」 |
| 刪除閘道 | 閘道端點會停止提供服務,而每個叢集的端點會繼續提供服務 | 請參閲「刪除閘道」 |
如需故障排除協助,請參閲故障排除指南。
最佳做法及注意事項
- 發佈前先規劃羣組。決定每個閘道後方要連接哪些叢集,並在所有應共用某模型流量的叢集上使用相同的
modelName。如果希望尖峯流量能溢流至其他區域,請確保兩個區域的叢集均預留充足容量。 - 只發佈已加入閘道的叢集。已發佈但未加入任何閘道的叢集不會接收流量,但其 Network Load Balancer 仍會運作並產生費用。
- 涵蓋所有模型。
InferenceGatewayConfig中的每個排程器會將模型名稱對應至提供該模型服務的 Pod。未列於任何排程器中的模型無法透過閘道存取,對該模型的請求會返回 404 錯誤。 - 確保附加元件設定完整。 使用
--resolve-conflicts OVERWRITE時,不完整的設定可能會重設負載平衡器或 TLS 設定。每次都以目前的設定為起點。 - 傳入
--context,並在每個kubectl命令中使用。 您需要在多個叢集之間操作,因此請確保每個命令都在您指定的叢集上執行。 - 如有需要,請將工作負載保留在同一個區域。 建立一個只納入該區域內叢集的閘道。
結論
本文介紹了 Amazon SageMaker HyperPod Global Inference Gateway:透過單一由 SageMaker 管理的端點,連接同一個或多個區域中的 HyperPod 叢集。閘道會根據 KV 快取餘量、佇列深度、與區域的距離及錯誤率選擇叢集,並在叢集故障時將流量轉離該叢集,無需更改用戶端。
Global Inference Gateway 目前在 13 個 AWS 區域提供服務:美國東部(北維吉尼亞)、美國東部(俄亥俄)、美國西部(北加州)、美國西部(奧勒岡)、南美洲(聖保羅)、歐洲(法蘭克福)、歐洲(愛爾蘭)、歐洲(倫敦)、歐洲(斯德哥爾摩)、亞太地區(東京)、亞太地區(孟買)、亞太地區(新加坡)及亞太地區(悉尼)。
如要開始使用,請參閲AWS 文件。
關於作者

Dmitry Soldatkin
Dmitry 是 AWS Amazon SageMaker AI Inference 專業解決方案架構全球主管。他協助客戶設計、建構及最佳化生成式 AI 和機器學習方案,專注於推理效能最佳化、深度學習,以及在企業內擴展機器學習。他曾在金融服務、保險及電訊公司擔任領導職務。

Aryaman Kothari
Aryaman 是 Amazon SageMaker AI 的資深產品經理,負責 Amazon SageMaker HyperPod 上的 AI 推理,協助企業大規模執行 AI 模型,以支援正式環境工作負載。Aryaman 畢業於 Chicago Booth,曾負責 Quantiphi 對話式 AI 業務的產品及市場推廣。在工作以外,他喜歡踢足球、沖煮 chai 和行山。

Piyush Daftary
Piyush 是 Amazon SageMaker AI 的首席軟件工程師,負責建構高效能、可擴展的大型語言模型推理系統,包括 SageMaker HyperPod Global Inference Gateway。他熱衷於解決複雜的分散式系統挑戰,並令生成式 AI 推理更快速、更具成本效益。他的技術興趣包括大規模模型服務、GPU 效率及分散式推理。在工作以外,他喜歡旅遊、行山及與家人共度時光。
來源:AWS Machine Learning Blog · aws.amazon.com