Amazon Bedrock Managed Knowledge Base 支援表格搜尋
Get answers from tables with tabular search in Amazon Bedrock Managed Knowledge Base
Amazon Bedrock Managed Knowledge Base 現已支援表格搜尋,可透過 AgenticRetrieveStream 請求結合 CSV、XLSX 或 XLS 表格計算與相關文件資訊,回答分析問題。
文章以財務政策、結賬備忘錄及 P&L 活頁簿示範如何結合文件規則與全表計算,並透過追蹤記錄查看程式讀取的檔案。
Amazon Bedrock Managed Knowledge Base 現在支援表格搜尋,因此你可以透過代理式檢索從表格取得答案。當問題需要從 CSV、XLSX 或 XLS 檔案取得數據時,表格搜尋會查找數值,並在一個或多個表格或工作表中,對所有相關資料列執行計算。然後,它會結合相關文件中的事實,回答需要多步驟分析的問題。
正在結算季度的財務團隊需要知道:「哪些部門必須撰寫差異説明?」沒有任何單一檔案包含答案。答案取決於差異政策的門檻、季度結算備忘錄中的預算修訂,以及對損益 (P&L) 工作簿中每個部門的數據進行計算。
跟這支財務團隊一樣,大部分團隊都會把敍述性內容和數據存放在同一處。例如,Microsoft SharePoint 網站會把工作簿和政策文件放在一起,而 Amazon Simple Storage Service (Amazon S3) 儲存貯體則會把 CSV 匯出檔和 PDF 放在一起。表格搜尋可透過你現時用於文件的同一個 AgenticRetrieveStream 請求,回答涵蓋這些檔案的問題。它會在隔離的沙盒中執行程式碼來讀取原始檔案,因此答案會運用整個表格,而不只是檢索返回的資料列。對財務團隊而言,一個請求便會返回必須撰寫差異説明的部門。答案會引用政策文件和備忘錄,而執行追蹤會列出程式碼讀取的工作簿。
在本文中,你會瞭解表格搜尋如何回答同時需要表格數據和文件資訊的問題,以及在甚麼情況下使用其他工具會更合適。你也會使用財務範例檔案建立知識庫,並透過執行追蹤查看程式碼讀取了哪個檔案。
為何表格難以檢索
檢索增強生成 (RAG) 會返回固定數量、與問題最相符的段落,這種做法很適合處理文字內容。表格拆分成段落時會遺失資訊,而資訊遺失的方式取決於表格的形狀:
- 長表格 – 有數千列的表格會分散在許多段落中,而檢索只會返回少數最符合問題的段落。根據這些段落生成的答案只會用到少量資料列,因此總和、比較或門檻檢查可能不完整。
- 寬表格 – 在有數百個欄位的表格中,單一資料列所含的文字可能多於一個段落的容量,或超出搜尋模型一次可處理的內容。因此,較後面的欄位中的數值較難配對。寬表格拆分而成的長段落也可能與許多不相關的問題相符,令更相關的段落被排除在結果之外。
檢索還需要把問題配對到正確的表格。問題會使用「可控支出」等業務用語,但表格中可能只有成本中心代碼、帳戶名稱和數字。對搜尋系統而言,草稿和最終版工作簿看起來幾乎一樣。賦予數字意義的規則往往載於另一份文件,例如政策文件。
因此,表格搜尋會把工作拆開處理。檢索只需從正確的表格檔案中返回一個段落,程式碼便會讀取整個表格。由於檢索仍須先找到該檔案,在問題中寫出檔案名稱會有幫助。
表 1 展示一般檢索和透過表格搜尋進行的代理式檢索,如何分別回答財務團隊的問題:「哪些部門必須撰寫差異説明?」
| 比較項目 | 僅使用檢索 | 透過表格搜尋進行代理式檢索 |
| 返回的內容 | 來自政策文件、備忘錄、業務檢討和工作簿的段落,但沒有完整答案 | 列出銷售部、工程部及營運部,並列明各部門相對修訂預算差異的答案 |
| 修訂後的差異百分比 | 無法提供。沒有檔案儲存這些數值,因此沒有任何片段會包含這些數值 | 根據最終工作簿中每個部門的資料列計算 |
| 來源 | 每個片段都連結至對應檔案,但沒有任何檔案包含答案 | 引用財務政策及結賬備忘錄。追蹤記錄列出程式碼讀取的工作簿 |
表 1:使用一般檢索與表格搜尋處理相同問題。
智能體式檢索中的表格搜尋如何運作
在智能體式檢索中,智能體會使用檢索來判斷哪些文件與問題相關,然後撰寫答案。表格搜尋是這個流程的一部分,因此無需啟用任何功能。
當問題需要使用表格中的資料時,請求會經過以下階段:
- 檢索 – 系統會返回片段,包括來自表格檔案的片段。
- 規劃 – 智能體會根據問題及表格結構,判斷是否要對一個或多個已檢索的表格執行程式碼。
- 暫存 – 表格搜尋會將原始檔案複製到無法存取網絡的隔離沙盒中。
- 計算 – 模型編寫的程式碼會對整個表格或工作表執行。
- 返回 – 智能體只會收到程式碼輸出的內容,例如總計或符合條件的資料列。
- 回答 – 智能體會根據結果及片段作答,並附上引用。
當已檢索的片段來自 CSV、XLSX 或 XLS 檔案,而問題需要計算多個資料列的數值或查找特定值時,便會使用表格搜尋。
知識庫、連接器及 API
AgenticRetrieveStream 請求可以搜尋一個或多個知識庫。Retrieve API 會持續返回片段,而且不會執行程式碼。
無論透過哪個連接器將檔案匯入知識庫,表格搜尋的運作方式都相同,包括 Amazon S3、Microsoft SharePoint、Atlassian Confluence 等連接器。
適用範圍與取捨
表格搜尋適用於需要對檢索到的表格檔案進行計算或查找的問題。執行程式碼至少會多一個智能體回合,因此使用表格資料作答會比純文字答案花更長時間。受管治的指標、定期儀錶板、數據倉庫級別的聯結及報告管控,仍應使用商業智能(BI)工具。表格搜尋可處理與文件一同儲存的表格檔案,而且無需定義結構描述。
解決方案概覽
在此解決方案中,Amazon Bedrock Managed Knowledge Base 會將 CSV 和 Excel 檔案與相關文件(例如 PDF 和 Word 檔案)一同儲存。應用程式會透過智能體式檢索處理每個問題。當問題需要表格資料時,答案會結合表格計算結果與文件中的事實。答案會引用所用的片段,而追蹤記錄則會列出程式碼讀取的表格檔案。
在圖 1 中,Amazon S3 資料來源會將這些檔案同步至知識庫;知識庫會保存嵌入向量、文字、中繼資料及原始檔案。當應用程式傳送包含 AgenticRetrieveStream 的問題時,智能體式檢索會規劃工作,並從知識庫檢索片段。如果問題需要表格檔案中的資料,系統會將待讀取的檔案傳送到無法存取網絡的隔離沙盒。在沙盒中,模型編寫的程式碼會對原始檔案執行,並返回輸出結果。答案連同引用及追蹤事件,會以串流方式傳回應用程式。
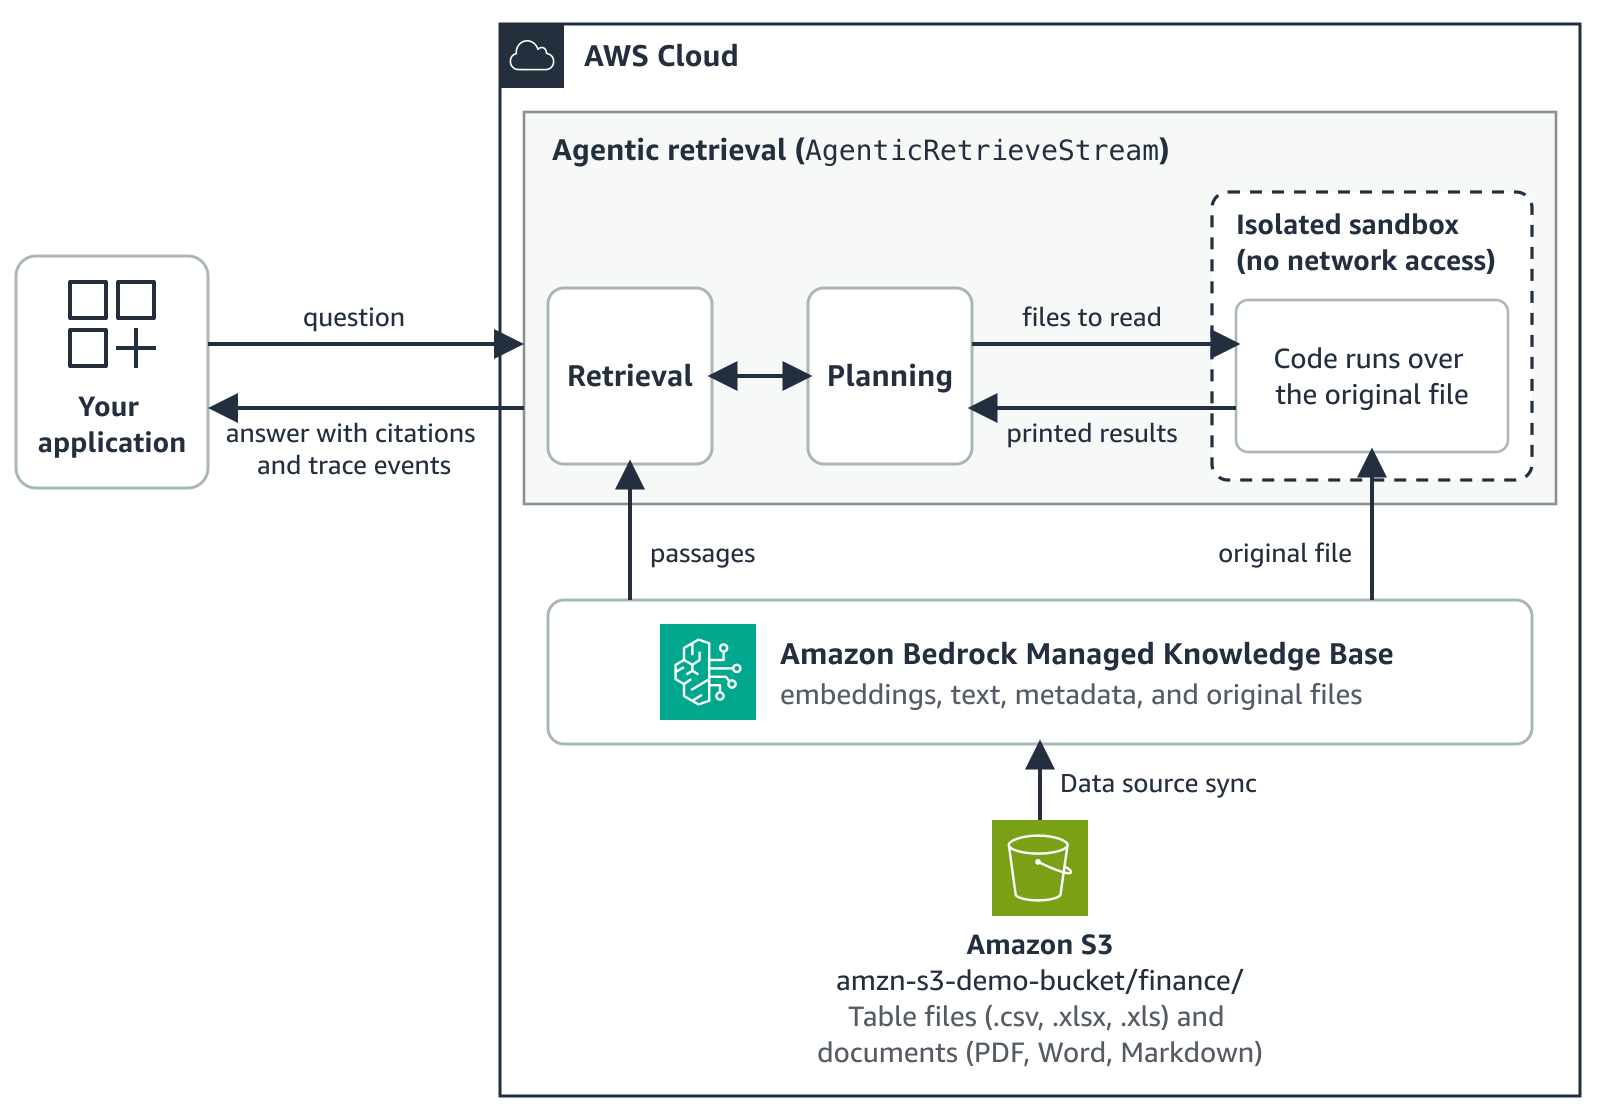
圖 1:Amazon Bedrock 管理式知識庫中的表格檔案和文件,以及代理式檢索中的表格搜尋。
以下範例使用 AnyCompany Retail 的虛構財務檔案:
- 最終損益活頁簿(
anycompany-pnl-fy2026.xlsx)。內有 Notes、Actuals、Budget 和 Summary 工作表;Actuals 和 Budget 工作表中,每一列對應一個月份、成本中心和會計科目。 - 草稿活頁簿。初步版本,Q3 數字不同。
- 財務差異政策(PDF)。界定可控支出和核準預算,並訂明審核門檻。
- Q3 結算備忘錄(Word)。列出已核准及遭拒的預算修訂。
- 業務檢討(Markdown)。説明主要差異。
這些檔案位於 sample-managed-knowledge-base-patterns GitHub 儲存庫的 tabular-search 資料夾。資料夾亦包含一個 AWS Cloud Development Kit(AWS CDK)應用程式,用來部署本文中的資源,以及用來提出這些問題的 Python 指令碼。
先決條件
你需要具備以下條件:
- 具備建立 AWS Identity and Access Management(IAM)角色、S3 儲存貯體和 Amazon Bedrock 知識庫的權限。
- 對於呼叫
AgenticRetrieveStream的身分,須具備代理式檢索所需的權限,包括bedrock:GetDocumentContent。Agent 會使用呼叫者的憑證讀取原始表格檔案。 - 在支援表格搜尋的 AWS 區域中使用 Amazon Bedrock。如需瞭解支援的區域,請參閲支援的 AWS 區域。
- 你自己的 CSV、XLSX 或 XLS 檔案及相關文件。
- 如要跟隨本教學操作:Python 3.10 或更新版本,以及 1.43.123 或更新版本的 AWS SDK for Python(Boto3)。你亦可在 Amazon Bedrock 主控台的知識庫測試視窗,或使用 AWS Command Line Interface(AWS CLI)提出問題。
呼叫身分需要代理式檢索文件中列出的以下政策:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "bedrock:AgenticRetrieveStream",
      "Resource": "*"
    },
    {
      "Effect": "Allow",
      "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
      "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/*"
    },
    {
      "Effect": "Allow",
      "Action": "bedrock:InvokeModelWithResponseStream",
      "Resource": "*"
    }
  ]
}如需瞭解費用,請參閲Amazon Bedrock 定價。
將檔案上傳至 Amazon S3
將表格檔案和相關文件放在同一個前綴下。
- 開啟 Amazon S3 主控台,然後選擇 建立儲存貯體。
- 輸入全球唯一的儲存貯體名稱(本文使用
amzn-s3-demo-bucket),保持選取 封鎖所有公開存取,然後選擇 建立儲存貯體。 - 選擇該儲存貯體,選擇 建立資料夾,然後輸入
finance。 - 開啟
finance資料夾,然後選擇 上傳。 - 選擇 新增檔案,選取你的表格檔案和文件,然後選擇 上傳。
建立知識庫和資料來源
知識庫需要一個 Amazon Bedrock 可擔任的 IAM 角色。此信任政策只允許 bedrock.amazonaws.com 服務主體,而且只限於你帳戶中的知識庫。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "BedrockKnowledgeBaseAssume",
      "Effect": "Allow",
      "Principal": {"Service": "bedrock.amazonaws.com"},
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {"aws:SourceAccount": "111122223333"},
        "ArnLike": {
          "aws:SourceArn": "arn:aws:bedrock:<region>:111122223333:knowledge-base/*"
        }
      }
    }
  ]
}
接著,設定其餘資源:
- 建立一個名為
kb-finance-role的角色,並套用該信任政策。 - 附加一項內嵌政策,允許對儲存貯體執行
s3:ListBucket,並對其中的物件執行s3:GetObject。 - 建立類型為
MANAGED、使用管理式嵌入模型的知識庫。 - 為該儲存貯體建立
MANAGED_KNOWLEDGE_BASE_CONNECTOR資料來源,並將範圍限定在finance/前綴。 - 將
maxFileSizeInMegaBytes設定為大於你最大檔案的值。
步驟 2 的內嵌政策只允許讀取此儲存貯體:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "ListBucket",
      "Effect": "Allow",
      "Action": "s3:ListBucket",
      "Resource": "arn:aws:s3:::amzn-s3-demo-bucket",
      "Condition": {"StringEquals": {"aws:ResourceAccount": "111122223333"}}
    },
    {
      "Sid": "ReadObjects",
      "Effect": "Allow",
      "Action": "s3:GetObject",
      "Resource": "arn:aws:s3:::amzn-s3-demo-bucket/*",
      "Condition": {"StringEquals": {"aws:ResourceAccount": "111122223333"}}
    }
  ]
}
此指令碼會執行步驟 3 至 5,並列印 ID:
import time
import boto3

agent = boto3.client("bedrock-agent")

kb = agent.create_knowledge_base(
    name="finance-kb",
    roleArn="arn:aws:iam::111122223333:role/kb-finance-role",
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {"embeddingModelType": "MANAGED"},
    },
)
kb_id = kb["knowledgeBase"]["knowledgeBaseId"]

# Wait until the knowledge base is ACTIVE before adding a data source.
status = "CREATING"
while status in ("CREATING", "UPDATING"):
    time.sleep(10)
    status = agent.get_knowledge_base(knowledgeBaseId=kb_id)["knowledgeBase"]["status"]
if status != "ACTIVE":
    raise RuntimeError(f"Knowledge base status is {status}")

ds = agent.create_data_source(
    knowledgeBaseId=kb_id,
    name="finance-s3",
    dataSourceConfiguration={
        "type": "MANAGED_KNOWLEDGE_BASE_CONNECTOR",
        "managedKnowledgeBaseConnectorConfiguration": {
            "connectorParameters": {
                "type": "S3",
                "version": "1",
                "connectionConfiguration": {
                    "bucketName": "amzn-s3-demo-bucket",
                    "bucketOwnerAccountId": "111122223333",
                },
                "filterConfiguration": {
                    # In MB. Set this above your largest table.
                    "maxFileSizeInMegaBytes": "200",
                    "inclusionPrefixes": ["finance/"],
                },
                "aclEnabled": False,
            }
        },
    },
    vectorIngestionConfiguration={
        "parsingConfiguration": {"parsingStrategy": "SMART_PARSING"}
    },
)
print("knowledge base:", kb_id, "data source:", ds["dataSource"]["dataSourceId"])
同步資料來源並檢查檔案類型
只有知識庫為檔案指定正確的檔案類型後,才能開始表格搜尋,因此請在首次同步後檢查檔案類型。
- 啟動資料來源的擷取工作。
- 持續查詢工作,直到其狀態為
COMPLETE。 - 查看工作統計資料,檢查是否有文件處理失敗。
- 使用你的問題執行
Retrieve呼叫。 - 確認表格段落會將
_file_type顯示為CSV(CSV 檔案)或MS_EXCEL(XLSX 和 XLS 檔案)。
第一個指令碼會執行第 1 至 3 步:
import time
import boto3

agent = boto3.client("bedrock-agent")
KB_ID, DS_ID = "<your-knowledge-base-id>", "<your-data-source-id>"

job_id = agent.start_ingestion_job(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)[
    "ingestionJob"]["ingestionJobId"]
while True:
    job = agent.get_ingestion_job(
        knowledgeBaseId=KB_ID, dataSourceId=DS_ID, ingestionJobId=job_id
    )["ingestionJob"]
    if job["status"] in ("COMPLETE", "FAILED", "STOPPED"):
        break
    time.sleep(15)
print(job["status"], job.get("statistics"), job.get("failureReasons"))
第二個指令碼會執行第 4 和第 5 步,讓你在使用 Agentic retrieval 提問前,先檢查表格檔案類型。使用自己的檔案時,提出一個問題,將其中一份文件的規則與對表格的計算結合起來,並註明兩者的名稱。
import boto3

runtime = boto3.client("bedrock-agent-runtime")
question = (
    "In fiscal Q2 of FY2026, which cost center had the largest overspend in "
    "controllable spend, as the finance policy defines it? Compare the Actuals "
    "and Budget sheets of the FY2026 P&L workbook and give the cost center and "
    "the overspend in US dollars."
)
response = runtime.retrieve(
    knowledgeBaseId="1234567890",
    retrievalQuery={"text": question},
    retrievalConfiguration={"managedSearchConfiguration": {"numberOfResults": 10}},
)
for result in response["retrievalResults"]:
    print(result["metadata"].get("_file_type"), result.get("documentId"))
提出跨表格和文件的問題
透過 AgenticRetrieveStream 傳送相同問題。指令碼會列印答案、每個 CodeExecution 狀態,以及程式碼讀取的檔案。
import boto3

runtime = boto3.client("bedrock-agent-runtime")
question = (
    "In fiscal Q2 of FY2026, which cost center had the largest overspend in "
    "controllable spend, as the finance policy defines it? Compare the Actuals "
    "and Budget sheets of the FY2026 P&L workbook and give the cost center and "
    "the overspend in US dollars."
)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": question}}],
    retrievers=[{"configuration": {"knowledgeBase": {"knowledgeBaseId": "1234567890"}}}],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
    },
)

for event in response["stream"]:
    if "traceEvent" in event:
        attributes = event["traceEvent"]["attributes"]
        # CodeExecution steps report IN_PROGRESS, then SUCCEEDED or FAILED.
        if attributes.get("step") == "CodeExecution":
            print(attributes["status"], attributes.get("message"))
        # A Planning event lists the files the code will read.
        for action in attributes.get("actions", []):
            for doc in action.get("codeExecution", {}).get("documents", []):
                print("code read:", doc["documentId"])
    elif "responseEvent" in event:
        print(event["responseEvent"]["text"], end="")
就這些檔案而言,答案結合了兩個活頁簿表格和兩份文件:
- 來自文件。 財務政策將承包商、差旅、軟件和市場推廣計劃科目定義為可控開支,因此不包括薪金和設施開支。業務檢討則説明主要差異。
- 來自表格。 程式碼使用 Actuals 和 Budget 工作表中的所有資料列,篩選出財政年度第 2 季及四個科目的資料,然後比較各成本中心。
- 答案。 CC-3010 (Platform) 超支 124,559.90 美元,實際開支為 394,859.90 美元,預算為 270,300.00 美元。業務檢討將這項差異歸因於為數據平台遷移而聘用的承包商。若計算所有營運開支科目,超支金額則為 133,434.05 美元。
查看執行追蹤
追蹤事件依以下次序出現:
- 規劃。 一個狀態為
SUCCEEDED的Planning事件包含一項codeExecution動作,列出程式碼將讀取的文件。 - 程式碼步驟。 一個狀態為
IN_PROGRESS的CodeExecution事件(「正在對 1 份文件執行程式碼」)之後,會出現一個狀態為SUCCEEDED的事件。SUCCEEDED訊息會列出程式碼讀取的每個檔案及其大小。 - 答案。 第二輪規劃和回應文字之後,會出現一個包含引用資料的最終
result事件。引用資料指向答案所用的段落,因此程式碼讀取的表格檔案不一定會列在引用資料中。
在這個例子中,Planning 事件只列出最終活頁簿,因為政策和業務檢討的內容是以檢索段落形式提供。
{
  "traceEvent": {
    "attributes": {
      "step": "Planning",
      "status": "SUCCEEDED",
      "message": "Agent planning completed",
      "actions": [
        {
          "retrieve": {},
          "codeExecution": {
            "documents": [
              {
                "documentId": "s3://amzn-s3-demo-bucket/finance/anycompany-pnl-fy2026.xlsx",
                "sourceRetriever": {"identifier": "1234567890"}
              }
            ]
          }
        }
      ]
    }
  }
}
較長的呼叫中,串流會每 10 秒重複 IN_PROGRESS 事件,因此不會觸發讀取逾時。若程式碼步驟未能完成,會回報 FAILED,Agent 通常會重試或改用後備方案。
表格搜尋屬於回應生成的一部分,而且預設為啟用,因此指令碼不會設定 generateResponse。如果將 generateResponse 設為 false,Agent 會傳回檢索結果而不執行程式碼。詳情請參閲 Agentic retrieval。
試試更多問題
以下每個問題也會結合一份文件和活頁簿。
將備忘錄修訂套用至季度總額
這個問題需要使用只有在備忘錄修訂後才會有的預算:
Did total operating expense for fiscal Q3 of FY2026 stay within the Q3 budget
as revised in the Q3 close memo? Give the actual Q3 operating expense, the
revised Q3 budget and the difference, in US dollars.
答案使用備忘錄中的修訂,以及活頁簿中的第 3 季實際數字和原始預算。開支比修訂後的預算低 49,572.40 美元,因此答案是肯定的,即使同一筆開支高於原始預算也是如此。一般 Retrieve 會傳回備忘錄和活頁簿中的段落,但其中沒有任何一段包含這些數字。
預算修訂後套用政策門檻
以下是引言中財務團隊問題的完整版本。這個問題需要政策中的門檻、備忘錄中的修訂,以及活頁簿:
Applying the budget revisions approved in the Q3 close memo, which
departments must write variance commentary for fiscal Q3 of FY2026 under
the finance policy?
政策規定,差異超出已批准預算(包括已批准修訂)的 5 percent 時,必須提供説明;備忘錄批准增加市場推廣部預算,並削減工程部預算。答案是銷售部 (-6.50 percent)、工程部 (+5.79 percent) 和營運部 (+6.20 percent)。工程部只有在已批准的預算削減後,差異才超出門檻。
繼續對話
表格搜尋亦適用於多輪對話。請在 messages 中傳送較早的對話回合,系統便會在需要使用表格的回合執行。第一條問題要求根據工作簿進行計算:
Calculate the Customer Support department's actual operating expense and its
budget for fiscal Q2 of FY2026 from the Actuals and Budget sheets of the final
FY2026 P&L workbook, in US dollars.
如要提出後續問題,請在 messages 中傳送第一條問題、該問題的答案 ("role": "assistant"),以及新問題:
Under the finance policy, does that variance need written commentary, and does
anyone besides the Controller have to review it?
差異超出預算 12.40 percent,因此需要書面説明。由於超出 10 percent,政策亦要求由財務總監 Nikki Wolf 審核。在這個例子中,第一個回合通常會對工作簿執行程式碼,第二個回合則根據對話記錄回答政策問題。
如要進行較長時間的對話,可以在請求中設定 memoryConfiguration,將對話記錄保存在 Amazon Bedrock AgentCore 記憶體資源中,毋須重新傳送較早的對話回合。如需詳情,請參閲代理式檢索。
表格問題的最佳做法
請仔細措辭提問,因為檢索會選擇程式碼讀取哪個表格。明確指出資料來源的聚焦問題,有助檢索選取正確的表格。
- 將一項規則與一個表格配對。指出載有該規則的文件,例如「以 Q3 結帳備忘錄所作修訂為準」。
- 有多個版本時,請指出檔案名稱。例如:「使用最終版 FY2026 損益表工作簿 anycompany-pnl-fy2026.xlsx。」
- 如需計算,請明確提出。如果摘要工作表載有某個數值,Agent 可以直接根據該數值作答。若要根據詳細資料列進行計算,請説:「根據 Actuals 和 Budget 工作表,計算各部門的差異。」
- 提出聚焦的問題。較大型的分析可分幾個回合進行。
此外,以下資料和應用程式設定亦有幫助:
- 將表格保存在 CSV、XLSX 或 XLS 檔案中。請先從 PDF 或 Word 文件匯出表格。
- 將檔案大小篩選上限設為大於最大表格的大小。大於
maxFileSizeInMegaBytes的檔案不會載入,因此程式碼無法讀取。 - 將 Excel 工作表大小控制在 200 MB 以內。截至本文撰寫時,表格搜尋可對大小不超過 500 MB 的 CSV 檔案執行程式碼;這也是載入上限。但對 Excel 工作表執行程式碼時,大小上限只有 200 MB。較大的 Excel 檔案仍可載入,因此在依賴全表計算前,請先檢查工作表大小。
- 使用表格搜尋進行分析。執行程式碼會增加一個 Agent 回合,因此快速查找文字內容時,請繼續使用一般的
Retrieve。 - 使用中繼資料篩選器限定檔案範圍。在
retrievalOverrides下設定篩選條件,例如按_document_title篩選,可控制程式碼能讀取哪些檔案。 - 透過追蹤記錄進行審核。基於設計考量,系統不會傳回產生的程式碼,因為其中可能會回顯儲存格值。追蹤記錄會顯示程式碼讀取了哪些檔案。
清理
為避免持續產生費用,請依照以下次序刪除資源:
- 在 Amazon Bedrock 主控台中,選擇 知識庫,然後選擇
finance-kb。 - 選取
finance-s3資料來源,然後選擇 刪除。 - 刪除
finance-kb知識庫。 - 在 Amazon S3 主控台中,選取儲存貯體,選擇 清空,然後選擇 刪除;如有其他工作負載使用該儲存貯體,則不要刪除。
- 在 IAM 主控台中,選擇 角色,選取
kb-finance-role,然後選擇 刪除。
如果你使用儲存庫中的 AWS CDK 應用程式進行部署,請改為在其 infra 資料夾中執行 npx cdk destroy,而非按照以下步驟操作。這會刪除堆疊建立的所有內容。
結語
財務團隊成員需要知道:「哪些部門必須撰寫差異説明?」使用 Amazon Bedrock Managed Knowledge Base 的表格搜尋,你只需提出一次代理式檢索請求,就能結合活頁簿、政策文件和備忘錄回答這個問題。
在本文中,你瞭解了表格搜尋如何回答同時需要表格數據和文件內容的問題,以及何時改用其他工具更合適。你也使用財務範例檔案建立了知識庫,並透過追蹤資料查看程式碼讀取了哪個檔案。
如要開始使用,請參閲 Amazon Bedrock 使用者指南中的建立受管理知識庫和代理式檢索,以及 Amazon Bedrock API 參考中的AgenticRetrieveStream。如要了解更多,請閲讀 AWS Artificial Intelligence Blog 上的使用 Amazon Bedrock Managed Knowledge Base 為 Agent 建構企業搜尋。
作者簡介

Josh DeMuth
Josh 是 AWS 的生成式 AI 解決方案架構師。他投身科技業逾 20 年,期間有數年從事系統整合工作,專注於讓不同系統協同運作。現在,他協助客戶運用現有系統和數據建構生成式 AI 應用程式。

Siddhant Sahu
Siddhant 是 AWS 的高級產品經理,也是 Amazon Bedrock Managed Knowledge Base 的唯一專責負責人;作為產品主管,他負責產品策略、路線圖及推出。他構思並推出了產品的代理式檢索功能和應用程式連接器,讓 AI Agent 能夠在 SharePoint、Confluence、S3 等重要商業應用程式的企業數據中執行複雜的搜尋查詢。自服務於 2026 年 6 月推出以來,OpenAI、Syngenta、MRH Trowe、Sony 及其他企業均已採用這項服務,以企業數據建構 AI Agent。

John Minicus
John 是 Software Development Engineer II,負責 Amazon Bedrock Managed Knowledge Base 和 AWS Quick 的檢索功能。他在 AWS 工作的 3 年間,曾負責自然語言解析、數據視覺化,最近則專注於代理式檢索系統及其運作所需的基礎架構。

Inan Tainwala
Inan 是 Amazon Bedrock Managed Knowledge Base 團隊的軟件工程師,負責協助 AI 找到正確答案,避免它發揮創意、憑空捏造答案。他熬過不少深夜追查錯誤、照看 cron 工作,還得勸説金絲雀唱準音調。工作以外,他通常會外出踩單車;他堅稱這只是為了讓自己有理由試遍城中每間新餐廳。
來源:AWS Machine Learning Blog · aws.amazon.com