Amazon Bedrock 開放權重模型現支援顯式提示詞快取
Introducing explicit prompt caching with open-weight models on Amazon Bedrock
Amazon Bedrock 的開放權重模型現已支援顯式提示詞快取,並可透過 Chat Completions API 標記可重用的提示詞前綴。文章以 Python 範例比較隱式與顯式快取,並示範 OpenCode 編碼智能體工作階段如何使用隱式快取及檢視快取用量欄位。快取讀取的費率低於標準輸入,快取寫入費率則視乎模型而定;回應中的用量欄位可用來核對快取讀寫。
文章比較隱式與顯式快取的適用情境,並以 Python 範例展示快取讀寫欄位,再示範 OpenCode 工作階段中的快取讀取。
許多生成式 AI 應用程式每次提出請求時,都會傳送相同的長篇上下文;提示詞快取可避免每次都重新處理這些內容。這些上下文可以是系統提示詞、參考文件、工具定義,或截至目前的對話內容。Amazon Bedrock 上的開放權重模型可以在不同請求之間重用這些內容,有助降低輸入成本及回應延遲。
提示詞快取會重用相符提示詞前綴的運算狀態,讓重複的上下文直接從快取讀取,而不必再次處理。Amazon Bedrock 會代你管理快取。視乎模型而定,你可以使用會自動運作的隱式快取、由你標記可重用前綴的明確快取,或同時使用兩者。重用的上下文越多、重用次數越頻密,節省就越多。
與 Amazon Bedrock 上的其他模型一樣,你的提示詞和輸出內容不會與模型供應商分享,也不會用於訓練模型。如需更多資訊,請參閲《Amazon Bedrock User Guide》中的資料保護。
Amazon Bedrock 上的開放權重模型現已支援明確提示詞快取。本文會透過 Chat Completions API,使用開放權重模型示範兩種模式,並説明如何從每個回應讀取快取用量。接着,我們會在同一 API 上,為 OpenCode 編碼 Agent 工作階段套用隱式快取,最後介紹最佳做法。
Amazon Bedrock 上開放權重模型的提示詞快取
當請求以與先前請求相同的內容開頭時,Amazon Bedrock 會從快取讀取該前綴,只處理其餘內容。快取讀取的收費低於標準輸入,因此每次重用前綴都能增加節省幅度。視乎模型而定,快取寫入的收費可能高於標準輸入。各模型的收費請參閲 Amazon Bedrock 定價。
支援的模式視乎模型和 API 而定。各模型支援的快取模式、前綴最短長度,以及快取項目的保留時間,請參閲模型一覽。兩種模式的比較如下:
| 功能 | 隱式快取 | 明確快取 |
| 請求變更 | 無 | 在 Chat Completions API 上,prompt_cache_options,模式設為 explicit,並加入一個或多個 prompt_cache_breakpoint 標記 |
| 快取內容 | 系統會盡力自動選取符合條件的前綴 | 截至每個斷點(包括該斷點)的內容 |
| 適用情況 | 已以穩定前綴開頭的提示詞,例如對話和 Agent 循環 | 固定的共用前綴搭配會變動的問題,或需要自行控制的分層前綴 |
隱式快取:Amazon Bedrock 會盡力自動重用符合條件的前綴。在對話中,每次請求都會重新傳送完整上下文,因此上一個請求的內容會成為下一個請求的快取前綴(圖 1)。如提示詞快取指南所建議,應把靜態內容放在前面,動態內容放在後面。保持提示詞開頭穩定,便可讓之後的每個請求都重用該部分。如果較前面的內容有所變動,例如圖 1 第 4 輪的情況,快取便會從該處重新建立。
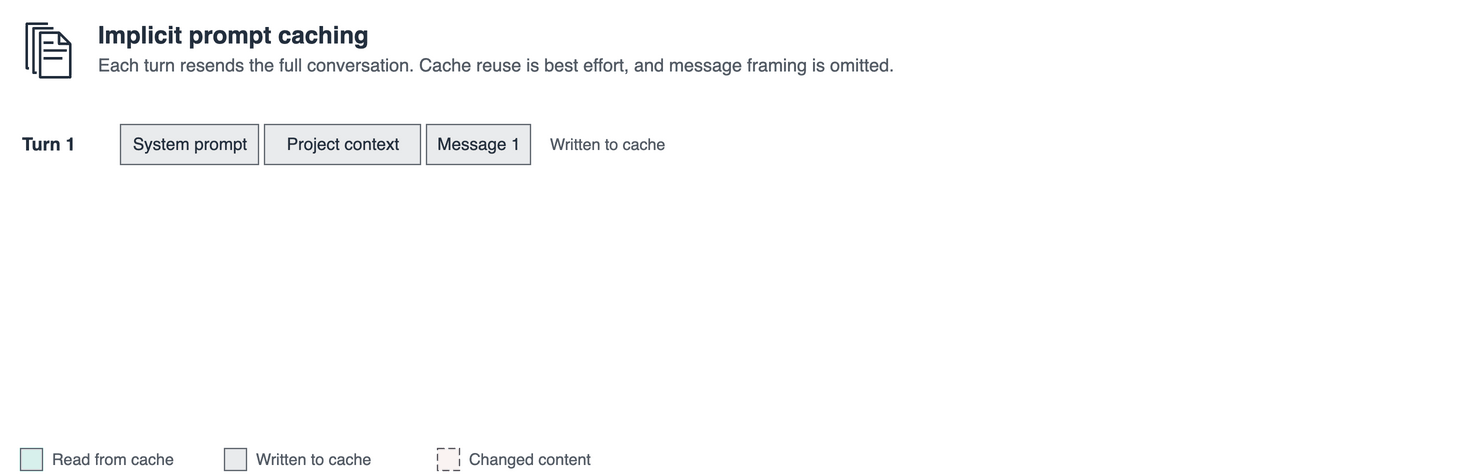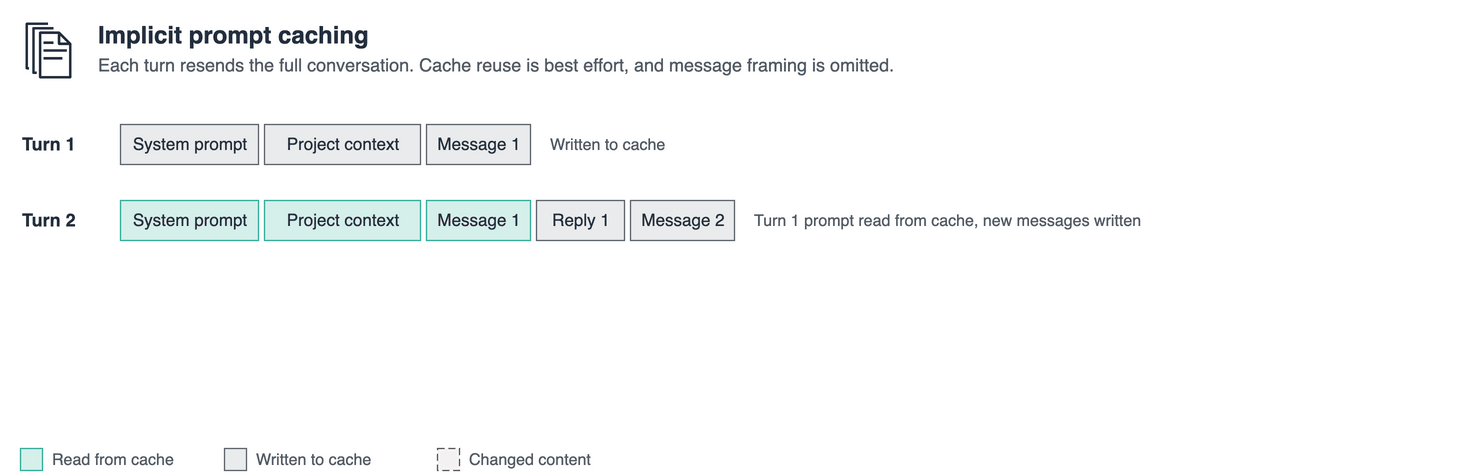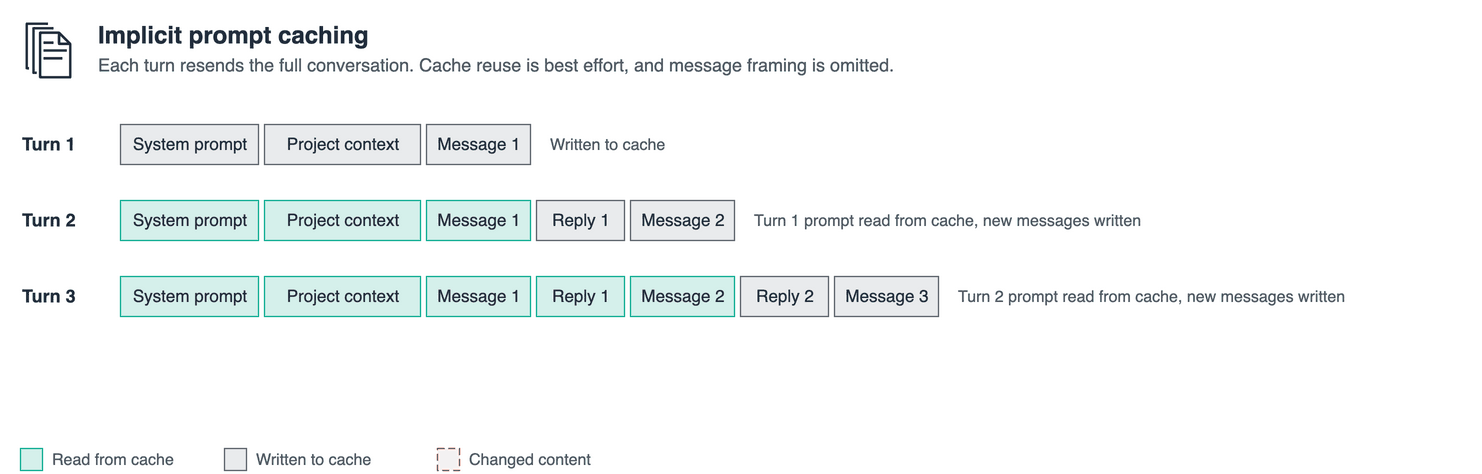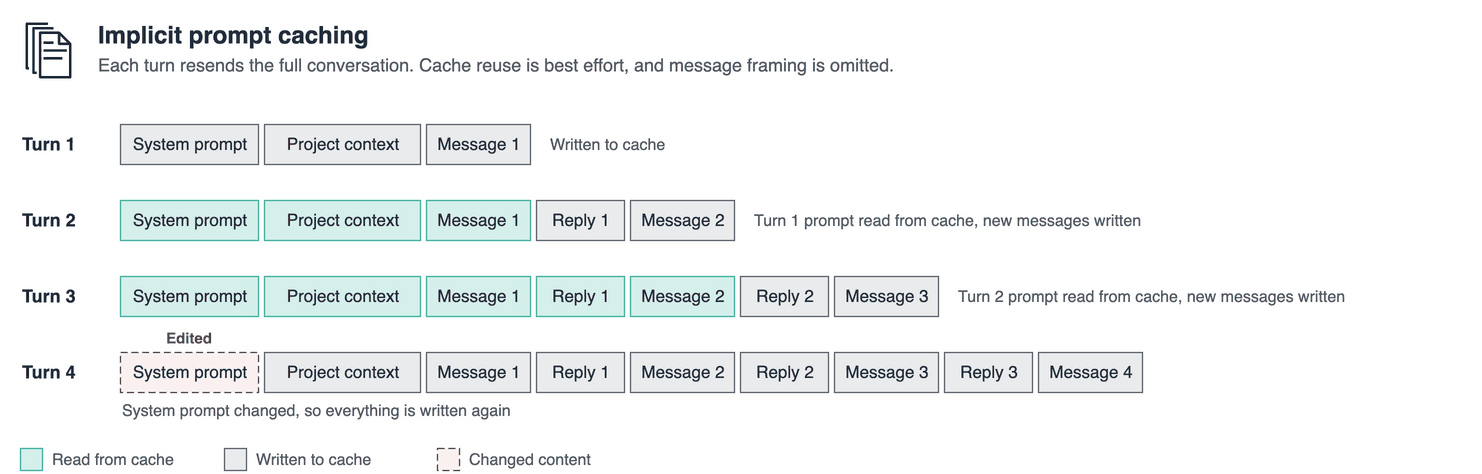
圖 1:對話各輪之間的隱式提示詞快取
明確快取:在每個可重用前綴的末尾標記快取斷點。如圖 2 所示,你可以加入多個斷點,數量上限視乎模型支援情況,讓更新頻率不同的內容分層快取。每個斷點之前的內容只會寫入快取一次,其後的請求會讀取這些內容;最後一個斷點之後的內容則會在每次請求時處理。請查閲模型卡,確認斷點前所需的最少 token 數量、斷點數量上限,以及存活時間(TTL);每次快取命中時,TTL 都會重設。
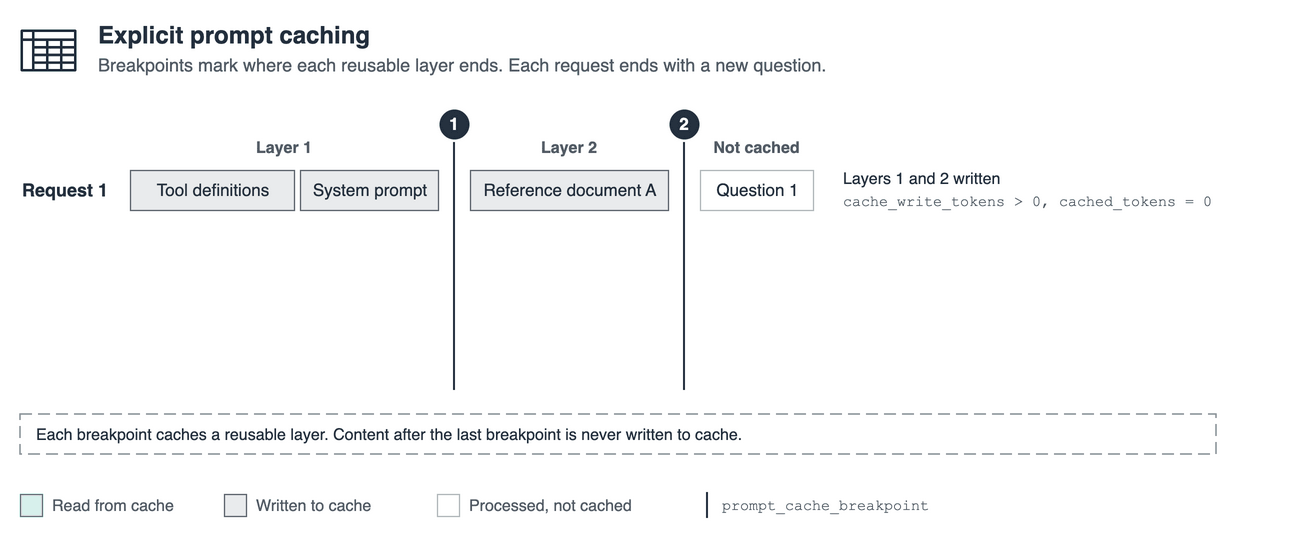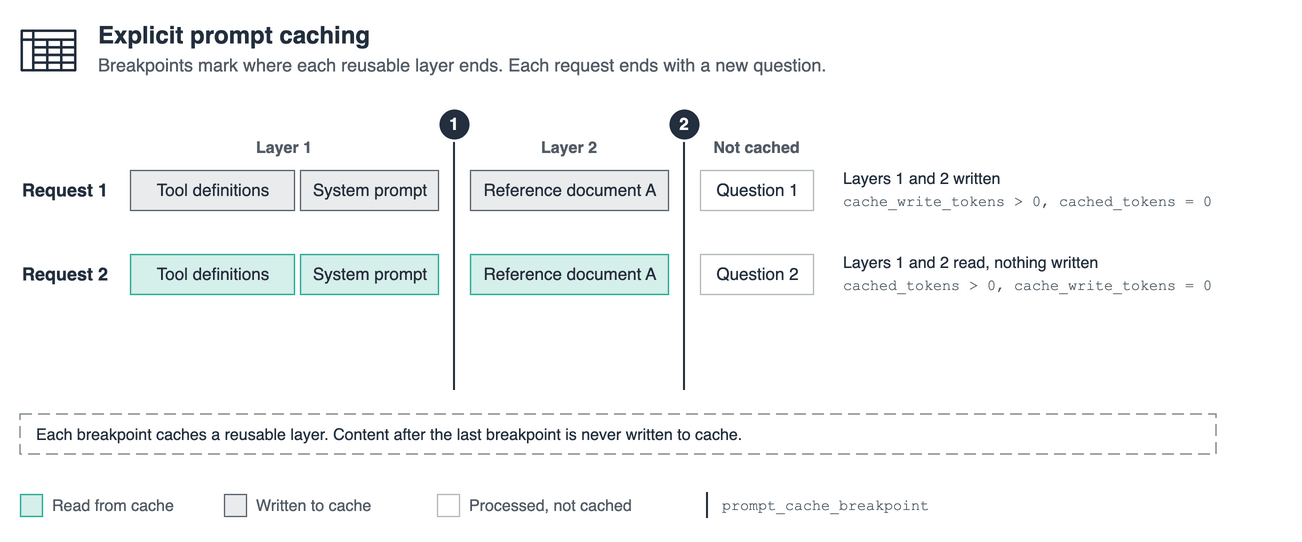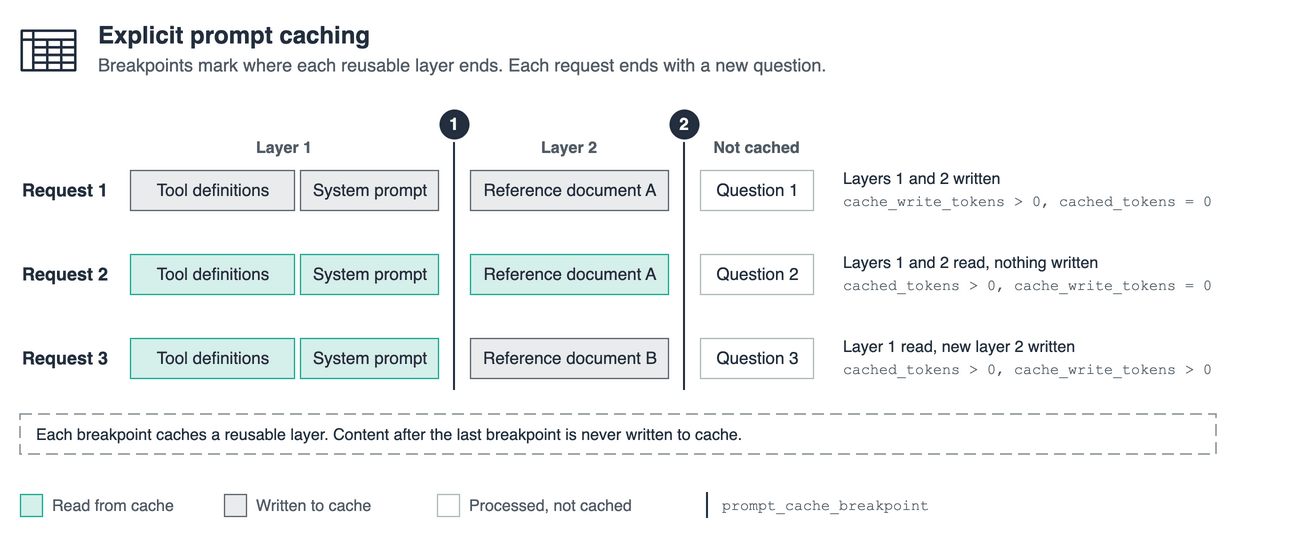
圖 2:在共用前綴之後設置斷點,明確快取提示詞
使用隱式快取時,Amazon Bedrock 亦可能將之後的請求不會重用的內容寫入快取,例如每次都不同的問題。如果共用前綴之後的內容在每次請求中都會改變,請使用明確快取,將快取寫入範圍限制在共用前綴。最後一個斷點之後的內容會按標準輸入費率收費。對於快取寫入費用較高的模型,你無須為從未讀取的內容支付較高的寫入費率。
解決方案概覽
以下圖表展示本文中的兩個範例如何透過同一個 Chat Completions API 端點連接至 Amazon Bedrock。
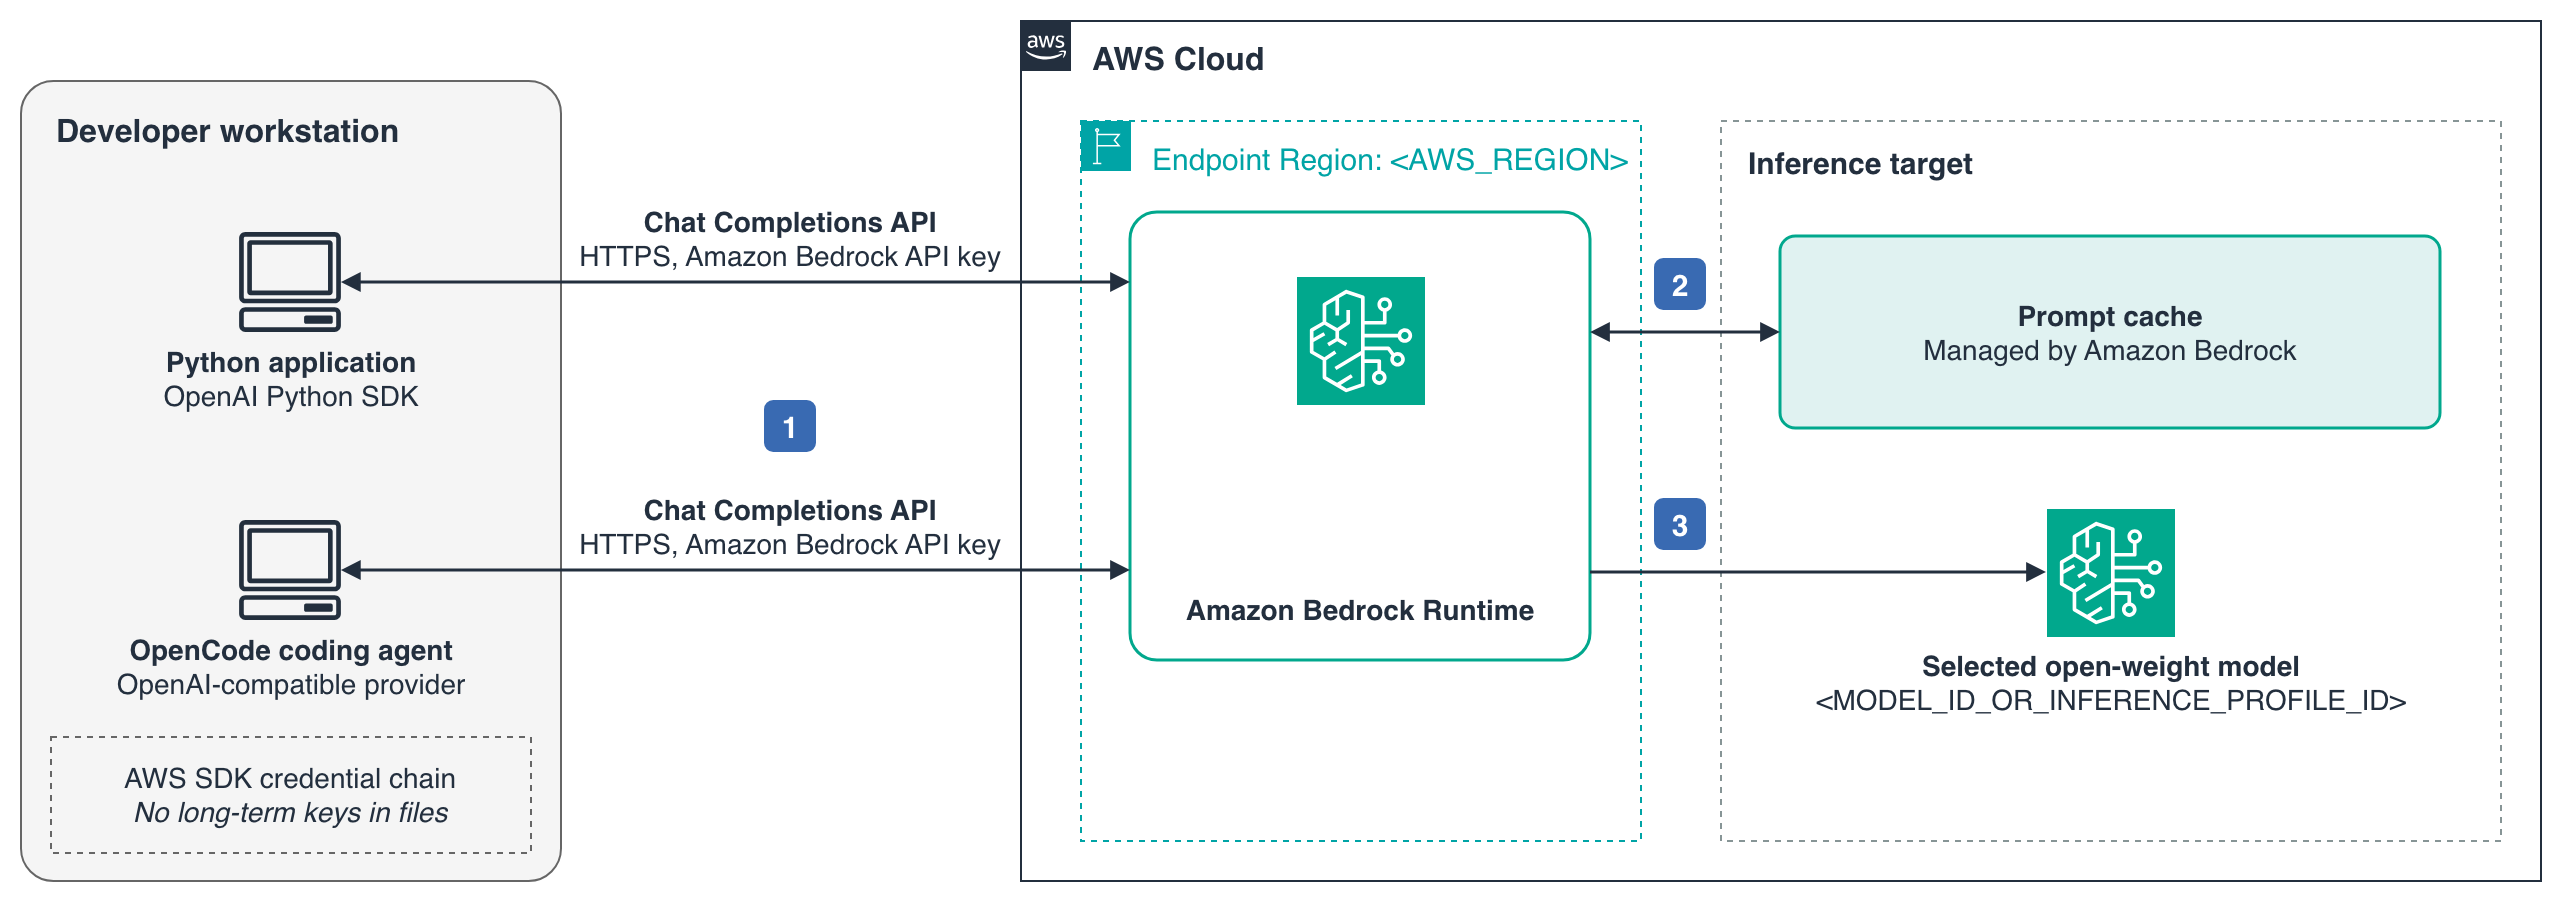
圖 3:本文中的兩個範例如何連接至 Amazon Bedrock
- Python 應用程式和 OpenCode 編碼 Agent 會向你所在區域的 Amazon Bedrock Runtime 端點傳送請求,並使用短期 Amazon Bedrock API 金鑰進行驗證。
- Amazon Bedrock 會在提示詞快取中檢查是否有相符的前綴。若找到相符的前綴,便會從快取讀取,並將新的可快取內容寫入快取。
- Amazon Bedrock 會將請求傳送至所選的開放權重模型,並傳回回應,其中包括以下章節會説明如何讀取的快取用量欄位。
先決條件
執行範例前,你需要具備以下項目:
- 一個可在 Amazon Bedrock 使用所選模型的 AWS 帳戶。模型的可用性和提示詞快取支援因 AWS 區域而異,請查閲模型卡,確認模型支援的區域。
- 具備權限的 AWS Identity and Access Management (IAM) 身分的 AWS 憑證,可用來在 Amazon Bedrock 呼叫所選模型。
- Python 3.12,以及
openai(3.26.0 或更新版本)和aws-bedrock-token-generator(1.1.0 或更新版本)套件。 - 編碼 Agent 範例需要使用 npm 安裝 OpenCode 1.18.35。
使用模型前,請先查閲其授權和服務條款,相關連結可在其模型卡找到。使用模型亦須遵守AWS 負責任 AI 政策。
透過 Chat Completions API 快取產品手冊
範例是一個虛構濾水器 AnyCompany AquaPure 500 的支援助理。系統提示詞包含一行指示和使用手冊,後者是可重用的前綴。每次請求都會提出不同的客戶問題。
設定用戶端
範例使用 OpenAI Python SDK,透過 Amazon Bedrock Chat Completions 端點傳送請求。驗證時,aws-bedrock-token-generator 套件中的 provide_token() 函數會將你的 AWS 憑證轉換為短期 Amazon Bedrock API 金鑰,有效期最長為 12 小時。你無須建立或儲存長期金鑰。
1. 建立虛擬環境並安裝套件:
python3.12 -m venv .venv
source .venv/bin/activate
pip install "openai>=3.26.0" "aws-bedrock-token-generator>=1.1.0"
2. 建立手冊。我們的手冊約有 4,000 個 Markdown token。以下摘錄展示其格式:
# AnyCompany AquaPure 500 Owner's Manual

### 7.1 Replacement schedule
| Stage | Cartridge | Part number | Replace every |
| ----- | ------------------- | ----------- | ------------- |
| 1 | Sediment pre-filter | AP-F1 | 6 months |
| 4 | Carbon post-filter | AP-F4 | 12 months |

### 9. Error codes
| Code | Description | What to do |
| ---- | ----------------------- | -------------------------------------------- |
| E01 | Low feed water pressure | Check that the feed water valve is open. |
| E07 | Drain line restriction | Check the black concentrate tube for kinks. |

### 11. Warranty
- Faucet: 3 years from the date of purchase. The 3 V cell is not covered.
將它儲存為 manual.md,並加入章節,直至內容超過模型卡列出的最低前綴長度。使用佔位文字亦可,因為快取只需要完全相同的前綴。保留所示的三個章節,這些章節可回答範例問題。
3. 將以下設定程式碼儲存為同一目錄中的 common.py。你接下來建立的範例會從這個檔案匯入內容。
from pathlib import Path

from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "<AWS_REGION>"
MODEL_ID = "<MODEL_ID_OR_INFERENCE_PROFILE_ID>"

MANUAL = Path(__file__).with_name("manual.md").read_text()

SYSTEM_PROMPT = (
    "You are the AnyCompany AquaPure support assistant. Answer the customer's question in at "
    "most three sentences, using only the owner's manual below.\n\n" + MANUAL
)

QUESTIONS = [
    "My filter shows error code E07. What does it mean and how do I fix it?",
    "How often do I need to replace the AP-F4 post-filter?",
    "Is the 3 V battery in the smart faucet covered by the warranty?",
]

# Chat Completions API client: the OpenAI SDK pointed at the Amazon Bedrock OpenAI-compatible endpoint
client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
)


def report(call_number, response):
    """Print the cache fields from the response usage."""
    usage = response.usage
    read = usage.prompt_tokens_details.cached_tokens or 0
    written = usage.prompt_tokens_details.cache_write_tokens or 0
    print(
        f"Call {call_number}: prompt_tokens={usage.prompt_tokens} cached_tokens={read} "
        f"cache_write_tokens={written} uncached={usage.prompt_tokens - read - written}"
    )
如果模型會傳回推理 token,這些 token 也會計入 max_tokens。範例會設定 max_tokens=1024,讓簡短答案有足夠空間完成。
隱式快取
隱式快取不需要設定任何快取控制項。將手冊放在系統訊息中,並將問題放在用戶訊息中。把兩者作為同一則用戶訊息的不同部分傳送,並沒有命中隱式快取。將以下內容儲存為 implicit.py,並以 python implicit.py 執行:
from common import MODEL_ID, QUESTIONS, SYSTEM_PROMPT, client, report

for i, question in enumerate(QUESTIONS, start=1):
    response = client.chat.completions.create(
        model=MODEL_ID,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT}, # static, same every call
            {"role": "user", "content": question}, # changes every call
        ],
        max_tokens=1024,
    )
    report(i, response)
驗證隱式快取
每個回應都會在 usage.prompt_tokens_details 中回報快取活動。圖 4 説明如何解讀這些欄位,以及每個範例的三次呼叫預期會出現的模式。
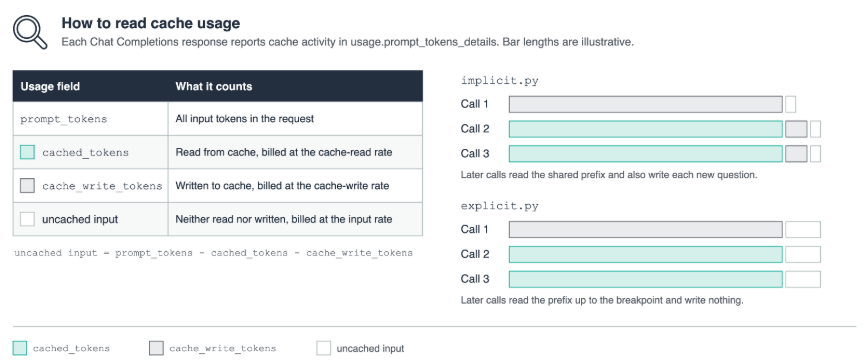
圖 4:如何解讀快取用量欄位(示意)
在隱式模式下,第一次呼叫會將提示詞寫入快取。第二和第三次呼叫會從快取讀取包含指示和手冊的系統訊息。每次也會寫入少量 token,因為隱式模式會延伸快取前綴,涵蓋每條新問題。每次呼叫中,最後一則訊息之後的少量 token 都不會快取。首次執行時會出現這種模式。如果在 TTL 內再次執行範例,所有呼叫都會從快取讀取,亦不會有任何寫入。
顯式快取
選用顯式快取,即可精確控制哪些內容會被快取。如圖 4 所示,隱式快取執行中的第二和第三次呼叫都會向快取寫入少量 token,而使用顯式快取時,這兩次呼叫都不會寫入任何內容。設定多個快取斷點,即可快取分層前綴,例如先放共用指示和工具,再接每位客戶專屬的文件(圖 2)。
若要使用顯式快取,請在請求中加入以下內容:
- 將
prompt_cache_options的 mode 設為 explicit,即可選用顯式模式。這是 Amazon Bedrock 的請求欄位,而 OpenAI SDK 會透過extra_body傳送此欄位。 - 文字內容部分中的
prompt_cache_breakpoint會標示可重用前綴的結尾。直到並包括該部分的內容都會被快取,而其後的內容則會在每次請求中重新處理。
將相同迴圈的顯式快取版本儲存為 explicit.py:
from common import MODEL_ID, QUESTIONS, SYSTEM_PROMPT, client, report

for i, question in enumerate(QUESTIONS, start=1):
    response = client.chat.completions.create(
        model=MODEL_ID,
        messages=[
            {
                "role": "system",
                "content": [
                    {
                        "type": "text",
                        "text": SYSTEM_PROMPT,
                        # Cache everything up to and including this content part.
                        "prompt_cache_breakpoint": {"mode": "explicit"},
                    }
                ],
            },
            {"role": "user", "content": question}, # after the breakpoint, not cached
        ],
        max_tokens=1024,
        extra_body={"prompt_cache_options": {"mode": "explicit"}},
    )
    report(i, response)
兩部分都要一併設定。顯式模式若沒有斷點,不會快取任何內容;沒有顯式模式的斷點則會如隱式快取般運作。至於 prompt_cache_options 的可選 ttl 欄位,請查閲模型卡,瞭解支援的值。
驗證顯式快取
若在執行 implicit.py 後立即執行 explicit.py,其第一次呼叫已會命中快取。若要讓首次呼叫不命中快取,請在系統提示詞加入獨有的首行,例如 SYSTEM_PROMPT = f"Run ID: {uuid.uuid4()}\n" + SYSTEM_PROMPT(並將 import uuid 放在 explicit.py 的頂部)。
如圖 4 的顯式快取柱狀圖所示,只有第一次呼叫會寫入快取。每次重複呼叫都會從快取讀取直到斷點為止的整個前綴,而且不會寫入任何內容;斷點後的問題則構成未快取的其餘部分。
在 OpenCode 編碼 Agent 中使用提示詞快取
編碼 Agent 每一步都會重新傳送大量而穩定的前綴:系統提示詞、工具定義,以及目前為止的對話。因此,隱式快取很適合用於這類 Agent。OpenCode 是一款開源編碼 Agent。它可透過自訂的 OpenAI 相容供應商呼叫任何 Chat Completions 端點,因此可使用與 Python 範例相同的 Amazon Bedrock 端點。圖 5 展示 OpenCode 在一個回合中傳送的請求,以及 Amazon Bedrock 從快取讀取的部分。
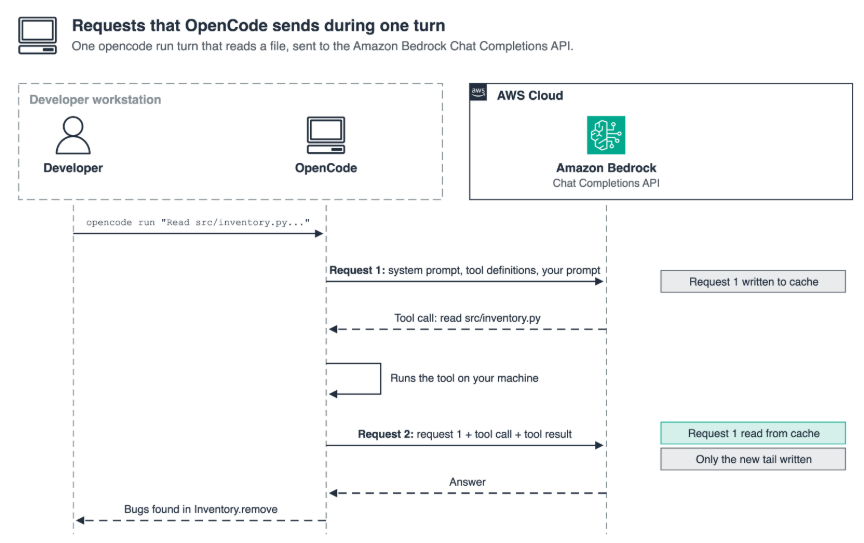
圖 5:OpenCode 在一個回合中傳送至 Amazon Bedrock 的請求
在一個回合中,OpenCode 會傳送請求 1,其中包含系統提示詞、工具定義及你的提示詞,而 Amazon Bedrock 會將其寫入快取。模型會回傳工具呼叫,OpenCode 隨即在你的電腦上執行該呼叫。然後,OpenCode 會傳送請求 2,其中包含請求 1、工具呼叫及其結果。Amazon Bedrock 會從快取讀取請求 1,只將新增的尾段寫入快取,然後回傳回應。
設定 OpenCode
安裝 OpenCode 並檢查版本:
npm install --prefix ~/.local/opt/opencode opencode-ai@1.18.35
export PATH="$HOME/.local/opt/opencode/node_modules/.bin:$PATH"
opencode --version接著,將以下opencode.json加入儲存庫的根目錄,或將它儲存為~/.config/opencode/opencode.json,以套用至每個專案。它會定義一個名為bedrock的供應商,使用 OpenAI 相容套件呼叫 Amazon Bedrock Chat Completions 端點:
{
  "$schema": "https://opencode.ai/config.json",
  "model": "bedrock/<MODEL_ID_OR_INFERENCE_PROFILE_ID>",
  "small_model": "bedrock/<MODEL_ID_OR_INFERENCE_PROFILE_ID>",
  "provider": {
    "bedrock": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Amazon Bedrock (Chat Completions)",
      "options": {
        "baseURL": "https://bedrock-runtime.<AWS_REGION>.amazonaws.com/openai/v1",
        "apiKey": "{env:BEDROCK_API_KEY}"
      },
      "models": {
        "<MODEL_ID_OR_INFERENCE_PROFILE_ID>": { "name": "Open-weight model on Amazon Bedrock" }
      }
    }
  }
}
OpenCode 使用small_model作為工作階段標題,因此將它指向相同的模型,可確保每個請求都使用你已啟用的模型。供應商會從BEDROCK_API_KEY讀取金鑰。在第一個範例使用的虛擬環境中,將它設為從provide_token()取得的短期 Amazon Bedrock API 金鑰。如果金鑰到期,請再次執行該命令以取得新金鑰:
export BEDROCK_API_KEY="$(python -c '
from aws_bedrock_token_generator import provide_token
print(provide_token(region="<AWS_REGION>"))')"
確認 OpenCode 顯示該模型:
opencode models bedrock在編碼工作階段中驗證隱式快取
我們在一個小型程式碼儲存庫中進行了三回合測試,該儲存庫只有一個簡短的 Python 檔案。第 1 回合要求檢查錯誤,第 2 回合要求修正,第 3 回合則要求簡短跟進:
opencode run --format json --title "cache-demo" \
"Read src/inventory.py and list any bugs in Inventory.remove. Do not edit files."
opencode run --format json -s <sessionID> \
"Now propose a fixed version of Inventory.remove as a code block. Do not edit files."opencode run --format json -s <sessionID> \
"In one sentence, what does low_stock return?"將<sessionID>替換為第 1 回合 JSON 輸出中的sessionID值。opencode export <sessionID>命令會列出每個請求的 token 使用量:cache.read包含 Amazon Bedrock 回傳的cached_tokens值,而input則包含其餘部分。OpenCode 1.18.35 不會為 OpenAI 相容供應商記錄cache_write_tokens,因此cache.write會維持為 0。
圖 6 顯示工作階段中每個請求有多少內容從快取讀取。
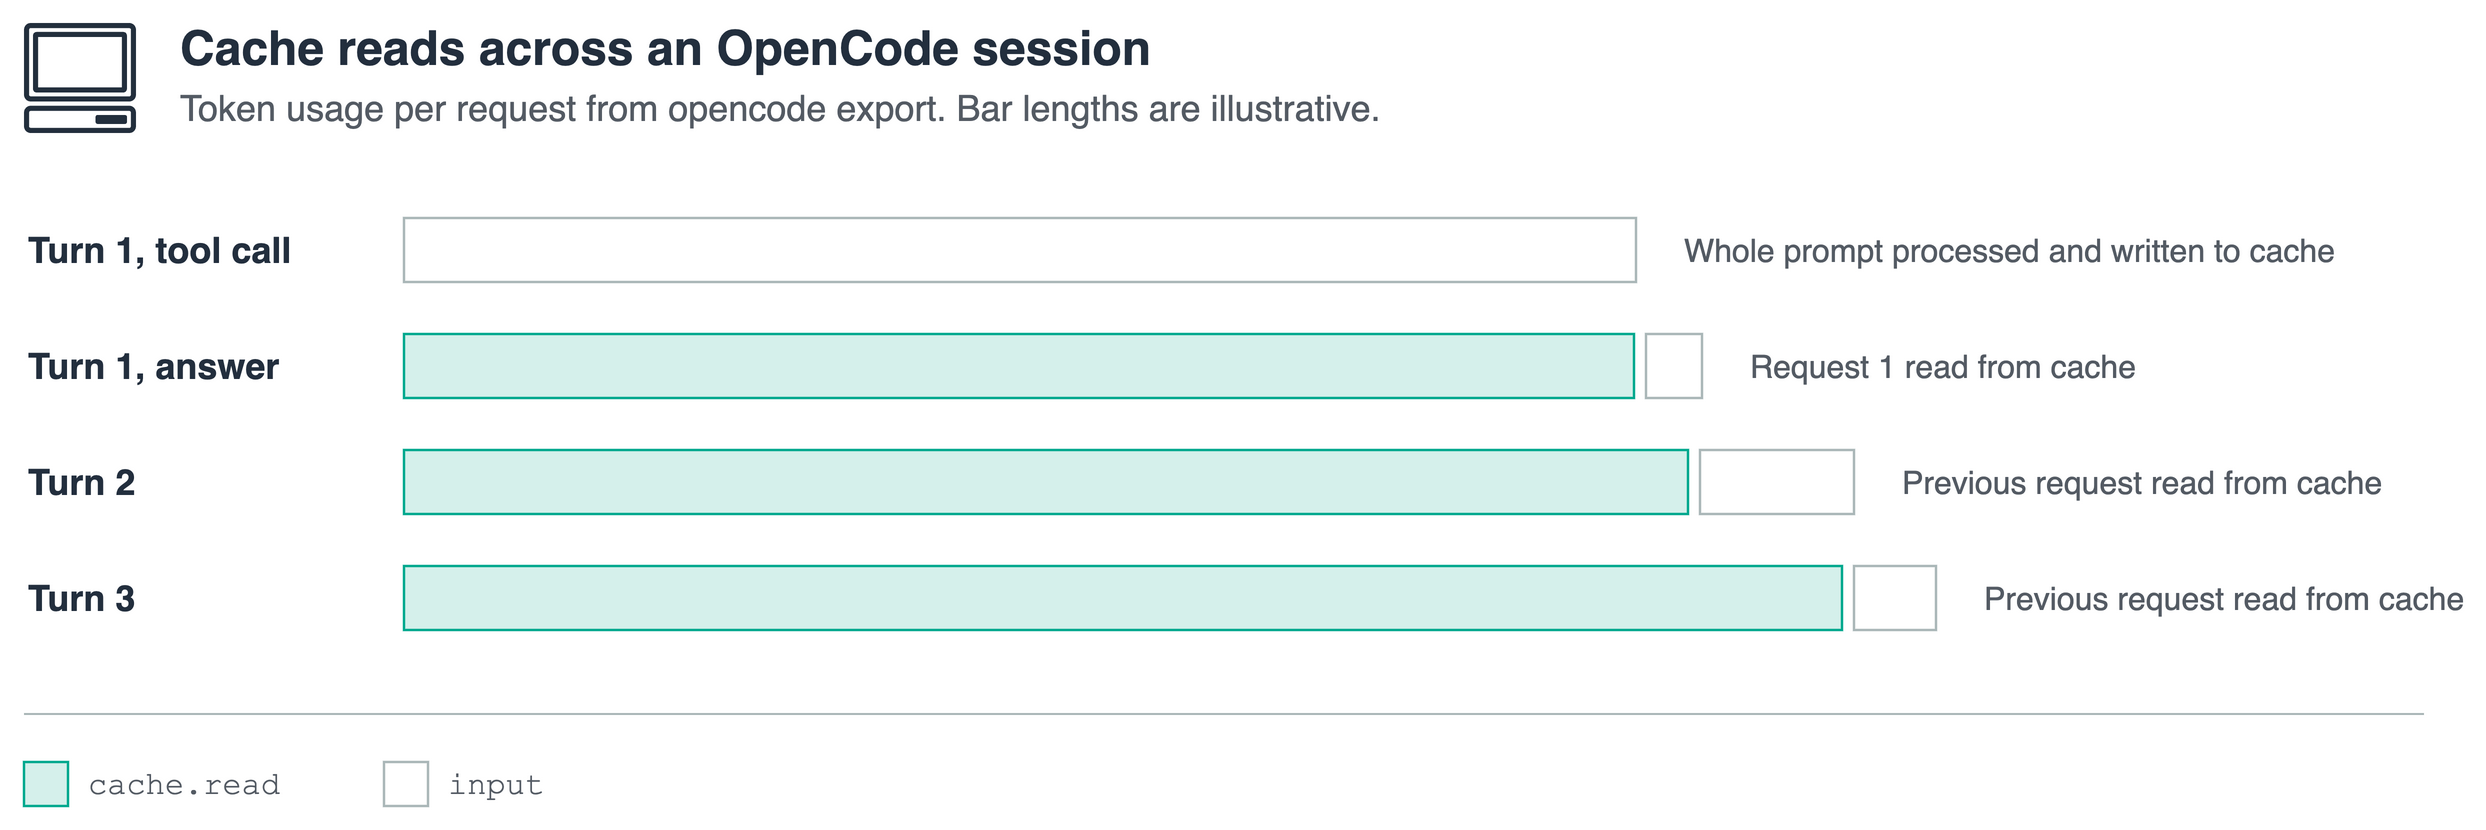
圖 6:OpenCode 工作階段中的快取讀取量(示意圖)
第一個請求會處理整個提示詞,其中大部分是 OpenCode 系統提示詞和工具定義,然後 Amazon Bedrock 會將其寫入快取。之後的每個請求都會從快取讀取截至上一個請求結尾的所有內容,因此只需處理對話中新增的尾段。這項功能無需任何快取設定即可運作。
最佳做法
以下做法適用於任何支援提示詞快取的模型:
- 無論使用哪種模式,都將靜態內容放在前面。將系統提示詞、工具定義和參考文件放在會變動的內容之前,並確保它們在各個請求中完全相同。在明確模式下,應在每個快取斷點所涵蓋的靜態內容之後設定斷點。時間戳記和請求 ID 應放在提示詞末尾。
- 確保前綴夠長。符合模型卡所列最低 token 數的前綴才符合快取資格。
- 透過使用量欄位確認命中情況。在任何模式下,都要檢查每個回應中的快取讀取和寫入量。對整個工作負載,請追蹤
CacheReadInputTokenCount和CacheWriteInputTokenCount執行階段指標。 - 維持快取的熱度。穩定的流量可讓前綴維持在快取中,因為每次命中都會重設 TTL。閒置時間超過 TTL 後,下一個請求會再次寫入該前綴。
- 快取會重用的內容。節省來自快取讀取,因此應快取會由後續請求再次讀取的內容,尤其是在快取寫入費用高於標準輸入內容的情況下。使用跨區域推理時,預期在需求高峯期間會有一些額外的快取寫入。
清理
這些範例只會發出推理呼叫,不會在你的 AWS 帳戶中建立任何資源。快取項目在超過 TTL 未被讀取後便會過期。從provide_token()取得的短期 API 金鑰也會自行到期,而這些範例絕不會將它寫入磁碟。如要提早從 Shell 中清除金鑰,請執行unset BEDROCK_API_KEY。
移除本機檔案:
1. 刪除範例目錄及其 Python 虛擬環境。
2. 從你的儲存庫刪除 opencode.json;如果你已將它儲存至全域位置,則刪除 ~/.config/opencode/opencode.json。
3. 如果不再需要 OpenCode,請刪除 ~/.local/opt/opencode。
總結
提示詞快取讓 Amazon Bedrock 上的開放權重模型能重用重複的上下文,而幾乎無須或完全毋須更改程式碼。本文介紹的隱式快取,涵蓋了支援助理及 OpenCode 工作階段,兩者均完全不需要設定快取。顯式快取則只需一個請求選項,並為每個可重用層設定一個斷點,即可精確控制。在所有情況下,每個回應中的用量欄位都會顯示哪些內容來自快取,讓你可以根據自己的流量衡量效益。
如要開始使用,請選擇Amazon Bedrock 上支援提示詞快取的開放權重模型。使用自己的參考內容執行本文中的範例,並比較快取讀取量與未使用快取時的輸入量。提示詞快取指南介紹各個模型的限制及選項,而 Amazon Bedrock 的執行階段指標則讓你追蹤不同應用程式的快取讀取及寫入情況。如有疑問,請透過AWS Support或AWS re:Post 社羣聯絡我們。
作者簡介

Dustin Liu
Dustin 是 AWS 的 AI/ML 專家解決方案架構師,常駐澳洲墨爾本。他與數碼原生企業/獨立軟件供應商合作,設計、將 AI 方案投入生產環境並擴大其規模。他喜歡親身參與實作,並打造能解決實際業務問題的方案。

Aman Arora
Aman 是 AWS 的生成式 AI 專家解決方案架構師,常駐澳洲悉尼。他與客戶合作,設計及構建在 Amazon Bedrock 和 Amazon Bedrock AgentCore 上運行的生成式 AI 應用程式及 AI Agent。他專注協助企業大規模在生產環境中運行 Agent 系統,尤其重視評估、可觀測性及可靠性。

Melanie Li
Melanie 擁有博士學位,是 AWS 的資深生成式 AI 專家解決方案架構師,常駐澳洲悉尼,專注與客戶合作,使用最先進的 AI/ML 工具構建方案。她積極參與 APJ 多項生成式 AI 計劃,善用 LLM 的力量。加入 AWS 前,Li 博士曾在金融及零售業擔任數據科學職務。

Saurabh Trikande
Saurabh 是 Amazon Bedrock 和 Amazon SageMaker Inference 的資深產品經理。他專注處理部署複雜 AI 應用程式、使用多租戶模型進行推理、成本優化,以及令生成式 AI 模型更容易部署等核心挑戰。閒暇時,Saurabh 喜歡遠足、瞭解創新科技、關注 TechCrunch,以及與家人共度時光。
來源:AWS Machine Learning Blog · aws.amazon.com