Open ASR Leaderboard 新增 Hindi、Indian English 評測集,首度納入全球南方語言
The Open ASR Leaderboard Adds Its First Global South Language
Voice Arena 與 Hugging Face 為 Open ASR Leaderboard 加入 Monsoon en-IN 和 Monsoon hi-IN 評測集,涵蓋 Indian English 與 Hindi,令 Hindi 成為其多語言分頁首個 Indic language。
這批評測集把説話者背景與可接受的拼寫變體納入 ASR 評估,讓總體 WER 之外的區域差異和 Hindi 正字法誤差更容易被辨識。
Voice Arena 與 Hugging Face 合作,推出 Hindi 和 Indian English 開放式 ASR 評測
基準測試決定哪些技術會獲得開發。模型若在 Open ASR Leaderboard 上取得好成績,就會被採用並持續迭代;排行榜沒有量度的能力,往往就不會進步。近期排行榜上的不少工作,都在令評測指標更可信:
- 保留測試用的私人資料集。
- 基準測試擬合分析,量化模型在多大程度上只是重現參考謄本,而非單憑音訊進行轉錄。
- 補足正規化器的缺口,確保正確的預測或變體不會被扣分。
以上做法令一個數字(WER)更難被操弄,但它始終只是一個數字。大量研究顯示,ASR 錯誤率並非在所有使用者身上平均分佈。自動語音識別中的種族差異發現,商用系統識別黑人説話者的表現約比白人説話者差一倍;量化自動語音識別中的偏差則發現性別、年齡和口音之間也有差異。排行榜看不到這些情況,不是因為排行榜刻意隱瞞,而是它所用的測試集只記錄説了甚麼,幾乎不記錄是誰在説。
為了填補這個缺口,我們在 Open ASR Leaderboard 加入兩個評測集:Monsoon en-IN 和 Monsoon hi-IN。Hindi 有超過五億人使用,是目前多語言分頁中首個納入的印度語言;該分頁目前只涵蓋歐洲語言。每個評測集均提供可供自行評分的公開資料集,以及為限制針對基準測試進行優化而保留的私人資料集。四個資料集彼此按説話者劃分,互不重疊,共有 4,888 位説話者;每人均記錄 12 項説話者屬性。
資料收集設計
測試集只能揭示它有變化的面向上的失效情況。大部分基準測試都取材自當時容易取得的音訊。Monsoon 的設計則涵蓋九個變化面向:地理位置、年齡、性別、詞彙、裝置、聲學環境、説話類型、語速,以及同一段音訊是否存在多種有效謄本。每個面向都可能令整體 WER 平均而言正確,卻對某個特定羣體失準。
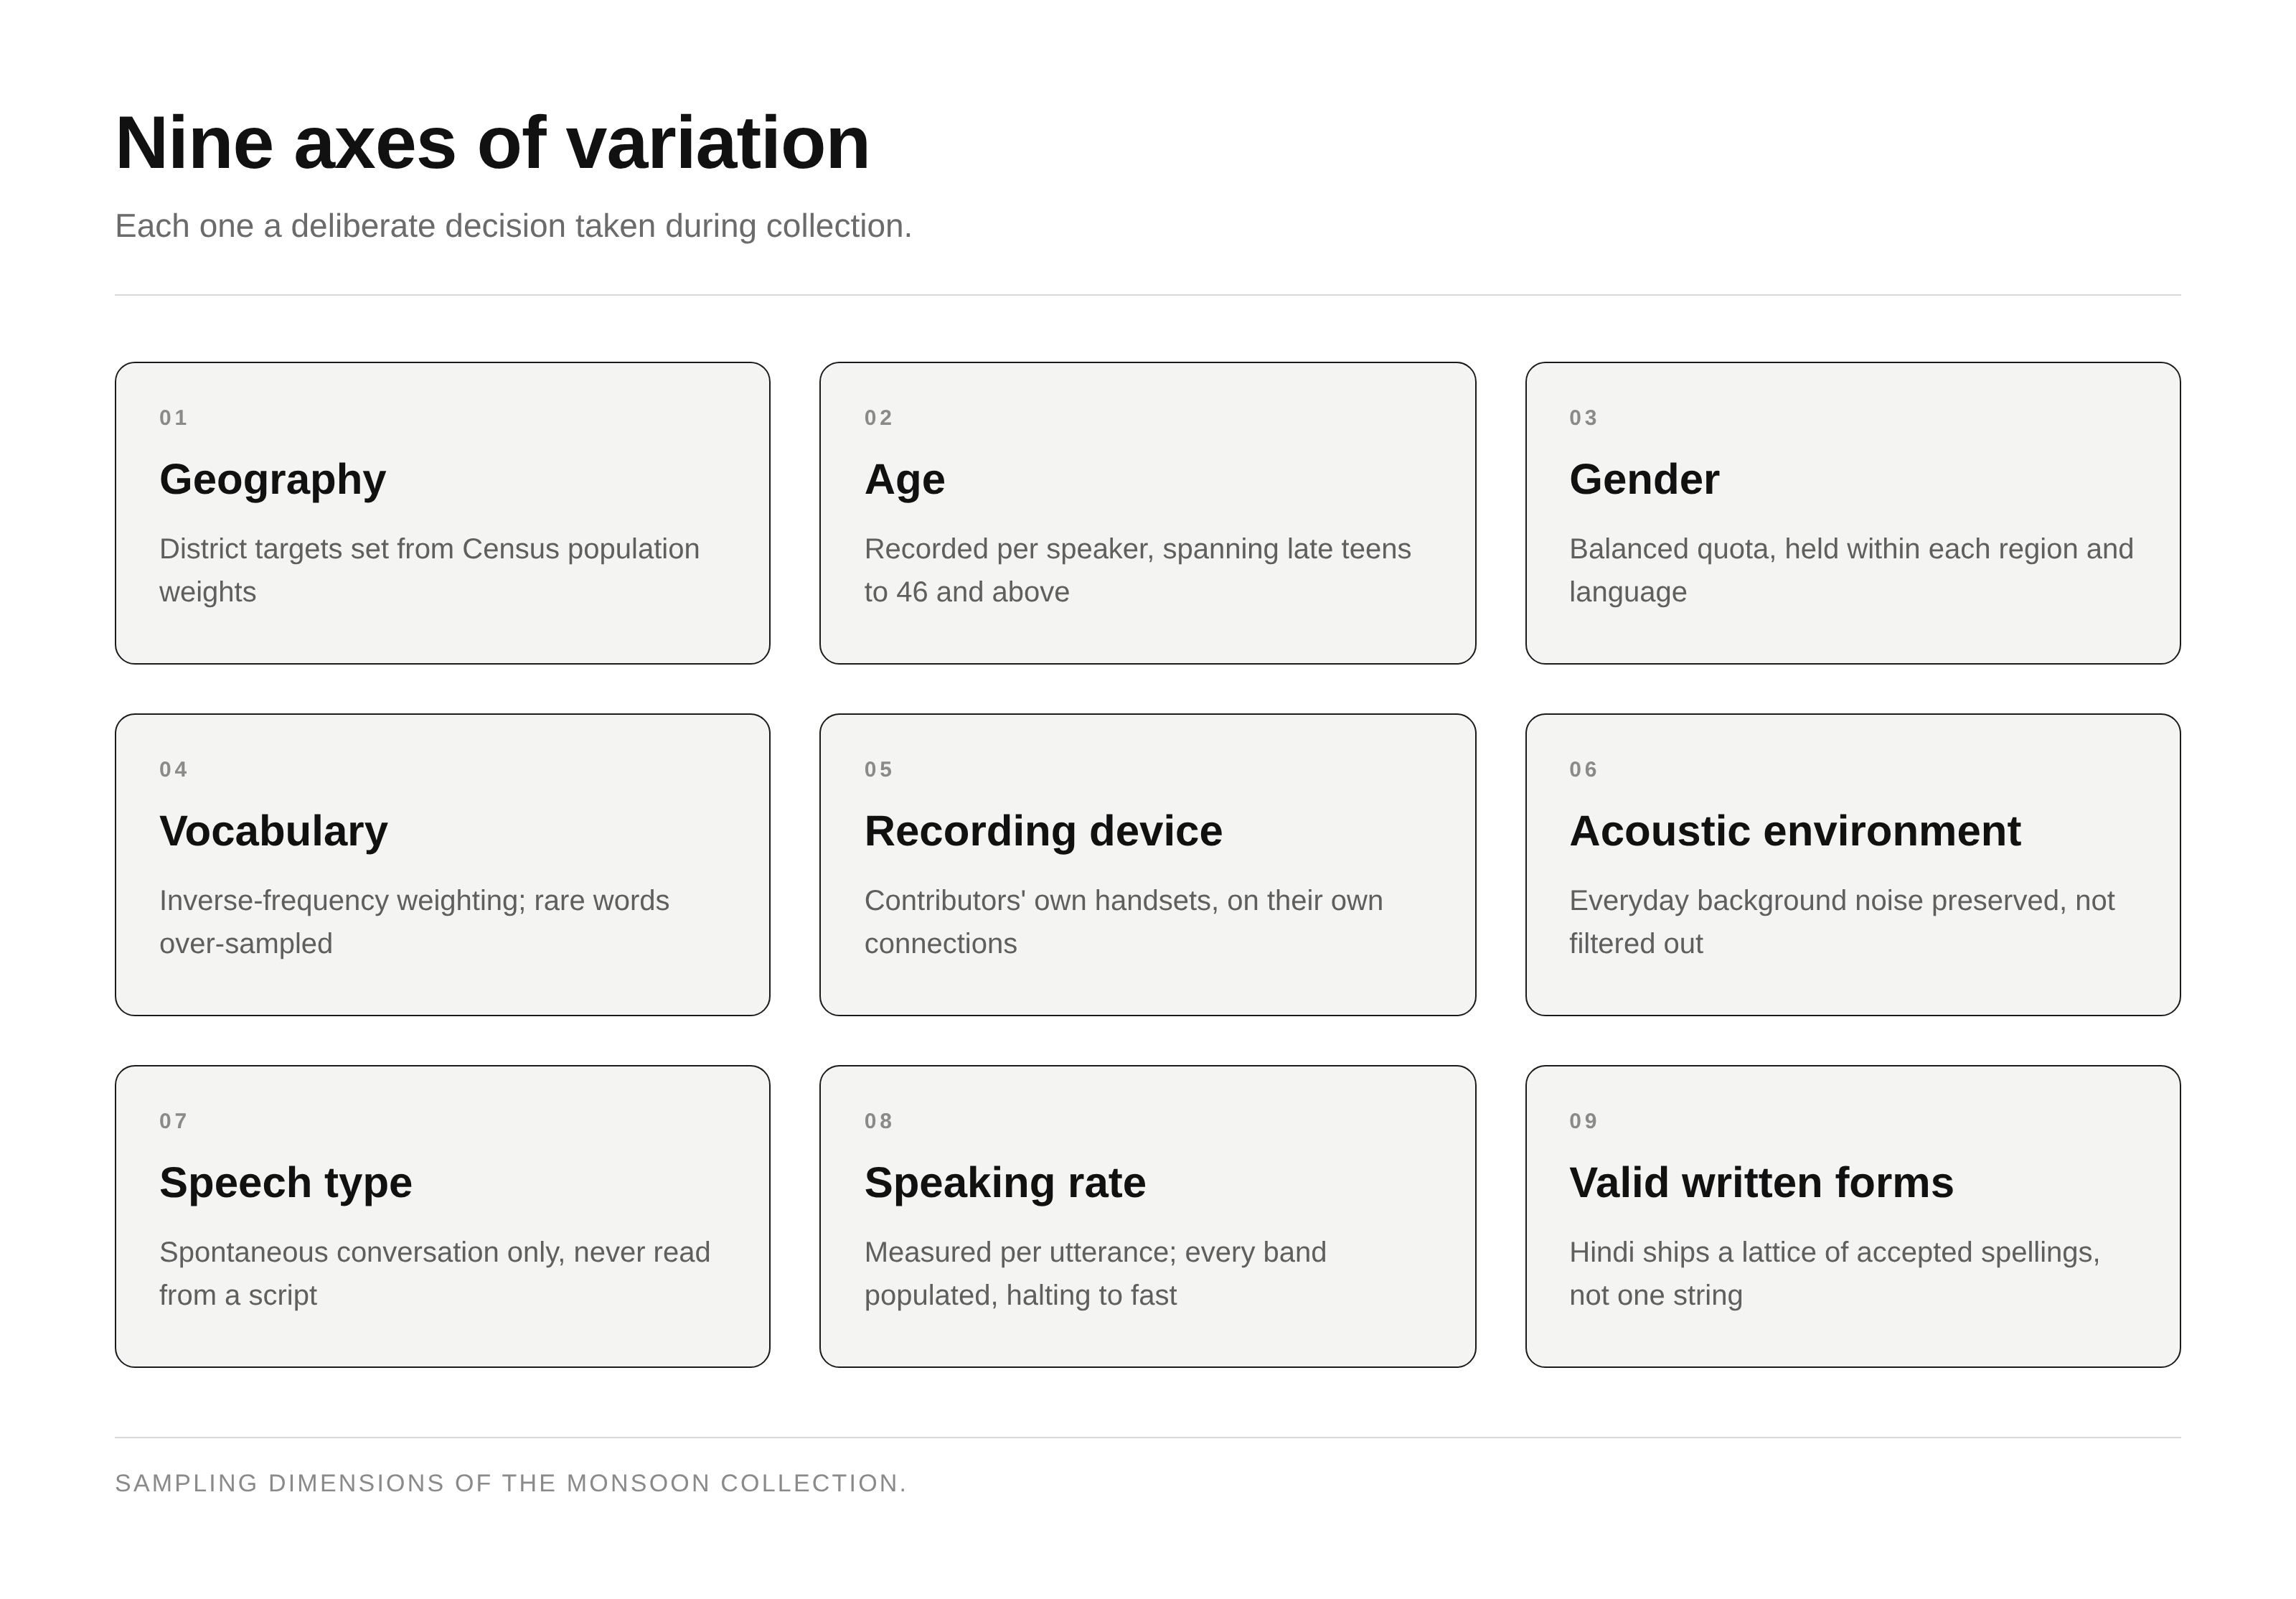
因此,收集方法也由此而定。
- 地理位置方面,我們在數百個縣區招募參與者,而非只在少數地方錄製較長的對話。
- 裝置和聲學條件方面,參與者在室內外使用自己的手機和網絡連線,而非在安靜的房間使用指定設備。
- 詞彙、説話類型和語速由提示題目帶出:日常話題引導參與者表達意見、提出異議、敍述和回憶,這些情境會出現專有名詞、數字和未經排練的措辭。
- 年齡和性別會逐位記錄並核實。
- 多種有效謄本是參考文本本身的特性,而非音訊的特性;後文會再談到。
資料集組成
四個資料集、兩種語言,透過同一套流程收集。
| 資料集 | 語言 | 時長 | 説話者 | 片段長度(平均/中位數) | 男/女 | 縣區 | 邦/聯邦屬地 | 裝置 | 風格 | 轉錄方式 |
|---|---|---|---|---|---|---|---|---|---|---|
| Monsoon en-IN 公開資料集 | 印度英語 | 5.62 h | 1,444 | 9.6s / 10.4s | 50/50 | 428 | 24/6 | 556 | 對話式、自發表達 | 已正規化,保留不流暢表達 |
| Monsoon en-IN 私人資料集 | 印度英語 | 5.58 h | 1,405 | 9.6s / 10.4s | 45/55 | 420 | 24/6 | 560 | 對話式、自發表達 | 已正規化,保留不流暢表達 |
| Monsoon hi-IN 公開資料集 | Hindi | 1.33 h | 468 | 6.4s / 5.0s | 54/46 | 202 | 11/3 | 315 | 對話式、自發表達 | 格狀謄本(接受拼寫變體) |
| Monsoon hi-IN 私人資料集 | Hindi | 4.47 h | 1,571 | 6.6s / 5.3s | 55/45 | 295 | 12/3 | 582 | 對話式、自發表達 | 格狀謄本(接受拼寫變體) |
資料來自未經腳本安排的雙聲道自發對話;系統會將片段切自單一聲道,令每段只包含一位説話者。除了表格所列欄位,每段也會記錄職業、教育程度、婚姻狀況、收入範圍、手機品牌、現居城市,以及在現居縣區居住的年數。
以下列出印度英語公開資料集中的五段音訊及各自附帶的資料:
29 歲女性,來自 Tripura 邦 West Tripura。學生,Samsung SM-G781B。
32 歲女性,來自 Madhya Pradesh 邦 Satna。失業,Samsung SM-E146B。
22 歲男性,來自 Bihar 邦 Rohtas。學生,Motorola moto g54 5G。
27 歲女性,來自 Telangana 邦 Warangal。失業,vivo V2247。
57 歲男性,來自 Puducherry。私人企業職員,Xiaomi M2006C3LI。
英語資料集採用標準字串作為參考文本,排行榜的正規化器會合併大部分拼寫差異。Hindi 的拼寫變體多得多,正規化器也無法解決,因為這些變體並非兩套慣例之間固定的對應關係。因此,Hindi 資料集提供格狀謄本:對於謄本中的每個片段,都列出可接受為正確的拼寫。
説話者涵蓋情況
若按小時衡量,Monsoon 規模不大;若按説話者人數衡量,則相當廣泛。這正是它的設計,而大部分價值也在於此。
除上述欄位以外的説話者集中程度和多樣性。
| Monsoon hi-IN 公開資料集 | Monsoon hi-IN 私人資料集 | Monsoon en-IN 公開資料集 | Monsoon en-IN 私人資料集 | |
|---|---|---|---|---|
| 每位説話者的片段數(平均) | 1.61 | 1.56 | 1.46 | 1.48 |
| 只有一段片段的説話者人數 | 261 | 994 | 956 | 924 |
| 每位説話者的音訊時長(中位數) | 8.34 s | 8.28 s | 12.36 s | 12.39 s |
| 由最多 10 位説話者佔有的比例 | 6.8% | 3.1% | 2.8% | 2.9% |
| 現居城市 | 289 | 814 | 641 | 584 |
| 裝置製造商 | 18 | 25 | 23 | 20 |
以下三項特點均關乎變異,而非數量。
分數不由少數聲音主導:貢獻量最多的 10 位參與者佔總時長的 2.8% 至 6.8%,而超過半數説話者只出現一次。Monsoon 的結果是數百個不同聲音的平均值,而非少數人長時間錄音的結果。時長相若的測試集通常採用相反的設計。
分數也不由地區或手機型號主導:印度英語公開資料集涵蓋 30 個邦和聯邦屬地的 428 個原籍縣區;Hindi 資料集屬於 Hindi 語帶語言,地域分佈較集中,但仍涵蓋 202 和 295 個縣區。錄音來自 315 至 582 種不同裝置型號,任何子集都沒有單一型號佔超過 2.1% 的片段。以標準化硬件收集的語料庫容易過度擬合某一種麥克風響應;這個資料集則不會。
這裏的印度英語並非單一口音:這是全國各地使用的英語,而非某一地區的英語。六個地區均有代表:公開資料集中,南部説話者貢獻 35% 的片段,東部佔 18%、中部佔 18%、北部佔 16%、西部佔 11%。由此而來的口音差異會記錄在資料欄位中,而非只作口頭宣稱。
元資料欄位
Monsoon 每段資料有 18 欄,其中 12 欄是元資料;大部分公開 ASR 測試集則只提供識別碼、謄本和時長。人口統計欄位完整或近乎完整,參與者亦已同意作此用途。
| 分組 | 欄位 |
|---|---|
| 片段 | id、audio、audio_length_s、language |
| 參考謄本 | lattice(Hindi)或 text(印度英語) |
| 説話者 | speaker_id、gender、date_of_birth |
| 背景 | occupation、educational_background、marital_status、income |
| 地理位置 | native_district、native_state、current_city、years_spent_in_current_district |
| 錄音 | device_manufacturer、device_model |
兩種語言的地理分佈形態不同,而這些形態很有參考價值。Hindi 資料集集中在 Hindi 語帶,約 40% 的説話者來自 Uttar Pradesh,這符合按人口抽樣的 Hindi 語料庫應有的分佈。印度英語資料集的分佈則平坦得多:沒有任何邦超過 13%,三分之一説話者來自最大八個邦以外的地方。公開和私人兩部分在兩種語言上的分佈都非常接近。
印度各邦的邊界按語言劃分,因此縣區和邦確實帶有口音訊號,這也是我們公開這些欄位、而非把資料概括掉的原因。印度 ASR 曾有大規模同類分析報告:縣區層級錯誤率約介乎 4% 至 44%,代表不足的地區遠遜於 Hindi 語帶和大城市;分析亦按音訊質素、語速、話語時長、性別、年齡和裝置等項目細分。這些測試使用的是封閉基準。Monsoon 則令大家能在公開排行榜測試集上進行同類分析。
資料收集與品質控制
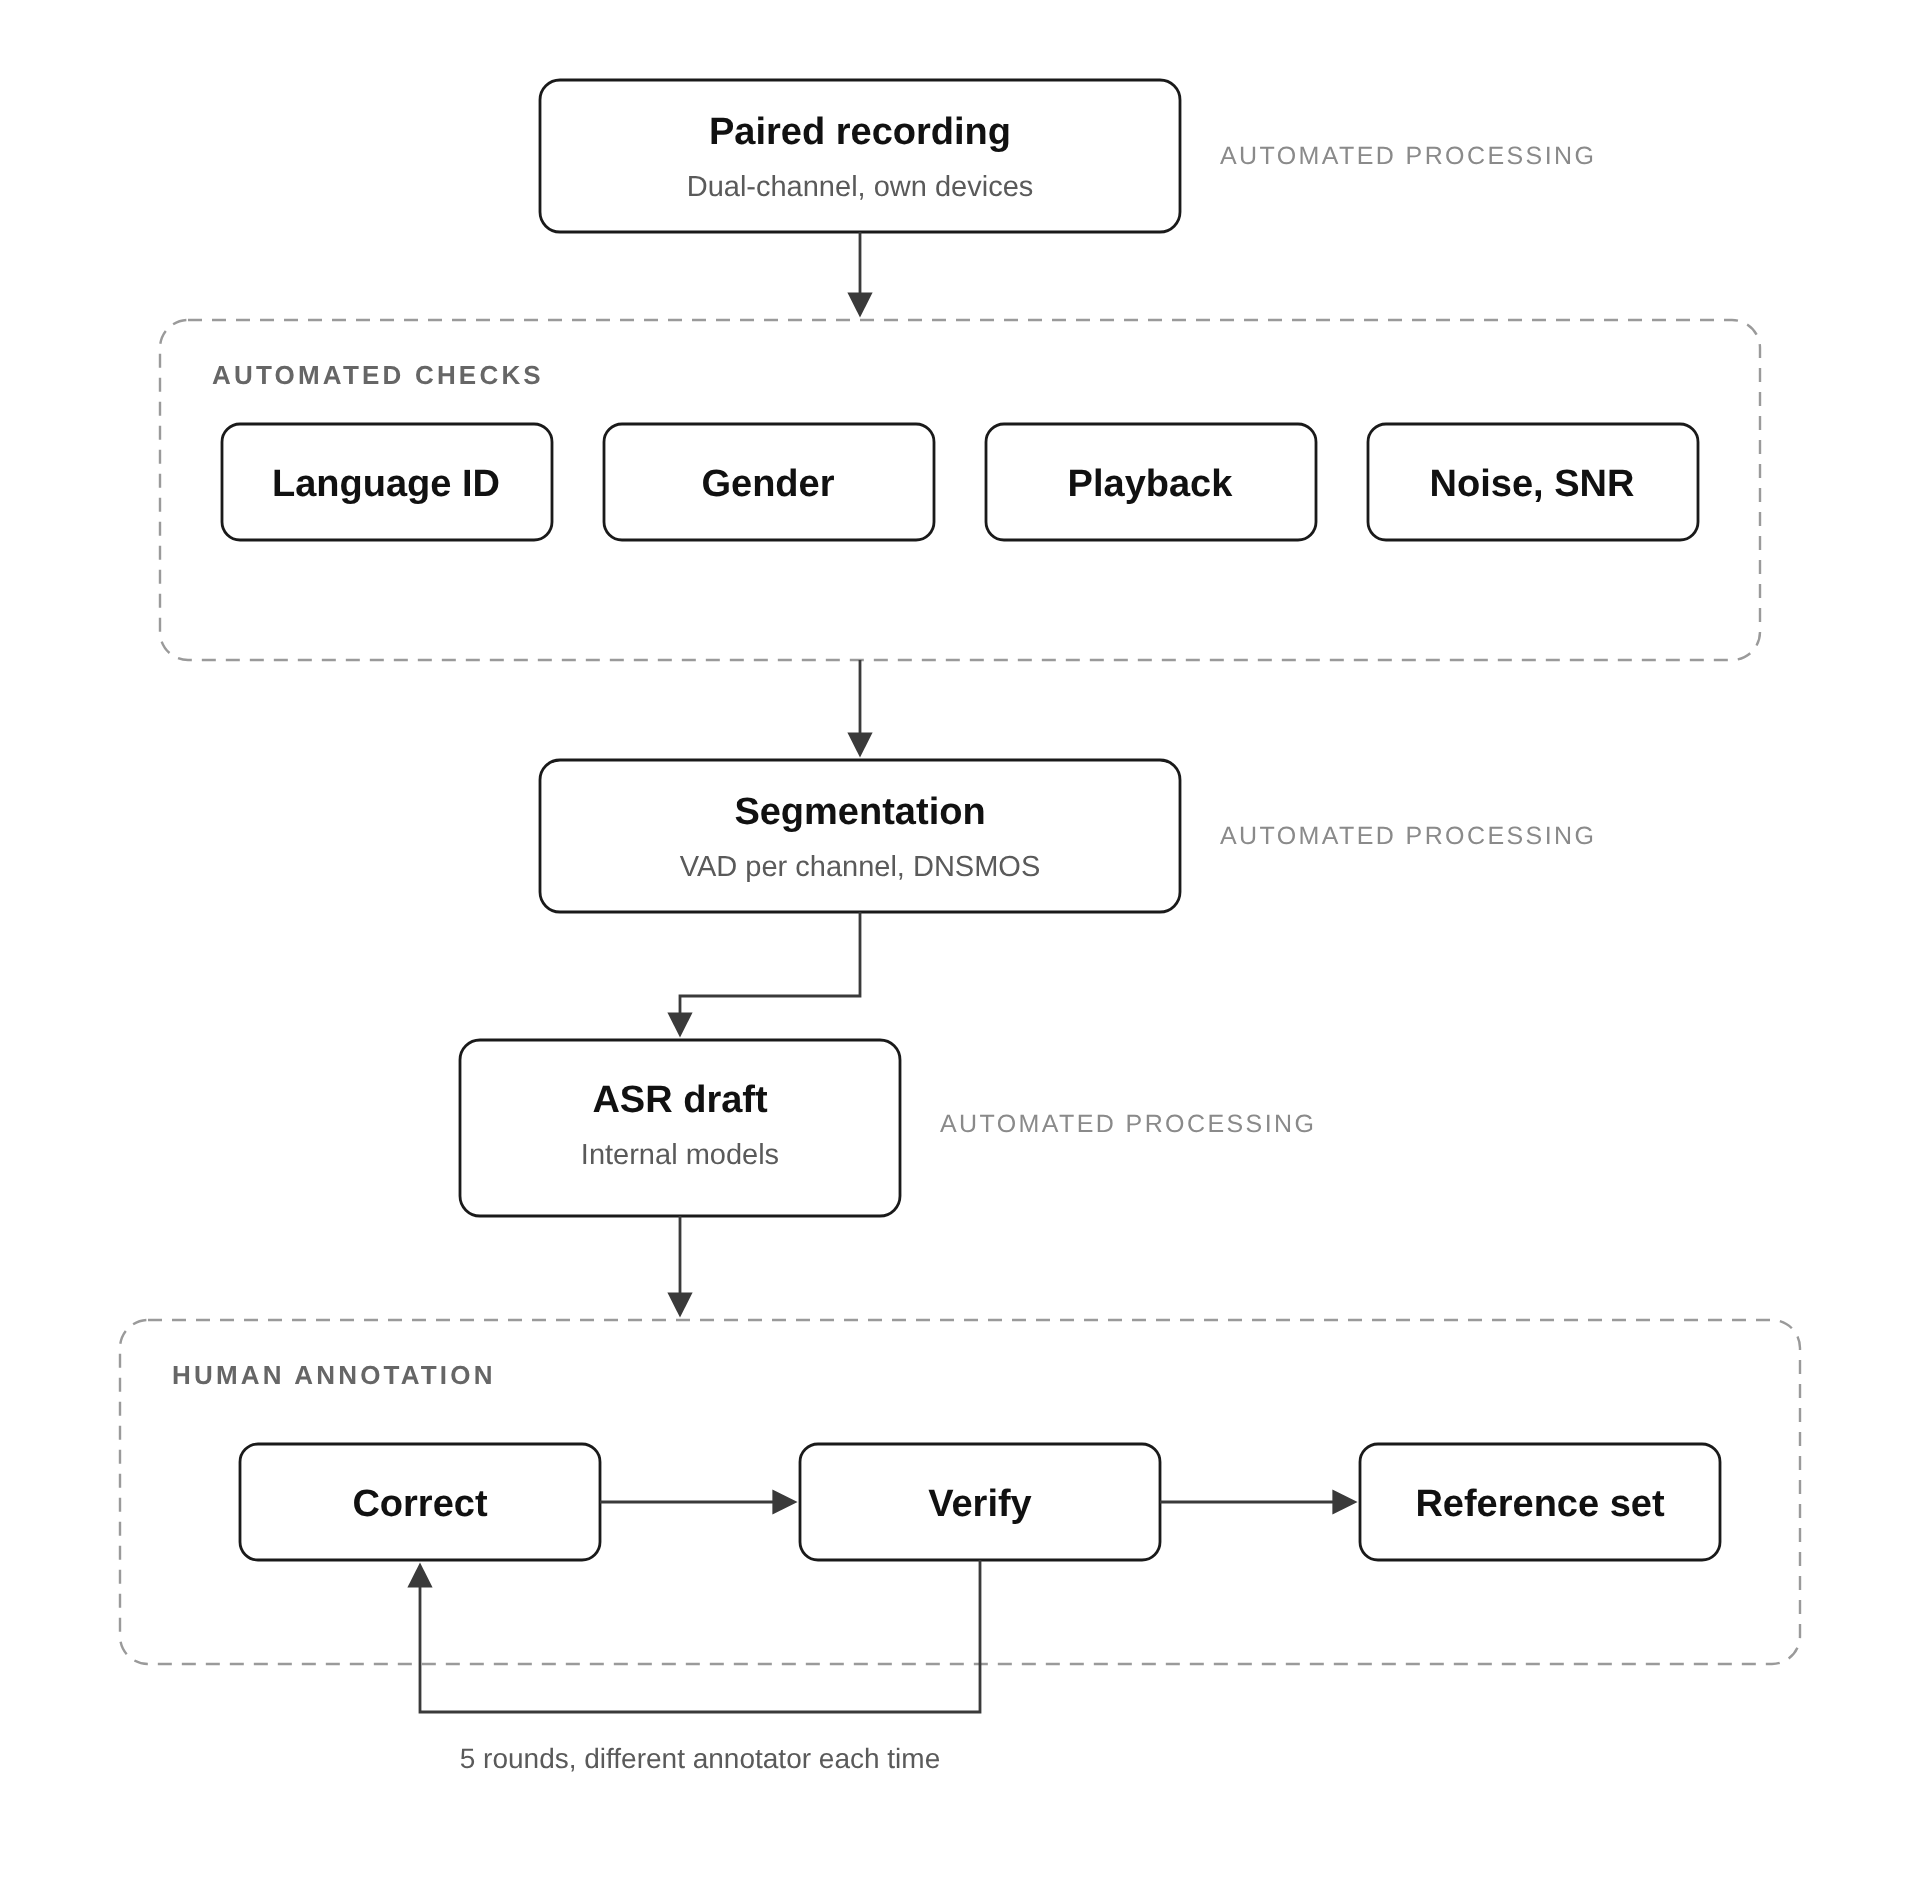
要廣泛涵蓋不同地區,就必須在數百個縣區招募參與者,而非只找少數説話者錄製較長對話。這種大規模分散招募亦會帶來小型收集計劃不會遇到的失效情況:參與者鑽任務空子、把播放錄音當作即時語音提交,以及標註時不專心。每種情況都有明確的檢查程序處理。
招募和錄音:我們透過 Voice Arena 社羣招募參與者。這個全球數碼平台的觸及範圍包括語音語料庫鮮少涵蓋的鄉郊和半城市縣區。之後由兩人一組透過點對點介面,按指定的日常話題錄製雙聲道對話。參與者使用自己的手機和網絡連線,當中不少是低階裝置,在網絡頻寬不穩定的情況下使用;我們刻意在公開音訊中保留這種情況,而非將其過濾。準參與者先完成語言能力篩選,通過後才獲得錄音權限;他們會獲得報酬,並提供知情同意,授權將資料用於訓練及發布。每位説話者的時長上限會按語言設定,並依照該語言説話者的人口規模和地理分佈校準,避免少數錄音量大的參與者主導某種語言或地區;這些資料集超過半數的説話者恰好只貢獻一段片段。
引導發言:大規模引出自發語音有其難度,因為參與者在缺乏結構指引時,往往只會給出簡短、零散的回應。因此,每段對話都以開放式敍事提示開始,再逐步揭示後續問題,涵蓋旅遊、醫療、農業、教育和數碼服務等範疇,引導交流者詳盡描述,但不為對話編寫腳本。候選話題由大型語言模型生成,再交由母語語言學家審閲和本地化。
品質控制:每段錄音在轉錄前都必須通過一系列關卡檢查。系統會使用以人工標註資料訓練、涵蓋超過 30 種語言的語言識別模型,核實錄音中的語言是否與指定語言相符。專用分類器會核對説話者性別與其自我申報標籤是否一致;分類器只用作佐證,而非取代自我申報。另一個模型則分辨真正的自發對話與預錄或播放的音訊。訊噪比估算會剔除清晰度低至無法理解的錄音;為保留真實環境中語音的聲學特徵,則刻意保留自然環境背景噪音。通過上述檢查的錄音會以語音活動偵測方式切段,在連續靜音達 2 秒時分段,或在 15 秒的軟性上限處分段,並以隨後偵測到的靜音作結。每個聲道會獨立切段,因此每段片段都只包含一位説話者和一個聲道。其後,片段會通過 DNSMOS P.808 檢查。
轉錄:參考謄本由人手完成。第一稿由以領域內資料訓練的內部 ASR 模型生成,這些模型均未出現在任何公開排行榜,因此沒有任何在這些資料集受評的系統參與建立自己要對照評分的參考文本。其後每個階段均由母語語言學家按五級流程處理,嚴格分工:每輪修正之後,都由另一位標註者進行獨立核實,因此沒有語言學家會審核自己的產出。語言學家先逐段對照聲學訊號修正初稿;第二位語言學家再核實,並標示仍有分歧之處。後續各級由新的標註者重複這個循環,逐步解決含糊的語音實現、語碼轉換界線、專有名詞,以及不同拼寫變體之間的一致性。數字一律寫成文字,令謄本直接對應實際説出的內容。最後一級仍被標記的片段會退回重新轉錄,通過後才會納入。系統全程自動監察標註者的行為,標記包含目標文字系統以外字元、不自然的字元或詞語重複,以及編輯次數異常偏低或偏高的提交內容。
地區差異
以下以印度英語公開資料集為例,展示元資料能進行哪類評測。這並非這些資料集旨在得出的研究發現,而是説明每段片段都帶有説話者資料後,哪些問題便能得到解答。
在這個資料集上,排行榜有 8 個模型的 WER 介乎 4.81 和 4.99。最好與最差相差 0.18 個百分點,這個差距落在 5 小時音訊能分辨的範圍之內。按整個語料庫排名,這些模型表現相同。
按地區分組説話者後,結果就不同了。每位説話者的原籍縣區會歸入邦議會區域劃分,即印度內政部對各邦的分組,形成 5 個採樣充足的區域。openai/whisper-large-v3-turbo 在各區之間的 WER 相差 0.46 個百分點。mistralai/Voxtral-Mini-3B-2507 在整體語料庫的表現只落後它 0.14 個百分點,但各區之間相差 1.68 個百分點,在中部地區的 WER 為 4.38,在東部則為 6.06。兩個在排行榜上難以區分的系統,其準確度受説話者來自哪裏影響的程度相差近 4 倍。

哪個地區最難轉錄也並非固定不變。ibm-granite/granite-speech-3.3-2b 在北部表現最差,microsoft/VibeVoice-ASR-HF 在南部最差,mistralai/Voxtral-Mini-3B-2507 則在東部最差。如果單純是某個地區比較難轉錄,每個模型對各區的排名應該都一樣,但事實並非如此,這顯示差異來自模型,而非音訊。
地區是 12 項記錄屬性之一;上述各區是把 428 個縣區粗略歸併而成。年齡、教育、職業和手機型號也可作同樣細分,公開檔案則包含重現分析所需的一切資料。只記錄説了甚麼的測試集,無法提供這些資料。
Hindi 的拼寫差異
英語拼寫差異的範圍有限,例如英式和美式拼法、標點、大小寫,以及用數字還是文字表示數值:正規化器可以把大部分差異轉成同一格式,排行榜使用的正規化器也能做到。Hindi 的情況並非如此。日常對話經常混用語言,源自英語的詞語沒有固定的天城文拼法,而合成詞會否連寫則視乎個人習慣。同一句話可能有 10 種或更多有效寫法,沒有固定的對應方式可將它們統一,因為根本不存在可作為唯一標準的一方。
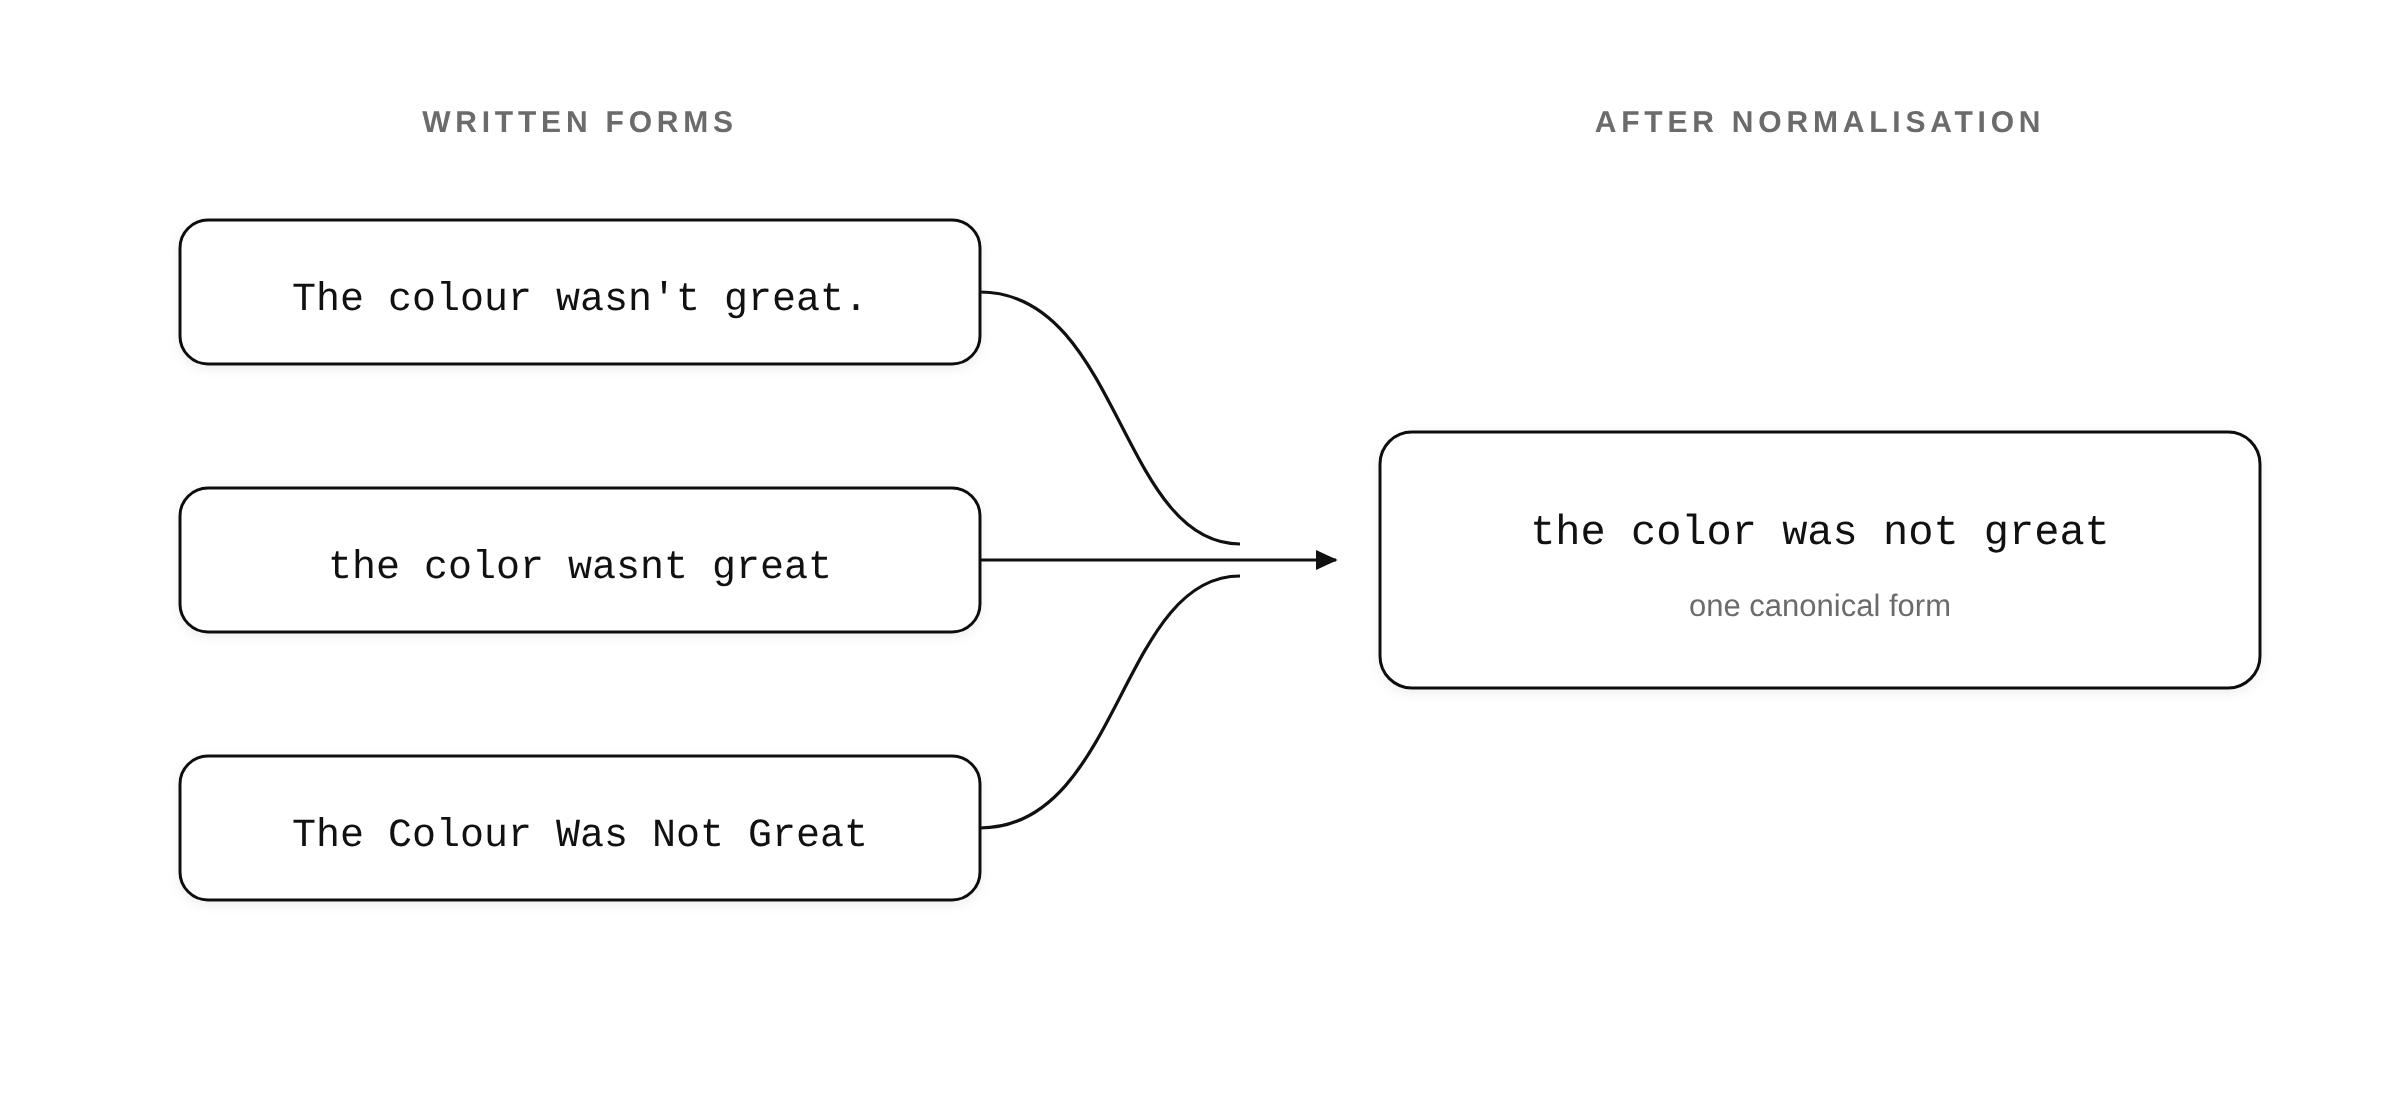
若只用單一參考謄本計分,WER 便會獎勵系統寫出標註者碰巧選用的拼法。兩個辨識音訊能力相同的系統,也可能單因拼寫差異而相差數個百分點。
因此,Hindi 資料集提供格狀謄本:對謄本的每個片段,列出可接受為正確的寫法。建立格狀謄本需要人手處理。系統會從同一段音訊的多份 ASR 謄本抽取候選變體,再透過語言模型擴充;之後由母語語言學家判斷哪些寫法適用於該句話,並剔除其餘寫法,確保只有符合實際説話內容的形式才會被接受。
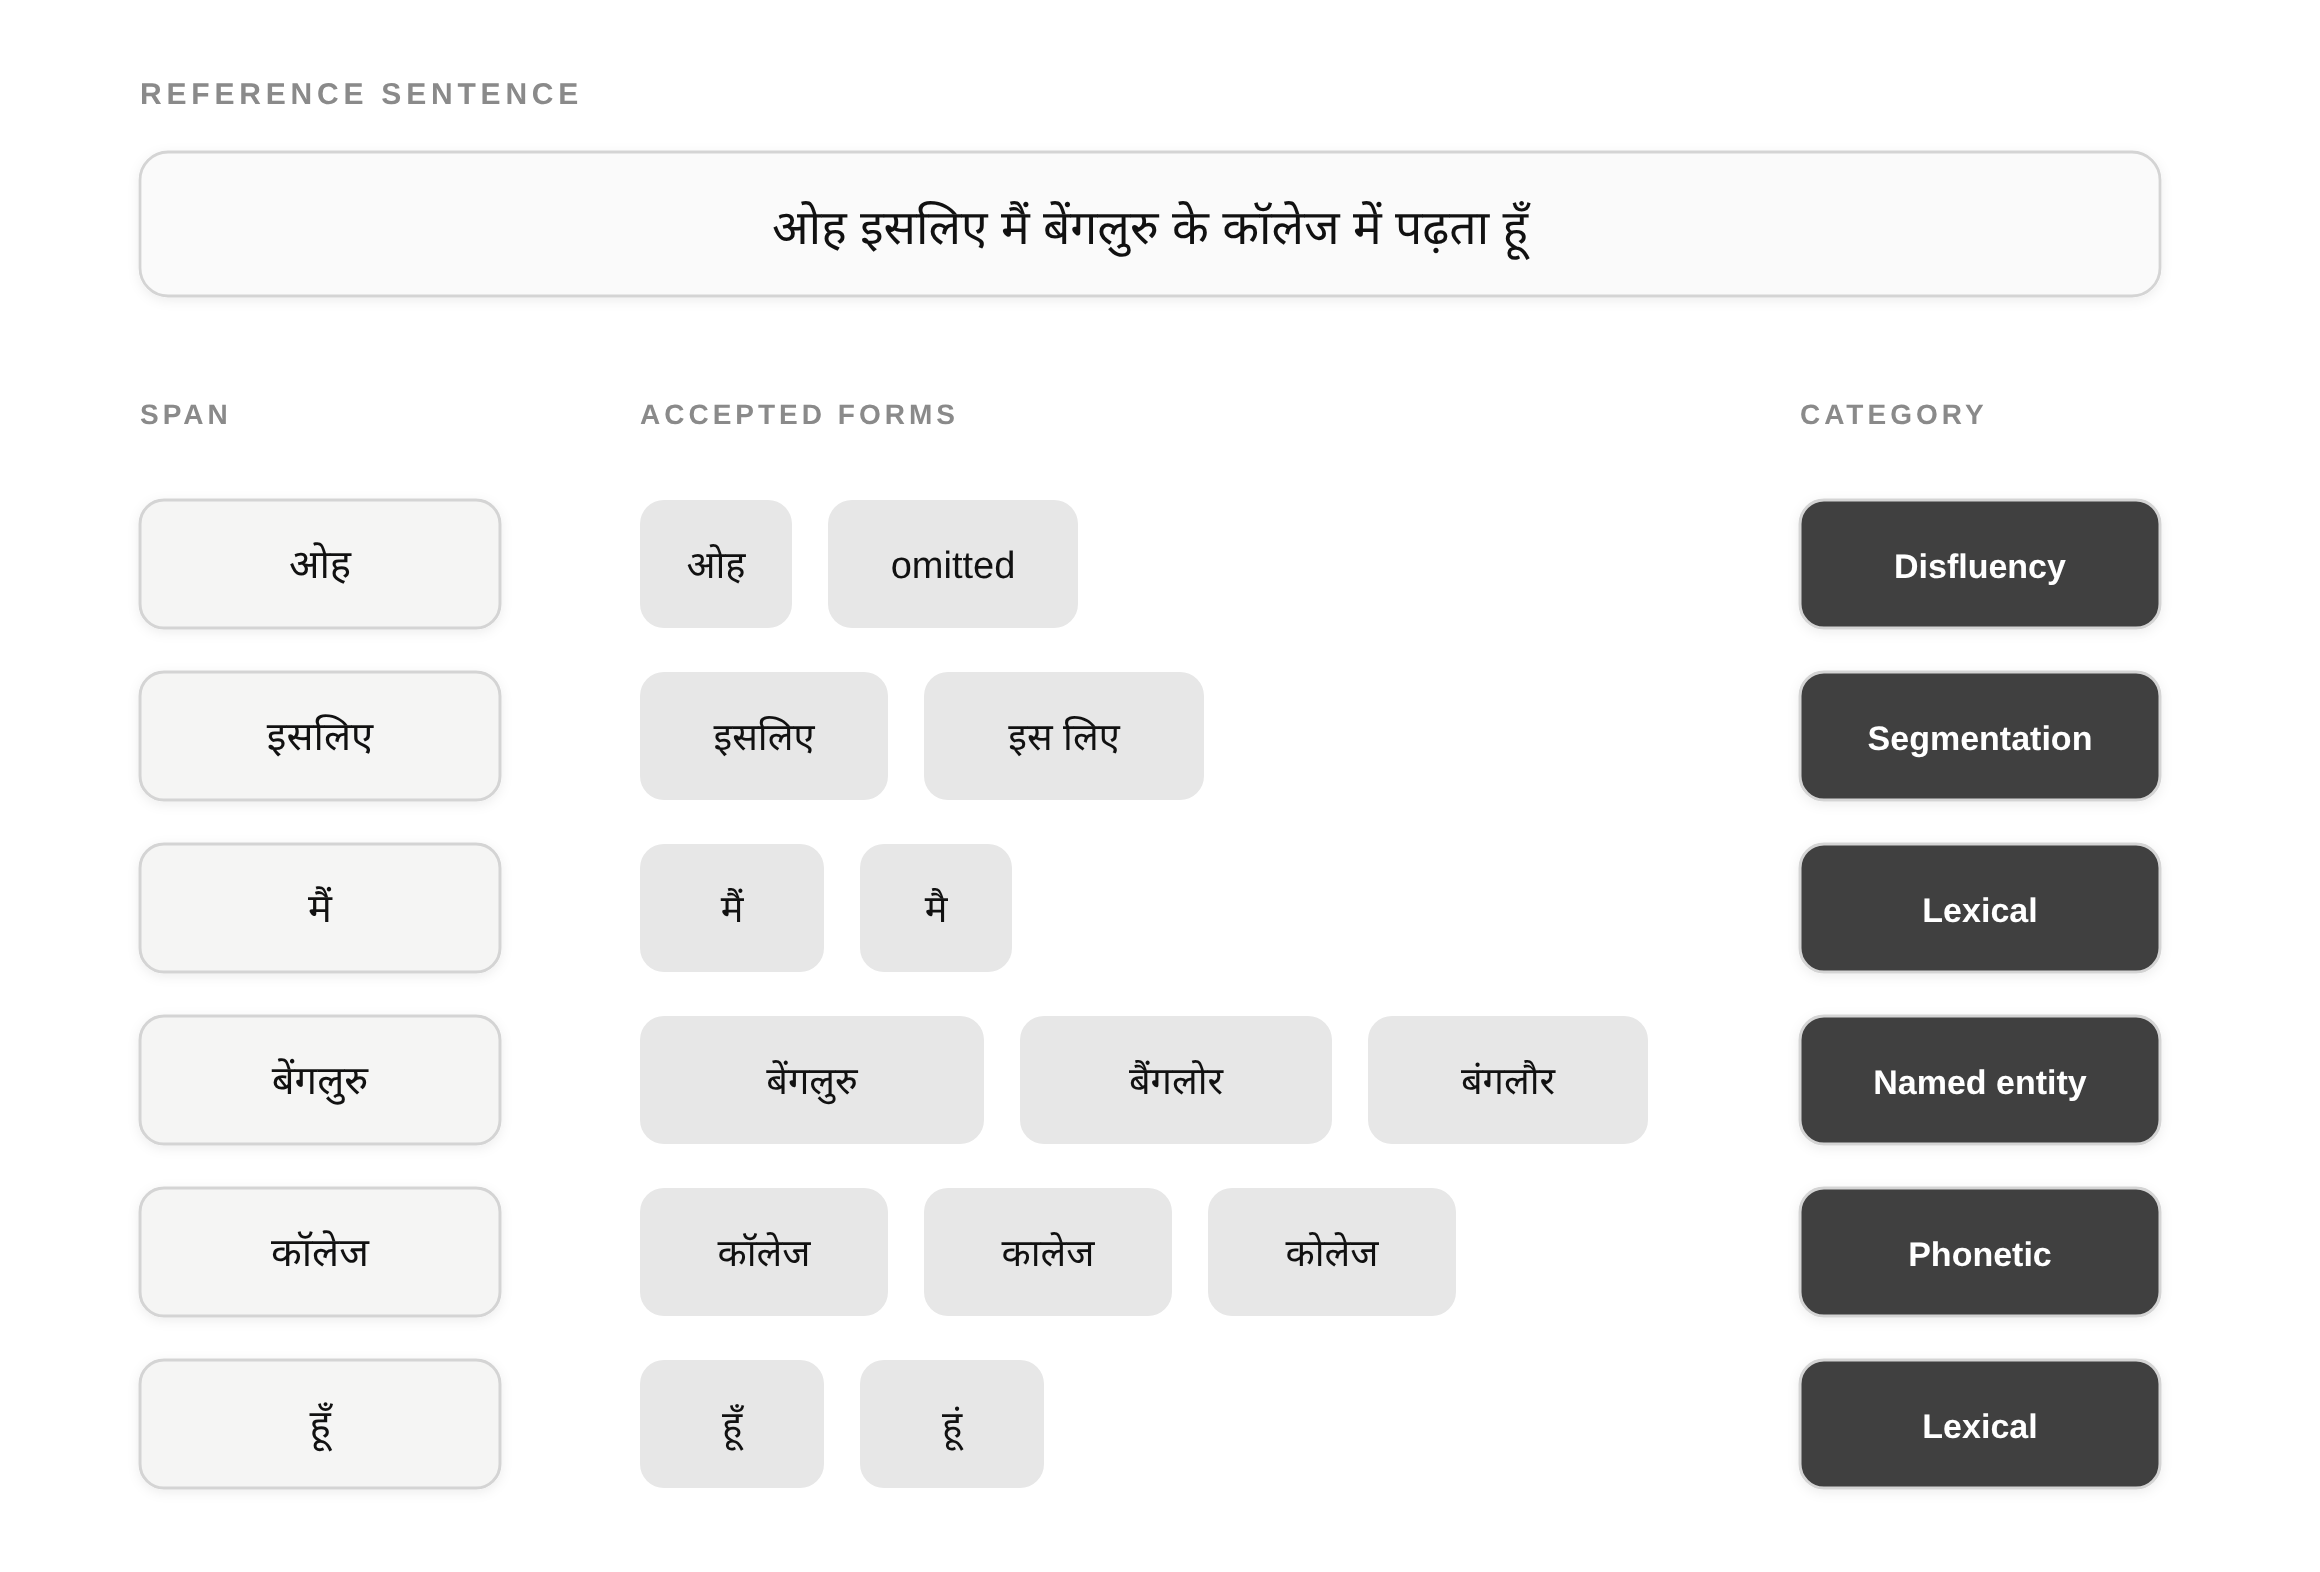
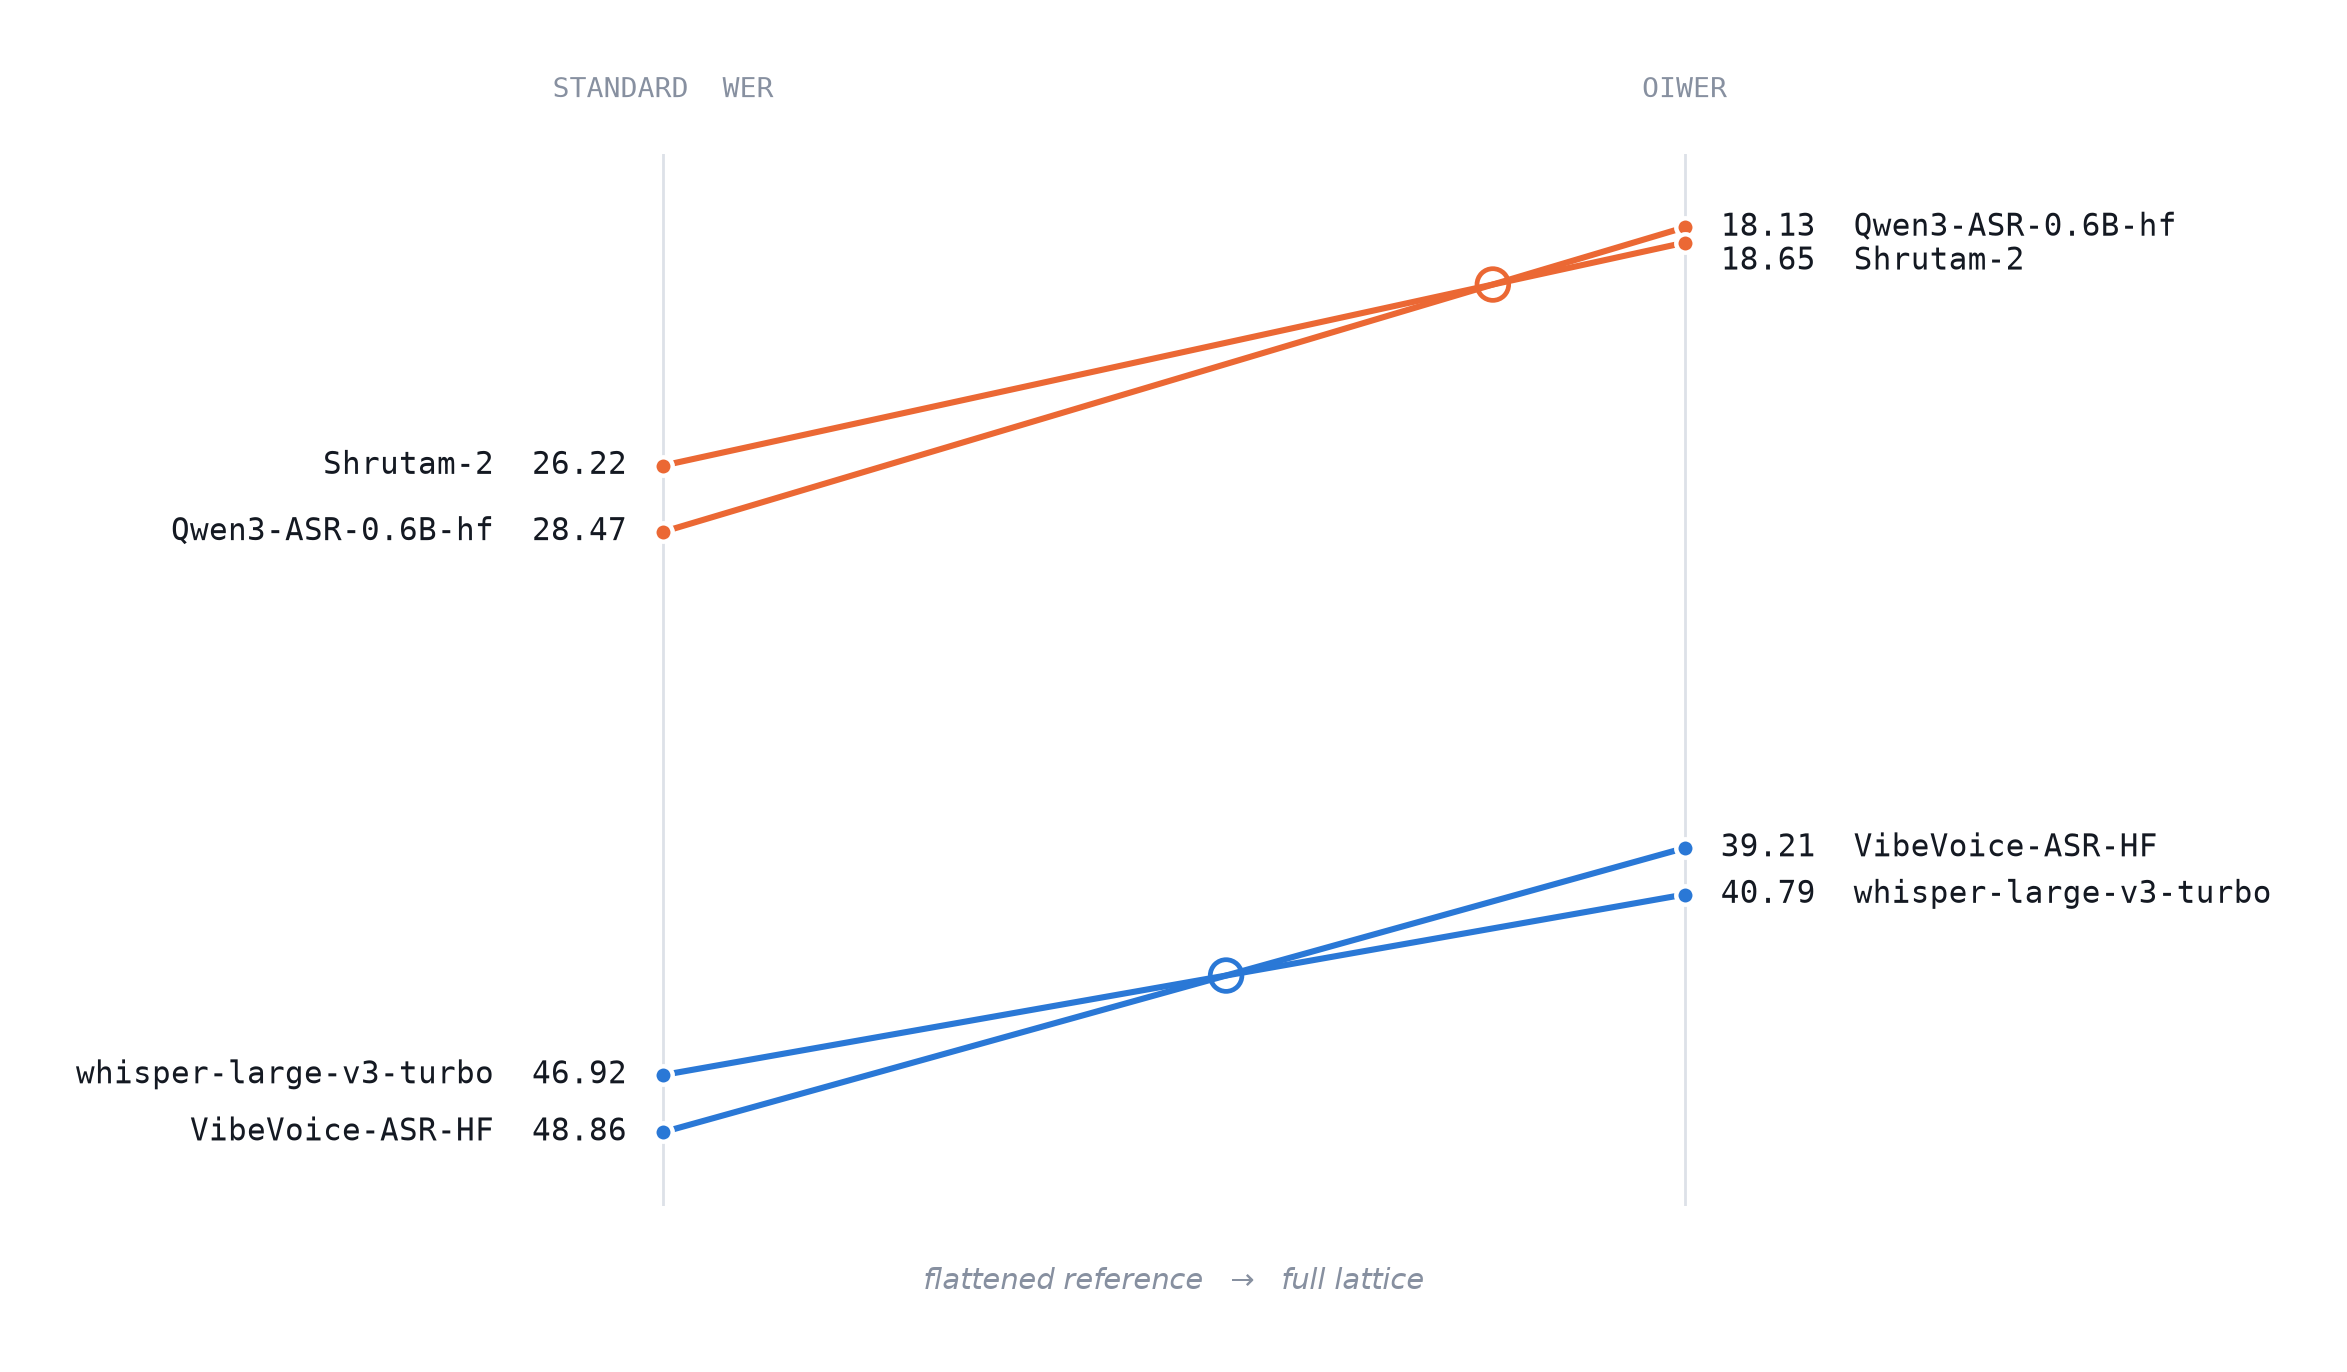
因此,Hindi 採用 AI4Bharat 提出的 Orthographically-Informed Word Error Rate(OIWER,拼寫感知詞錯誤率),而非 WER。系統會將假設謄本與每個片段的可接受寫法集合比對;任何獲接納的形式都計作正確,只有真正的辨識錯誤才會被扣分。
為量化其影響,我們以相同的假設謄本評分兩次。把每個格狀謄本各片段的第一個變體攤平成單一參考字串,就會得到傳統基準測試常用的格式;任何已接納的變體都同樣有效,改用另一種寫法便會得到另一份參考謄本。以攤平後的參考謄本計分,所有系統的錯誤率都上升,而且升幅並不一致,因此排名也會改變。下圖顯示兩組系統在兩種參考謄本下排名互換:採用單一參考謄本時,系統會部分因重現標註者的拼寫習慣而得分;格狀謄本評量的則只有辨識能力。
我們也以開放原始碼方式發布實作 voi-oiwer,讓任何人都能直接重現這些資料集上的所有結果。
參與評測
若要使用私人資料集評測,請先將模型提交至 Open ASR Leaderboard,Hugging Face 團隊便會執行評測。與以往一樣,將模型加入排行榜的流程在 Open ASR Leaderboard GitHub 上進行:
- 提交 pull request 後,系統會顯示模型檢查清單。與以往一樣,你應提交模型在公開資料集上的結果。
- 我們會核實模型在公開資料集上的結果,並計算它在私人資料集上的指標。
- 請確認我們得出的結果。
印度英語加入主排行榜,顯示名稱為 Voice Arena Monsoon,並列入預設欄目,而非需要自行選取才顯示,因此會計入每個模型的標題 Average WER。私人資料集的結果會匯總至 Private (conversational) 欄目,並與Appen 和 DataoceanAI 資料一同顯示。Hindi 的公開及私人資料會顯示在Multilingual 分頁;只有支援所有已選語言的模型才會排名,令欄目中的比較更公平。或者,可在「Language dataset breakdown」下拉式選單中選取「Hindi」。
接下來
Hindi 是一個突出的例子,反映更普遍的問題。任何以多種方式書寫、又由基準測試未曾採樣的羣體使用的語言,都同時面對本文所述的兩種缺陷。這些資料集無法解決問題,但可以讓我們看見問題:它們登上業界已有關注的排行榜,並記錄足夠的説話者和參考謄本資料,令兩個系統之間的差異可以追溯至説話者的身分及其書寫習慣,而非消失在單一數字之中。
這四個資料集均屬於 Monsoon,是 Voice Arena 面向全球南方的整體資料集計劃之一部分。
來源:Hugging Face Blog · huggingface.co