Hugging Face Inference Endpoints 部署 ASR、説話人分離與推測解碼流程
Powerful ASR + diarization + speculative decoding with Hugging Face Inference Endpoints
Hugging Face 示範透過自訂 inference handler,在 Hugging Face Inference Endpoints 將 ASR、説話人分離與推測解碼整合至單一 API endpoint。
文章展示如何把 ASR、説話人分離與推測解碼組成單一端點,並以長短音訊基準説明推測解碼的效益會隨輸入長度改變。
Whisper 是其中一款最佳的開源語音識別模型,而且肯定是使用最廣泛的一款。Hugging Face Inference Endpoints 讓你可以輕鬆部署任何 Whisper 模型,開箱即用。不過,如果你想加入其他功能,例如識別説話者的分段管道,或用於推測解碼的輔助生成,事情就會複雜一點,因為你必須將 Whisper 與其他模型整合,同時仍只提供單一 API 端點。
我們會使用自訂推論處理器來解決這個問題,在 Inference Endpoints 上實作自動語音識別(ASR)和説話者分段管道,並支援推測解碼。分段管道的實作參考了知名的 Insanely Fast Whisper,並使用 Pyannote 模型進行説話者分段。
這亦示範了 Inference Endpoints 的靈活性:幾乎任何內容都可以在上面託管。你可在這裏取得跟隨教學所需的程式碼。請注意,端點初始化時會掛載整個儲存庫,因此 handler.py 可引用儲存庫內的其他檔案,毋須把所有邏輯放在單一檔案中。這個例子把程式碼分成多個檔案,方便整理:
handler.py包含初始化和推論程式碼diarization_utils.py包含所有説話者分段相關的前處理和後處理config.py包含ModelSettings和InferenceConfig。ModelSettings用來指定管道會使用哪些模型(不一定要全部使用),而InferenceConfig則定義預設推論參數
由 Pytorch 2.2 起,SDPA 已原生支援 Flash Attention 2,因此我們會使用這個版本加快推論。
主要模組
以下是端點內部運作方式的高層次示意圖:
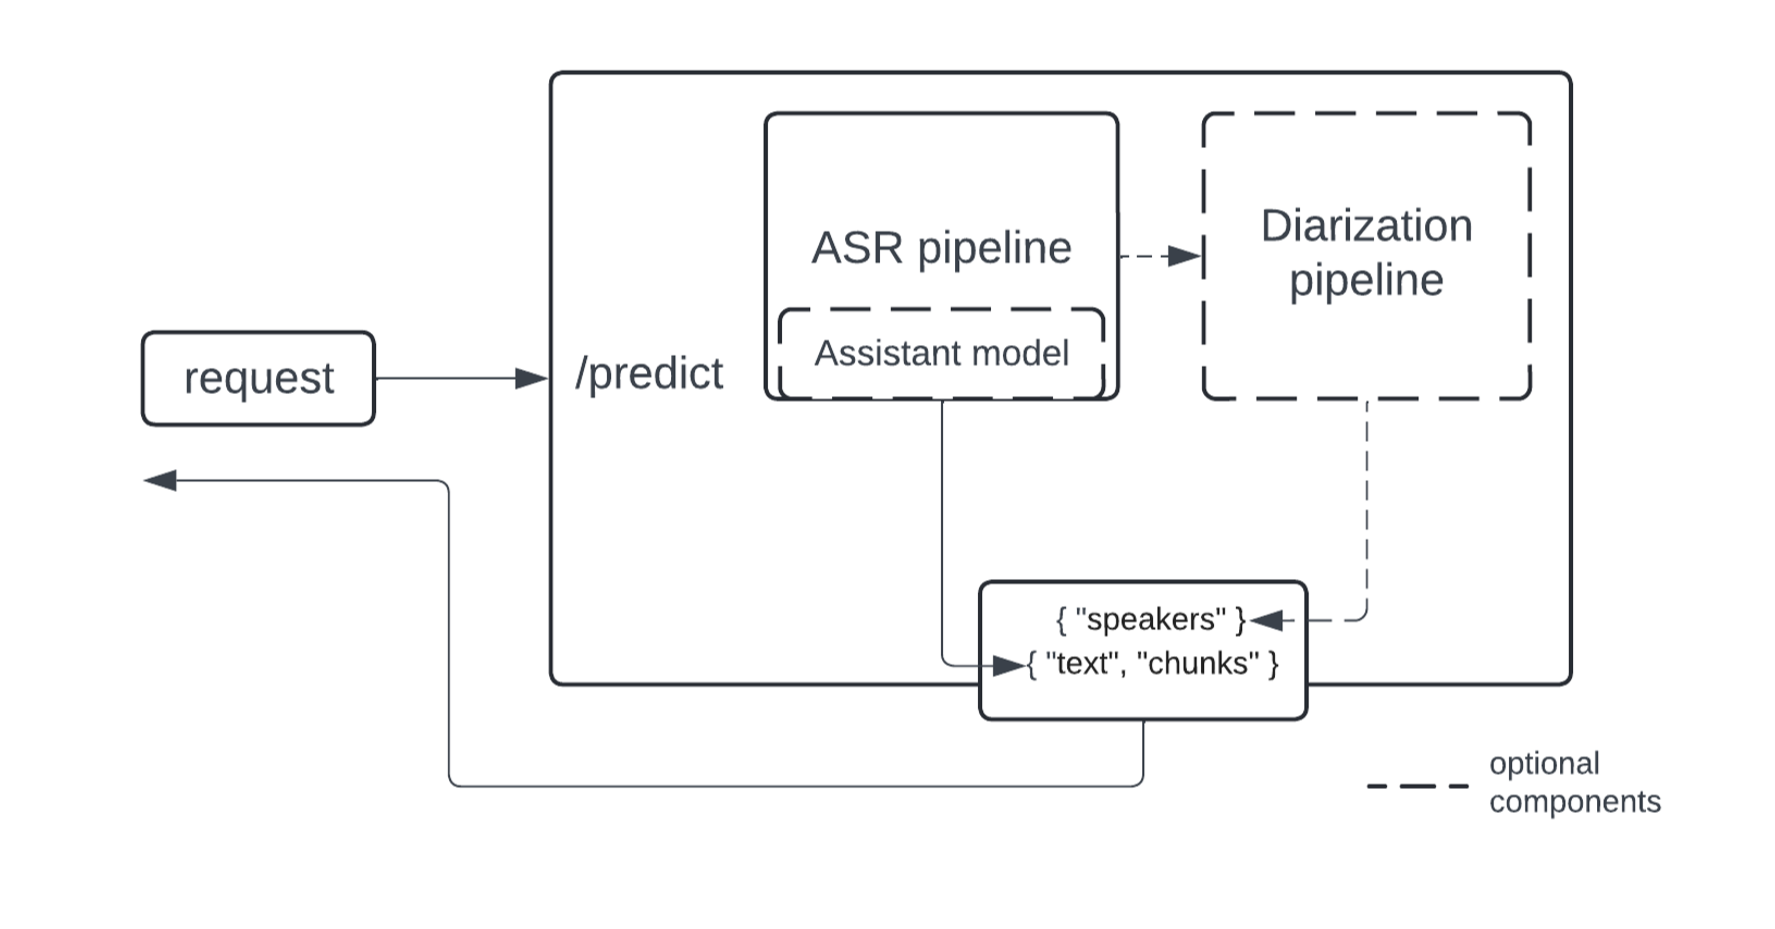
ASR 和説話者分段管道採用模組化設計,以配合更多使用情境:分段管道以 ASR 輸出為基礎;若不需要分段功能,也可以只使用 ASR 部分。至於説話者分段,我們建議使用 Pyannote 模型,目前這是最先進的開源實作。
我們亦會加入推測解碼以加快推論。方法是使用較小、速度較快的模型提出生成候選內容,再由較大型模型驗證,藉此加速。如想了解它如何特別應用於 Whisper,請參閲這篇精彩網誌文章。
推測解碼有以下限制:
- 輔助模型至少要有與主模型相同架構的解碼器部分
- 批次大小必須為 1
請將以上限制納入考慮。視乎你的生產使用情境,支援較大的批次可能比推測解碼更快。如果你不打算使用輔助模型,只需在設定中將 assistant_model 保持為 None。
如果你會使用輔助模型,Whisper 的理想選擇是蒸餾版本。
設定自己的端點
最簡單的開始方法,是使用 自訂處理器儲存庫,並透過 repo duplicator 複製它。
以下是 handler.py 中載入模型的程式碼:
from pyannote.audio import Pipeline
from transformers import pipeline, AutoModelForCausalLM

...

self.asr_pipeline = pipeline(
      "automatic-speech-recognition",
      model=model_settings.asr_model,
      torch_dtype=torch_dtype,
      device=device
  )

  self.assistant_model = AutoModelForCausalLM.from_pretrained(
      model_settings.assistant_model,
      torch_dtype=torch_dtype,
      low_cpu_mem_usage=True,
      use_safetensors=True
  )

  ...

  self.diarization_pipeline = Pipeline.from_pretrained(
      checkpoint_path=model_settings.diarization_model,
      use_auth_token=model_settings.hf_token,
  )

  ...
你可以按需要自訂管道。ModelSettings(位於 config.py 檔案中)儲存初始化參數,用來指定推論時使用的模型:
class ModelSettings(BaseSettings):
    asr_model: str
    assistant_model: Optional[str] = None
    diarization_model: Optional[str] = None
    hf_token: Optional[str] = None
你可以傳入名稱相應的環境變數來調整參數;自訂容器和推論處理器都適用。這是 Pydantic 的功能。若要在建置時向容器傳入環境變數,就必須透過 API 呼叫建立端點(而非使用介面)。
你可以直接寫死模型名稱,而不透過環境變數傳入;但請注意,説話者分段管道要求明確傳入 Token(hf_token)。基於安全理由,不可將 Token 寫死在程式碼中,因此若要使用説話者分段模型,就必須透過 API 呼叫建立端點。
提醒一下,所有説話者分段相關的前處理和後處理工具都在 diarization_utils.py 中。
唯一必需的元件是 ASR 模型。你可選擇指定輔助模型用於推測解碼,也可使用説話者分段模型,按説話者區分轉錄內容。
在 Inference Endpoints 上部署
如果你只需要 ASR 部分,可指定 asr_model/assistant_model,並在 config.py 中設定,然後按一下按鈕部署:
若要向託管於 Inference Endpoints 的容器傳入環境變數,必須使用提供的 API以程式方式建立端點。以下是呼叫範例:
body = {
    "compute": {
        "accelerator": "gpu",
        "instanceSize": "medium",
        "instanceType": "g5.2xlarge",
        "scaling": {
            "maxReplica": 1,
            "minReplica": 0
        }
    },
    "model": {
        "framework": "pytorch",
        "image": {
            # a default container
            "huggingface": {
                "env": {
            # this is where a Hub model gets mounted
                    "HF_MODEL_DIR": "/repository",
                    "DIARIZATION_MODEL": "pyannote/speaker-diarization-3.1",
                    "HF_TOKEN": "<your_token>",
                    "ASR_MODEL": "openai/whisper-large-v3",
                    "ASSISTANT_MODEL": "distil-whisper/distil-large-v3"
                }
            }
        },
        # a model repository on the Hub
        "repository": "sergeipetrov/asrdiarization-handler",
        "task": "custom"
    },
    # the endpoint name
    "name": "asr-diarization-1",
    "provider": {
        "region": "us-east-1",
        "vendor": "aws"
    },
    "type": "private"
}
何時使用輔助模型
以下是使用 k6 進行的基準測試,可幫助你瞭解何時使用輔助模型較有利:
# Setup:
# GPU: A10
ASR_MODEL=openai/whisper-large-v3
ASSISTANT_MODEL=distil-whisper/distil-large-v3

# long: 60s audio; short: 8s audio
long_assisted..................: avg=4.15s    min=3.84s    med=3.95s    max=6.88s    p(90)=4.03s    p(95)=4.89s
long_not_assisted..............: avg=3.48s    min=3.42s    med=3.46s    max=3.71s    p(90)=3.56s    p(95)=3.61s
short_assisted.................: avg=326.96ms min=313.01ms med=319.41ms max=960.75ms p(90)=325.55ms p(95)=326.07ms
short_not_assisted.............: avg=784.35ms min=736.55ms med=747.67ms max=2s       p(90)=772.9ms  p(95)=774.1ms
如你所見,音訊較短時,輔助生成可大幅提升效能(批次大小為 1)。音訊較長時,推論會自動將音訊切分為多個批次;由於上述限制,推測解碼可能反而拖慢推論。
推論參數
所有推論參數都在 config.py 中:
class InferenceConfig(BaseModel):
    task: Literal["transcribe", "translate"] = "transcribe"
    batch_size: int = 24
    assisted: bool = False
    chunk_length_s: int = 30
    sampling_rate: int = 16000
    language: Optional[str] = None
    num_speakers: Optional[int] = None
    min_speakers: Optional[int] = None
    max_speakers: Optional[int] = None
你當然可以按需要新增或移除參數。與説話者數目相關的參數會傳給説話者分段管道,其餘大多供 ASR 管道使用。sampling_rate 表示待處理音訊的取樣率,供前處理使用;assisted 旗標則指定管道是否使用推測解碼。請記住,使用輔助生成時,batch_size 必須設為 1。
負載
部署完成後,可將音訊連同推論參數傳送至推論端點,例如以下 Python 程式碼:
import base64
import requests

API_URL = "<your endpoint URL>"
filepath = "/path/to/audio"

with open(filepath, "rb") as f:
    audio_encoded = base64.b64encode(f.read()).decode("utf-8")

data = {
    "inputs": audio_encoded,
    "parameters": {
        "batch_size": 24
    }
}

resp = requests.post(API_URL, json=data, headers={"Authorization": "Bearer <your token>"})
print(resp.json())
這裏的 「parameters」 欄位是一個字典,包含你想透過 InferenceConfig 調整的所有參數。請注意,未在 InferenceConfig 指定的參數都會被忽略。
亦可使用 InferenceClient(另有非同步版本):
from huggingface_hub import InferenceClient

client = InferenceClient(model = "<your endpoint URL>", token="<your token>")

with open("/path/to/audio", "rb") as f:
    audio_encoded = base64.b64encode(f.read()).decode("utf-8")
data = {
    "inputs": audio_encoded,
    "parameters": {
        "batch_size": 24
    }
}

res = client.post(json=data)
總結
本文説明瞭如何使用 Hugging Face Inference Endpoints,設定模組化的 ASR + 説話者分段 + 推測解碼管道。我們盡量令管道容易設定和按需要調整;而透過 Inference Endpoints 部署一向十分簡單!我們很幸運,社羣有不少出色且公開提供的模型和工具,並在實作中用到:
- OpenAI 的一系列 Whisper 模型
- Pyannote 的説話者分段模型
- 作為主要靈感來源的 Insanely Fast Whisper 儲存庫
另有一個儲存庫實作了相同管道,並包含伺服器部分(FastAPI+Uvicorn)。如果你想進一步自訂,或將它託管在其他地方,這個專案可能派得上用場。
來源:Hugging Face Blog · huggingface.co