Amazon SageMaker AI 多輪強化學習實作指南
Multi-Turn Reinforcement Learning on Amazon SageMaker AI: A hands-on guide
Amazon SageMaker AI 的多輪強化學習(MTRL)可按整個任務的結果獎勵訓練 Agent 模型,文章以 Wordle 展示端到端實作流程。以 medium effort、temperature 1.0 評估時,gpt-oss-20b 的解題率由 61% 升至 84%;訓練 token 費用約 $339,AgentCore 執行環境費用另約 $79。
文章以 Wordle 示範按多輪任務整體結果設計獎勵的方法,並拆解 SageMaker AI 訓練流程,提供企業內部工作流可參照的實作脈絡。
大多數微調都是教模型根據單一提示詞產生更好的答案。Agent 任務則有所不同。負責提交費用報銷單或分流支援工單的 Agent,需要執行一連串動作,而每個步驟都取決於此前的進展。通常沒有唯一正確的行動順序可供模仿,而唯一可靠的回饋,是整個流程是否成功。監督式微調沒有這類標籤,而單輪強化學習無法將最終結果歸因於三個步驟前作出的決策。
Amazon SageMaker AI 上的多輪強化學習(MTRL)正是根據這種訊號訓練模型。SageMaker AI 會透過 AWS Lambda 轉發器,將提示詞傳送至你託管於 Amazon Bedrock AgentCore 的 Agent,或部署在你自有基礎設施上的 Agent,例如 Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon Elastic Compute Cloud (Amazon EC2) 或 AWS Fargate。本文的示例使用 AgentCore。Agent 會呼叫正在訓練的策略模型,按任務需要在你的環境中執行多輪操作,並在一次執行回合結束時回報一次獎勵。你無須指定正確的行動軌跡,只需定義如何為結果評分。
本文以 Wordle 為例。這是一款玩家有六次機會猜出一個隱藏五字母單詞的遊戲。每次猜測後,如果字母位置正確,該字母會變成綠色;如果該字母在答案中但位置不同,會變成黃色;如果該字母不在答案中,則會變成灰色。Wordle 很適合用來示範 MTRL,因為遊戲規則不多,每次猜測都取決於上一次的回饋,而且結果可以客觀評分。Wordle 只是教學示例,前沿模型早已能玩得很好。實際上,你會用 MTRL 讓成本較低的小型模型擅長處理專屬於你業務的多步驟任務,例如公開模型從未受訓處理的內部工作流程。同一套流程也適用於這類情況。
在我們的測試中,MTRL 令 gpt-oss-20b 在預設推理力度下,對留出詞彙的解題率由 61% 提升至 84%;在訓練時採用的低推理力度下,解題率則由 15% 提升至 69%,訓練 token 成本約為 $339。本文會逐步介紹整套流程:將 Agent 和獎勵函數部署到 AgentCore、準備數據集、進行訓練、在 MLflow 監控,以及按照服務設定進行評估。我們亦會分享設計獎勵時犯下的錯誤,以及遇到的訓練失敗。你的數據集、Agent 和訓練完成的模型都會留在你的 AWS 帳戶內,且不會用於訓練基礎模型。所有程式碼都在隨文提供的 aws-samples repository。
解決方案概覽
系統分為兩部分。SageMaker AI 負責訓練工作和策略模型;AgentCore 則託管 Agent、Wordle 環境和獎勵函數。下圖展示兩者如何連接。
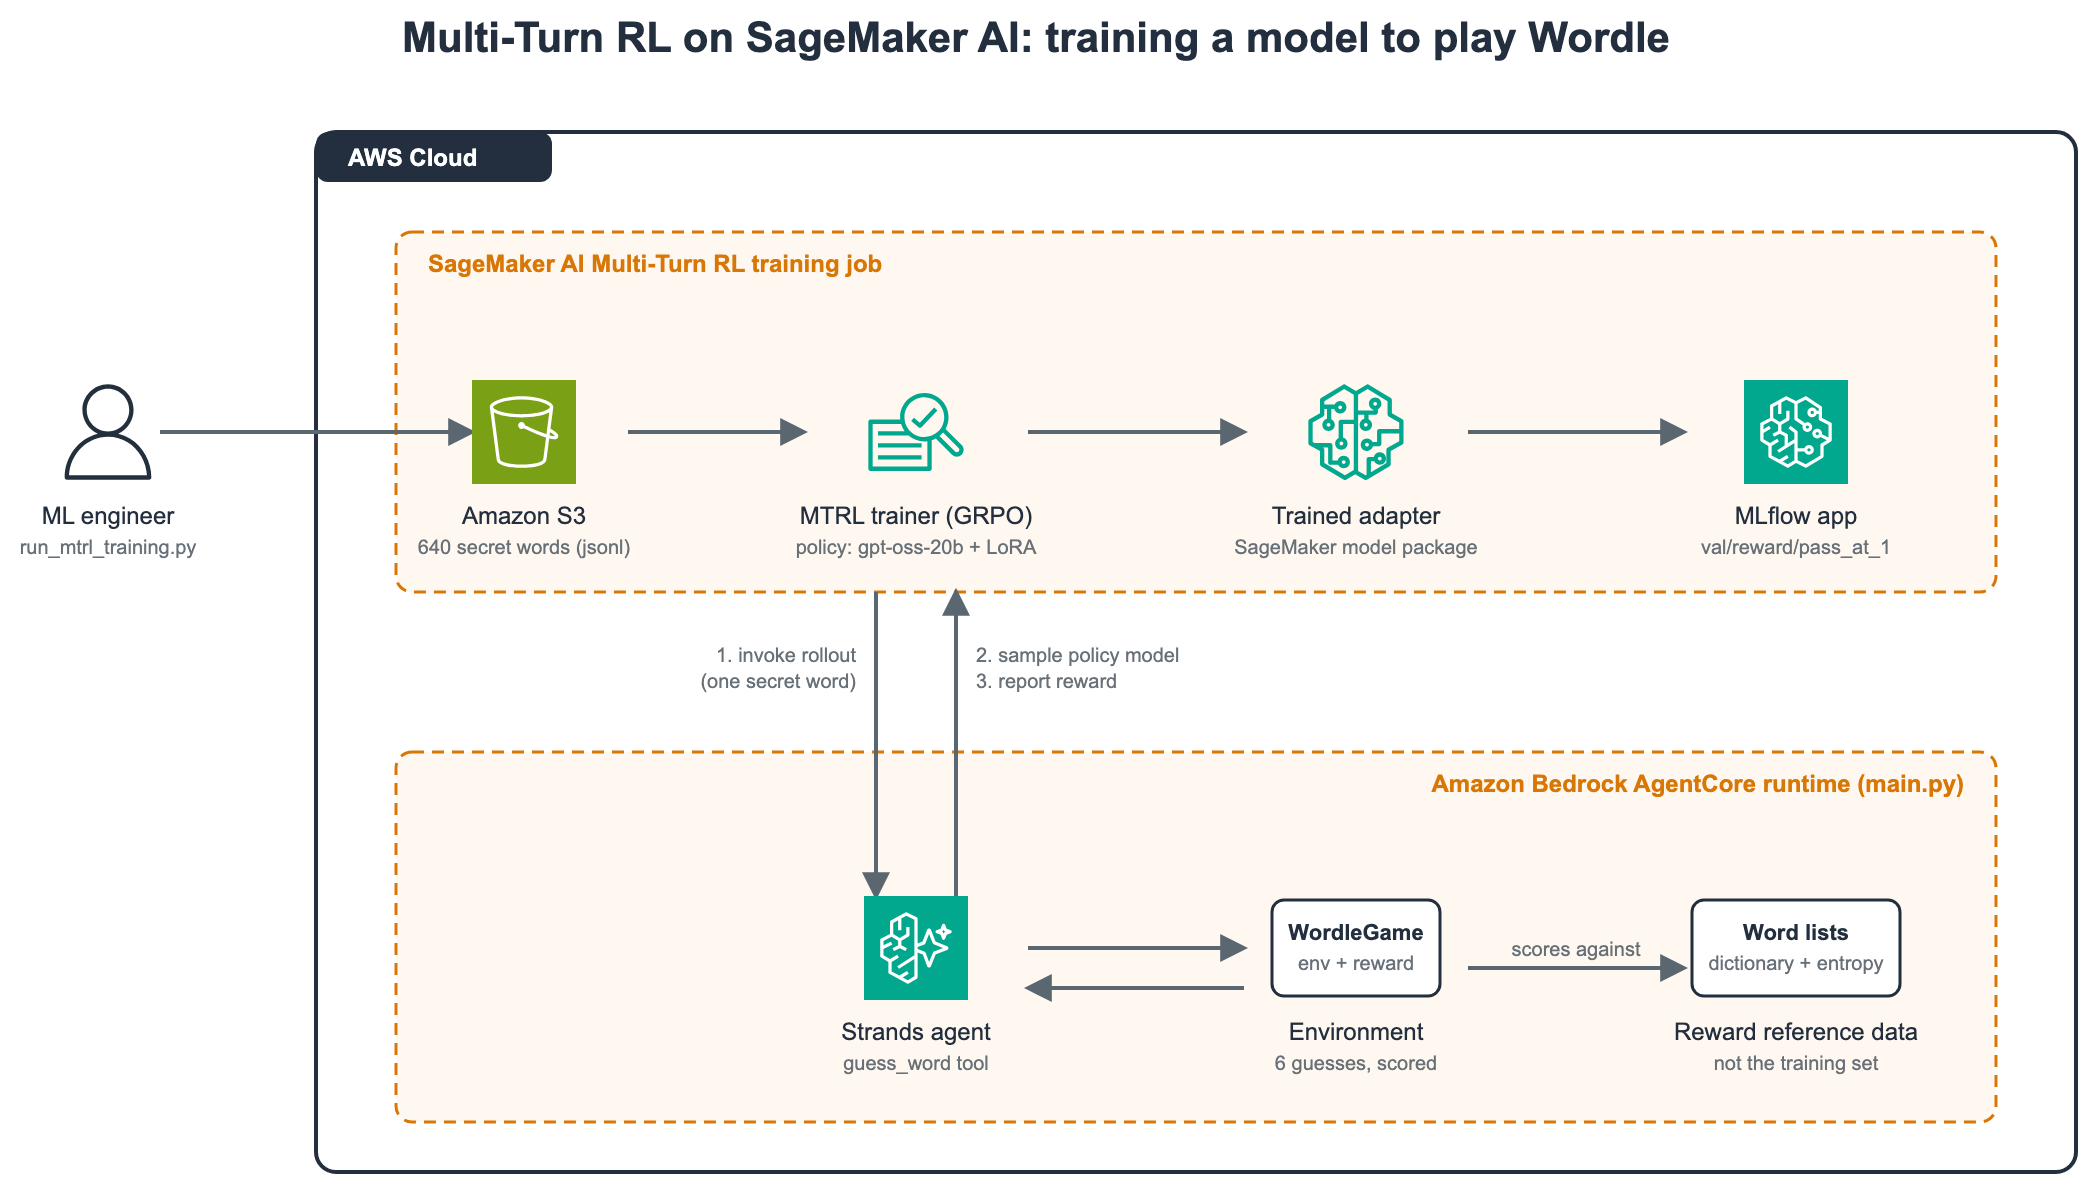
圖 1:在 SageMaker AI 上進行 MTRL。訓練工作每次 rollout 都會呼叫一次由 AgentCore 託管的 Agent,從策略模型抽樣、進行遊戲,並回報獎勵
每次 rollout 中,MTRL 服務都會以一筆訓練資料列呼叫 AgentCore runtime(Amazon Bedrock AgentCore 的一項功能),而該資料列只包含一個秘密字詞。runtime 內的 Strands agent 會透過 SageMaker Job Runtime 的 OpenAI 相容端點呼叫策略模型。模型會透過一個工具 guess_word 最多猜六次;每次猜測後,環境都會傳回逐個字母的回饋,以及目前已知資訊的摘要。遊戲結束時,agent 會傳回一個獎勵值。羣組相對策略最佳化(GRPO)會根據同一字詞在多次 rollout 中的獎勵差異,更新策略模型上的低秩適配(LoRA)adapter。
以下三個設計要點與後續內容有關:
- agent 和獎勵都放在同一處。部署到 AgentCore 的單一 Python 檔案包含環境、工具和評分函數。
- 數據集只包含秘密字詞。agent 隨附的詞表由開源 SCOWL 詞表建立,只用於評分。
- 獎勵以結果為主。成功解出可獲 1.05–1.55 的獎勵,視乎速度;失敗則為 -0.5;從未作出有效猜測則為 -1.5。每個級別內的良好策略亦會獲得少量獎勵塑形分。
支援的模型和 AWS 區域
MTRL 採用無伺服器架構:你只需選擇基礎模型,服務便會配置訓練和抽樣基礎架構。撰寫本文時,服務支援以下基礎模型,各自透過 LoRA adapter 進行訓練:
| 基礎模型 | AWS 區域 |
| Amazon Nova 2 Lite | US East (N. Virginia) (us-east-1), US West (Oregon) (us-west-2) |
GPT-OSS-20B |
US East (N. Virginia) (us-east-1), US West (Oregon) (us-west-2) |
| Gemma 4 31B(指令微調版) | US West (Oregon) (us-west-2) |
| Qwen 3.6 27B | US West (Oregon) (us-west-2) |
我們選擇 GPT-OSS-20B,因為四款模型之中,它的每 token 價格最低,而且每次請求都可以控制推理力度。請參閲 MTRL 文件,瞭解目前的清單。
定價
你無須選擇執行個體或配置叢集。服務按基礎模型定價,並按三個維度以每百萬個 token 計費:
- Prefill:策略模型處理的輸入 token。這些 token 會在多輪任務中累積,因為每一輪都會重新讀取對話歷史。
- Sample:策略模型生成的 token,包括推理 token。
- Train:在反向傳播過程中處理、用於更新 LoRA adapter 的 token。
這次 100 步執行在 12 小時 40 分鐘內進行了 105,486 次 rollout,共消耗 491.6 million 個 prefill token、159.7 million 個 sample token,以及 643.3 million 個 train token。按撰寫本文時 GPT-OSS-20B 在 US East (N. Virginia) 區域 (us-east-1) 的價目表價格計算,費用約為 $339:
| 維度 | Token 數量 | 每 1M 個 token 的價格 | 費用 |
| Prefill | 491,616,806 | $0.12 | $58.99 |
| Sample | 159,737,098 | $0.30 | $47.92 |
| Train | 643,308,554 | $0.36 | $231.59 |
| Total | 1,294,662,458 | $338.50 |
Train 維度的費用佔比最高,並會隨軌跡長度增加,因此縮短遊戲時間和減少冗長推理都能降低費用。AgentCore runtime 會就 agent 使用的 vCPU 和記憶體另行收費。按 us-east-1 的價目表價格計算,這次執行的費用約為 $79。相關數據來自 runtime 的 Amazon CloudWatch 使用量指標。DescribeJob會在 BillableTokenUsage 下列出 token 數量。請參閲 Amazon SageMaker AI 定價,瞭解最新價格。
先決條件
如要跟隨本教學操作,你需要具備以下條件。另請參閲 MTRL 先決條件。
- Python 3.10 或更新版本、uv、Node 20 或更新版本,以及 AgentCore CLI(
npm install -g @aws/agentcore)。安裝方法及 CLI 所需的 IAM 權限,請參閲 開始使用 Amazon Bedrock AgentCore。 - 在啟動工作之機器上安裝 botocore 1.43.37 或更新版本。這是首個包含
AgentRFTCreateJob操作的版本。 - 兩個 AWS Identity and Access Management (IAM) 角色,詳情見步驟 1。
- 一個與 Agent 位於同一區域的 Amazon Simple Storage Service (Amazon S3) 儲存貯體。訓練工作亦必須在該區域執行,因為
CreateJob不接受跨區域的執行環境 ARN。
步驟 1:建立 IAM 角色
MTRL 使用兩個角色,其中一個角色的信任政策未有在 SageMaker AI 一般文件中提及。
Agent 執行環境角色。 agentcore deploy 會為你建立此角色。此角色信任 bedrock-agentcore.amazonaws.com,並需要 AmazonSageMakerJobRuntimeAccess 受管政策,讓 Agent 呼叫策略模型及回報獎勵。範例儲存庫中的 CDK 堆疊會自動附加此政策。
訓練工作角色。 此角色由你建立。它必須透過 sts:AssumeRole 和 sts:TagSession 信任 job.sagemaker.amazonaws.com,並需要 AmazonSageMakerJobFullAccess 受管政策。
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "job.sagemaker.amazonaws.com"},
        "Action": ["sts:AssumeRole", "sts:TagSession"]
    }]
}注意:信任主體是 job.sagemaker.amazonaws.com,而不是 sagemaker.amazonaws.com。若使用一般主體,CreateJob 會以「無法承擔角色」失敗;重試後,訊息才會指出正確的主體。
步驟 2:將 Agent 部署至 Amazon Bedrock AgentCore
複製範例儲存庫,在 Wordle/agentcore/aws-targets.json 設定你的帳戶和區域,然後部署:
git clone https://github.com/aws-samples/sample-multi-turn-rl-wordle
cd sample-multi-turn-rl-wordle/Wordle
agentcore validate
agentcore deploy
CLI 會為執行環境的 Linux ARM64 平台建置 Agent 的相依套件,建立附加了 AmazonSageMakerJobRuntimeAccess 的執行角色,並透過 AWS CloudFormation 部署。我們建議使用 CLI,而非在主控台上傳程式碼套件;這種做法常會弄錯約 700 MB 的已編譯相依套件,或政策附加設定。請記下輸出中的執行環境 ARN,供訓練工作使用。
圖 2:Amazon Bedrock AgentCore 主控台中的 Wordle Agent 執行環境,狀態為 Ready
執行環境會從 agentcore.json 讀取兩個環境變數。REASONING_EFFORT=low 會在每次向策略模型發出請求時設定 reasoning_effort。在我們的評估工作中,每局使用低推理力度時的樣本 token 數量,比中推理力度少 63% 至 83%。REASONING_PROMPT_HINT=true 亦會在系統提示詞中加入「Reasoning: low」,讓 gpt-oss 透過其 Harmony 聊天格式讀取此設定。這兩個變數都不會向模型透露任何有關秘密字詞的提示。
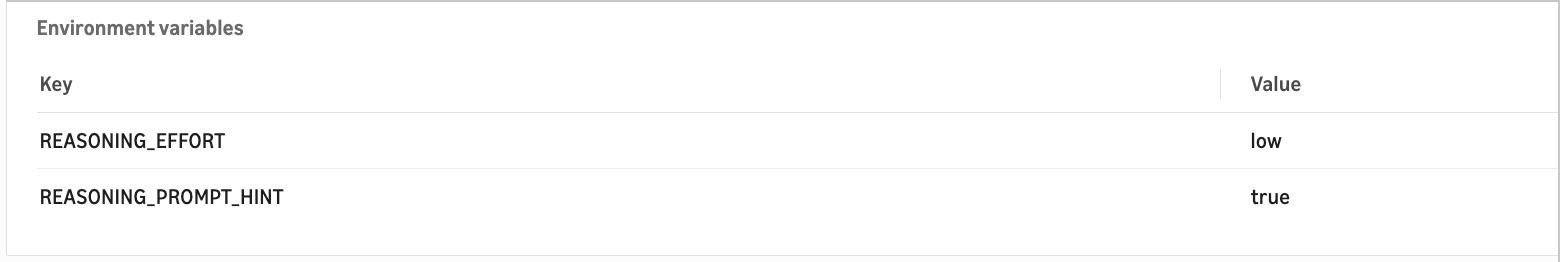
圖 3:執行環境變數,顯示 REASONING_EFFORT 設定為 low
Agent 只有一個檔案,即 main.py。簡化後,其進入點如下。要用於自己的任務,請修改任務解析、工具和獎勵:
app = BedrockAgentCoreApp()

@app.entrypoint  # outermost: starts the HTTP server AgentCore invokes
@sagemaker_rft_handler  # reports the returned reward to SageMaker AI
def handle_rollout(payload):
    prompt, answer = parse_task(payload["prompt"])
    game = WordleGame(answer)

    @tool
    def guess_word(guess: str) -> str:
        """Submit a 5-letter Wordle guess and get feedback."""
        return game.guess(guess)

    agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word])
    agent(prompt)
return {"reward": game.final_reward()}重要:sagemaker_rft_handler 裝飾器本身不會啟動 HTTP 伺服器。請用 BedrockAgentCoreApp 和 @app.entrypoint 封裝,並將進入點裝飾器放在最外層。否則,每次呼叫都會在 30 秒後逾時。
步驟 3:驗證執行環境
在花費 GPU 資源之前,請先確認整個流程能以訓練服務傳送的載荷格式正常運作。儲存庫在 Wordle/payload.json 提供了一個範例:
{
  "prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"beach\", \"id\": \"smoke-test\"}",
  "metadata": {
    "jobArn": "arn:aws:sagemaker:us-east-1:111122223333:job/AgentRFT/smoke-test",
    "rolloutId": "r1"
  }
}
測試用工作 ARN 預期會失敗,而失敗的方式本身就是證明。請先在其中填入自己的帳戶 ID:如果工作 ARN 屬於另一個帳戶,服務會在檢查工作是否存在之前回傳 403,這看起來就像 IAM 設定有問題。請在 Wordle 目錄中執行:
ACCOUNT=$(aws sts get-caller-identity --query Account --output text)
sed "s/111122223333/$ACCOUNT/" payload.json > /tmp/payload.json

aws bedrock-agentcore invoke-agent-runtime \
  --agent-runtime-arn <RUNTIME_ARN> \
  --runtime-session-id smoke-test-$(date +%s)000000000000000 \
  --payload fileb:///tmp/payload.json /dev/stdout
在 runtime 的 Amazon CloudWatch 日誌中,你會看到 Agent 解析提示詞、向 Job Runtime 端點驗證身分,並收到「找不到工作。」的 400 錯誤。這個失敗確認瞭解析、驗證身分及錯誤回報均正常運作。由於 Agent 未有執行至策略模型,指令本身會輸出 {“reward”: -1.5}。如果收到「未獲授權存取此資源」的 403 錯誤,表示工作 ARN 仍指向另一個帳戶。如果發生 30 秒逾時,則表示 HTTP 伺服器未有啟動(請參閲第 2 步的「重要」提示)。
第 4 步:準備資料集
MTRL 資料集沒有目標回應、對話紀錄或標籤。每一列都是一項要由 Agent 嘗試完成的任務。以下是訓練檔案的首三列:
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"riser\", \"id\": \"wordle_train_0000\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"swoon\", \"id\": \"wordle_train_0001\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"dirty\", \"id\": \"wordle_train_0002\"}"}
服務會讀取 prompt 欄(或第一欄),並將字串原封不動地傳給你的 Agent,不會對字串作任何解析。我們將字串設為包含三個欄位的小型 JSON 物件:
- prompt:Agent 向策略模型顯示的指令,每一列都相同。
- answer:秘密詞語。只有環境和獎勵函數會使用它。策略模型看不到這個欄位。
- id:列 ID,可在日誌中追查 rollout 的來源列。
範例儲存庫的 make_dataset.py 會從答案清單中抽取 640 個訓練詞語(五個完整的 128 詞批次)和 128 個驗證詞語,兩者沒有重疊,因此驗證集解題率可用來衡量泛化能力。服務亦支援 Apache Parquet、JSON 陣列和 CSV。將兩個檔案上載至 Amazon S3:
uv run python make_dataset.py
aws s3 cp training-data.jsonl s3://<YOUR_BUCKET>/wordle-mtrl/train/
aws s3 cp validation-data.jsonl s3://<YOUR_BUCKET>/wordle-mtrl/validation/
由於服務不會檢查 prompt 字串,正式環境中的任務可以將完整的訊息清單、工具設定或獎勵規格放入其中。如需範例(包括如何保護字串中的敏感內容),請參閲 MTRL 文件。
第 5 步:啟動訓練工作
啟動程式會使用 sagemaker-train SDK 中的 MultiTurnRLTrainer 類別。將第 2 步的 runtime ARN、第 1 步的角色、第 4 步的資料集,以及用於指標的 MLflow app 指定給它。MLflow app 是必需的;如果你尚未建立,請先使用 aws sagemaker create-mlflow-app 建立:
uv run python run_mtrl_training.py \
  --model openai-reasoning-gpt-oss-20b \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --train-dataset s3://<YOUR_BUCKET>/wordle-mtrl/train/training-data.jsonl \
  --val-dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/output/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
啟動程式會覆寫三個超參數,其餘參數則維持 gpt-oss-20b 的預設值。它會將 sampling_max_tokens 設為 8192,即服務允許的上限,因為在預設值 4096 下,gpt-oss 經常在首次呼叫工具前推理時耗盡 token。它會將 max_epochs 設為 20,並將 max_steps 設為 100:640 列除以預設的 global_batch_size 128,每個 epoch 會有 5 個步驟;而採用預設的 group_size 8 時,每個步驟會進行 1,024 場遊戲。工作會依次經過 Starting、Downloading 和 Pending,然後進入 Training。開始訓練後,你的 AgentCore runtime 便會開始接收 rollout 呼叫。
重要:工作執行期間,請勿重新部署 Agent。重新部署會令 runtime 重新啟動,進行中的 rollout 將收不到取樣請求,服務亦會令整項工作失敗。
第 6 步:在 MLflow 監察訓練
服務會在每個步驟記錄獎勵、token 和回合統計數據,並每隔 val_every 個步驟執行一次驗證。要留意的指標是 val/reward/pass_at_1,即成功解出的留出詞語比例。每次成功解題的分數至少為 1.01,高於服務的 success_threshold 門檻 1.0,因此會計入 pass@1。以下圖表根據這次執行的 MLflow 歷程繪製:
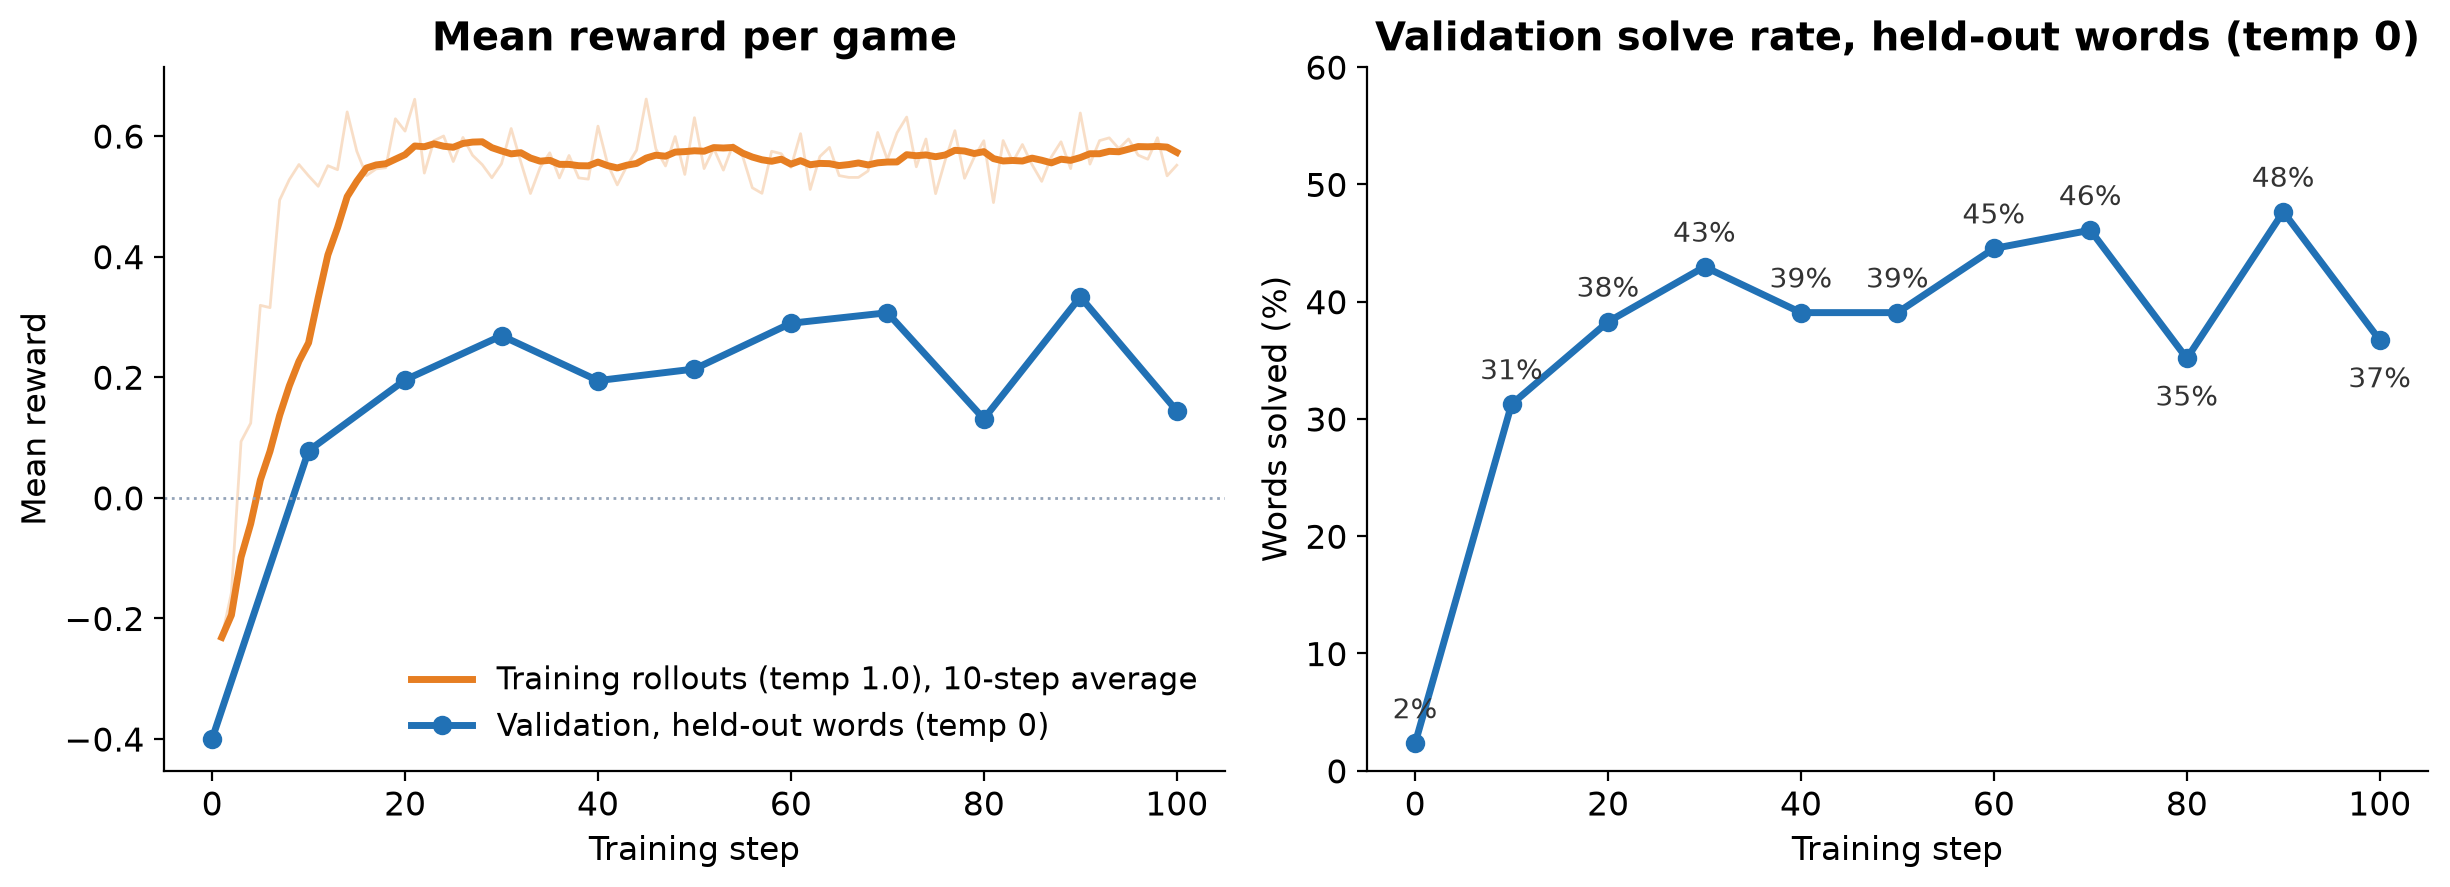
圖 4:100 步執行的訓練曲線;左方為每局平均獎勵,右方為驗證集解題率
訓練獎勵在 15 個步驟內升至約 +0.57,並維持在該水平。驗證獎勵較低,主要是因為温度設為 1.0 而非 0,而不是過度擬合(見步驟 7)。驗證解題率在首 10 個步驟內由 2% 跳升至 31%,之後在 35% 至 48% 之間波動。以 128 個單字來説,這些波動大多隻是雜訊。我們沒有測試增加步驟是否有助於提升推論服務設定下的表現。
CloudWatch 中 runtime 的 OpenTelemetry 追蹤記錄會記錄每個模型回合和工具呼叫。以下是訓練後的模型在一次評估作業中進行的一局遊戲(中等推理力度、温度 1.0),推理內容經過刪減。秘密單字是 PASTE:
[model] Reasoning: [...] "CRANE" has 5 distinct letters: C,R,A,N,E. [...]
We'll guess "CRANE".
Tool call: guess_word(guess="CRANE")
[tool] Guess 1/6: CRANE -> C=gray, R=gray, A=yellow, N=gray, E=green
Current Knowledge:
- Correct Position (Green): _ _ _ _ E
- In Word, Wrong Position (Yellow): 'A' (at least 1)
- Not in Word (Gray): C, N, R
- Guesses Remaining: 5
[model] Reasoning: [...] "ALIVE": ends with E, includes A. Letters not C,N,R.
Tool call: guess_word(guess="ALIVE")
[tool] Guess 2/6: ALIVE -> A=yellow, L=gray, I=gray, V=gray, E=green
[model] Reasoning: [...] So positions not 1 or 3 for A. Positions left: 2,4
for A. [...] We might guess "HASTE"? [...]
Tool call: guess_word(guess="HASTE")
[tool] Guess 3/6: HASTE -> H=gray, A=green, S=green, T=green, E=green
[model] Reasoning: We have the word: _ASTE. [...] "PASTE" is a word. PASTE
fits. Also "WASTE" also fits [...] Choose "PASTE" maybe.
Tool call: guess_word(guess="PASTE")
[tool] Guess 4/6: PASTE --- all green. Correct, you solved it!
來自 AgentCore runtime 追蹤記錄的訓練模型推演過程。模型會將綠色字母留在原位,不會重用灰色字母,並利用每個黃色字母排除不可能的位置,雖然訓練資料從未教過它這些做法。
步驟 7:在推論服務設定下評估訓練後的模型
作業完成後,其在 SageMaker AI Studio 的頁面會顯示狀態,以及存放訓練後模型的模型套件羣組。DescribeJob,將 JobCategory 設為 AgentRFT,會傳回輸出模型套件 ARN 和計費 token 數量。
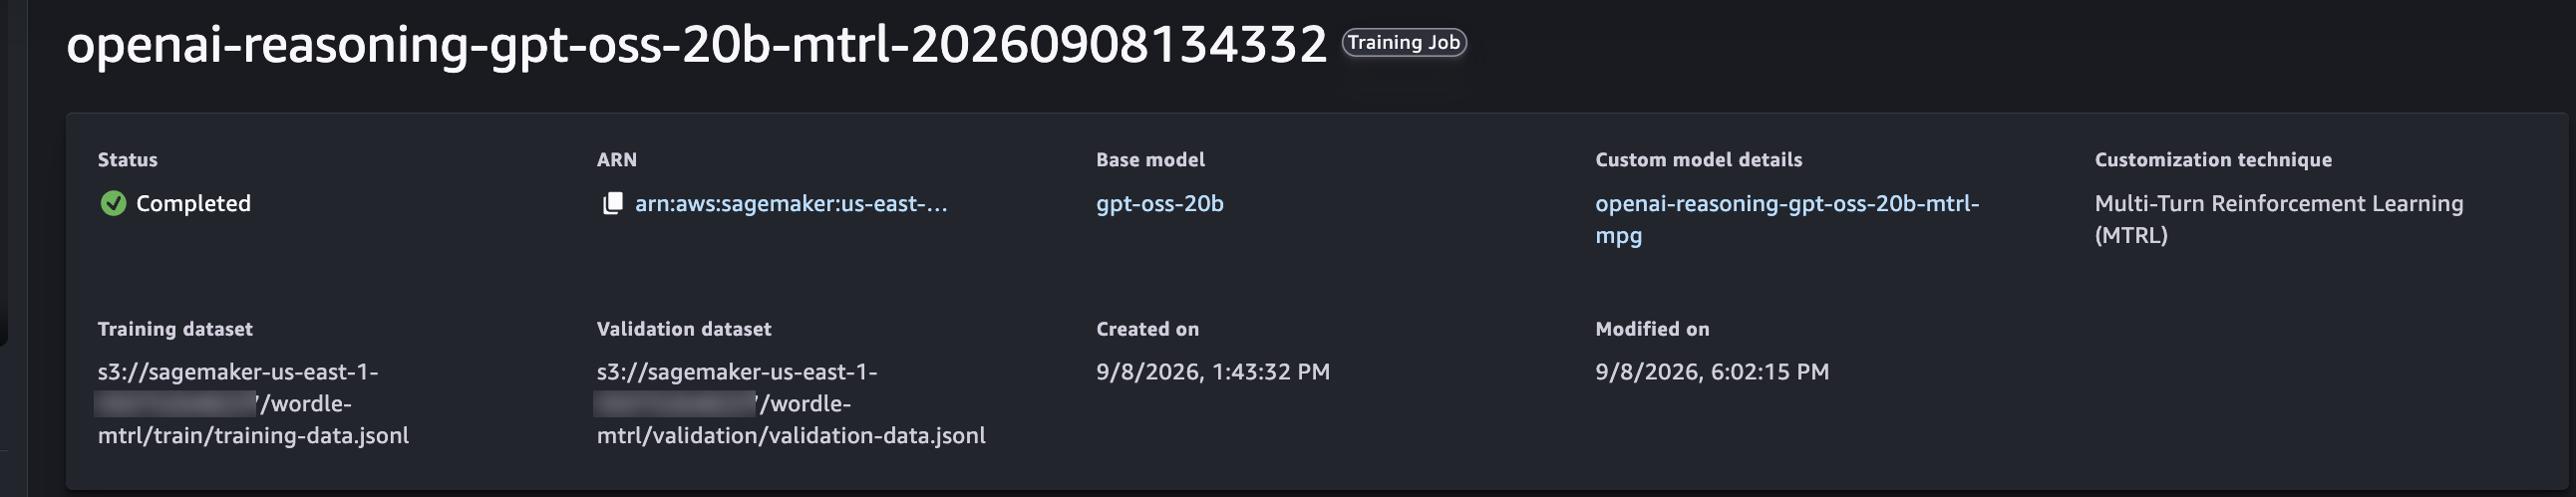
圖 5:SageMaker AI Studio 中已完成的訓練作業,位於「作業」、「訓練」、「多輪 RL」分頁
評估作業(將 JobCategory 設為 AgentRFTEvaluation)會透過相同的 AgentCore runtime 和獎勵函數,使用基礎模型或訓練後的模型套件來執行評估提示詞,並將 eval/reward/pass_at_1 記錄至 MLflow。與訓練期間的驗證不同,你可以設定温度。由於預設配額一次只允許執行一個評估作業,程式碼儲存庫中的啟動器會接連執行評估(你可以申請提高配額):
uv run python run_mtrl_eval.py --runs base:1.0 trained:1.0 \
  --model-package-arn <OUTPUT_MODEL_PACKAGE_ARN> \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/eval/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
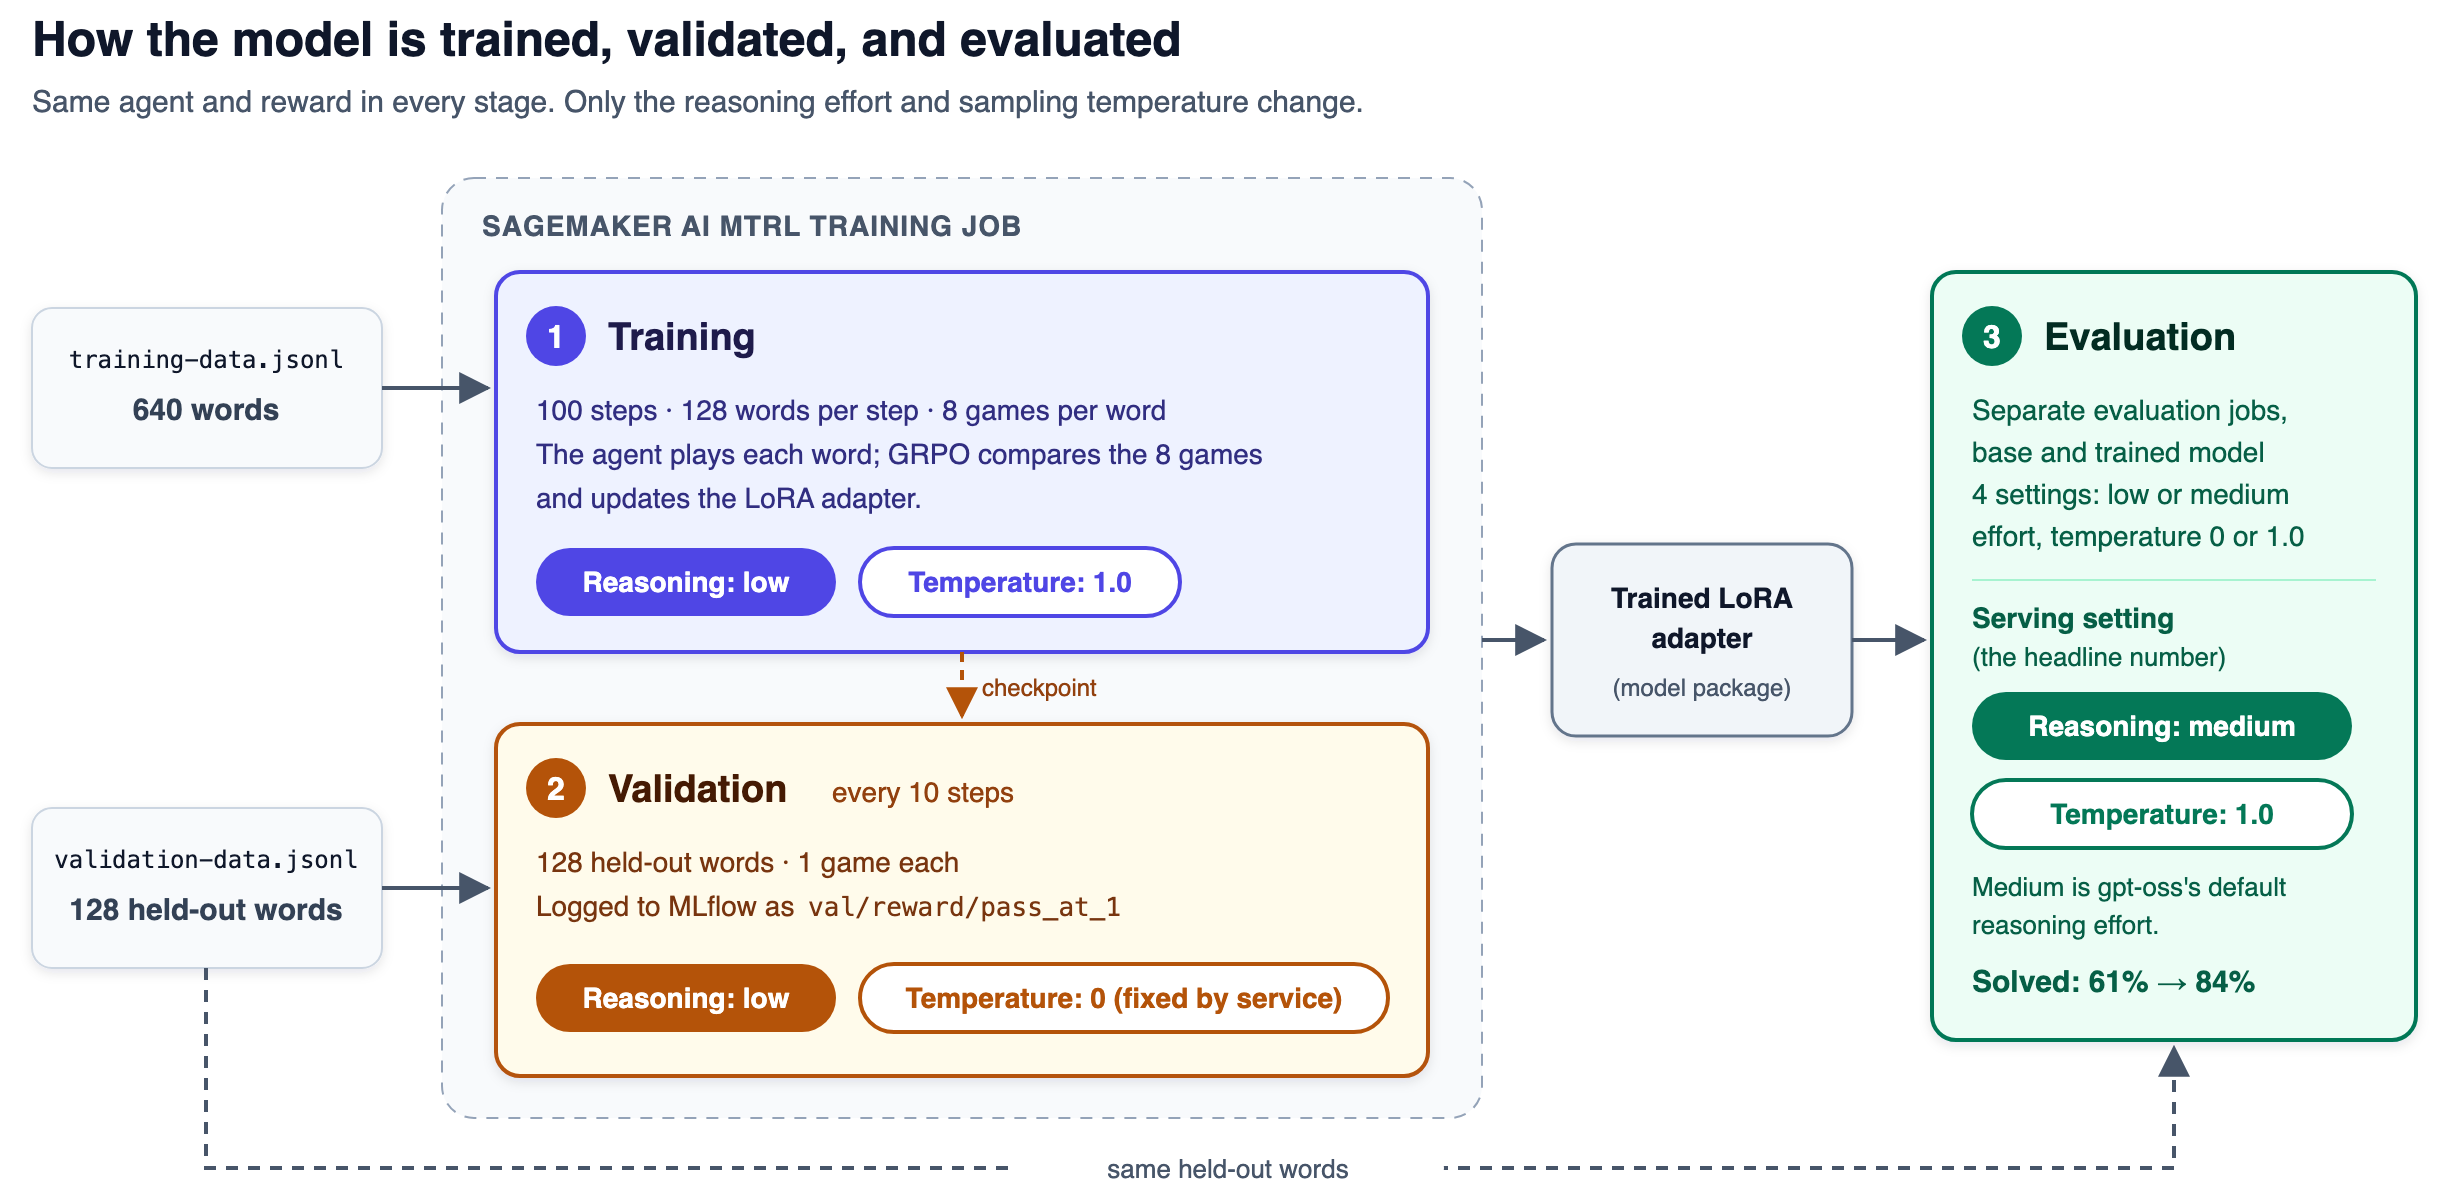
圖 6:各階段的推理力度和取樣温度;訓練作業會將驗證温度固定為 0,並使用部署時的推理力度,而評估作業則讓你自行選擇
每次評估 128 個單字需時四至七分鐘。推理力度由 Agent 的環境變數決定,因此如要更改,必須編輯 REASONING_EFFORT、重新部署,再進行評估。我們以低和中等推理力度,以及温度 0 和 1.0 評估了兩個模型:
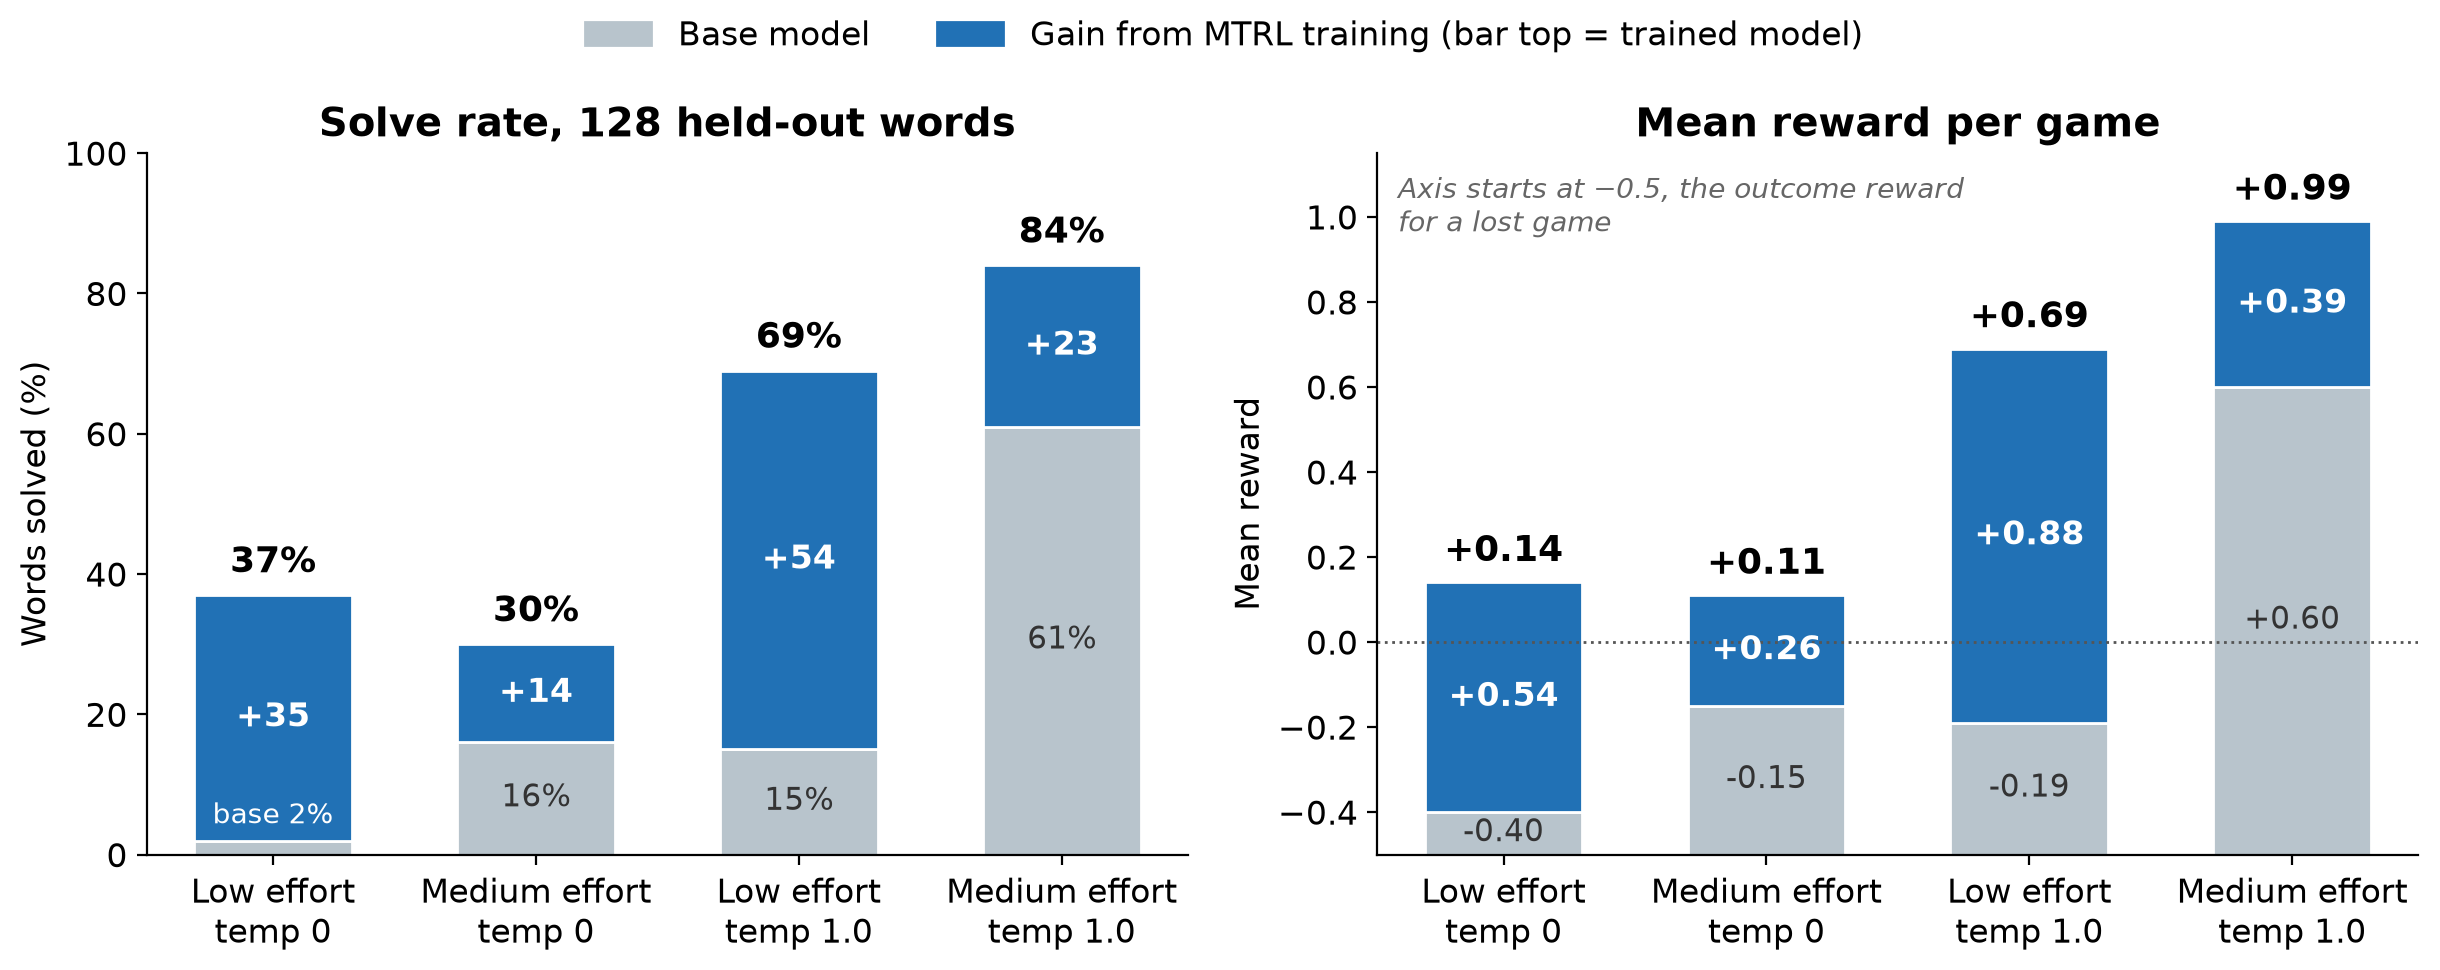
圖 7:基礎模型與訓練後模型在四種解碼設定下的表現;左側為解題率,右側為每局平均獎勵
每條長條的灰色部分代表基礎模型,藍色部分代表訓練帶來的提升。低推理力度、温度 0 的組合,是訓練作業在步驟 0 和 100 時的驗證結果。中等推理力度、温度 1.0 下訓練後模型的結果,是兩次執行的平均值(80% 和 88%)。
在温度 0 下,兩個模型在兩種推理力度下都經常無法解題便結束遊戲。啟用取樣後,中等推理力度令訓練後模型的解題率提高 15 個百分點,基礎模型則提高 46 個百分點。適配器在每種設定下都帶來 14–54 個百分點的提升,説明訓練所學能在不同設定間發揮作用。
訓練作業在 MLflow 上的驗證曲線則呈現不同結果:在步驟 90 時達到 48% 的峯值,最後以温度 0 評分時降至 37%。超參數參考資料建議評估時使用温度 0,因為貪婪解碼能令曲線結果具確定性,並方便比較不同執行結果。我們報告温度 1.0 的結果,因為實際提供模型服務時使用的就是這個設定。在中等推理力度、温度 1.0 下,訓練後模型能解出 84% 的留出單字,高於基礎模型的 61%。
提示:請使用正式服務時採用的設定進行評估。訓練曲線顯示,這個 adapter 最終達到 37%。採用服務設定時,它可解出 84%。這些結果由評估工作得出,token 費用約為 $1.20,耗時約一小時。
第 8 步:清理
訓練和評估工作完成後便會停止計費,但 AgentCore runtime、IAM 角色、MLflow 應用程式和 S3 物件會繼續保留。在專案目錄中:
# 1. Agent runtime and its execution role. remove all resets the project config;
# the next deploy sees the empty state and tears down the deployed resources.
cd sample-multi-turn-rl-wordle/Wordle
agentcore remove all
agentcore deploy

# 2. MLflow app
aws sagemaker delete-mlflow-app --arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>

# 3. Datasets, job output, and evaluation output
aws s3 rm s3://<YOUR_BUCKET>/wordle-mtrl/ --recursive
由於 agentcore remove all 會改寫 agentcore/ 下的檔案,如果日後想重新部署,請執行 git checkout -- agentcore/。刪除 AgentCore-Wordle-default CloudFormation 堆疊會移除相同資源,但不會動到檔案。訓練工作角色和模型套件不會產生費用。
深入探討:設計獎勵
我們的獎勵設計需要修訂一次,而這是一個常見的錯誤。
第一個設計將 wordle-lora-rl 專案中每次猜測的評分加總,作為整局遊戲的獎勵。這種評分方式在該專案中可行,因為每次猜測都是獨立的訓練樣本。把分數加總為每局遊戲的一個獎勵後,卻造成兩個反常結果;只有查看追蹤記錄後,我們才發現問題:
- 輸掉一局竟然得到正獎勵。6 回合的獎勵加起來約為 +0.49。
- 第 1 回合解出答案的得分低於第 3 回合。因為額外回合累積了更多獎勵,第 1 次猜測便解出答案可得 +0.99,第 3 次猜測解出則可得 +1.61。
修正方法是將主要的結果項與幅度較小且有上限的塑形項分開:
reward = outcome + w * clip(shaping, -1, 1), w = 0.04 if solved, else 0.15結果項完全取決於遊戲如何結束:
| 結果 | 數值 |
| 第 n 次猜測時解出答案 | 1.05 + 0.5 * (6 – n) / 5,因此第 1 次猜測解出時為 1.55,第 6 次猜測解出時為 1.05 |
| 用完 6 次猜測仍未解出答案 | -0.5 |
| 從未作出有效猜測 | -1.5 |
塑形項則是每次猜測的評分在整局遊戲中的總和:
- 猜測與已知的綠色、黃色或灰色字母線索矛盾、重複猜測,以及猜測字典以外的單字,均會受到懲罰。
- 對出色的開局用詞給予熵獎勵。
- 對嘗試新字母,以及縮小剩餘可能答案的範圍給予獎勵。
總和會截限在 [-1, 1] 範圍內;解出答案時乘以 0.04,輸掉時乘以 0.15。這樣能區分結果相同的遊戲,但不會令遊戲跨越不同獎勵級別。採用常見的塑形值時:
| 情況 | 獎勵 |
| 第 1 次猜測解出答案 | +1.550 |
| 第 3 次猜測解出答案 | +1.375 |
| 第 6 次猜測解出答案 | +1.069 |
| 猜足 6 次後仍輸掉 | -0.427 |
| 從未作出有效猜測 | -1.500 |
現在,較快解出答案的獎勵總是高於較慢解出;任何一次解出都勝過任何一次輸掉,而完全沒有進行遊戲則是最差結果。我們的第一個修正方案採用單一的 0.15 權重,結果第 3 次猜測解出且塑形分數最高(+1.45),得分反而高於第 2 次猜測解出且塑形分數最低(+1.25)。相鄰猜測次數的基礎分相差 0.1,因此降低解出答案的權重至 0.04,便可避免分數重疊;而最差的解出答案分數(+1.01)仍高於 1.0 的成功門檻。塑形仍然重要,因為 GRPO 會從一組樣本內的獎勵變異中學習,所以即使兩局遊戲都輸掉,只要線索一致性不同,仍能讓模型學到一些資訊。正如 SageMaker AI 文件建議,應先採用以結果為基礎的獎勵,謹慎加入塑形,並檢查實際軌跡上的獎勵。
深入探討:問題所在,以及你會遇到的先後次序
以下每個問題至少耗費了一次訓練。
- 並行處理下的 Bearer token。每次呼叫都建立新的 botocore 工作階段來簽發 token,會令憑證提供者在 32 個 rollout 並行時不堪負荷;而將 token 快取一小時,則會在憑證輪替時引發 403 錯誤。解決方法是使用一個會自行重新整理的工作階段、設定較短的快取時間,並在收到 403 時重新簽署請求。
- 如果一次 rollout 沒有到達策略模型,整項工作便會失敗。當一次 rollout 中的所有模型呼叫都未能通過驗證時,服務便會以「未收到採樣請求。」結束工作。回傳錯誤狀態同樣會令工作失敗,因此務必回傳獎勵。模型有收到採樣,但始終沒有作出有效猜測的遊戲則沒有問題:得分為 -1.5;在約 105,000 次 rollout 的 100 步執行中,這種情況出現了 51 次。
- 工具呼叫逐漸變成純文字。學習率過高時,模型會以文字形式寫出工具呼叫,所有 rollout 都取得相同的最低獎勵,梯度亦隨之消失。代理現時會從原始文字中擷取猜測,並施加少量格式懲罰。
- 訓練進入平台期。訓練獎勵在約第 15 步後停止上升,驗證結果則在約第 30 步後停止改善;不過,在 temperature 0 下,驗證結果未能充分反映模型表現(Step 7)。接下來我們會嘗試採用課程安排,以先前的猜測作為遊戲初始資料;或增加每個詞的 rollout 次數,超過預設的
group_size8 次。
結論
SageMaker AI 上的 MTRL 會根據整個回合的結果訓練模型。這適合代理式任務,因為這類任務的正確軌跡並不明確,而且只有結果可以評分。我們採用單一的回合層級獎勵。如果中間步驟也可以評分,MTRL 亦可透過 UpdateReward API,為每個回合提供一項獎勵。在本文中,一個開放權重的 20B 模型在服務設定下的解題率達到 84%,高於原來的 61%;訓練 token 費用約為 $339,AgentCore 執行時用量約為 $79。訓練曲線所顯示的 37% 是由訓練工作評分驗證結果的方式所造成,因此應使用實際服務時採用的設定進行評估。
同一流程亦適用於公開模型從未接受訓練的內部程序、工具及工作流程。
如要開始使用,請複製範例程式碼庫,按照前述步驟操作,並在投入 GPU 資源前,先執行 Step 3 的冒煙測試。如需瞭解底層 API,請參閲SageMaker AI MTRL 文件。
作者簡介

Daniel Quang
Daniel 是 AWS Frontier AI Startups 團隊的解決方案架構師,協助全球規模最大、最具策略重要性的生成式 AI 初創企業在雲端擴展基礎設施。他持有加州大學爾灣分校計算機科學博士學位,研究方向為機器學習及生物資訊學。

Hadrien Almela
Hadrien 是 AWS Startup 團隊的 Frontier AI 資深客戶經理,協助頂尖 AI 初創企業建立技術整合及全球市場拓展 (GTM) 合作夥伴關係。他在初創企業領域擁有八年經驗。

Vinay Bhat
Vinay 是 AWS Frontier AI 解決方案架構主管,帶領一支技術團隊,協助基礎模型實驗室及 AI 原生初創企業在 AWS 上建立、訓練及擴展模型與應用程式。他在 AWS、Google Cloud 及高速增長的初創企業建立技術團隊方面,擁有超過 20 年經驗。
來源:AWS Machine Learning Blog · aws.amazon.com