如何利用 Amazon Bedrock 和 LiteLLM 建立自助式 LLM 閘道
Building a self-service LLM gateway with Amazon Bedrock and LiteLLM
AWS 作者示範以 Amazon Bedrock Application Inference Profiles、LiteLLM 和 AWS Fargate 建立自助式 LLM 閘道,透過兼容 OpenAI 的 API 提供模型存取。
文章把自助式 LLM 閘道拆解為推理設定、用戶成本管控與監察環節,並指出預算限制及跨區 IAM 權限的關鍵配置。
開發人員希望 AI 編碼助手只需最少設定。透過大型語言模型(LLM)閘道和 LiteLLM,他們可以快速存取 Amazon Bedrock 提供的基礎模型(FM),而你則可掌握使用情況並控制用量。平台團隊需要監察延遲和錯誤,財務團隊需要將推理成本歸屬至團隊和項目,而保安團隊則需要一致的存取控制。LLM 閘道可透過提供一個集中管理的存取點,連接為編碼助手提供動力的模型,協助滿足這些需求。
本文會示範如何使用 Amazon Bedrock Application Inference Profiles,並在 AWS Fargate 上執行 LiteLLM,建置自助式 LLM 閘道,將 Amazon Bedrock 封裝在 OpenAI 相容 API 背後。採用這種模式,開發人員可透過單一 API 和專用金鑰存取基礎模型,而你則可控制每位用戶的成本,並觀察模型效能。閲讀本文後,你將充分了解這種模式,並可參考示意程式碼片段及 AWS Cloud Development Kit(AWS CDK)構件,建置自己的版本。本文以 Claude Sonnet 和 Claude Haiku 模型作為示例。如要查看各 AWS 區域提供的模型清單,請參閲 Amazon Bedrock 按 AWS 區域劃分的支援模型。
這種 LLM 閘道模式採用直接的請求流程:請求由開發人員發出,經過 LiteLLM 層,抵達 Amazon Bedrock 和底層基礎模型。下圖展示了支援該流程的生產環境拓撲。為求簡潔,本文不會介紹加入 Amazon Bedrock Guardrails,例如內容篩選和 grounding;不過,在部署至生產環境前,通常會加入適當的負責任 AI 控制措施。
開發人員的 OpenAI 相容用戶端會經由 Amazon Route 53、Amazon CloudFront 和 Application Load Balancer(ALB)連線至 LLM 閘道,並使用每位用戶的 API 金鑰向 Fargate 上的 LiteLLM 進行驗證。在背後,請求會使用 Amazon Relational Database Service(Amazon RDS)(PostgreSQL)儲存虛擬金鑰和支出狀態,也會使用 Amazon ElastiCache for Valkey 作為快取,並透過 AWS Secrets Manager 管理機密。LiteLLM 最終會使用具有限定範圍的 AWS Identity and Access Management(IAM)任務角色,呼叫 Amazon Bedrock Application Inference Profiles。Amazon CloudWatch 會收集每分鐘請求數(RPM)和每分鐘 Token 數(TPM)指標,以及配額警報。
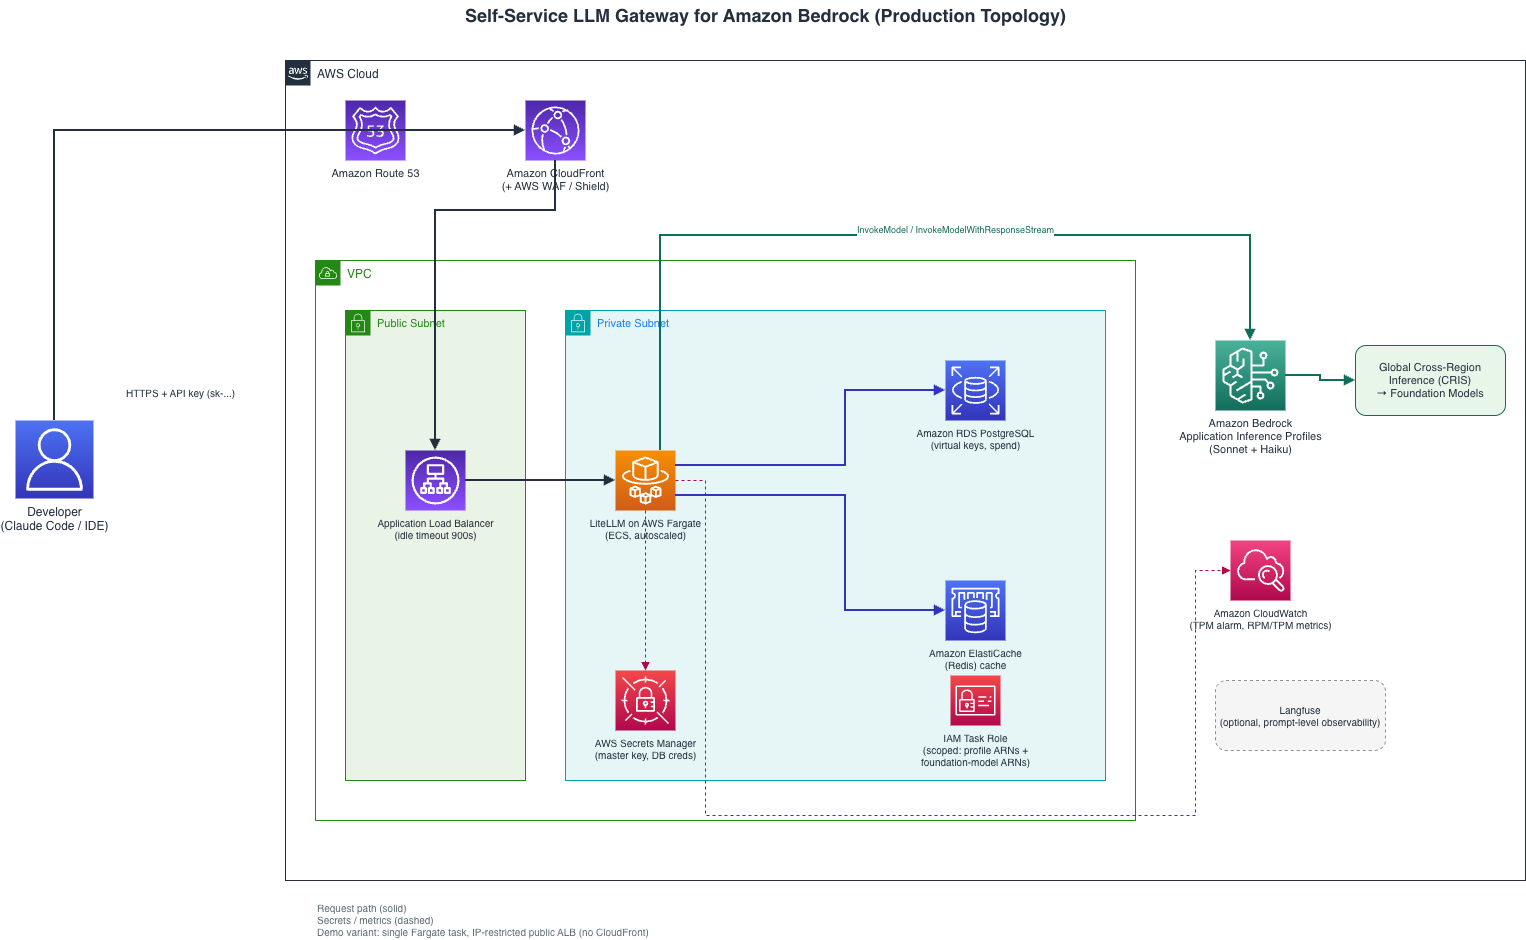
圖 1:LLM 閘道架構(生產環境拓撲)
架構由以下核心元件組成:
- AWS Fargate 上的 LiteLLM:LiteLLM 提供代理服務,開放 OpenAI 相容 API。我們會在 AWS Fargate 工作上執行 LiteLLM,並根據 CPU 使用率進行目標追蹤自動擴展。開發人員只需將工具指向這個端點,無須直接與 Amazon Bedrock 互動。
- 自助服務入口網站:LiteLLM 提供輕量級入口網站,供管理員和開發人員自助使用。此網頁應用程式可與企業單一登入(SSO)整合。營運工程師可透過入口網站設定支出政策,而開發人員則可在這些參數範圍內自行建立 API 金鑰。
- 持久化儲存及快取儲存:LiteLLM 使用 Amazon ElastiCache for Valkey 進行非持久性回應快取,也用於協調各 AWS Fargate 工作之間的速率限制。另一個獨立的 Amazon RDS(PostgreSQL)資料庫則作為持久狀態的權威資料庫,例如儲存 API 金鑰中繼資料及追蹤支出。
- Amazon Bedrock Application Inference Profiles:每個模型(例如 Claude Sonnet 和 Claude Haiku)都會有自己的推理設定檔,並透過 AWS Cloud Development Kit (AWS CDK) 管理。藉此可按模型隔離配額,並在 LiteLLM 設定與 Amazon Bedrock 的模型版本管理之間建立清晰的抽象層。
- Langfuse:開源 LLM 可觀測性工具,可提供提示詞層級的遙測資料、延遲追蹤及除錯功能。它能補足 Amazon CloudWatch 在基礎設施層級的指標,提供應用程式層級的洞察。
透過使用與 OpenAI 相容的協定,開發人員只需設定一個基礎 URL 和 API 金鑰,便可配置 Claude Code、Continue 和 Cursor 等工具。之後,開發人員可在 Amazon Bedrock 後端之上操作,切換模型、加入備援模型,或遷移模型供應商,而無須修改開發人員的設定。
先決條件
你需要 AWS 帳戶、Amazon Bedrock 模型存取權,以及部署此專案所需的 IAM 權限。你亦需要 LiteLLM。LiteLLM AI Gateway 元件為開源軟件,適合用於小型試行,但有若干限制。LiteLLM 文件指出,AI Gateway 可供最多五名用戶免費使用,超出此人數則需要授權。LiteLLM Enterprise 是適合正式環境使用、可擴展的授權版本,包含開源閘道,以及單一登入、審核記錄、委派管理員角色和支援。免費版本支援虛擬金鑰,但本文所述的自助式金鑰簽發功能需要 Enterprise 版本。
端對端設定:由左至右
以下會逐一説明從開發人員的電腦到基礎模型的各個設定層。
步驟 1:開發人員 IDE 設定(例如 Claude Code)
開發人員將編碼助理設定為連接至 LLM 閘道。這是開發人員唯一需要為工具作出的設定:
{
  "apiProvider": "openai-compatible",
  "apiBaseUrl": "https://llm-gateway.internal.example.com/v1",
  "apiKey": "sk-user-abc123",
  "model": "claude-sonnet-4-20250514"
}
完成設定後,每位開發人員都可從自助服務入口網站取得自己的 API 金鑰,並將其填入工具設定。
步驟 2:LiteLLM 閘道設定
按照LiteLLM 文件,將 LiteLLM 部署至容器服務。此例使用 AWS Fargate。這項部署會包含入口網站,在本機測試期間可於 http://localhost:4000/ui 開啟。
LiteLLM 閘道會將模型名稱對應至 Amazon Bedrock 推理設定檔 ARN,並強制執行每個金鑰的支出上限:
model_list:
  - model_name: claude-sonnet-4-20250514
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/sonnet-profile-id
      aws_region_name: us-east-1
      max_retries: 3
      timeout: 900  # 15 min for extended thinking
    # REQUIRED for spend tracking: when `model` is a raw inference-profile ARN,
    # LiteLLM can't find it in its built-in cost map and defaults the cost to $0
    # which means per-key `spend` stays 0 and budgets NEVER enforce. Set the
    # per-token costs explicitly.
    model_info:
      input_cost_per_token: 0.000003        # example cost
      output_cost_per_token: 0.000015    # example cost

  - model_name: claude-haiku-4-5
    litellm_params:
      model: bedrock/arn:aws:bedrock:us-east-1:111122223333:application-inference-profile/haiku-profile-id
      aws_region_name: us-east-1
      timeout: 120
    model_info:
      input_cost_per_token: 0.000001       # example cost
      output_cost_per_token: 0.000005    # example cost

litellm_settings:
  max_budget: 250            # example per key cost
  budget_duration: 7d      # Rolling 7-day window
  max_parallel_requests: 10
  set_verbose: false
  cache: true
  cache_params:
    type: redis    # Valkey is protocol-compatible, so this stays "redis"
    host: elasticache-endpoint
    port: 6379
master_key: os.environ/LITELLM_MASTER_KEY
database_url: os.environ/DATABASE_URL
在 Fargate 任務上設定,並從 AWS Secrets Manager 取得:
LITELLM_MASTER_KEY=sk-platform-admin-... DATABASE_URL=postgresql://user:password@rds-endpoint:5432/litellm注意:不要在 config.yaml 中硬編碼 master_key 或資料庫憑證。LiteLLM 會在載入時解析 os.environ/VAR_NAME 參照,因此請將 LITELLM_MASTER_KEY 和 DATABASE_URL 設為 Fargate 任務上的環境變數,並從 AWS Secrets Manager 取得。第 5 步的 Langfuse 憑證亦以相同方式設定。
例如,當開發人員呼叫 claude-sonnet-4-20250514 時,LiteLLM 會將其解析為推理設定檔 ARN,然後使用 AWS Fargate 任務的 IAM 角色向 Amazon Bedrock 驗證,並以 OpenAI 格式串流傳回回應。
步驟 3:Bedrock 推理設定檔(CDK)
透過Amazon Bedrock Application Inference Profiles,你可以為特定模型建立具名端點,從而隔離配額並進行精細的 IAM 控制。
選擇跨區域推理(CRIS):地理區域或全球
Amazon Bedrock CRIS 可免卻自行實作跨區域請求路由的開銷,其他優點包括:
- 可使用更廣泛的區域容量。
- 自動將請求路由至有可用容量的支援區域。
- 更廣泛的模型選擇,因為部分模型只可透過推理設定檔使用。
對於這種代理模式,我們建議在所選模型支援,且組織政策允許跨全球支援的 AWS 商業區域處理推理時,使用全球跨區域推理。地理跨區域推理會將處理限制在指定地理區域內。例如,美國推理設定檔只會將請求路由至受支援的美國區域。與地理跨區域推理相比,全球跨區域推理可存取更廣泛的區域容量池,並可能帶來定價優惠。你可以透過最新的 AWS 文件和 AWS 定價頁面,核實模型是否可用、適用的服務配額,以及各模型的定價。
CDK 構造
import * as cdk from 'aws-cdk-lib';
import * as bedrock from 'aws-cdk-lib/aws-bedrock';
import * as iam from 'aws-cdk-lib/aws-iam';

// Create an Application Inference Profile pointing to the Global CRIS
// system-defined inference profile (note the `global.` prefix in the ARN).
const sonnetProfile = new bedrock.CfnApplicationInferenceProfile(this, 'SonnetProfile', {
  inferenceProfileName: 'claude-sonnet-gateway',
  modelSource: {
    copyFrom: `arn:aws:bedrock:us-east-1:${this.account}:inference-profile/global.anthropic.claude-sonnet-4-20250514-v1:0`,
  },
  description: 'Claude Sonnet for developer coding assistants (Global CRIS)',
});

// Grant LiteLLM's task role access to invoke the profile.
// For Global CRIS, include the inference profile, the regional FM, and the global FM resources.
litellmTaskRole.addToPolicy(new iam.PolicyStatement({
  effect: iam.Effect.ALLOW,
  actions: ['bedrock:InvokeModel', 'bedrock:InvokeModelWithResponseStream'],
  resources: [
    sonnetProfile.attrInferenceProfileArn,
    'arn:aws:bedrock:us-east-1::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
    'arn:aws:bedrock:*::foundation-model/anthropic.claude-sonnet-4-20250514-v1:0',
  ],
}));重要:對於 Global CRIS,copyFrom ARN 必須引用以 global. 為前綴的系統定義推理設定檔,而非直接引用基礎模型 ARN。使用基礎模型 ARN 會建立沒有跨區域路由的單一區域設定檔。此外,IAM 政策必須包含實際呼叫所涉及的資源 ARN:應用程式推理設定檔,以及任何可能被路由至的區域中的底層基礎模型(區域欄位使用萬用字元)。若只將範圍限制在應用程式推理設定檔 ARN,呼叫時會返回 not authorized to perform: bedrock:InvokeModel on resource: arn:aws:bedrock:us-east-1::foundation-model/...。這是遵循最小權限原則的範圍設定:列明實際使用的確切模型,而非 bedrock:* 或 *。
步驟 4:Bedrock 呼叫基礎模型
推理設定檔會透明地處理模型解析和跨區域路由,無需額外設定。當 LiteLLM 呼叫推理設定檔 ARN 時,Amazon Bedrock 會將請求路由至已設定 AWS 區域中的可用容量,並傳回回應。
步驟 5:Langfuse 可觀測性
LiteLLM 透過記錄回呼與 Langfuse 整合,讓你無需更改開發者工具設定,即可查看模型呼叫情況。要啟用整合,請將以下項目合併至第 2 步設定中的現有 litellm_settings 區塊,並保留現有的回呼項目:
litellm_settings:
  success_callback: ["langfuse"]
  failure_callback: ["langfuse"]  # also log failed requests
在 Fargate 任務上,將 Langfuse 公開金鑰、密鑰和部署端點設定為環境變數。將憑證存放在 AWS Secrets Manager:
LANGFUSE_PUBLIC_KEY=pk-lf-...
LANGFUSE_SECRET_KEY=sk-lf-...
LANGFUSE_HOST=https://us.cloud.langfuse.com  # or your self-hosted URL
端點必須與所選的 Langfuse Cloud 區域或自建部署相符。請根據數據管治和營運要求選擇託管方式。啟用提示詞和回應記錄前,請檢視整合會擷取的內容,並設定適當的資料遮蓋、保留期限和存取控制。
視乎整合和記錄設定,Langfuse 追蹤記錄可能包含提示詞、回應、模型參數、Token 用量和延遲。這些資訊有助調查未如預期的模型回應,並補充 Amazon CloudWatch 收集的營運指標。
實施成本控制
成本控制是成功 AI 策略的重要一環。若沒有成本控制,大量使用延伸思考功能可能導致費用高於預期;我們在早期試行中曾觀察到這種情況。
第 2 步設定的支出上限(max_budget: 250、budget_duration: 7d)會為每個 API 金鑰套用滾動 7 天時段,前提是已設定每個模型的 model_info 費用(請參閲第 2 步的備註)。用戶達到上限時,LiteLLM 會傳回 HTTP 429 狀態碼,並清楚説明預算已超出,不會在沒有提示的情況下降低服務,亦不會帶來意外帳單。開發人員和工程團隊可透過以下任一方式查看目前支出及重設時間:
- 每日支出:使用
start_date和end_date範圍查詢 GET /user/daily/activity,取得每日指標:支出、提示詞 token、完成內容 token 及 API 請求數,並按模型、供應商及 API 金鑰分類。 - 每位用戶的支出:查詢 GET /user/info?user_id=…,即可查看用戶總支出,以及其各個相關 API 金鑰的支出摘要。
- 管理平台控制面板:Admin UI(位於
https://<proxy-host>/ui)設有 Usage 分頁,開發人員和管理員可按模型、用戶及標籤查看支出,無須直接呼叫 API。
同一批端點也可讓財務團隊按用戶追蹤支出,無須自行建立自訂計量基建。只要排程工作呼叫 /user/daily/activity 或 /global/spend/report,便足以為成本控制面板或內部轉賬報告提供數據。
開發人員自助服務平台
自助服務平台亦可處理金鑰生命週期流程。開發人員使用公司的 SSO 驗證身分後,可產生與其身分綁定的金鑰;若金鑰外洩,或需要配合輪替政策,也可重新產生金鑰。平台工程師只需設定一次預算政策,開發人員便可在限制範圍內自行操作。開發人員可直接透過平台使用以下兩項功能:
- 產生金鑰:在 Admin UI 的 Virtual Keys 頁面(
https://<proxy-host>/ui),通過 SSO 驗證的開發人員可選擇 Generate Key,產生與其身分綁定的專屬金鑰。 - 查看速率限制:每個
/chat/completions回應都會包含x-litellm-key-remaining-requests-{model}和x-litellm-key-remaining-tokens-{model}標頭,讓開發人員可直接在工具的回應中查看該模型剩餘的 RPM 和 TPM 額度。這與本文前文提及、以美元計算的支出追蹤不同。
監察與可觀測性
對 LLM 閘道而言,延遲百分位等傳統指標可能會造成誤導,尤其是使用延伸思考模型時,單一請求可能需要數分鐘才能完成。因此,我們主要關注每分鐘請求數(RPM)和每分鐘 token 數(TPM)等指標。你可透過以下設定,使用 Amazon CloudWatch 監察這些指標並設定警報。
使用 Amazon CloudWatch 警報管理配額
new cloudwatch.Alarm(this, 'BedrockTPMAlarm', {
  metric: new cloudwatch.Metric({
    namespace: 'LiteLLM/Gateway',
    metricName: 'TokensPerMinute',
    statistic: 'Sum',
    period: cdk.Duration.minutes(1),
  }),
  // Alert at ~60% of your account's TPM quota (check Service Quotas for your
  // actual limit, defaults vary by model and account).
  threshold: 600000,
  evaluationPeriods: 3,
  comparisonOperator: cloudwatch.ComparisonOperator.GREATER_THAN_THRESHOLD,
  alarmDescription: 'TPM approaching Bedrock quota - request increase proactively',
});
請注意,警報設定會在配額使用率達到 60–70 percent 時發出提示,而不是等到請求遭限流才通知。這樣可預留時間提升 Amazon Bedrock 配額,避免用戶遇到服務降級。
發出指標:LiteLLM 沒有內置回呼會將名為 TokensPerMinute 的指標發佈至 LiteLLM/Gateway 命名空間,因此警報需要有資料來源。只需建立一個小型自訂記錄器回呼,在每次請求時呼叫 CloudWatch PutMetricData 即可。請透過 litellm_settings.success_callback 註冊(這是附加方式),不要使用 callbacks。callbacks 清單會取代 LiteLLM 的內部記錄器清單,其中包括內置的支出追蹤記錄器;這會在不發出提示的情況下停用預算限制。
以下是使用 LiteLLM CustomLogger 類別編寫的精簡回呼:
import boto3
from litellm.integrations.custom_logger import CustomLogger

cloudwatch = boto3.client("cloudwatch")

class TPMEmitter(CustomLogger):
    async def async_log_success_event(self, kwargs, response_obj, start_time, end_time):
        total_tokens = kwargs.get("standard_logging_object", {}).get("total_tokens", 0)
        cloudwatch.put_metric_data(
            Namespace="LiteLLM/Gateway",
            MetricData=[{
                "MetricName": "TokensPerMinute",
                "Value": total_tokens,
                "Unit": "Count",
            }],
        )

# Register alongside success_callback, not in place of it:
import litellm
litellm.callbacks = [TPMEmitter()]
為了除錯提示詞層級的問題,我們會同時使用 Langfuse 和 CloudWatch。當開發人員反映「模型給出了不佳回應」時,你可以使用 Langfuse 檢視確切的提示詞、token 數量和模型參數。對合規要求嚴格的環境,Amazon Bedrock 原生的呼叫記錄功能可將記錄寫入 Amazon Simple Storage Service (Amazon S3),提供不可篡改的審計軌跡。
大規模部署的經驗
我們在全新的 AWS 帳戶上端對端部署了這個模式,以確認範例程式碼片段可正常運作。在我們自己的部署中,這個 LLM 閘道擴展至數百名開發人員,過程中我們汲取了多項經驗。
營運方面的經驗
大規模運行後的主要發現:
- 延伸思考會徹底改變延遲表現。 使用 Claude 延伸思考功能的請求,視乎思考預算,可能需要數分鐘甚至更長時間。如果負載平衡器的閒置逾時設為 60 秒,這些請求便會無聲失敗。要解決這個問題,你可以將負載平衡器的閒置逾時設為至少 900 秒,並相應設定 LiteLLM 的請求逾時(
timeout: 900,見本文較早部分的 Step 2 設定)。 - 遭限流時,先在同一模型上退避並重試,再啟動後備方案。我們最初的想法是在遭限流時由 Sonnet 切換至 Haiku。但對編碼助理而言,這並非最佳做法,因為更換模型會破壞開發人員所依賴的一致行為。相反,應在代理層級以指數退避方式,在同一模型上重試(
max_retries: 3,見 Step 2)。重試後仍無法處理請求時,應清楚顯示錯誤,而不是傳回其他模型的補全結果。 - 將自動化工具呼叫與開發人員流量分開。持續整合和持續交付 (CI/CD) 管道及自動化程式碼審查工具,應使用各自的推理設定檔和配額,直接呼叫 Amazon Bedrock。將自動化流量與開發人員的互動流量混合,會導致延遲難以預測,亦妨礙準確歸屬成本。
- 可行情況下,從第一天起便使用 Global CRIS。我們最初使用 Geographic (US) CRIS,但達到區域配額上限後,最終遷移了推理設定檔。由於我們的使用情況沒有資料駐留限制,因此可以使用 Global CRIS。Global CRIS 會跨區域路由請求,以利用更大的容量池,令大規模管理更簡單。
部署注意事項
有兩項常見的設定錯誤,往往要到支出或連線出現問題時才會察覺:
必須設定各模型的成本,才能執行預算限制。若要追蹤每位用戶的成本控制,每個模型中的 model_info 區塊不可省略。當 model 指向 Amazon Bedrock 推理設定檔 ARN 時,LiteLLM 無法在其內置定價表中查找該 ARN。因此,它會將每個 token 的成本記錄為 $0,導致 max_budget 和 429 的限流機制無聲地無法觸發。無論流經多少 token,支出都會維持在 $0。請設定 input_cost_per_token 和 output_cost_per_token(或 input_cost_per_million_tokens)以修正問題。
資料庫與快取:database_url 必須是 PostgreSQL。LiteLLM 的虛擬金鑰(/key/generate)、store_model_in_db 和支出追蹤均由 Postgres 支援。
以下幾項較小的部署細節,也補充完善了我們的檢查清單:
- Global CRIS 的 IAM 需要基礎模型資源,不能只提供應用程式推理設定檔 ARN,否則執行時會拒絕呼叫。
- 為 Fargate 任務配置足夠記憶體。 LiteLLM 的閘道映像檔在 512 MB 時會耗盡記憶體並遭終止(exit 137),無法通過健康檢查。約 2 GB 是較安全的最低配置。
- 覆寫容器
entryPoint。 官方映像檔的進入點是litellm。如果你使用 shell 指令碼在啟動時產生設定檔,請設定entryPoint: ['/bin/sh','-c'],否則你的指令碼會作為引數傳給litellm。 - IAM 角色和安全羣組的描述必須使用 ASCII 字元。 IAM 和 Amazon EC2 不接受長破折號和
->箭頭。 - 確認你的帳戶和區域是否提供該模型。 模型 ID 和 CRIS 設定檔會有變動。請使用
aws bedrock list-inference-profiles核實(例如,我們使用了claude-haiku-4-5,因為當時無法使用claude-haiku-3-5)。
清理
本文透過示意程式碼片段介紹這種模式,而非提供單一可部署的堆疊,因此沒有一鍵拆除的方法。不過,這個架構依賴多項在運作期間會持續收費的資源,包括 AWS Fargate 服務、Amazon RDS(PostgreSQL)、Amazon ElastiCache for Valkey 和 Application Load Balancer,以及支援服務所需的 Secrets Manager 機密、CloudWatch 警示和 Amazon Bedrock 應用程式推理設定檔。測試完成後,請移除這些資源,以免持續產生費用。
如果你使用 Guidance for Multi-Provider Generative AI Gateway on AWS 部署了完整方案,請按照該方案的清理指示移除所有建立的資源。使用 AWS CDK 時,請執行 cdk destroy。使用 AWS CloudFormation 時,請刪除堆疊。
如果你根據本文的程式碼片段自行建置此模式,請逐一移除各項資源:
- AWS Fargate 服務和叢集:刪除 Amazon Elastic Container Service(Amazon ECS)服務,以停止並排空任務,然後刪除叢集。
- Application Load Balancer:刪除 ALB,以及其接聽程式和目標羣組。
- Amazon RDS(PostgreSQL):刪除資料庫執行個體。只有在需要保留 API 金鑰和支出數據時,才先建立最後一份快照。
- Amazon ElastiCache for Valkey:刪除複寫羣組或叢集。它只存放快取數據,因此無需建立快照。
- Amazon Bedrock 應用程式推理設定檔:刪除在步驟 3 建立的設定檔,可以移除 AWS CDK 建構項目,或執行
aws bedrock delete-inference-profile。 - AWS Secrets Manager 機密:安排刪除代理伺服器的機密,例如主金鑰和資料庫登入資料。
- Amazon CloudWatch 警示和日誌羣組:刪除 TPM 警示,以及任何 LiteLLM 日誌羣組。
請先刪除 AWS Fargate 服務和 ALB,再刪除它們所依賴的 Amazon RDS 和 ElastiCache 端點,避免拆除期間執行中的任務因後端已移除而出錯。
總結
本文詳細介紹了一種 LLM 閘道模式,透過抽象化 Amazon Bedrock 的多模型架構,為團隊提供可擴展且具可觀測性的自助服務存取。由於 Amazon Bedrock 可透過單一介面在不同模型之間路由,而無需更改基礎架構,開發人員便能透過熟悉的 API 即時使用基礎模型。工程和安全團隊可掌控成本管治、可觀測性和單一控制平面,而財務團隊則可取得按用戶歸屬的費用資料,無需自行建置自訂計量基礎設施。
先仔細閲讀本文中的模式及程式碼片段,瞭解各部分如何配合。AWS CDK 程式碼片段涵蓋 Amazon Bedrock 應用程式推論設定檔、其 IAM 政策,以及 CloudWatch 警示。周邊的 AWS Fargate 服務、Amazon RDS、Amazon ElastiCache、ALB 和 AWS Secrets Manager 資源均採用標準 AWS CDK 模式,因此未有展示。
如要取得完整且可部署的實作,Guidance for Multi-Provider Generative AI Gateway on AWS 與此模式高度一致。你可在 AWS Solutions Library 找到此指南,以及配套的網誌文章和 GitHub 專案。本文逐步説明瞭相同的核心模式,但重點在於將 Amazon Bedrock 用於開發者程式碼助理。較完整的解決方案架構則加入多供應商支援、Amazon ECS 或 Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon CloudFront 和 AWS WAF 選項,以及管理員介面。
你可參閲 Amazon Bedrock Inference Profiles、LiteLLM gateway、AWS Fargate 和 Langfuse 的補充文件,深入瞭解此架構的各個元件。
在你的機構中試用此模式。先由試點團隊開始,驗證成本控制措施,再逐步擴展。
關於作者

Sitaraman Vijay Krishna
Sitaraman Vijay Krishna 是 AWS 的資深技術客戶經理,與客戶合作處理生成式 AI、Agentic AI 和 AI 可觀測性相關工作,包括親自協助客戶採用 AWS DevOps Agent。工作以外,他一向熱愛體育,無論親自上場,還是在看台觀賽,都同樣樂在其中。

Saurav Bhattacharya
Saurav Bhattacharya 是 Amazon Web Services (AWS) 的資深解決方案架構師,在電訊、寬頻和媒體領域擁有豐富經驗。他目前專注於解決媒體與娛樂業的挑戰、加快技術銷售,並建立可擴展的解決方案,協助客戶加快數碼轉型。

Eric Christensen
Eric Christensen 是 Amazon Web Services (AWS) 的技術客戶經理,在雲端財務管理和成本優化方面經驗豐富。他已在 AWS Solutions Library 發佈大量程式碼範例,以及多個成本及運作狀況追蹤儀錶板。
來源:AWS Machine Learning Blog · aws.amazon.com