如何在 Amazon EKS 上使用 NVIDIA Run:ai GPU Fractioning
Using NVIDIA Run:ai GPU Fractioning on Amazon EKS
文章示範如何在 Amazon EKS 設定 NVIDIA Run:ai GPU Fractioning,並以自訂 AL2023 映像及 G5/A10G 配置驗證 GPU 記憶體共享。
文章以 G5/A10G 實測展示 Pod 記憶體合約、用量監測及超限拒絕的驗證流程,並交代這項測試未涵蓋的隔離與效能範圍。
GPU 共用並非新概念:Multi-Instance GPU (MIG)、時間切片和 Multi-Process Service (MPS) 分別滿足不同的隔離和使用率需求。NVIDIA Run:ai GPU Fractioning 以 MPS 為基礎,加入與 Kubernetes 整合的排程、每個 Pod 的記憶體配額、強制執行機制及指標。
NVIDIA Run:ai 是適用於 Kubernetes 的 AI 工作負載編排軟件。其 GPU Fractioning Operator 可協助多個團隊在 Amazon Elastic Kubernetes Service (Amazon EKS) 上共用一張或兩張 GPU。即使 GPU 記憶體仍有剩餘,筆記本、模型評估和小型推理服務也可能令團隊需要等待。在本教學的基準設定中,NVIDIA 裝置外掛程式會將單張 GPU 以一個 nvidia.com/gpu 資源形式公開,並停用 GPU 共用功能。即使兩者合計的 GPU 記憶體需求符合容量,兩個各自要求 nvidia.com/gpu: 1 的 Pod 仍無法在該節點上同時執行。
NVIDIA Run:ai GPU Fractioning 為軟件式共用加入 Kubernetes 排程整合、強制執行的 GPU 記憶體上限,以及每個 Pod 的指標。此方案適用於符合 GPU Fractioning Operator 硬件及軟件要求的 NVIDIA GPU,包括不支援 MIG 的 GPU。我們以一部配備 NVIDIA A10G Tensor Core GPU 的 Amazon Elastic Compute Cloud (Amazon EC2) g5.xlarge 執行個體作為經驗證的範例。其他配置則需要進行相容性檢查和驗證。
NVIDIA 於 2026 年 10 月 13 日宣佈開源發布 NVIDIA Run:ai。本範例使用其四個模組化元件中的兩個:KAI Scheduler 和 GPU Fractioning Operator。KAI Resource Management 和 Workload Map 涉及組織治理及其他工作負載類型,不在本教學的範圍內。
本文將展示如何建立自訂的 Amazon Linux 2023 (AL2023) 映像,並在 Amazon EKS 上設定 GPU 記憶體共用。在經驗證的 G5/A10G 範例中,你會先建立整張 GPU 的基準設定,為每個 Pod 設定 8 GiB 記憶體配額,並驗證 6 GiB 配置。然後檢查每個 Pod 的指標、測試 9 GiB 配置是否會被拒絕,並清理這個臨時環境。
選擇 GPU 共用方案
MIG 可在受支援的 GPU上提供硬件分區。裝置外掛程式的時間切片可讓多個工作負載共用 GPU,但不提供副本之間的記憶體隔離或故障隔離。MPS 允許多個 CUDA 程序同時執行。故障隔離能力取決於設定。NVIDIA Run:ai GPU Fractioning 會強制執行每個容器的記憶體上限,並支援 time-slicing(預設)或 sm-sharing 計算模式。NVIDIA 的文件指出,預設模式會為不同工作負載劃分獨立的錯誤範圍,而 sm-sharing 則共用錯誤範圍。這些並非安全性保證。本教學測試記憶體上限,不測試故障隔離或運算效能。記憶體上限不會按比例預留運算資源。
Amazon EKS 列出數種 GPU 共用選項:MIG、使用 NVIDIA 裝置外掛程式的時間切片,以及使用 NVIDIA DRA 驅動程式和 Karpenter的時間切片。如需瞭解如何選擇,請參閲 Amazon EKS Best Practices Guide 中的GPU 共用指引。如需在不支援 MIG 的 GPU 上強制執行每個 Pod 的 GPU 記憶體上限,並可使用固定規模的 GPU 節點羣組,請選擇 GPU 資源切分方案。
動態資源配置 (DRA) 提供用於請求及配置裝置的 Kubernetes API。GPU 共用與隔離取決於裝置驅動程式的實作及已啟用的功能。KAI Scheduler 和 GPU Operator 支援 DRA。本指南使用 NvFractions 註解,而非 DRA。
GPU 分割有助於處理有閒置時段的互動式筆記本、短時間評估工作、GPU 相容性測試,以及小型推理服務。請根據實測峯值用量加上額外開銷,設定各項 GPU 記憶體請求,然後在並行負載下測試延遲。示範中呈現的密度提升,並不代表吞吐量有所提升或成本普遍下降。
方案概覽
下圖展示在美國東部(俄亥俄)區域 (us-east-2) 經驗證的單 GPU 環境。你會使用 AWS 命令列介面 (AWS CLI)、eksctl、Helm 和 Packer 建置及操作此環境。Amazon EKS 控制平面在 AWS 管理的 Amazon 虛擬私有雲 (Amazon VPC) 中執行 Kubernetes 1.36 版,並與客戶 VPC 分開。控制平面連接至客戶 VPC 私有子網中的 EC2 工作節點。
m7i.large 系統節點承載 Operator 控制器和 KAI Scheduler。KAI Scheduler 將兩個 Pod 安排在一個加上污點的 g5.xlarge 上;該執行個體配備一張 A10G,具有 23,028 MiB GPU 記憶體。
每個 Pod 的 GPU 記憶體限制為 8 GiB,並配置 6 GiB GPU 記憶體。GPU 工作節點使用自訂 AL2023,並配備 NVIDIA R615 驅動程式分支、NVIDIA Container Toolkit 和 containerd。它透過 Node Resource Interface (NRI) 整合及 MPS 共用功能執行 fractiond。metricsd 守護程序會輸出每個 Pod 的 GPU 記憶體指標。
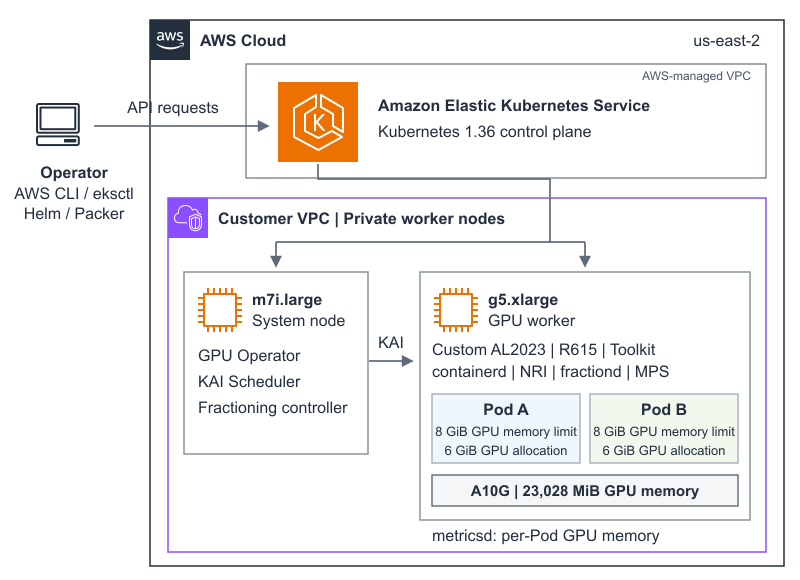
圖 1:Amazon EKS 中單張 A10G 上兩項 GPU 記憶體配置的經驗驗證範例
實作指南
本指南使用 AWS Samples 儲存庫。確認先決條件及經驗驗證的元件版本,然後完成步驟 1 至 10。
先決條件
使用具備 Amazon EKS、AWS CloudFormation、Amazon VPC、Amazon EC2、Amazon Elastic Block Store (Amazon EBS)、AWS Identity and Access Management (IAM),以及用於探索 Amazon Machine Image (AMI) 的 AWS Systems Manager 權限的 AWS 帳戶。確認 g5.xlarge、系統節點及臨時 m5.xlarge 映像建置器的配額和容量。安裝 AWS CLI v2、eksctl、kubectl、Helm、Packer、Git、jq 和 curl。
使用你平常採用的 AWS 憑證提供者:命名設定檔、AWS IAM Identity Center、已承擔的角色,或存取金鑰環境變數。優先使用臨時憑證。使用臨時存取金鑰時,AWS_SESSION_TOKEN 為必需項目。範例使用 us-east-2。其他區域必須支援所選的 Amazon EKS 版本和執行個體類型。
選用其他 GPU 前,請查看 NVIDIA 的 GPU Operator 硬件清單、所選 驅動程式的硬件支援,以及 GPU Fractioning Operator 的先決條件。僅有硬件支援並不足以確認 GPU 分割相容性。本指南只驗證 G5/A10G 配置。AMI 建置的目標為 x86_64。請檢查 CUDA 相容性及記憶體餘裕:兩項 8 GiB 配置必須有足夠記憶體,容納兩項配置及執行階段開銷。較小的裝置需要較小的配置,並須調整探測設定。
本操作指南會建立會產生費用的資源,包括 Amazon EKS 控制平面、NAT 閘道、執行個體、磁碟區及 AMI 快照。請使用可棄置的環境,並在驗證完成後徹底清理。
使用已驗證的 AL2023 堆疊
驗證時,EKS 最佳化的 AL2023 NVIDIA 映像提供 R580 和 R595 驅動程式分支。GPU Fractioning Operator v0.1.7 需要 R615 或更新版本。R615 是短生命週期分支,並非 GPU Operator 的預設分支。本範例會建置自訂的標準 Amazon EKS 1.36 AL2023 映像,並使用隨 AMI 提供的驅動程式和工具套件。此做法不會在另一個作業系統上使用由 Operator 管理的驅動程式容器。表格記錄的是實驗室驗證結果,並非供應商支援認證。
| 元件 | 已驗證版本 |
| Amazon EKS | 1.36 |
| GPU | NVIDIA A10G, 23,028 MiB |
| NVIDIA 驅動程式 / Container Toolkit | 615.71.10 / 1.20.1-1 |
| containerd | 2.3.5(含 NRI) |
| GPU Operator / 裝置外掛程式 | 26.7.1 / 0.20.1 |
| KAI Scheduler / Fractioning Operator | 0.18.5 / 0.1.7 |
我們於 2026 年 10 月 22 日使用 NVIDIA 驅動程式 615.71.10 驗證本操作指南。2026 年 11 月 18 日,在更新 GPU 節點污點後,我們使用相同驅動程式的映像重複所有步驟,但第 3 步的映像建置除外。結果一致。表格列出受測元件版本,並非永久適用的支援矩陣。更改任何元件前,請重新查閲 Amazon EKS AMI 文件及 NVIDIA 先決條件。
步驟 1:複製及設定
複製存放庫,然後根據提供的範例建立本機設定檔,並限制其權限:
git clone https://github.com/aws-samples/sample-code-for-gpu-fractioning-on-eks.git
cd sample-code-for-gpu-fractioning-on-eks
cp walkthrough.env.example walkthrough.env
chmod 600 walkthrough.env
複製後,使用 walkthrough.env 進行設定,並使用 run.sh 執行各個階段。產生的檔案和 kubeconfig 會保留在已加入 Git 忽略設定的 .state 目錄中。GPU_INSTANCE_TYPE 用於選取執行個體類型。單獨更改此設定不代表已確認相容性。
walkthrough.env 中的預設值及選用驗證設定
AWS_REGION=us-east-2
CLUSTER_NAME=runai-fractioning-blog
EKS_VERSION=1.36
GPU_INSTANCE_TYPE=g5.xlarge
NVIDIA_DRIVER_VERSION=615.71.10

# Choose a profile or access-key variables, not both.
# AWS_PROFILE=my-profile
# AWS_ACCESS_KEY_ID=YOUR_ACCESS_KEY_ID
# AWS_SECRET_ACCESS_KEY=YOUR_SECRET_ACCESS_KEY
# AWS_SESSION_TOKEN=YOUR_SESSION_TOKEN
切勿將憑證提交至 Git。本機設定檔已加入 Git 忽略設定。佈建前請確認目前使用的身分:
./run.sh check可分別執行各個階段以檢查結果,或使用 ./run.sh walkthrough 一直執行至記憶體限制測試。清理作業必須另行執行。
步驟 2:建立可棄置的叢集
執行以下指令,以建立可棄置的 Amazon EKS 叢集及其系統節點:
./run.sh create-cluster此指令會佈建一個執行 Kubernetes 1.36 的 Amazon EKS 叢集、一個設有單一 NAT 閘道的專用 VPC、OpenID Connect (OIDC) 整合,以及一個私有 m7i.large 受管節點。
config/eksctl-cluster.yaml.tpl 中的選定欄位
iam:
  withOIDC: true
vpc:
  nat:
    gateway: Single
managedNodeGroups:
  - name: system-ondemand
    instanceType: m7i.large
    desiredCapacity: 1
    privateNetworking: true
步驟 3:建置自訂 AL2023 映像
執行以下指令,以建置採用 R615 驅動程式分支的自訂 AL2023 映像:
./run.sh build-ami指令碼會尋找公用建置子網路,以及適用於 AL2023 上 Kubernetes 1.36 的建議標準 Amazon EKS AMI。Packer 會安裝 R615 驅動程式分支的最新修補版本及工具套件、設定 NVIDIA 執行階段、檢查套件狀態,並建立加密映像。該區域專屬的 AMI ID 會儲存在 .state/ami-id 中。
NVIDIA_DRIVER_VERSION 用於選取 R615 分支,並非鎖定至特定修補版本。工作流程會將偵測到的驅動程式版本與 AMI ID 一併記錄,並在 AMI 和節點羣組標籤中使用該版本。請查看 .state/installed-driver-version,瞭解建置中偵測到的版本。用於正式環境時,請在自己的建置中鎖定確切套件和基礎映像,並驗證升級至受支援的驅動程式分支。
只有在驗證時 EKS 最佳化 AL2023 NVIDIA AMI 尚未包含 R615 驅動程式分支的情況下,才需要此步驟。在該 AMI 為你的 GPU 選用的驅動程式及其餘主機先決條件均符合 GPU Fractioning Operator 的要求後,請優先使用 EKS 最佳化 NVIDIA AMI。請查看 GitHub 上的 Amazon EKS AMI 發佈版本,瞭解驅動程式版本。範例中的指令碼目前要求 R615 驅動程式及映像檔建置時產生的中繼資料,因此使用標準 AMI 亦需要修改指令碼。
ami/eks-al2023-r615.pkr.hcl 的相關 Packer 設定
source "amazon-ebs" "eks_al2023_r615" {
  source_ami = var.source_ami_id
  region = var.aws_region
  encrypt_boot = true
  metadata_options {
    http_tokens = "required"
  }
}
SOURCE_AMI_ID 和 PACKER_SUBNET_ID 是已核准基礎映像或建置器子網路的可選覆寫值。作業系統或 GPU 堆疊變更時,請重新建置並測試映像。
步驟 4:新增 GPU 工作節點
執行以下指令,新增使用自訂映像的 GPU 受管節點羣組:
./run.sh add-gpu-node預設情況下,受管節點羣組會使用自訂映像,並維持一個 On-Demand g5.xlarge,即經過驗證的 GPU 工作節點。GPU 污點會排除一般工作負載。由於 GPU Operator 會管理該元件,因此指令碼會停用 eksctl 的 NVIDIA 裝置外掛程式安裝。
config/eksctl-gpu-nodegroup.yaml.tpl 的選定欄位
managedNodeGroups:
  - name: gpu-g5-r615-ondemand
    instanceType: g5.xlarge
    ami: <generated-ami-id>
    amiFamily: AmazonLinux2023
    desiredCapacity: 1
    minSize: 1
    maxSize: 1
    privateNetworking: true
    taints:
      - key: nvidia.com/gpu
        effect: NoSchedule
步驟 5:安裝 GPU Operator 並檢查主機
執行以下指令,安裝 GPU Operator 並檢查 GPU 工作節點的主機設定:
./run.sh install-gpu-operatorGPU Operator 26.7.1 提供裝置外掛程式及 Kubernetes 整合功能。其設定會保留由映像檔管理的驅動程式和工具套件:
driver:
  enabled: false
toolkit:
  enabled: false
同一指令會在 GPU 工作節點上執行一個臨時特權檢查 Pod、列印主機設定,然後移除該 Pod。驗證所得的節點資訊如下:
觀察到的主機設定
GPU: NVIDIA A10G, 23028 MiB
Driver: 615.71.10
NVIDIA Container Toolkit: 1.20.1-1
containerd: 2.3.5
cgroup filesystem: cgroup2fs
NRI socket paths:
  /var/run/nri/nri.sock
  /run/nri/nri.sock
在此 AL2023 節點上,/var/run 是指向 /run 的符號連結。兩個路徑都指向同一個通訊端。只在可棄置環境中進行特權檢查,並確認 Pod 已移除。
步驟 6:建立整張 GPU 的基準測試
執行以下指令,在安裝 GPU 分割功能前測試整張 GPU 的排程:
./run.sh baseline每個基準測試 Pod 的 nvidia.com/gpu 請求值和限制值均為 1。此測試假設有一張可用的實體 GPU,且已停用 GPU 共享:一個 Pod 會執行,另一個則維持 Pending 狀態。這展示了安裝 GPU 分割功能前,整張 GPU 的排程限制。在多 GPU 節點上,請調整此基準測試,並確認兩個 GPU 分割工作負載使用同一張 GPU。
實測基準測試結果
NAME          READY   STATUS    NODE
whole-gpu-a   1/1     Running   <gpu-node>
whole-gpu-b   0/1     Pending   <none>
指令碼會檢查此狀態並移除兩個基準測試 Pod。
步驟 7:安裝 KAI Scheduler 和 GPU Fractioning Operator
執行以下指令,安裝包含 GPU Fractioning Operator 的 KAI Scheduler:
./run.sh install-kai固定版本的 KAI Scheduler 0.18.5 chart 包含 GPU Fractioning Operator 0.1.7。設定會啟用 NvFractions 和每個 Pod 的指標,同時保留 GPU 堆疊版本檢查。可選的 nvidia.com/container.<name>.gpu-compute.mode 註釋可選擇計算模式。這些工作負載不會更改預設值。
helm/kai-values.yaml 的相關欄位
global:
  gpuSharingMode: NvFractions
  nvFractions:
    set: true
gpu-fractioning:
  metricsAgent:
    enabled: true
skipGpuStackVersionChecks: false在驗證中,FractiondReady、MpsdReady 及 Ready 的值均為 True。DriverUpgradeInProgress 為 False,原因為 NoDriverUpgrade,這與 AMI 保留驅動程式管理權相符。
步驟 8:執行 GPU 共享正向測試
執行以下指令,部署兩個 GPU 記憶體配額為 8 GiB 的 Pod:
./run.sh share每個 Pod 的記憶體請求值和限制值均為 8 GiB,並選取 kai-scheduler。兩者均不會請求完整的 nvidia.com/gpu 資源。此程式碼庫會套用這些排程欄位,並執行配置 6 GiB 記憶體的 CUDA 探測程式:
kubernetes/fraction-8gi-pods.yaml 的必要欄位
metadata:
  annotations:
    nvidia.com/container.gpu-workload.gpu-memory.request: 8Gi
    nvidia.com/container.gpu-workload.gpu-memory.limit: 8Gi
spec:
  schedulerName: kai-scheduler
  runtimeClassName: nvidia
實測正向結果
NAME             READY   STATUS    NODE
fraction-8gi-a   1/1     Running   <same-gpu-node>
fraction-8gi-b   1/1     Running   <same-gpu-node>
腳本會驗證節點名稱和 GPU UUID 是否相符。在驗證中,兩個 Pod 均顯示 8,192 MiB,並回報 allocation_succeeded_mib=6144。這些檢查證明 Pod 部署在同一張實體 GPU 上、看到受限制的裝置視圖,並在各自的資源合約範圍內成功配置。
每個 Pod 的實測配置輸出
NVIDIA_GPU_MEMORY_LIMIT=8192
requested_allocation_mib=6144
allocation_succeeded_mib=6144
兩個 Pod 保持運作時觀察記憶體
./run.sh metricsgpu_fractioning_gpu_memory_used_bytes 指標按 Pod 和 GPU UUID 標示記憶體用量。每個 Pod 觀察到的 6,394 MiB(約 6.24 GiB),比探測程式配置的 6,144 MiB 多 250 MiB。指標可能包含 CUDA context 和執行階段開銷。本實驗沒有量度這些開銷的細分情況。監察共用裝置時,應一併保留工作負載身分,以及請求、限制和使用量數值。
每個 Pod 的實測指標序列
gpu_fractioning_gpu_memory_used_bytes{
  gpu_uuid="<same-gpu-uuid>",
  namespace="runai-fractioning-test",
  pod="fraction-8gi-a"} 6.704594944e+09

gpu_fractioning_gpu_memory_used_bytes{
  gpu_uuid="<same-gpu-uuid>",
  namespace="runai-fractioning-test",
  pod="fraction-8gi-b"} 6.704594944e+09
步驟 9:驗證超出限制時會否遭拒
執行以下命令,測試超出 8 GiB 合約的記憶體配置:
./run.sh limit此命令會移除正向測試 Pod,並建立一個具有 8 GiB 合約、但嘗試配置 9 GiB 記憶體的 Pod。探測程式回報:
超出限制時的實測結果
NVIDIA_GPU_MEMORY_LIMIT=8192
requested_allocation_mib=9216
allocation_failed=out of memory
負向測試 Pod 的實測狀態
NAME                      READY   STATUS      NODE
fraction-8gi-over-limit 0/1 Completed <gpu-node>在此,cudaMalloc 會傳回記憶體不足錯誤,探測程式會在退出並回傳代碼 0 前處理該錯誤。Completed 是預期結果,而非 OOMKilled。這證明配置會遭拒,並非容器終止或一般故障隔離。
步驟 10:清理
刪除叢集前,先擷取 VPC ID。接下來的獨立檢查會使用預設叢集名稱和區域。如有更改設定,請代入相應值。
擷取 VPC ID
VPC_ID=$(aws eks describe-cluster \
  --name runai-fractioning-blog --region us-east-2 \
  --query cluster.resourcesVpcConfig.vpcId --output text)
移除暫用環境
./run.sh cleanup標準清理程序會移除測試命名空間、Helm 發行版本及暫用叢集,同時保留自訂 AMI 及其 Amazon EBS 快照。
驗證資源已刪除
aws eks describe-cluster \
  --name runai-fractioning-blog --region us-east-2
aws cloudformation describe-stacks \
  --stack-name eksctl-runai-fractioning-blog-cluster \
  --region us-east-2
aws ec2 describe-vpcs --vpc-ids "$VPC_ID" --region us-east-2
預期會收到明確的「找不到資源」回應,確認資源已刪除。驗證或權限錯誤不能證明資源已刪除。亦請檢查剩餘的節點羣組,以及帶有叢集標籤的執行個體。如清理失敗,請檢查 CloudFormation 事件,並在重試前處理由相關資源管理的依賴項。Amazon EKS 端點不存在,並不能證明其 VPC 已刪除。
只有在不再需要自訂 AMI 及其 Amazon EBS 快照時,才使用 ./run.sh cleanup-all。如果刪除映像檔遭拒,請確認 AMI ID 和範例中的擁有權標籤。請勿繞過安全措施。
正式環境注意事項
請將此視為行為驗證。使用可信任的工作負載,並採用最小權限 IAM、命名空間控制、核准的映像檔,以及針對 GPU 分額請求的准入規則。若需要更強的隔離,請在支援的硬件上選用整張 GPU 或 MIG。
已鎖定版本的 GPU 分額配置守護程式會使用特權容器、主機 PID 存取權,以及 NRI/MPS 主機掛載項目。請只讓可信任的管理員部署及設定這些守護程式。
為 CUDA context、快取、批次處理及執行階段開銷預留空間。在並行負載下量度延遲和吞吐量。監察配置失敗、MPS 健康狀況、NRI 連線狀態及 GPU 錯誤。將基礎 AMI、驅動程式、工具套件、裝置外掛程式、Operator、排程器及工作負載映像檔鎖定為一組經測試的組合。推出前重新建置映像檔並測試回復程序。
本操作指南需要預先配置 GPU 容量,並不會設定或驗證可感知 GPU 分額的自動擴展功能。分額 Pods 會選取 kai-scheduler,不會要求任何 nvidia.com/gpu 資源,並使用 nodeSelector,將目標節點羣組的節點數固定為一個。Karpenter 對次要排程器的支援,目前仍有一項待處理的功能請求(GitHub 上的問題 #742)。自訂映像檔無法在 Amazon EKS Auto Mode 管理的節點上執行,因為 Auto Mode 會選取並管理這些節點的 AMI。叢集可以混合使用 Auto Mode 管理的節點與受管節點羣組,但我們未有在這類叢集上驗證本操作指南。
採用 Karpenter 的團隊可在 EC2NodeClass 中透過 ID 參照相同的自訂 AMI。自動擴展限制仍然適用。我們未有驗證這種做法。
KAI Scheduler 是第二個排程器,負責處理選用它的 Pod 的佇列管理及放置。如果你已使用 Kueue,請在採用 KAI Scheduler 前,決定由哪個元件負責 GPU 工作負載的佇列管理。
我們建議在 GPU 節點上執行 Amazon EKS 節點監控代理程式。在 2026 年 11 月 18 日的一次回歸測試中,代理程式在自訂 R615 映像檔上執行,當時 MPS 共用已啟用;在整個共用及限制測試期間,代理程式回報的 GPU 狀態均正常。該次測試沒有測試故障偵測。由於 GPU Operator 已執行 Data Center GPU Manager (DCGM) 主機引擎,請設定代理程式使用該主機引擎,而非使用隨附的主機引擎。
結論
本文展示如何在 Amazon EKS 上使用自訂 AL2023 映像檔設定 GPU 記憶體比例分配,並以 G5/A10G 作為已驗證的範例。檢查先決條件並驗證所選設定後,此方法亦可延伸至相容的 NVIDIA GPU。你已建立全 GPU 基準,在同一張 GPU 上執行兩個設有限制的工作負載、檢視每個 Pod 的記憶體用量,並驗證超出上限的分配要求會被拒絕。當工作負載的記憶體需求符合條件時,比例分配可提升現有容量的使用效益。在正式環境採用此方法,亦須具備隔離控制措施並進行效能測試。
如要重複這項實驗,請複製 AWS Samples 儲存庫,並將結果與其中經驗證的測試證據作比較。在按你的工作負載調整範例前,請先參閲 GPU Fractioning Operator 説明文件及 Amazon EKS 加速運算 AMI 指引。
本文的內容及觀點由第三方作者提供,AWS 對本文的內容或準確性概不負責。
作者簡介

Muru Bhaskaran
Muru Bhaskaran 是 Amazon Web Services 的資深專業解決方案架構師。他擁有超過 20 年經驗,運用加速運算及 Kubernetes,協助企業建構安全、可擴展的 AI 訓練與推理基礎設施,並着重於正式環境就緒程度及價格效能。

Robert Ferrer
Robert Ferrer 是 Amazon Web Services 的專業解決方案架構師。他專注於大規模模型訓練與推理、GPU 加速基礎設施、分散式運算及 Agentic AI。他與客戶合作,權衡運算、網絡、儲存、編排、韌性及成本等方面的架構取捨,協助客戶從實驗階段邁向可靠的正式環境部署。

Eliuth Triana
Eliuth Triana 是 NVIDIA Amazon 團隊的開發者關係經理。他聯繫 Amazon 和 AWS 的產品主管、開發者及科學家,與 NVIDIA 的技術人員和產品主管合作,加快 Amazon 模型推理與訓練、ML/DL 工作負載、Amazon EC2 產品及 AWS AI 服務的發展。Eliuth 熱愛山地單車、網球、滑雪和撲克。

Felipe Garcia
Felipe Garcia 是 NVIDIA 雲端服務供應商 GTM 團隊的 AI 雲端服務高級解決方案架構師。他協助雲端供應商建立並擴展 GPU 加速的 AI 基礎設施,專注於雲原生架構,以及將 AI 工作負載從實驗階段推進至正式環境。
來源:AWS Machine Learning Blog · aws.amazon.com