AI 智能體的「土撥鼠之日」:在 Amazon Bedrock 使用 OpenAI 模型的提示詞快取模式
Groundhog Day for AI agents: Prompt caching patterns for using OpenAI models on Amazon Bedrock
AWS 的 Claudio Mazzoni 示範如何在 Amazon Bedrock 上為 OpenAI 模型配置提示詞快取,讓智能體重用未變的上下文並降低重複輸入成本。文章比較隱式、顯式及混合快取,並示範如何處理工具清單變更、子智能體和跨工作階段重用。六輪工作負載中,GPT-6 Astra 的隱式快取令輸入成本約降低 62%,顯式滾動斷點約降低 61%。
文章按靜態共享前綴、逐輪增長的對話及新增工具等情境,示範提示詞快取邊界的配置方法,並提供相應程式碼。
每次啟動 Agent,它都要重新讀取自己至今的完整經歷,才能採取行動。以下説明如何讓它記住事情,而不用再次向它提供相同的上下文。
在電影 Groundhog Day 中,Bill Murray 飾演的角色每天都要重過同一個2月2日。他一次又一次在同一間旅館醒來,聽到收音機播放同一首歌,身處同一個小鎮;部分影迷估計,這樣的日子持續了34年。
前一天完成的事情,沒有一件會延續下來,除非他從頭再做一次。AI Agent 活在一個版本的《Groundhog Day》裡。每次 Agent 採取一步行動(呼叫工具、讀取結果、決定下一步要做甚麼),都必須把截至當時的完整經歷傳給模型,才能維持連貫性:工具定義、指示、之前每一次工具呼叫,以及每個結果。模型只會根據你提供的輸入預測下一個 token。它在不同請求之間沒有內置記憶,因此每次都必須重新讀取全部內容。編碼工作階段進行到第20回合時,模型要重新讀取第1至19回合,而這些 token 每次都要由你再次付費。
提示詞快取打破了這個循環。服務會儲存你的輸入提示詞(指示、工具和內容),並在下一個請求中重用,費用只佔輸入價格的一小部分。
本文會帶你瞭解 Agent 的整個生命歷程,從第一個回合開始,到它取得新工具並啟動輔助 Agent 為止。過程中,我會説明提示詞快取如何降低成本,並讓 Agent 保持回應迅速和穩定一致。
Agent 傳送給 LLM 的內容
在討論快取之前,先看看典型 Agent 首次呼叫大型語言模型(LLM)時會包含哪些內容,會有助理解:
- 工具清單 – Agent 可呼叫的所有函式定義。推出新版本時會有所變更。
- 指示 – 開發者提示詞:規則、角色設定、政策和範例。每次推出新版本時也會有所變更。
- 歷史記錄 – 目前工作階段至今發生的一切:任務、模型的工具呼叫,以及工具結果(每個回合都會增加)。
- 新回合 – 最新的工具結果或用戶訊息(每次可能都不同)。
如果沒有設定快取,Agent 每個回合都會傳送以下內容給模型:
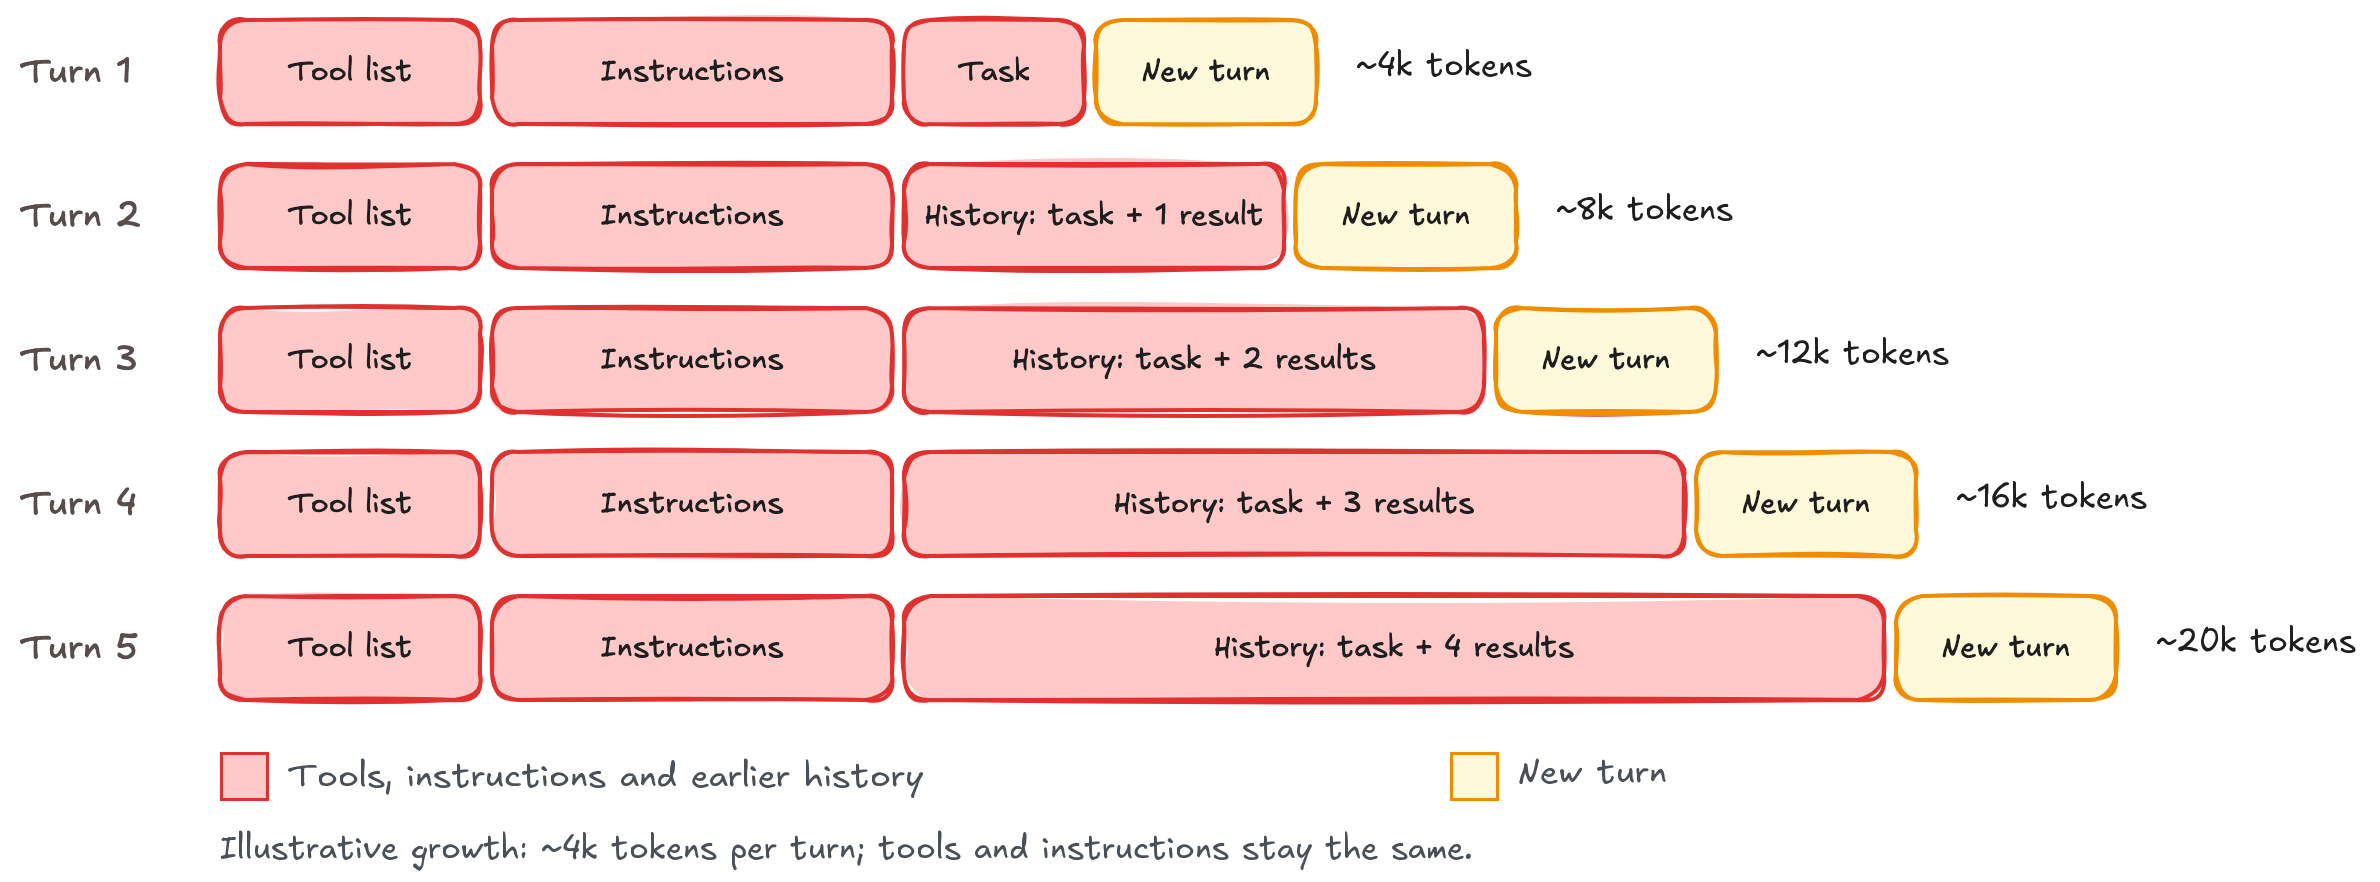
圖1:Agent 每個回合傳送給模型的內容
提示詞快取的底層運作原理
模型讀取提示詞時,首先會進行稱為 prefill 的寫入操作。在 prefill 過程中,模型會處理每個輸入 token,並建立鍵向量和值向量(亦稱為鍵值向量,或 KV),這些向量構成模型的工作狀態。這個步驟會在模型輸出第一個 token 之前完成。
提示詞快取會儲存該狀態,其中包含系統提示詞、工具、內容、歷史記錄等。之後的請求若以相同的輸入 token(即相同文字)開頭,提示詞快取服務便會載入已儲存的狀態,而不是再次計算。接着,它只會處理下一個傳送給模型的負載中新增的部分。提示詞快取可以是隱式的,由 Amazon Bedrock 選擇可重用前綴的結束位置;也可以是顯式的,由你的程式碼使用 prompt_cache_breakpoint 標示該位置。兩種方式可以一併使用,我們亦建議這樣做。
第1回合與第2回合的比較
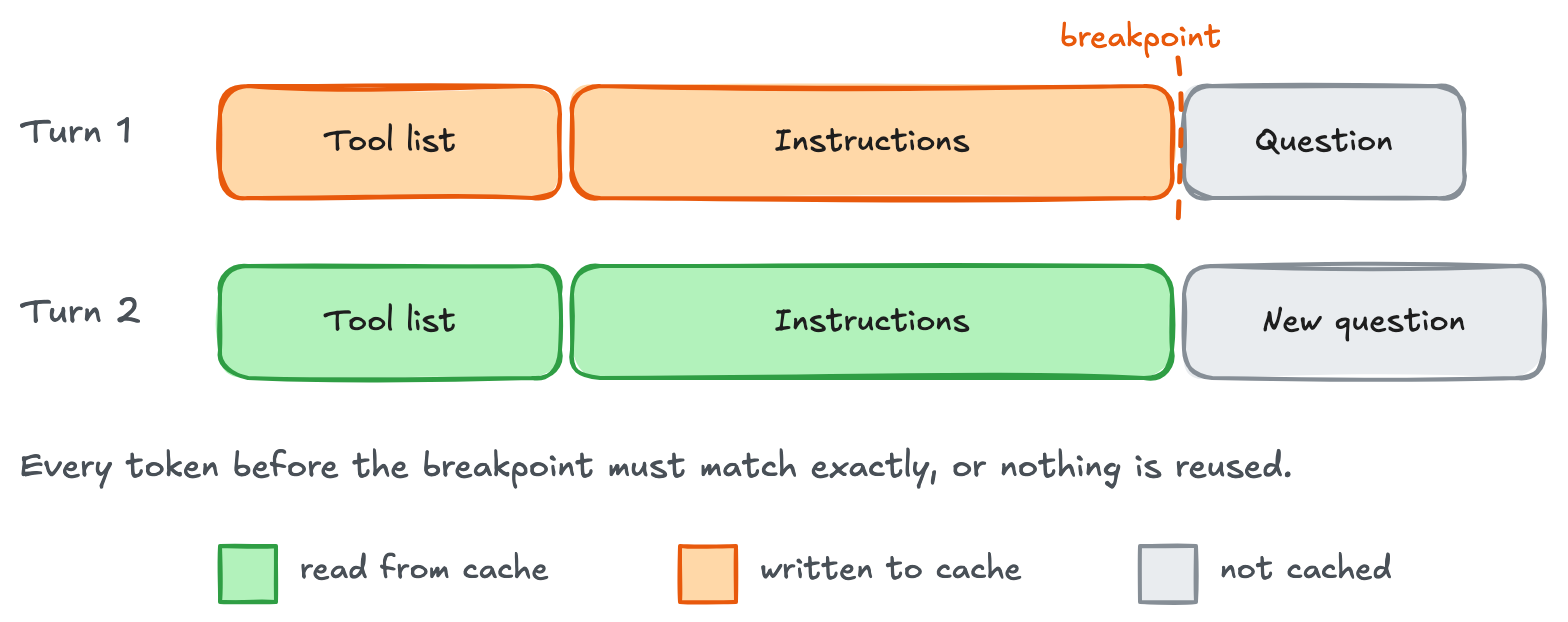
圖2:第1回合會儲存截至斷點的提示詞前綴;第2回合會重用該前綴,只需按全價支付新問題的費用
隱式還是顯式?為甚麼兩者都需要?
對於 Agent 工作負載,隱式快取會讓 Bedrock 隨着對話內容增加,自行選擇要快取的內容。使用明確快取時,你可以標記共用內容,例如工具和指示,讓它們在不同工作階段及啟動輔助 Agent 時重複使用。你不一定需要同時使用兩種快取方式,但結合使用可提供可重複使用的起點,同時由 Bedrock 自動管理不斷增加的對話內容。
新的工作階段也可以重用這個共用起點,同時讓每段對話以各自快取的歷史記錄為基礎繼續進行。在這篇文章中,我們會先介紹第一輪對話,再示範如何在後續輪次、新工具及子 Agent 之間延續已快取的內容。
快取世界,你好
首先要做的是快取提示詞中的靜態部分:在不同請求中保持不變的工具和指示。以下範例會使用你現有的 Amazon Bedrock 用戶端、TOOLS 和 task。請將縮短版的 INSTRUCTIONS 字串替換為你實際使用的政策和範例。可重複使用的前綴必須達到 1,024 個 tokens 才符合資格。
快取靜態內容時,請使用明確模式:選擇已儲存前綴的結束位置。
KEY = "support-agent:v7:gpt-6-astra"
INSTRUCTIONS = "Your full support policies and examples..."

# Rendered context: [provider context][TOOLS][INSTRUCTIONS] | [task]
# Cache starts at the beginning; the marker below chooses its end.
resp = client.responses.create(
    model="us.openai.gpt-6-astra",
    store=False,  # Response storage; prompt caching still works.
    include=["reasoning.encrypted_content"],
    prompt_cache_key=KEY,
    prompt_cache_options={"mode": "explicit", "ttl": "30m"},
    tools=TOOLS,  # Rendered before instructions; keep order stable.
    input=[
        {
            "role": "developer",
            "content": [{
                "type": "input_text",
                "text": INSTRUCTIONS,
                # Save through this whole block, including TOOLS.
                "prompt_cache_breakpoint": {"mode": "explicit"},
            }],
        },
        # User message is processed but not cached.
        {"role": "user", "content": task},
    ],
)
prompt_cache_key 會告知服務哪些請求要共用快取。接下來談到如何在新工作階段讀取快取時,我們會再説明如何使用它。在我們其中一項使用明確快取的測試中,約 4,000 個 tokens 的工具及指示前綴在首次請求時寫入了 4,120 個 tokens,之後的請求則讀取這 4,120 個 tokens。task(或用戶請求)位於快取分界點之後,因此不會觸發寫入快取。
請注意,提示詞快取只會在傳入的文字完全相同時運作。請確保 Agent 的指示和工具清單每次都以相同方式序列化。Model Context Protocol (MCP) 伺服器及其他工具提供方式都需要建立索引,以確保內容保持一致。日期、用戶姓名或請求 ID 等會變動的內容,應放在已快取的指示之後。
隨着內容增加並出現變化(工具和內容各有不同),請使用隱式模式,讓服務跟進對話。此處的第一個請求沒有明確標記。最近一則符合資格的訊息是用戶的任務,因此自動快取分界點會設在該任務之後,並一併涵蓋工具、指示和任務。以下範例會明確展示此模式以便説明,雖然隱式模式是預設值。設定 store=False 會讓對話歷史記錄保留在你的應用程式中,並不會停用快取。
def ask_with_implicit_cache(history):
    return client.responses.create(
        model="us.openai.gpt-6-astra",
        store=False,
        include=["reasoning.encrypted_content"],
        prompt_cache_key=KEY,
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
        tools=TOOLS,
        input=history,  # Everything gets cached
    )

history = [
    {"role": "developer", "content": INSTRUCTIONS},
    {"role": "user", "content": task},
]
# Automatic endpoint: the end of the user message.
resp = ask_with_implicit_cache(history)
當下一輪延續同一項任務時,這種方式很有用。不同的任務不會符合延伸至舊任務的前綴,而隱式寫入也不一定會只為工具和指示建立獨立項目。如果你需要在不同任務之間重複使用較短的共用前綴,請在該處使用明確標記。
當 Agent 需要共用起點及不斷增加的歷史記錄時,請同時使用兩種方式。從以下程式碼範例中已標記的 developer 區塊開始,並呼叫函式 ask_with_implicit_cache。請求層級的模式維持為隱式。區塊層級的標記會在指示之後加入明確的儲存點。服務也可以將內容儲存至最近一則符合資格的訊息。這樣一來,共用前綴便能在對話內容增加時繼續使用。
history = [
    {
        "role": "developer",
        "content": [{
            "type": "input_text",
            "text": INSTRUCTIONS,
            "prompt_cache_breakpoint": {"mode": "explicit"},
        }],
    },
    {"role": "user", "content": task},
]
# Still implicit mode, now with an explicit startup save point in the history.
resp = ask_with_implicit_cache(history)
快取對話歷史記錄和工具結果
模型會按名稱要求使用工具,並提供其引數。你的應用程式必須執行這些工具。execute_function 是你建立的輔助函式,用來將這些要求路由至相應的 Python 函式,並傳回結果。以下迴圈會使用這個輔助函式執行每項所要求的工具。它會將模型的輸出及所有工具結果附加至 history 清單,然後再次傳送該清單,直至模型傳回最終答案。在隱式模式下,Amazon Bedrock 可以重用未變更的前綴,並快取截至最後一項工具結果的新增內容。請勿變更較早的訊息及初始的 TOOLS。
import json

# Map tool names to their Python implementations.
TOOL_HANDLERS = {
    "get_owner": get_owner,
    # Register your other initial tools here.
}

def execute_function(name, arguments):
    """Run the requested tool and return its result."""
    handler = TOOL_HANDLERS.get(name)
    if handler is None:
        return {"error": f"Unknown tool: {name}"}
    return handler(**arguments)

while True:
    # Preserve all output items, including encrypted reasoning.
    history.extend(resp.output)
    calls = [x for x in resp.output if x.type == "function_call"]
    if not calls:
        break
    for call in calls:
        result = execute_function(call.name, json.loads(call.arguments))
        history.append({
            "type": "function_call_output",
            "call_id": call.call_id,
            "output": json.dumps(result),
        })
    # The last result in this group supplies the automatic endpoint.
    resp = ask_with_implicit_cache(history)
如要繼續對話,請附加新的用戶訊息,然後再次呼叫輔助函式。請保持較早的訊息不變,以便其快取端點仍可使用。
滾動式斷點:每一輪都會讀取之前的所有內容
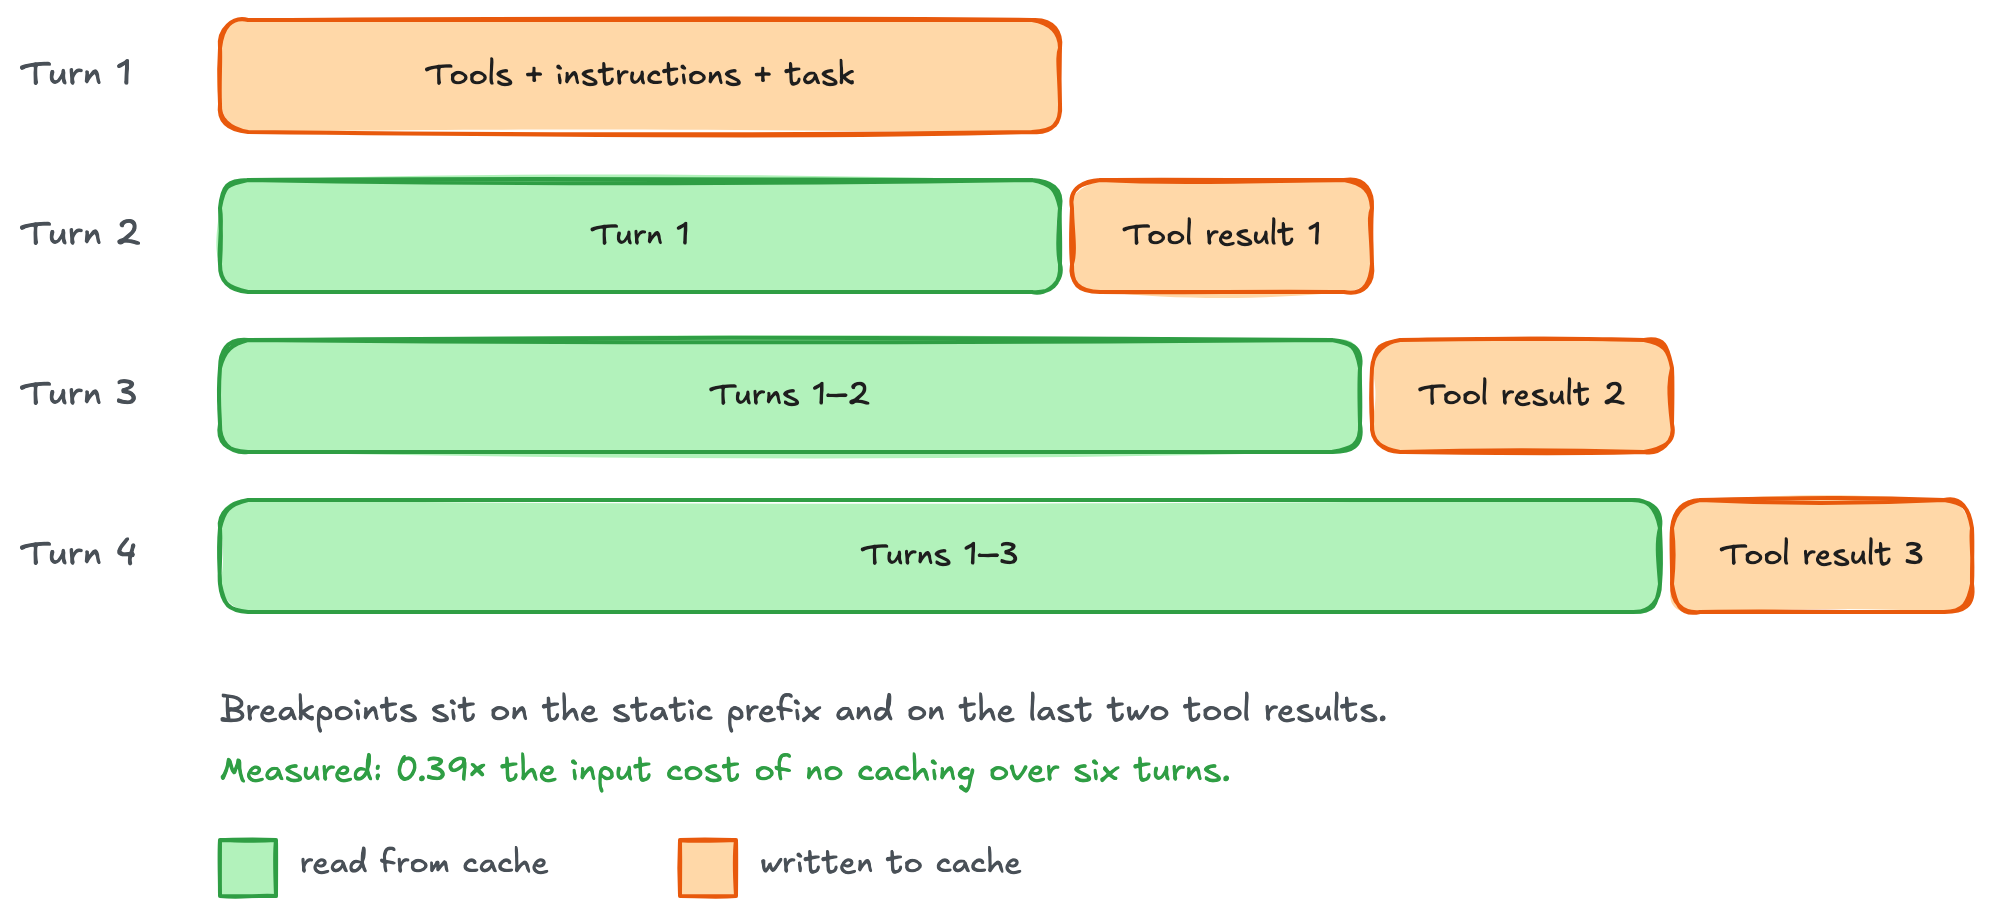
圖 3:滾動式斷點;每一輪都會讀取之前的所有內容,並只寫入該輪自己的工具結果
如要另外執行僅明確模式,請根據合併的 Hello cached world 範例,重新建立兩則訊息的歷史記錄。此迴圈會將工具結果包在 input_text 區塊中,並標示每批結果中的最後一項。較早的標記會保留在 history 中。長對話請參閲目前的查找規則。
import json

while True:
    resp = client.responses.create(
        model="us.openai.gpt-6-astra", store=False,
        include=["reasoning.encrypted_content"],
        tools=TOOLS, prompt_cache_key=KEY, input=history,
        prompt_cache_options={"mode": "explicit", "ttl": "30m"},
    )
    d = resp.usage.input_tokens_details
    print("read", d.cached_tokens, "write", d.cache_write_tokens)
    history.extend(resp.output)  # Includes encrypted reasoning.
    calls = [x for x in resp.output if x.type == "function_call"]
    if not calls:
        break
    batch = []
    for call in calls:
        result = execute_function(call.name, json.loads(call.arguments))
        batch.append({
            "type": "function_call_output", "call_id": call.call_id,
            "output": [{"type": "input_text", "text": json.dumps(result)}],
        })
    # Add the newest boundary; retain every earlier marker.
    batch[-1]["output"][-1]["prompt_cache_breakpoint"] = {"mode": "explicit"}
    history.extend(batch)
在這個六輪工作負載中,GPT-6 Astra 的隱式模式表現並列最佳:與不使用快取相比,輸入成本約低 62%。在同一模型上,明確滾動式斷點則節省約 61%。隨着對話延長,兩者都能重用更多歷史記錄。這些是該工作負載的結果。請量度自己的 Agent 可節省多少。
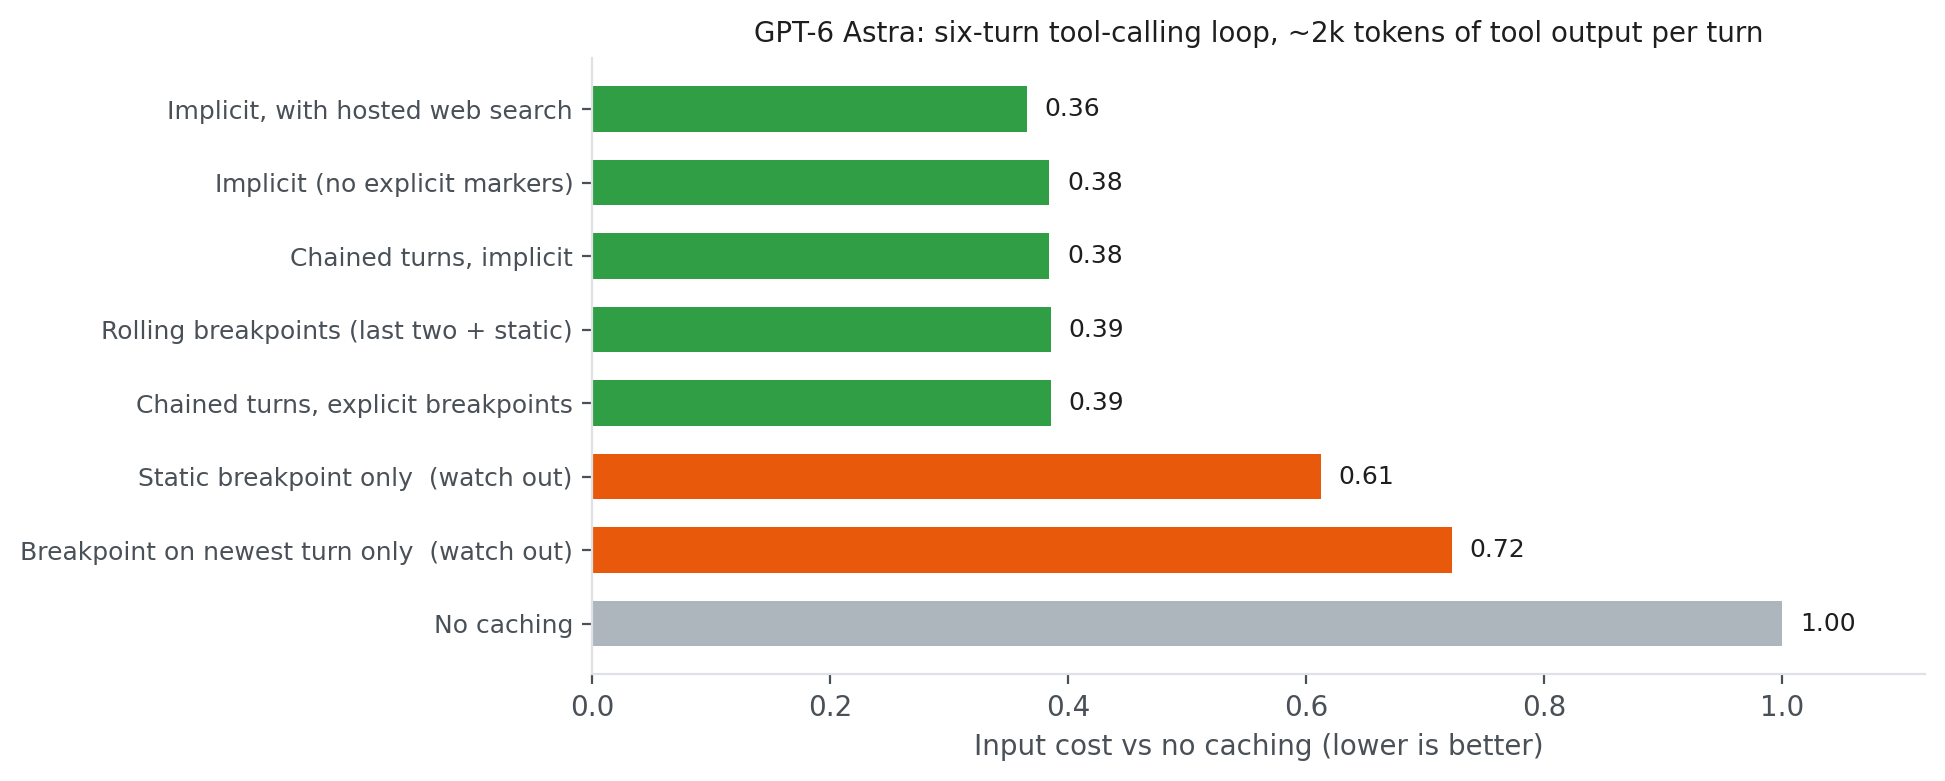
圖 4:GPT-6 Astra 各種快取設定的輸入成本,相對於不使用快取
請留意:
- 僅明確模式下只設置靜態斷點 – 工具和指示會被快取,但逐漸增加的歷史記錄每一輪都會重新處理 (0.61)。這項限制不適用於合併範例,該範例亦會透過符合條件的對話結尾節省成本。
- 移動單一斷點可能會令快取無法重用,並在僅明確模式下導致重複寫入。請同時保留上一輪的斷點。
- 任務變動時只進行隱式寫入 – 新任務可能會沿用相同的工具和指示,但不會沿用先前儲存的端點。如果不同任務需要重用較短的前綴,請在共用指示後加入明確標記。
工具變更時
有時 Agent 的工具清單會有變動,或會加入新工具。請保持初始清單不變:新增、移除或重新排序定義,都可能令快取前綴失效。請按工具的可用方式選擇合適做法。
已知工具會在 Agent 流程的不同步驟中呼叫時:傳送相同、已排序的 TOOLS,並使用 allowed_tools 限制模型可呼叫的工具。使用 allowed_tools 時,"mode": "auto" 會讓模型決定是否呼叫允許使用的工具,而 "mode": "required" 則要求至少呼叫一項允許使用的工具。請將此作為 tool_choice 傳入。這項限制不會改變已快取的工具目錄:
tool_choice={"type": "allowed_tools", "mode": "auto",
             "tools": [{"type": "function", "name": "get_owner"}]}
工作階段期間新增工具。 Amazon Bedrock Runtime 和 Amazon Bedrock Mantle 端點均接受一種名為 additional_tools 的輸入項目類型,適用於 GPT-6 Astra、GPT-6.1 Sol 和 GPT-5.6 Luna。如要查看各 AWS 區域支援的模型,請參閲Amazon Bedrock 各 AWS 區域支援的模型。請在輔助函式 execute_function 中註冊新工具 get_due_date,然後將其結構描述附加至 Agent 迴圈整理完成的歷史記錄。請保持初始的 TOOLS 不變:
TOOL_HANDLERS["get_due_date"] = get_due_date
NEW_TOOL = {
    "type": "function", "name": "get_due_date",
    "description": "Return the due date for a support case.",
    "strict": True,
    "parameters": {
        "type": "object",
        "properties": {"case_id": {"type": "string"}},
        "required": ["case_id"], "additionalProperties": False,
    },
}
history.append({
    "type": "additional_tools", "role": "developer",
    "tools": [NEW_TOOL],
})
history.append({
    "role": "user", "content": "Find the due date for case C-123.",
})
# Implicit mode saves through this new user message, including NEW_TOOL.
resp = ask_with_implicit_cache(history)
d = resp.usage.input_tokens_details
print("old prefix read", d.cached_tokens, "new write", d.cache_write_tokens)

# Example output:
# old prefix read 2048 new write 256
工作階段中途加入新工具
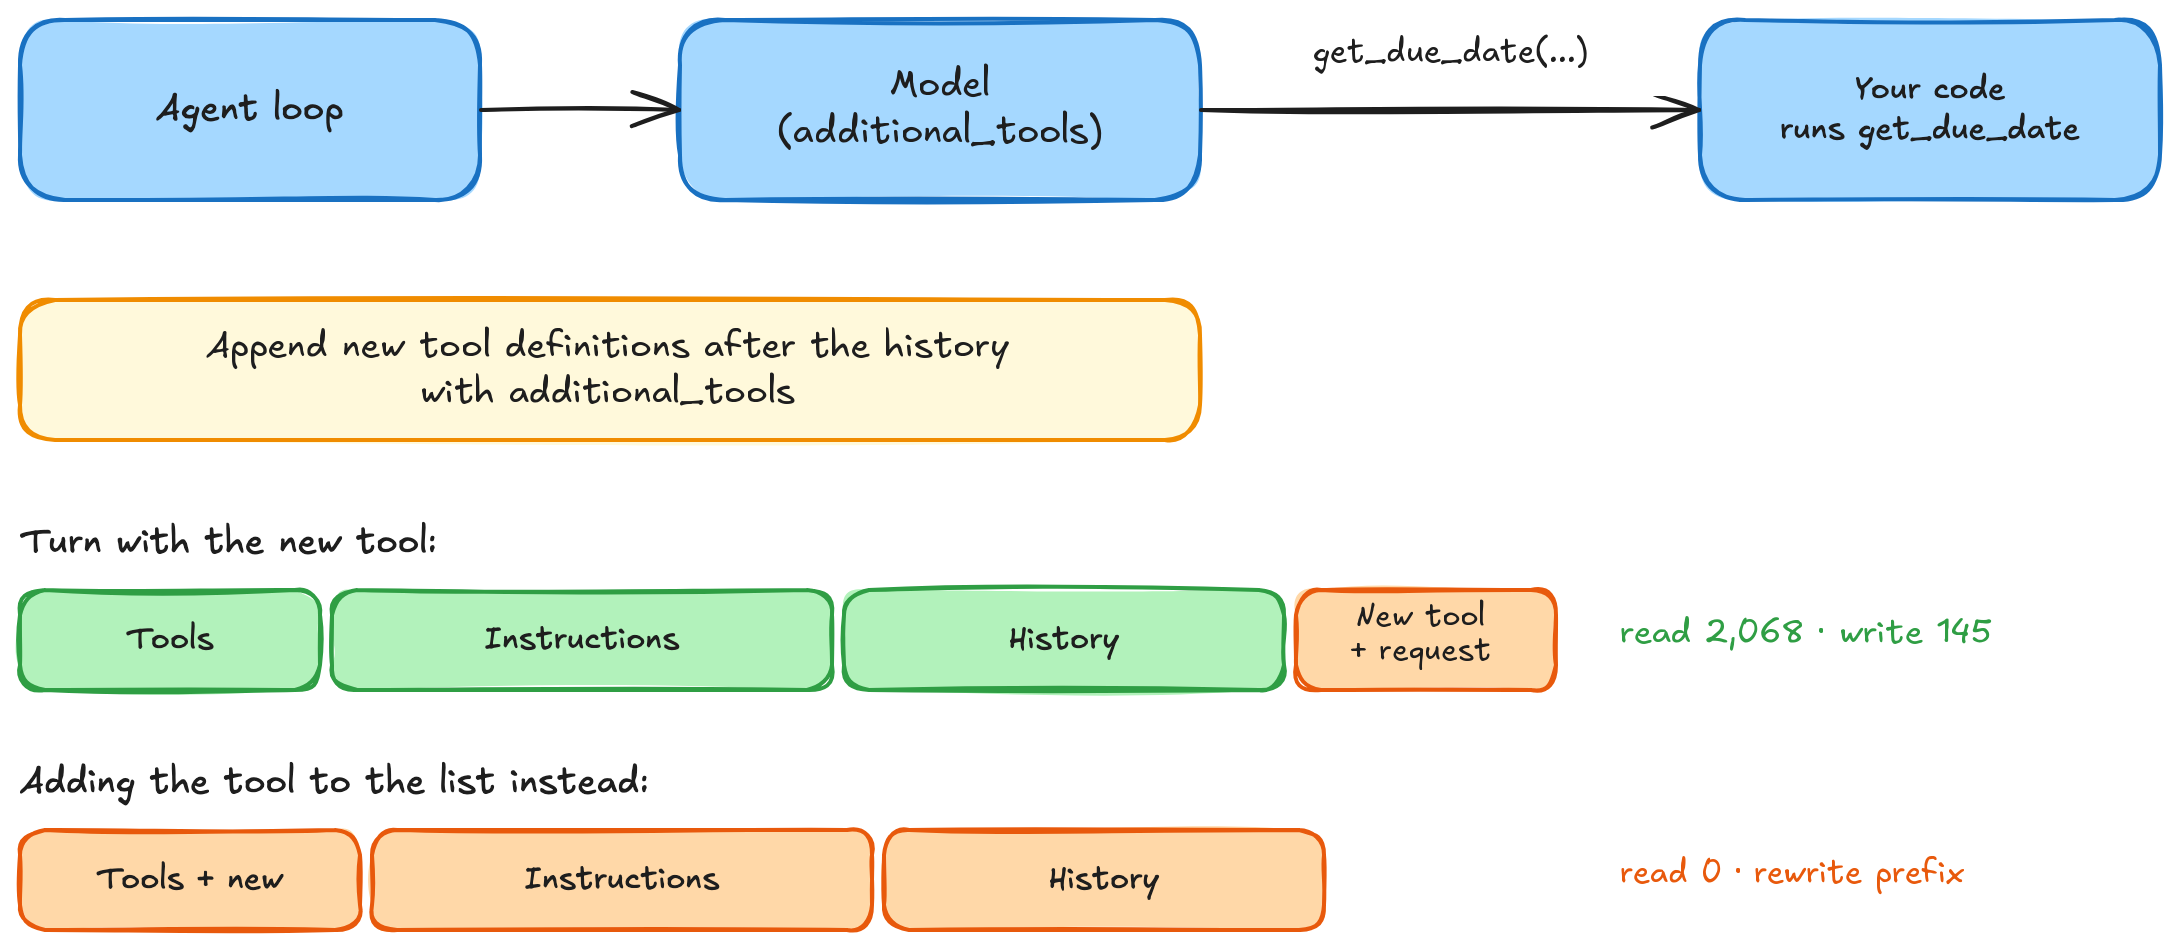
圖 5:附加工具可讓較早的前綴重複使用,並顯示 GPT-6 Astra 在 Amazon Bedrock Runtime 上的範例計數
使用新的回應繼續工具執行迴圈。迴圈會將模型輸出加入 history、執行任何已要求的工具,並附加其結果。在後續請求中保留 additional_tools 項目,讓新工具繼續可用。在隱式模式下,Amazon Bedrock 可以將快取延伸至新的用戶訊息,包括其前面的工具定義。在僅限明確模式下,保留較早的斷點,並在該用戶訊息中的 input_text 區塊加入一個斷點。additional_tools 項目本身不能設定斷點。
不同角色,不同目錄。 不同的 Agent 角色需要不同工具時,請在每個工作階段開始時選擇一個固定的工具設定檔,例如支援或帳單。每個設定檔都有自己的快取前綴。為共用指示設定標記,讓之後使用該設定檔的任務可以重用這些指示;然後隨着對話發展,選用任何一種模式。
快取的工具設定檔
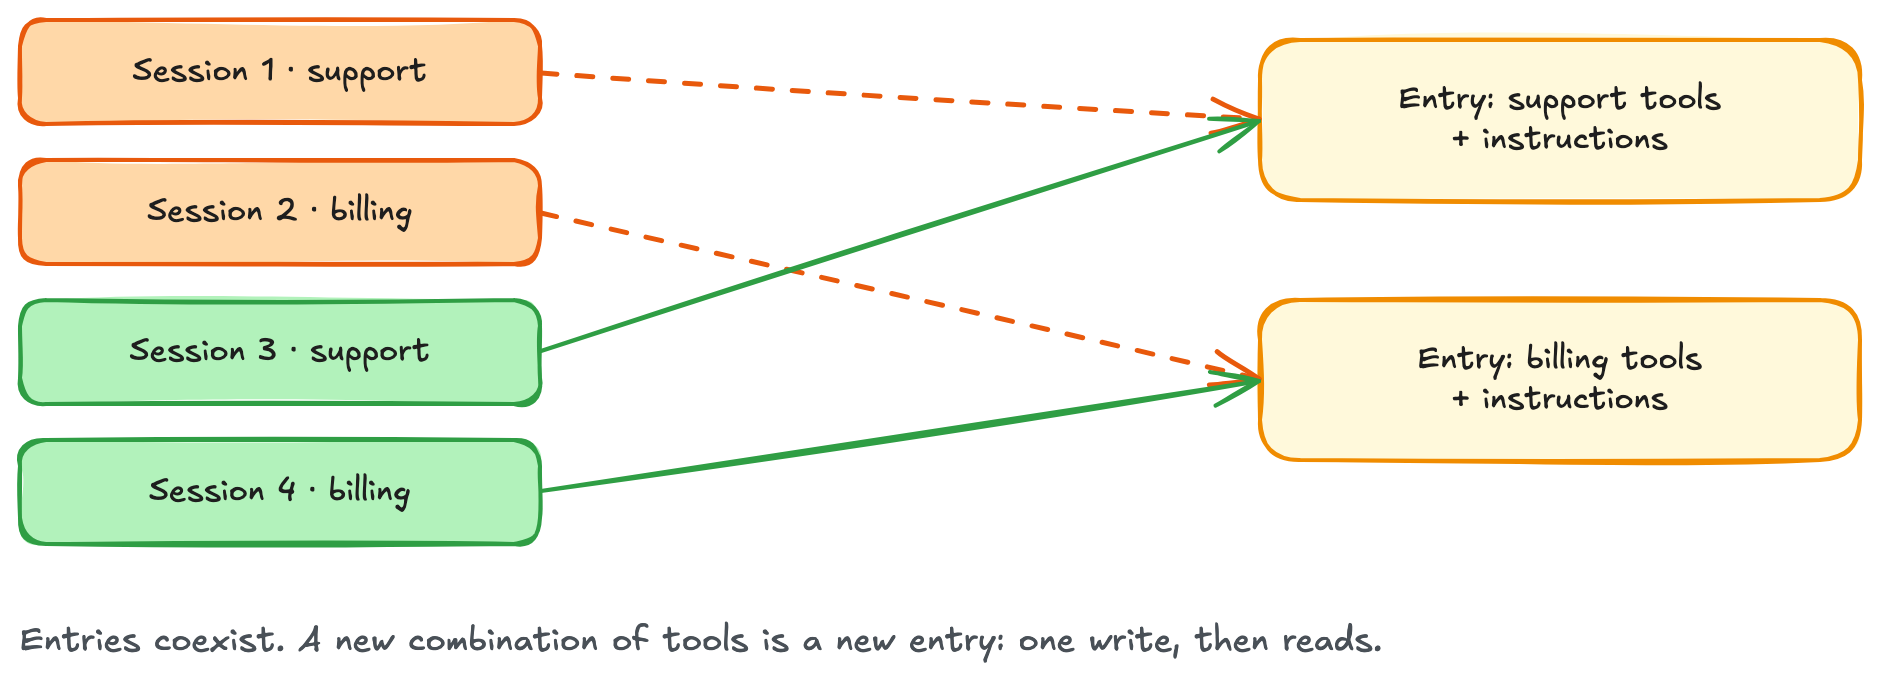
圖 6:每個工具設定檔都有自己的快取前綴,符合設定檔的工作階段可重複使用該前綴
子代理與側向呼叫
委派工作不應令每個助手都要重新讀取相同的背景資料。共用前綴,然後在末尾加入每個助手的任務。請注意,使用 AI Agent 快取時,工具和系統提示詞可能會外洩或遭人利用。請制定負責任的 AI 實踐,並將提示詞快取的實作納入相關管治措施。
預熱一次,再分派工作。 先發出一般請求,並等候完成後才啟動助手。即使使用隱式模式,也要在每個請求中明確標記共用內容:
shared = {"role": "developer", "content": [{
    "type": "input_text", "text": INSTRUCTIONS,
    "prompt_cache_breakpoint": {"mode": "explicit"},
}]}
warm = client.responses.create(
    model="us.openai.gpt-6-astra", store=False,
    tools=TOOLS, prompt_cache_key=KEY,
    prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    max_output_tokens=16,
    input=[shared, {"role": "user", "content": "Reply READY."}],
)
d = warm.usage.input_tokens_details
if not (d.cache_write_tokens or d.cached_tokens):
    raise RuntimeError("Shared prefix was not cached.")
from concurrent.futures import ThreadPoolExecutor

# helper_tasks contains the task text for each helper.
helper_inputs = [
    [shared, {"role": "user", "content": task}]
    for task in helper_tasks
]
with ThreadPoolExecutor(max_workers=4) as pool:
    helpers = list(pool.map(ask_with_implicit_cache, helper_inputs))
助手使用與預熱請求相同的 TOOLS、模型和 KEY。即使預熱請求因達到輸出上限而結束,仍可填充快取。用量檢查會在助手啟動前確認快取已運作。
子代理:先預熱共用前綴,再分派工作
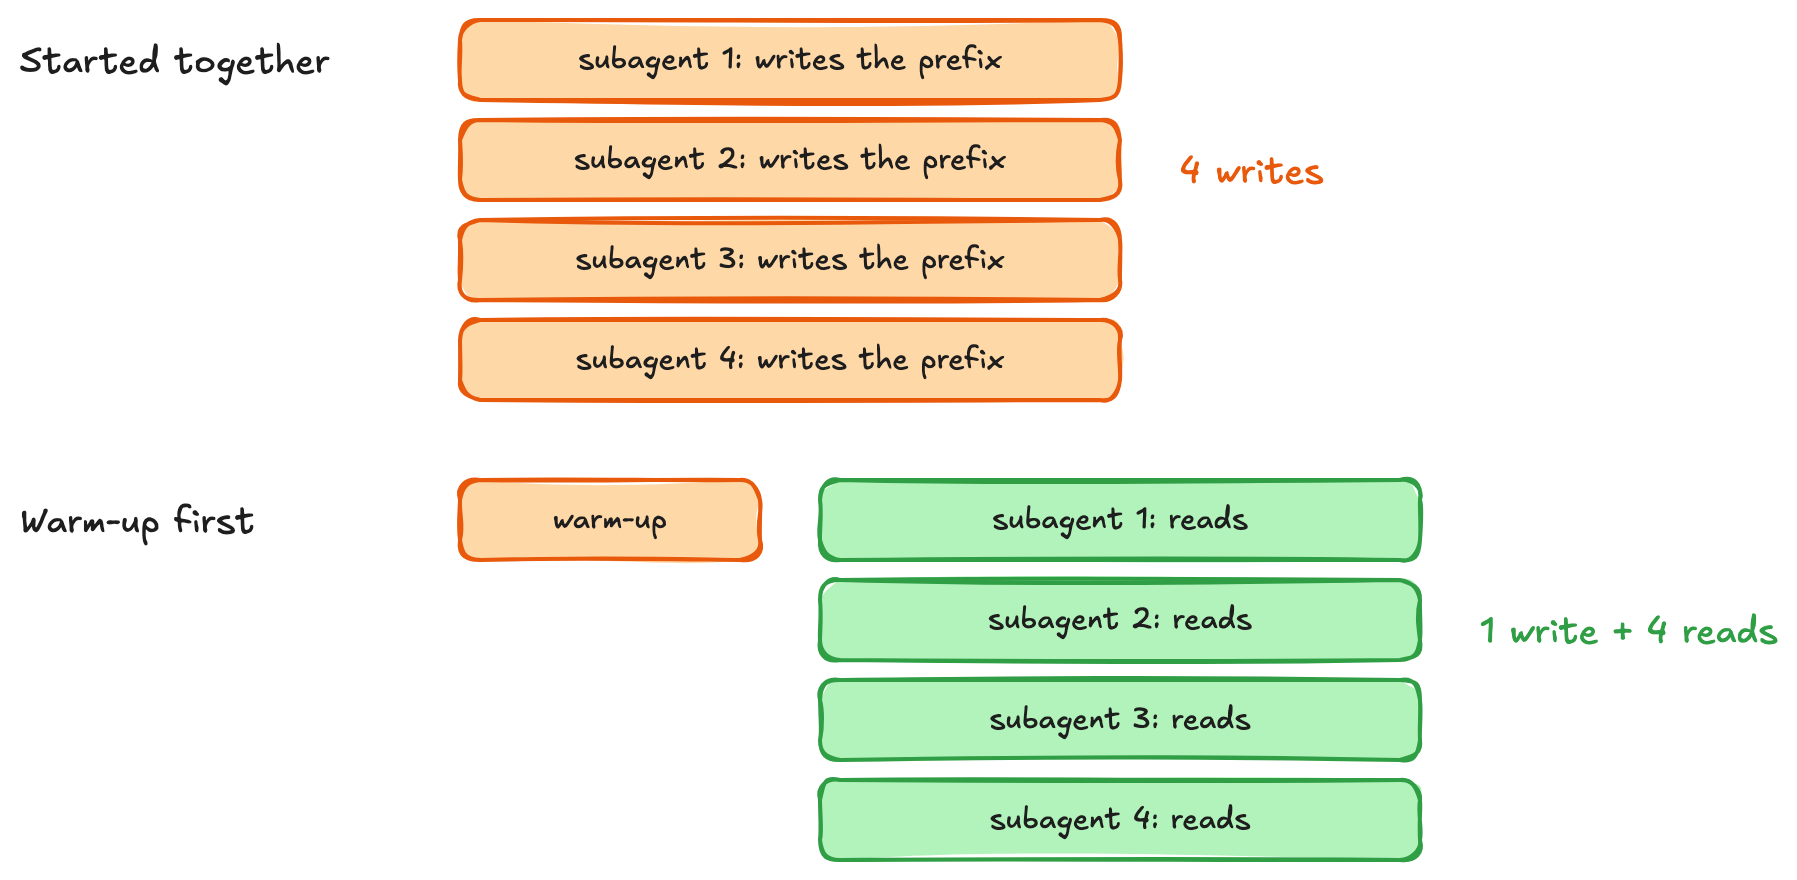
圖 7:先預熱共用前綴,再啟動助手;每個助手隨後會加入自己的任務
讓側向呼叫使用相同的開頭。 Agent 迴圈會將每個 resp.output 及其相應的工具結果(包括加密推理)附加起來,建立 history。父項工作完成後,複製完整清單,交給摘要器或評審器。同一個助手會沿用相同的工具、模型和金鑰:
from copy import deepcopy

# history is the completed history built by the agent loop above.
# Copy it so the helper can add instructions without changing the parent.
helper_history = deepcopy(history)
helper_history.append({
    "role": "developer",
    "content": "Summarize this conversation in one sentence. Do not call tools.",
})
summary = ask_with_implicit_cache(helper_history)
d = summary.usage.input_tokens_details
print("history read", d.cached_tokens, "write", d.cache_write_tokens)
print(summary.output_text)

# Example output (assumed values and conversation):
# history read 4096 write 32
# Case C-123 is due on October 31, 2026.
助手可以重用 history 中已快取的部分,但附加的開發者訊息不會自動延伸快取,將摘要指示也納入其中。如果後續請求會重用相同的歷史記錄和指示,請將該指示放在含有 prompt_cache_breakpoint 的 input_text 區塊中。只需生成一次的摘要則無需額外標記。
暫停、重新啟動與快取金鑰
暫停。 快取前綴的最短存留時間(TTL)為 30 分鐘;每次成功重用都會刷新存留時間,快取亦可能保留更久。如果工作階段很快便恢復,可以在快取過期前發出一般預熱請求,以刷新前綴。請比較該請求的成本與讓快取過期的成本。如需瞭解 TTL 規則,請參閲 Amazon Bedrock 文件。
新工作階段。 對於預期要共用前綴的請求,請保持 prompt_cache_key 穩定。即使提示詞相同,工作階段專屬金鑰也會將不同工作階段隔離。以下例子顯示,改用共用金鑰後,工作階段便可重用該前綴。
新工作階段只有使用相同金鑰,才會重用快取
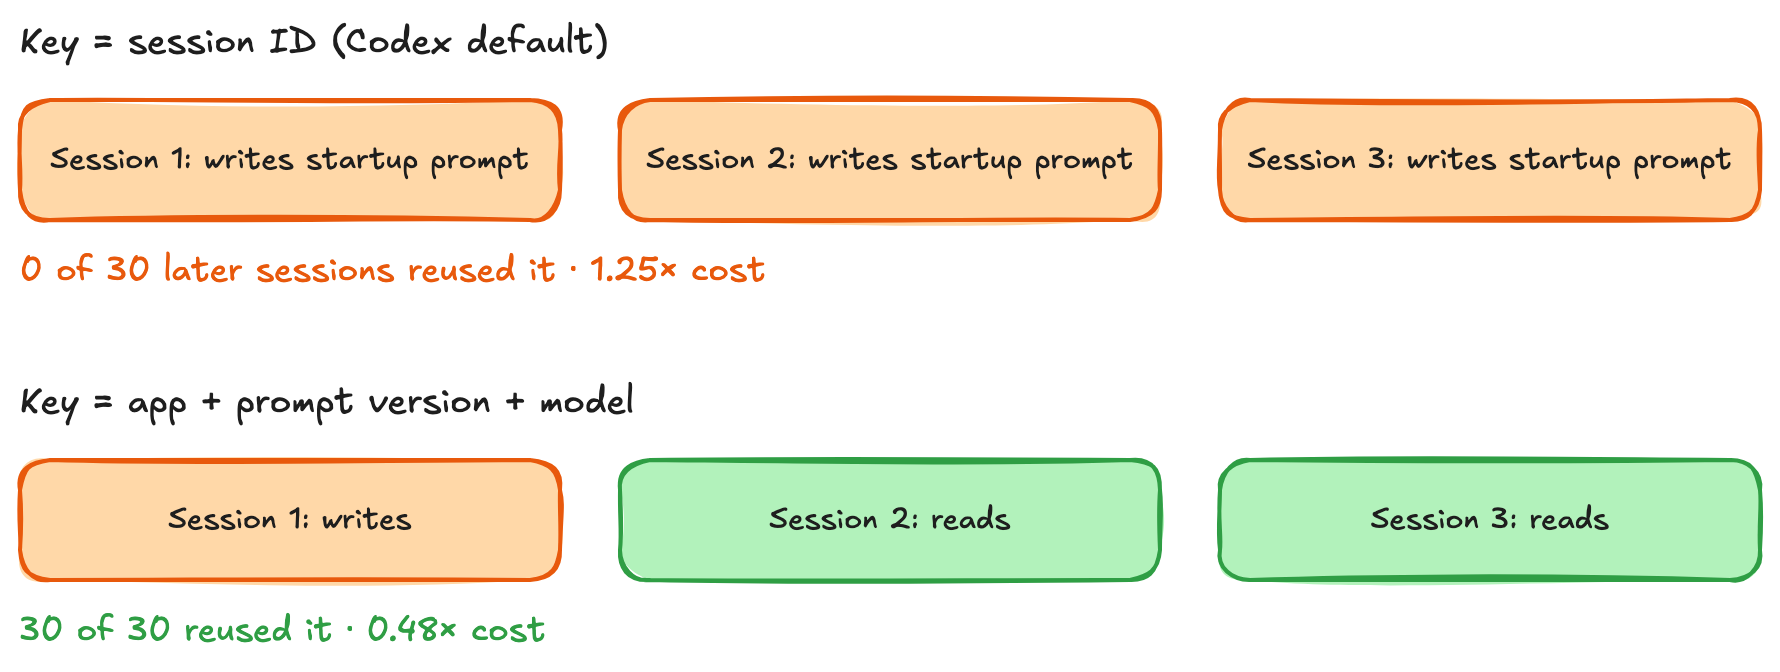
圖 8:工作階段專屬金鑰會分隔快取項目;共用金鑰則讓符合條件的工作階段重用這些項目
重用現有快取內容需要使用相同的模型、AWS 帳戶和區域,並且要有可用且相符的前綴。以下範例結合明確的啟動標記與隱式模式。每個工作階段都以相同的指示開始,並執行各自的任務。兩者使用相同的計算鍵:
import hashlib

def cache_key(app, model, prompt_version, instructions):
    digest = hashlib.sha256(instructions.encode()).hexdigest()[:12]
    return f"{app}:{prompt_version}:{model}:{digest}"

KEY = cache_key("support-agent", "us.openai.gpt-6-astra", "v7", INSTRUCTIONS)
prefix = {"role": "developer", "content": [{
    "type": "input_text", "text": INSTRUCTIONS,
    "prompt_cache_breakpoint": {"mode": "explicit"},
}]}
for label, question in [
    ("session A", "Explain the refund policy without calling tools."),
    ("session B", "Explain the escalation policy without calling tools."),
]:
    # A fresh conversation for each session; the startup prefix matches.
    session_history = [prefix, {"role": "user", "content": question}]
    result = ask_with_implicit_cache(session_history)
    d = result.usage.input_tokens_details
    print(label, "read", d.cached_tokens, "write", d.cache_write_tokens)
在冷啟動時,工作階段 1 會寫入共用前綴。即使工作階段 2 的任務不同,也可以讀取該前綴。每個任務也可以透過隱式方式快取。請查看用量計數器:鍵和標記相符即可重用內容,但仍須有可用的快取項目。
提示詞快取的效果
成本。以 GPT-6 Astra 驅動的代理程式為例,其啟動前綴有 8,000 個詞元,每輪再新增 2,000 個詞元,共六輪。一次性的靜態快取可將成本降至 $0.50;滾動式斷點則令預計輸入成本降低 64 percent:每個工作階段由 $0.87 降至 $0.32。
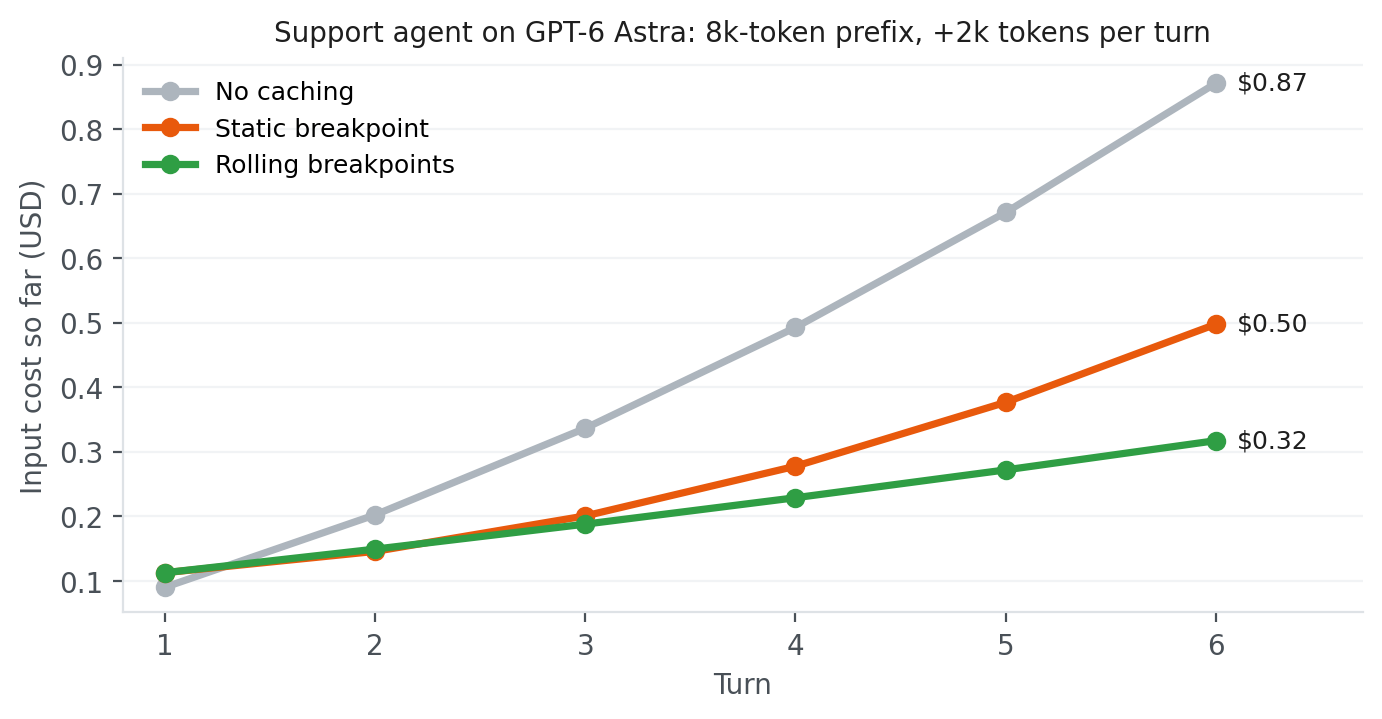
圖 9:支援代理程式範例中每個工作階段的累積輸入成本,採用 Amazon Bedrock 的 GPT-6 Astra 隨選價格
如何確認快取是否正常運作
先查看回應用量。cached_tokens會回報從快取讀取的輸入,cache_write_tokens則會回報寫入快取的輸入。對話內容增加時,請確認後續輪次會重用先前的對話紀錄,而新增的寫入內容則反映正在加入的資料。
如要在正式環境監察 Amazon Bedrock Runtime 端點,請使用 Amazon CloudWatch 中的CacheReadInputTokenCount和CacheWriteInputTokenCount指標。如需個別請求記錄,請啟用模型呼叫記錄,然後使用 Amazon CloudWatch Logs Insights 查詢記錄。至於 Amazon Bedrock Mantle 端點,請在應用程式記錄中記錄回應用量欄位。其 Amazon CloudWatch 命名空間目前沒有獨立的快取計數器。
如要檢查成本,請在 AWS Cost Explorer 篩選 Amazon Bedrock,並按 用量類型分組。每個模型的快取讀取、快取寫入和未快取輸入會分別列出。計算它們佔輸入成本的比例時,請排除輸出詞元項目。
簡短檢查清單
- 保持可重用前綴穩定。先放入共用工具和指示,再附加對話紀錄和新輪次。修改時間戳記、訊息或工具定義後,該處之後的內容便無法重用。較短的前綴如有自己的已儲存端點,仍可重用。
- 按照要重用的內容設定邊界。對不斷增加的對話紀錄使用隱式快取,對共用前綴使用明確標記,或兩者並用。僅明確模式可避免寫入不需保留的後綴。延續僅明確模式的對話時,請保留較早的標記,讓後續請求能找到已儲存的前綴。
- 保持初始工具目錄不變。使用
allowed_tools限制可呼叫的工具。使用additional_tools附加已知定義,或透過具命名空間的用戶端tool_search探索工具。不同代理程式角色需要不同目錄時,請選擇穩定的工具設定檔。 - 檢查前綴大小和有效期。可快取的前綴必須至少包含 1,024 個詞元。快取前綴在最近一次寫入或成功重用後,至少 30 分鐘內仍符合重用條件。
- 啟動輔助代理程式前,先預熱共用內容。在預熱請求和輔助代理程式請求中標記共用前綴,使用隱式模式時亦然。開始並行呼叫前,先完成預熱請求。
- 在每個共用羣組內保持快取鍵穩定。要重用前綴的請求必須使用相同的鍵。使用不同的鍵可分開計算不同客戶或用戶的快取用量。
- 衡量整個工作流程的節省效益。快取寫入的費用是一般輸入費率的 1.25 倍。讀取價格視乎模型而定。開發期間可利用回應中的用量資料,正式環境則可利用監察及帳單資料,同時追蹤寫入成本和讀取所節省的費用。
在2月3日醒來
Bill Murray 停止重複犯下相同錯誤,並開始把每天學到的事情帶到下一天,才終於擺脱《Groundhog Day》。Agent 以類似的方式做到這一點,只是沒那麼浪漫:讓提示詞開頭逐字節保持不變,並隨着歷史內容增加,使用自動或明確的快取邊界。
本文介紹瞭如何快取共用工具和指示、在多個 Agent 回合之間擴展快取,以及在新增工具、啟動輔助 Agent 或開啟新工作階段時保留快取重用效益。保持共用前綴穩定,並隨工作流程推進附加新資訊。對於不斷增長的對話,使用隱式快取;對於共用內容,則使用明確快取斷點。需要兩者時可結合使用;如果不太可能重用會變動的後綴,則選擇僅使用明確快取的模式。比較快取讀取、快取寫入、輸入總成本和延遲時間,找出最適合你的 Agent 的做法。如要應用這些模式,請參閲Amazon Bedrock 中 OpenAI 模型的提示詞快取説明文件,並查看各 AWS 區域及端點的模型供應情況。先從一個工作流程開始,並在對話增長時量度節省效益。
關於作者

Claudio Mazzoni
Claudio 是 Amazon Bedrock GTM 團隊的資深專業解決方案架構師。Claudio 擅長引導客戶踏上生成式 AI 之旅。工作以外,Claudio 喜歡與家人共度時光,也喜歡打理家中的花園。
來源:AWS Machine Learning Blog · aws.amazon.com