從原型到正式環境:以 Agent DLC 建構智能體
From prototype to production: Engineering agents with Agent DLC
AWS 文章提出 Agent Development Lifecycle(Agent DLC),以一套包含準則、門檻和核準示例的明確標準,串連定義、建置、評估、發佈、觀察及回饋六項活動,並形成內外兩個循環。
HR 政策助理案例中,區塊層級精確率為 1.00、事實層級僅 0.09,呈現單一檢索指標如何掩蓋知識覆蓋缺口。
過去一年,AI Agent 已由探索階段邁入工程實踐。企業團隊正推出大型語言模型(LLM)系統,這些系統會呼叫工具、協調 API,並根據內部知識回答問題。
成功的示範可以展示 Agent 的能力。但在推出前,團隊還需要回答另一個問題:「這個 Agent 是否已準備好投入生產環境?」負責作出決定的人,需要有證據證明 Agent 符合已商定的要求。
為了一致地作出決定,團隊需要一種可重複、負擔得起的方法,評估 Agent 目前的行為,以及最新變更有否令其表現改善。
在傳統軟件開發中,團隊會透過單元測試、持續整合與持續交付(CI/CD),以及通過的建置來回答這些問題。這些機制對 Agent 而言不可或缺,但並不足夠,原因有三個,而每個原因都需要額外檢查。本文會説明這三項特性,並展示一個經量化的案例,説明匯總指標如何掩蓋覆蓋率問題。接着,本文會介紹 Agent 開發生命週期(Agent DLC):一個生命週期、兩個循環,以及一套明確而單一的標準,用以判斷每項變更。
術語説明: 本文所説的黃金標準,是指一項特定的成果:一套可驗證的準則、各項準則的門檻,以及用作對照檢查的已核准範例。業務負責人會核准這套標準,作為驗收決策的依據。
1. Agent 的三項特性,以及所需的額外工程實踐
傳統軟件測試和 CI/CD 仍適用於 Agent,但有三項特性需要額外檢查。第一,Agent 具有非確定性:相同輸入可能產生不同輸出和執行路徑。第二,提示詞、工具説明、檢索設定或記憶設定的變更,可能以單靠審閲文字無法察覺的方式改變行為。第三,模型端點、知識庫和外部 API 可獨立於程式碼儲存庫而改變,並影響 Agent 的行為。表 1 概述了應對各項特性所需的工程實踐。
表 1. 各項特性會令哪些做法失效,以及應改用甚麼做法。
| 特性 | 傳統做法 | 不足之處 | Agent DLC 的要求 |
| 非確定性 | 在 CI 中為每個案例設一項斷言 | 只測量分佈中的單一樣本。測試可能因與變更無關的原因而通過或失敗 | 每個範例執行 k 次,並以通過率和失敗分佈作判斷 |
| 提示詞是原始碼 | 審閲差異,批准變更 | 無法單靠提示詞文字判斷其行為 | 每項提示詞、工具、檢索及記憶設定變更均須納入版本管理並附上評估,並保留其版本脈絡 |
| 依賴項會自行變動 | 固定版本,升級時驗證 | 由於儲存庫沒有任何變更,因此不會觸發 | 按時間表重新執行標準,並在偏離基準時發出警示 |
2. 量化案例:高檢索精確率可能掩蓋資訊缺漏
以下案例展示指標的選擇如何影響問題診斷。
我們建立了一個參考實作,以端對端方式測試這套方法:一個內部政策助理,透過文件知識庫回答人力資源政策問題。我們選擇了一個範圍明確、涵蓋面較窄的領域,讓評估和問題診斷過程更容易理解。以下結果是在這個參考實作上測得的,並非客戶成果,也不是基準測試結果。
隨附的 AWS Samples 儲存庫包含基礎設施部署、人力資源助理、自訂評估器,以及用於基準評估和提示詞變更後重新評估的指令碼(09-run-eval.sh 和 10-optimize-prompt.sh)。此外,亦包含可選的評審結果可重複性、模型比較、成本及延遲檢查。這些指令碼可重現整個工作流程。評分可能因執行次數和儲存庫版本而異。
三條標準問題,每條採用五項指標:
- 來源依據度:將回答拆解為各項主張,並逐一對照檢索到的來源進行核查。
- 區塊層級來源精確率:每個檢索到的內容區塊,整體而言,對回答這個問題是否必要?
- 事實層級來源精確率:將每個內容區塊拆解為個別事實,並核查每項事實是否必要。
- 檢索涵蓋率:對於每個子問題,檢索到的內容區塊中是否有任何一個能回答該問題?
- 回答精確率:回答中的各項主張,有多少是必要的?
表 2. 第一輪評估。於參考實作上測得,並非客戶成果。
| 問題 | 來源依據度 | 區塊層級精確率 | 事實層級精確率 | 檢索涵蓋率 | 判定 |
| 績效評核 | 0.83 | 1.00 | 0.59 | 1.00 | 通過 |
| 福利登記 | 0.90 | 1.00 | 0.53 | 1.00 | 通過 |
| 病假證明 | 0.39 | 1.00 | 0.09 | 0.00 | 不通過 |
三條問題的區塊層級精確率均為 1.00。若發佈門檻只根據這項指標,三個回答都會獲接納。
事實層級精確率則呈現另一番情況:0.59、0.53、0.09。對於第三條問題,檢索到的資料中約有十分之九的事實與問題無關。區塊層級精確率只判斷一段內容是否切合主題,並不衡量其中有多少內容切合問題。
接著,我們只改動了一項內容:系統提示詞。我們加入三項限制:回答嚴格以檢索到的內容為依據、忽略檢索到的無關內容,以及讓回答聚焦。助理、知識庫、評估器和問題均維持不變,因此前後結果只有一個變數不同。
表 3. 只改動提示詞後的結果。一次改動,兩種相反結果。
| 績效評核,改動前 | 績效評核,改動後 | 病假,改動前 | 病假,改動後 | |
| 來源依據度 | 0.83 | 0.87 | 0.39(不通過) | 0.31(仍不通過) |
| 事實層級精確率 | 0.59 | 0.85 | 0.09 | 0.04 |
| 回答精確率 | 0.58 | 0.73 | 0.33 | — |
第一條問題大幅改善,第三條則變得更差。
在作出改動前,評估結果已指出值得調查的方向。再看一次表 2 的第三列:區塊層級精確率為 1.00,事實層級精確率為 0.09,檢索涵蓋率為 0.00。這些分數合在一起,顯示問題可能出在知識涵蓋不足:檢索到的資料表面上與主題相關,卻沒有回答問題。要求模型「嚴格以檢索到的內容為依據」,無法補上缺失的資訊。
我們核對了這項診斷與實驗所用的來源文件。語料庫沒有專門的病假政策文件,不過休假管理政策曾簡短提及病假。下一步是補足政策涵蓋範圍,然後檢查檢索,而不是繼續修改提示詞。
在這個個案中,來源資料缺少回答問題所需的資訊,因此單靠修改提示詞無法解決這項問題。
在這個例子中,評估有助找出進一步修改前需要調查的事項。
另一項結果説明,除了其他準則外,亦需要檢查根據性。福利登記的答案通過了評估,根據性為 0.90,並包含以下句子:「我亦留意到,根據你的個人檔案,你偏好的聯絡方式是社交媒體。」然而,根本不存在這樣的個人檔案。
政策文件在某個流程步驟中,將聯絡偏好列為一個選項。公開、由羣眾提供且內容雜亂的 FAQ 語料庫中,有一組問答以「社交媒體」回答了這個問題。模型把政策中的選項與一個無關的 FAQ 答案結合起來,並將其當作關於用戶的事實來呈現。偏高的根據性評分未能發現這項虛假的個人資料聲稱。通過品質門檻,並不代表已符合責任方面的限制。
這些評分在不同執行次數之間可能有所變動,接近門檻的「通過」也可能變成「不通過」。解讀評分差異時,應同時考慮重複執行的結果及底層證據。第 5 節會討論如何檢查評估器的可靠性。
這個小型參考實作範例説明評估如何引導問題診斷,但無法證明普遍的改善幅度,也不能驗證正式環境版本的發佈。
3. Agent DLC:一個生命週期,兩個迴圈
Agent DLC 以一項明確的黃金標準連結六項活動:定義、建置、評估、發佈、觀察及回饋。
過往研究曾探討以評估為主導的開發,包括 Xia 等人的Evaluation-Driven Development of LLM Agents: A Process Model and Reference Architecture。Agent DLC 透過六項活動,將這種方法應用於交付;每項活動均設有明確的驗收條件、發佈權限及證據要求。
以驗收條件為先的方法亦見於Fotor 已發佈的 AWS 客戶案例研究。團隊在遷移至 AgentCore runtime(Amazon Bedrock AgentCore 的一項功能)之前,先訂立可擴展性、成本、隔離及架構靈活性準則,然後根據營運數據驗證改動。案例指出,工作流程開銷由數分鐘降至數秒(不包括模型推理),並支援數以千計的並行活躍工作階段。該案例記錄了在 Agent DLC 指導下交付架構的過程,並指出品質評估是下一步。
定義會把業務目標轉化為準則、門檻及已核准的範例。建置會設計提示詞、工具、上下文、記憶及執行環境機制,確保符合這些要求。評估會產生證據,判斷候選版本是否符合要求。符合要求後,版本便會進入受控發佈流程。觀察會監察版本在正式環境中的運作。回饋則會把正式環境帶來的經驗交回定義階段。
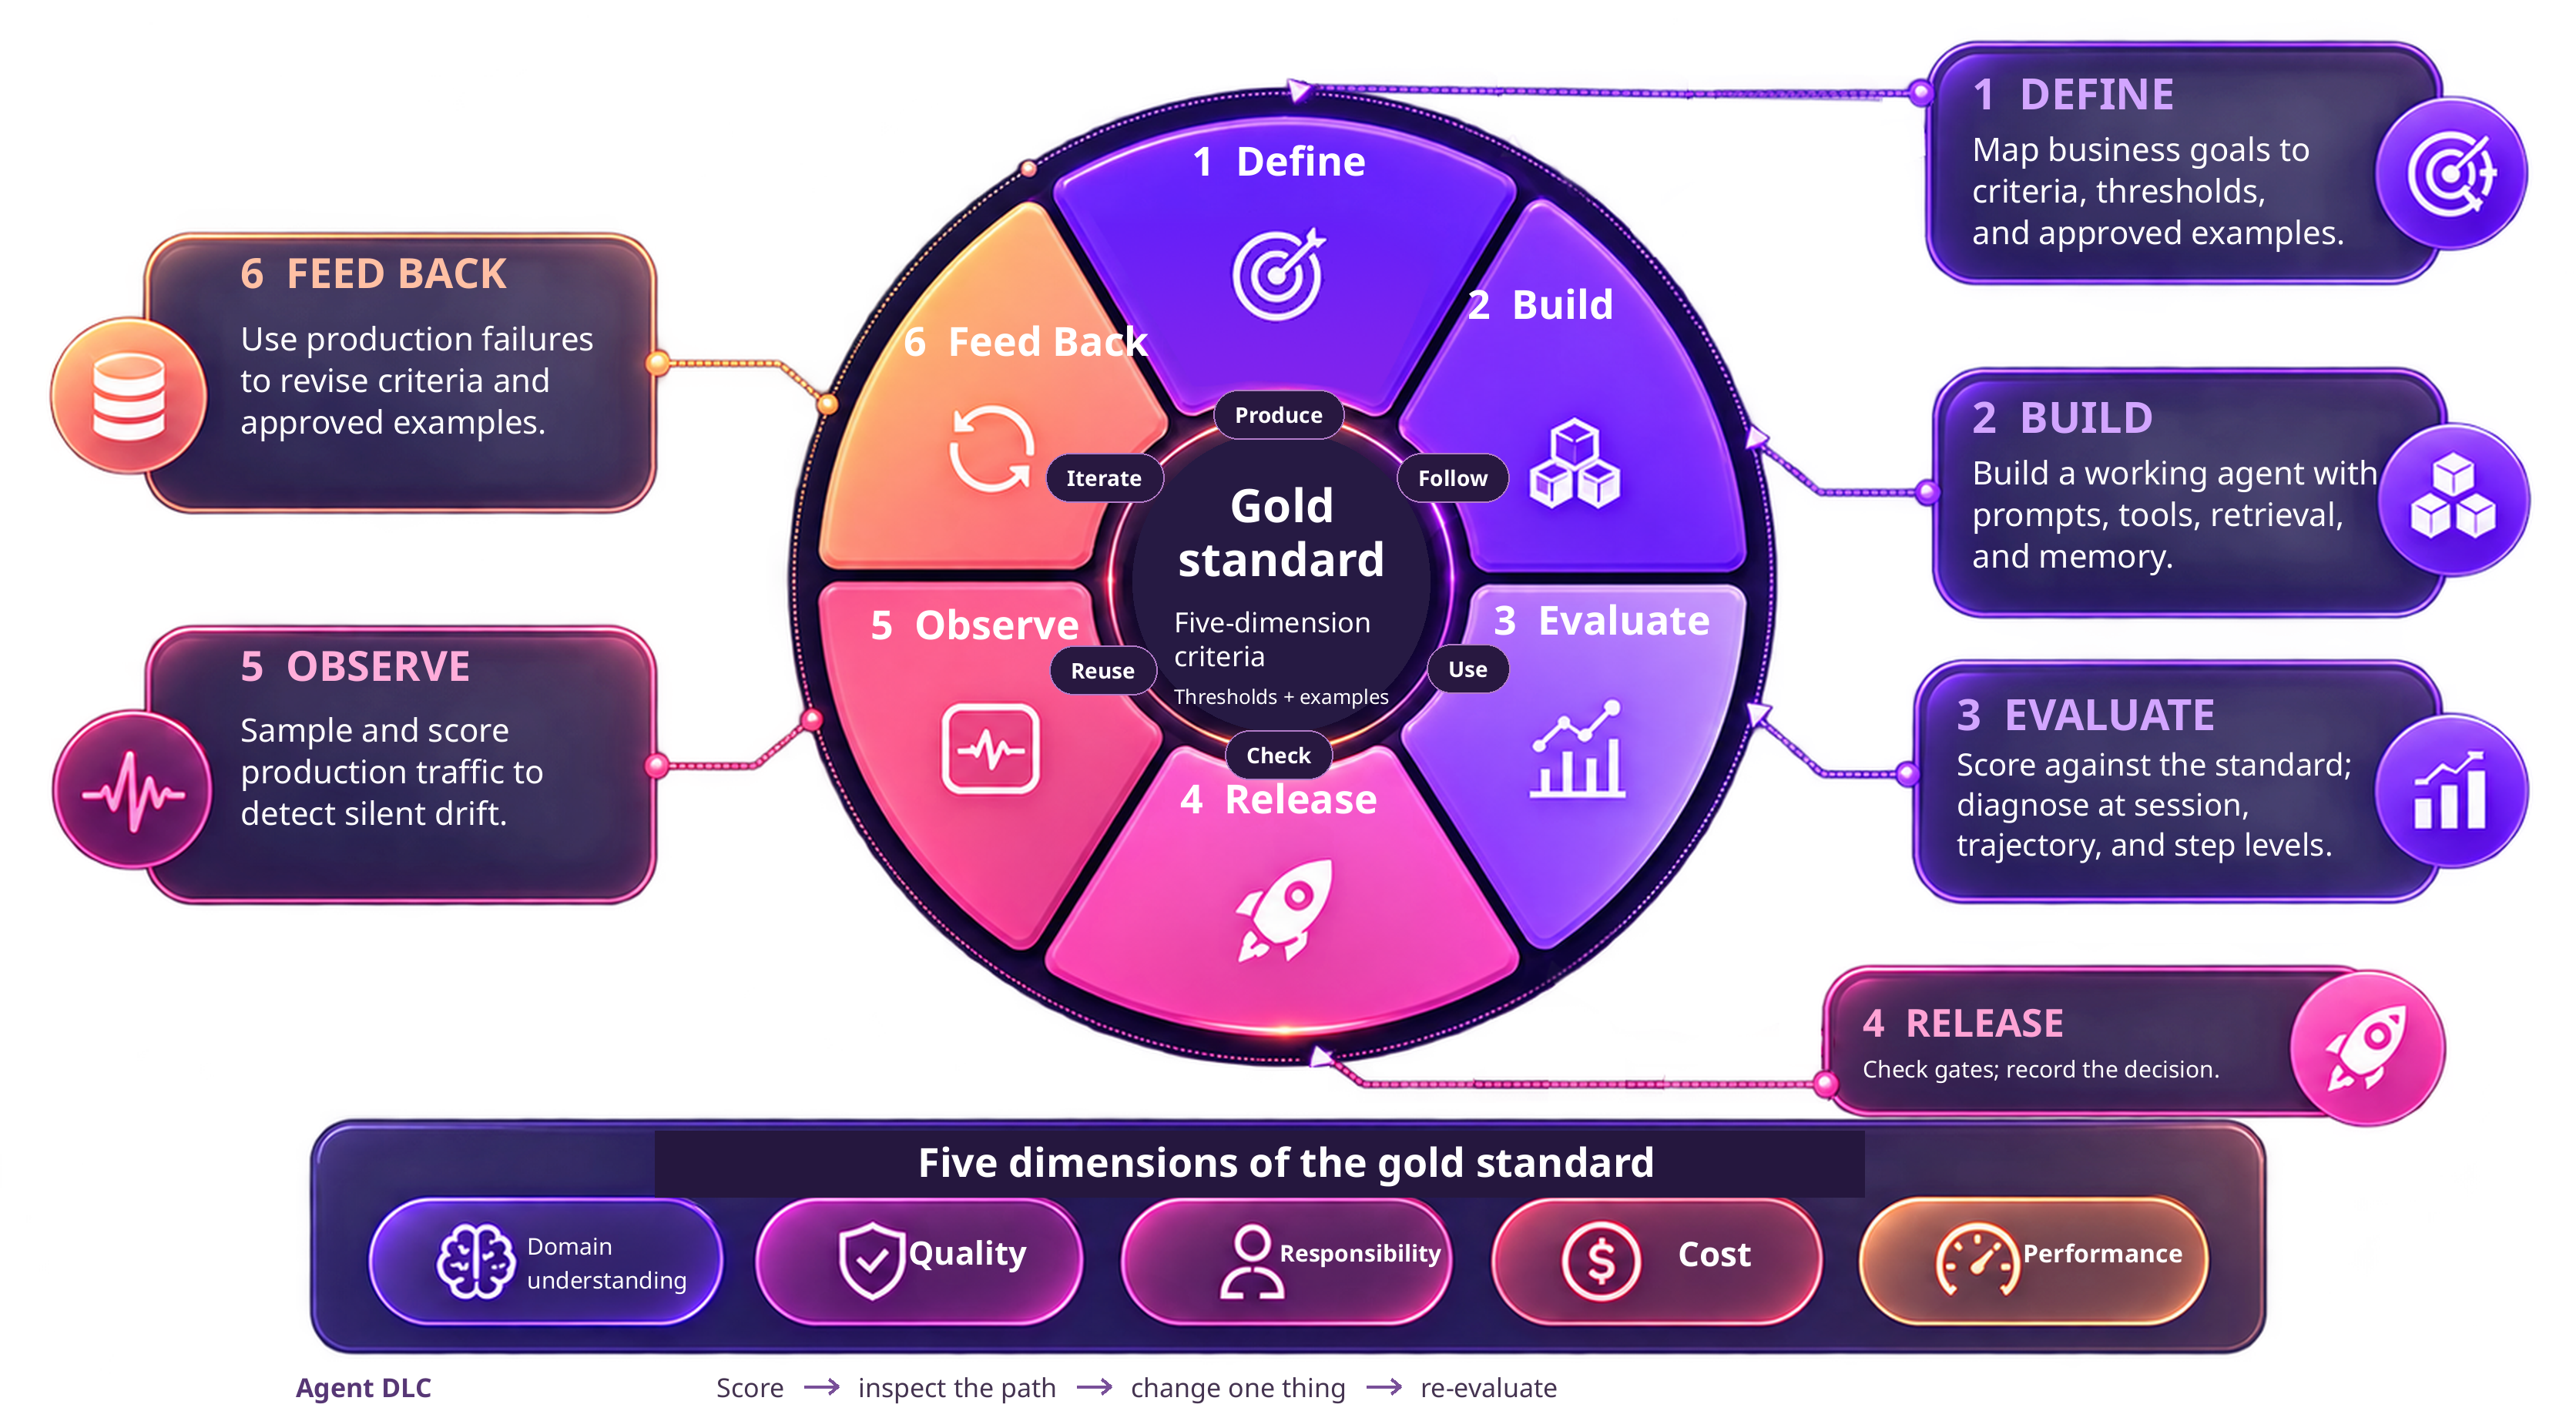
圖 1:Agent DLC 的六項活動均與中央的黃金標準相關。「界定」會產生標準,「建構」依循標準,而「評估」會使用標準。「發佈」會對照標準進行檢查,「觀察」會重用標準,而「回饋」則會反覆更新標準。標準的五個維度列於下方
圖 1 展示各項活動如何使用或更新標準,清楚説明標準在開發及發佈過程中的作用。
在這個外層循環中,還有一個速度更快的內層循環:評分 → 檢視路徑 → 修改一項內容 → 重新評估。內層循環針對單一候選版本運作,並回答兩個問題:應在哪裏作出修改,以及修改是否有幫助。
兩個循環各有不同作用,這個分別很重要。內層循環根據固定標準改善 Agent。外層循環則讓標準有所變動。若在開發期間發現 Agent 會在未查核庫存的情況下推薦產品,這便是內層循環的問題。假設正式環境的用戶要求 Agent 代家庭成員查找資料,但現有準則並未涵蓋這種情況。這就需要外層循環:界定授權界線,並加入相關例子。然後利用內層循環,達到更新後的標準。
混淆兩者可能令團隊試圖透過修改提示詞,來補救缺少準則的問題。團隊亦可能在改進週期中擴大標準,結果無法判斷是哪項改動令評分有所變化。
兩個循環都會建立可重用的資產:業務準則、已核准的例子、評估器,以及過往如何處理失敗的記錄。這些資產的生命週期比模型和框架更長。更換模型時,應根據相同的準則和例子評估替代模型。
接下來四節會説明如何界定良好的標準,令其可供檢查(第 4 節),以及如何根據該標準改善 Agent(第 5 節)。然後會探討如何透過正式環境的回饋更新標準(第 6 節),以及如何設計架構以提供評估證據(第 7 節)。
4. 界定良好:五個維度、三個層級
首先由負責人界定業務成果。以推薦 Agent 為例,目標可以是:「向回頭客推薦合適的產品,同時保護他們的個人資料。」將這項要求轉化為涵蓋五個維度、可供驗證的準則。
表 4. 界定準則時,應考慮全部五個維度。
| 維度 | 關鍵問題 | 關注範疇 |
| 領域理解 | 它是否真正理解你的業務? | 術語、別名、多跳關係、企業內部知識 |
| 質素 | 它是否始終準確、完整且一致? | 準確性、完整性、一致性、引用來源支援 |
| 責任 | 是否已處理權限、界線、合規要求及可審核性? | 未經授權的存取、資訊披露、合規硬性限制、可追溯性 |
| 成本 | 每次執行的成本是多少?大規模使用時能否維持成本效益? | Token 消耗量、評估器成本、冗餘步驟 |
| 效能 | 它是否快速、穩定,並能承受工作負載? | 延遲、吞吐量、穩定性、可用性 |
每項準則都應訂明驗證方法及核准人。「必須準確」是一個目標;「每項事實陳述都必須可追溯至檢索到的來源」則是可驗證的。業務專家應核准能具體説明預期行為的例子。
表 5. 準則分為三個層級。決定某項準則會否阻止發佈的,是其層級,而非所屬維度。
| 層級 | 是否阻止發佈? | 表達方式 | 例子 |
| 硬性限制 | 是 | 布林值,每次執行均評估 | 洩露另一位客戶的資訊 |
| 發佈門檻 | 未達標之前 | k 次執行的通過率門檻 | 至少 95% 的引用條款可追溯至來源 |
| 僅供監察 | 否 | 持續追蹤及檢視,日後再提升層級 | 語氣是否恰當,直至其評估器完成校準 |
為每項準則各自指定等級,並在適用情況下設定門檻。絕不可讓其他方面的高分抵銷硬性限制違規。
在推薦例子中,推薦品質是品質層面的發佈門檻,而保護另一位客戶的資訊則是責任層面的硬性限制。同一項業務要求會在不同維度及等級中產生準則。每項準則都要按照各自的驗收條件評估。
這些準則亦會決定系統必須提供哪些證據。下一節會利用這些證據改善 Agent,並決定是否發佈。第 7 節説明證據要求如何影響架構。
5. 內部循環:評估、診斷及改善
評分。按準則選用合適的評估器。對於明確無歧義的規則,使用程式碼;對於成本及延遲,使用執行階段遙測資料;對於容量及可用性,使用負載測試及運作數據。對於需要判斷的準則,使用基於模型的評審,並以經人工審核的例子進行校準。評估資訊保護時,除檢查禁止欄位外,亦要進行授權及跨用戶隔離測試。每個例子執行 k 次,以評估行為的變異性。
對於基於模型的評審,重複進行評估以量度評分變異,並將評審結果與經人工審核的例子作比較。細微的分數提升必須有佐證,方可視為改善。
檢視流程。在三個層面定位故障:工作階段、執行軌跡及步驟。若推薦內容洩露電話號碼,便沿受影響的工作階段追查至回應組合階段,並檢查個人資料欄位在哪個環節進入草稿。根源可能位於可見症狀的上游,正如第 2 節所示。
一次只改動一項,然後重新評估。修正已識別的原因,並在相同條件下按照不變的標準重複評估。確認資訊披露已停止,而推薦品質仍達到其發佈門檻。
按每種任務類型(或意圖)分別評估是否適合發佈。只發佈符合準則的意圖;任何未發佈意圖的後備方案亦須符合已協定的發佈條件。
表 6. 按維度、等級及意圖作出的發佈決策。
| 矩陣狀態 | 決策 |
| 任何硬性限制未通過 | 不予發佈。 |
| 所有硬性限制均通過,但一個或多個發佈門檻未達標 | 除非事先已批准有限推出,並訂明明確的保障措施及停止準則,否則不要發佈受影響的意圖。否則,轉交人工處理。 |
| 所有硬性限制均通過,而且所有發佈門檻均達標 | 全面發佈。 |
有限推出所需的驗收條件、保障措施及停止準則,必須在評估前協定。有限推出不能凌駕硬性限制,也不能在結果未通過後降低門檻。
發佈前,將被阻擋及被拒絕的請求納入評估,檢查每項請求是否按預期處理。記錄準則、門檻、評估器版本及發佈決策,讓團隊可追溯某個版本獲批准的原因。
通過這些檢查,表示具備在已測試範圍內發佈的依據。正式環境監察會在此後檢查 Agent 是否繼續符合標準,並留意用量和相依項目的變化。
6. 外循環:保持數據流動
從首次測試請求開始記錄執行追蹤記錄,以便在開發和正式環境中診斷故障。抽樣評估正式環境中的互動,找出故障,再與業務負責人檢視,確認預期行為。將現有準則涵蓋的案例加入回歸測試集。如果案例揭示缺少某項要求,便更新標準,並使用內循環使其符合標準。
定期執行評估,以捕捉外部相依項目引起的行為變化。標準變更時,按新舊兩個版本比較結果,以分辨 Agent 回歸問題與測試範圍擴大的影響。將每項結果連結至其標準、測試集、評估器和 Agent 版本。
7. 設計支援評估的架構
評估和回饋循環需要架構提供證據。從每項準則反向推導,找出驗證該準則所需的系統行為和記錄。
例如,要分辨工具選擇錯誤與執行失敗,應定義工具的用途、接受的輸入、輸出和錯誤情況。在追蹤記錄中呈現實際輸入、結果和錯誤,讓評估人員找出故障位置。
因此,驗收準則會同時影響評估和架構。打好這些基礎後,先從一項業務任務着手,建立基準。
8. 在 AWS 上開始
選擇一項範圍明確的業務任務,並以一週內建立初步評估基準為目標。
- 第 1–2 天。由業務負責人和工程師共同商定驗收準則、等級和門檻。準備 20–30 個黃金範例,涵蓋常見請求和重要邊界情況,並由業務負責人核准預期行為。
- 第 3–5 天。實作第 5 節所述的評估器,並重複執行黃金範例集。發布基準,當中包括故障,以及調查所需的證據。
- 第 2 週。只改動一項內容,並在相同條件下重新評估。記錄發佈決定及其支持證據。
檢視基準後,將評估納入發佈流程,並定期執行以偵測偏差。指派負責人檢視正式環境中的故障,並將確認的案例納入標準。
在 AWS 上,使用 Amazon Bedrock 提供的模型建構 Agent。Amazon Bedrock AgentCore Evaluations 是 Amazon Bedrock AgentCore 的一項功能,可使用內置評估器評估 Agent 行為,亦支援用於業務專屬準則的自訂評估器。AgentCore Observability 是 Amazon Bedrock AgentCore 的一項功能,可提供執行過程的可視性,並由 Amazon CloudWatch 補充執行階段監察和診斷功能。AgentCore runtime、Gateway、Identity 和 Memory 支援執行、工具整合、身分管理和記憶管理。
作者簡介

Yuan Wei
Yuan 是 AWS GCR Service Specialist Org 的應用科學家,在演算法開發方面擁有多年經驗。Yuan 在大型語言模型 (LLMs)、多模態模型、時間序列預測和 AI 生成內容 (AIGC) 方面,擁有豐富的解決方案開發和部署實務經驗。

Tianqin Cai
Tianqin 是 AWS GCR Service Specialist Org 的應用科學家,研究範疇包括生成式 AI、自然語言處理及多模態預訓練。他在演算法開發及實際應用方面經驗豐富,涵蓋廣告和推薦系統、搜尋排名、基礎模型預訓練及多模態 AI。

Jiade Wu
Jiade 是 Amazon Web Services (AWS) 的解決方案架構經理,負責帶領大中華區的 Partner Solutions Architecture 團隊。他的工作重點是推動 AI Agent 從原型走向正式環境,包括以評估為導向的開發,以及 Agent 生命週期方法。他亦有參與開源項目,在 aws-samples 上開發 Agent 基礎架構及 AWS 無伺服器架構相關項目。
來源:AWS Machine Learning Blog · aws.amazon.com