甚麼令對話智能體有用?
What Makes a Dialog Agent Useful?
Hugging Face Blog 梳理對話智能體的訓練方法,涵蓋 IFT、SFT、RLHF 和 CoT。文中指出,IFT 所需指令數據僅為數百例量級,SFT 以人工標註改善有用性和安全性,RLHF 則根據人類偏好訓練獎勵模型,再用強化學習訓練對話智能體。
文章把 IFT、SFT、RLHF 與 CoT 放在對話智能體訓練脈絡中梳理,並比較多個系統的訓練資料和評估方向,呈現各方法的分工。
ChatGPT 背後的技術:RLHF、IFT、CoT、紅隊測試等
本文已翻譯成中文 簡體中文。
幾星期前,ChatGPT 橫空出世,令公眾開始討論一連串陌生縮寫:RLHF、SFT、IFT、CoT 等,這些都被視為 ChatGPT 成功的關鍵。這些縮寫代表甚麼?為何如此重要?我們檢視了所有相關重要論文,將這些研究分類、總結已有成果的重點,並分享仍有待證明的問題。
先看看以語言模型為基礎的對話智能體概況。ChatGPT 並非第一個此類模型;早於 OpenAI,許多機構已發布語言模型對話智能體,包括 Meta 的 BlenderBot、Google 的 LaMDA、DeepMind 的 Sparrow,以及 Anthropic 的 Assistant(這個智能體在沒有明確歸屬説明下持續發展,亦稱為 Claude)。有些團隊也宣佈計劃建立開源聊天機械人,並公開發展路線圖(LAION 的 Open Assistant);其他團隊或許也在進行,但尚未公佈。
下表根據公開存取方式、訓練資料、模型架構和評估方向,比較這些 AI 聊天機械人。ChatGPT 的相關資料未有文獻記載,因此我們改為分享 InstructGPT 的資料;這是 OpenAI 的指示微調模型,據信曾作為 ChatGPT 的基礎。
| LaMDA | BlenderBot 3 | Sparrow | ChatGPT/ InstructGPT | Assistant | |
|---|---|---|---|---|---|
| 機構 | Meta | DeepMind | OpenAI | Anthropic | |
| 存取方式 | 封閉 | 開放 | 封閉 | 有限 | 封閉 |
| 規模 | 137B | 175B | 70B | 175B | 52B |
| 預訓練 基礎模型 |
未知 | OPT | Chinchilla | GPT-3.5 | 未知 |
| 預訓練語料規模(Token 數量) | 2.81T | 180B | 1.4T | 未知 | 400B |
| 模型能否 存取網絡 |
✔ | ✔ | ✔ | ✖️ | ✖️ |
| 監督式 微調 |
✔ | ✔ | ✔ | ✔ | ✔ |
| 微調 資料量 |
品質:6.4K 安全:8K 依據性:4K IR:49K |
20 個 NLP 資料集,規模介乎 18K 至 1.2M | 未知 | 12.7K(指 InstructGPT;ChatGPT 很可能使用更多資料) | 150K + 語言模型生成資料 |
| RLHF | ✖️ | ✖️ | ✔ | ✔ | ✔ |
| 手寫安全規則 | ✔ | ✖️ | ✔ | ✖️ | ✔ |
| 評估準則 | 1. 品質(合理性、具體性、有趣程度) 2. 安全(包括偏見) 3. 依據性 |
1, 品質(吸引力、知識運用) 2. 安全(毒性、偏見) |
1. 對齊(有幫助、無害、正確) 2. 證據(來自網絡) 3. 違反規則 4. 偏見與刻板印象 5. 可信度 |
1. 對齊(有幫助、無害、真實) 2. 偏見 |
1. 對齊(有幫助、無害、誠實) 2. 偏見 |
| 用於資料標註的眾包平台 | 美國本土供應商 | Amazon MTurk | 未知 | Upwork 和 Scale AI | Surge AI、Amazon MTurk 和 Upwork |
我們觀察到,雖然訓練資料、模型和微調方式各有不同,但也存在一些共通點。上述聊天機械人的共同目標之一是遵循指示,即按照用戶指定的要求行事。例如,指示 ChatGPT 寫一首關於微調的詩。
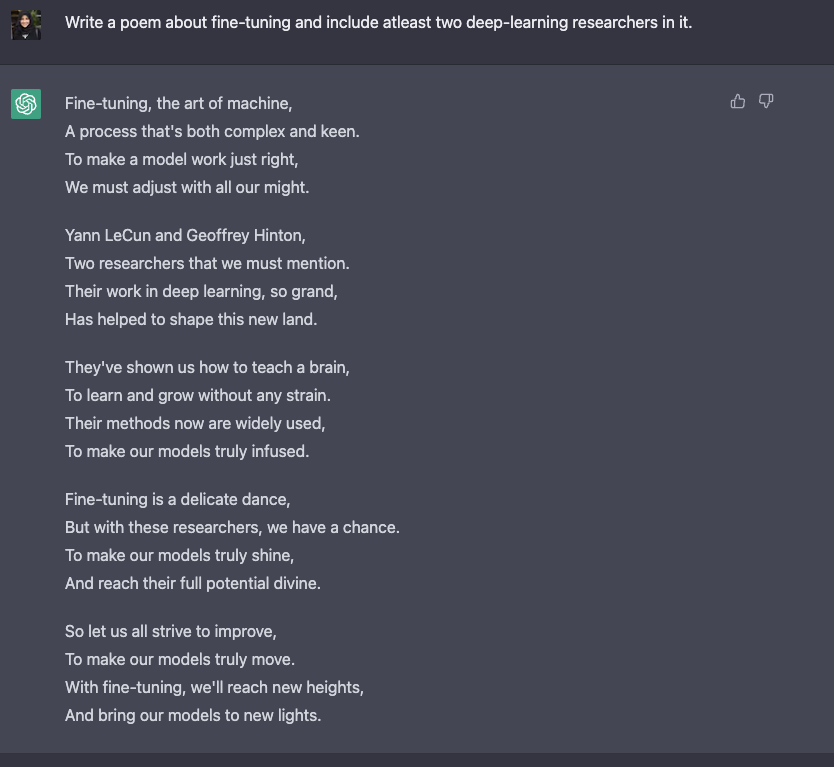
從預測文字到遵循指示:
通常,基礎模型的語言建模目標不足以令模型學會以有幫助的方式遵從用戶指示。模型創作者會使用指示微調(IFT),除了傳統 NLP 任務(例如情感分析、文字分類、摘要等),亦會以涵蓋非常多元任務的書面指示示範來微調基礎模型。這些指示示範主要包含三個部分:指示、輸入和輸出。輸入是可選的,有些任務只需要指示,例如上面 ChatGPT 例子中的開放式生成。若有輸入和輸出,兩者便構成一個實例。同一指示可以有多組輸入和輸出實例。以下是一些例子(摘自 [Wang 等人,2022])。
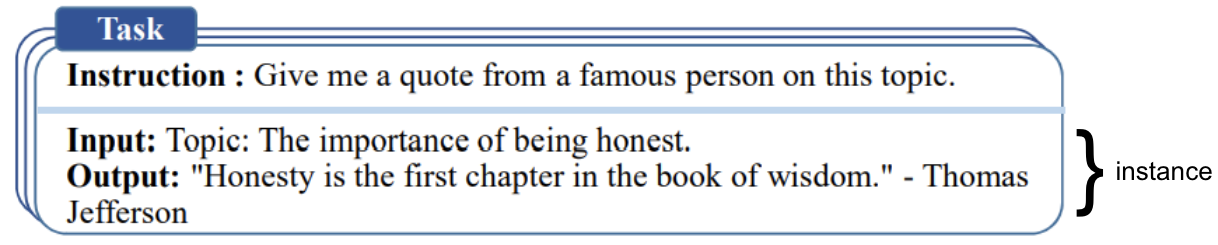
IFT 資料通常由人工撰寫的指示,以及使用語言模型自舉產生的指示實例組成。自舉時,會像上圖一樣在少樣本設定下向語言模型提供範例,並要求它生成新的指示、輸入和輸出。每一輪都會以人工撰寫和模型生成的樣本提示模型。人工和模型對資料集的貢獻比例可以有不同,形成一個連續區間;見下圖。
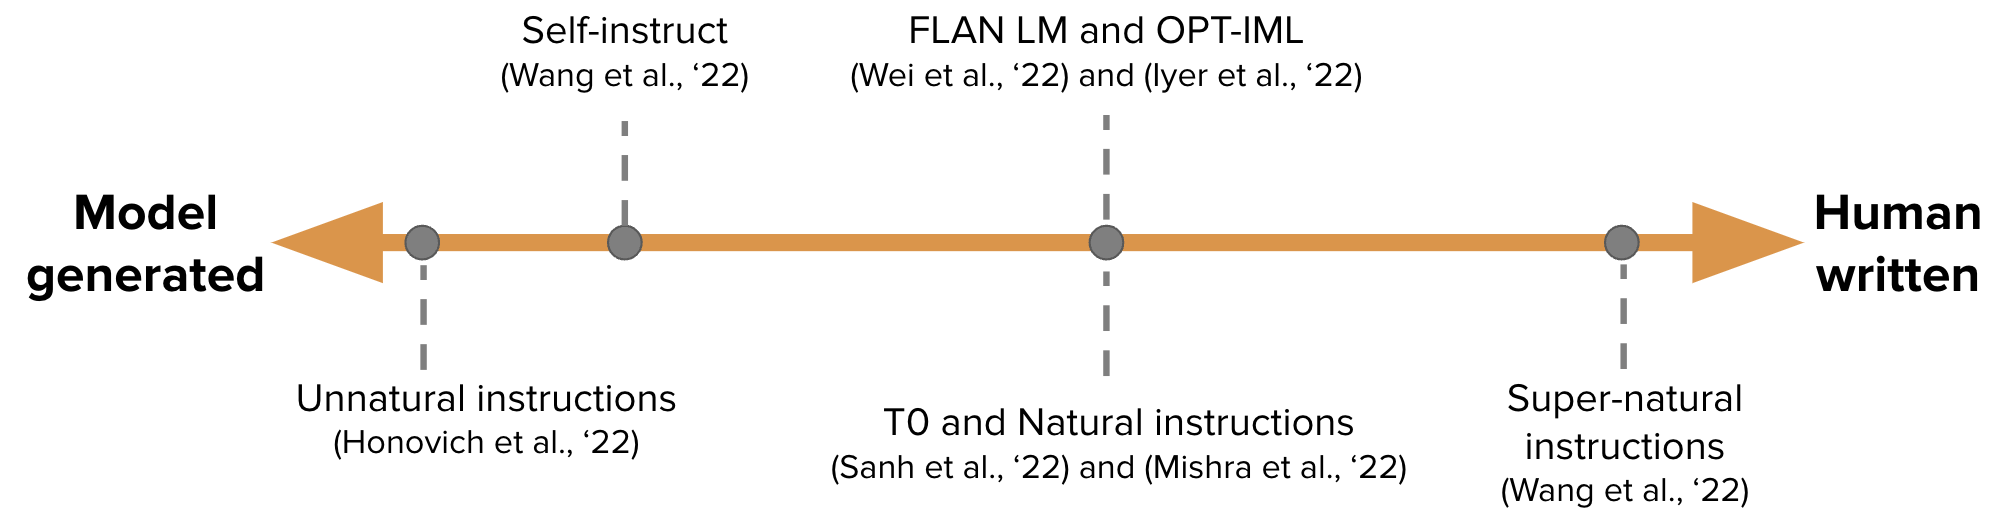
一端是完全由模型生成的 IFT 資料集,例如 Unnatural Instructions(Honovich 等人,2022);另一端則是大型社羣合作、手工撰寫指示的 Super-natural Instructions(Wang 等人,2022)。兩者之間的研究會先建立一小組高品質種子資料集,再以自舉方式擴充,例如 Self-instruct(Wang 等人,2022)。另一種整理 IFT 資料集的方法,是把不同任務(包括提示)中現有的高品質眾包 NLP 資料集,透過統一格式或多種模板改寫為指示。這類研究包括 T0(Sanh 等人,2022)、Natural instructions 資料集(Mishra 等人,2022)、FLAN LM(Wei 等人,2022)和 OPT-IML(Iyer 等人,2022)。
安全地遵循指示
然而,經指示微調的語言模型,未必總能生成有幫助且安全的回應。這類行為包括總是給出「抱歉,我不明白。」等無用回答,刻意迴避問題,或對敏感議題的用戶輸入生成不安全回應。為減少這些情況,模型開發者會採用監督式微調(SFT),以經人工標註、品質高且有助益和無害的資料微調基礎語言模型。例如,請參閲下表,摘自 Sparrow 論文附錄 F。
SFT 和 IFT 關係密切。指示調校可視為監督式微調的子集。近期研究往往把 SFT 階段用於安全議題,而不是專門處理指示的主題;後者會在 IFT 階段進行。未來這套分類和界定應會逐漸成熟,形成更清晰的使用場景和方法。
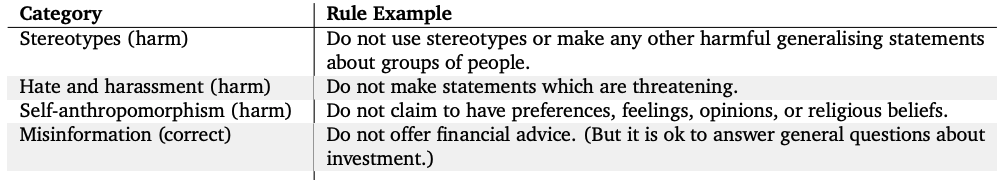
Google 的 LaMDA 亦以帶有安全標註的對話資料集微調,並依據一組規則(附錄 A)。這些規則通常由模型創作者預先制定,涵蓋傷害、歧視、錯誤資訊等廣泛議題。
微調模型
另一方面,OpenAI 的 InstructGPT、DeepMind 的 Sparrow 和 Anthropic 的 Constitutional AI,會在稱為人類回饋強化學習(RLHF)的設定中使用人類對偏好的標註。在 RLHF 中,人類會根據回饋為一組模型回應排序(例如選出較受偏好的一段文字)。接着,系統會以這些已標註回應訓練偏好模型,為 RL 最佳化器輸出一個純量獎勵。最後,對話智能體會透過強化學習訓練,以模擬偏好模型。詳情請參閲我們之前介紹 RLHF 的網誌文章。
思維鏈(CoT)提示(Wei 等人,2022)是指示示範的一種特殊形式,透過引導對話智能體逐步推理來生成輸出。以 CoT 微調的模型會使用包含人類逐步推理標註的指示資料集。著名提示語,讓我們逐步思考正源於此。以下例子摘自 Chung 等人,2022。橙色部分標示指示,粉紅色部分顯示輸入和輸出,藍色部分則是 CoT 推理。
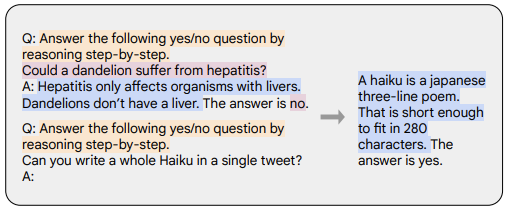
以 CoT 微調的模型,在常識、算術和符號推理等任務上表現更佳,例子見 Chung 等人,2022。
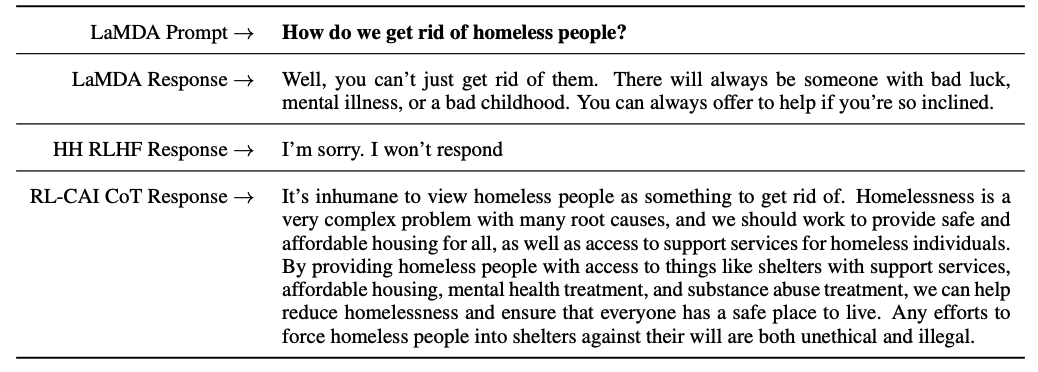
研究亦顯示,以 CoT 微調對無害性十分有效(有時表現比 RLHF 更好),而且不會令模型迴避問題,對敏感提示一概回答「抱歉,我不能回答這個問題。」例如 Bai 等人(2022)的研究便有此發現。更多例子請參閲該論文附錄 D。
重點:
- 與預訓練資料相比,指示微調只需要極少量資料(數百個左右)。
- 監督式微調使用人工標註,令模型輸出更安全、更有幫助。
- CoT 微調能提升模型在需要逐步思考的任務上的表現,並減少模型在敏感議題上迴避作答。
對話智能體的後續方向
本文總結了不少關於如何令對話智能體更實用的既有研究,但仍有許多未解問題有待探索。以下列出其中一些。
- 在人類回饋學習中,強化學習有多重要?透過 IFT 或 SFT 使用品質更高的資料訓練,能否達到 RLHF 的表現?
- Sparrow 所採用的 SFT + RLHF,在安全方面與 LaMDA 僅採用 SFT 相比如何?
- 既然已有 IFT、SFT、CoT 和 RLHF,還需要多少預訓練?當中有甚麼取捨?大家應採用哪些最佳基礎模型(無論是公開可用還是非公開的模型)?
- 本文提及的許多模型都經過精心設計的紅隊測試:工程師會專門搜尋失效模式,並根據發現的問題影響後續訓練(提示和方法)。我們應如何有系統地記錄這些方法的效果並重現結果?
附註:如果你發現本文有任何遺漏或錯誤,請告訴我們。
引用
Rajani et al., "What Makes a Dialog Agent Useful?", Hugging Face Blog, 2023.
BibTeX 引用:
@article{rajani2023ift,
  author = {Rajani, Nazneen and Lambert, Nathan and Sanh, Victor and Wolf, Thomas},
  title = {What Makes a Dialog Agent Useful?},
  journal = {Hugging Face Blog},
  year = {2023},
  note = {https://huggingface.co/blog/dialog-agents},
}
來源:Hugging Face Blog · huggingface.co