如何透過 NVIDIA NeMo Switchyard 在 Amazon Bedrock 為編碼智能體請求路由至合適模型
Route coding agent requests to the right model on Amazon Bedrock with NVIDIA NeMo Switchyard
這篇教學示範如何在 Amazon Bedrock 上部署 LiteLLM 與 NVIDIA NeMo Switchyard,將編碼智能體的請求路由至合適模型。Switchyard 的 LiteLLM 整合支援 Stage 與 Random 兩種路由策略,並以路由模型組與單模型基線比較每個成功完成任務的成本。
文章把智能體路由的比較指標從每 token 價格轉為每個成功完成任務的成本,並示範以相同任務比較路由模型組與單模型基線,按測試是否通過判定任務完成。
Claude Code 和 OpenAI Codex CLI 等編碼 Agent 會處理任務。開發人員提出修改要求後,Agent 會讀取檔案、編輯程式碼並執行測試,直至完成工作。一項任務可能需要呼叫模型幾次,也可能需要幾十次。開發人員付費的是任務,而不是單次呼叫。
單看每個 Token 的價格,無法得知完成整項任務的成本。總成本取決於模型需要多少輪對話、每輪對話要重播多少對話紀錄,以及任務需要重試多少次,或是否一直無法完成。每次嘗試都要付費,包括最終未能完成的任務。因此,將編碼 Agent 的請求分流至不同模型時,應以每項已解決任務的成本來評估分流效果:將所有執行的總成本除以測試通過的執行次數。
NVIDIA NeMo Switchyard 是一個開源程式庫,可協助 AI Agent 選擇由哪個模型處理每項請求。你可以設定可用模型及採用的策略。它的 LiteLLM 整合支援兩種策略。階段分流會讀取請求紀錄中近期的工具活動及結果,然後從兩個候選模型中選擇一個。隨機分流則會從已設定的模型中選擇,並可設定權重,適用於流量分配及 A/B 比較。你亦可考慮另一個選項 LiteLLM;它近期亦已推出原生內置的 Switchyard 階段路由器,作為自動路由策略。
本文會使用 AWS Cloud Development Kit (AWS CDK),在你的 AWS 帳戶中部署 LiteLLM(一個開源大型語言模型 (LLM) 閘道),並加入 Switchyard 路由外掛程式。LiteLLM 會呼叫 Amazon Bedrock 上的模型。接著,你會使用範例中的基準測試執行工具,量度已路由模型組及單一模型基準組的每項已解決任務成本,藉此評估路由在你自身工作負載中的成效。
注意:此範例會從 crates.io 安裝
switchyard-server0.3.0,並執行已發布的 LiteLLM v1.102.0 映像。NVIDIA 將switchyard-server0.3.0 列為示範及評估元件,其設定可能因版本而異。此範例使用實驗階段的 Switchyard LiteLLM 整合,其設定及 API 亦可能因版本而異。此範例程式碼僅供非生產用途。部署前,請與安全及法律團隊合作,以符合機構的安全、監管及合規要求。請在非生產環境的帳戶中部署此範例並進行測試,然後才依賴它。
方案概覽
圖 1 顯示方案架構。LiteLLM 和 Switchyard 外掛程式在同一個容器映像中執行,並部署於私有子網中的 Amazon Elastic Container Service (Amazon ECS) 和 AWS Fargate 上。
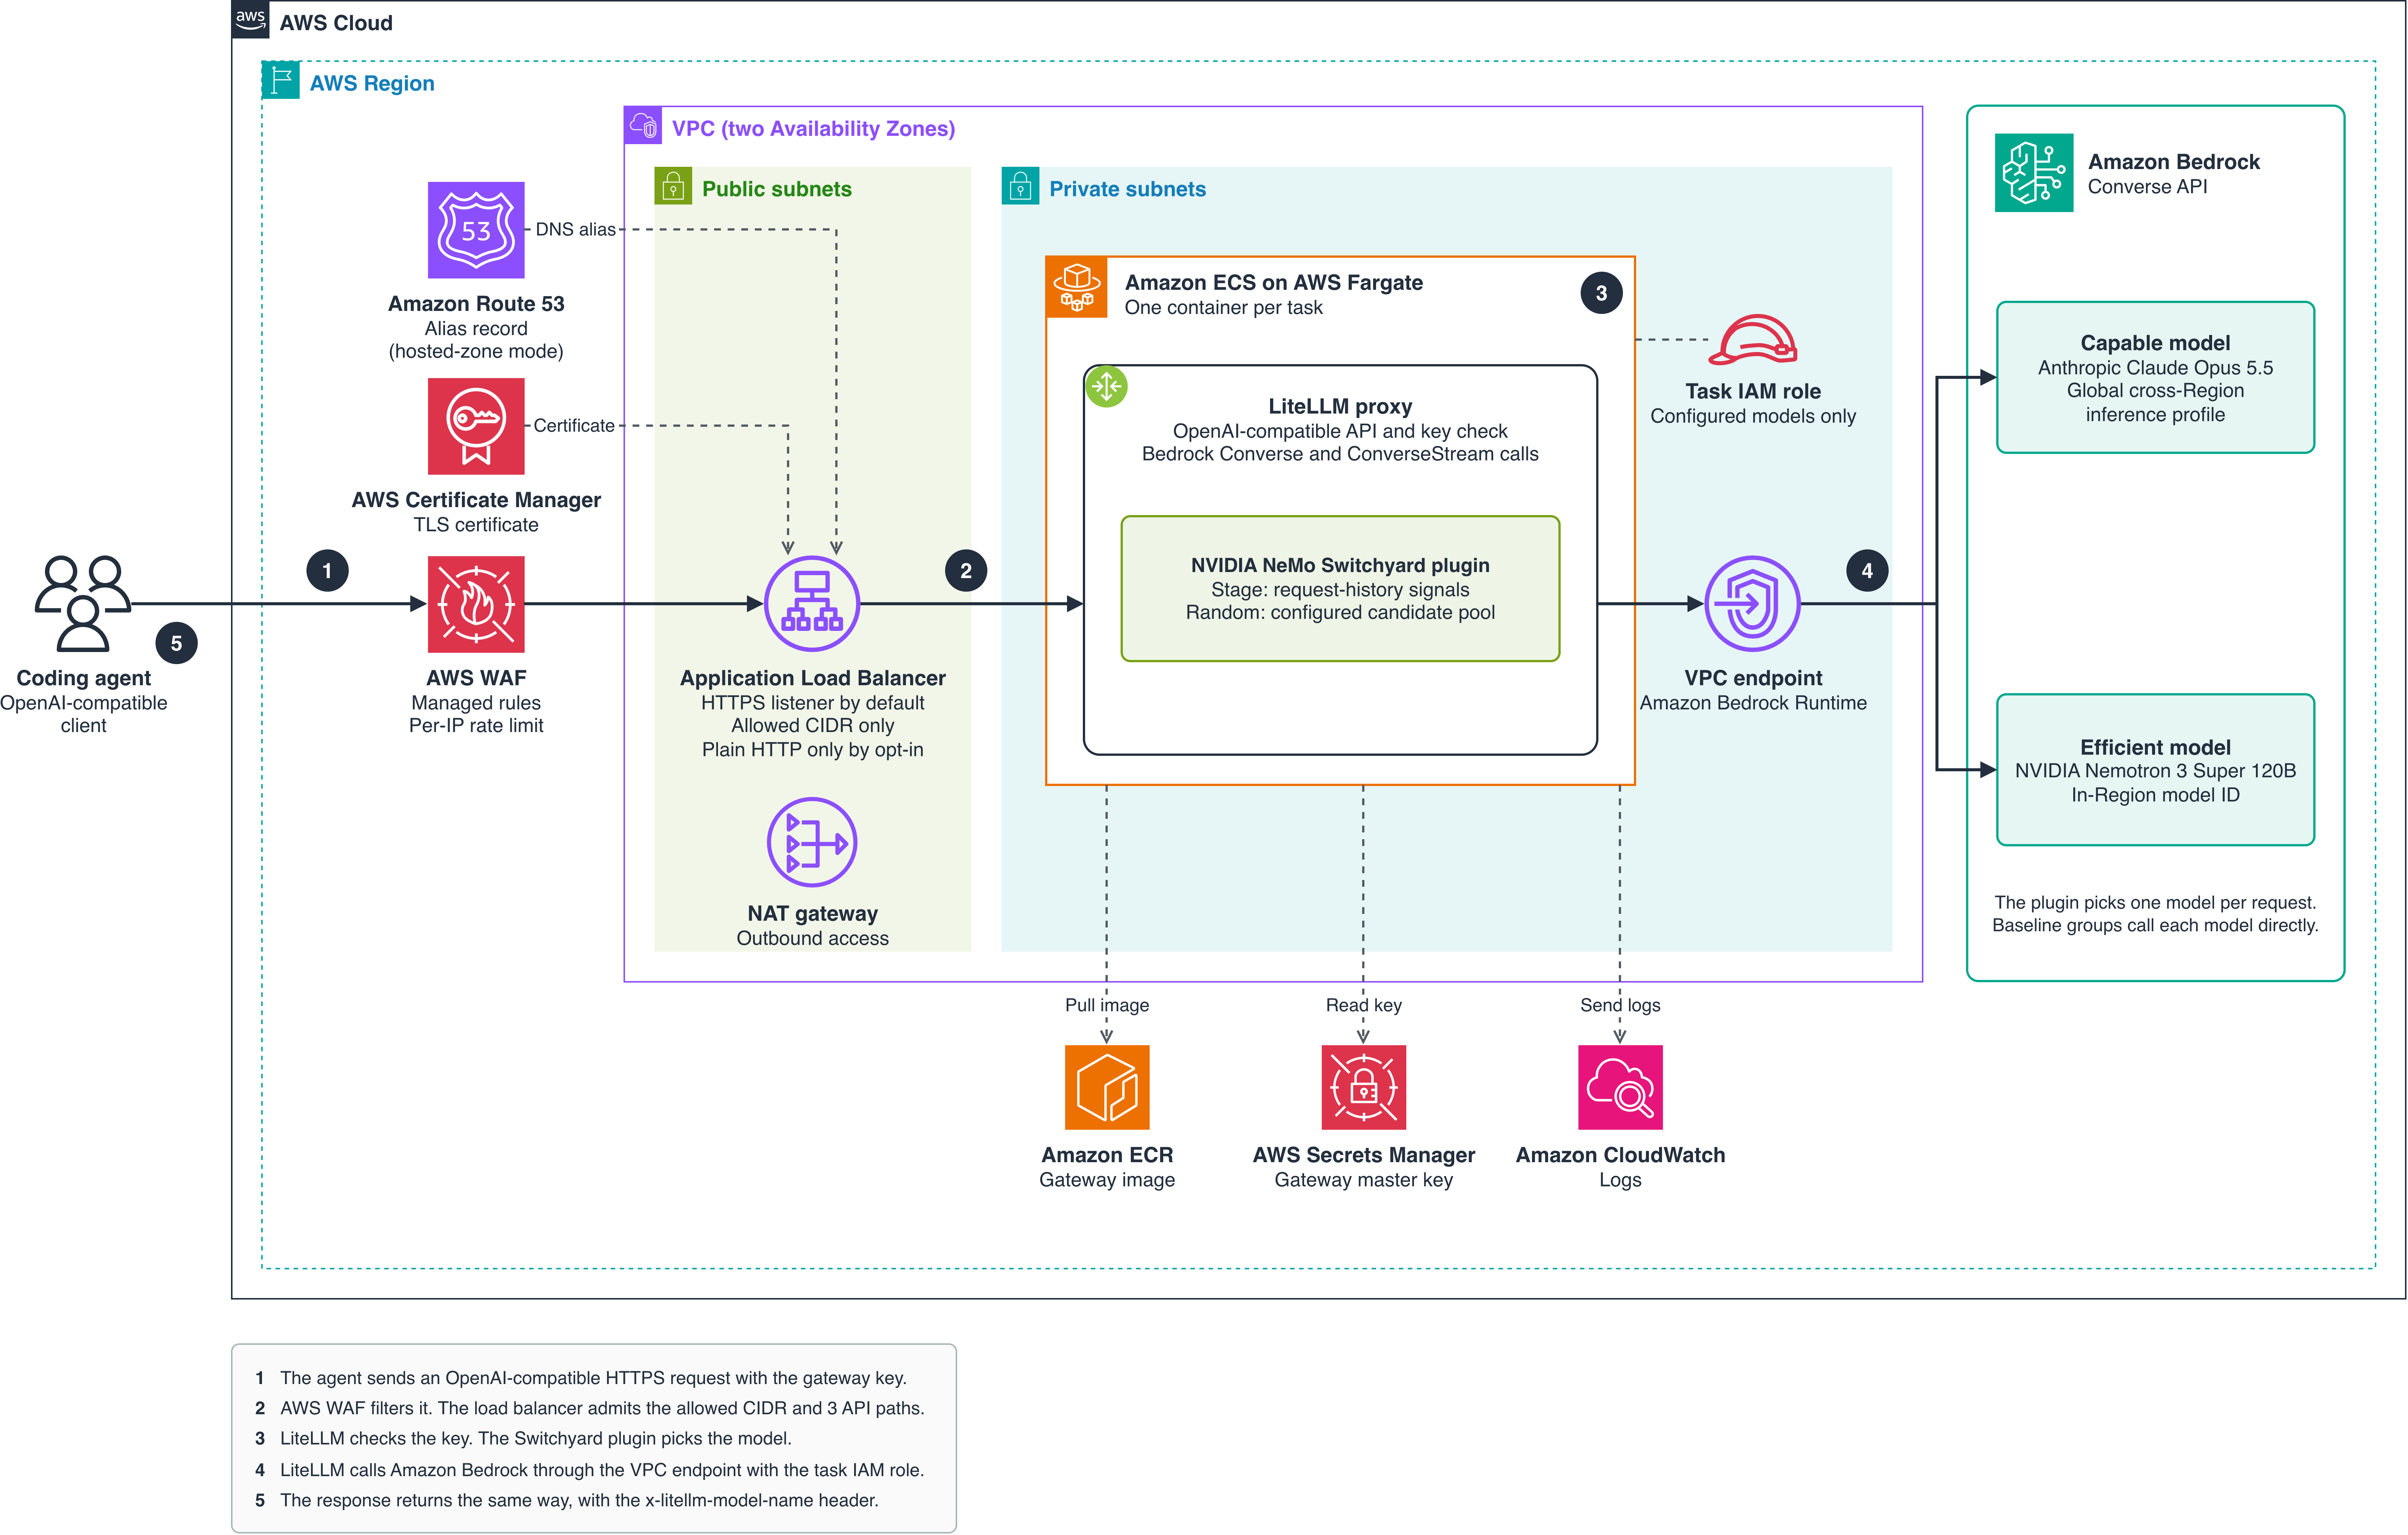
圖 1:方案架構
請求會按以下步驟傳送,各步驟的編號與圖中的編號相符。
- 編碼 Agent 會傳送 OpenAI 相容請求,並將模型欄位設為
switchyard(由 Switchyard 路由的 LiteLLM 模型組),同時在Authorization標頭中提供共用閘道金鑰。端點是使用 HTTPS 的主機名稱,負載平衡器上設有 AWS Certificate Manager (ACM) 憑證,而且只有你允許的 IPv4 CIDR 範圍可以連線至該端點。如果你在 Amazon Route 53 中設有託管區域,Route 53 會將主機名稱解析至負載平衡器。 - AWS WAF會根據 IP 信譽、已知惡意輸入及每個 IP 的速率限制規則篩選請求。Application Load Balancer只會將
/v1/chat/completions、/v1/models及/health/liveliness轉發至私有子網中的 ECS 工作,其他所有路徑均會回應 404。 - 此工作會執行一個容器:內嵌 Switchyard 插件的 LiteLLM。LiteLLM 會驗證閘道金鑰,並呼叫插件選擇模型。Stage 會在能力較強的模型與成本較低、效率較高的模型之間作出選擇。它會讀取請求記錄中的工具活動及結果,因此 Agent 必須傳送完整的對話記錄。Random 會從按權重配置的模型池中選擇模型。這兩種策略都不會呼叫評審模型。
- LiteLLM 會透過 Amazon Bedrock
Converse或ConverseStreamAPI 呼叫所選模型,並使用工作所屬的 AWS Identity and Access Management (IAM) 角色取得憑證。呼叫會經過 Amazon Virtual Private Cloud (Amazon VPC) 中的 Amazon Bedrock Runtime 介面端點,因此推理流量會留在 AWS 網絡內。 - 回應或 Token 串流會經 LiteLLM 和負載平衡器返回。
x-litellm-model-name回應標頭會指出作出回應的模型。回應本文中的model欄位會維持switchyard。
LiteLLM 會在容器的 4000 連接埠上接聽,並作為負載平衡器的目標;工作所屬的安全羣組只會允許負載平衡器連入。路徑允許清單會令 LiteLLM 管理介面、API 文件及金鑰管理路徑無法存取。Amazon Elastic Container Registry (Amazon ECR) 會存放閘道映像檔。AWS Secrets Manager 會產生閘道金鑰所用的密鑰,而容器啟動時會加入 sk- 前綴。工作定義會傳入位於 LITELLM_CONFIG_TEXT 和 SWITCHYARD_CONFIG_TEXT 的設定檔,啟動指令碼會先將它們寫入 /tmp,再啟動 LiteLLM。記錄會寫入單一 Amazon CloudWatch 記錄羣組 /<stack name>/litellm,並保留 30 天;Container Insights 則會收集指標。VPC 橫跨兩個可用區,而一個 NAT 閘道會提供對外存取,以便擷取映像檔及使用其他 AWS 服務。
此插件支援 Stage 路由(需要剛好兩個候選模型),以及 Random 路由(至少需要兩個候選模型,並按權重分配流量以進行 A/B 測試)。以分類器為基礎的策略(例如 Task 和 Composite 路由)需要進行中間模型呼叫,而此整合並不支援這種呼叫方式。完整清單請參閲 Switchyard 路由概覽。
前置條件
如要按照本教學操作,你需要:
- 一個非正式環境的 AWS 帳戶,並可透過 Amazon Bedrock 使用 Claude Opus 5.5 和 NVIDIA Nemotron 3 Super 120B。這兩個模型已在美國東部(維珍尼亞北部)測試。如要使用其他 AWS 區域,請查看各模型的區域可用性及工具呼叫支援情況。
- AWS Command Line Interface (AWS CLI) v2,並已設定憑證及明確指定 AWS 區域;所用的帳戶和區域亦須完成 AWS CDK 初始化設定。
- Node.js 20 或更新版本、npm、支援 BuildKit 的 Docker,以及 Python 3.11 或更新版本。
- 一個由你擁有的主機名稱,並為其網域設有公開的 Route 53 託管區域,或在部署區域為該主機名稱設有 ACM 憑證。短時間的純 HTTP 測試兩者皆不需要。
操作指南
你會定義模型羣組、設定 Stage、部署並測試閘道,以及衡量成本。首先複製範例儲存庫:
git clone https://github.com/aws-samples/sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard.git
cd sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard
步驟 1:在 LiteLLM 中定義模型羣組
LiteLLM 模型羣組是一個公開模型名稱,背後有一個或多個部署。範例將設定保存在 profiles/ 下的部署設定檔中。每個設定檔會配對 litellm.yaml(用來定義模型和閘道設定)與 switchyard.toml(用來控制 Switchyard 如何選擇模型)。以下摘錄自 profiles/stage/litellm.yaml,當中定義了路由式 switchyard 羣組、兩個單一模型基準羣組,以及外掛程式註冊:
model_list:
  - model_name: switchyard
    litellm_params:
      model: bedrock/converse/global.anthropic.claude-opus-5-5
      aws_region_name: os.environ/AWS_REGION
  - model_name: switchyard
    litellm_params:
      model: bedrock/converse/nvidia.nemotron-super-3-120b
      aws_region_name: os.environ/AWS_REGION
  # One-model baseline groups, same model strings as the routed candidates.
  - model_name: claude-opus-5-5
    litellm_params:
      model: bedrock/converse/global.anthropic.claude-opus-5-5
      aws_region_name: os.environ/AWS_REGION
  - model_name: nemotron-super-3-120b
    litellm_params:
      model: bedrock/converse/nvidia.nemotron-super-3-120b
      aws_region_name: os.environ/AWS_REGION

# The same object selects a deployment and applies supported request changes.
router_settings:
  plugins:
    - switchyard_gateway.configured.ROUTING_PLUGIN
litellm_settings:
  callbacks:
    - switchyard_gateway.configured.ROUTING_PLUGIN
  drop_params: true
  request_timeout: 600
  num_retries: 2
general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
兩個候選模型共用 model_name: switchyard,因此用戶端會傳送 "model": "switchyard",再由 Switchyard 選擇候選模型。請先列出能力較強的模型,再列出效率較高的模型,因為 Stage 會按這個次序讀取角色。
claude-opus-5-5 和 nemotron-super-3-120b 羣組是單一模型基準。每個羣組一律由其自身模型作答,因此你可以在相同部署中,比較路由式羣組與各模型單獨使用時的成本和通過率。Stage 外掛程式本身會拒絕只有一個候選模型的羣組,因此此映像會註冊一個小型包裝器 switchyard_gateway.configured.ROUTING_PLUGIN。它會對有兩個或以上獨特候選模型的羣組套用 Switchyard,並讓單一模型羣組直接通過。設定會將包裝器註冊兩次:一次用來選擇模型,另一次用來套用 Switchyard 記錄的請求變更。
每個模型都使用 bedrock/converse/<id>,因此所有候選模型都會經由 Amazon Bedrock Converse API 處理,而驗證會拒絕任何其他路由。LiteLLM 的 request_timeout 設為 600 秒,與負載平衡器的 10 分鐘閒置逾時相符。
檔案不包含任何憑證。LiteLLM 會從環境讀取閘道金鑰,而任務角色會提供 AWS 憑證。切勿在 litellm_params 下加入例如 aws_access_key_id、aws_secret_access_key 或 api_key 的憑證:堆疊會將整個 litellm.yaml 複製到任務定義和 AWS CloudFormation 範本中,並以純文字儲存。
堆疊會根據此檔案推導任務角色的 Amazon Bedrock 權限。對於全球跨區域推理設定檔,foundation-model 資源會使用 * 區域和結尾的 *,因此也會匹配具有相同前綴的其他模型 ID。部署前請檢視推導出的政策。
global. 前綴表示全球跨區域推理設定檔,而 Amazon Bedrock 可能會在全球各個支援的 AWS 商業區域處理這些請求。如果處理位置很重要,請改用地理區域設定檔或區域內模型 ID。Nemotron 3 Super 的設定檔使用區域內模型 ID nvidia.nemotron-super-3-120b,你可以在測試時將其替換為任何模型。
步驟 2:設定 Stage 路由
Switchyard 會從 switchyard.toml 讀取演算法和設定。預設設定檔 profiles/stage/switchyard.toml 會設定 Stage:
# Model inventory is in litellm.yaml. This file configures selection behavior.
algorithm = "stage"
# Prefer the efficient candidate when history signals are inconclusive.
picker = "efficient_first"
confidence_threshold = 0.5
# Inspect the three most recent tool results for execution signals.
recent_window = 3
only_on_wrong_signal_escalation = true
設定如下:
picker = "efficient_first":如果歷史記錄中的訊號不足以得出結論,Stage 會使用效率較高的模型。新請求尚未有工具結果,因此會交由 Nemotron 3 Super 處理。confidence_threshold:Stage 對執行訊號評分時使用的信心閾值,範圍為 0 至 1。recent_window = 3:Stage 會檢查最近三項工具結果。only_on_wrong_signal_escalation = true:Switchyard 的預設值。它控制 Stage 何時加入可選的升級備註,而此設定檔沒有設定備註。
Stage 亦接受可選的交接備註和各層級的系統提示詞(escalation_note、deescalation_note、capable_system_prompt 和 efficient_system_prompt)。範例設定檔沒有設定這些項目。
進行 A/B 測試時,profiles/random/ 中的 Random 設定檔會使用相同模型,並設定 algorithm = "random" 和 weights = [0.5, 0.5];每個獨特候選模型按宣告次序各佔一個權重。要部署此設定檔,請將 -c routingProfile=random 加入步驟 3 的 cdk diff 和 cdk deploy 指令中。
堆疊在合成時會一併驗證兩個檔案,而預檢指令碼也會執行相同檢查。若要單獨檢查設定檔變更而不呼叫 AWS,請執行 npm run validate:profile -- stage。無效設定會令 LiteLLM 無法啟動,而不支援的訊息格式會在推理前報錯。
選用:在本機執行閘道
你可以先在自己的電腦上試用閘道,再部署任何內容。Docker Compose 會建置相同的映像檔,並讀取部署至 Amazon ECS 的堆疊所使用的相同設定檔。請在存放庫根目錄執行:
npm ci
cp .env.example .env

export LITELLM_MASTER_KEY="sk-$(openssl rand -hex 24)"
eval "$(aws configure export-credentials --format env)"

ROUTING_PROFILE=stage docker compose up --build --wait
GATEWAY_URL=http://127.0.0.1:4000 ROUTING_PROFILE=stage scripts/smoke-test.sh
你匯出的金鑰優先於 .env 中的佔位符,因此 Compose 和冒煙測試會使用同一個金鑰。AWS 認證資料只會來自你的 shell,不會放進 .env 或設定檔。Compose 只會在 127.0.0.1 上發布閘道。本機沒有負載平衡器,因此冒煙測試會略過封閉路徑檢查。本機閘道仍會呼叫 Amazon Bedrock,而這些呼叫會產生費用。完成後,請執行 docker compose down。
步驟 3:部署閘道
閘道會在你擁有的主機名稱上提供 HTTPS。將 GATEWAY_DOMAIN 設為該主機名稱,並將 HOSTED_ZONE 設為包含該主機名稱的現有 Route 53 公開託管區域。AWS CDK 隨後會建立經 DNS 驗證的 ACM 憑證和別名記錄。在存放庫根目錄安裝相依套件、執行唯讀預檢查,然後部署:
npm ci

export AWS_REGION=us-east-1
export AWS_DEFAULT_REGION="$AWS_REGION"
eval "$(aws configure export-credentials --format env)"
export CDK_DEFAULT_REGION="$AWS_REGION"
export CDK_DEFAULT_ACCOUNT="$(aws sts get-caller-identity --query Account --output text)"
export ALLOWED_CIDR="$(curl -4 -fsS --connect-timeout 5 --max-time 15 https://checkip.amazonaws.com)/32"
export GATEWAY_DOMAIN=llm-gateway.example.com
export HOSTED_ZONE=example.com

scripts/preflight.sh
npx cdk diff -c allowedCidr="$ALLOWED_CIDR" \
  -c domainName="$GATEWAY_DOMAIN" -c hostedZone="$HOSTED_ZONE"
npx cdk deploy -c allowedCidr="$ALLOWED_CIDR" \
  -c domainName="$GATEWAY_DOMAIN" -c hostedZone="$HOSTED_ZONE"
如果你的網域 DNS 不在 Route 53,請改用現有的 ACM 憑證。將 CERTIFICATE_ARN 設為部署區域中適用於該主機名稱的 ACM 憑證,並在兩個命令中將 -c hostedZone="$HOSTED_ZONE" 替換為 -c certificateArn="$CERTIFICATE_ARN"。AWS CDK 不會建立憑證或 DNS 記錄。部署完成後,建立 CNAME 記錄(或 Route 53 別名),將主機名稱指向 LoadBalancerDnsName 輸出中的值。
必須設定 allowedCidr 值,以限制哪些網絡可以連接負載平衡器;命令會將其設為你目前的公開 IPv4 位址。請將範圍限制在你自己的 /32:任何共用獲準位址的人,例如使用辦公室 NAT 或 VPN 出口的人,都可以連接端點。如果沒有 allowedCidr、使用對所有來源開放的範圍(例如 0.0.0.0/0),或使用 IPv6 範圍,堆疊都會拒絕合成。
預檢會檢查設定、工具和 AWS 存取權限,包括存取設定檔中每個模型的權限,但不會發出推理請求。AWS CDK 會建置閘道映像檔、將其發布至 Amazon ECR,並部署堆疊。部署會輸出以下項目:
| 輸出 | 説明 |
| GatewayUrl | 基本 URL。OpenAI 相容 API 位於 /v1 路徑下。 |
| MasterKeySecretArn | 閘道金鑰所用的 Secrets Manager 機密。完整金鑰由 sk- 加上機密值組成。 |
| MasterKeyCommand | 用來列印閘道金鑰的命令。 |
| SmokeTestCommand | 冒煙測試命令,已填入堆疊名稱、區域和設定檔。 |
| RoutingProfile | 目前使用的路由設定檔,預設為 stage。 |
| ClusterName, ServiceName | ECS 叢集和服務。輪換金鑰的步驟會用到它們。 |
| LoadBalancerDnsName | 只有設定 certificateArn 時才會輸出:供你將主機名稱指向的名稱。 |
請一律向用戶提供 https:// URL。連接埠 80 只會保持開啟,以便重新導向至 HTTPS;若用戶端設定為使用 http://,重新導向送達時,金鑰和第一個請求已經以明文傳送。
負載平衡器的閒置逾時設為 10 分鐘,以支援較長的 Agent 回應。Web ACL 使用 Amazon IP 信譽清單和已知惡意輸入規則羣組,並將每個 IP 位址的請求數限制為每 5 分鐘 2,000 次。由於 Agent 請求中的原始碼會觸發跨網站指令碼、SQL 注入和本文大小的一般規則,因此未加入這些規則。allowedCidr 範圍和閘道金鑰仍然適用。
透過純 HTTP 快速測試。未設定 HTTPS 時,合成程序會停止並顯示錯誤。若要在沒有網域的情況下短暫測試,你可以選擇在負載平衡器的 DNS 名稱上啟用純 HTTP:
npx cdk deploy -c allowedCidr="$ALLOWED_CIDR" -c allowPlainHttp=true啟用 allowPlainHttp=true 後,每次合成堆疊時,AWS CDK 都會印出警告。閘道金鑰會放在 Authorization 標頭中;你的 Agent 傳送的提示詞、工具結果和原始碼,以及模型回應,都會在用戶端與負載平衡器之間以未加密方式傳送。只在使用自己 /32 中不含敏感資料的程式碼進行短時間測試時,才選擇啟用此設定。之後請輪換金鑰,並在完成時執行 cdk destroy。日後如要將同一個堆疊改用 HTTPS,請使用 HTTPS 設定重新部署,並停用 allowPlainHttp。
步驟 4:測試閘道
在部署時使用的同一個終端機中,讀取 AWS CloudFormation 堆疊輸出,並建立閘道金鑰:
export STACK_NAME=SwitchyardGateway

output() {
  aws cloudformation describe-stacks --region "$AWS_REGION" --stack-name "$STACK_NAME" \
    --query "Stacks[0].Outputs[?OutputKey=='$1'].OutputValue" --output text
}

export GATEWAY_URL="$(output GatewayUrl)"
export LITELLM_MASTER_KEY="sk-$(aws secretsmanager get-secret-value --region "$AWS_REGION" \
  --secret-id "$(output MasterKeySecretArn)" --query SecretString --output text)"
向 switchyard 模型組別傳送請求:
curl -sS -i --connect-timeout 10 --max-time 180 "$GATEWAY_URL/v1/chat/completions" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"switchyard","messages":[{"role":"user","content":"Reply with the word hello."}],"max_tokens":128}'
查看是否收到 HTTP 200 和回應。x-litellm-model-name 回應標頭會以完整的 LiteLLM 模型字串顯示所選模型。新請求沒有可評分的工具結果,因此 Stage 會選用效率較高的模型 bedrock/converse/nvidia.nemotron-super-3-120b。
如要檢查健康狀態、驗證及路由,請執行冒煙測試:
ROUTING_PROFILE="$(output RoutingProfile)" scripts/smoke-test.sh冒煙測試會檢查健康狀態端點、/ui 等未開放路徑是否會收到負載平衡器自行傳回的 404、沒有金鑰的請求是否會收到 401,以及 /v1/models 是否列出所有模型組別。對於 Stage,測試會檢查一般請求是否選用效率較高的模型,以及記錄了重複失敗的歷史後,是否會升級至能力較強的模型。接着,測試會向每個基準組別各傳送一個請求。這些請求和冒煙測試都會產生需付費的 Amazon Bedrock 呼叫。
如要試用自己的 Agent,請使用 $GATEWAY_URL/v1 作為其 OpenAI 相容的基礎 URL、使用閘道金鑰作為其 API 金鑰,並使用 switchyard 作為模型。Stage 要求每個請求都包含完整且受支援的請求歷史記錄。上游介面卡支援文字訊息、函數工具呼叫及文字工具結果;不支援的訊息格式會在推理前失敗。負載平衡器會轉發 Chat Completions 路徑,但不會轉發 OpenAI Responses 或 Anthropic Messages 路徑。在你加入路徑、以本機容器進行測試並重新部署之前,使用這些 API 的用戶端都會收到 404。
步驟 5:計算每個已解決任務的成本
範例中的程式碼執行工具 bench/run.py 可讓小型程式碼 Agent 透過閘道列出及讀取檔案、替換原始碼檔案,以及執行提供的單元測試。預設情況下,任務須在最多六個模型回合內完成,並在最後通過測試,才算已解決。列出任務,並先在路由組別上執行 slugify:
python3 bench/run.py --list-tasks
python3 bench/run.py --tasks slugify --model switchyard --max-turns 6
終端機會顯示任務、所選模型、工具操作、測試結果及最終程式碼差異。每次執行都會將起始檔案、最終工作區、對話記錄、修補檔及結果儲存在 bench/results/ 下。
| 任務 | Agent 必須執行的工作 |
| slugify | 修正一個用來建立 URL slug 的簡短函數。 |
| roman | 編寫一個將整數轉換為羅馬數字的函數。 |
| calc | 編寫一個運算式剖析器,不使用 eval,並支援運算優先次序、乘方運算子、函數及錯誤處理。 |
| lru_ttl | 編寫一個具備執行緒安全、每個項目獨立到期時間及精確計數器的最近最少使用(LRU)快取。 |
如要讓算術剖析器任務有足夠回合執行測試及嘗試修正,請提高回合上限:
python3 bench/run.py --tasks calc --model switchyard --max-turns 12執行完成後,執行器會為每個模型組別列印一行,列出 RUNS、SOLVED、ERRORS、COST/TASK 和 COST/SOLVED 欄目。每個已解決任務的成本,是某組別所有執行的估算成本除以測試通過的執行次數。執行器會根據 x-litellm-model-name 標頭中的模型,以及回應中的 token 用量,計算每回合的成本,並使用 bench/run.py 中的 PRICES 表格。含有快取輸入的回合、沒有 PRICES 項目的模型,或缺少標頭或 token 數量的回應,都會維持未計價狀態,而不會按零計算。將模型加入設定檔時,請新增相應的 PRICES 項目,並查閲 Amazon Bedrock pricing 以瞭解最新價格。這裏以兩項任務的少量執行示範整個流程,但不足以據此判斷成本或質素。
如果某組別有任何執行未計價,便會顯示 n/a 及原因;如果沒有執行成功,COST/SOLVED 則會顯示 -。如要了解成本花在哪裏,可查看各回合:終端機會列印每回合所用的模型,而 bench/results/ 下的對話記錄則會記下該模型。
如要比較完整對話,bench/multiturn.py 會針對每項程式編寫任務執行 Agent 式循環,在第一個提示詞中加入專案檔案,並在每次編輯後將測試輸出傳回。此外,它亦會執行四段由七個回合組成的預設對話,交替進行簡單回合,以及涉及設計、除錯和編寫程式碼的回合;每個回合都會重新提交完整對話歷史。對於設有簡單檢查的回合(例如檢查預期文字、字數限制、項目符號,或針對回傳函式的斷言),系統會記錄檢查是否通過。設計回覆不會評分。
python3 bench/multiturn.py --tasks slugify --scripts backend api --max-spend 2--max-conv-cost 選項(預設為 1 USD)會為每段對話設置上限,而 --max-spend 則會阻止執行器開始新對話。摘要會按模型組別列出通過的程式編寫對話數目、通過的對話檢查數目,以及每段程式編寫對話、每段對話和總體的估算成本。
執行器會在你的電腦上執行模型編寫的 Python。執行測試的子程序,其環境中沒有憑證,但它並非作業系統層級的沙盒:程式碼可以讀取你的用戶有權讀取的任何檔案,也可以連接網絡。請使用可拋棄式開發環境,並確保磁碟上沒有長期有效的 AWS 憑證;同時保護 bench/results/ 下的檔案,當中包含提示詞、模型回應、工具輸出和生成的程式碼。
解讀結果
範例中的任務規模小,僅作示範。要判斷路由是否適合你的工作負載,請以能代表你自己的程式碼庫的任務取代或擴充這些任務,並在閲讀執行器的輸出時留意以下事項。
- 先看 SOLVED,再看 COST/SOLVED – 某組別解決的任務較少,COST/TASK 仍可能較低,但每個已解決任務的成本卻更高,因為失敗的執行會增加成本,卻不會增加已解決任務的數目。比較路由組別與各個基準組別的 COST/SOLVED 前,應先比較各組別解決的任務數目。
- 分開檢視困難任務 – 整體數據可能掩蓋了某一項主導結果的任務,應按任務細分結果。Stage 根據歷史記錄中的失敗作出決定,因此無法預先將困難任務路由至有能力處理的候選模型。升級處理的回合亦會重播整個失敗嘗試,因此復原成本可能高於一開始便使用有能力的候選模型執行。如果少數困難任務佔了大部分成本,可考慮將它們路由至專用模型組別,或選擇能解決更多這類任務的高效候選模型。
- 進行足夠次數的重複測試 – 模型每次執行的輸出都可能不同。若每組只執行少數幾次,成功完成的任務相差一兩項可能只是隨機誤差。增加
--repeats,直至你關注的差異趨於穩定,並在根據差異採取行動前進行統計檢定,例如以 Fisher 精確檢定分析任務成功率。 - 考慮回合上限 – 較低的
--max-turns值會對先探索再編輯的模型造成不利影響,因為留給它修正失敗編輯的回合會較少。請將上限設為符合實際 Agent 執行方式的數值。 - 考慮輸出上限 – 如果某組回覆達到
max_tokens,測得的成本只是下限,而縮短的回覆亦會令後續回合重播的對話記錄縮短。比較對話成本前,請檢查逐字稿,確認回覆沒有被截斷。 - 將成本視為估算值 – 執行工具會根據 Token 用量和 PRICES 表估算成本,而非使用你的帳單金額。提示詞快取、批次推理及價格變動都會影響實際成本。請參閲 Amazon Bedrock 定價,並查閲 AWS 成本與用量報告以確認。
- 測試你打算使用的設定 – 結果只適用於你測量過的模型、設定檔設定和任務。如果你更換候選模型、修改 Stage 設定,或切換至 Random 設定檔,請重新測量。
你可以根據這些測量結果,為每種工作負載選擇三種方案之一:路由羣組、單一模型羣組,或採用不同候選模型或設定的設定檔。更改模型、提示詞或 Agent 行為後,請使用相同方法重新測量。
清理
為避免持續產生費用,請刪除堆疊。AWS CDK 需要 allowedCidr 值才能合成應用程式,但在此處該值並不重要:
npx cdk destroy -c allowedCidr=203.0.113.0/24CloudFormation 會在沒有復原期的情況下刪除主金鑰密碼,因此如有需要,請先複製金鑰。閘道容器映像檔會保留在 Amazon ECR 的 AWS CDK bootstrap 儲存庫中。
結論
本文介紹如何在 AWS 上部署 LiteLLM 和 NVIDIA NeMo Switchyard 路由外掛程式、設定 Amazon Bedrock 模型之間的 Stage 和 Random 路由,以及測量路由模型羣組每項成功完成任務的成本,並與單一模型基準進行比較。Agent 任務的總成本取決於回合數、對話記錄和重試次數,因此單看每個 Token 的價格並非可靠的參考依據。使用你自己的任務測量每項成功完成任務的成本,便能取得所需數據,選擇合適的設定。
如要開始使用,請在開發帳戶中部署範例儲存庫,並使用你自己工作負載中的任務,測量 Stage 路由和單一模型基準。如要了解更多,請參閲Switchyard LiteLLM 外掛程式指南和Amazon Bedrock 使用者指南。歡迎在留言中提出問題。
作者簡介

Aswath Ram A Srinivasan
Aswath 是 Amazon Bedrock 的高級專家解決方案架構師,專注於 Amazon Bedrock 核心模型、功能,以及成本最佳化和歸屬分析。他協助獨立軟件供應商和策略客戶解決難題,並與企業團隊合作設計推理架構,在兼顧責任的前提下平衡效能、成本和營運簡易程度。閒暇時,他是攝影師,也喜歡閲讀神經符號 AI 和負責任 AI 相關的科學期刊論文。

Anshika Saxena
Anshika 是 AWS 的生成式 AI 數據科學家,專注於 Amazon Bedrock。她透過指導企業客戶在 Amazon Bedrock 上建構及實施解決方案,協助他們加快採用生成式 AI 和代理式 AI。她亦與 ISV 和初創公司合作,協助他們採用 Amazon Bedrock 上最新的 Anthropic 服務。

Aris Tsakpinis
Aris 是生成式 AI 高級專家解決方案架構師,專注於 Amazon Bedrock 上的開放權重模型,以及更廣泛的生成式 AI 開源生態系統。在專業工作以外,他正在雷根斯堡大學攻讀機器學習工程博士學位,研究重點是科學領域的應用自然語言處理。

Kevon Mayers
Kevon 是 NVIDIA 的高級解決方案架構師,負責推動各大雲端服務供應商的代理式 AI 和實體 AI 計劃。他曾任 AWS 遊戲解決方案架構師,並領導 Terraform 計劃中的基礎設施即程式碼(IaC)工作,具備 DevOps、軟件工程及開源 Terraform 貢獻方面的背景。他亦是 MM Productions 的負責人,並曾任 GRAMMYs/The Recording Academy 的工作室經理、製作人及音訊工程師。

Curt Lockhart
Curt 是 NVIDIA 的 AI 解決方案架構師,協助客戶處理 AI 技術堆疊各個部分的工作,涵蓋推理、訓練以至代理式工作流程。他熱衷教學,喜歡讓複雜的 AI 概念更易理解。

Ian Cairns
Ian 是 NVIDIA 的產品管理總監,與應用 AI 研究工程團隊合作,開發用於最佳化 Agent 的新 NVIDIA NeMo 產品及程式庫。加入 NVIDIA 之前,他共同創立 Freeplay,並出任行政總裁。Freeplay 是一款為 AI 工程師而設的大型語言模型(LLM)評估及實驗產品。他的背景包括開發面向開發人員的產品,亦曾出任 Twitter 開發人員平台的產品主管。
來源:AWS Machine Learning Blog · aws.amazon.com