Hugging Face 講解如何用 PyTorch / XLA 在 Cloud TPU 訓練 Transformers 模型
Hugging Face on PyTorch / XLA TPUs
Hugging Face 介紹以 PyTorch / XLA 在 Cloud TPU 訓練 Transformers 的整合方式,並保留 Hugging Face Trainer 原有介面。
文章梳理 PyTorch / XLA 接入 Hugging Face Trainer 的設備選擇、梯度同步與輸入流水線,並説明固定張量形狀對減少編譯成本的作用。

使用 PyTorch / XLA 在 Cloud TPU 上訓練你喜愛的 Transformers 模型
PyTorch-TPU 計劃源自 Facebook PyTorch 團隊與 Google TPU 團隊的合作,並於 2019 PyTorch Developer Conference 2019 正式推出。自此,我們一直與 Hugging Face 團隊合作,透過 PyTorch / XLA為 Cloud TPU 訓練提供一流支援。這項全新整合讓 PyTorch 用戶能在 Cloud TPU 上執行和擴展模型,同時維持完全相同的 Hugging Face Trainer 介面。
這篇網誌會概述 Hugging Face 函式庫的改動、PyTorch / XLA 函式庫的功能、如何開始在 Cloud TPU 上訓練你喜愛的 Transformers 模型,以及一些效能基準測試。如果你已迫不及待想開始使用 TPU,請直接跳到「在 Cloud TPU 上訓練 Transformer」一節;我們已在 Trainer 模組中替你處理所有 PyTorch / XLA 操作細節!
XLA:TPU 裝置類型
PyTorch / XLA 為 PyTorch 新增了 xla 裝置類型。這種裝置類型的運作方式與其他 PyTorch 裝置類型相同。例如,以下示範如何建立並輸出 XLA 張量:
import torch
import torch_xla
import torch_xla.core.xla_model as xm

t = torch.randn(2, 2, device=xm.xla_device())
print(t.device)
print(t)
這段程式碼應該看起來很熟悉。PyTorch / XLA 使用與一般 PyTorch 相同的介面,只作少量增補。匯入 torch_xla 便會初始化 PyTorch / XLA,而 xm.xla_device() 會傳回目前的 XLA 裝置。視乎你的環境,這可以是 CPU、GPU 或 TPU;不過本文會主要聚焦於 TPU。
Trainer 模組利用 TrainingArguments 資料類別定義訓練細節。它會處理多種參數,包括批次大小、學習率、梯度累積,以及所使用的裝置。根據以上內容,在使用 XLA:TPU 裝置時,我們只需在 TrainingArguments._setup_devices() 中傳回供 Trainer 使用的 TPU 裝置:
@dataclass
class TrainingArguments:
    ...
    @cached_property
    @torch_required
    def _setup_devices(self) -> Tuple["torch.device", int]:
        ...
        elif is_torch_tpu_available():
            device = xm.xla_device()
            n_gpu = 0
        ...

        return device, n_gpu
XLA 裝置步驟計算
在典型的 XLA:TPU 訓練情境中,我們會在多個 TPU 核心上平行訓練(單一 Cloud TPU 裝置包含 8 個 TPU 核心)。因此,我們需要整合梯度並執行最佳化器步驟,確保資料平行副本之間交換所有梯度。為此,我們提供 xm.optimizer_step(optimizer),負責整合梯度並執行步驟。在 Hugging Face Trainer 中,我們相應地更新訓練步驟,使用 PyTorch / XLA API:
class Trainer:
…
   def train(self, *args, **kwargs):
       ...
                    if is_torch_tpu_available():
                        xm.optimizer_step(self.optimizer)
PyTorch / XLA 輸入流程
執行 PyTorch / XLA 模型主要分為兩部分:(1) 延遲追蹤並執行模型計算圖(更深入的説明請參閲下方「PyTorch / XLA 函式庫」一節);以及 (2) 向模型提供輸入。如果沒有任何最佳化,模型的追蹤與執行會和輸入資料供應依序進行,令主機 CPU 和 TPU 加速器分別出現閒置時段。為避免這種情況,我們提供一個 API,把兩者安排在流水線中,讓第 n 步仍在執行時,同時追蹤第 n+1 步。
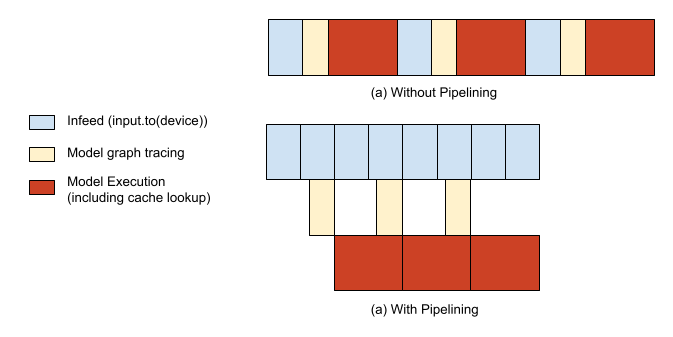
import torch_xla.distributed.parallel_loader as pl
...
  dataloader = pl.MpDeviceLoader(dataloader, device)
檢查點寫入與載入
XLA 裝置中的張量存入檢查點後再載入時,會載回原本的裝置。為模型中的張量建立檢查點前,應確保所有張量都位於 CPU 裝置,而非 XLA 裝置。這樣載入張量時便會先經由 CPU 裝置處理,之後你可再將它們放到所需的 XLA 裝置。我們為此提供 xm.save() API,它會確保每個主機只有一個程序(若主機之間共用檔案系統,則全域只有一個程序)寫入儲存位置。
class PreTrainedModel(nn.Module, ModuleUtilsMixin, GenerationMixin):
…
    def save_pretrained(self, save_directory):
        ...
        if getattr(self.config, "xla_device", False):
            import torch_xla.core.xla_model as xm

            if xm.is_master_ordinal():
                # Save configuration file
                model_to_save.config.save_pretrained(save_directory)
            # xm.save takes care of saving only from master
            xm.save(state_dict, output_model_file)
class Trainer:
…
   def train(self, *args, **kwargs):
       ...
       if is_torch_tpu_available():
           xm.rendezvous("saving_optimizer_states")
           xm.save(self.optimizer.state_dict(),
                   os.path.join(output_dir, "optimizer.pt"))
           xm.save(self.lr_scheduler.state_dict(),
                   os.path.join(output_dir, "scheduler.pt"))
PyTorch / XLA 函式庫
PyTorch / XLA 是一個 Python 套件,利用 XLA 線性代數編譯器,把 PyTorch 深度學習框架連接至 XLA 裝置,包括 CPU、GPU 和 Cloud TPU。以下部分內容亦載於我們的API_GUIDE.md。
PyTorch / XLA 張量採用延遲執行
使用 XLA 張量和裝置只需修改少量程式碼。不過,即使 XLA 張量與 CPU 和 CUDA 張量的操作方式相似,內部實作仍然不同。CPU 和 CUDA 張量會立即或急切地執行操作;相反,XLA 張量採用延遲執行,會先把操作記錄在計算圖中,直到需要結果時才執行。延後執行讓 XLA 可以進行最佳化。多個分開的操作所構成的計算圖,可能會融合成單一最佳化操作。
呼叫端通常不會察覺延遲執行。PyTorch / XLA 會自動建立計算圖、將它們傳送至 XLA 裝置,並在 XLA 裝置與 CPU 之間複製資料時同步。在執行最佳化器步驟時插入屏障,則會明確同步 CPU 和 XLA 裝置。
這表示當你呼叫 model(input) 前向傳播、計算損失 loss.backward(),再執行最佳化器步驟 xm.optimizer_step(optimizer) 時,所有操作的計算圖都會在背景建立。只有在你明確評估張量(例如輸出張量或把它移至 CPU 裝置),或標記一個步驟時,整個步驟才會執行;每次迭代 MpDeviceLoader 時都會標記步驟。
追蹤、編譯、執行,然後重複
從用戶角度看,在 PyTorch / XLA 上執行模型的典型訓練程序包括前向傳播、反向傳播和最佳化器步驟。但從 PyTorch / XLA 函式庫的角度看,流程略有不同。
用戶執行前向和反向傳播時,系統會即時追蹤中間表示法(IR)計算圖。每個根/輸出張量對應的 IR 計算圖可以如下檢視:
>>> import torch
>>> import torch_xla
>>> import torch_xla.core.xla_model as xm
>>> t = torch.tensor(1, device=xm.xla_device())
>>> s = t*t
>>> print(torch_xla._XLAC._get_xla_tensors_text([s]))
IR {
  %0 = s64[] prim::Constant(), value=1
  %1 = s64[] prim::Constant(), value=0
  %2 = s64[] xla::as_strided_view_update(%1, %0), size=(), stride=(), storage_offset=0
  %3 = s64[] aten::as_strided(%2), size=(), stride=(), storage_offset=0
  %4 = s64[] aten::mul(%3, %3), ROOT=0
}
這個即時計算圖會在用戶程式執行前向和反向傳播時累積;呼叫 xm.mark_step()(由 pl.MpDeviceLoader 間接呼叫)後,即時張量的計算圖便會截斷。這表示一個步驟完成,接着系統會把 IR 計算圖降階為 XLA 高階操作(HLO),這是 XLA 使用的 IR 語言。
接着,HLO 計算圖會編譯成 TPU 二進制檔,然後在 TPU 裝置上執行。不過,編譯成本可能很高,通常比單一步驟所需時間更長;若每一步都重新編譯用戶程式,額外開銷便會很大。為避免這種情況,我們會使用快取,按 HLO 計算圖的唯一雜湊識別碼儲存已編譯的 TPU 二進制檔。因此,第一步填滿 TPU 二進制快取後,之後通常毋須重新編譯新的 TPU 二進制檔,只需從快取查找所需檔案。
由於 TPU 編譯通常比步驟執行慢得多,如果計算圖形狀持續變化,便會出現快取未命中,導致過於頻繁地編譯。為盡量降低編譯成本,我們建議盡可能維持張量形狀固定。Hugging Face 函式庫的大部分張量形狀已固定,輸入 token 亦會適當填充,因此訓練過程中快取應能持續命中。你可使用 PyTorch / XLA 提供的偵錯工具檢查。以下示例顯示,編譯只發生 5 次(CompileTime),而執行則涵蓋 1220 個步驟(ExecuteTime):
>>> import torch_xla.debug.metrics as met
>>> print(met.metrics_report())
Metric: CompileTime
  TotalSamples: 5
  Accumulator: 28s920ms153.731us
  ValueRate: 092ms152.037us / second
  Rate: 0.0165028 / second
  Percentiles: 1%=428ms053.505us; 5%=428ms053.505us; 10%=428ms053.505us; 20%=03s640ms888.060us; 50%=03s650ms126.150us; 80%=11s110ms545.595us; 90%=11s110ms545.595us; 95%=11s110ms545.595us; 99%=11s110ms545.595us
Metric: DeviceLockWait
  TotalSamples: 1281
  Accumulator: 38s195ms476.007us
  ValueRate: 151ms051.277us / second
  Rate: 4.54374 / second
  Percentiles: 1%=002.895us; 5%=002.989us; 10%=003.094us; 20%=003.243us; 50%=003.654us; 80%=038ms978.659us; 90%=192ms495.718us; 95%=208ms893.403us; 99%=221ms394.520us
Metric: ExecuteTime
  TotalSamples: 1220
  Accumulator: 04m22s555ms668.071us
  ValueRate: 923ms872.877us / second
  Rate: 4.33049 / second
  Percentiles: 1%=045ms041.018us; 5%=213ms379.757us; 10%=215ms434.912us; 20%=217ms036.764us; 50%=219ms206.894us; 80%=222ms335.146us; 90%=227ms592.924us; 95%=231ms814.500us; 99%=239ms691.472us
Counter: CachedCompile
  Value: 1215
Counter: CreateCompileHandles
  Value: 5
...
在 Cloud TPU 上訓練 Transformer
如要設定 VM 和 Cloud TPU,請依照「設定 Compute Engine 執行個體」和「啟動 Cloud TPU 資源」(撰文時為 pytorch-1.7 版本)各節的指示操作。建立 VM 和 Cloud TPU 後,只需透過 SSH 連接 GCE VM,並執行以下指令,即可開始訓練 bert-large-uncased(批次大小適用於 v3-8 裝置,在 v2-8 上可能會發生記憶體不足):
conda activate torch-xla-1.7
export TPU_IP_ADDRESS="ENTER_YOUR_TPU_IP_ADDRESS"  # ex. 10.0.0.2
export XRT_TPU_CONFIG="tpu_worker;0;$TPU_IP_ADDRESS:8470"
git clone -b v4.2.2 https://github.com/huggingface/transformers.git
cd transformers && pip install .
pip install datasets==1.2.1
python examples/xla_spawn.py \
  --num_cores 8 \
  examples/language-modeling/run_mlm.py \
  --dataset_name wikitext \
  --dataset_config_name wikitext-103-raw-v1 \
  --max_seq_length 512 \
  --pad_to_max_length \
  --logging_dir ./tensorboard-metrics \
  --cache_dir ./cache_dir \
  --do_train \
  --do_eval \
  --overwrite_output_dir \
  --output_dir language-modeling \
  --overwrite_cache \
  --tpu_metrics_debug \
  --model_name_or_path bert-large-uncased \
  --num_train_epochs 3 \
  --per_device_train_batch_size 8 \
  --per_device_eval_batch_size 8 \
  --save_steps 500000
以上操作應可在約少於 200 分鐘內完成訓練,評估困惑度約為 3.25。
效能基準測試
下表顯示在 v3-8 Cloud TPU 系統(包含 4 顆 TPU v3 晶片)上使用 PyTorch / XLA 訓練 bert-large-uncased 的效能。所有基準測量都使用WikiText103資料集,並採用 Hugging Face 示例提供的 run_mlm.py 指令碼。為確保工作負載不受主機 CPU 限制,我們在這些測試中使用 n1-standard-96 CPU 配置;即使使用較小配置,效能或許也不會受影響。
| 名稱 | 資料集 | 硬件 | 全域批次大小 | 精度 | 訓練時間(分鐘) |
|---|---|---|---|---|---|
| bert-large-uncased | WikiText103 | 4 顆 TPUv3 晶片(即 v3-8) | 64 | FP32 | 178.4 |
| bert-large-uncased | WikiText103 | 4 顆 TPUv3 晶片(即 v3-8) | 128 | BF16 | 106.4 |
開始使用 PyTorch / XLA 和 TPU
請參閲 Hugging Face 示例中的「在 TPU 上執行」一節,開始使用。如要詳細瞭解我們的 API,請參閲API_GUIDE;如要了解效能最佳做法,請參閲疑難排解指南。如需一般 PyTorch / XLA 示例,請執行我們提供的Colab Notebooks,即可免費使用 Cloud TPU。若要直接在 GCP 上執行,請參閲我們文件網站上標示為「PyTorch」的教學。
還有其他問題或遇到狀況嗎?請在https://github.com/huggingface/transformers/issues提出 issue 或問題,亦可直接前往https://github.com/pytorch/xla/issues。
來源:Hugging Face Blog · huggingface.co