Hugging Face PEFT 新增 LoRA adapter 合併方法
🤗 PEFT welcomes new merging methods
Hugging Face 的 PEFT 新增多種面向 LoRA adapter 的合併方法,使用者可透過 `add_weighted_adapter()` 試驗不同組合。
文章逐項比較 cat、linear、SVD、TIES 與 DARE 等 LoRA 合併方法,並整理 rank、density 和 GPU 記憶體需求對實作選擇的影響。
模型合併迅速成為突破大型語言模型效能極限的業界標準。在 Open LLM Leaderboard 上,我們持續看到合併模型登上排行榜榜首。我們的 Omar Sanseviero 曾抽出時間研究模型合併,並發現一些有趣結果。
至今,典型的模型合併方式是取一組模型並將它們合併。這篇文章對此作了很好的入門介紹。一般來説,要合併多個模型,我們會先下載它們的檢查點,再進行合併。視乎合併演算法和底層模型規模,這個過程可能非常耗用記憶體。mergekit 程式庫提供經最佳化的處理方式,讓記憶體有限的環境也能應付。
但如果我們想合併從同一模型取得的不同「adapter」呢?你可能有從同一基礎模型取得的四個不同 LoRA 檢查點,並希望試驗不同合併技術,最後選出效果最佳、最適合任務的合併結果。要實現這種開發者體驗,有幾點很快便會變得清楚:
- 使用 LoRA 等 adapter 時,用戶經常切換不同 adapter,甚至將它們組合起來。Adapter 可以啟用、停用,或完全從記憶體中替換。因此,為用戶提供無縫體驗,我們需要即時進行「合併」,而非採用上述方法。
- 不同 adapter 可能有不同合併要求。例如,LoRA 的合併演算法未必同樣適用於 IA3。
考慮到這些因素,我們為 🤗 PEFT 中廣受歡迎的 LoRA adapter 推出全新的合併方法。本文會介紹現有方法、協助你快速上手的程式碼範例、令人印象深刻的成果,以及未來計劃。開始吧 🚀
目錄
組合/合併 LoRA adapter 的方法
串接(cat)
此方法會串接 LoRA 矩陣。例如,如果有 2 個 LoRA adapter (A1,B1) (A_1, B_1) 和 (A2,B2) (A_2, B_2) ,並分別以權重 weight1 weight_1 和 weight2 weight_2 加權合併這兩個 adapter,合併方式如下:
Amerged=concat(weight1∗scaling1∗A1,weight2∗scaling2∗A2,dim=0)A_{merged} = concat(weight_1*scaling_1*A_1, weight_2*scaling_2*A_2, dim=0)
Bmerged=concat(B1,B2,dim=1)B_{merged} = concat(B_1, B_2, dim=1)
其中 shape(Amerged)=(rank1+rank2, d))and(shape(Bmerged)=(d, rank1+rank2) shape(A_{merged}) = (rank_1+rank_2,\ d) )\ and \ ( shape(B_{merged}) = (d,\ rank_1+rank_2) 。
新的合併 LoRA 層輸出,會等同原來 2 個 LoRA 同時啟用,並分別套用權重 weight1weight_1 和 weight2weight_2 的結果。
h=W0x+BmergedAmergedxh = W_0x + B_{merged}A_{merged}x
由此可見:
BmergedAmerged=weight1∗scaling1∗B1A1+weight2∗scaling2∗B2A2B_{merged}A_{merged} = weight_1 * scaling_1 * B_1A_1 + weight_2 * scaling_2 * B_2A_2
🧠 這正是 LoRA adapter 的精確加權合併。在呼叫 Diffusers 的 PEFT 整合之 set_adapters() 時亦可使用此功能:系統不會建立新的合併 adapter,而會依序組合已啟用的 adapter,如上式右側所示。使用這種方法時,參與合併的 LoRA adapter 可有不同 rank。
線性/任務算術(linear)
此方法會對 LoRA 矩陣進行加權求和,正是《任務算術》論文對任務權重採用的方法。任務算術會先計算微調後權重與基礎模型權重之間的差異,作為任務權重,再對這些任務權重作加權求和。此處的差異權重是個別矩陣 AA 和 BB,而非兩者的乘積 BABA。只有所有參與合併的 LoRA adapter rank 相同,才能使用此方法。
以下舉例説明。假設有 2 個 LoRA adapter (A1,B1) (A_1, B_1) 和 (A2,B2) (A_2, B_2) ,並分別以權重 weight1 weight_1 和 weight2 weight_2 加權合併,合併方式如下:
Amerged=sqrt(weight1∗scaling1)∗A1+sqrt(weight2∗scaling2)∗A2A_{merged} = sqrt(weight_1 * scaling_1) * A_1+ sqrt (weight_2 * scaling_2) * A_2
Bmerged=sqrt(weight1∗scaling1)∗B1+sqrt(weight2∗scaling2)∗B2B_{merged} = sqrt(weight_1 * scaling_1) * B_1+ sqrt (weight_2 * scaling_2) * B_2
詳情請參閲論文:使用任務算術編輯模型。
SVD(svd)
此方法不把個別矩陣 A A 和 B B 視為任務權重,而是將兩者的乘積 BA BA (即差異權重)視為任務權重。
繼續使用前幾節的例子:首先按以下方式計算合併組合的差異權重:
deltamerged=weight1∗scaling1∗B1A1+weight2∗scaling2∗B2A2delta_{merged} = weight_1 * scaling_1 * B_1A_1 + weight_2 * scaling_2 * B_2A_2
取得上述合併差異權重後,再套用 SVD(奇異值分解),以取得近似矩陣 Amerged_approx A_{merged\_approx} 和 Bmerged_approx B_{merged\_approx} :

🧠 與 cat 方法類似,此方法亦支援不同 rank 的 LoRA adapter。此外,用戶可選擇合併後 LoRA adapter 的 rank;預設為所有參與合併的 adapter 中最高的 rank。此方法的限制是執行 SVD 運算需要大量 GPU 記憶體。
TIES(ties、ties_svd)
此方法延伸 linear 和 svd 方法,改變根據任務權重計算合併 adapter 的方式,分別形成 ties 和 ties_svd。在 TIES(TRIM、ELECT SIGN & MERGE)中,首先計算任務權重:非 SVD 版本使用 LoRA adapter A A 、B B ,SVD 版本則使用其乘積 BA BA 。接着,按指定的 density 比例剪除任務權重中最小的值,保留最大的 k 個值。然後,根據參與合併的剪枝任務權重計算多數符號遮罩,以用戶提供的權重縮放任務張量,再按多數符號遮罩進行互不重疊的合併。計算多數符號遮罩有兩個選項:
total同時考慮幅值和符號來判定多數符號,即將所有對應權重相加;frequency只考慮權重符號來判定多數符號,即將所有對應權重的符號相加。
詳情請參閲論文:TIES-Merging:解決模型合併時的幹擾。
DARE(dare_linear、dare_ties、dare_linear_svd、dare_ties_svd)
這同樣延伸 linear 和 svd 方法:非 SVD 版本以 LoRA adapter A A 、B B 作為任務權重,SVD 版本則以其乘積 BA BA 作為任務權重。DARE 方法由《語言模型就是超級瑪利歐:免費吸收同源模型的能力》提出,會按指定比例 1-density 隨機剪除任務權重的值,再將剪枝後的權重按 1/density 重新縮放。DARE 是通用插件,可套用於任何現有模型合併方法。我們已實作 DARE 結合線性/任務算術(*_linear*)和 TIES(*_ties*)的方法。
對於 *_linear* 這類 DARE 變體,我們先用 DARE 隨機剪除任務權重,再按照用戶指定的權重,對參與合併 LoRA adapter 的任務張量作加權求和。
對於 *_ties* 這類 DARE 變體,我們先用 DARE 取得剪枝後的任務權重,再採用 ties 的最後兩個步驟:計算多數符號遮罩,並使用遮罩對任務權重進行互不重疊的合併。
幅值剪枝(magnitude_prune、magnitude_prune_svd)
這同樣延伸 linear 和 svd 方法:非 SVD 版本以 LoRA adapter A A 、B B 作為任務權重,SVD 版本則以其乘積 BA BA 作為任務權重。此方法會先按指定的 density 比例剪除任務權重中最小的值,保留最大的 k 個值,再依用戶指定的權重,對參與合併 LoRA adapter 的任務張量進行加權求和。
如何合併 LoRA adapter?
在 PEFT 中使用 LoRA 時,可透過類別方法 add_weighted_adapter() 試用不同組合方法。例如,下方示範如何使用 ties 方法組合三個 LoRA adapter,以及新合併 adapter 產生的結果。可以看到,合併後的 adapter 保留了各個 adapter 的能力:
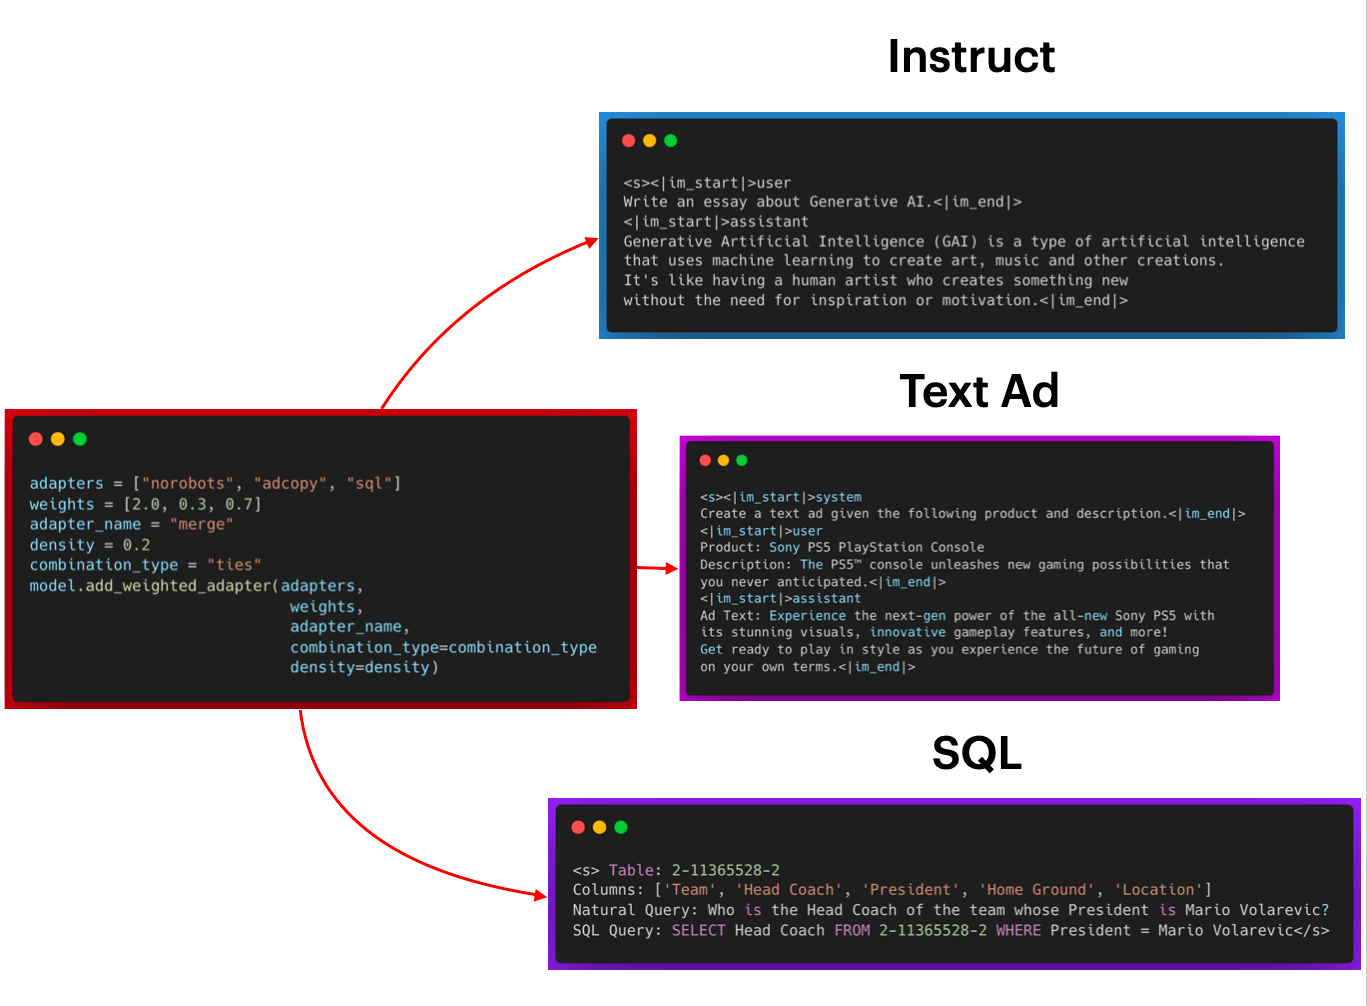
以上範例可在 PEFT 儲存庫的範例中找到。
以下再以 magnitude_prune 方法和生成結果作另一個示範。
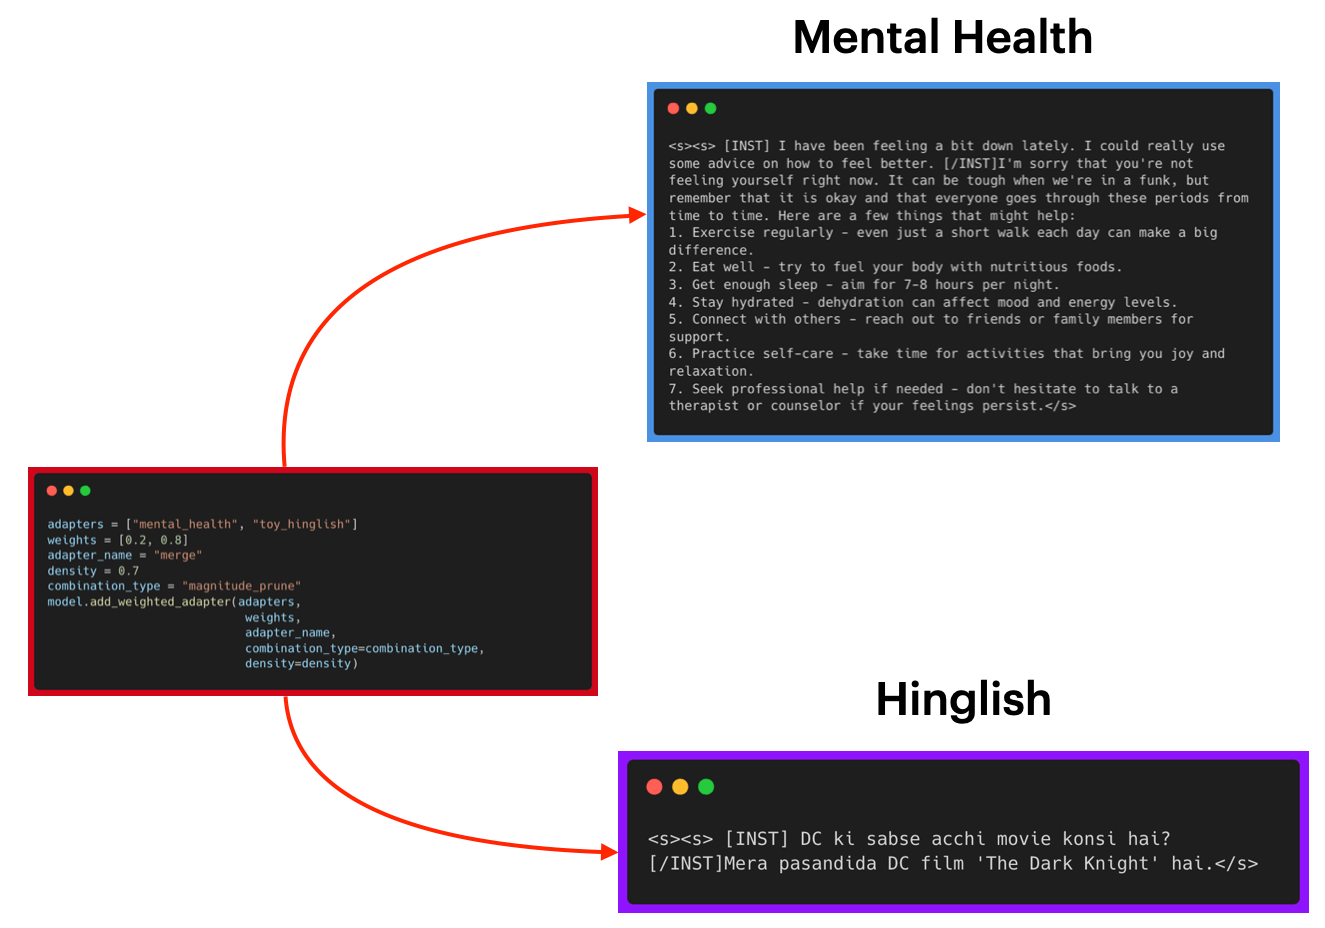
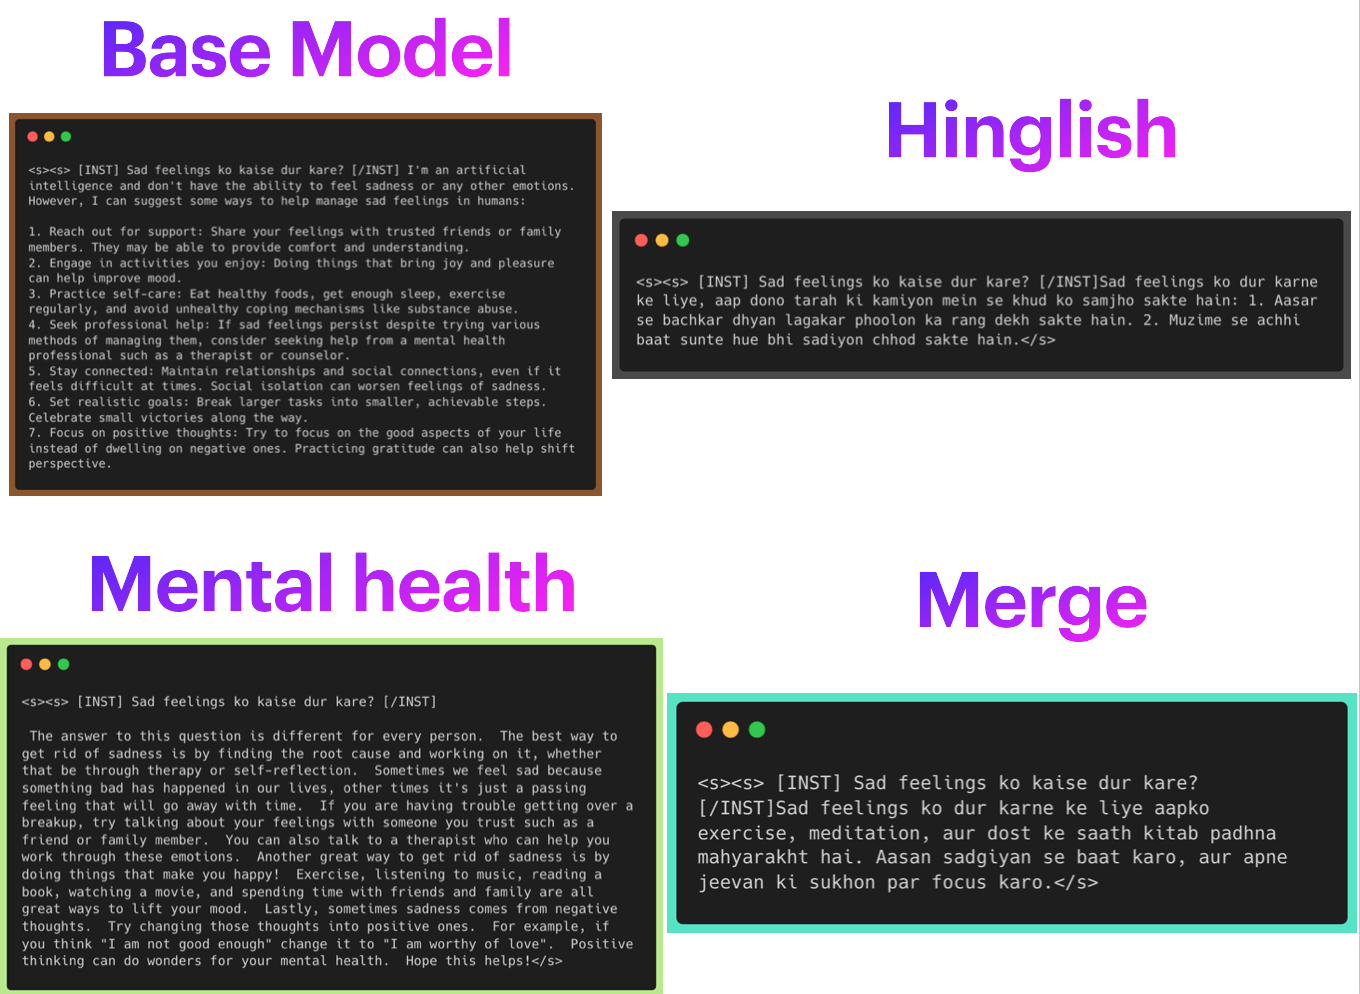
那麼,如果要使用合併 adapter 的能力,以 Hinglish 回答心理健康相關問題呢?這需要同時運用兩個 adapter 的能力。以下查看問題「Sad feelings ko kaise dur kare?」(翻譯:如何擺脱悲傷?)的結果。停用所有 adapter、使用基礎模型時,回應先表示自己是 AI,接着提供一般建議。啟用 hinglish adapter 後,回應會依照微調資料以 Hinglish 簡短作答,但未能提供有效克服悲傷的具體建議。啟用 mental_health adapter 後,回應內容像人類會説的話,可惜不是 Hinglish。啟用 merge adapter 後,回應便以 Hinglish 簡短作答,並提供 mental_health adapter 回應中的具體建議,例如運動、與朋友相處、閲讀、冥想和專注正向思考。因此,合併 adapter 能結合各自能力,支援新的使用情境。
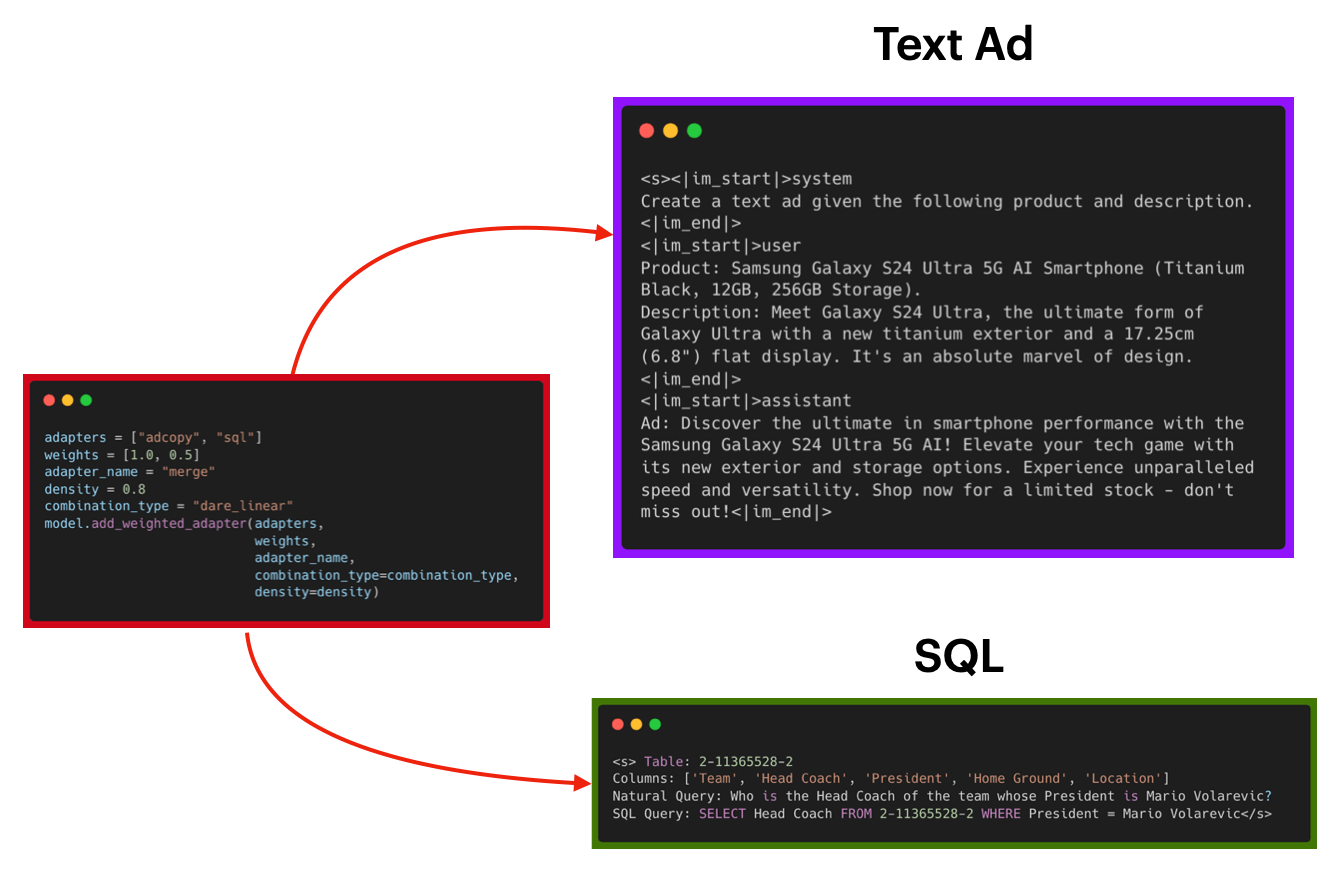
最後,我們以 dare_linear 為例,查看生成結果。
PEFT 為這些合併方法提供專用開發者指南。
延伸至文字轉圖片生成
本節示範如何在 🤗 Diffusers 中運用這些合併方法進行文字轉圖片生成。請注意,Diffusers 的 LoRA 功能(包括訓練和推論)已採用 PEFT。然而,目前在 Diffusers pipeline 呼叫 set_adapters() 時,尚未能使用新的合併方法。因此,我們正與社羣公開討論如何在 Diffusers 內原生支援此功能。
不過,有 PEFT 就總有方法繞過這項限制。我們會使用 add_weighted_adapter() 功能。具體來説,我們會按以下步驟組合「toy-face」LoRA 和 「Pixel-Art」LoRA,並試驗不同合併技術:
- 從這些 LoRA 檢查點取得
PeftModel。 - 合併這些
PeftModel時,使用add_weighted_adapter()方法和所選合併方法。 - 將合併模型指派至底層
DiffusionPipeline的相應組件。
現在看看實際操作。以下各部分展示的程式碼均來自這份 Colab Notebook。
由於兩個 LoRA 檢查點均以 SDXL UNet 為基礎模型,我們先載入 UNet:
from diffusers import UNet2DConditionModel
import torch

unet = UNet2DConditionModel.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
    subfolder="unet",
).to("cuda")
接着載入 SDXL pipeline 和 LoRA 檢查點。先從「CiroN2022/toy-face」LoRA 開始:
from diffusers import DiffusionPipeline
import copy

sdxl_unet = copy.deepcopy(unet)
pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
     variant="fp16",
     torch_dtype=torch.float16,
     unet=unet
).to("cuda")
pipe.load_lora_weights("CiroN2022/toy-face", weight_name="toy_face_sdxl.safetensors", adapter_name="toy")
現在從已載入的 LoRA 檢查點取得 PeftModel:
from peft import get_peft_model, LoraConfig

toy_peft_model = get_peft_model(
    sdxl_unet,
    pipe.unet.peft_config["toy"],
    adapter_name="toy"
)

original_state_dict = {f"base_model.model.{k}": v for k, v in pipe.unet.state_dict().items()}
toy_peft_model.load_state_dict(original_state_dict, strict=True)
💡 你亦可選擇使用以下方式將 toy_peft_model 推送至 Hub:toy_peft_model.push_to_hub("toy_peft_model", token=TOKEN)。
接着以相同步驟處理「nerijs/pixel-art-xl」LoRA:
pipe.delete_adapters("toy")
sdxl_unet.delete_adapters("toy")

pipe.load_lora_weights("nerijs/pixel-art-xl", weight_name="pixel-art-xl.safetensors", adapter_name="pixel")
pipe.set_adapters(adapter_names="pixel")

pixel_peft_model = get_peft_model(
    sdxl_unet,
    pipe.unet.peft_config["pixel"],
    adapter_name="pixel"
)

original_state_dict = {f"base_model.model.{k}": v for k, v in pipe.unet.state_dict().items()}
pixel_peft_model.load_state_dict(original_state_dict, strict=True)
現在已備妥加權 adapter 推論所需項目!先載入所有必要內容:
from peft import PeftModel
from diffusers import UNet2DConditionModel, DiffusionPipeline
import torch

base_unet = UNet2DConditionModel.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0",
    torch_dtype=torch.float16,
    use_safetensors=True,
    variant="fp16",
    subfolder="unet",
).to("cuda")

toy_id = "sayakpaul/toy_peft_model"
model = PeftModel.from_pretrained(base_unet, toy_id, use_safetensors=True, subfolder="toy", adapter_name="toy")
model.load_adapter("sayakpaul/pixel_peft_model", use_safetensors=True, subfolder="pixel", adapter_name="pixel")
現在合併 LoRA adapter,終於來到期待已久的時刻!
model.add_weighted_adapter(
    adapters=["toy", "pixel"],
    weights=[0.7, 0.3],
    combination_type="linear",
    adapter_name="toy-pixel"
)
model.set_adapters("toy-pixel")
此處先採用「linear」合併策略,之後會試驗 TIES 等其他較特別的合併演算法。最後將 model 指派至 DiffusionPipeline 並執行推論:
model = model.to(dtype=torch.float16, device="cuda")

pipe = DiffusionPipeline.from_pretrained(
    "stabilityai/stable-diffusion-xl-base-1.0", unet=model, variant="fp16", torch_dtype=torch.float16,
).to("cuda")

prompt = "toy_face of a hacker with a hoodie, pixel art"
image = pipe(prompt, num_inference_steps=30, generator=torch.manual_seed(0)).images[0]
image
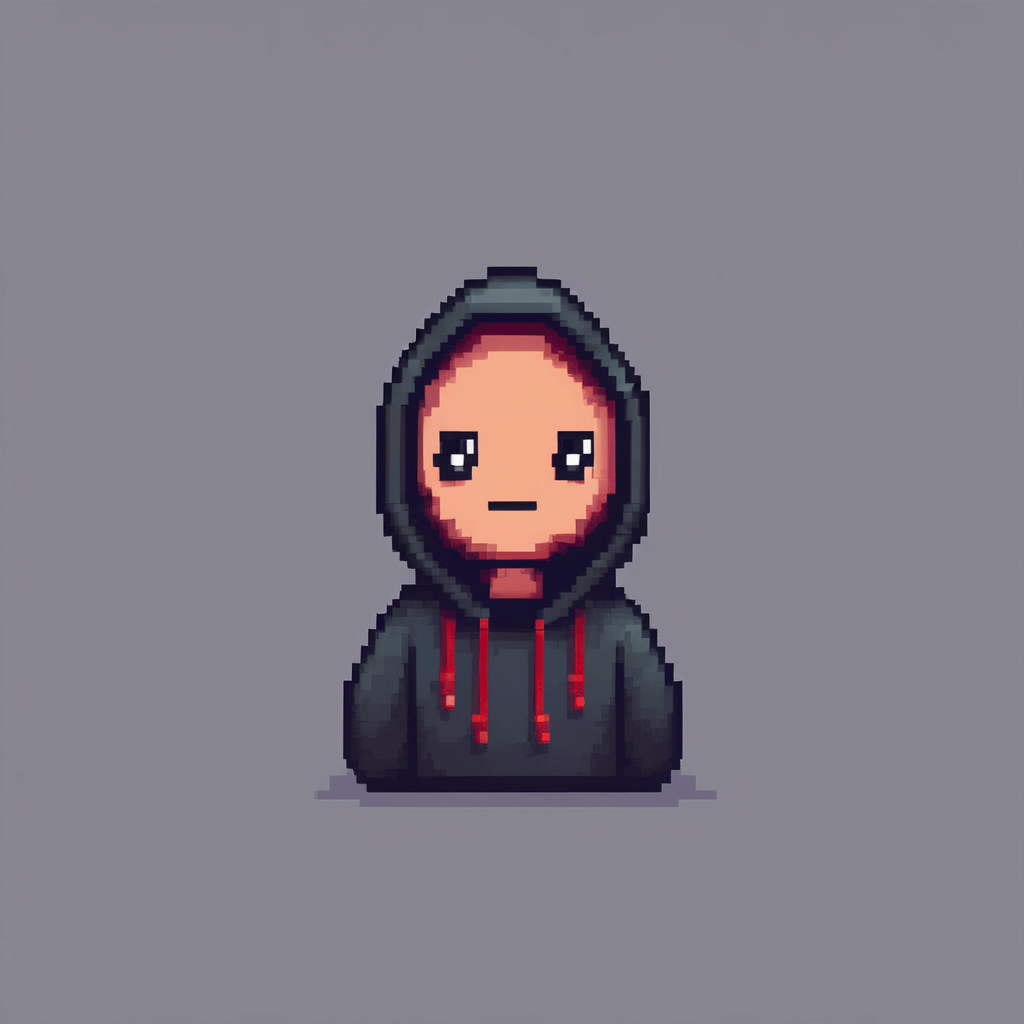
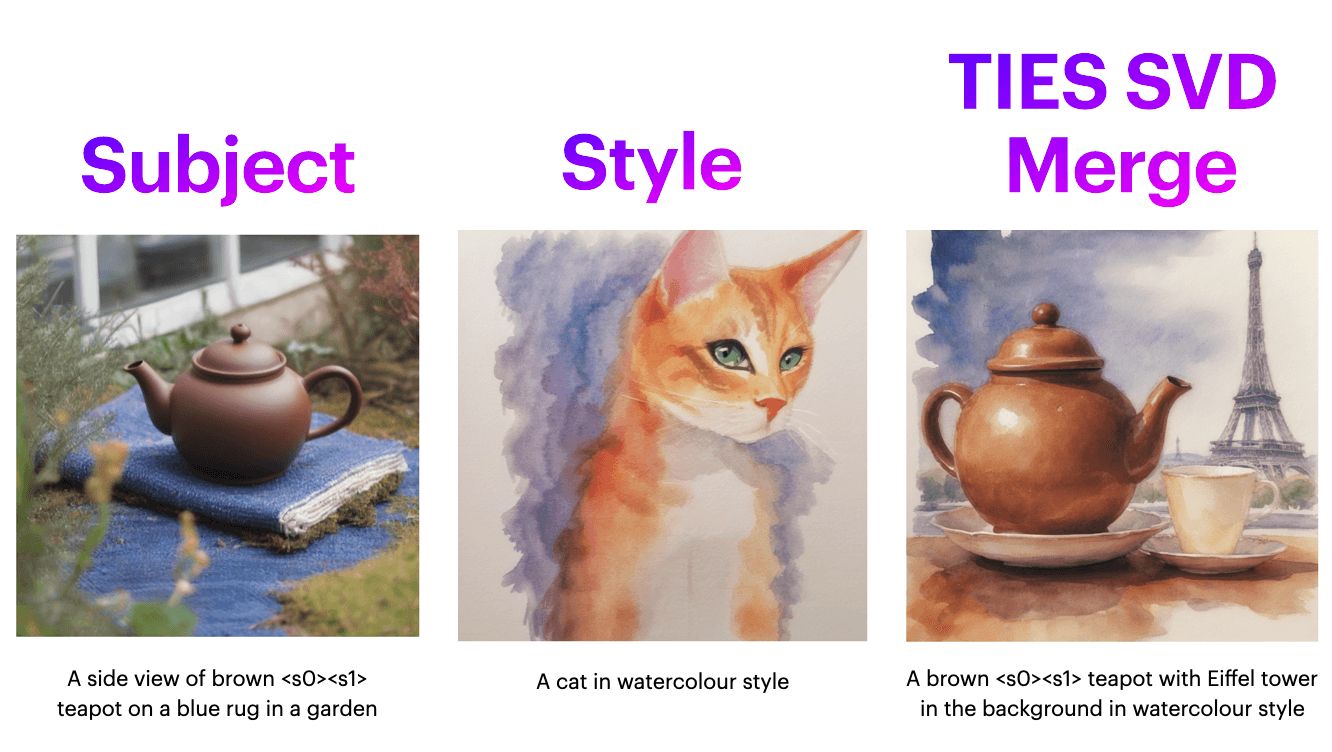
現在試試 ties_svd 方法。你可在此處找到範例 notebook。
pipe.unet.add_weighted_adapter(
    ["teapot","watercolour"],
    [1.0, 1.0],
    "merge",
    combination_type="ties_svd",
    density=0.5
)
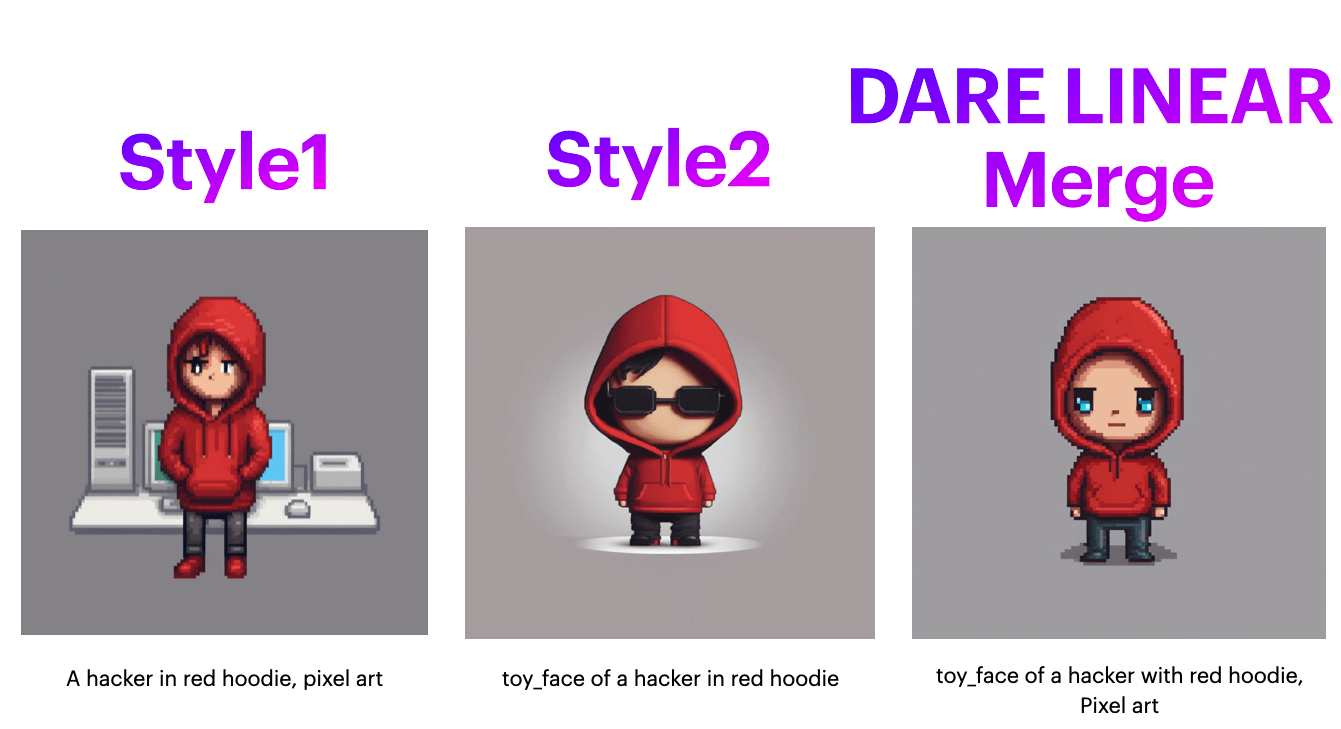
現在試試以 dare_linear 合併兩個風格 LoRA:
model.add_weighted_adapter(
    adapters=["toy", "pixel"],
    weights=[1.0, 1.0],
    combination_type="dare_linear",
    adapter_name="merge",
    density=0.7
)
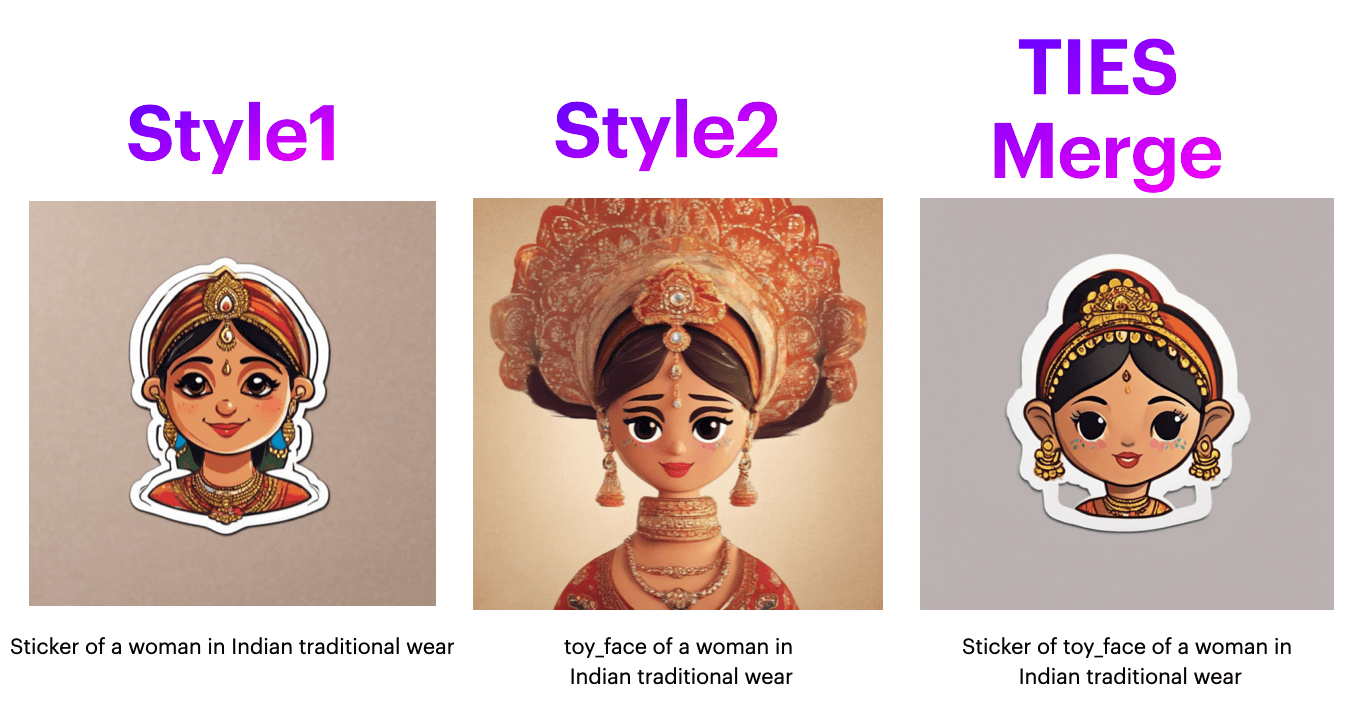
現在試試使用 ties 方法,並設定 majority_sign_method="frequency":
model.add_weighted_adapter(
    adapters=["toy", "sticker"],
    weights=[1.0, 1.0],
    combination_type="ties",
    adapter_name="merge",
    density=0.5,
    majority_sign_method="frequency"
)
觀察結果
- 大部分情況下,
cat方法都能帶來出色結果,建議先從此方法開始。不過請注意,若組合多個 adapter,串接可能令合併後的 adapter 體積變大,導致記憶體不足(OOM)。因此,探索少量 adapter 時,cat是不錯的起點。 - 如果你想進一步探索,或
cat效果不理想,可依序嘗試linear、maginuted_prune和dare_linear。我們發現,對maginuted_prune和dare_linear而言,約 0.7-0.8 的較高density值效果較好。 - 使用
ties時,我們發現不少情況下majority_sign_method="frequency"的表現勝過majority_sign_method="total"(目前預設為total)。對 TIES 而言,density的理想預設值為 0.5。合併 adapter 後,可按觀察結果再嘗試調高或調低此值。 dare_ties的效果不理想。- 合併 rank 不同的 Stable Diffusion LoRA adapter 時,可試用
*svd系列方法。請注意,這些方法需要更多 GPU 記憶體,而且昂貴的 SVD 運算令建立合併 adapter 約需 1.5 分鐘。如上方範例所示,使用ties_svd組合subject+styleLoRA 時效果良好。組合兩個styleadapter 時,如上方範例所示,dare_linear搭配較高density,或ties搭配majority_sign_method="frequency",似乎效果更好。
鳴謝
我們感謝 DARE 和 TIES 的作者 Le Yu 與 Prateek Yadav,慷慨地為PR提供意見和指導。為肯定他們的付出,我們已將兩人列為 PR 共同作者。亦感謝 Prateek 和 Le 審閲網誌文章草稿。
實用連結
- 使用任務算術編輯模型
- TIES-Merging:解決模型合併時的幹擾
- 語言模型就是超級瑪利歐:免費吸收同源模型的能力
- mergekit:合併預訓練大型語言模型的工具。
- Diffusers 中的 PEFT 整合
- PEFT 用戶的模型合併指南
引用
@inproceedings{
    ilharco2023editing,
    title={Editing models with task arithmetic},
    author={Gabriel Ilharco and Marco Tulio Ribeiro and Mitchell Wortsman and Ludwig Schmidt and Hannaneh Hajishirzi and Ali Farhadi},
    booktitle={The Eleventh International Conference on Learning Representations },
    year={2023},
    url={https://openreview.net/forum?id=6t0Kwf8-jrj}
}
@inproceedings{
    yadav2023tiesmerging,
    title={{TIES}-Merging: Resolving Interference When Merging Models},
    author={Prateek Yadav and Derek Tam and Leshem Choshen and Colin Raffel and Mohit Bansal},
    booktitle={Thirty-seventh Conference on Neural Information Processing Systems},
    year={2023},
    url={https://openreview.net/forum?id=xtaX3WyCj1}
}
@misc{yu2023language,
    title={Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch},
    author={Le Yu and Bowen Yu and Haiyang Yu and Fei Huang and Yongbin Li},
    year={2023},
    eprint={2311.03099},
    archivePrefix={arXiv},
    primaryClass={cs.CL}
}
@misc{
    mergekit,
    author = {Charles O. Goddard and contributors},
    title = {mergekit},
    year = {2023},
    publisher = {GitHub},
    journal = {GitHub repository},
    howpublished = {\url{https://github.com/arcee-ai/mergekit}}
}
來源:Hugging Face Blog · huggingface.co