Apertus 1.5 發佈説明:新增圖像與音訊理解,上下文窗口擴至 262,144 tokens
Apertus 1.5 Release Notes
Apertus 1.5 更新 8B 和 70B 模型,加入圖像與音訊理解及可選思考模式,並將上下文窗口擴至 262,144 tokens。持續預訓練分別為 8B 和 70B 模型加入 4 trillion tokens 和 2 trillion tokens 的文字及多模態訓練資料,總訓練量分別達 19T 和 17T。
文章同時公開訓練資料、各階段檢查點與可重跑的評測記錄,讀者可據此瞭解 Apertus 1.5 的訓練流程及比較評測結果。
我們最新推出的 Apertus 1.5,在 Apertus 1.0 的 8B 和 70B 模型基礎上,加入圖像/音訊理解、可選的思考模式、長四倍的上下文視窗、改進的指示遵循能力,以及更佳的工具使用能力。更新後的 8B 和 70B 模型權重已於 2026年7月24日以 Apache 2.0 授權條款發布至 Hugging Face。更多詳情現已刊載於項目的技術報告,並在此作摘要介紹。
Apertus 1.5 是在第一代模型上繼續預訓練而成:為 8B 模型加入 4 萬億個文字及多模態訓練數據 token,為 70B 模型加入 2 萬億個 token,令兩者的總數分別達到 19T 和 17T。與每次推出 Apertus 模型一樣,這些模型完全開放:開放權重、開放數據、開放價值觀,並公開完整的訓練詳情。
主要改進
- 原生多模態理解:除了文字,Apertus 1.5 亦可接收圖像和音訊,讓文件、圖表和相片都能融入對話。模型亦可處理口語,但這項功能仍屬實驗性質。
- 思考模式:模型可切換至思考模式,在回答前先對輸入進行推理,從而提升處理推理問題的表現。
- 長上下文:上下文視窗增至 262,144 個 token,較 Apertus 1.0 長 4 倍。
- 改進指示遵循能力:相比 Apertus 1.0,模型更能遵循指示,回應亦更可預測和準確。
- 改進工具使用能力:模型經過訓練,能更有效整合工具,並更有效地使用外部工具和 API。
- 開放價值觀:模型更能遵循 Apertus Charter,令其價值觀和原則更透明。
訓練流程
 Apertus 1.5 的完整訓練流程
透過 Tokenizer 實現多模態
我們在 v1.5 模型中以早期融合方式引入多模態:圖像和音訊會像文字 token 一樣,以離散 token 形式進入 Apertus 的同一序列,而非使用獨立的視覺編碼器。圖像使用 Emu3.5 Tokenizer 轉換為 token(一張 512×512 圖像會轉換為 1,024 個 token),音訊則使用 WavTokenizer(每秒 40 個 token)。我們只擴充詞彙表,因此架構維持不變,訓練速度亦與純文字訓練相同。模型能理解圖像和音訊,但只會生成文字。

預訓練
我們以 Apertus 1.0 為基礎,分四個階段繼續預訓練:
- 未配對:文字加上獨立的圖像和音訊,讓模型學習新的模態。
- 配對:圖像-説明文字及音訊-轉錄文字配對,讓模型學習將它們與語言對齊。
- 冷卻階段:使用更高質素的數據,增加數學及程式碼內容。
- 長上下文:逐步將上下文視窗由 8k 擴大至 262k 個 token。
整體而言,超過一半的訓練 token 為純文字,藉此保留 Apertus 1.0 的語言能力。文字數據已更新,採用的來源包括 FineWeb2-HQ+、FinePDFs 和 Nemotron-CC。所有新增數據(包括多模態數據)均符合以往相同的標準:公開可用、採用寬鬆授權,並追溯尊重 robots.txt 中的退出選項。每個來源均列於 apertus-data-transparency。
後訓練
後訓練分五個階段進行:SFT → 長上下文 SFT → RL → DPO → 憲章對齊 (SDPO)。
- 使用 3.7M 個文字樣本,以及圖像和語音資料進行 SFT。只有在模型無法自行解決提示詞時,才會加入推理軌跡。工具使用資料僅限於經執行驗證的軌跡。我們在 Hugging Face 發佈了所用的文字 SFT 混合資料。
- 在完整的 262k 上下文視窗進行長上下文 SFT,恢復短上下文 SFT 會削弱的長上下文能力。
- 使用約 350k 個數學、程式碼、指令遵循、多語言及視覺提示詞進行可驗證獎勵的 RL (RLVR),並混合使用思考模式和非思考模式。
- 使用由評審評分的偏好配對進行 DPO,以提升聊天品質、工具使用能力和安全性。我們發佈了偏好資料集及訓練配對。
- SDPO 透過評審回饋和自我蒸餾,讓模型與 Apertus Charter 保持一致。
評估結果
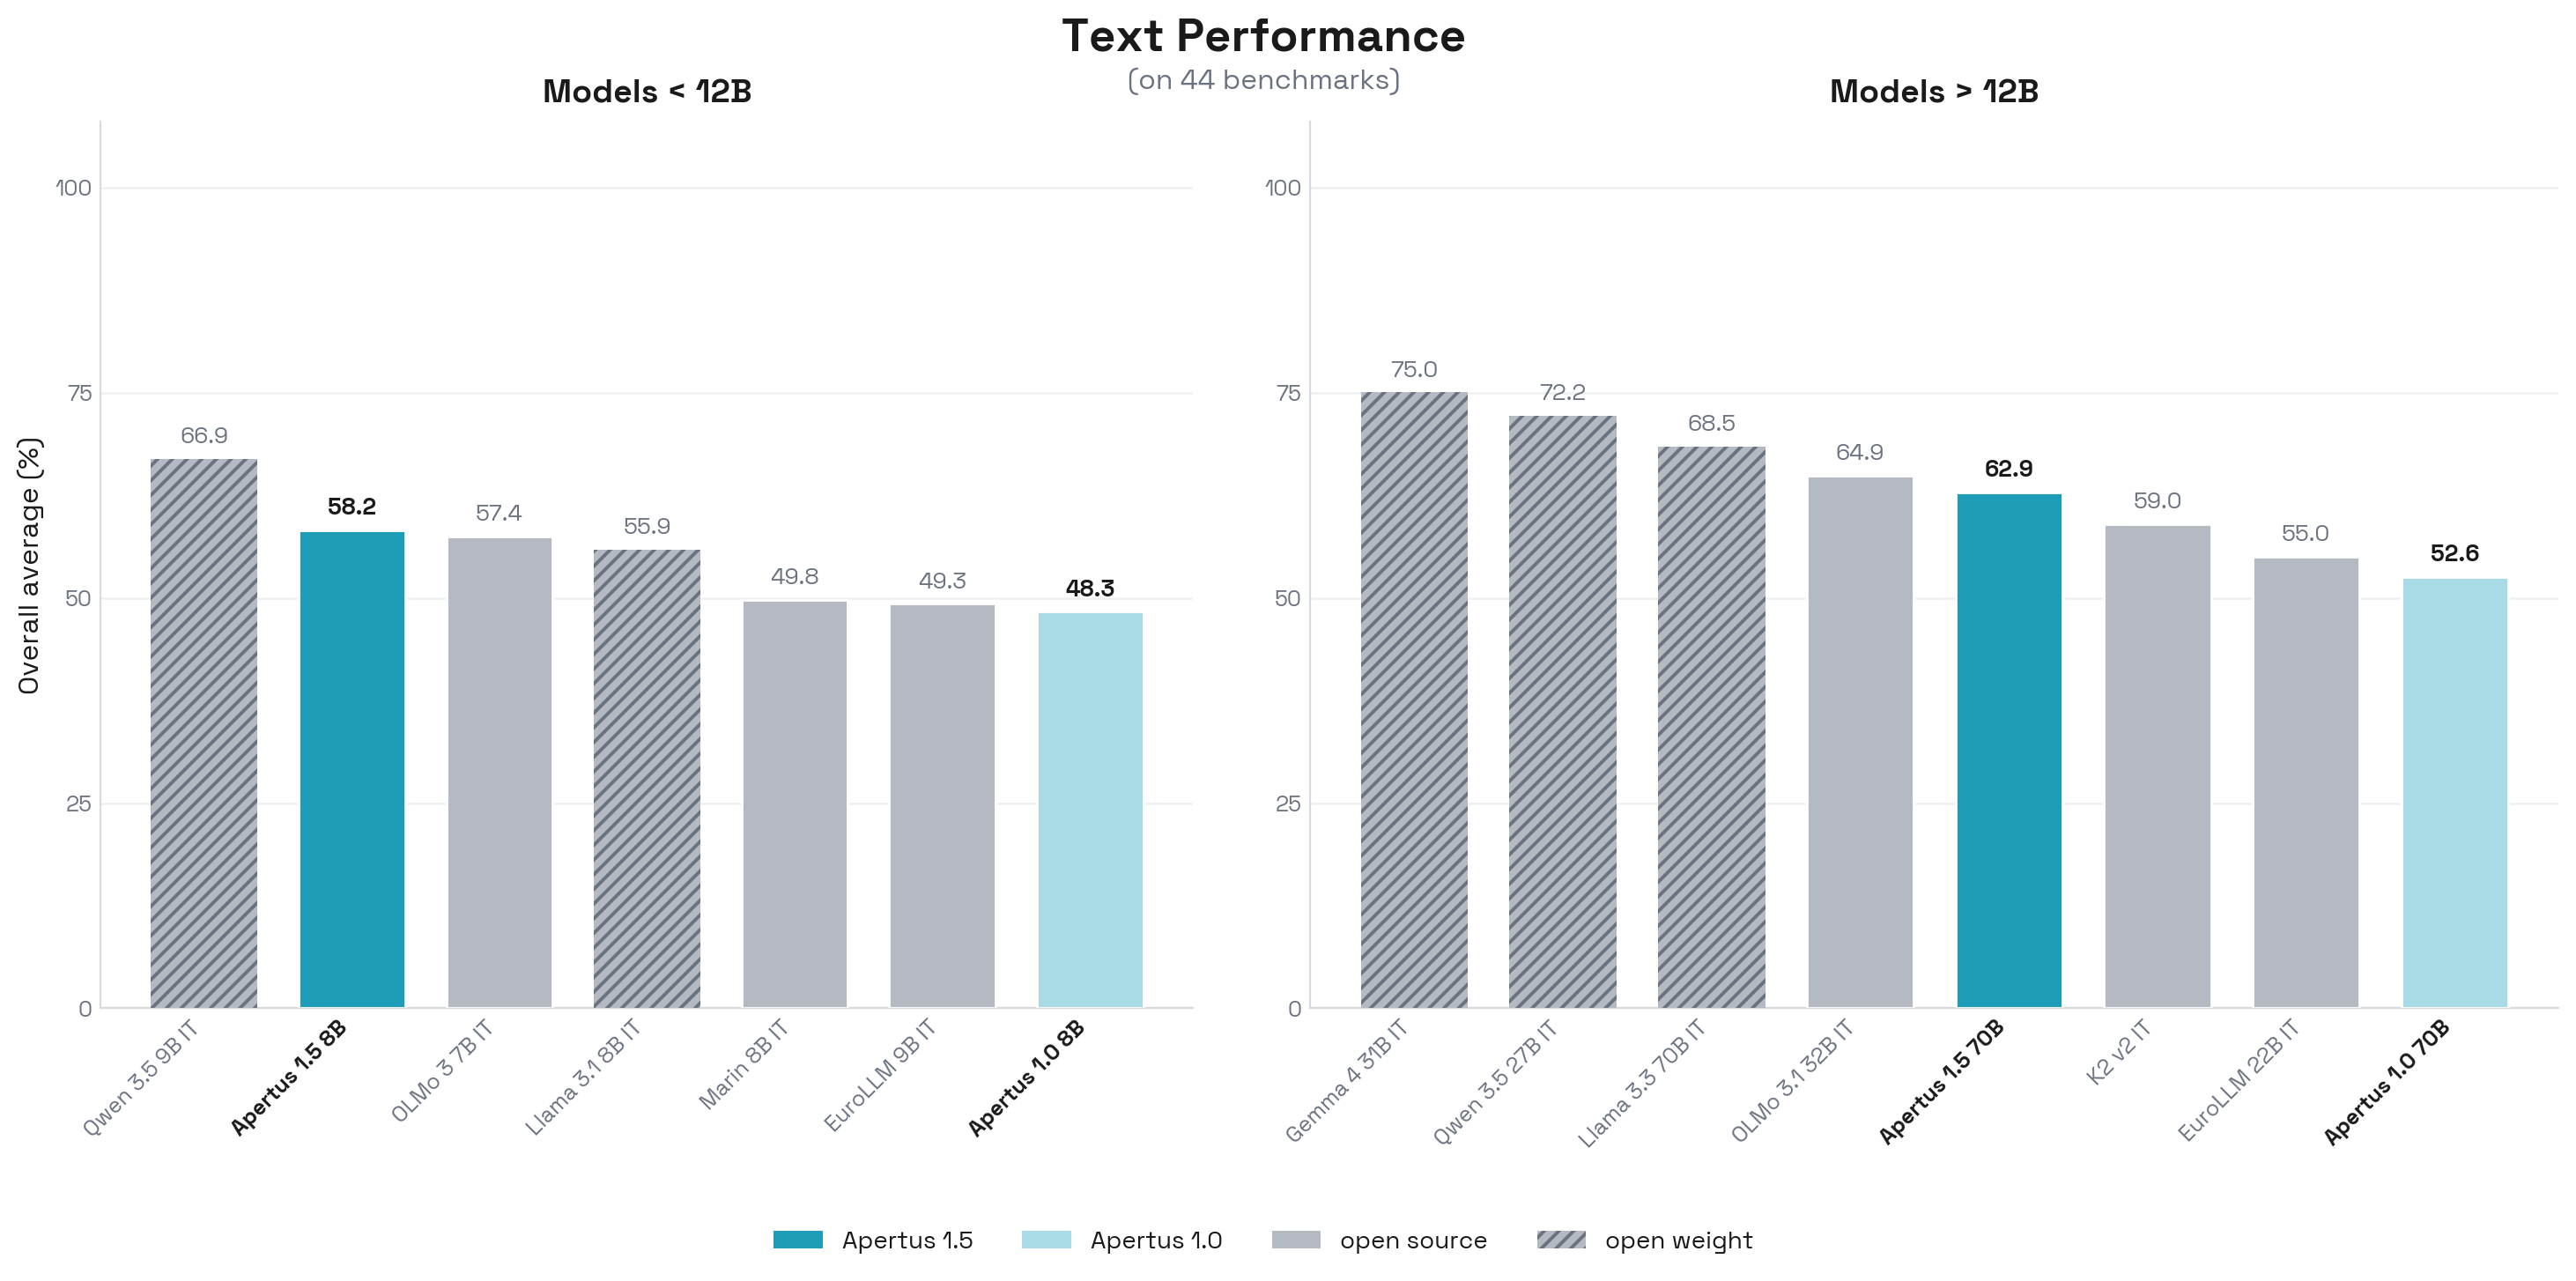
除了擴展模型能力外,我們亦大幅擴大了評估範圍。除了 Apertus 1.0 使用的既有文字評估外,我們亦加入多模態評估(圖像與音訊)及思考模式評估。
多模態評估透過 MLLM-eval-suite 流程進行,整合兩個主要的多模態評估框架 lmms-eval 和 VLMEvalKit。我們亦加入了一系列文字基準測試,並擴展翻譯及多語言能力、安全性和工具使用方面的基準測試。這些內容可在我們的後訓練評估儲存庫中找到;該儲存庫以 lm-evaluation-harness 分支版本為基礎。
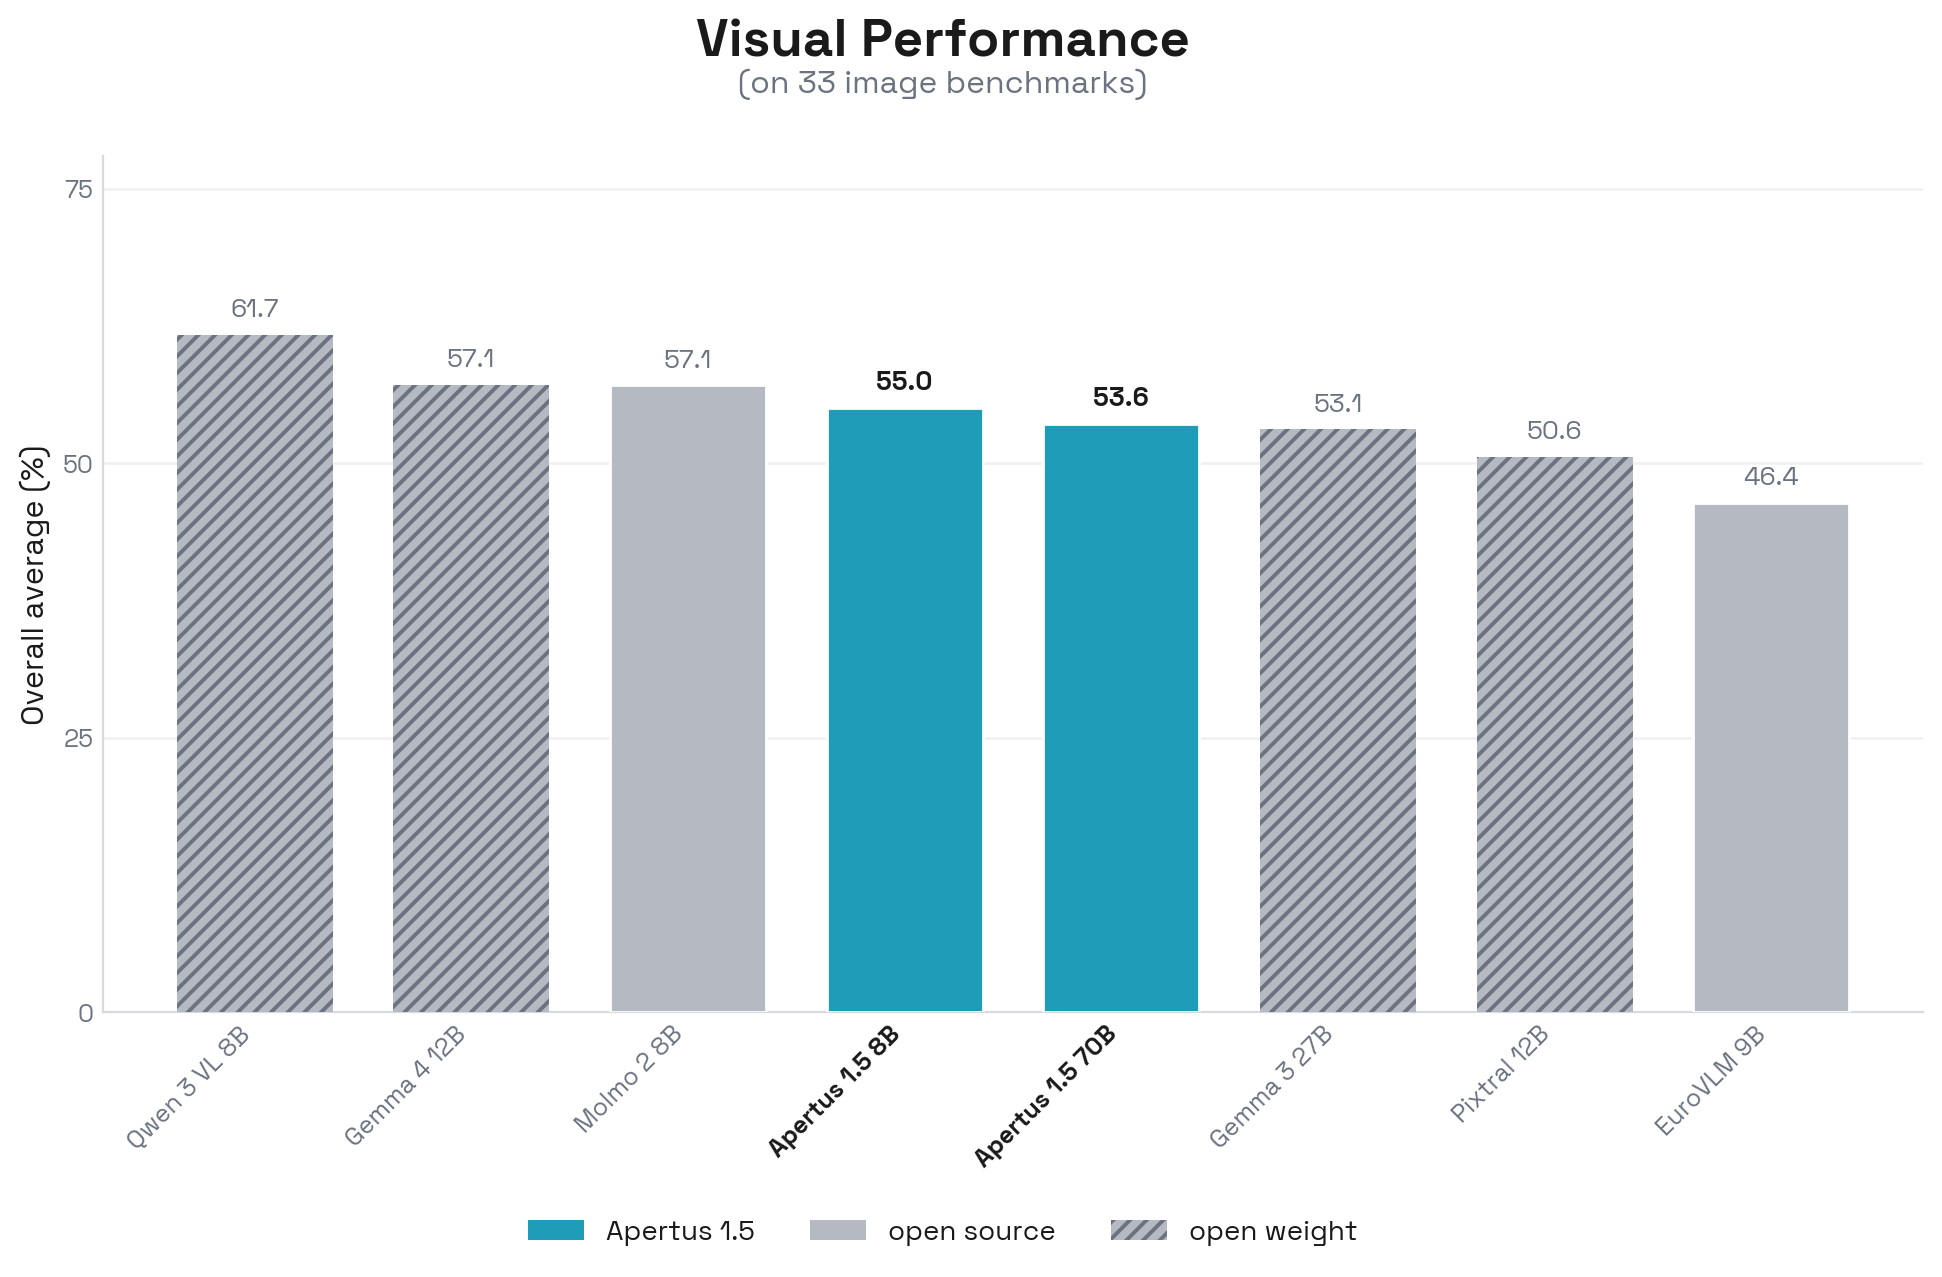
雖然新版本的表現仍落後於頂尖開放權重模型,但其程式編寫和指令遵循能力亦大幅提升;Apertus 1.5 8B 在 IF 和多語言任務上的表現勝過規模相近的開放權重模型。在 AIME 等具挑戰性、側重推理能力的基準測試中,思考模式可進一步提升表現。模型的多模態表現更接近 Gemma 4 12B 及其他現有開放權重模型。Apertus 1.5 在開放權重模型的空間理解方面,以及在開源模型的文件和圖表理解方面,均具競爭力。
我們亦感謝合作夥伴和外部評估人員協助有效率地對 Apertus 的能力進行基準測試。Apertus 1.5 在瑞士法律任務上尤其表現出色,媲美領先的開放權重模型(網誌、程式碼)。此外,在 Last Translation Benchmark 中,Apertus 1.5 8B 展現的機器翻譯能力媲美 GPT-OSS-20B,並勝過 Claude Haiku 4.5 或 Google Translate 等模型(排行榜、論文)。
評估卡:Apertus ❤️ EvalEval
Apertus 與 EvalEval Coalition 合作,確保基準測試完全透明且可重現。我們按照 Every Eval Ever (EEE) 架構發布 Apertus 1.5 的結果。這是一種共用格式,不但記錄評分,亦記錄由誰執行評測、如何存取模型、生成設定,以及每項指標應如何解讀:這些細節通常不會在排行榜中列出,卻往往能解釋外觀相近的評分為何有所不同。
結果列於下方的評測卡中,當中將執行資料與基準測試及模型中繼資料整合為一份易於解讀的紀錄;亦可透過 Hugging Face Community Evals 查閲。這與 英國 AI Security Institute 用來公開發布評測的基礎設施相同。由於我們的文字評測是在 lm-evaluation-harness 的公開分支上執行,而 EEE 為此提供專用轉換器,任何人都可以在相同設定下重新執行評測,並將結果與我們的數字比較。
結構化的評測報告對研究以外的範疇同樣重要。EvalEval 已將評測卡與 AI 管治要求對照,包括《歐盟 AI 法案》第 55 條及 GPAI Code of Practice,並發現 EEE 架構能呈現這些框架要求的 60 項評測報告元素中的 56 項。這與我們目前發布 Apertus 的方式一致:除了模型,我們亦會發布訓練內容的公開摘要,並自願提供一份實務守則文件。機器可讀的評測紀錄是順理成章的下一步,讓監管機構、部署者和研究人員更容易找到、解讀和比較模型背後的證據。
我們致力透過評測卡和 EEE 架構推動可重現且透明的評測,並鼓勵其他模型開發者以相同方式報告結果,讓不同模型和機構的評分可以互相比較。
Apertus 1.5 可重現性
所有訓練配方、消融研究和數據混合均記錄於技術報告。我們希望公開 v1.5 的訓練流程,讓更多人參與開放模型開發。中間檢查點存放於我們的Apertus 1.5 Hugging Face collection,包括基礎權重、SFT、RLVR 和 DPO;我們整理的訓練數據混合/自訂數據集則收錄於Apertus 1.5 datasets collection。分享這些資料,讓研究人員可以探討各個階段如何改變模型行為。
報告涵蓋多項消融研究,探討不同階段的後訓練資料所帶來的影響。我們觀察到,在 SFT 期間與文字資料混合的多模態資料,有助提升模型在所有模態上的表現。我們亦發現,多模態推理軌跡帶來的效益在後續純文字強化學習後仍然保留:以經多模態推理軌跡訓練的 SFT 檢查點為起點時,RL 對數學能力的提升比以純文字檢查點為起點更大,而模型在推理任務上的優勢亦在整個訓練過程中持續存在。
| 模型 | 8B | 70B |
|---|---|---|
| 預訓練(長上下文基礎模型) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| 監督式微調(SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| 強化學習(RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| 偏好對齊(DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B(最終版) |
| 憲章對齊(SDPO) | Apertus-v1.5-8B(最終版) | – |
| 階段 | 資料 | 程式碼/配方 |
|---|---|---|
| 預訓練:階段 1–2(非配對、配對) | 所有資料來源、版本及授權條款均列於 apertus-data-transparency;視覺及音訊處理配方載於 multimodal-data | Megatron-LM;啟動腳本載於 pretrain-code、apertus-omni-tokenizer、benchmark-image-tokenizer、benchmark-audio-tokenizer(包括交錯語音—文字建構器) |
| 預訓練:階段 3(冷卻階段) | apertus-data-transparency;精選圖像數據集:NASA、Our World in Data、Smithsonian、swisstopo | Megatron-LM;啟動腳本載於 pretrain-code |
| 長上下文擴展 | apertus-data-transparency;合成長上下文任務載於 LongContextQA | Megatron-LM;啟動腳本載於 pretrain-code |
| SFT | Apertus-v1.5-SFT-mix(報告中列出的多模態 SFT 混合數據) | posttraining-data、Megatron-LM(SFT 啟動腳本) |
| 長上下文 SFT | SFT 混合數據的子集(報告中列出),以及 LongContextQA 任務 | Megatron-LM |
| RL(RLVR) | 報告中列出的混合數據 | verl、verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool(已標註的補全內容)、Apertus-v1.5-Preference-Data(配對資料) | posttraining、verl |
| SDPO(憲章對齊,僅限 8B) | gretelai/gretel-safety-alignment-en-v1 | 自我蒸餾 |
模型供應情況
Proton Lumo 和 Infomaniak Euria 是兩款廣泛使用的應用程式,最近均已整合 Apertus 1.5。這些部署的連結亦收錄於社羣展示等頁面——可參閲此討論串預覽。
多間供應商已宣佈向開發人員提供 Apertus 1.5 API,包括 Swisscom、Infomaniak、Phoeniqs,以及我們的正式供應指南中列出的其他公司。報告亦詳述我們如何與外部評估人員合作,測試及準備模型。
模型運行的技術指引載於 Hugging Face 上 Apertus 各版本的模型卡,以及我們的快速入門指南。
如何參與
感謝閲讀這篇網誌文章,並成為社羣的一員!我們剛慶祝 Hugging Face 分析數據中的下載次數達五百萬 🤗,而且不會放慢步伐。在最近於蘇黎世舉行的 AI+X Summit 上,我們的團隊公佈了Apertus 2.0 的路線圖:稀疏/MoE 架構、總參數量約為 600B、延長訓練時程,並以 Agent、數學及編碼為優先方向。
總括而言:我們邀請你閲讀我們的報告、下載模型、探索中間檢查點、微調權重,並重現我們的評估。我們的出版物或網站常見問題尚未涵蓋的問題,歡迎隨時提出;我們也很想知道,哪些主題最值得社羣日後深入探討。
如果你使用 Apertus 或以此建立項目,請填寫作品展示表格,並透過聯絡頁面上的方式與我們聯絡。我們期待展示更多成果、瞭解你正在建立的項目,並聽取你對如何改進 Apertus 的意見!
引用
Project Apertus 等人。《Apertus 1.5:從開放文字模型到開放多模態推理模型》。arXiv:2610.15542。預印本,arXiv,2026年10月11日。https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}
來源:Hugging Face Blog · huggingface.co