Hugging Face 引入 Artificial Analysis LLM Performance Leaderboard
Bringing the Artificial Analysis LLM Performance Leaderboard to Hugging Face
Hugging Face 引入 Artificial Analysis LLM Performance Leaderboard,集中比較逾 100 個無伺服器 LLM API 端點的品質、價格與速度。
榜單把逾 100 個無伺服器 LLM API 端點的品質、價格與速度指標集中呈現,並以多種提示長度和並行查詢組合供工程師比較。
使用 LLM 建構應用程式,考慮因素不止品質:對許多用途而言,速度和價格同樣重要,甚至更重要。
對消費者應用程式和聊天體驗來説,速度和回應能力對用戶參與度至關重要。用戶期望幾乎即時收到回覆,延遲會直接降低參與度。建構涉及工具使用或代理系統等較複雜的應用程式時,速度和成本就更加重要,甚至可能成為整體系統能力的限制因素。LLM 的串行請求所需時間會迅速累積,而每項用戶請求的成本也會隨之增加。
因此,Artificial Analysis(@ArtificialAnlys)建立排行榜,評估超過 100 個無伺服器 LLM API endpoint 的價格、速度和品質;現在排行榜亦將登陸 Hugging Face。
按此處查看排行榜!
LLM 效能排行榜
LLM 效能排行榜旨在提供全面指標,協助 AI 工程師決定在 AI 應用程式中使用哪些 LLM(包括開放及專有模型)和 API 供應商。
選擇 AI 技術時,工程師需要考慮品質、價格和速度(延遲與吞吐量)。LLM 效能排行榜將這三項集中展示,方便在同一處比較專有及開源模型,並作出決策。
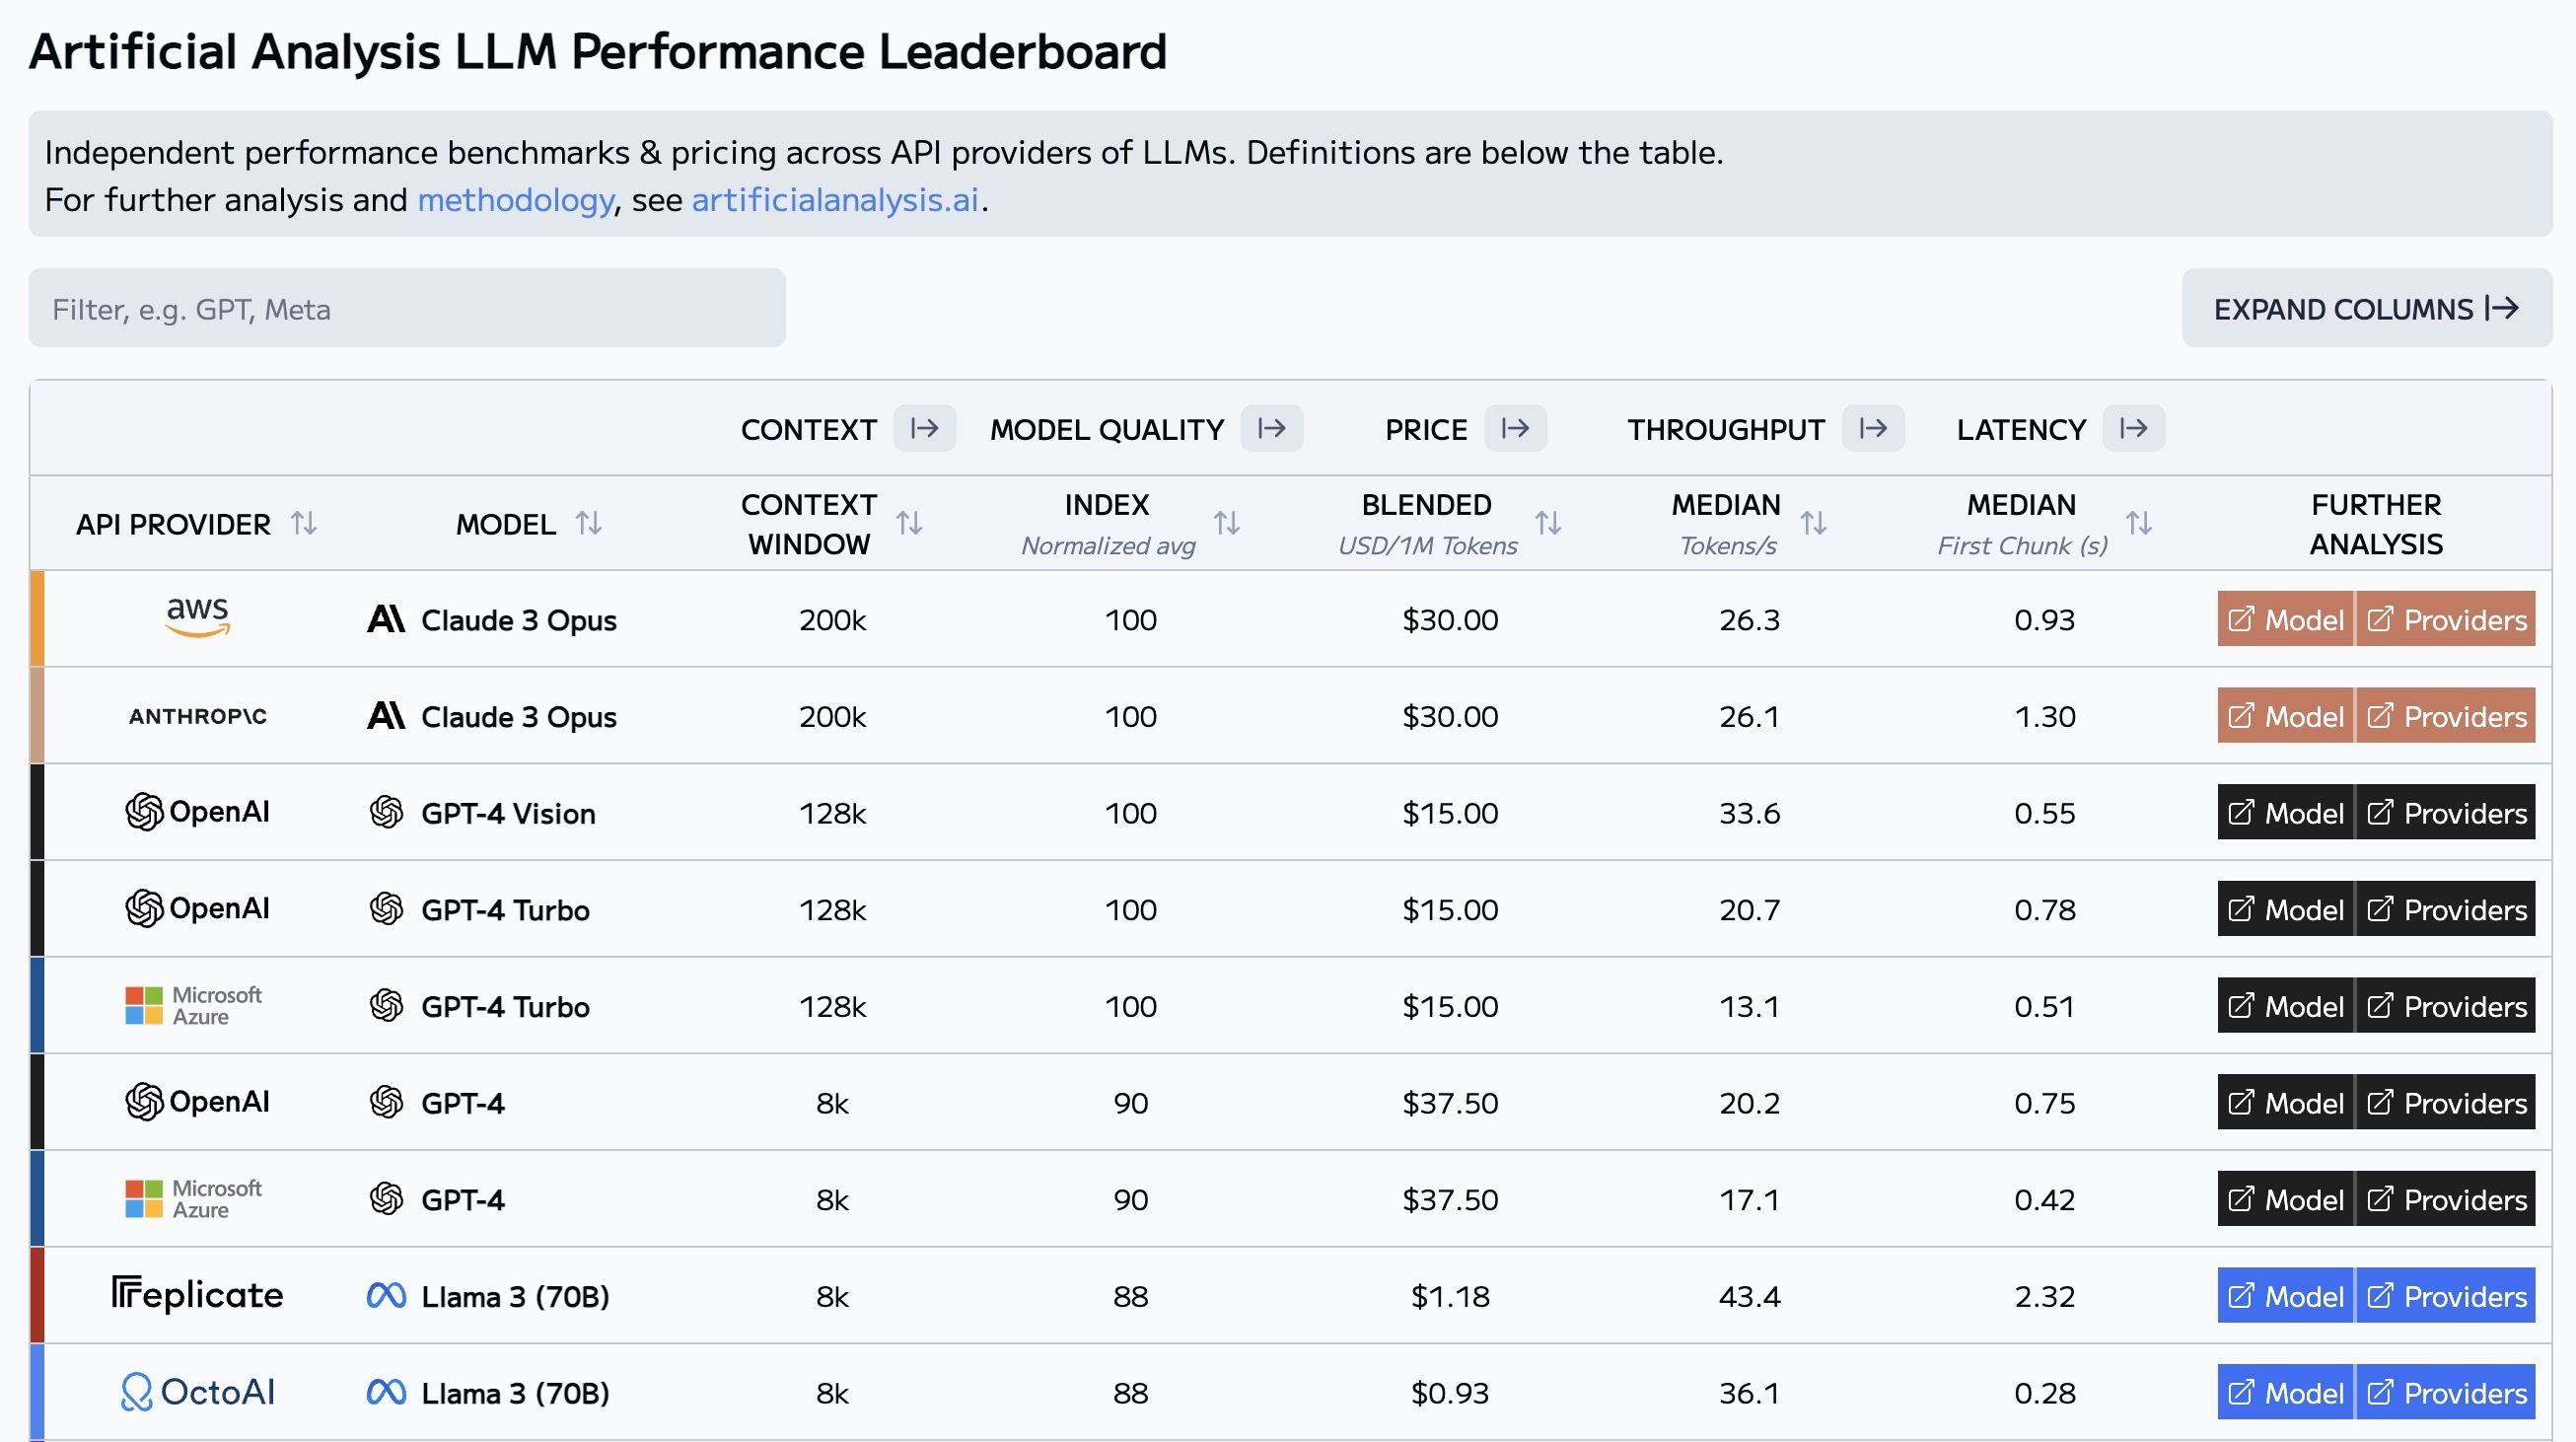
來源:LLM Performance Leaderboard
指標涵蓋範圍
排行榜提供以下指標:
- 品質:用於比較模型品質和準確度的簡化指數,根據模型作者報告的 MMLU、MT-Bench、HumanEval 等分數,以及 Chatbot Arena 排名計算。
- 上下文視窗:LLM 在任何時間可處理的 token 數上限(包括輸入和輸出 token)。
- 價格:供應商為模型推理查詢收取的費用。我們會列出每個輸入/輸出 token 的價格,也會提供「混合」價格,以單一指標比較託管供應商。我們按 3:1 比例混合輸入和輸出價格(即假設輸入長度是輸出長度的 3 倍)。
- 吞吐量:endpoint 在推理期間輸出 token 的速度,以每秒 token 數量計算(通常稱為 tokens/s 或「TPS」)。我們會報告過去 14 日測量值的中位數、P5、P25、P75 和 P95。
- 延遲:送出請求後 endpoint 回應所需時間,稱為首個 token 時間(「TTFT」),以秒計算。我們會報告過去 14 日測量值的中位數、P5、P25、P75 和 P95。
如需更多定義,請參閲完整方法説明頁。
測試負載
排行榜可探索不同負載下的效能(共 6 種組合):
- 改變提示詞長度:約 100 個 token、約 1k 個 token、約 10k 個 token。
- 改變平行查詢數量:1 個查詢、10 個平行查詢。
方法
我們每天對排行榜上的每個 API endpoint 測試 8 次;排行榜數據則是過去 14 日測量值的中位數。展開分頁中亦提供百分位數細分。
目前,品質指標按模型收集,展示由模型創作者提供的結果報告。隨着我們開始分享各 endpoint 的獨立品質評估結果,請留意此頁更新。
如需更多定義,請參閲完整方法説明頁。
重點(2024 年 5 月;最新資訊請查看排行榜)
- 過去一年,語言模型市場的複雜程度急劇上升。僅在最近兩個月,便有多項發布改變市場格局,包括 Anthropic 的 Claude 3 系列等專有模型,以及 Databricks 的 DBRX、Cohere 的 Command R Plus、Google 的 Gemma、Microsoft 的 Phi-3、Mistral 的 Mixtral 8x22B 和 Meta 的 Llama 3 等開放模型。
- 不同模型和供應商的價格與速度差異甚大。從 Claude 3 Opus 到 Llama 3 8B,價格相差 300 倍,超過兩個數量級!
- API 供應商加快了模型上架速度。Llama 3 模型發布後 48 小時內,已有 7 家供應商提供這些模型。這反映了市場對新開源模型的需求,以及 API 供應商之間的競爭態勢。
- 各品質區間值得重點介紹的模型:
- 品質高,通常價格較高且速度較慢:GPT-4 Turbo 和 Claude 3 Opus
- 品質、價格和速度中等:Llama 3 70B、Mixtral 8x22B、Command R+、Gemini 1.5 Pro、DBRX
- 品質較低,但速度快得多且價格更低:Llama 3 8B、Claude 3 Haiku、Mixtral 8x7B
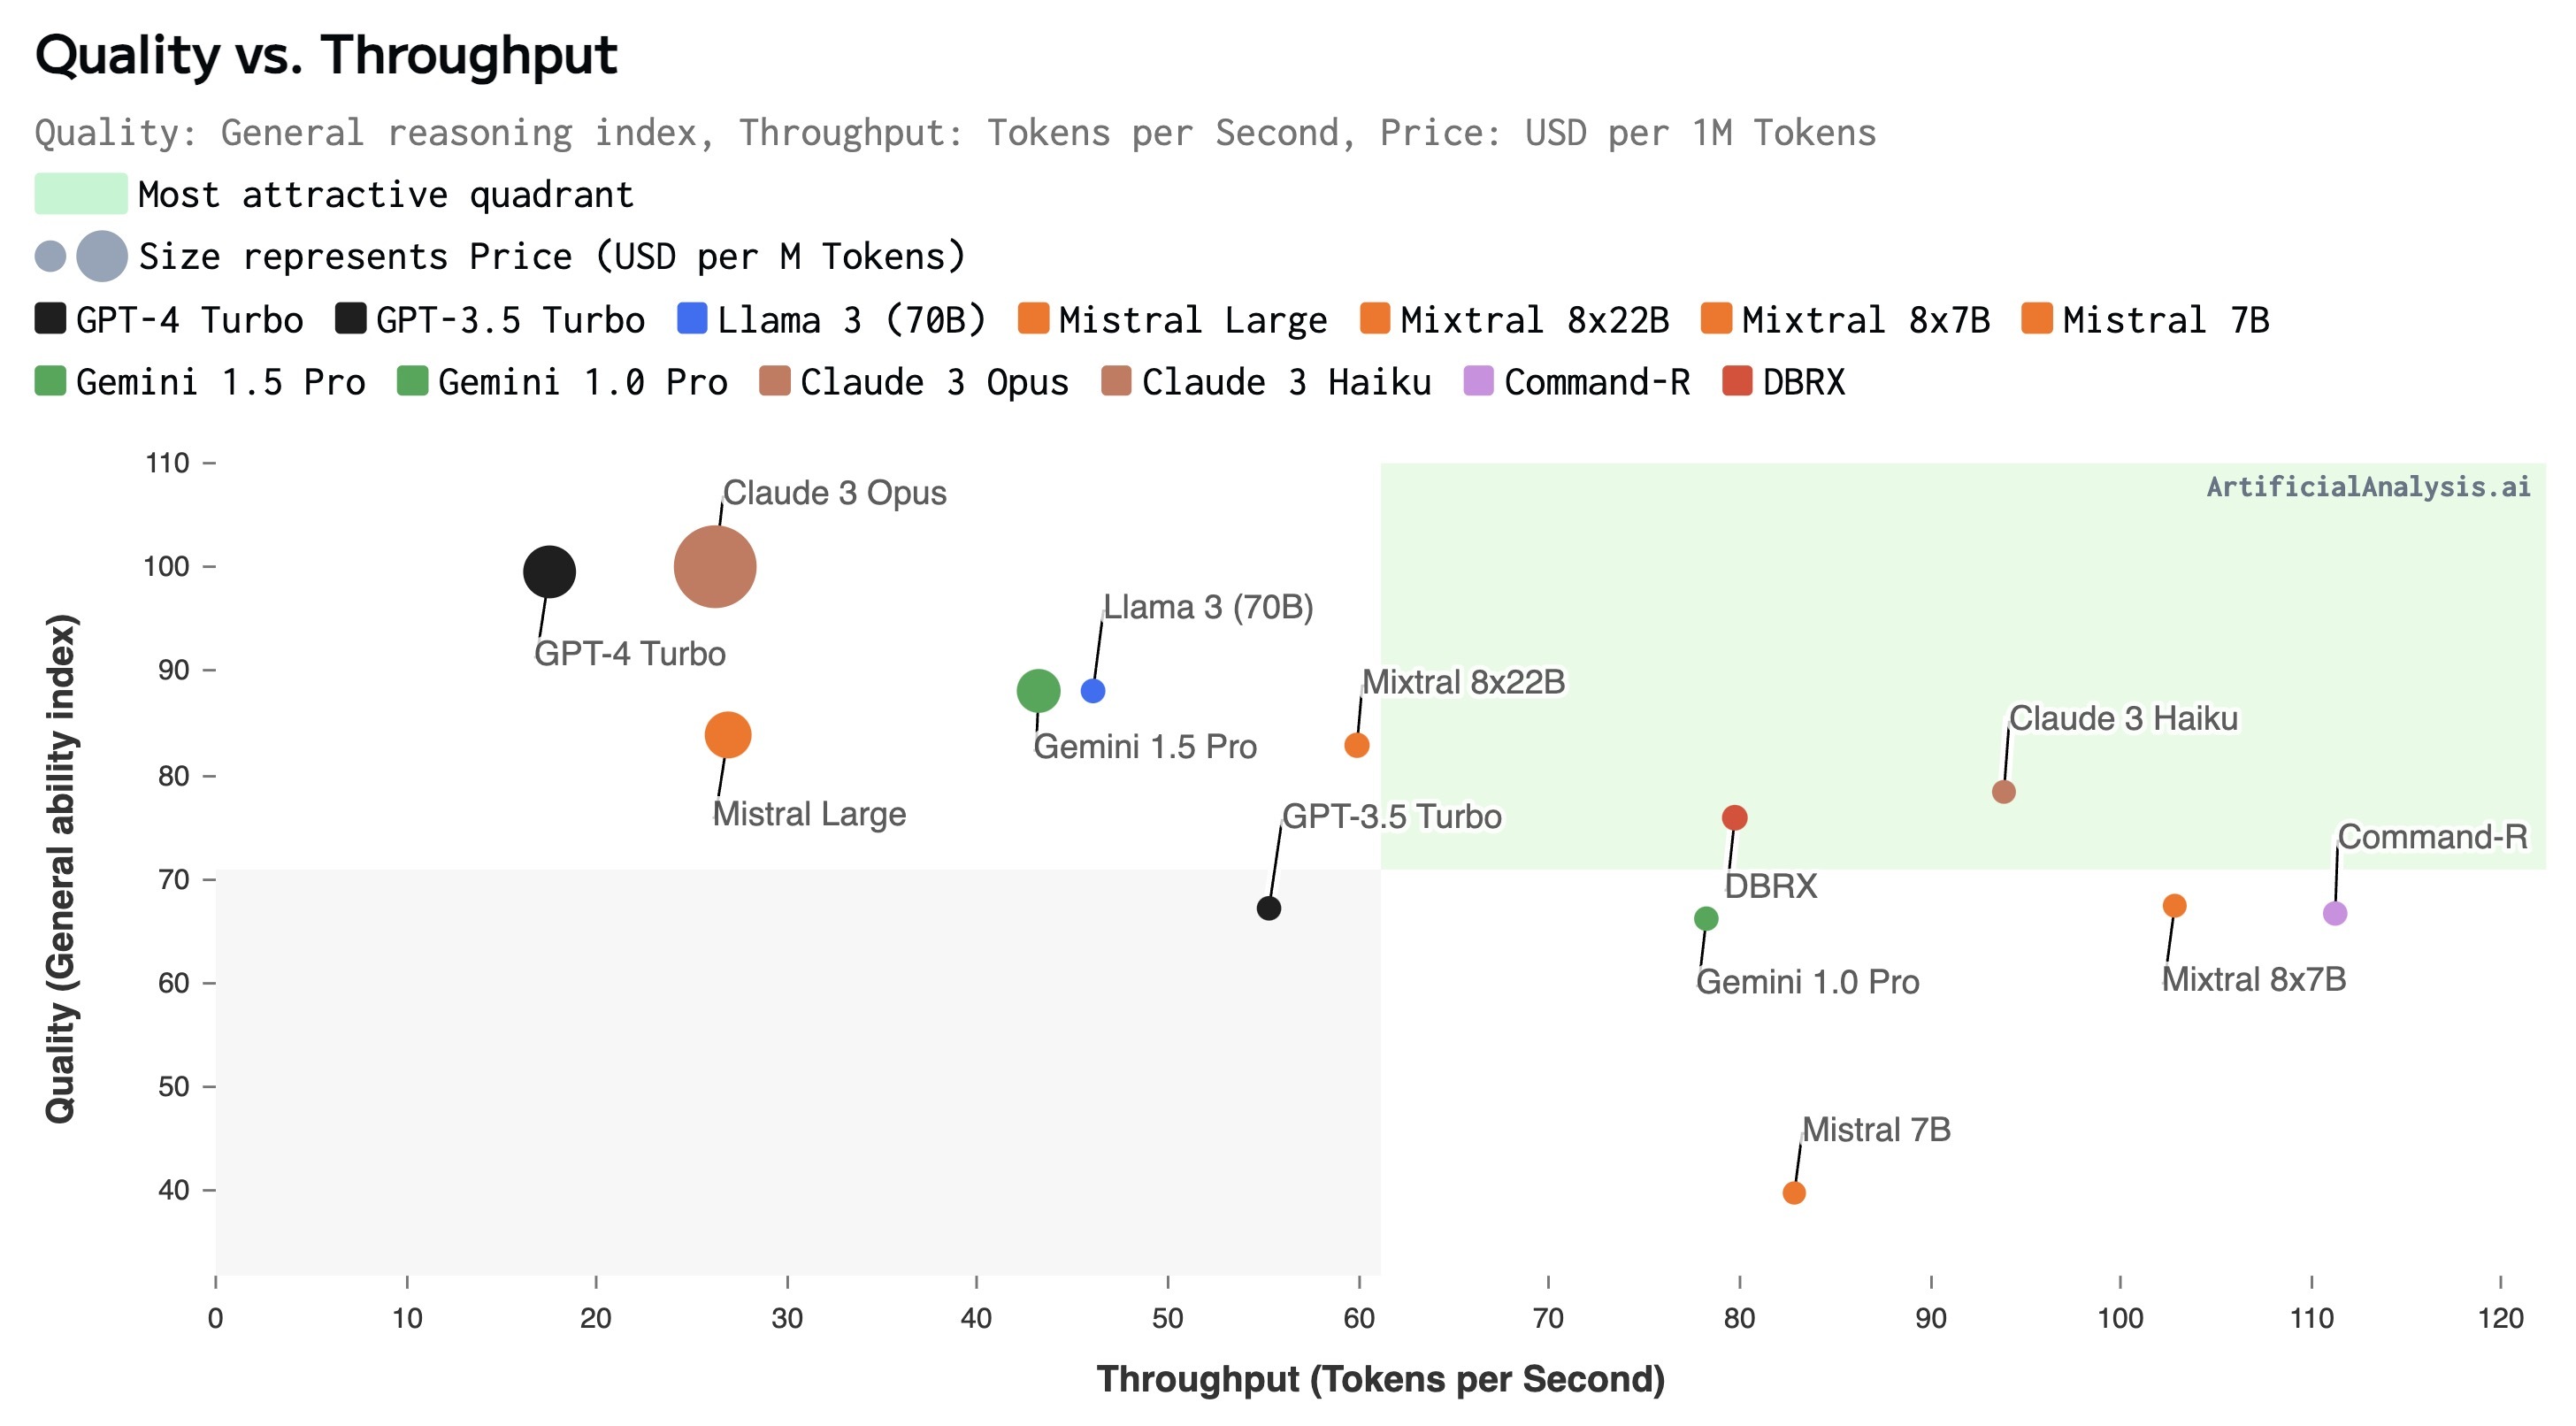
我們的品質與吞吐量(tokens/s)圖表,展示了不同品質和效能特性的各種選擇。
來源:artificialanalysis.ai/models
用例示例:速度和價格可能與品質同樣重要
在某些情況下,使用多個更快、更便宜的模型處理一連串請求,不僅成本更低,整體系統品質也可能高於使用單一大型模型。
例如,假設要建立一個聊天機械人,必須瀏覽網頁,從近期新聞文章中找出相關資訊。一種做法是使用 GPT-4 Turbo 這類大型高品質模型進行搜尋,再讀取和處理少數排名靠前的文章。另一種做法是使用 Llama 3 8B 這類較小、速度較快的模型,平行讀取數十個網頁並摘取重點,然後再用 GPT-4 Turbo 評估和摘要最相關的結果。即使計入多閲讀 10 倍內容的成本,第二種做法仍然更符合成本效益,而且可能產生更高品質的結果。
聯絡我們
請在 Twitter 和 LinkedIn 追蹤我們以取得最新消息。你可以透過上述任一平台傳訊息聯絡我們,也可使用我們的網站或電郵聯絡。
來源:Hugging Face Blog · huggingface.co