如何使用 Sentence Transformers 訓練 CPU 推理速度快 100 至 400 倍的靜態嵌入模型
Train 400x faster Static Embedding Models with Sentence Transformers
Hugging Face Blog 公開兩款靜態嵌入模型,稱其 CPU 推理比常見嵌入模型快 100 至 400 倍,且多項基準保留至少 85% 表現。
文章公開兩款模型的訓練配方與資料集,並以 NanoBEIR 結果呈現靜態嵌入模型在 CPU 速度與檢索品質間的取捨。
重點摘要
本文介紹一種訓練靜態嵌入模型的方法;這類模型在 CPU 上比最先進的嵌入模型快 100x 至 400x,同時保留大部分質素。這解鎖了許多令人期待的用途,包括在裝置和瀏覽器上執行、邊緣運算、低耗電和嵌入式應用。
我們運用這套方法訓練了兩款效率極高的嵌入模型:用於英文檢索的 sentence-transformers/static-retrieval-mrl-en-v1,以及用於多語言相似度任務的 sentence-transformers/static-similarity-mrl-multilingual-v1。與常見模型相比,這些模型在 CPU 上快100x 至 400x,例如 all-mpnet-base-v2 和 multilingual-e5-small;各項基準測試的表現則至少達到對照模型的85%。
今天我們會發布:
- 上文提及的兩款模型(分別用於英文檢索和多語言相似度)。
- 詳細訓練策略,涵蓋構思、資料集選擇、實作和評估各階段。
- 根據開源 sentence transformers 程式庫編寫的兩份訓練指令碼。
- 兩份 Weights and Biases 報告,載有訓練期間收集的訓練和評估指標。
- 我們使用的詳細資料集清單:30 個訓練集和 13 個評估集。
我們亦會討論可能的改進,並鼓勵社羣探索和延續這項工作!
按此查看已發布模型的使用範例
這些模型的使用方法非常直接,與一般 Sentence Transformers 流程完全相同:
英文檢索
from sentence_transformers import SentenceTransformer

# Download from the 🤗 Hub
model = SentenceTransformer("sentence-transformers/static-retrieval-mrl-en-v1", device="cpu")
# Run inference
sentences = [
    'Gadofosveset-enhanced MR angiography of carotid arteries: does steady-state imaging improve accuracy of first-pass imaging?',
    'To evaluate the diagnostic accuracy of gadofosveset-enhanced magnetic resonance (MR) angiography in the assessment of carotid artery stenosis, with digital subtraction angiography (DSA) as the reference standard, and to determine the value of reading first-pass, steady-state, and "combined" (first-pass plus steady-state) MR angiograms.',
    'In a longitudinal study we investigated in vivo alterations of CVO during neuroinflammation, applying Gadofluorine M- (Gf) enhanced magnetic resonance imaging (MRI) in experimental autoimmune encephalomyelitis, an animal model of multiple sclerosis. SJL/J mice were monitored by Gadopentate dimeglumine- (Gd-DTPA) and Gf-enhanced MRI after adoptive transfer of proteolipid-protein-specific T cells. Mean Gf intensity ratios were calculated individually for different CVO and correlated to the clinical disease course. Subsequently, the tissue distribution of fluorescence-labeled Gf as well as the extent of cellular inflammation was assessed in corresponding histological slices.',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 1024]

# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings[0], embeddings[1:])
print(similarities)
# tensor([[0.7649, 0.3279]])
多語言相似度
from sentence_transformers import SentenceTransformer

# Download from the 🤗 Hub
model = SentenceTransformer("sentence-transformers/static-similarity-mrl-multilingual-v1", device="cpu")
# Run inference
sentences = [
    'It is known for its dry red chili powder.',
    'It is popular for dried red chili powder.',
    'These monsters will move in large groups.',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 1024]

# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings, embeddings)
print(similarities)
# tensor([[ 1.0000,  0.8388, -0.0012],
#         [ 0.8388,  1.0000,  0.0445],
#         [-0.0012,  0.0445,  1.0000]])

目錄
甚麼是嵌入向量?
嵌入向量是自然語言處理中用途最廣泛的工具之一,能讓實務人員處理大量不同任務。本質上,嵌入向量是較複雜物件(例如文字、圖像、音訊等)的數值表示。
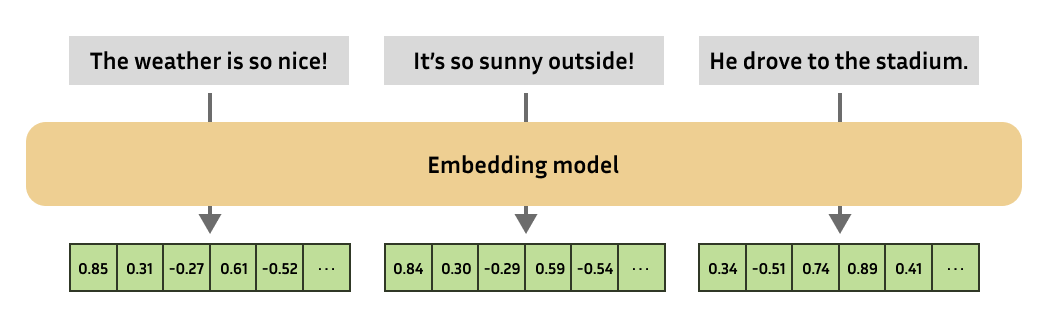
嵌入模型每次都會產生固定大小的嵌入向量。然後,你可以計算各自嵌入向量的相似度,從而比較複雜物件的相似程度。
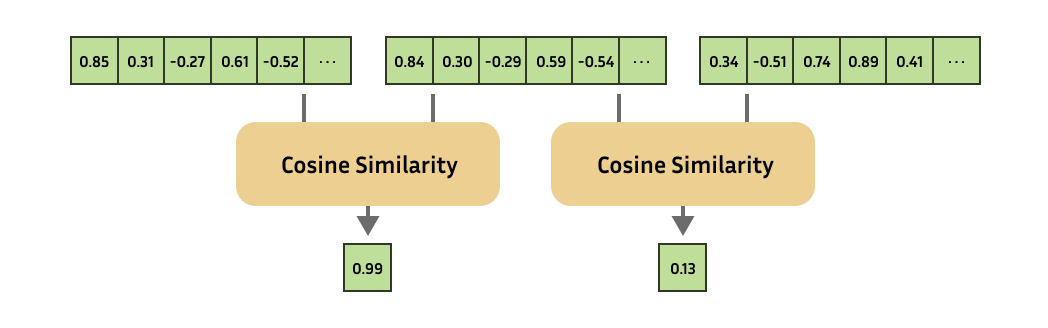
這有大量用途,是推薦系統、檢索、離羣值偵測、單樣本或少樣本學習、相似度搜尋、分羣、改寫偵測、分類等多種應用的基礎。
現代嵌入模型
現今許多嵌入模型都由幾個轉換步驟組成。執行這些步驟的過程稱為「推論」。

Tokenizer 和 Pooler 分別負責 Encoder 的前處理和後處理。前者會把文字切分為 token(又稱詞或子詞),讓 Encoder 能夠理解;後者則把所有 token 的嵌入向量合併成代表整段文字的一個嵌入向量。
在這條管道中,Encoder 通常是具有注意力層的語言模型,讓每個 token 可在其他 token 的上下文中計算。例如,bank 可以是一個 token,但文字指的是「河岸」還是金融機構,很可能會令該 token 的嵌入表示有所不同。
具有大量注意力層的大型 encoder 模型能有效利用上下文產生實用嵌入向量,但代價是推論速度緩慢。值得注意的是,在整條管道中,Encoder 步驟通常佔用幾乎所有運算時間。
靜態嵌入模型
靜態嵌入模型是一類不使用大型、緩慢的注意力模型,而改用預先計算 token 嵌入向量的 Encoder 模型。在 Transformer 架構發展之前很多年,人們已使用靜態嵌入模型。常見例子包括 GLoVe 和 word2vec。近期,Model2Vec 已用於把預訓練嵌入模型轉換成靜態嵌入模型。
對靜態嵌入模型而言,Encoder 步驟只是簡單的字典查找:給定 token,便傳回預先計算的 token 嵌入。因此,推論不再受 Encoder 階段限制,速度突然提升數個數量級。這篇網誌會展示質素損失可以很小!
我們的方法
我們希望以現代技術重新研究靜態嵌入模型。我們的大部分提升來自採用對比學習損失函數,稍後會詳述。另外,也可以選擇使用 Matryoshka 表示學習,取得額外速度提升,並使用截短版本的嵌入向量。
我們會使用 Sentence Transformers 程式庫進行訓練。若想了解如何使用這個程式庫訓練嵌入模型的一般概況,可以閲讀 使用 Sentence Transformers 訓練和微調嵌入模型網誌文章,或Sentence Transformers 訓練概覽文件。
訓練詳情
這些重新構想的靜態嵌入模型,目標是試驗適用於高效率嵌入模型的現代微調技術。具體而言,與 GLoVe 和 word2vec 不同,我們會使用:
對比學習:在大部分機器學習中,你會提供輸入 $X$ 並期望得到輸出 $Y$,然後訓練模型,令 $X$ 經過模型後產生接近 $Y$ 的結果。對嵌入模型而言,我們沒有 $Y$:事前並不知道理想的嵌入向量應該是甚麼。
對比學習則使用多個輸入 $X_1$ 和 $X_2$,並提供相似度。我們把兩個輸入都送入模型,再比較兩個嵌入向量,得出預測相似度。若實際相似度低,便把嵌入向量推得更遠;若實際相似度高,便把它們拉得更近。
Matryoshka 表示學習(MRL):Matryoshka 嵌入模型(網誌文章)採用巧妙的訓練方法,讓用戶只需付出極小的表現代價,便可把嵌入模型截短至較小維度。做法是除了正常大小的嵌入向量,也對截短版本使用對比損失函數。因此,模型會學習把資訊主要儲存在嵌入向量開首部分。
截短的嵌入向量可加快檢索、分類和分羣等下游應用。
至於未來研究,我們把其他可改善資料質素的現代訓練方法留待日後探討。具體建議請參閲後續步驟。
訓練需求
如 Sentence Transformers 的訓練概覽文件所示,訓練由 3 至 5 個元件組成:
- 資料集
- 損失函數
- 訓練參數(可選)
- 評估器(可選)
- Trainer
以下小節會逐一介紹我們對各項元件的考量。
模型構想
按我們的經驗,嵌入模型的用途不外乎兩種:1)只用於檢索,或 2)用於各種任務(分類、分羣、語意文字相似度等)。因此,我們決定各訓練一款。
檢索模型方面,可用的多語言檢索訓練資料有限,因此我們選擇只支援英文。相反,多語言資料較容易取得,所以我們決定訓練一款多語言通用相似度模型。
我們希望為這些模型使用 StaticEmbedding 模組;它實作了高效的 tokenize 方法,毋須填充,並具備高效的 forward 方法來計算和池化嵌入向量。這就像使用 torch 的 EmbeddingBag 一樣簡單;它只是一個具平均池化功能的高效 Embedding(即嵌入向量查找表)。
可以用幾種方式初始化:使用 StaticEmbedding.from_model2vec 載入 Model2Vec 模型;使用 StaticEmbedding.from_distillation 執行 Model2Vec 式蒸餾;或提供 Tokenizer 和嵌入維度,以隨機權重初始化。
根據我們的研究結果,若要用大量資料完整訓練,最後一種方法效果最好。為了匹配 all-mpnet-base-v2 或 bge-large-en-v1.5 等常見模型,我們選用 1024 維嵌入,也就是每個嵌入向量包含 1024 個值。
英文檢索
英文檢索模型採用 google-bert/bert-base-uncased tokenizer。因此,模型初始化方式如下:
from sentence_transformers import SentenceTransformer
from sentence_transformers.models import StaticEmbedding
from tokenizers import Tokenizer

tokenizer = Tokenizer.from_pretrained("google-bert/bert-base-uncased")
static_embedding = StaticEmbedding(tokenizer, embedding_dim=1024)

model = SentenceTransformer(modules=[static_embedding])
modules 清單的第一項必須實作 tokenize,最後一項必須產生池化嵌入向量。這裏兩項條件都符合,所以可以開始訓練模型。
多語言相似度
多語言相似度模型則採用 google-bert/bert-base-multilingual-uncased tokenizer;初始化程式碼只需更改這一項:
from sentence_transformers import SentenceTransformer
from sentence_transformers.models import StaticEmbedding
from tokenizers import Tokenizer

tokenizer = Tokenizer.from_pretrained("google-bert/bert-base-multilingual-uncased")
static_embedding = StaticEmbedding(tokenizer, embedding_dim=1024)

model = SentenceTransformer(modules=[static_embedding])
訓練資料集選擇
除了數十款 Sentence Transformer 模型外,Hugging Face 上的 Sentence Transformers 組織在撰寫本文時亦託管 70 多個資料集:
此外,許多資料集都加上 sentence-transformers 標籤,表示它們適合訓練嵌入模型:
- 帶有
sentence-transformers標籤的資料集
英文檢索
對英文檢索資料集,我們主要尋找符合以下條件的資料集:
- 包含問答配對,亦可選擇包含負例(即錯誤答案);以及
- 不與 BEIR 基準測試重疊,也就是不與 MTEB 上的 Retrieval 分頁重疊。我們希望避免在這些資料集上訓練,以便把 MTEB 用作 0-shot 基準測試。
我們選用了以下資料集:
- gooaq
- msmarco - 「triplet」子集
- squad
- s2orc - 「title-abstract-pair」子集
- allnli - 「triplet」子集
- paq
- trivia_qa
- msmarco_10m
- swim_ir - 「en」子集
- pubmedqa - 「triplet-20」子集
- miracl - 「en-triplet-all」子集
- mldr - 「en-triplet-all」子集
- mr_tydi - 「en-triplet-all」子集
多語言相似度
多語言相似度資料集方面,我們希望資料集包含:
- 跨語言平行句子,即同一段文字的多種語言版本;或
- 正例配對,即相似度高的配對,亦可選擇包含負例(即相似度低的配對)。
我們選擇以下包含平行句子的資料集:
以下資料集則包含某類正例配對:
- stackexchange - 「post-post-pair」子集
- quora - 「triplet」子集
- wikianswers_duplicates
- all_nli - 「triplet」子集
- simple_wiki
- altlex
- flickr30k_captions
- coco_captions
- nli_for_simcse
- negation
程式碼
載入這些資料集相當簡單,例如:
from datasets import load_dataset, Dataset

gooaq_dataset = load_dataset("sentence-transformers/gooaq", split="train")
gooaq_dataset_dict = gooaq_dataset.train_test_split(test_size=10_000, seed=12)
gooaq_train_dataset: Dataset = gooaq_dataset_dict["train"]
gooaq_eval_dataset: Dataset = gooaq_dataset_dict["test"]

print(gooaq_train_dataset)
"""
Dataset({
    features: ['question', 'answer'],
    num_rows: 3002496
})
"""

print(gooaq_eval_dataset)
"""
Dataset({
    features: ['question', 'answer'],
    num_rows: 10000
})
"""
gooaq 資料集沒有預設訓練-評估分割,因此可使用 train_test_split 建立分割。其他資料集則可直接載入預先計算的分割,例如 split="eval"。
請注意,train_test_split 會把資料集載入記憶體,而不是像一般情況只保存在磁碟上。訓練時增加記憶體用量並不理想,因此建議:1)載入資料;2)分割資料;3)使用 save_to_disk 把資料存至磁碟。訓練前再使用 load_from_disk 重新載入即可。
選擇損失函數
在 Sentence Transformers 中,損失模型必須配合訓練資料格式。損失概覽提供不同損失函數與資料格式之間兼容性的概覽。
具體而言,我們的資料目前有以下格式:
- (錨點、正例)配對,沒有標籤
- (錨點、正例、負例)三元組,沒有標籤
- (錨點、正例、負例_1、……、負例_n)元組,沒有標籤
這些格式都有一些很好的選擇:
MultipleNegativesRankingLoss(MNRL):亦稱為批次內負例損失或 InfoNCE 損失,近幾年一直用於訓練現代嵌入模型。簡單來説,損失函數會最佳化以下目標:給定一個錨點(例如問題),要從批次中的所有正例和負例(例如所有答案)中,為相應正例(即答案)分配最高相似度。
如果你提供可選的負例,它們只會作為額外選項(亦稱批次內負例),讓模型從中選出正確正例。在合理範圍內,「選擇」越困難,模型能力便越強。因此,較大的批次會帶來更多批次內負例,進而提升表現(但提升會有上限)。
CachedMultipleNegativesRankingLoss(CMNRL):這是 MNRL 的延伸實作,使用 GradCache 方法,可以任意增加批次大小而不增加記憶體用量。除非單靠 MNRL 已能在記憶體中容納足夠大的批次,否則建議使用這項損失函數。若能做到,則可使用 MNRL,省下 CMNRL 帶來的 20% 訓練速度成本。
GISTEmbedLoss(GIST):這也是 MNRL 的延伸,會使用一個guideSentence Transformer 模型,從候選清單中移除可能的假負例,讓模型從其餘選項中選出正確正例。假負例會損害表現,但難度高的真負例(與正確答案相近但並非正確答案的文字)可以改善表現,因此這種篩選需要拿捏得恰到好處。
由於這些靜態嵌入模型非常小,我們選定的批次大小 2048 個樣本,可在硬件上輕鬆容納:單張 24GB RTX 3090。因此我們不需要使用 CMNRL。
此外,由於我們訓練的模型速度很快,guide 配合 GISTEmbedLoss 會令訓練慢很多。因此,我們選擇為模型使用 MultipleNegativesRankingLoss。
如果再次進行這些實驗,我們會選用更大的批次,例如搭配 CMNRL 使用 16384。若你試過,歡迎告訴我們結果!
程式碼
用法相當簡單:
from sentence_transformers import SentenceTransformer
from sentence_transformers.losses import MultipleNegativesRankingLoss

# Prepare a model to train
tokenizer = Tokenizer.from_pretrained("google-bert/bert-base-uncased")
static_embedding = StaticEmbedding(tokenizer, embedding_dim=1024)
model = SentenceTransformer(modules=[static_embedding])

# Initialize the MNRL loss given the model
loss = MultipleNegativesRankingLoss(model)
Matryoshka 表示學習
除了常規損失函數,Sentence Transformers 也實作了數種損失修飾器。它們會在標準損失函數之上,以不同方式運作,為受訓嵌入模型加入實用特性。
其中一個很有意思的是 MatryoshkaLoss,可把受訓模型轉化成Matryoshka 模型。用戶可以截短輸出嵌入向量而只造成極小的表現損失;維度較小也能加快檢索或分羣。
程式碼
MatryoshkaLoss 會套用在一般損失函數之上。建議在 matryoshka_dims 清單中同時加入一般嵌入維度:
from sentence_transformers import SentenceTransformer
from sentence_transformers.losses import MultipleNegativesRankingLoss, MatryoshkaLoss

# Prepare a model to train
tokenizer = Tokenizer.from_pretrained("google-bert/bert-base-uncased")
static_embedding = StaticEmbedding(tokenizer, embedding_dim=1024)
model = SentenceTransformer(modules=[static_embedding])

# Initialize the MNRL loss given the model
base_loss = MultipleNegativesRankingLoss(model)
loss = MatryoshkaLoss(model, base_loss, matryoshka_dims=[1024, 768, 512, 256, 128, 64, 32])
選擇訓練參數
Sentence Transformers 支援許多訓練參數,其中最有用的項目已列於訓練概覽 > 訓練參數文件。
我們使用相同的核心訓練參數訓練兩款模型:
num_train_epochs: 1- 我們的資料量已足夠;若想延長訓練,可以加入更多資料,而不是重複使用相同資料訓練多次。
per_device_train_batch_size/per_device_eval_batch_size: 2048learning_rate: 2e-1- 注意!這個值比一般嵌入模型訓練大很多;一般訓練的損失值通常約為 2e-5。
warmup_ratio: 0.1- 0.1 或 10% 是相當標準的預熱比例,可讓模型平順地逐漸採用較高學習率。
bf16: True- 如果你的 GPU 支援
bf16,通常值得用它來訓練;否則若支援,可改用fp16=True。
- 如果你的 GPU 支援
batch_sampler:BatchSamplers.NO_DUPLICATES- 所有採用批次內負例的損失函數(例如 MNRL)都能受惠於這種批次取樣器,避免同一批次出現重複資料。重複資料往往會造成假負例,削弱模型訓練效果。
multi_dataset_batch_sampler:MultiDatasetBatchSamplers.PROPORTIONAL- 你同時使用多個資料集訓練時,不同資料集的大小通常不一樣。遇到這種情況,可以:
- 輪替取樣:從每個資料集中抽取相同數量的批次,直至其中一個資料集用完。資料分佈會均衡,但不會用到全部資料。
- 按比例取樣:從每個資料集取樣,直至全部用完。這會用盡所有資料,但各資料集的分佈並不均衡。由於我們不太擔心資料失衡,所以選擇這種方式。
- 你同時使用多個資料集訓練時,不同資料集的大小通常不一樣。遇到這種情況,可以:
除了這些核心參數,我們也設定了幾個用於追蹤和除錯的訓練參數:eval_strategy、eval_steps、save_strategy、save_steps、save_total_limit、logging_steps、logging_first_step 和 run_name。
程式碼
最後,我們為兩款模型使用以下 SentenceTransformerTrainingArguments:
run_name = "static-retrieval-mrl-en-v1"
# or
# run_name = "static-similarity-mrl-multilingual-v1"

args = SentenceTransformerTrainingArguments(
    # Required parameter:
    output_dir=f"models/{run_name}",
    # Optional training parameters:
    num_train_epochs=1,
    per_device_train_batch_size=2048,
    per_device_eval_batch_size=2048,
    learning_rate=2e-1,
    warmup_ratio=0.1,
    fp16=False,  # Set to False if you get an error that your GPU can't run on FP16
    bf16=True,  # Set to True if you have a GPU that supports BF16
    batch_sampler=BatchSamplers.NO_DUPLICATES,  # MultipleNegativesRankingLoss benefits from no duplicate samples in a batch
    multi_dataset_batch_sampler=MultiDatasetBatchSamplers.PROPORTIONAL,
    # Optional tracking/debugging parameters:
    eval_strategy="steps",
    eval_steps=1000,
    save_strategy="steps",
    save_steps=1000,
    save_total_limit=2,
    logging_steps=1000,
    logging_first_step=True,
    run_name=run_name,  # Used if `wandb`, `tensorboard`, or `neptune`, etc. is installed
)
選擇評估器
向 Sentence Transformer Trainer 提供評估資料集後,評估時便會得到評估損失。這有助追蹤是否過度擬合,但對實際下游表現的參考價值不大。
因此,Sentence Transformers 另外支援評估器。與訓練損失不同,它們會提供 NDCG、MAP、MRR 等資訊檢索質性指標、語意文字相似度的 Spearman 相關係數,或三元組準確度(即 similarity(anchor, positive) > similarity(anchor, negative) 的樣本數量)。
由於使用簡單,我們會為檢索模型採用 NanoBEIREvaluator。這個評估器會在 NanoBEIR 資料集集合上執行資訊檢索基準測試。這個集合是規模大得多(因而速度較慢)的 BEIR 基準測試子集;BEIR 常用作 MTEB Leaderboard 中的 Retrieval 分頁。
程式碼
所有資料集都已預先定義,因此無需提供任何參數即可載入評估器:
from sentence_transformers import SentenceTransformer
from sentence_transformers.evaluation import NanoBEIREvaluator

# Load an example pre-trained model to finetune further
model = SentenceTransformer("sentence-transformers/all-MiniLM-L6-v2")

# Initialize the NanoBEIR Evaluator
evaluator = NanoBEIREvaluator()

# Run it on any Sentence Transformer model
evaluator(model)
硬件詳情
我們在消費級硬件上訓練這些模型,具體配置如下:
- GPU:RTX 3090
- CPU:i7-13700K
- RAM:32GB
完整訓練指令碼
本節列出兩款模型的最終訓練指令碼,結合前文介紹的所有元件(資料集、損失函數、訓練參數、評估器和 trainer)。
英文檢索
按此展開
import random
import logging
from datasets import load_dataset, Dataset, DatasetDict
from sentence_transformers import (
    SentenceTransformer,
    SentenceTransformerTrainer,
    SentenceTransformerTrainingArguments,
    SentenceTransformerModelCardData,
)
from sentence_transformers.losses import MatryoshkaLoss, MultipleNegativesRankingLoss
from sentence_transformers.training_args import BatchSamplers, MultiDatasetBatchSamplers
from sentence_transformers.evaluation import NanoBEIREvaluator
from sentence_transformers.models.StaticEmbedding import StaticEmbedding

from transformers import AutoTokenizer

logging.basicConfig(
    format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO
)
random.seed(12)


def load_train_eval_datasets():
    """
    Either load the train and eval datasets from disk or load them from the datasets library & save them to disk.

    Upon saving to disk, we quit() to ensure that the datasets are not loaded into memory before training.
    """
    try:
        train_dataset = DatasetDict.load_from_disk("datasets/train_dataset")
        eval_dataset = DatasetDict.load_from_disk("datasets/eval_dataset")
        return train_dataset, eval_dataset
    except FileNotFoundError:
        print("Loading gooaq dataset...")
        gooaq_dataset = load_dataset("sentence-transformers/gooaq", split="train")
        gooaq_dataset_dict = gooaq_dataset.train_test_split(test_size=10_000, seed=12)
        gooaq_train_dataset: Dataset = gooaq_dataset_dict["train"]
        gooaq_eval_dataset: Dataset = gooaq_dataset_dict["test"]
        print("Loaded gooaq dataset.")

        print("Loading msmarco dataset...")
        msmarco_dataset = load_dataset("sentence-transformers/msmarco-co-condenser-margin-mse-sym-mnrl-mean-v1", "triplet", split="train")
        msmarco_dataset_dict = msmarco_dataset.train_test_split(test_size=10_000, seed=12)
        msmarco_train_dataset: Dataset = msmarco_dataset_dict["train"]
        msmarco_eval_dataset: Dataset = msmarco_dataset_dict["test"]
        print("Loaded msmarco dataset.")

        print("Loading squad dataset...")
        squad_dataset = load_dataset("sentence-transformers/squad", split="train")
        squad_dataset_dict = squad_dataset.train_test_split(test_size=10_000, seed=12)
        squad_train_dataset: Dataset = squad_dataset_dict["train"]
        squad_eval_dataset: Dataset = squad_dataset_dict["test"]
        print("Loaded squad dataset.")

        print("Loading s2orc dataset...")
        s2orc_dataset = load_dataset("sentence-transformers/s2orc", "title-abstract-pair", split="train[:100000]")
        s2orc_dataset_dict = s2orc_dataset.train_test_split(test_size=10_000, seed=12)
        s2orc_train_dataset: Dataset = s2orc_dataset_dict["train"]
        s2orc_eval_dataset: Dataset = s2orc_dataset_dict["test"]
        print("Loaded s2orc dataset.")

        print("Loading allnli dataset...")
        allnli_train_dataset = load_dataset("sentence-transformers/all-nli", "triplet", split="train")
        allnli_eval_dataset = load_dataset("sentence-transformers/all-nli", "triplet", split="dev")
        print("Loaded allnli dataset.")

        print("Loading paq dataset...")
        paq_dataset = load_dataset("sentence-transformers/paq", split="train")
        paq_dataset_dict = paq_dataset.train_test_split(test_size=10_000, seed=12)
        paq_train_dataset: Dataset = paq_dataset_dict["train"]
        paq_eval_dataset: Dataset = paq_dataset_dict["test"]
        print("Loaded paq dataset.")

        print("Loading trivia_qa dataset...")
        trivia_qa = load_dataset("sentence-transformers/trivia-qa", split="train")
        trivia_qa_dataset_dict = trivia_qa.train_test_split(test_size=5_000, seed=12)
        trivia_qa_train_dataset: Dataset = trivia_qa_dataset_dict["train"]
        trivia_qa_eval_dataset: Dataset = trivia_qa_dataset_dict["test"]
        print("Loaded trivia_qa dataset.")

        print("Loading msmarco_10m dataset...")
        msmarco_10m_dataset = load_dataset("bclavie/msmarco-10m-triplets", split="train")
        msmarco_10m_dataset_dict = msmarco_10m_dataset.train_test_split(test_size=10_000, seed=12)
        msmarco_10m_train_dataset: Dataset = msmarco_10m_dataset_dict["train"]
        msmarco_10m_eval_dataset: Dataset = msmarco_10m_dataset_dict["test"]
        print("Loaded msmarco_10m dataset.")

        print("Loading swim_ir dataset...")
        swim_ir_dataset = load_dataset("nthakur/swim-ir-monolingual", "en", split="train").select_columns(["query", "text"])
        swim_ir_dataset_dict = swim_ir_dataset.train_test_split(test_size=10_000, seed=12)
        swim_ir_train_dataset: Dataset = swim_ir_dataset_dict["train"]
        swim_ir_eval_dataset: Dataset = swim_ir_dataset_dict["test"]
        print("Loaded swim_ir dataset.")

        # NOTE: 20 negatives
        print("Loading pubmedqa dataset...")
        pubmedqa_dataset = load_dataset("sentence-transformers/pubmedqa", "triplet-20", split="train")
        pubmedqa_dataset_dict = pubmedqa_dataset.train_test_split(test_size=100, seed=12)
        pubmedqa_train_dataset: Dataset = pubmedqa_dataset_dict["train"]
        pubmedqa_eval_dataset: Dataset = pubmedqa_dataset_dict["test"]
        print("Loaded pubmedqa dataset.")

        # NOTE: A lot of overlap with anchor/positives
        print("Loading miracl dataset...")
        miracl_dataset = load_dataset("sentence-transformers/miracl", "en-triplet-all", split="train")
        miracl_dataset_dict = miracl_dataset.train_test_split(test_size=10_000, seed=12)
        miracl_train_dataset: Dataset = miracl_dataset_dict["train"]
        miracl_eval_dataset: Dataset = miracl_dataset_dict["test"]
        print("Loaded miracl dataset.")

        # NOTE: A lot of overlap with anchor/positives
        print("Loading mldr dataset...")
        mldr_dataset = load_dataset("sentence-transformers/mldr", "en-triplet-all", split="train")
        mldr_dataset_dict = mldr_dataset.train_test_split(test_size=10_000, seed=12)
        mldr_train_dataset: Dataset = mldr_dataset_dict["train"]
        mldr_eval_dataset: Dataset = mldr_dataset_dict["test"]
        print("Loaded mldr dataset.")

        # NOTE: A lot of overlap with anchor/positives
        print("Loading mr_tydi dataset...")
        mr_tydi_dataset = load_dataset("sentence-transformers/mr-tydi", "en-triplet-all", split="train")
        mr_tydi_dataset_dict = mr_tydi_dataset.train_test_split(test_size=10_000, seed=12)
        mr_tydi_train_dataset: Dataset = mr_tydi_dataset_dict["train"]
        mr_tydi_eval_dataset: Dataset = mr_tydi_dataset_dict["test"]
        print("Loaded mr_tydi dataset.")

        train_dataset = DatasetDict({
            "gooaq": gooaq_train_dataset,
            "msmarco": msmarco_train_dataset,
            "squad": squad_train_dataset,
            "s2orc": s2orc_train_dataset,
            "allnli": allnli_train_dataset,
            "paq": paq_train_dataset,
            "trivia_qa": trivia_qa_train_dataset,
            "msmarco_10m": msmarco_10m_train_dataset,
            "swim_ir": swim_ir_train_dataset,
            "pubmedqa": pubmedqa_train_dataset,
            "miracl": miracl_train_dataset,
            "mldr": mldr_train_dataset,
            "mr_tydi": mr_tydi_train_dataset,
        })
        eval_dataset = DatasetDict({
            "gooaq": gooaq_eval_dataset,
            "msmarco": msmarco_eval_dataset,
            "squad": squad_eval_dataset,
            "s2orc": s2orc_eval_dataset,
            "allnli": allnli_eval_dataset,
            "paq": paq_eval_dataset,
            "trivia_qa": trivia_qa_eval_dataset,
            "msmarco_10m": msmarco_10m_eval_dataset,
            "swim_ir": swim_ir_eval_dataset,
            "pubmedqa": pubmedqa_eval_dataset,
            "miracl": miracl_eval_dataset,
            "mldr": mldr_eval_dataset,
            "mr_tydi": mr_tydi_eval_dataset,
        })

        train_dataset.save_to_disk("datasets/train_dataset")
        eval_dataset.save_to_disk("datasets/eval_dataset")

        # The `train_test_split` calls have put a lot of the datasets in memory, while we want it to just be on disk
        quit()


def main():
    # 1. Load a model to finetune with 2. (Optional) model card data
    static_embedding = StaticEmbedding(AutoTokenizer.from_pretrained("google-bert/bert-base-uncased"), embedding_dim=1024)
    model = SentenceTransformer(
        modules=[static_embedding],
        model_card_data=SentenceTransformerModelCardData(
            language="en",
            license="apache-2.0",
            model_name="Static Embeddings with BERT uncased tokenizer finetuned on various datasets",
        ),
    )

    # 3. Set up training & evaluation datasets - each dataset is trained with MNRL (with MRL)
    train_dataset, eval_dataset = load_train_eval_datasets()
    print(train_dataset)

    # 4. Define a loss function
    loss = MultipleNegativesRankingLoss(model)
    loss = MatryoshkaLoss(model, loss, matryoshka_dims=[32, 64, 128, 256, 512, 1024])

    # 5. (Optional) Specify training arguments
    run_name = "static-retrieval-mrl-en-v1"
    args = SentenceTransformerTrainingArguments(
        # Required parameter:
        output_dir=f"models/{run_name}",
        # Optional training parameters:
        num_train_epochs=1,
        per_device_train_batch_size=2048,
        per_device_eval_batch_size=2048,
        learning_rate=2e-1,
        warmup_ratio=0.1,
        fp16=False,  # Set to False if you get an error that your GPU can't run on FP16
        bf16=True,  # Set to True if you have a GPU that supports BF16
        batch_sampler=BatchSamplers.NO_DUPLICATES,  # MultipleNegativesRankingLoss benefits from no duplicate samples in a batch
        multi_dataset_batch_sampler=MultiDatasetBatchSamplers.PROPORTIONAL,
        # Optional tracking/debugging parameters:
        eval_strategy="steps",
        eval_steps=250,
        save_strategy="steps",
        save_steps=250,
        save_total_limit=2,
        logging_steps=250,
        logging_first_step=True,
        run_name=run_name,  # Will be used in W&B if `wandb` is installed
    )

    # 6. (Optional) Create an evaluator & evaluate the base model
    evaluator = NanoBEIREvaluator()
    evaluator(model)

    # 7. Create a trainer & train
    trainer = SentenceTransformerTrainer(
        model=model,
        args=args,
        train_dataset=train_dataset,
        eval_dataset=eval_dataset,
        loss=loss,
        evaluator=evaluator,
    )
    trainer.train()

    # (Optional) Evaluate the trained model on the evaluator after training
    evaluator(model)

    # 8. Save the trained model
    model.save_pretrained(f"models/{run_name}/final")

    # 9. (Optional) Push it to the Hugging Face Hub
    model.push_to_hub(run_name, private=True)

if __name__ == "__main__":
    main()
這份指令碼經過 17.8 小時訓練後,產生了 sentence-transformers/static-retrieval-mrl-en-v1。總共消耗 2.6 kWh 電力,排放 1kg 二氧化碳,大約等於一般人一天呼出的二氧化碳量。
請參閲我們的 Weights and Biases 報告,查看訓練期間收集的訓練和評估指標。
多語言相似度
按此展開
import random
import logging
from datasets import load_dataset, Dataset, DatasetDict
from sentence_transformers import (
    SentenceTransformer,
    SentenceTransformerTrainer,
    SentenceTransformerTrainingArguments,
    SentenceTransformerModelCardData,
)
from sentence_transformers.losses import MatryoshkaLoss, MultipleNegativesRankingLoss
from sentence_transformers.training_args import BatchSamplers, MultiDatasetBatchSamplers
from sentence_transformers.models.StaticEmbedding import StaticEmbedding

from transformers import AutoTokenizer

logging.basicConfig(
    format="%(asctime)s - %(message)s", datefmt="%Y-%m-%d %H:%M:%S", level=logging.INFO
)
random.seed(12)


def load_train_eval_datasets():
    """
    Either load the train and eval datasets from disk or load them from the datasets library & save them to disk.

    Upon saving to disk, we quit() to ensure that the datasets are not loaded into memory before training.
    """
    try:
        train_dataset = DatasetDict.load_from_disk("datasets/train_dataset")
        eval_dataset = DatasetDict.load_from_disk("datasets/eval_dataset")
        return train_dataset, eval_dataset
    except FileNotFoundError:
        print("Loading wikititles dataset...")
        wikititles_dataset = load_dataset("sentence-transformers/parallel-sentences-wikititles", split="train")
        wikititles_dataset_dict = wikititles_dataset.train_test_split(test_size=10_000, seed=12)
        wikititles_train_dataset: Dataset = wikititles_dataset_dict["train"]
        wikititles_eval_dataset: Dataset = wikititles_dataset_dict["test"]
        print("Loaded wikititles dataset.")

        print("Loading tatoeba dataset...")
        tatoeba_dataset = load_dataset("sentence-transformers/parallel-sentences-tatoeba", "all", split="train")
        tatoeba_dataset_dict = tatoeba_dataset.train_test_split(test_size=10_000, seed=12)
        tatoeba_train_dataset: Dataset = tatoeba_dataset_dict["train"]
        tatoeba_eval_dataset: Dataset = tatoeba_dataset_dict["test"]
        print("Loaded tatoeba dataset.")

        print("Loading talks dataset...")
        talks_dataset = load_dataset("sentence-transformers/parallel-sentences-talks", "all", split="train")
        talks_dataset_dict = talks_dataset.train_test_split(test_size=10_000, seed=12)
        talks_train_dataset: Dataset = talks_dataset_dict["train"]
        talks_eval_dataset: Dataset = talks_dataset_dict["test"]
        print("Loaded talks dataset.")

        print("Loading europarl dataset...")
        europarl_dataset = load_dataset("sentence-transformers/parallel-sentences-europarl", "all", split="train[:5000000]")
        europarl_dataset_dict = europarl_dataset.train_test_split(test_size=10_000, seed=12)
        europarl_train_dataset: Dataset = europarl_dataset_dict["train"]
        europarl_eval_dataset: Dataset = europarl_dataset_dict["test"]
        print("Loaded europarl dataset.")

        print("Loading global voices dataset...")
        global_voices_dataset = load_dataset("sentence-transformers/parallel-sentences-global-voices", "all", split="train")
        global_voices_dataset_dict = global_voices_dataset.train_test_split(test_size=10_000, seed=12)
        global_voices_train_dataset: Dataset = global_voices_dataset_dict["train"]
        global_voices_eval_dataset: Dataset = global_voices_dataset_dict["test"]
        print("Loaded global voices dataset.")

        print("Loading jw300 dataset...")
        jw300_dataset = load_dataset("sentence-transformers/parallel-sentences-jw300", "all", split="train")
        jw300_dataset_dict = jw300_dataset.train_test_split(test_size=10_000, seed=12)
        jw300_train_dataset: Dataset = jw300_dataset_dict["train"]
        jw300_eval_dataset: Dataset = jw300_dataset_dict["test"]
        print("Loaded jw300 dataset.")

        print("Loading muse dataset...")
        muse_dataset = load_dataset("sentence-transformers/parallel-sentences-muse", split="train")
        muse_dataset_dict = muse_dataset.train_test_split(test_size=10_000, seed=12)
        muse_train_dataset: Dataset = muse_dataset_dict["train"]
        muse_eval_dataset: Dataset = muse_dataset_dict["test"]
        print("Loaded muse dataset.")

        print("Loading wikimatrix dataset...")
        wikimatrix_dataset = load_dataset("sentence-transformers/parallel-sentences-wikimatrix", "all", split="train")
        wikimatrix_dataset_dict = wikimatrix_dataset.train_test_split(test_size=10_000, seed=12)
        wikimatrix_train_dataset: Dataset = wikimatrix_dataset_dict["train"]
        wikimatrix_eval_dataset: Dataset = wikimatrix_dataset_dict["test"]
        print("Loaded wikimatrix dataset.")

        print("Loading opensubtitles dataset...")
        opensubtitles_dataset = load_dataset("sentence-transformers/parallel-sentences-opensubtitles", "all", split="train[:5000000]")
        opensubtitles_dataset_dict = opensubtitles_dataset.train_test_split(test_size=10_000, seed=12)
        opensubtitles_train_dataset: Dataset = opensubtitles_dataset_dict["train"]
        opensubtitles_eval_dataset: Dataset = opensubtitles_dataset_dict["test"]
        print("Loaded opensubtitles dataset.")

        print("Loading stackexchange dataset...")
        stackexchange_dataset = load_dataset("sentence-transformers/stackexchange-duplicates", "post-post-pair", split="train")
        stackexchange_dataset_dict = stackexchange_dataset.train_test_split(test_size=10_000, seed=12)
        stackexchange_train_dataset: Dataset = stackexchange_dataset_dict["train"]
        stackexchange_eval_dataset: Dataset = stackexchange_dataset_dict["test"]
        print("Loaded stackexchange dataset.")

        print("Loading quora dataset...")
        quora_dataset = load_dataset("sentence-transformers/quora-duplicates", "triplet", split="train")
        quora_dataset_dict = quora_dataset.train_test_split(test_size=10_000, seed=12)
        quora_train_dataset: Dataset = quora_dataset_dict["train"]
        quora_eval_dataset: Dataset = quora_dataset_dict["test"]
        print("Loaded quora dataset.")

        print("Loading wikianswers duplicates dataset...")
        wikianswers_duplicates_dataset = load_dataset("sentence-transformers/wikianswers-duplicates", split="train[:10000000]")
        wikianswers_duplicates_dict = wikianswers_duplicates_dataset.train_test_split(test_size=10_000, seed=12)
        wikianswers_duplicates_train_dataset: Dataset = wikianswers_duplicates_dict["train"]
        wikianswers_duplicates_eval_dataset: Dataset = wikianswers_duplicates_dict["test"]
        print("Loaded wikianswers duplicates dataset.")

        print("Loading all nli dataset...")
        all_nli_train_dataset = load_dataset("sentence-transformers/all-nli", "triplet", split="train")
        all_nli_eval_dataset = load_dataset("sentence-transformers/all-nli", "triplet", split="dev")
        print("Loaded all nli dataset.")

        print("Loading simple wiki dataset...")
        simple_wiki_dataset = load_dataset("sentence-transformers/simple-wiki", split="train")
        simple_wiki_dataset_dict = simple_wiki_dataset.train_test_split(test_size=10_000, seed=12)
        simple_wiki_train_dataset: Dataset = simple_wiki_dataset_dict["train"]
        simple_wiki_eval_dataset: Dataset = simple_wiki_dataset_dict["test"]
        print("Loaded simple wiki dataset.")

        print("Loading altlex dataset...")
        altlex_dataset = load_dataset("sentence-transformers/altlex", split="train")
        altlex_dataset_dict = altlex_dataset.train_test_split(test_size=10_000, seed=12)
        altlex_train_dataset: Dataset = altlex_dataset_dict["train"]
        altlex_eval_dataset: Dataset = altlex_dataset_dict["test"]
        print("Loaded altlex dataset.")

        print("Loading flickr30k captions dataset...")
        flickr30k_captions_dataset = load_dataset("sentence-transformers/flickr30k-captions", split="train")
        flickr30k_captions_dataset_dict = flickr30k_captions_dataset.train_test_split(test_size=10_000, seed=12)
        flickr30k_captions_train_dataset: Dataset = flickr30k_captions_dataset_dict["train"]
        flickr30k_captions_eval_dataset: Dataset = flickr30k_captions_dataset_dict["test"]
        print("Loaded flickr30k captions dataset.")

        print("Loading coco captions dataset...")
        coco_captions_dataset = load_dataset("sentence-transformers/coco-captions", split="train")
        coco_captions_dataset_dict = coco_captions_dataset.train_test_split(test_size=10_000, seed=12)
        coco_captions_train_dataset: Dataset = coco_captions_dataset_dict["train"]
        coco_captions_eval_dataset: Dataset = coco_captions_dataset_dict["test"]
        print("Loaded coco captions dataset.")

        print("Loading nli for simcse dataset...")
        nli_for_simcse_dataset = load_dataset("sentence-transformers/nli-for-simcse", "triplet", split="train")
        nli_for_simcse_dataset_dict = nli_for_simcse_dataset.train_test_split(test_size=10_000, seed=12)
        nli_for_simcse_train_dataset: Dataset = nli_for_simcse_dataset_dict["train"]
        nli_for_simcse_eval_dataset: Dataset = nli_for_simcse_dataset_dict["test"]
        print("Loaded nli for simcse dataset.")

        print("Loading negation dataset...")
        negation_dataset = load_dataset("jinaai/negation-dataset", split="train")
        negation_dataset_dict = negation_dataset.train_test_split(test_size=100, seed=12)
        negation_train_dataset: Dataset = negation_dataset_dict["train"]
        negation_eval_dataset: Dataset = negation_dataset_dict["test"]
        print("Loaded negation dataset.")

        train_dataset = DatasetDict({
            "wikititles": wikititles_train_dataset,
            "tatoeba": tatoeba_train_dataset,
            "talks": talks_train_dataset,
            "europarl": europarl_train_dataset,
            "global_voices": global_voices_train_dataset,
            "jw300": jw300_train_dataset,
            "muse": muse_train_dataset,
            "wikimatrix": wikimatrix_train_dataset,
            "opensubtitles": opensubtitles_train_dataset,
            "stackexchange": stackexchange_train_dataset,
            "quora": quora_train_dataset,
            "wikianswers_duplicates": wikianswers_duplicates_train_dataset,
            "all_nli": all_nli_train_dataset,
            "simple_wiki": simple_wiki_train_dataset,
            "altlex": altlex_train_dataset,
            "flickr30k_captions": flickr30k_captions_train_dataset,
            "coco_captions": coco_captions_train_dataset,
            "nli_for_simcse": nli_for_simcse_train_dataset,
            "negation": negation_train_dataset,
        })
        eval_dataset = DatasetDict({
            "wikititles": wikititles_eval_dataset,
            "tatoeba": tatoeba_eval_dataset,
            "talks": talks_eval_dataset,
            "europarl": europarl_eval_dataset,
            "global_voices": global_voices_eval_dataset,
            "jw300": jw300_eval_dataset,
            "muse": muse_eval_dataset,
            "wikimatrix": wikimatrix_eval_dataset,
            "opensubtitles": opensubtitles_eval_dataset,
            "stackexchange": stackexchange_eval_dataset,
            "quora": quora_eval_dataset,
            "wikianswers_duplicates": wikianswers_duplicates_eval_dataset,
            "all_nli": all_nli_eval_dataset,
            "simple_wiki": simple_wiki_eval_dataset,
            "altlex": altlex_eval_dataset,
            "flickr30k_captions": flickr30k_captions_eval_dataset,
            "coco_captions": coco_captions_eval_dataset,
            "nli_for_simcse": nli_for_simcse_eval_dataset,
            "negation": negation_eval_dataset,
        })

        train_dataset.save_to_disk("datasets/train_dataset")
        eval_dataset.save_to_disk("datasets/eval_dataset")

        # The `train_test_split` calls have put a lot of the datasets in memory, while we want it to just be on disk
        quit()

def main():
    # 1. Load a model to finetune with 2. (Optional) model card data
    static_embedding = StaticEmbedding(AutoTokenizer.from_pretrained("google-bert/bert-base-multilingual-uncased"), embedding_dim=1024)
    model = SentenceTransformer(
        modules=[static_embedding],
        model_card_data=SentenceTransformerModelCardData(
            license="apache-2.0",
            model_name="Static Embeddings with BERT Multilingual uncased tokenizer finetuned on various datasets",
        ),
    )

    # 3. Set up training & evaluation datasets - each dataset is trained with MNRL (with MRL)
    train_dataset, eval_dataset = load_train_eval_datasets()
    print(train_dataset)

    # 4. Define a loss function
    loss = MultipleNegativesRankingLoss(model)
    loss = MatryoshkaLoss(model, loss, matryoshka_dims=[32, 64, 128, 256, 512, 1024])

    # 5. (Optional) Specify training arguments
    run_name = "static-similarity-mrl-multilingual-v1"
    args = SentenceTransformerTrainingArguments(
        # Required parameter:
        output_dir=f"models/{run_name}",
        # Optional training parameters:
        num_train_epochs=1,
        per_device_train_batch_size=2048,
        per_device_eval_batch_size=2048,
        learning_rate=2e-1,
        warmup_ratio=0.1,
        fp16=False,  # Set to False if you get an error that your GPU can't run on FP16
        bf16=True,  # Set to True if you have a GPU that supports BF16
        batch_sampler=BatchSamplers.NO_DUPLICATES,  # MultipleNegativesRankingLoss benefits from no duplicate samples in a batch
        multi_dataset_batch_sampler=MultiDatasetBatchSamplers.PROPORTIONAL,
        # Optional tracking/debugging parameters:
        eval_strategy="steps",
        eval_steps=1000,
        save_strategy="steps",
        save_steps=1000,
        save_total_limit=2,
        logging_steps=1000,
        logging_first_step=True,
        run_name=run_name,  # Will be used in W&B if `wandb` is installed
    )

    # 6. Create a trainer & train
    trainer = SentenceTransformerTrainer(
        model=model,
        args=args,
        train_dataset=train_dataset,
        eval_dataset=eval_dataset,
        loss=loss,
    )
    trainer.train()

    # 7. Save the trained model
    model.save_pretrained(f"models/{run_name}/final")

    # 8. (Optional) Push it to the Hugging Face Hub
    model.push_to_hub(run_name, private=True)

if __name__ == "__main__":
    main()
這份指令碼經過 3.1 小時訓練後,產生了 sentence-transformers/static-similarity-mrl-multilingual-v1。總共消耗 0.5 kWh 電力,排放 0.2kg 二氧化碳,大約是一般人一天呼出二氧化碳量的 20%。
請參閲我們的 Weights and Biases 報告,查看訓練期間收集的訓練和評估損失。
使用方式
這些模型的使用方法非常直接,與一般 Sentence Transformers 流程完全相同:
英文檢索
from sentence_transformers import SentenceTransformer

# Download from the 🤗 Hub
model = SentenceTransformer("sentence-transformers/static-retrieval-mrl-en-v1", device="cpu")
# Run inference
sentences = [
    'Gadofosveset-enhanced MR angiography of carotid arteries: does steady-state imaging improve accuracy of first-pass imaging?',
    'To evaluate the diagnostic accuracy of gadofosveset-enhanced magnetic resonance (MR) angiography in the assessment of carotid artery stenosis, with digital subtraction angiography (DSA) as the reference standard, and to determine the value of reading first-pass, steady-state, and "combined" (first-pass plus steady-state) MR angiograms.',
    'In a longitudinal study we investigated in vivo alterations of CVO during neuroinflammation, applying Gadofluorine M- (Gf) enhanced magnetic resonance imaging (MRI) in experimental autoimmune encephalomyelitis, an animal model of multiple sclerosis. SJL/J mice were monitored by Gadopentate dimeglumine- (Gd-DTPA) and Gf-enhanced MRI after adoptive transfer of proteolipid-protein-specific T cells. Mean Gf intensity ratios were calculated individually for different CVO and correlated to the clinical disease course. Subsequently, the tissue distribution of fluorescence-labeled Gf as well as the extent of cellular inflammation was assessed in corresponding histological slices.',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 1024]

# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings[0], embeddings[1:])
print(similarities)
# tensor([[0.7649, 0.3279]])
以下的效能 > 英文檢索一節會顯示,這些結果相當可靠,與 all-mpnet-base-v2 等常用 Transformer encoder 模型的差距在 15% 以內。
SentenceTransformerAPI 參考文件。SentenceTransformer.encodeAPI 參考文件。SentenceTransformer.similarityAPI 參考文件。
多語言相似度
from sentence_transformers import SentenceTransformer

# Download from the 🤗 Hub
model = SentenceTransformer("sentence-transformers/static-similarity-mrl-multilingual-v1", device="cpu")
# Run inference
sentences = [
    'It is known for its dry red chili powder.',
    'It is popular for dried red chili powder.',
    'These monsters will move in large groups.',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 1024]

# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings, embeddings)
print(similarities)
# tensor([[ 1.0000,  0.8388, -0.0012],
#         [ 0.8388,  1.0000,  0.0445],
#         [-0.0012,  0.0445,  1.0000]])
與熱門但速度慢得多的 multilingual-e5-small 相比,這款模型只損失約 8% 表現;詳情請參閲下文效能 > 多語言相似度一節。
SentenceTransformerAPI 參考文件。SentenceTransformer.encodeAPI 參考文件。SentenceTransformer.similarityAPI 參考文件。
Matryoshka 維度截短
要減少所計算嵌入向量的維度,只需傳入 truncate_dim 參數。這適用於所有 Sentence Transformer 模型。
from sentence_transformers import SentenceTransformer

# Download from the 🤗 Hub
model = SentenceTransformer(
    "sentence-transformers/static-retrieval-mrl-en-v1",
    device="cpu",
    truncate_dim=256,
)
# Run inference
sentences = [
    'Gadofosveset-enhanced MR angiography of carotid arteries: does steady-state imaging improve accuracy of first-pass imaging?',
    'To evaluate the diagnostic accuracy of gadofosveset-enhanced magnetic resonance (MR) angiography in the assessment of carotid artery stenosis, with digital subtraction angiography (DSA) as the reference standard, and to determine the value of reading first-pass, steady-state, and "combined" (first-pass plus steady-state) MR angiograms.',
    'In a longitudinal study we investigated in vivo alterations of CVO during neuroinflammation, applying Gadofluorine M- (Gf) enhanced magnetic resonance imaging (MRI) in experimental autoimmune encephalomyelitis, an animal model of multiple sclerosis. SJL/J mice were monitored by Gadopentate dimeglumine- (Gd-DTPA) and Gf-enhanced MRI after adoptive transfer of proteolipid-protein-specific T cells. Mean Gf intensity ratios were calculated individually for different CVO and correlated to the clinical disease course. Subsequently, the tissue distribution of fluorescence-labeled Gf as well as the extent of cellular inflammation was assessed in corresponding histological slices.',
]
embeddings = model.encode(sentences)
print(embeddings.shape)
# [3, 256]

# Get the similarity scores for the embeddings
similarities = model.similarity(embeddings[0], embeddings[1:])
print(similarities)
# tensor([[0.7844, 0.3561]])
第三方程式庫
這款模型也可直接用於多種第三方程式庫,例如 LangChain、LlamaIndex、Haystack 和 txtai。
LangChain
# pip install langchain langchain_huggingface
from langchain_huggingface import HuggingFaceEmbeddings

model_name = "sentence-transformers/static-retrieval-mrl-en-v1"
model_kwargs = {'device': 'cpu'} # you can use 'truncate_dim' here
model = HuggingFaceEmbeddings(
    model_name=model_name,
    model_kwargs=model_kwargs,
)
LlamaIndex
# pip install llama-index llama-index-embeddings-huggingface
from llama_index.core import Settings
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

# Set up the HuggingFaceEmbedding class with the required model to use with llamaindex core.
model_name = "sentence-transformers/static-retrieval-mrl-en-v1"
device = "cpu"
embed_model = HuggingFaceEmbedding(
    model_name=model_name,
    device=device,
    # truncate_dim=256, # you can use 'truncate_dim' here
)
Settings.embed_model = embed_model
Haystack
# pip install haystack sentence-transformers
from haystack.components.embedders import (
    SentenceTransformersDocumentEmbedder,
    SentenceTransformersTextEmbedder,
)

model_name = "sentence-transformers/static-retrieval-mrl-en-v1"
device = "cpu"
document_embedder = SentenceTransformersDocumentEmbedder(
    model=model_name,
    device=device,
    # truncate_dim=256, # you can use 'truncate_dim' here
)
text_embedder = SentenceTransformersTextEmbedder(
    model=model_name,
    device=device,
    # truncate_dim=256, # you can use 'truncate_dim' here
)
txtai
# pip install txtai sentence-transformers
from txtai import Embeddings

model_name = "sentence-transformers/static-retrieval-mrl-en-v1"
embeddings = Embeddings(path=model_name)
效能
英文檢索
訓練完成後,我們以 NanoBEIR(一般維度和 Matryoshka 維度)及 BEIR 評估最終模型 sentence-transformers/static-retrieval-mrl-en-v1。
NanoBEIR
我們在 NanoBEIR 上評估 sentence-transformers/static-retrieval-mrl-en-v1,並將結果與我們硬件上的推論速度比較。測試推論速度時,我們計算每秒處理的 GooAQ 資料集查詢嵌入數量,分別測試 CPU 和 GPU。
我們會比較三類模型:
以注意力為基礎的密集嵌入模型,例如傳統 Sentence Transformer 模型:
all-mpnet-base-v2、bge-base-en-v1.5和gte-large-en-v1.5。基於靜態嵌入的模型,例如
static-retrieval-mrl-en-v1、potion-base-8M、M2V_base_output和glove.6B.300d。稀疏詞袋模型 BM25,通常是很強的基線。
點擊展開 BM25 實作詳情我們採用高效率的 bm25s 實作,使用
model.get_scores()處理 token;而 token 在經過 tokenization 及英文PyStemmer詞幹提取後供模型使用。
注意:許多以注意力為基礎的密集嵌入模型,都是在(Nano)BEIR 評估資料集的訓練分割上微調。這令模型在此基準測試中享有不公平優勢,亦可能導致它們在實際檢索任務中的下游表現較差。
static-retrieval-mrl-en-v1 特意沒有在任何這些資料集上訓練。
按此查看以下兩幅圖的全部數據表
| 模型 | NanoBEIR NDCG@10 | CPU(每秒句子數) | GPU(每秒句子數) |
|---|---|---|---|
| zeta-alpha-ai/Zeta-Alpha-E5-Mistral | 0.6860 | 0.00* | 0.00* |
| Alibaba-NLP/gte-large-en-v1.5 | 0.6808 | 56.01 | 965.95 |
| Salesforce/SFR-Embedding-Mistral | 0.6800 | 0.00* | 0.00* |
| mixedbread-ai/mxbai-embed-large-v1 | 0.6567 | 79.83 | 1376.80 |
| BAAI/bge-large-en-v1.5 | 0.6592 | 80.94 | 1315.03 |
| intfloat/e5-mistral-7b-instruct | 0.6530 | 0.00* | 0.00* |
| Alibaba-NLP/gte-base-en-v1.5 | 0.6411 | 197.85 | 3142.94 |
| BAAI/bge-base-en-v1.5 | 0.6376 | 264.83 | 4363.04 |
| BAAI/bge-small-en-v1.5 | 0.6267 | 888.46 | 10159.97 |
| nomic-ai/nomic-embed-text-v1.5 | 0.6179 | 86.86 | 2843.03 |
| jinaai/jina-embeddings-v3 | 0.6174 | 0.55 | 3377.56 |
| BAAI/bge-m3 | 0.6054 | 80.63 | 1434.82 |
| sentence-transformers/all-mpnet-base-v2 | 0.5757 | 270.40 | 4043.13 |
| TaylorAI/gte-tiny | 0.5692 | 1752.26 | 17215.15 |
| sentence-transformers/all-MiniLM-L6-v2 | 0.5623 | 1739.31 | 16942.46 |
| mixedbread-ai/mxbai-embed-xsmall-v1 | 0.5557 | 1749.42 | 16773.76 |
| sentence-transformers/all-MiniLM-L12-v2 | 0.5533 | 909.72 | 9915.69 |
| sentence-transformers/static-retrieval-mrl-en-v1 | 0.5032 | 107419.51 | 97171.47 |
| bm25 | 0.4518 | 49706.77 | 49706.77 |
| minishlab/potion-base-8M | 0.4421 | 124029.91 | 122384.10 |
| minishlab/potion-base-4M | 0.4225 | 123082.88 | 123612.54 |
| minishlab/M2V_base_glove | 0.4077 | 142173.77 | 146154.73 |
| minishlab/M2V_base_glove_subword | 0.3914 | 127426.83 | 131412.56 |
| minishlab/M2V_base_output | 0.3851 | 84191.93 | 85738.36 |
| minishlab/potion-base-2M | 0.3666 | 128994.27 | 122358.16 |
| sentence-transformers/glove.6B.300d | 0.3293 | 76519.74 | 62782.23 |
| sentence-transformers/glove.840B.300d | 0.2899 | 86348.98 | 75350.36 |
*:對於 7B LLM,我們沒有進行推論實驗,因為它們的推論速度在圖表中會顯示為接近 0。- 我們進行了實驗,為每個模型找出最佳批次大小。
GPU
CPU

從這些圖表可以得出一些重要結論:
static-retrieval-mrl-en-v1勝過 GloVe 或 Model2Vec 等所有其他靜態嵌入模型。static-retrieval-mrl-en-v1是唯一效能勝過 BM25 的靜態嵌入模型。static-retrieval-mrl-en-v1是- 表現達到87.4%,相當於常用的
all-mpnet-base-v2, - GPU 上快24x,
- CPU 上快397x。
- 表現達到87.4%,相當於常用的
static-retrieval-mrl-en-v1在 CPU 上比 GPU 更快:這款模型在任何地方都能極速執行,包括消費級電腦、小型伺服器、手機和瀏覽器。
Matryoshka 評估
此外,我們也測試了採用 Matryoshka 方式降低維度(截短輸出嵌入向量)對 NanoBEIR 表現的影響。

結果顯示,例如把維度減半,表現只下降 1.47%(NDCG@10 由 0.5031 降至 0.4957),而檢索速度實際上可提升 2x。
多語言相似度
我們也在 sentence-transformers/static-similarity-mrl-multilingual-v1 最終模型上,於 5 種在不同任務上有大量基準測試的語言進行評估,並在 MTEB 上檢視結果。
我們再次強調,這款模型並非用於檢索用途;相反,我們評估語意文字相似度(STS)、分類和配對分類,並與優秀而小巧的 multilingual-e5-small 模型比較。

在所有測試語言中,static-similarity-mrl-multilingual-v1 的平均表現:STS 達到 92.3%、配對分類達到 95.52%,分類則達到 86.52%,比較對象為 multilingual-e5-small。

為彌補表現差距,static-similarity-mrl-multilingual-v1 在 CPU 上比 multilingual-e5-small 快約 125x,在 GPU 裝置上則快約 10x。由於注意力模型的複雜度呈超線性增長,而靜態嵌入模型則呈線性增長,編碼 token 數量越多,速度優勢便會越大。
Matryoshka 評估
最後,我們透過截短輸出嵌入向量以降低維度,測試這對 MTEB 英文 STS 表現的影響。

如你所見,維度可輕易減半或縮至四分之一,而表現只分別下降少量(0.15% 或 0.56%)。如果下游任務速度或儲存成本是瓶頸,這應有助紓緩相關問題。
結論
本文介紹了從構思到完成模型的所有步驟,也詳細説明瞭兩款模型 static-retrieval-mrl-en-v1 和 static-similarity-mrl-multilingual-v1 的使用和評估方式。
評估結果顯示:
- 基於靜態嵌入的模型可達到常見注意力式密集模型85%以上的表現;
- 以實際情況而言,靜態嵌入模型在 GPU 上快10x 至 25x,在 CPU 上快100x 至 400x,勝過 all-mpnet-base-v2 和 multilingual-e5-small 等常見的高效率替代方案。文字越長,速度優勢便越大。
- 採用 Matryoshka 損失訓練,有助大幅保留下游效能:
- 縮小 4x後,英文 STS 表現只下降0.56%,相對比較的模型是 static-similarity-mrl-multilingual-v1;而
- 縮小 2x後,英文檢索表現只下降1.47%,相對比較的模型是 static-retrieval-mrl-en-v1。
如果你需要只用 CPU 執行、用於檢索或相似度任務的高效率密集嵌入模型,static-retrieval-mrl-en-v1 和 static-similarity-mrl-multilingual-v1 都是效能出色而成本極低的方案,表現亦出乎意料地接近注意力式密集模型。
後續步驟
試用看看!如果你已在某處使用 Sentence Transformer 模型,不妨換成 static-retrieval-mrl-en-v1 或 static-similarity-mrl-multilingual-v1。更理想的是,使用能代表你感興趣任務和語言的資料自行訓練模型。
此外,關於受訓模型還有一些問題未有答案:
由於基於靜態嵌入的模型不受位置嵌入或超線性時間複雜度限制,因此最大序列長度可以任意提高。不過,對於非常長的文件,大數法則可能最終會把所有嵌入向量「正規化」,令它們失去用途。
仍需更多實驗,才能確定合適的截斷點。目前最大序列長度、分塊等設定都交由用戶決定。
此外,還有不少可能改善模型表現的擴展方法,我們樂於交由其他模型作者探索,也歡迎合作:
- 挖掘難負例:搜尋相似但並非完全相關的文字,提高訓練資料難度。
- 模型融合:以不同隨機種子或資料分佈訓練多個模型,再合併其權重。
- 課程式學習:使用難度逐漸提高的例子訓練。
- 有指引的批次內假負例篩選:使用高效率的預訓練嵌入模型排除假負例。
- 隨機權重初始化的種子最佳化:以不同隨機種子訓練最初幾步,找出有用的權重初始化。
- 重新訓練 tokenizer:使用現代文字和經驗重新訓練 tokenizer。
- 梯度快取:透過
CachedMultipleNegativesRankingLoss使用 GradCache,可支援更大的批次,往往能帶來更佳表現。 - 模型蒸餾:除了只使用監督式訓練資料,也可以把無監督資料送入較大的嵌入模型,再把其嵌入向量蒸餾至基於靜態嵌入的 student 模型。
延伸網誌文章
如果你想訓練其他 Sentence Transformers 模型類型,或瞭解可與靜態嵌入模型搭配的效率技術:
- 使用 Sentence Transformers 訓練和微調嵌入模型:雙編碼器嵌入模型的一般訓練指南;本文的靜態模型配方是其專門版本。
- 使用 Sentence Transformers 訓練和微調重排序模型:Cross Encoder 訓練,是靜態檢索器之上的自然第二階段。
- 使用 Sentence Transformers 訓練和微調稀疏嵌入模型:SPLADE 訓練,可在混合設定中補足靜態密集檢索。
- 使用 Sentence Transformers 建立多模態嵌入和重排序模型及訓練和微調多模態嵌入和重排序模型:文字、圖像、音訊和影片模型的推論和訓練。
- 🪆 Matryoshka 嵌入模型簡介:介紹本文用來截短靜態嵌入向量的 Matryoshka 損失。
- 二元和純量嵌入量化,大幅加快並降低檢索成本:可與本文速度提升疊加的訓練後壓縮技術。
致謝
感謝 Stéphan Tulkens 和 Thomas van Dongen(The Minish Lab)透過 Model2Vec 工作,讓我留意到靜態嵌入模型。另外,感謝 Vaibhav Srivastav 和 Pedro Cuenca 協助撰寫這篇網誌,也感謝 Antoine Chaffin 一同構思發布檢查點。
最後,衷心感謝所有研究嵌入模型、資料集和開源 Python 套件的研究人員。你們讓整個行業更強大,而我則站在你們的肩膀上。希望有一天,你們也能站在我的肩膀上。
來源:Hugging Face Blog · huggingface.co