AWS 示範以 Ray Train DLC 和 EFA 在 EKS 進行分散式訓練
Distributed training with Ray Train DLCs and EFA on EKS
AWS 示範以 Ray Train DLC、KubeRay 和 EFA 在 EKS 上用 FSDP 微調 Qwen2.5-1.5B。
文章逐一説明容器、叢集與傳輸設定如何分工,並展示以預建映像部署多機訓練及檢查 EFA 網絡路徑的方法。
譯文尚不完整,完整內容請切換到原文。
通常令 PyTorch 訓練無法擴展至叢集的,不是模型程式碼,而是容器。每個容器都需要相同的 CUDA 執行階段、以其為基礎編譯的 PyTorch 組建、NCCL(NVIDIA Collective Communications Library)、Elastic Fabric Adapter (EFA) 使用者空間程式庫、將 NCCL 連接至 EFA 的 AWS OFI NCCL 外掛程式,以及叢集營運者認可的 Ray 版本。建立映像檔,並在其中任何元件更新時重新建立,已經是一項獨立工程,與你原本要訓練的模型毫無關係。Ray Train Deep Learning Container (DLC) 就是這個映像檔,由 AWS 建置。AWS 組合整個軟件堆疊,將其作為一個整體進行測試,在 Amazon Elastic Container Registry (Amazon ECR) Public 發佈,並持續套用修補程式。
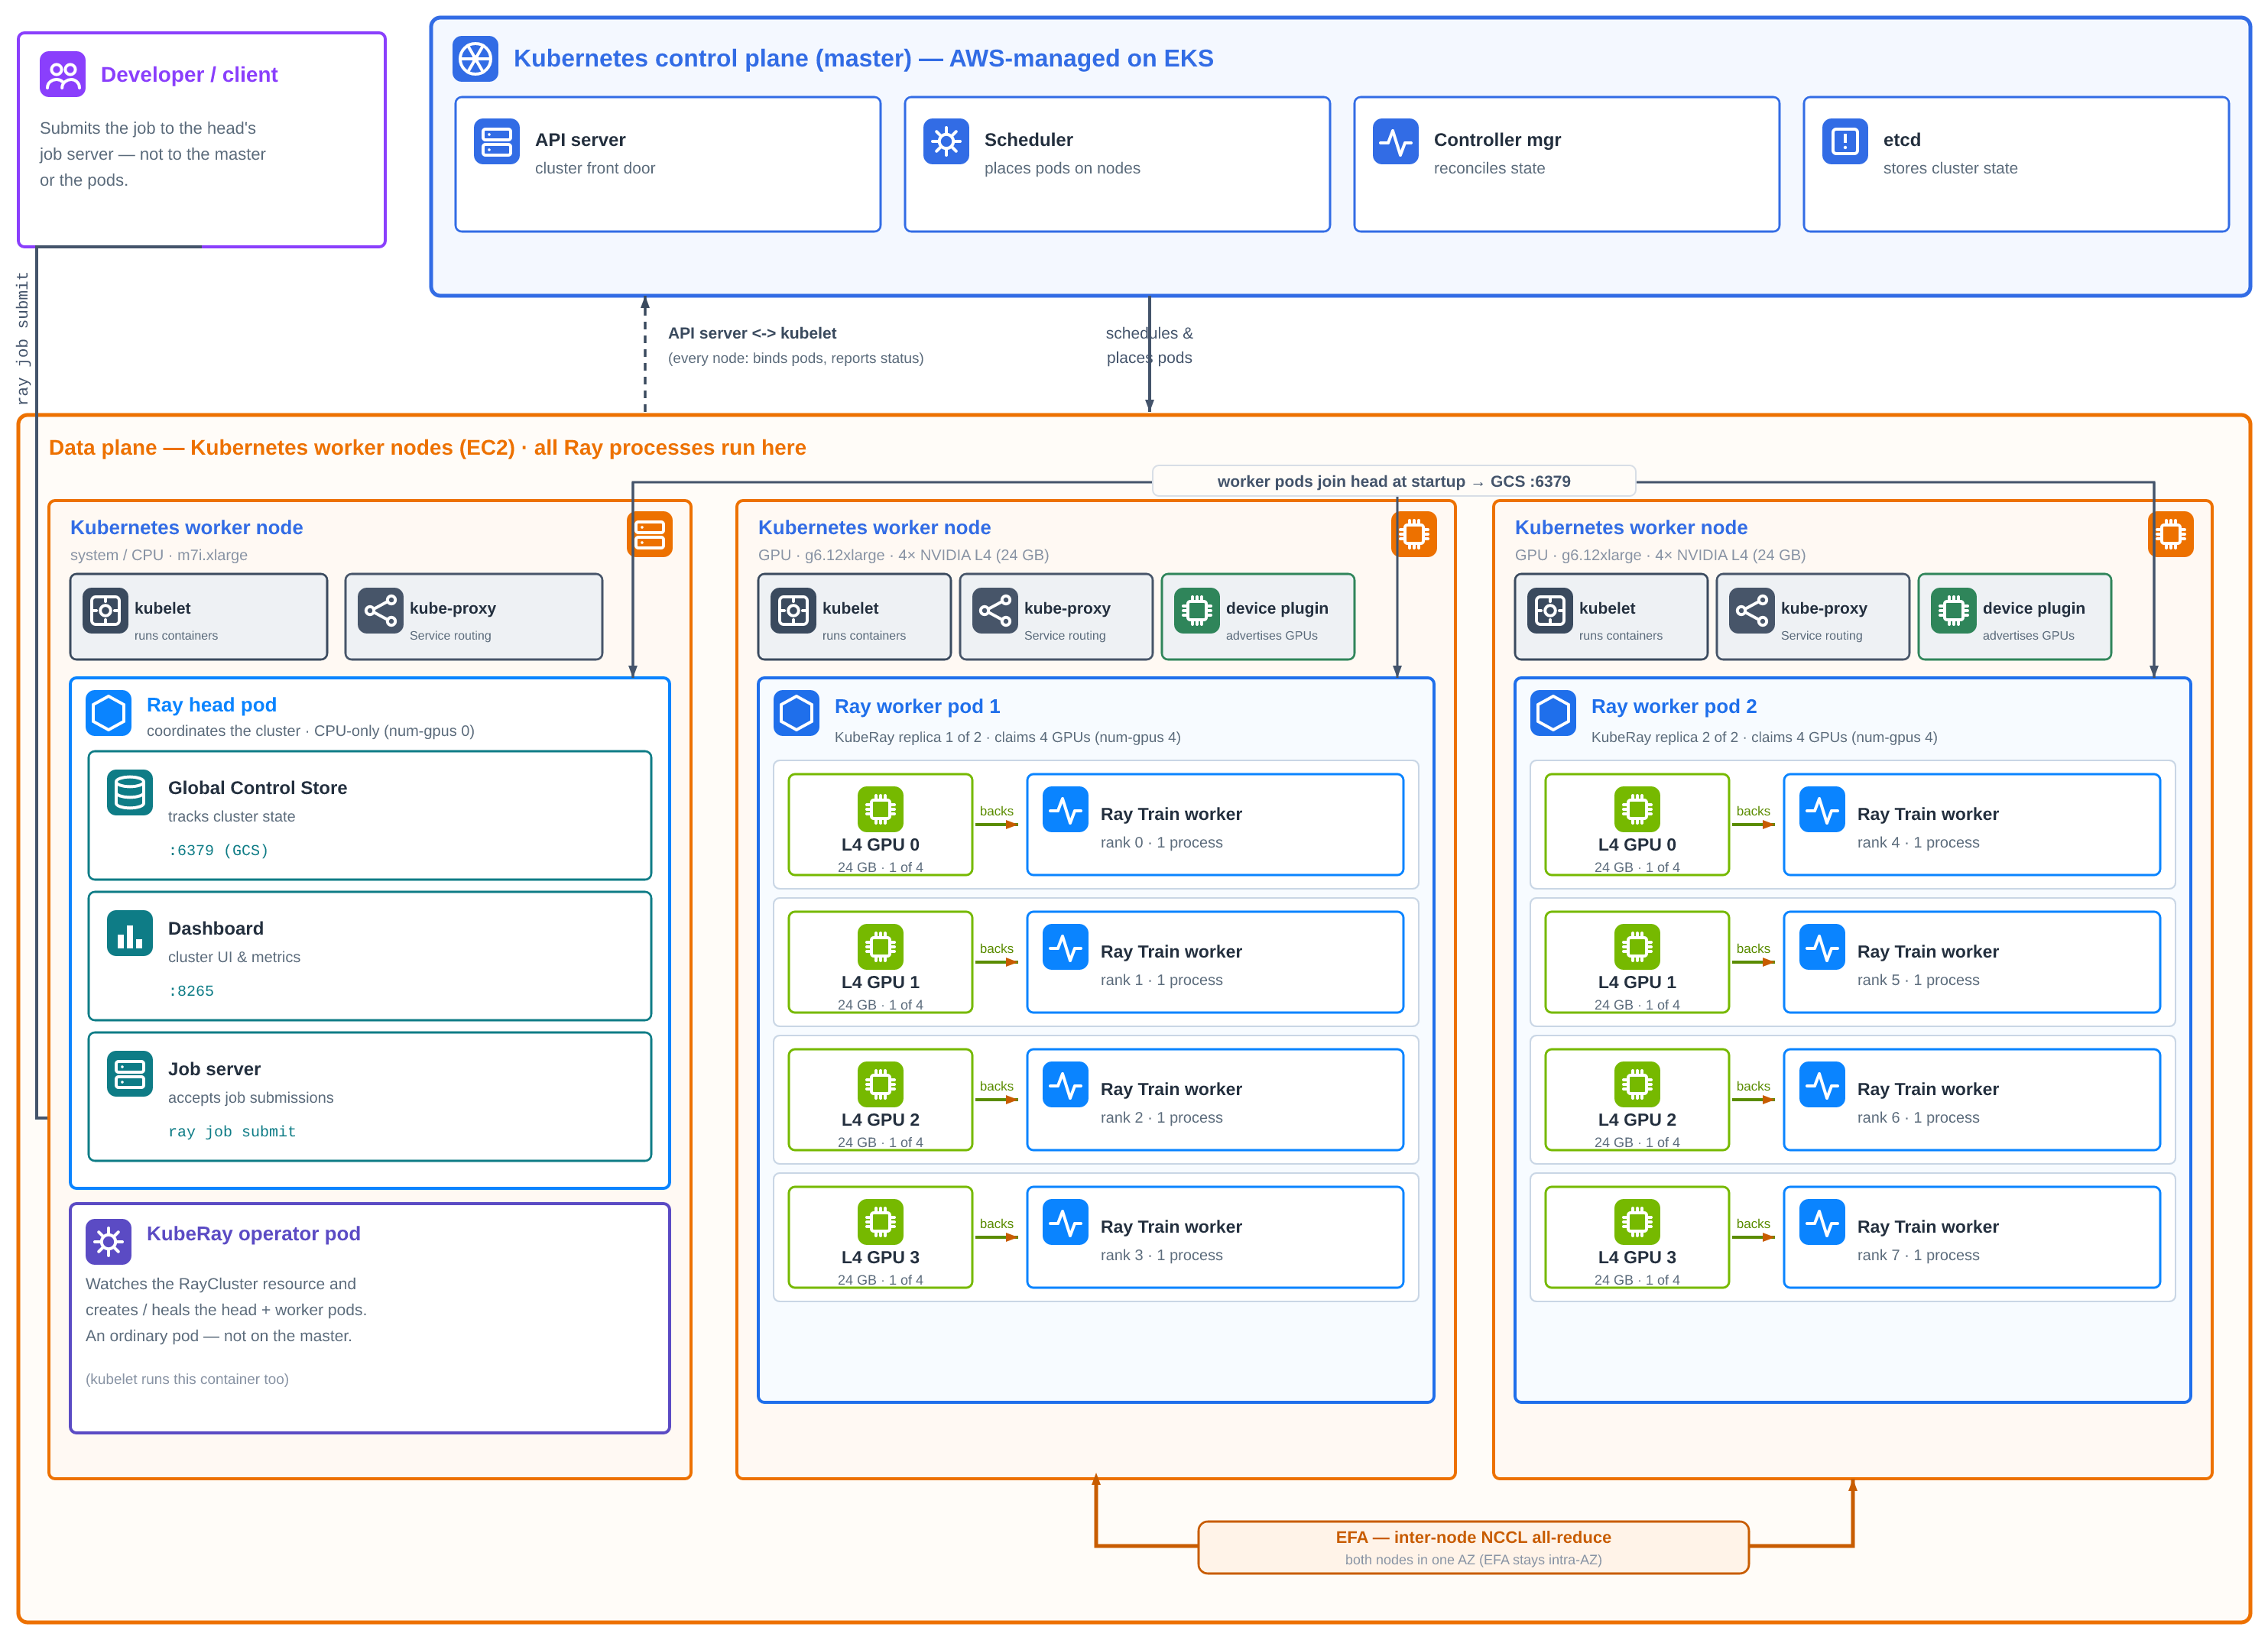
圖 1:一個 EKS 叢集,設有由 AWS 管理的控制平面、一個執行 KubeRay operator 和 Ray head 的 CPU 系統節點 (m7i.xlarge),以及同一可用區域內兩個啟用 EFA 的 g6.12xlarge 節點。KubeRay 根據一份 RayCluster manifest 建立叢集,Ray Train 放置八個 worker,每個 GPU 一個;節點間的集合通訊則透過 EFA 傳輸。
Ray 會將跨多部機器執行的作業組成一個叢集,並分為兩種角色。Ray head 負責協調工作,並執行追蹤叢集狀態的全域控制儲存區、儀錶板,以及供你提交作業的作業伺服器。Ray worker 節點提供 GPU,並執行訓練程序。每個 worker 啟動時,都會連接至 head 的位址以加入叢集。在 Kubernetes 上,這些節點各自都是一個 pod。Kubernetes 本身沒有 Ray 叢集的概念,因此必須有元件建立 head 和 worker pod,在各個 pod 中以正確角色啟動 Ray,將 worker 指向 head,並替換故障的 pod。KubeRay 負責這些工作。它是開源的 Kubernetes operator,會新增 RayCluster 資源:你只需在一份 manifest 中描述 head 羣組和 worker 羣組,KubeRay 便會據此建立並維護叢集。
無論由 KubeRay 在 Amazon Elastic Kubernetes Service (Amazon EKS) 上啟動,還是由你在 Amazon Elastic Compute Cloud (Amazon EC2) 上自行啟動,同一個帶有標籤的映像檔都可同時用作 Ray head 和 Ray worker。你只需加入設定:使用哪些執行個體、每個 pod 配置多少個 GPU、NCCL 使用哪種網絡傳輸方式,以及作業需要哪些額外的 Python 套件。所有設定都在映像檔外部完成。
本文會介紹一個範例,使用原樣發佈的 DLC,透過 PyTorch Fully Sharded Data Parallel (FSDP),在兩個 g6.12xlarge 執行個體上的八個 NVIDIA L4 GPU 之間微調 Qwen2.5-1.5B。訓練程式碼只有一個函式;叢集只需一份 RayCluster manifest 和一個變數檔,而且全程無需建置映像檔。DLC 已包含 EFA 軟件堆疊,因此只要 pod 要求使用 EFA,兩個執行個體之間的集合通訊便會透過 EFA 執行。完整方案載於這個範例程式碼庫,並以與多節點 Ray Serve 操作示範相同的 KubeRay-on-EKS 為基礎。
無需自行建置即可獲得的內容
Ray Train DLC 是在 PyTorch 訓練映像檔之上加入 Ray 訓練程式庫的映像檔。本範例拉取的標籤 public.ecr.aws/deep-learning-containers/ray:train-ml-cuda-v1.1,取代了原本需要自行建置、內容大致如下的映像檔:
| 層 | 原本需要自行建置並保持一致的內容 | Ray Train DLC 中的內容 |
| 分散式執行階段 | 採用 KubeRay 支援的版本,並包含儀錶板和作業伺服器的 Ray | Ray 2.58.0,搭配 Train、Tune 和 Data |
| 框架 | 針對你的 CUDA 版本編譯的 PyTorch | PyTorch 2.13.0、torchvision 0.28.0 |
| GPU 執行環境 | 彼此相容的 CUDA、cuDNN 和 NCCL 版本 | CUDA 13.0.2、cuDNN、NCCL 2.29.7 |
| 網絡 | 以該 NCCL 為基礎建置的 EFA 安裝程式、libfabric 和 aws-ofi-nccl |
最新版 EFA、AWS OFI NCCL plugin、GDRCopy |
| 訓練程式庫 | 針對你的 CUDA 版本編譯的 DeepSpeed、flash-attn 和 Transformer Engine | DeepSpeed、flash-attn、Transformer Engine、PyTorch Lightning、Hugging Face 程式庫 |
| 診斷 | 從原始碼建置的 NCCL tests | all_reduce_perf 已在 PATH 中 |
網絡這一項是大多數團隊最不想自行維護的部分。不相符不會引發錯誤。NCCL 會退回使用 TCP sockets,而工作仍會執行至完成,但速度只剩原來的一小部分。在 DLC 中,這些程式庫會一同建置和測試;AWS 會以多節點 EFA 和多節點 KubeRay 訓練測試作為每個版本的發布門檻,而這正是此範例使用的流程。
另有幾項特性,可省去原本需要在每個叢集逐一處理的工作:
- 無需設定登錄庫 – 映像檔是公開的,因此節點無需憑證即可下載,不必在部署過程中建置或推送任何內容。
- 無需配對驅動程式版本 – 啟動時,入口點會檢查主機的 NVIDIA 驅動程式;如果版本舊於映像檔中的 CUDA,便會自動啟用隨附的 CUDA 向前相容程式庫。
- 無需分開準備頭節點和工作節點映像檔 – 映像檔沒有固定角色。無論由甚麼啟動容器,都會提供
ray start指令,因此所有 Pod 都可使用同一個標籤。 - 無需另設推論映像檔系列 – Ray Train 與 Ray Serve DLC 和 Ray LLM DLCs 共用
rayECR 儲存庫,並使用train-ml標籤前綴。
設定即可,無需重新建置
不同訓練工作之間的所有差異,都透過映像檔以外的設定處理。此範例使用以下各種機制:
| 你控制的項目 | 設定方式 | 此範例中的設定 |
| 頭節點或工作節點角色 | 為每個 Pod 羣組設定 KubeRay rayStartParams |
兩者使用相同的 DLC_IMAGE。頭節點以 num-gpus: "0" 執行 |
| 每個 Pod 的 GPU 和 EFA | Kubernetes 資源要求 | nvidia.com/gpu: 4、vpc.amazonaws.com/efa: 1 |
| 網絡傳輸 | 在 Pod 或工作中設定環境變數 | FI_PROVIDER、NCCL_NET_PLUGIN、NCCL_SOCKET_IFNAME、NCCL_DEBUG |
| 額外的 Python 套件 | 提交時透過 Ray runtime_env 設定 |
工作所需的任何套件,均在提交時安裝 |
| 映像檔版本 | 在 DLC_IMAGE 中使用帶版本號或固定至摘要值的標籤 |
train-ml-cuda-v1.1 |
| 叢集規模 | scripts/env.sh 中的變數 |
執行個體類型、節點數量、每個節點的 GPU 數量、區域、可用區(AZ) |
| 訓練工作 | 傳遞給 train.py 的引數 |
模型、步數、序列長度、批次大小 |
每個工作所需的套件。映像檔已包含 HuggingFace 訓練堆疊,因此此範例的工作無需額外安裝任何套件。如果某項實驗需要映像檔未包含的程式庫,Ray 會在提交時透過 runtime_env 為該工作安裝,映像檔則保持不變。無需建立新映像檔,也無需使用新標籤。
每個工作的傳輸設定。映像檔預設使用 FI_PROVIDER=efa,其 NCCL 設定會排除 loopback 和 Docker bridge 網絡介面。在 EKS 上,你可以將 NCCL_SOCKET_IFNAME 指向 Pod 的 eth0。此範例仍在資訊清單中設定全部四個網絡變數,讓設定方式在同一個檔案中清晰可見,亦不依賴映像檔的預設值。由於這些只是一般環境變數,單一工作可透過其 runtime_env 覆寫設定。
自行選擇版本。範例會固定使用 train-ml-cuda-v1.1(目前的次要版本),讓叢集每次執行都能重現相同結果。vX.Y 標籤會隨安全性重建版本更新。完整限定的 vX.Y.Z 標籤則會固定在原始發行版本的建置,因此若要確保每次執行的位元組完全一致,請固定使用映像摘要。同一映像亦可透過私有 ECR URI 取得。
叢集配置
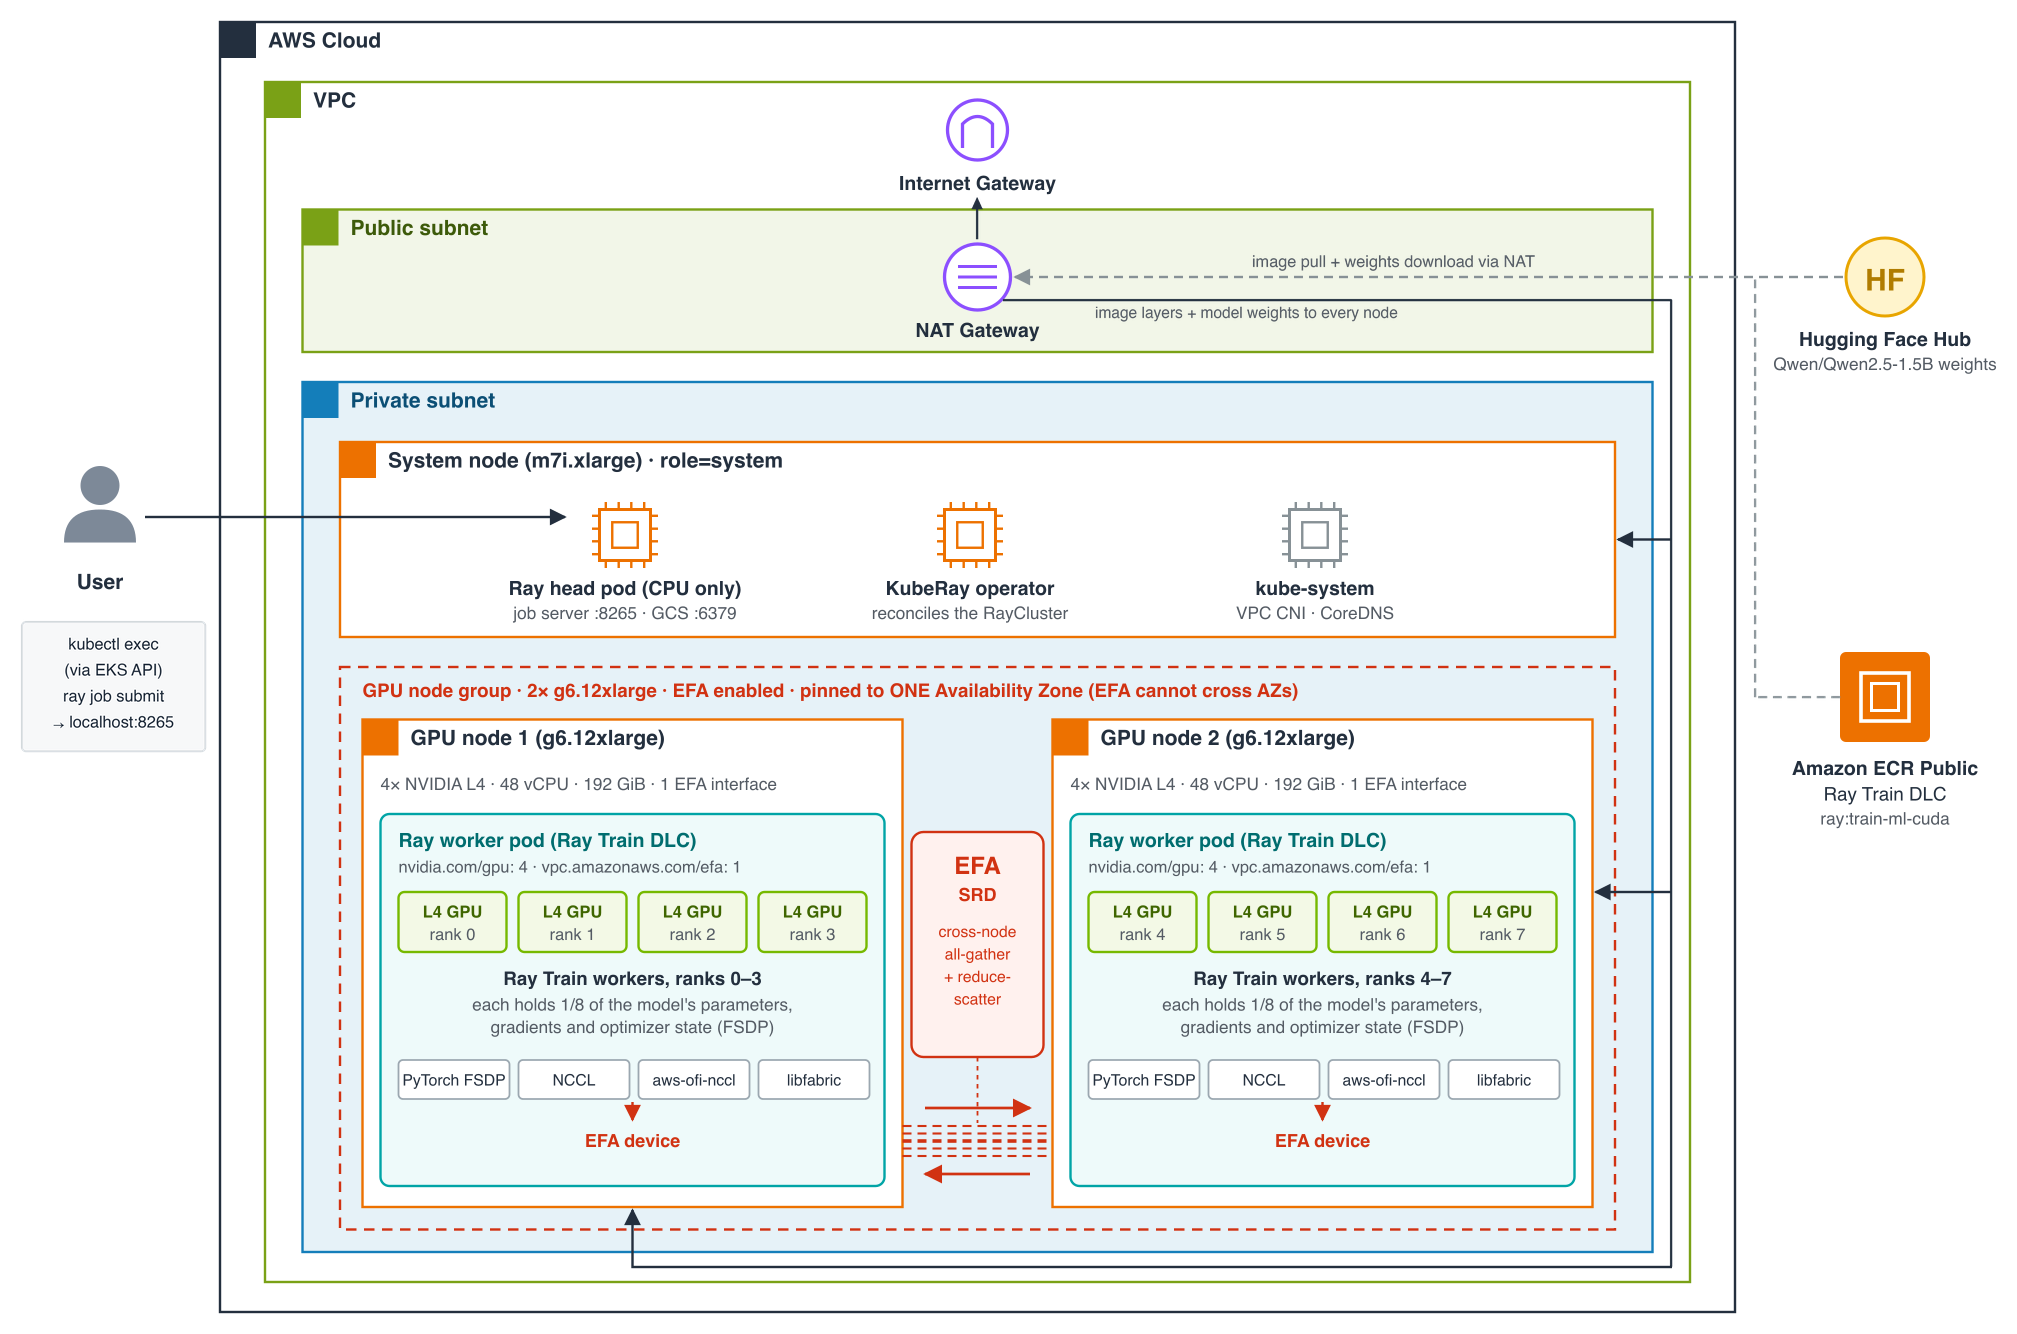
圖 2:範例叢集的配置。每個 Pod 都執行來自 Amazon ECR Public 的相同 Ray Train DLC。CPU 系統節點執行 KubeRay operator,以及不配備 GPU 的 Ray head。兩部啟用 EFA 的 g6.12xlarge 執行個體均位於同一個可用區,每部各執行一個配備四個 GPU 的 Ray worker Pod。
所有節點都位於同一個虛擬私有雲(VPC)的私有子網,並且只透過 NAT Gateway 連接互聯網;因此,所有節點都透過這個途徑從 Amazon ECR Public 下載 DLC,而 worker 也透過這個途徑從 Hugging Face 下載模型權重。一部 m7i.xlarge 組成系統節點羣組,承載 kube-system 附加元件、KubeRay operator 和 Ray head。Head 在連接埠 8265 上執行作業伺服器,並在 6379 上執行 Ray 的控制儲存區;它不會宣告任何 GPU,因此不會承接訓練工作。作業會透過 EKS API,從 head Pod 內使用 kubectl exec 提交,因此連接埠 8265 不會暴露在叢集之外。
訓練工作會在兩部 g6.12xlarge 執行個體上執行,每部均配備四個 NVIDIA L4 GPU、48 個 vCPU、192 GiB 記憶體、40 Gbps 網絡和一個 EFA 介面。每部執行個體都會執行一個 Ray worker Pod,並使用全部四個 GPU 和 EFA 介面;Ray Train 會在每個 Pod 中放置四個 worker:一部執行個體上的 rank 0–3,另一部上的 rank 4–7。由於 EFA 流量不會跨越可用區,指令碼會將兩部執行個體放在已確認提供 g6.12xlarge 的同一個可用區。
Ray Train 在容器內的運作方式
DLC 提供整套技術堆疊。Ray Train 則提供原本需要以啟動器程式碼實作的部分。多節點 PyTorch 通常需要在每部主機上為每個 GPU 啟動一個程序,並為每個程序提供其 rank、world size 和 rendezvous 位址。使用 Ray Train 時,你只需將訓練迴圈寫成函式,再搭配 ScalingConfig 傳入 TorchTrainer。Ray 會在叢集有 GPU 的地方,為每個 GPU 啟動一個 worker、建立 torch.distributed 程序羣組,並在每個 worker 上執行你的函式。
這個範例使用 Ray Train 的 FSDP,將模型權重、梯度和最佳化器狀態分散至全部八個 GPU,而非複製到每個 GPU。以 bfloat16 格式儲存的 Qwen2.5-1.5B,這四個張量約需 12 GB。平均分成八份後,每個 L4 GPU 約需承載 1.5 GB。代價是通訊開銷:FSDP 會在使用每一層權重前先將其收集起來,之後再對梯度執行 reduce-scatter,因此每個步驟中,整個模型都會在各個 rank 之間傳輸。兩部執行個體之間的這些流量,會由 DLC 的 EFA 技術堆疊承載。
先決條件
開始前,請先準備好以下項目:
- 工具:已登入目標帳戶的 AWS Command Line Interface (AWS CLI) v2、eksctl、kubectl、Helm,以及 GNU gettext 提供的
envsubst。 - 配額:在至少有一個可用區提供 g6.12xlarge 的 AWS 區域,具備供兩部 g6.12xlarge 執行個體使用的 96 個 vCPU G 系列隨需容量。如果你已為這些執行個體持有 On-Demand Capacity Reservation,請改為設定
CAPACITY_RESERVATION_ID。指令碼會將節點羣組部署至該預留容量,並略過容量搜尋。 - 預算:GPU 執行個體啟動期間,每小時約 $9.50,涵蓋兩部執行個體、EKS 控制平面和 NAT Gateway。
快速確認 CLI 是否正指向預期帳戶的方法:
aws sts get-caller-identity訓練程式碼:一個函式與一個訓練器
code/train.py 就是整個工作,不含任何與容器、叢集或網絡相關的專屬內容。Ray 會為每個 GPU 執行一次 train_func。它會向 Ray 取得自己的 rank、載入模型、將模型交給 prepare_model 進行 FSDP 處理,然後執行一般的 PyTorch 迴圈:
code/train.py — 每個 GPU 執行的函式(節錄)
def train_func(config):
    ctx = ray.train.get_context()
    world_size, rank = ctx.get_world_size(), ctx.get_world_rank()
    device = ray.train.torch.get_device()

    model = AutoModelForCausalLM.from_pretrained(config["model_id"], torch_dtype=torch.bfloat16)

    # Any submodule above 10M parameters becomes its own FSDP unit. Wrapping by
    # size, not by a model-specific layer class, keeps the script model-agnostic.
    auto_wrap_policy = partial(size_based_auto_wrap_policy, min_num_params=int(1e7))
    model = ray.train.torch.prepare_model(
        model,
        parallel_strategy="fsdp",
        parallel_strategy_kwargs={"auto_wrap_policy": auto_wrap_policy},
    )
    optimizer = torch.optim.AdamW(model.parameters(), lr=config["learning_rate"])

    for step in range(config["steps"]):
        input_ids = torch.randint(0, model.config.vocab_size,
            (config["batch_size"], config["seq_len"]), device=device)
        optimizer.zero_grad()
        loss = model(input_ids=input_ids, labels=input_ids).loss
        loss.backward()  # parameters gathered again, gradients reduce-scattered
        optimizer.step()  # local: each rank updates only its own slice
        ray.train.report({"step": step, "loss": loss.item()})
驅動程式會連接至正在運行的叢集、計算 GPU 數量,並啟動訓練器。由於工作節點數量取決於叢集,同一個指令碼可在單一節點或多個節點上原封不動地執行:
code/train.py — 驅動程式(節錄)
ray.init(address="auto")  # join the RayCluster
num_workers = int(ray.cluster_resources().get("GPU", 0))  # 8 here

trainer = TorchTrainer(
    train_func,
    train_loop_config={...},
    scaling_config=ScalingConfig(num_workers=num_workers, use_gpu=True),
    run_config=RunConfig(name="ray-train-fsdp-llm"),
)
result = trainer.fit()
批次使用隨機 Token ID,因此執行結果只取決於叢集。這個範例的評估標準,是實際的 FSDP 集體通信是否在兩個節點之間傳輸,以及工作是否完成。若要進行實際的微調,只需將隨機張量換成 Ray Data 或 DataLoader 管線。函式的其他部分無須更改。
清單:唯一設定 DLC 的位置
manifest/raycluster.yaml 是映像檔與叢集接合的地方;內容很精簡,因為映像檔所需的設定很少。Head 節點唯一的特殊設定是 NVIDIA_VISIBLE_DEVICES=void,用來避免容器執行環境的 NVIDIA hook 在沒有 GPU 的節點上失敗。其餘設定都放在工作節點羣組中:
manifest/raycluster.yaml — 工作節點羣組(節錄)
workerGroupSpecs:
  - groupName: gpu-workers
    replicas: 2
    rayStartParams:
      num-gpus: "${GPUS_PER_NODE}"  # keeps Ray's GPU count equal to the pod's
    template:
      spec:
        nodeSelector: { role: gpu-worker }
        containers:
          - name: ray-worker
            image: "${DLC_IMAGE}"  # the DLC as published; same tag as the head
            env:
              - { name: NCCL_DEBUG, value: "INFO" }  # print the chosen transport
              - { name: NCCL_SOCKET_IFNAME, value: "eth0" }  # pod network on EKS
              - { name: FI_PROVIDER, value: "efa" }  # libfabric: EFA, nothing else
              - { name: NCCL_NET_PLUGIN, value: "ofi" }  # load the AWS OFI plugin
            resources:
              limits: { nvidia.com/gpu: "${GPUS_PER_NODE}", vpc.amazonaws.com/efa: "1",
                cpu: "40", memory: 160Gi }
              requests: { nvidia.com/gpu: "${GPUS_PER_NODE}", vpc.amazonaws.com/efa: "1",
                cpu: "40", memory: 160Gi }
可將內容理解為三項決定。
使用哪個映像檔:Head 節點和工作節點都使用未經修改的 ${DLC_IMAGE}。
使用哪種硬件:每個 Pod 配置四張 GPU,以及節點的單一 EFA 介面。提出 vpc.amazonaws.com/efa 請求,才能讓 EFA 裝置外掛程式將介面掛載到容器中。若沒有這項設定,NCCL 就無法看到 EFA,並會改用通訊端。
使用哪種傳輸方式:設定四個環境變數,避免任何項目依賴自動偵測。
另外兩項細節有助保持多節點工作穩定。首先,請求值應與限制值相同,讓工作節點屬於 Kubernetes 的 Guaranteed 服務品質(QoS)類別。這點很重要,因為只要一個 rank 被限流或驅逐,其餘七個就會停滯。其次,num-gpus 由 GPU 請求所用的同一個變數推導,因此 Ray 所見的容量始終與 Kubernetes 一致。
啟動流程:一個指令設定基礎設施,然後執行工作
所有設定集中在 scripts/env.sh:叢集名稱、區域、Kubernetes 版本、節點類型及數量、映像檔、固定版本的 KubeRay 和兩個裝置外掛程式,以及訓練參數。匯出任何一項設定即可在某次執行時更改它。五個指令碼皆具冪等性,可安全地重複執行。deploy_cluster.sh、deploy_node_group.sh 和 deploy_ray_train_job.sh 在建立或接觸叢集資源前都會提示確認。install_gpu_plugins.sh 和 install_kuberay.sh 則是調和器,會直接執行。
cd training/ray-train/scripts
source ./env.sh
./deploy_all.sh – 找出容量實際所在的位置,然後在該處建立基礎設施。
g6.12xlarge 的容量每天都會在不同區域和可用區之間變動,因此這是起點,而不是預先在 env.sh 猜定一個區域。它首先會執行 find_gpu_capacity.sh,逐一檢查候選區域:每個可用區是否提供 g6.12xlarge、帳戶的隨需 G/VT 系列 vCPU 配額是否足以支援所需的節點數量,以及 EC2 Spot 配置評分所反映的容量情況。使用 --probe(deploy_all.sh 預設會傳入此選項),即可在每個候選可用區建立實際的 Capacity Reservation 並隨即取消,取得確切結果。接著,它會顯示計劃並提示確認一次:
Proceed with the whole chain without further prompts? (y/N):回答 y 後,會依次在建議的區域執行 deploy_cluster.sh、deploy_node_group.sh、install_gpu_plugins.sh 和 install_kuberay.sh;由於這裏已經要求確認一次,各步驟會略過各自的重複確認(-y 也會略過這個提示,而 --plan 只會顯示計劃,不會建立任何資源)。如果 GPU 節點羣組無法在最佳可用區啟動,指令碼會移除該羣組,然後嘗試探測結果確認的下一個可用區。GPU_AZ 亦會與叢集實際使用的私有子網交叉核對,而不只檢查 g6.12xlarge 是否在該處提供,避免 GPU 節點羣組被固定在叢集沒有子網的可用區。所選區域和可用區會儲存至 scripts/.placement.env,所有其他指令碼都會讀取這些資料,因此之後的指令會沿用相同位置,毋須重新匯出任何資料。在全新的區域中,這四個步驟合共需時 20 至 30 分鐘。系統會偵測並沿用現有的叢集或節點羣組。
deploy_cluster.sh creates the EKS control plane, VPC, OpenID Connect (OIDC) provider, core add-ons, and the m7i.xlarge system node group, choosing subnets in zones that actually offer g6.12xlarge. deploy_node_group.sh adds the two g6.12xlarge instances with EFA turned on, labeled role=gpu-worker and nvidia.com/gpu.present=true. The second label is one that teams often overlook. Without it, the NVIDIA device plugin chart’s DaemonSet runs on zero nodes, with no error pointing at the cause. install_gpu_plugins.sh makes sure both device plugins are present. Recent eksctl bundles them into an EFA-enabled node group, so on a fresh cluster it finds them and skips. Otherwise it installs them at pinned chart versions. Either way it verifies nvidia.com/gpu and vpc.amazonaws.com/efa are allocatable on every GPU node rather than trusting a successful Helm release. install_kuberay.sh installs the KubeRay operator onto the system node, keeping it off the GPU instances.
deploy_all.sh 預設不會執行訓練作業。訓練作業會獨立成為一個步驟,你可以按需要重複執行,因為這是真正的作業執行,而非基礎架構;這樣作業失敗時,也不會令你重新進行叢集設定。傳入 --train 即可串連執行:
./deploy_ray_train_job.sh — RayCluster、作業和檢查。
使用 envsubst 產生 manifest 並套用。接着會重新讀取每個 GPU 節點可分配的資源,然後才等待任何 Pod:如果 device plugin 未能啟動,你會在這裏看到清晰的錯誤,而不會等到 Pod 一直停留在 Pending 狀態直至逾時。待 head 和兩個 worker 均處於 Ready 狀態後,指令碼會把 code/ 複製到 head,再透過 kubectl exec 在其中提交作業:
ray job submit --address http://localhost:8265 --working-dir /tmp/ray-train-code \
python3 train.py --model_id Qwen/Qwen2.5-1.5B
提交呼叫會串流輸出全部八個 rank 的記錄,並在作業完成時返回。接着,指令碼會檢查 NCCL 使用了哪種傳輸方式;如果作業失敗或通訊路徑中沒有使用 EFA,便會以錯誤狀態結束,因此也可用作持續整合 (CI) 閘門。./deploy_ray_train_job.sh status 會顯示 RayCluster 狀態、各個 Pod 所在的執行個體,以及 GPU 容量。正確配置的叢集會如下所示:
$ kubectl get nodes -l role=gpu-worker \
-o custom-columns='NAME:.metadata.name,GPU:.status.allocatable.nvidia\.com/gpu,EFA:.status.allocatable.vpc\.amazonaws\.com/efa'
NAME               GPU   EFA
ip-192-168-70-51   4     1
ip-192-168-92-26   4     1
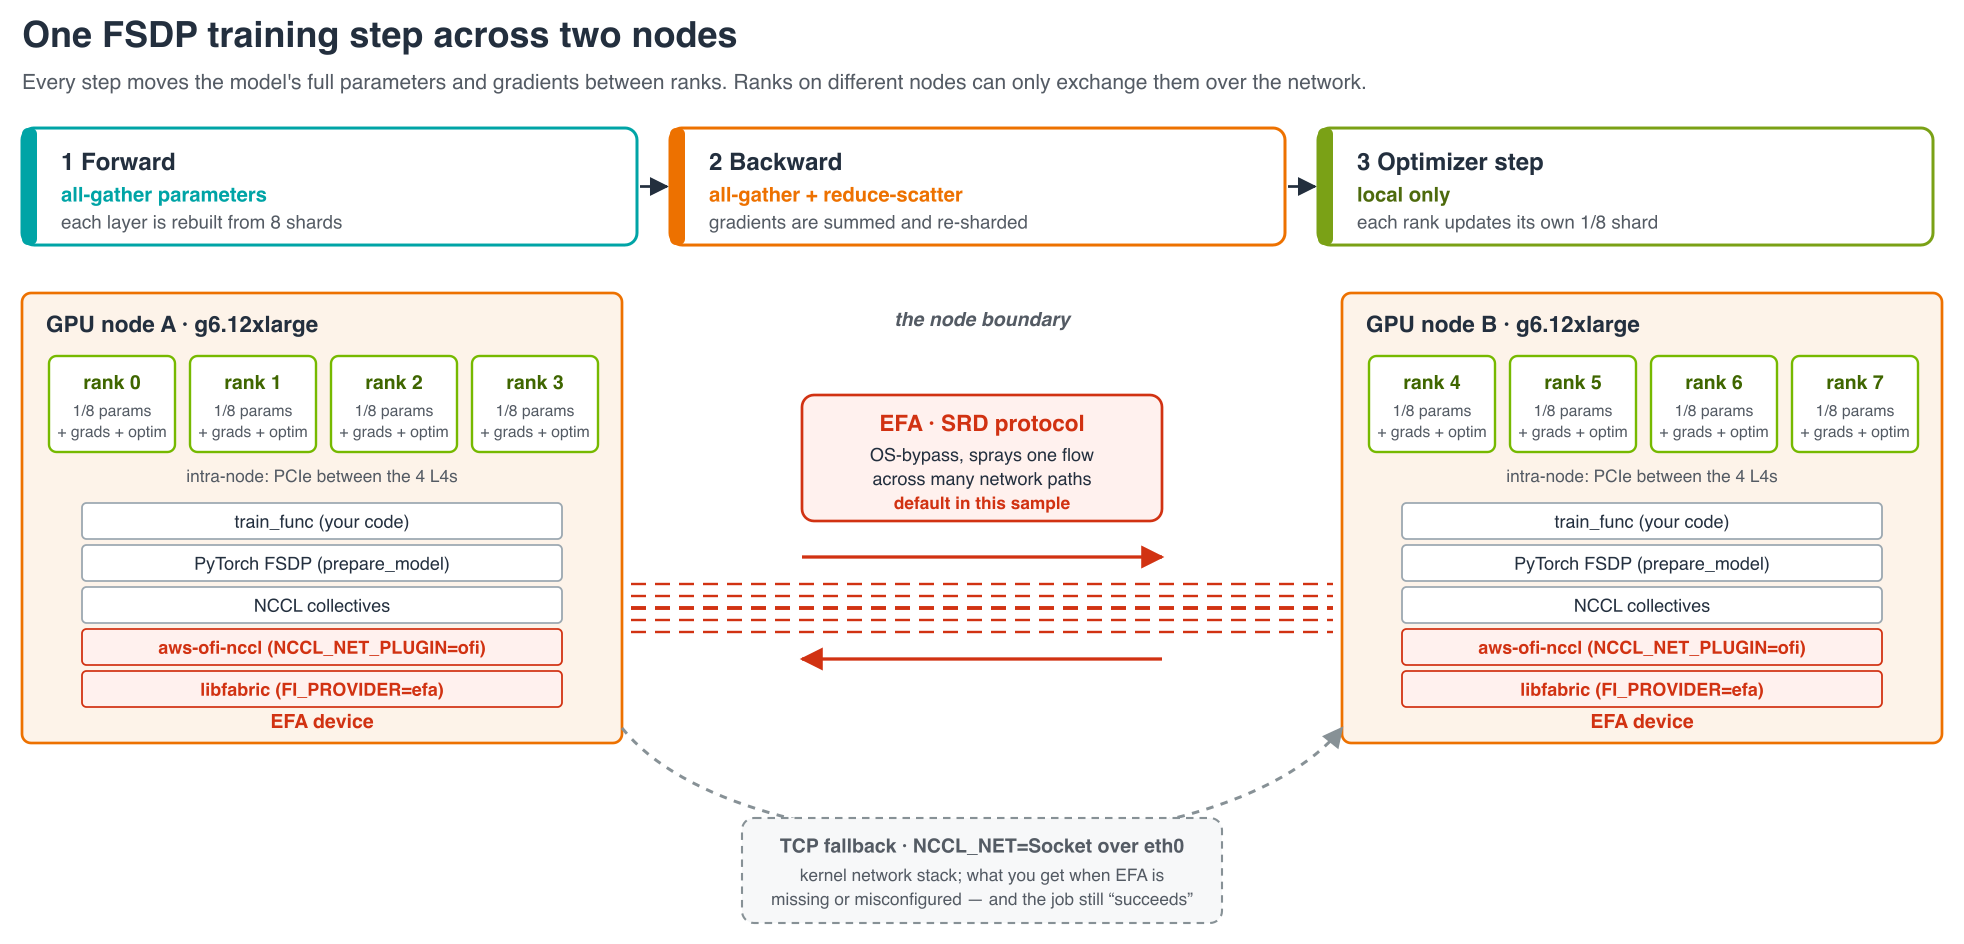
圖 3:此叢集中的一次 FSDP 步驟。權重會在前向和反向傳播期間聚集,梯度則會進行 reduce-scatter。執行個體之間的流量會採用 DLC 隨附的路徑:NCCL → AWS OFI NCCL plugin → libfabric → EFA;如果缺少這條路徑,則會回退至 TCP 通訊端。
配合你的工作負載調整
由於使用的是已發布的映像,而作業會根據叢集自行判斷所需規模,大部分修改只需改動一個檔案:
| 要修改的項目 | 修改位置 | 無需修改的項目 |
| 模型 | MODEL_ID |
程式碼、資訊清單、映像 |
| 步數、序列長度、批次大小 | STEPS, SEQ_LEN, BATCH_SIZE |
程式碼、資訊清單、映像 |
| 訓練循環本身 | train_func 的主體 |
訓練器、資訊清單、映像、指令碼 |
| 額外的 Python 套件 | --runtime-env-json pip list |
圖片 |
| 已鎖定版本的 DLC 發行版 | DLC_IMAGE 至具版本號的標籤 |
其他所有內容 |
| GPU 執行個體系列 | GPU_NODE_TYPE、GPUS_PER_NODE |
程式碼、映像檔 |
| GPU 執行個體數量 | GPU_NODE_COUNT,再加上資訊清單中的 replicas、minReplicas 和 maxReplicas |
程式碼(用來計算 GPU 數量) |
| 區域或可用區 | REGION,可選擇 GPU_AZ |
其他所有內容 |
表格中的變數除非另有説明,均設於 env.sh。切換執行個體系列時,GPUS_PER_NODE 必須配合硬件;該系列亦須支援 EFA,並列於 EFA 裝置外掛程式允許的執行個體類型清單中。此處鎖定的外掛程式版本已知包含 g6.12xlarge。改用 p5 或其他支援 GPUDirect 的系列,無須更改映像檔或訓練程式碼。
拆除環境
GPU 執行個體是成本最高的部分,連同控制平面和 NAT Gateway,每小時約 $9.50。請按照建立資源的相反次序移除:
./delete_ray_train_job.sh        # RayCluster
./install_kuberay.sh cleanup     # KubeRay operator
./install_gpu_plugins.sh cleanup # NVIDIA and EFA device plugins
./delete_node_group.sh           # GPU instances
./delete_cluster.sh              # EKS cluster, VPC and system node
下一步
使用兩個執行個體和八張 GPU,在 EKS 上執行分片微調,並採用一個沒有人自行建置的容器。Ray Train DLC 提供經測試的技術堆疊,涵蓋 CUDA 至 EFA。KubeRay 使用同一個標籤啟動主節點和工作節點。Ray Train 安排工作節點並建立處理程序羣組。所有可變項目,從硬件、傳輸方式到 Python 套件,均在映像檔外部設定。映像檔隨附的 EFA 路徑只需設定四個環境變數便可啟用;在程式碼不變的情況下,吞吐量是 TCP 的兩倍。
接下來可以:
- 將隨機批次換成真實數據集,並將檢查點儲存至 Amazon Simple Storage Service (Amazon S3) 或 Amazon FSx for Lustre。
- 為確保執行結果可重現,將
DLC_IMAGE鎖定至具版本號的標籤。 - 啟用
FailureConfig,讓長時間執行的工作在執行個體遺失後仍能繼續。 - 改用較大的模型,並部署於 p5 等支援 GPUDirect RDMA 的系列。映像檔和程式碼維持不變。
作者介紹

Sunita Koppar
Sunita 是 AWS 生成式 AI 與機器學習資深專業解決方案架構師,與各行各業的客戶合作,設計解決方案、建立概念驗證,並推動可衡量的業務成果。除了專業工作外,她亦熱衷於學習和教授梵文,並積極與學生社羣交流,協助他們提升技能和成長。

Kevin Wang
Kevin 是 AWS Deep Learning Containers/AMIs 團隊的軟件開發工程師,負責建置和維護客戶在 Amazon Elastic Compute Cloud (Amazon EC2)、Amazon SageMaker AI 及 Amazon Elastic Kubernetes Service (Amazon EKS) 上執行的深度學習映像檔。他的團隊以開源方式在 GitHub 管理這些映像檔及其建置系統。他持有北京大學學士學位及南加州大學碩士學位,兩個學位均主修電腦科學。

Sukhmeet Singh
Sukhmeet 是 AWS 生成式 AI 與機器學習資深專業解決方案架構師。他與獨立軟件供應商(ISV)客戶合作,設計 AI 解決方案、建立概念驗證,並將方案投入生產環境,實現可衡量的業務成果。他的興趣涵蓋生成式 AI、電腦視覺、物聯網(IoT)、機器學習基礎設施及自然語言處理。他尤其喜歡結合這些領域,大規模解決現實問題。
來源:AWS Machine Learning Blog · aws.amazon.com