Amazon Bedrock AgentCore runtime 的快速工作階段啟動架構模式
Architecture patterns for fast session startup on Amazon Bedrock AgentCore runtime
Amazon Bedrock AgentCore runtime V2 在建立或更新 runtime 時初始化容器並建立快照,新工作階段則還原快照,毋須每次重新初始化容器。文章説明如何量度工作階段啟動延遲,並建議把靜態工作移至 init,或用 build hook 預載無法保留在記憶體的檔案。若要低於 1 秒,可在用戶開始互動時於背景啟動工作階段,讓它在首個請求前就緒。
文章拆解 V2 的快照建立與還原流程,並按不同延遲需求整理初始化、build hook 與預先啟動工作階段的實作選擇,説明各做法適用的啟動情境。
現今的 Agent 會審查程式碼、處理索償,並在無人看管下執行數小時。很多 Agent 亦支援互動體驗,用戶會等待它們首次回應。Amazon Bedrock AgentCore runtime 為這些 Agent 提供全受管理的無伺服器環境:每個工作階段都在獨立的 microVM 中執行;沒有工作時,平台會縮減至零;你只需為工作階段實際使用的資源付費。
將 platformVersion 設為「V2」後,AgentCore runtime 啟動工作階段的方式會有所改變。它不再為每個工作階段初始化容器,而是先準備一次環境並建立快照,再為每個新工作階段還原該快照。工作階段啟動時間會更快、更穩定。V2 亦會回收工作階段未使用的記憶體,因此帳單會按 Agent 的實際用量計算。
對大部分 Agent 而言,切換至 V2 就足夠。有些 Agent 需要重新調整架構才能充分受惠;至於聊天和語音體驗,即使等待 2 秒也太久。本文會説明 V2 如何啟動工作階段、如何量度工作階段啟動時間,以及如何避免在首次請求時才執行工作,包括 AgentCore runtime 現已支援的建置掛鈎。我們會介紹四種模式,涵蓋修改 Agent 程式碼,以至在用戶需要前預先啟動工作階段。
你需要哪種模式?
| 你的情況 | 做法 | 章節 |
| 新工作階段約 2 秒內啟動即可 | 切換至 V2,並在 app.run() 前完成所有初始化工作 |
避免在首次請求時才執行工作 |
| 你的 Agent 需要及早使用大型檔案、CLI 或瀏覽器,而且無法在其程序中保留這些資源 | 新增建置掛鈎,在建立快照時載入並預熱這些資源 | 使用掛鈎 |
| 你需要在一秒內啟動;用戶在發出首次請求前便會開始使用服務(例如開啟應用程式或聊天視窗) | 在用戶開始使用服務時於背景啟動工作階段 | 在用戶開始使用服務時預熱 |
V2 如何啟動工作階段
AgentCore runtime 會在新的 microVM 中執行每個工作階段。使用 V1 時,AgentCore 會從 Amazon Elastic Container Registry (Amazon ECR) 拉取容器映像、啟動容器,並執行初始化程式碼,之後才能處理第一個請求。拉取映像所需時間佔大部分,因此冷啟動時間會隨映像大小增加。
V2 只需執行一次這些工作。建立或更新 runtime 時,AgentCore runtime 會在全新的 microVM 中啟動容器,並等待收到首次健康狀態 ping(GET /ping);該 ping 必須在 120 秒內送達。接著,系統會清除作業系統的檔案快取,以縮小快照,然後凍結 microVM,並將其記憶體和磁碟儲存為快照。
這與 V1 不同:現在每次建立或更新都需要幾分鐘,因為系統需要建立快照。
本文所説的 init,是指 Agent 在 /ping 回報健康狀態前執行的所有工作。使用 AgentCore Python SDK 時,即 app.run() 之前的所有工作。如果你使用自己的 HTTP 伺服器,以 Node.js 或其他語言編寫,請只在初始化完成後才回報健康狀態。
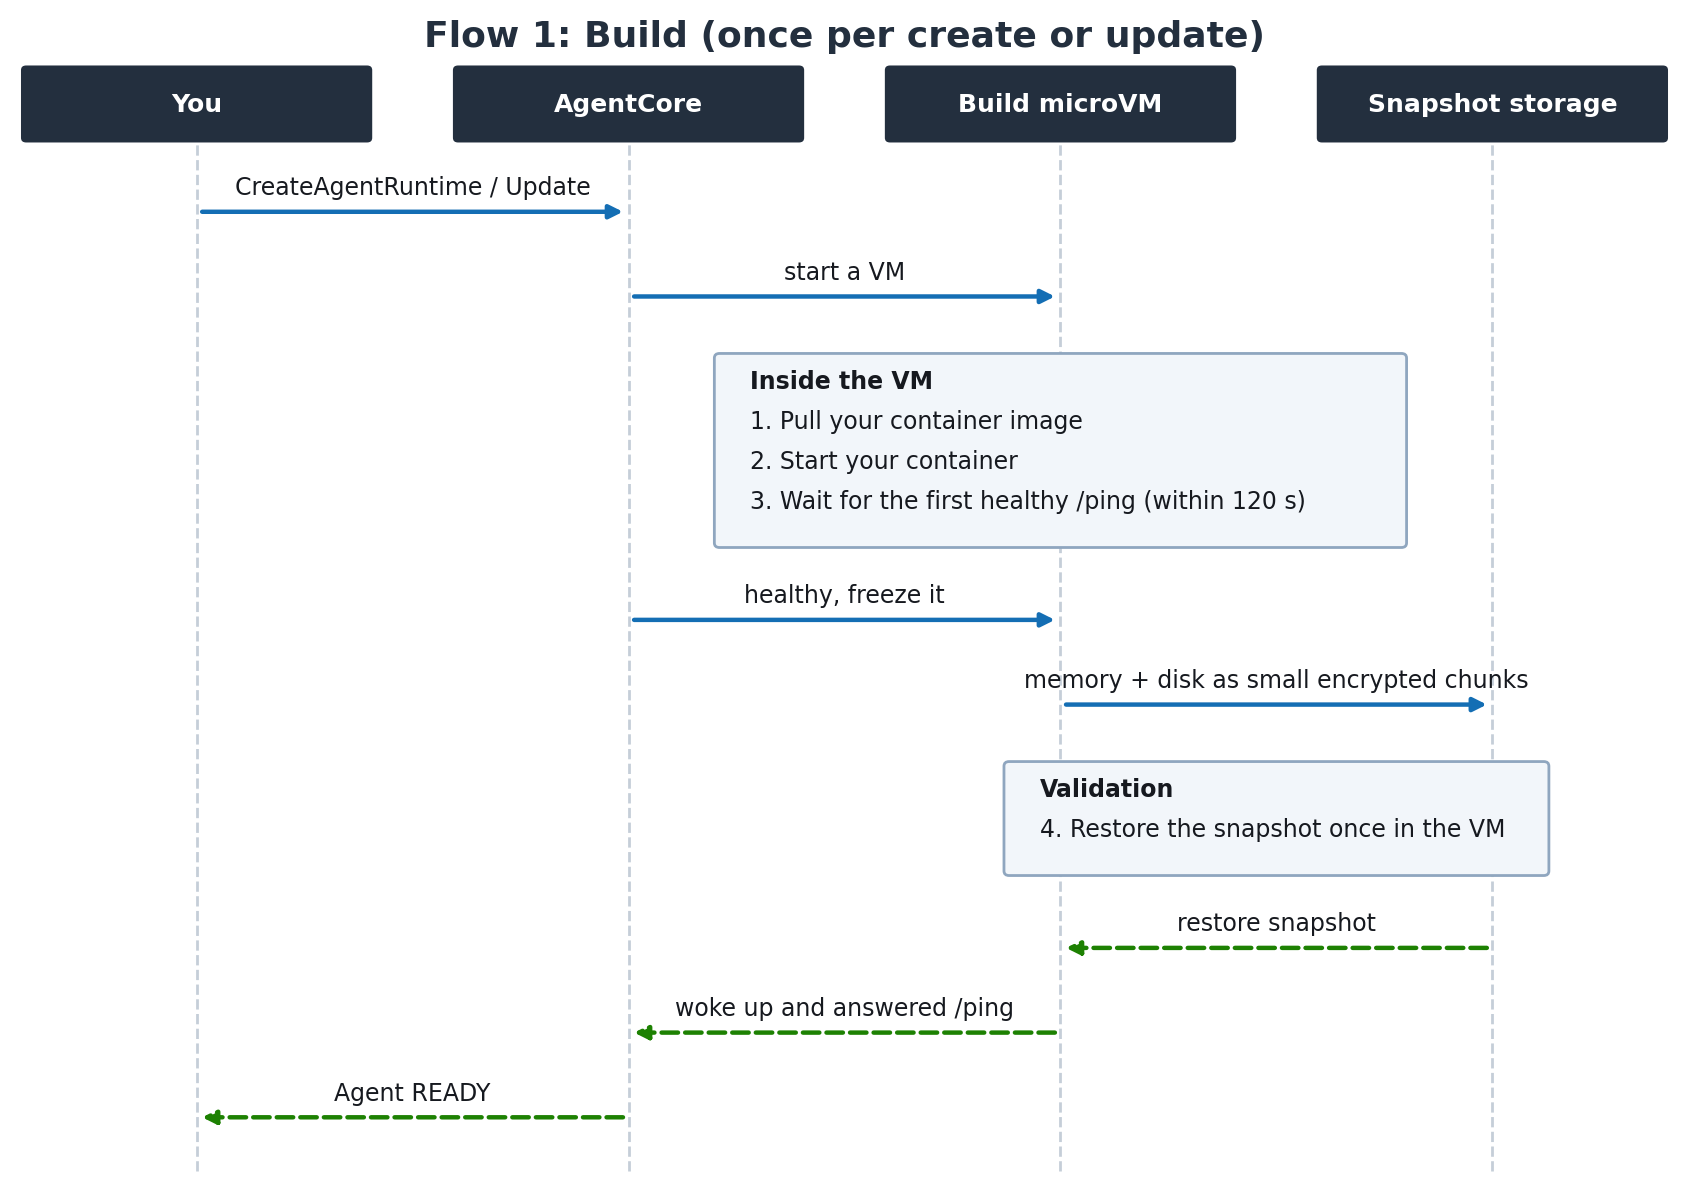
圖 1:建立時建置一次(每次建立或更新)
收到新的工作階段時,AgentCore 會將快照還原至新的 microVM。你的程序會從凍結時的狀態原樣繼續執行,匯入的模組、物件和用戶端都已就緒。映像中的檔案會按需載入:工作階段首次讀取某個區塊時,系統才會擷取該區塊。
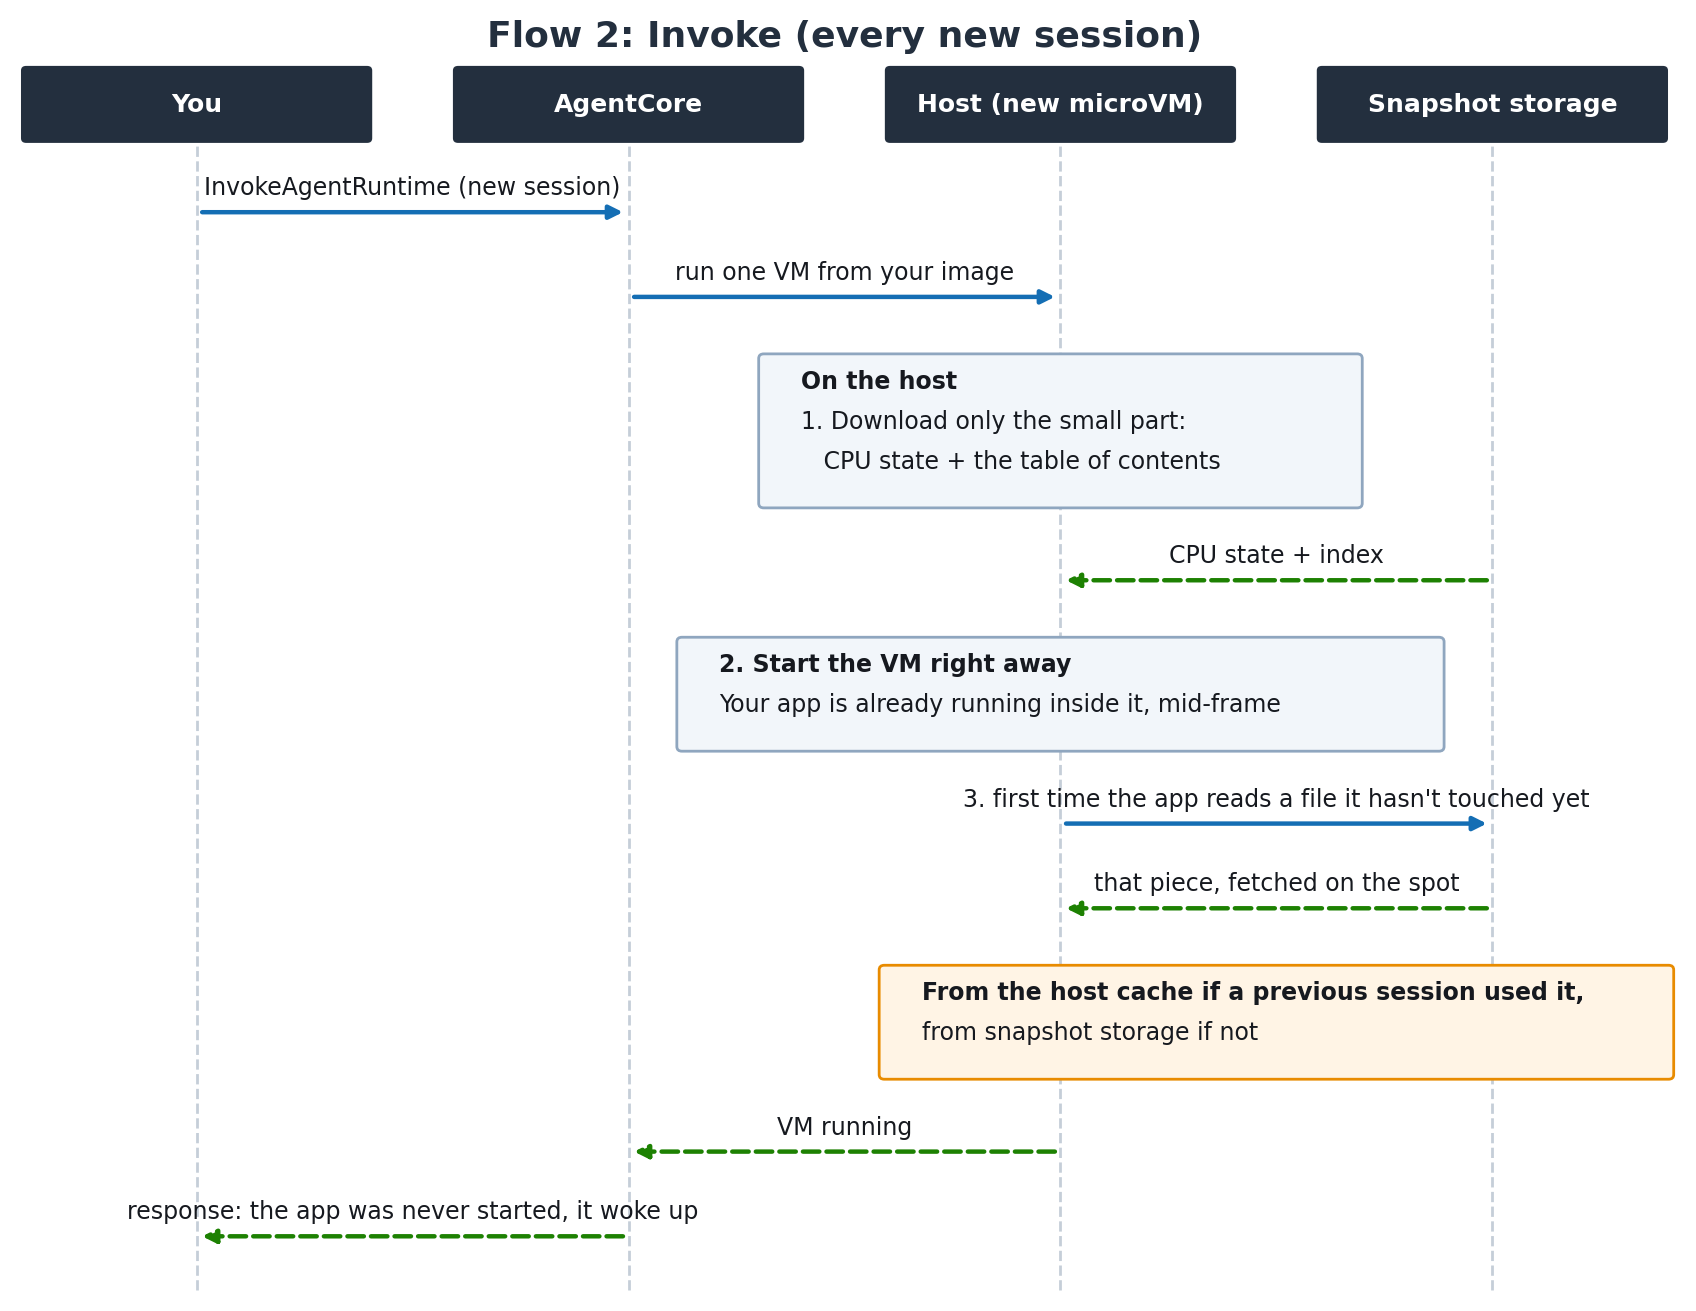
圖 2:呼叫時執行(每個新工作階段)
從這些流程可得出三個事實,本文其餘內容都會以此為基礎:
- 記憶體內容會完整保留。 在快照時程序持有的任何內容,以及以 RAM 為後備的檔案系統(例如
/dev/shm)中的任何內容,從首次存取起都可按記憶體速度使用。 - 檔案讀取狀態不會保留。 凍結前會清除檔案快取,因此在初始化期間讀取檔案,不會令還原後的工作階段更快。
- 映像檔會在首次讀取時擷取。 區塊首次讀取時會從快照儲存空間載入,之後會快取到更接近主機的位置。
下表説明典型 Agent 的工作在不同階段進行時會有甚麼影響:
| 工作 | 在初始化期間完成 | 在處理常式中完成 |
| 匯入程式庫 | 工作階段開始時已載入記憶體 | 每個新工作階段都會從映像讀取 |
建立用戶端(例如 boto3) |
還原時已完成端點及憑證解析。通訊端會在首次使用時重新連線 | 每個新工作階段都會從頭建立 |
| 開啟網絡連線 | 還原後會失效。請在建立快照前關閉 | 重新開啟連線 |
| 從映像載入靜態資料並存放在物件中 | 工作階段開始時已載入記憶體 | 每個新工作階段都會從映像讀取 |
| 從映像讀取檔案,但不保留資料 | 沒有影響,因為檔案快取會被清除 | 每個新工作階段都會從映像讀取 |
如果你熟悉 AWS Lambda SnapStart,這些內容應該不會陌生。Marc Brooker 關於 SnapStart 如何載入快照的文章,以及介紹 SnapStart 預熱策略的文章,都是有用的背景資料。
表中的情況都假設你的 Agent 可以在自己的程序中保留所需內容,但這並非總是可行。以獨立程序執行並在完成後退出的 CLI,或瀏覽器二進制檔,會在初始化期間讀取,之後便不再存在,因此還原後的工作階段會再次從映像擷取它們。遇到這些情況,你可以加入建置 Hook,詳情請參閲〈使用 Hook〉。圖 3 顯示 Hook 的執行位置。
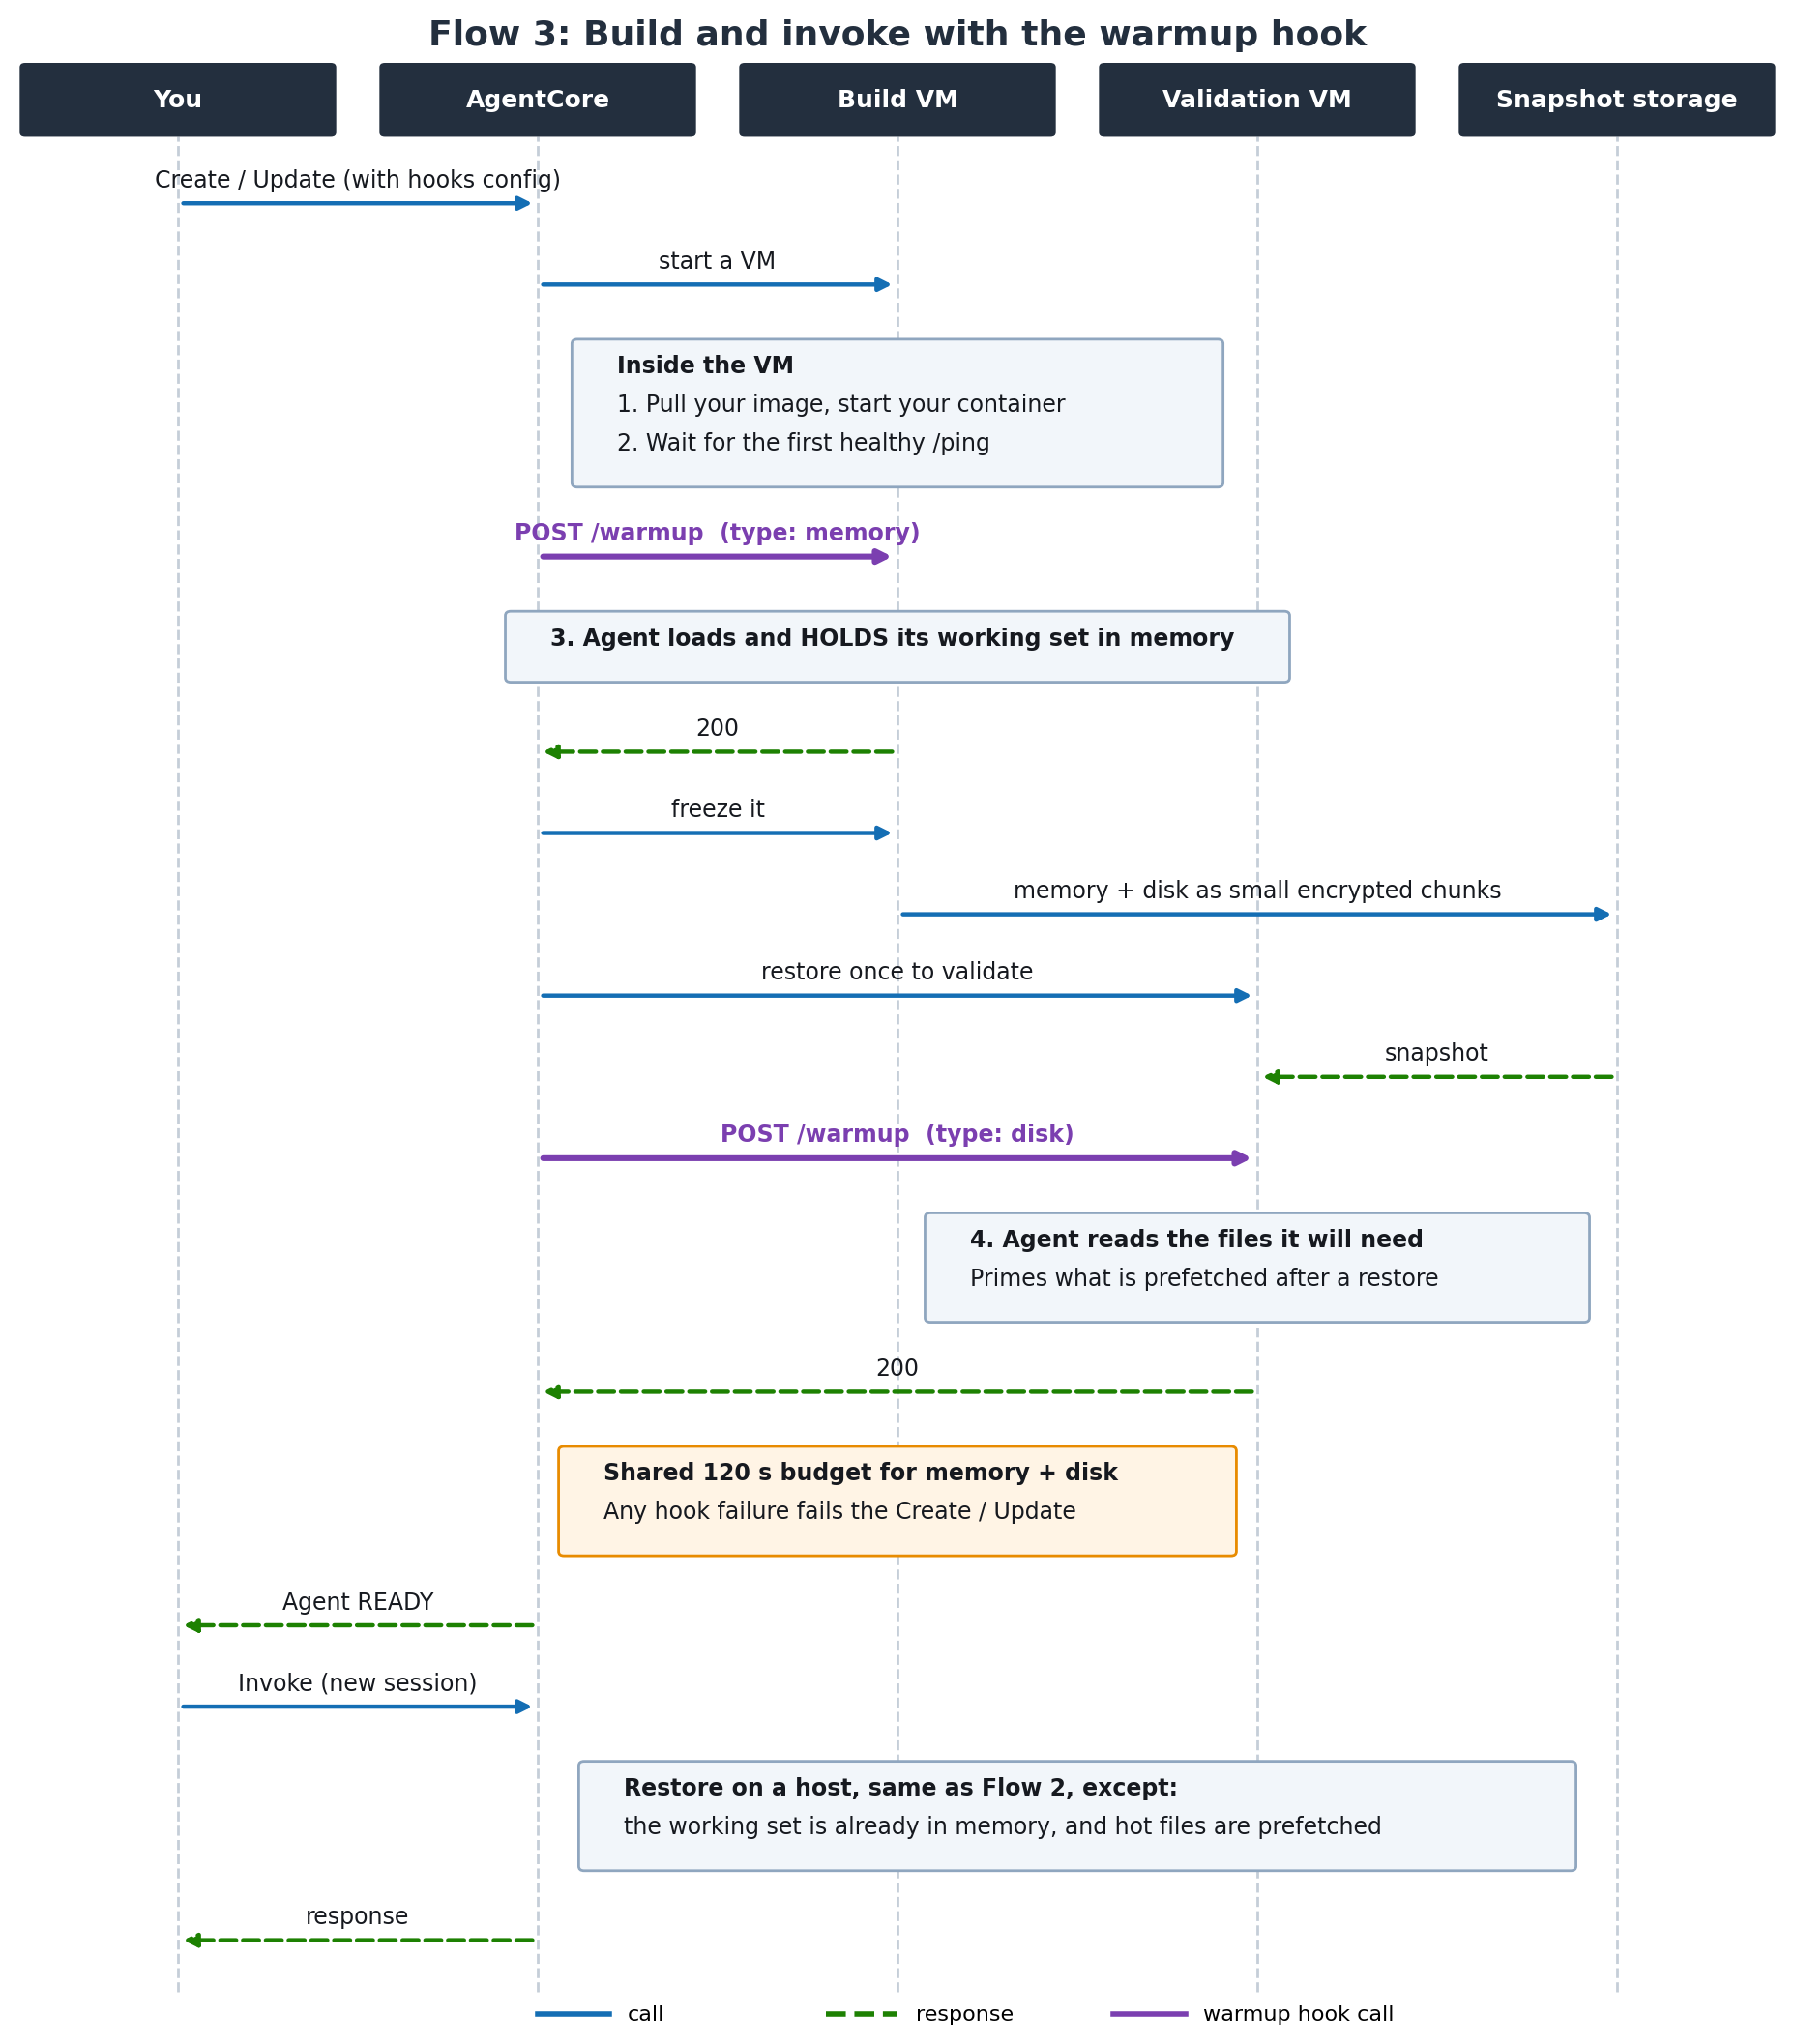
圖 3:使用 Hook 進行建置及呼叫
先量度,再作最佳化
Agent 應用程式的延遲並非單一數值。請求會先花時間讓 AgentCore 執行階段準備好工作階段,以執行你的程式碼;之後則花時間在你的程式碼中,包括模型呼叫、工具呼叫、子 Agent,以及將回應串流傳回。這些問題需要用不同方法處理,因此首先要找出哪一項佔用最多時間。
AgentCore 執行階段會在 AWS/Bedrock-AgentCore 命名空間中,將這兩項以 Amazon CloudWatch 指標發布。Latency 是首字節時間。OverheadLatency 是屬於平台的部分,例如在新工作階段中啟動 microVM 和還原快照所需的時間。
| 你想了解的項目 | 取得方法 |
| TTFB(首字節時間) | Latency |
| 執行階段時間 | OverheadLatency |
| 你的程式碼所需時間 | Latency − OverheadLatency |
| 初始化時間 | 在程式碼啟動時量度(見下例)。在 V2 中,這不屬於任何請求 |
在 V2 中,初始化只會在建立快照時執行一次,而非在每個工作階段執行,因此不會出現在這些指標中。它會增加建立或更新所需的時間,直至狀態變為 READY;但不會增加請求延遲。如要查看所需時間,請在 app.run() 前記錄一次。該行記錄會出現在執行階段的建置記錄中:
import time
INIT_START = time.time()  # first line of your module
# imports, clients, data loading ...
print(f"init_ms={round((time.time() - INIT_START) * 1000)}")
app.run()
如何解讀時間分佈:
- 新工作階段的
OverheadLatency偏高:耗時發生在工作階段啟動時。請使用本文稍後介紹的方法,在用戶需要工作階段之前先行啟動。 - 同一工作階段中,你的程式在首次請求上的執行時間遠高於第二次:原本應在 init 階段執行的工作,卻在處理常式中執行。在 AgentCore Observability(Amazon Bedrock AgentCore 的一項功能)中,於工具設定、載入檔案及延遲匯入附近加入自訂 spans,以找出問題,然後把這些工作移至 init 階段。
回報 P90、P99 等百分位數,或 TM90 等截尾平均值。TM90 計算最快 90% 請求的平均值,並剔除最慢的尾段。單純的平均值會掩蓋較慢的請求。OverheadLatency 涵蓋對執行中工作階段及新工作階段的請求,因此其分佈取決於你的請求中有多少會啟動新工作階段。請比較組成相近的測試結果。
請按照預期在正式環境中建立新工作階段的速率進行測試,不要只在部署後用少量工作階段測試。
若要計入用戶端的網絡時間,也要在用戶端進行量度。計算 invoke 呼叫所需時間,讓處理常式回傳自身的執行時間,再將兩者相減。兩個時間戳記都來自同一部機器,因此用戶端與 microVM 之間的時鐘差異並不重要。如果使用串流,較小的事件可能會被暫存,直至輸出累積到幾百個 bytes,因此量得的首個事件所需時間可能會高於工作階段啟動時間。
避免在首次請求時才執行工作
一般的冷啟動建議是延遲匯入,並盡量縮短初始化時間。但在 V2 中應該反其道而行:快照建立時會執行一次 init 階段的工作,而延後至處理常式執行的工作,每個新工作階段都要重新付出代價。這適用於靜態工作:從映像檔載入的匯入項目、用戶端及資料。動態資料無法納入快照。下一節會介紹相關內容。
改善最明顯的 Agent,通常是在請求處理期間從映像檔讀取大型檔案的 Agent:小型本機模型的權重、嵌入向量、數據集、大型程式庫、自動化操作所需的瀏覽器二進制檔,或編碼 Agent 以子程序方式執行的 CLI 工具鏈。讀取大量小型檔案也會有同樣影響,例如編譯 TypeScript 專案。若 Agent 只匯入少量程式庫並呼叫託管模型,主要只需妥善處理匯入項目及用戶端。
如何重整你的 Agent
在 init 階段建立物件,而不只是匯入模組。建立物件會載入其依賴的模組,並將它們保存在活躍記憶體中。使用外部程式庫的本機工具也應在 init 階段初始化,而不是等到 Agent 首次呼叫它們時才初始化。
在 init 階段建立用戶端。端點解析、憑證解析及用戶端所需的模組都會隨快照一同還原。通訊端則不會,但 boto3 用戶端會在首次呼叫時順利重新連線。部分其他網絡用戶端會先嘗試使用已失效的通訊端,令操作多花數百毫秒,因此應在建立快照前關閉這些連線。
將靜態資料保留在記憶體中,例如提示詞、技能的 front matter、設定及小型索引。把資料存放在物件中,而不只是讀取資料:
INDEX = pathlib.Path("/opt/data/index.bin").read_bytes() # during init: keep the bytes讓工具持續執行,不要每次請求都啟動。在處理常式中啟動的子程序,每個新工作階段都要從映像檔讀取其二進制檔及程式庫。在 init 階段啟動的長駐輔助程序,例如語言伺服器,或已完成匯入的工作程序,會隨程序記憶體一同還原。透過管道或 socket 與它通訊。
將無法保留在記憶體中的檔案複製到 RAM 支援的磁碟。像 tsc 這類工具鏈會以獨立程式執行,並讀取自己的檔案。在 init 階段將它們複製到 /dev/shm 或 ramfs 掛載點,讓讀取操作從記憶體進行。
部署已編譯的位元碼。 uv pip install 預設不會編譯,因此延遲匯入的項目也會從原始碼編譯。設定 UV_COMPILE_BYTECODE=1 或使用 pip install --compile。
以下範例會在 init 階段建立代理程式、模型及其用戶端,讓每個工作階段都能使用這些項目:
import json, pathlib
import boto3
import pandas as pd  # import during init, including rarely used libraries
from strands import Agent
from strands.models import BedrockModel
from bedrock_agentcore.runtime import BedrockAgentCoreApp

MODEL_ID = "us.anthropic.claude-haiku-5-5"

# Init: runs once, before the snapshot. Every new session inherits these objects.
PROMPTS = json.loads(pathlib.Path("prompts.json").read_text())
ddb = boto3.client("dynamodb")
agent = Agent(model=BedrockModel(model_id=MODEL_ID), system_prompt=PROMPTS["system"])

app = BedrockAgentCoreApp()

@app.entrypoint
def invoke(payload):
    return agent(payload["prompt"])

app.run() # /ping answers only after this line取捨:新工作階段從啟動到收到首個位元組所需的時間,是啟動 microVM 並還原快照所需的時間,加上處理常式的執行時間。將工作移至 init 階段可縮短處理常式的執行時間,但任何留在記憶體中的內容都會令快照變大。每個工作階段也都要為這些佔用的記憶體付費。變更前後都要量度工作階段啟動的端對端時間,確定延遲確實縮短,而不只是從處理常式轉移到還原過程。
參考卡
| 資料 | 做法 |
| 首個請求需要的大型檔案,例如模型、CLI 或瀏覽器 | 在 init 階段將它們載入記憶體,或使用建置 hook 預先載入 |
| 按需選擇性讀取的大型參考資料 | 在 init 階段透過存取點掛載 Amazon S3 Files 或 Amazon Elastic File System (Amazon EFS)(需要虛擬私有雲 (VPC) 模式) |
| 代理程式很少讀取的檔案 | 將它們保留在映像檔中,或移至 Amazon Simple Storage Service (Amazon S3)、S3 Files 或 Amazon EFS |
| 工作階段建立的檔案 | 不需變更 |
使用 hooks
建置 hook 會在 init 階段執行,並不會取代 init。能在 init 階段完成的工作就盡量在該階段完成,init 無法涵蓋的部分才使用 hook。你需要在容器中公開 HTTP 端點;AgentCore runtime 在建置 runtime 期間會向該端點發出兩次 POST 請求:
- 快照前。在建置用 microVM 上,代理程式回報狀態正常後、凍結前執行。代理程式在此載入並保留在記憶體中的內容都會納入快照,因此每個工作階段啟動時都會包含這些內容。
- 測試還原後。在另一個用來還原快照並進行檢查的 microVM 上執行。此次呼叫的任何內容都不會納入快照。你可以用它讀取工作階段所需的檔案,藉此影響還原後的工作階段會先擷取哪些內容。
X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type 標頭會告訴代理程式目前處理的是哪種呼叫:第一次呼叫為 memory,第二次為 disk。兩次呼叫共用 120 秒,因此 disk 呼叫可用的時間,取決於 memory 呼叫剩餘的時間。只有在工作完成後才回傳 2xx 回應。任何其他回應、連線失敗或時間耗盡,都會導致建立或更新作業失敗,而 AgentCore runtime 不會重試。runtime 的日誌羣組中的 build-logs- 串流會顯示哪次呼叫失敗及原因。
V2 runtime 支援 hooks。建立或更新 runtime 時,使用 hooksConfiguration 設定:
client = boto3.client("bedrock-agentcore-control")
client.create_agent_runtime(
    agentRuntimeName="my_agent",
    agentRuntimeArtifact={"containerConfiguration": {"containerUri": IMAGE_URI}},
    roleArn=ROLE_ARN,
    networkConfiguration={"networkMode": "PUBLIC"},
    platformVersion="V2",
    hooksConfiguration={
        "build": {
            "warmup": {
                "action": {"httpPost": {"path": "/warmup", "port": 8080}}
            }
        }
    },
)
連接埠為選填,預設使用代理程式的服務連接埠。如要設定,請使用 8000 至 12000 之間、未保留給平台使用的連接埠。路徑不得與 AgentCore runtime 已在該連接埠使用的路由相同,例如 POST /invocations 或 GET /ping。UpdateAgentRuntime 會取代整個 hook 設定,因此每次更新如要保留該 hook,都要一併包含 hooksConfiguration。
在代理程式中,於同一端點處理這兩種呼叫:
import asyncio
from fastapi import FastAPI, Request, Response

app = FastAPI()

# Files that each session reads when it starts.
STARTUP_FILES = ["/app/models/tokenizer.json", "/app/config/agent.json"]

def load_shared_state():
    # Load what every session needs into memory, such as heavy imports,
    # model weights, and caches.
    ...

def read_startup_files():
    # Read the files that a session reads when it starts, so that new
    # sessions can use them faster.
    for path in STARTUP_FILES:
        with open(path, "rb") as f:
            while f.read(1024 * 1024):
                pass

@app.get("/ping")
def ping():
    return {"status": "Healthy"}

@app.post("/warmup")
async def warmup(request: Request):
    # Header lookup in Starlette and FastAPI is case-insensitive.
    warmup_type = request.headers.get(
        "X-Amzn-Bedrock-AgentCore-Runtime-Warmup-Type", ""
    ).lower()
    # Run the work in a worker thread so that /ping keeps answering.
    if warmup_type == "memory":
        await asyncio.to_thread(load_shared_state)
    elif warmup_type == "disk":
        await asyncio.to_thread(read_startup_files)
    # Respond only after the work is done.
    return Response(status_code=200)

@app.post("/invocations")
async def invoke(request: Request):
    payload = await request.json()
    # Per-request work runs here on every session.
    return {"response": payload.get("prompt", "")}
完整設定參考請參閲 設定 AgentCore runtime 的生命週期 hooks。完整程式碼範例請參閲範例程式碼。
快照注意事項:哪些內容必須留在處理常式中
init 階段建立的所有內容都會凍結在快照中,直到下次部署為止;每個工作階段都會以相同副本啟動。對大部分物件而言,這正是預期效果;但對下列值而言,這會造成錯誤,而對隨機值而言,更會構成安全問題。
在處理常式中載入動態資料,每個工作階段只載入一次。AgentCore Gateway(Amazon Bedrock AgentCore 的一項功能)的工具目錄、功能旗標及價目表會在部署後變更。請在處理常式中載入這些資料,並在模組層級快取,讓每個工作階段只擷取一次。工作階段最長可持續 8 hours,因此請為快取設定到期時間:
_tools, _loaded_at = None, 0.0

def get_tools():
    global _tools, _loaded_at
    if _tools is None or time.time() - _loaded_at > 300:  # wall clock: refresh after 5 minutes
        _tools, _loaded_at = load_gateway_tools(), time.time()
    return _tools
在處理常式中呼叫 get_tools(),並將結果傳給你在初始化期間建立的 Agent。
在處理常式中建立每個工作階段專屬的值。
| 值 | 建立位置 | 原因 |
| 隨機值、nonce、秘密值、金鑰 | 在處理常式中使用 secrets、os.urandom() 或 uuid.uuid4() |
在初始化期間建立的程式庫隨機狀態(Python 的 random、NumPy)在每個工作階段中都相同。從作業系統取得的值則各不相同 |
| 目前時間及經過時間 | 在處理常式中使用 time.time() |
初始化時間戳記在建立快照時便固定,而 time.monotonic() 不會計算快照儲存期間經過的時間 |
| 計時器、速率限制器、TTL 快取 | 使用掛鐘時間,或在收到第一個請求時重設這些項目 | 任何使用單調時鐘測量經過時間的機制,在還原前後幾乎看不到時間間隔 |
| 你自行擷取的憑證和權杖 | 到期時更新 | 初始化期間載入的值可能會在工作階段開始前到期 |
瞭解限制。閒置逾時期限屆滿時(idleRuntimeSessionTimeout:預設為 15 minutes,範圍由 60 seconds 至 8 hours)、達到最長存續時間時(maxLifetime:預設為 8 hours,亦是上限),或在你停止工作階段時,工作階段便會結束。
低於一秒:在用戶需要前啟動工作階段
假設新工作階段啟動約需 2 seconds,包括前文各節所述的所有計時細項。已在執行的工作階段約 200 ms 即可回應。對話或語音體驗要做到低於一秒,方法是在用戶首次提出請求前確保工作階段已啟動。有兩種方法可以做到這一點。
用戶開始互動時預先暖機
大部分互動式應用程式都會在用戶輸入第一個提示詞前收到訊號:用戶開啟應用程式、聊天視窗或支援頁面。善用這個訊號。建立工作階段 ID,在背景向 Agent 發送暖機請求,並將工作階段 ID 與對話一同保留。用戶輸入第一則訊息時,工作階段便已在執行。
# Backend, when the user opens the chat (don't block the UI on it)
session_id = f"chat-{uuid.uuid4().hex}"  # session IDs need at least 33 characters
agentcore.invoke_agent_runtime(agentRuntimeArn=ARN, runtimeSessionId=session_id,
                               payload=json.dumps({"action": "prime"}).encode())
save_conversation(user_id, session_id)  # every later turn reuses this session ID

# Agent handler: answer the warm-up before any model call
@app.entrypoint
def invoke(payload):
    if payload.get("action") == "prime":
        return {"primed": True}
    return agent(payload["prompt"])
這種做法不需要額外的基礎架構;只要用戶在發送第一則訊息前花費超過約 2 seconds,工作階段啟動時間便會完全隱藏。每位有互動但沒有發送提示詞的用戶都會佔用一個工作階段。較短的閒置逾時期限可將這項成本維持在較低水平。
結論
在 V2 中,AgentCore runtime 將啟動工作階段的大部分工作移至部署時進行。你的容器只會啟動一次,而每個新工作階段都會還原其結果:記憶體會完整復原,檔案則會在首次讀取時擷取。
要將工作階段啟動時間維持在約 2 seconds,請在初始化期間處理靜態工作,將第一個請求所需的資料保留在記憶體中,並在處理常式中處理動態值及每個工作階段專屬的值。對於程序無法保留的檔案,請加入建置掛鈎。要將時間縮短至一秒以下,請在用戶需要前啟動工作階段:收到訊號時,在用戶開始互動便啟動。
要開始使用,建立或更新 runtime 時,將 platformVersion 設為 V2,然後參閲為 AgentCore runtime V2 最佳化你的 Agent。如對工作負載有疑問,請聯絡你的 AWS 帳戶團隊。
關於作者

Evandro Franco
Evandro 是 Amazon Web Services 的資深 數據科學家。他是全球 GTM 團隊的一員,協助 AWS 客戶克服在 AWS 上使用 AI/ML 時遇到的業務挑戰,工作主要圍繞 Amazon Bedrock AgentCore 和 Strands Agents。他有超過 18 年科技領域的工作經驗,涉足軟件開發、基礎設施、無伺服器架構和機器學習。閒暇時,Evandro 喜歡和兒子一起玩,尤其喜歡砌有趣的 Lego 套裝。

Massimiliano Angelino
Massimiliano 是 AWS AI/ML 領域的首席市場推廣專責解決方案架構師,常駐英國。他與 EMEA 各地的獨立軟件供應商(ISV)合作,設計、優化並擴展以 Amazon Bedrock AgentCore 為基礎的代理式 AI 應用程式。Massimiliano 專注於執行環境效能、成本效益和正式投入使用的準備工作,並經常與客戶一起建立概念驗證,讓客戶在 AgentCore Runtime 上執行其代理。他也共同撰寫指引,協助 ISV 將 AI 工作負載從原型推進至正式投入使用。

Phelipe Fabres
Phelipe 是 AWS for Startups 的生成式 AI 資深解決方案架構師。他是 Frontier AI 全球團隊的一員,主要支援正在開發基礎模型/LLM/SLM 的客戶。他長期投入代理式系統和軟件驅動的 AI 系統,並有超過 10 年軟件開發經驗,涉足單體式架構以至事件驅動架構,另持有圖論博士學位。閒暇時,Phelipe 喜歡和女兒一起玩,尤其喜歡玩桌上遊戲和畫公主。

Abhishek Singh
Abhishek 是 AWS Bedrock AgentCore 團隊的資深軟件開發工程師,也是 AgentCore Runtime 的技術主管。他從零開始主導多項 AgentCore 服務的設計和開發,包括 Runtime、Code Interpreter 和 Browser。他有 12 年構建分散式系統的經驗,之前曾在 Bedrock 和 SageMaker 團隊工作。工作以外,他喜歡踢足球和打網球,也喜歡與家人共度美好時光。

Vignesh Somasundaram
Vignesh 是 AWS Amazon Bedrock AgentCore 團隊的創始軟件開發工程師,負責構建可大規模部署代理的 AI 基礎設施。他持有 Purdue University 計算機科學碩士學位,以及 Anna University 學士學位,熱衷於構建大規模分散式系統和應對架構方面的挑戰。工作以外,他常到戶外做運動或探索大自然。

Ivan Rivera
Ivan 是 AWS Amazon Bedrock AgentCore 團隊的軟件開發工程師,專注於提升 AgentCore Runtime 的速度和可靠性。他致力於在 microvm 層減少代理的冷啟動時間,並設計了分散式鎖定機制,以防止代理工作階段在大規模運行時出現競爭條件。他原本是生物醫學工程師,後來轉型為軟件工程師,熱愛運用系統程式設計提升軟件速度。工作以外,Ivan 喜歡與家人共度時光、擺弄微控制器和 Raspberry Pi,也喜歡玩 Terraria。
來源:AWS Machine Learning Blog · aws.amazon.com