Hugging Face 分享以開源模型加速 Document AI 的方法
Accelerating Document AI
Hugging Face 介紹如何以開源模型建立 Document AI 方案,並按任務梳理文件分類、版面分析、文件解析、表格處理及文件問答。文中以 RVL-CDIP 為例,列出 BERT-base、DiT、LayoutLMv3 和 Donut 的文件分類準確率分別為 89%、92% 及 95%,並討論授權、數據準備、微調與評估等實作考量。
文章按文件類型與任務梳理 Document AI 模型選擇,並串連授權、數據準備和評估考量,提供從小規模微調起步的實作思路。
企業內有大量文件藴藏知識,卻未能透過數碼工作流程存取。文件類型包括信件、發票、表格、報告和收據。隨着文字、視覺和多模態 AI 進步,現在已可解鎖這些資訊。本文會介紹團隊如何免費使用開源模型建立自訂方案!
Document AI 涵蓋多種資料科學任務,包括圖片分類、圖片轉文字、文件問答、表格問答和視覺問答。本文首先整理 Document AI 的用途分類,以及最適合各用途的開源模型;接着探討授權、資料準備和建模。全文亦會提供網上示範、文件和模型的連結。
應用情境
建立文件 AI 方案至少有六種常見應用情境,各自使用不同類型的文件輸入和輸出。解決企業 Document AI 問題時,通常需要結合多種方法。
將打字、手寫或印刷文字轉成機器編碼文字,稱為光學字元辨識(OCR)。這是經過廣泛研究的問題,已有許多成熟的開源和商業方案。圖中示範如何將手寫內容轉成文字。
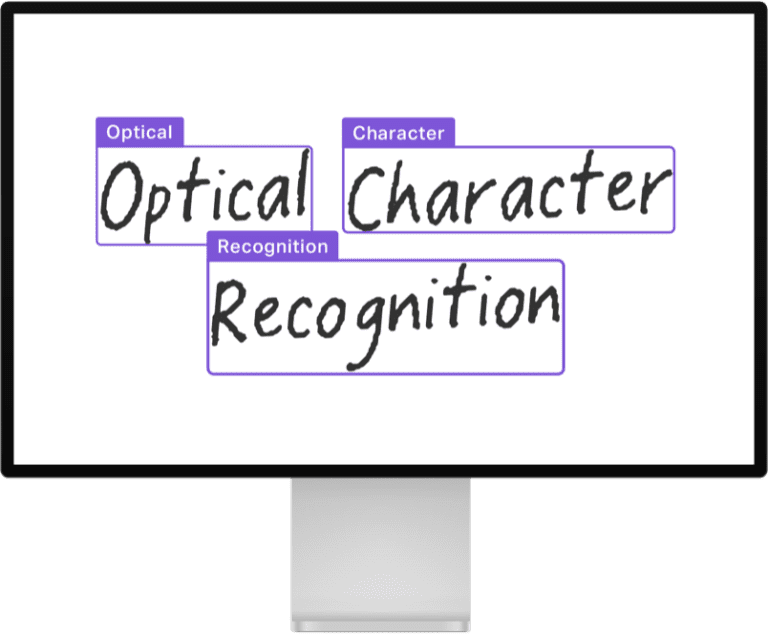
OCR 是 Document AI 各種應用情境的基礎,因為必須先將文字轉換成電腦可讀的格式。常見的文件層級 OCR 模型包括 EasyOCR 和 PaddleOCR。另有 TrOCR:使用預訓練模型的 Transformer 光學字元辨識等模型,可處理單行文字圖片。 此模型可配合 CRAFT 等文字偵測模型使用;CRAFT 會先以邊界框識別文件中各個文字「區塊」。OCR 的相關指標包括字元錯誤率(CER),以及詞語層級的精確率、召回率和 F1 分數。可到這個 Space觀看 CRAFT 和 TrOCR 示範。
將文件歸入適當類別(例如表格、發票或信件),稱為文件圖片分類。分類時可使用文件圖片、文字,或兩者兼用。近年多模態模型開始利用視覺結構和底層文字,大幅提升分類器效能。
一種基本方法是先對文件圖片執行 OCR,再使用類似 BERT 的模型進行分類。不過,單靠 BERT 並不會考慮版面或視覺資訊。RVL-CDIP 資料集中的圖片展示不同文件類型的視覺結構差異。
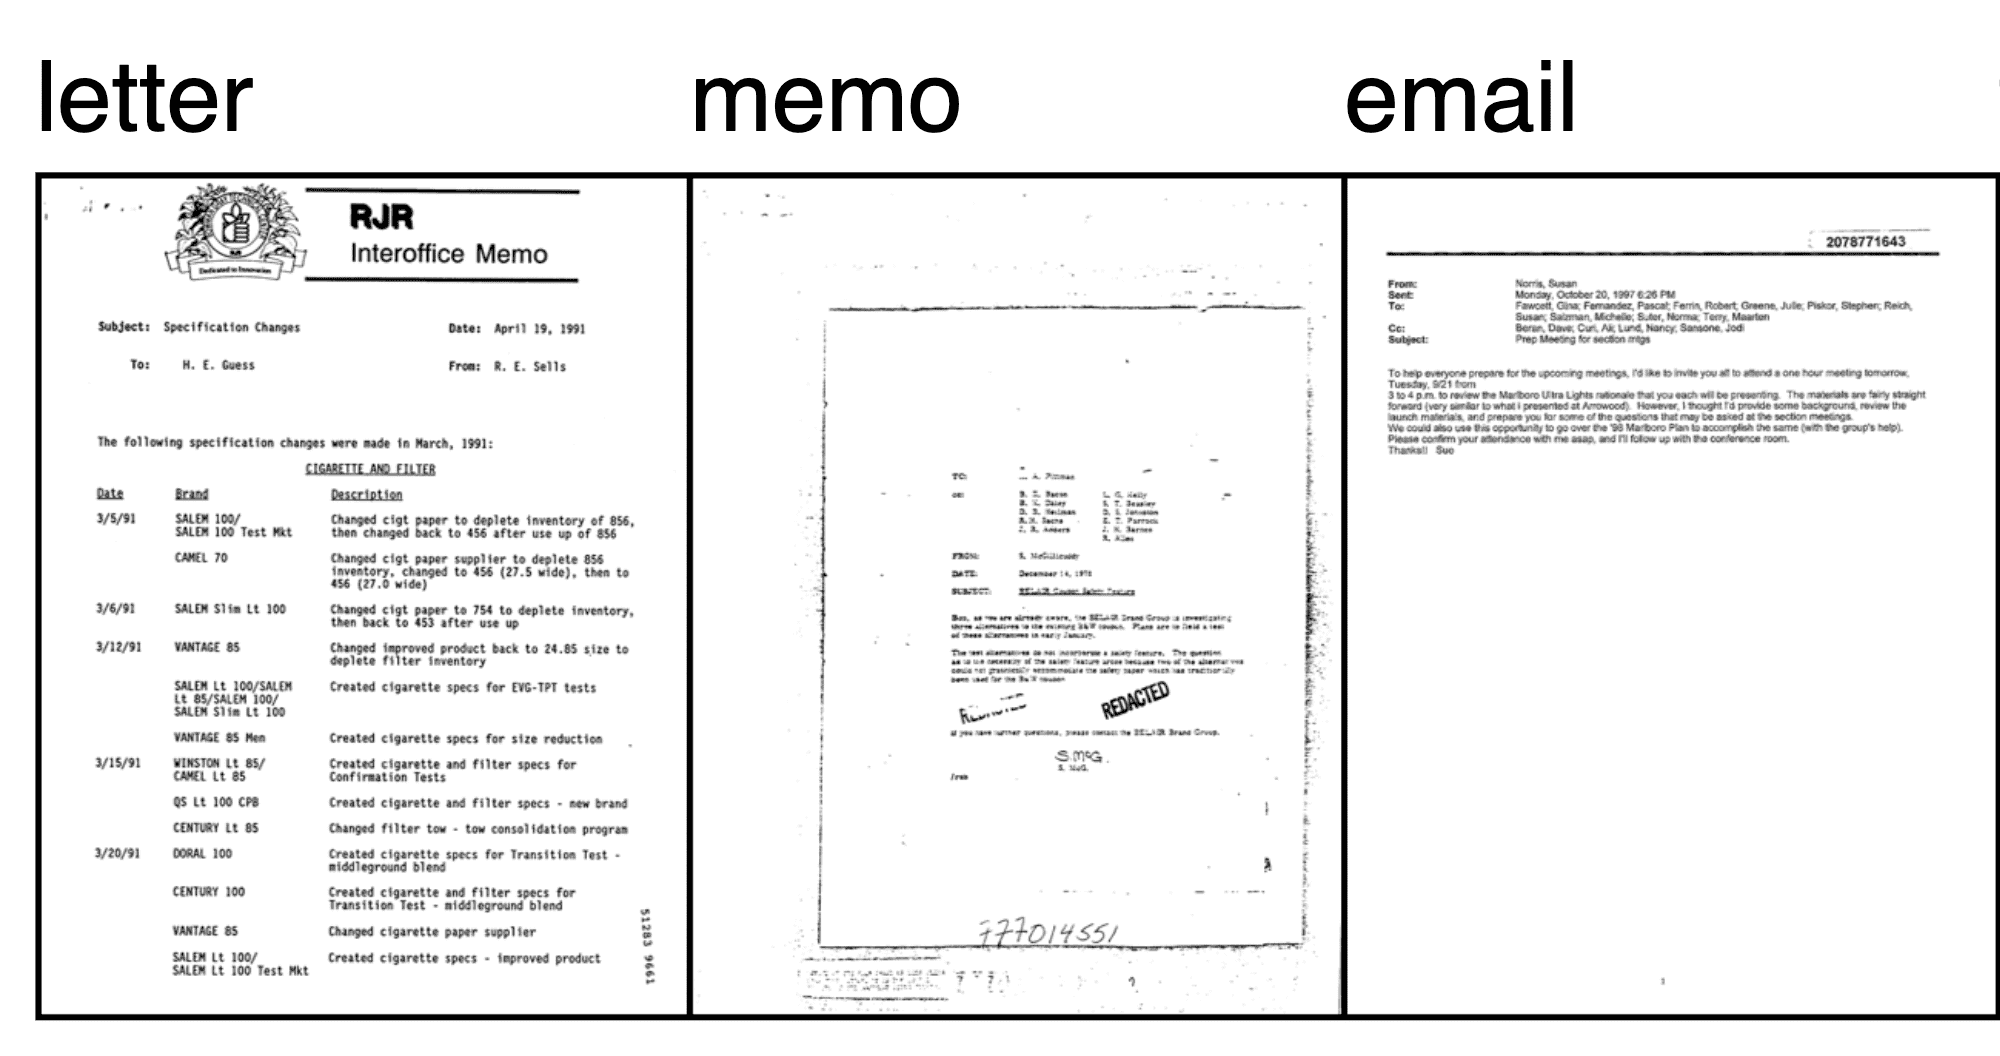
這時便可使用 LayoutLM 和 Donut 等模型。這些模型不只考慮文字,亦會納入視覺資訊,因而能大幅提升準確度。以重要的文件圖片分類基準測試 RVL-CDIP 為例,BERT-base 使用文字可達 89% 準確率。純視覺模型 DiT(Document Image Transformer)不會將文字作為輸入,準確率可達 92%。而 LayoutLMv3 和 Donut 等多模態 Transformer 同時運用文字和視覺資訊,準確率可達 95%!這些多模態模型正改變業界解決 Document AI 問題的方法。
文件版面分析旨在判斷文件的實體結構,即識別組成文件的個別區塊,例如文字段落、標題和表格。這項任務通常會建模為圖片分割或物件偵測問題。模型會輸出一組分割遮罩或邊界框,以及相應的類別名稱。
目前文件版面分析的最先進模型包括 LayoutLMv3 和 DiT(Document Image Transformer)。兩者均以經典的 Mask R-CNN 物件偵測框架為骨幹。這個文件版面分析 Space 示範如何使用 DiT 識別文件中的文字段落、標題和表格。此處亦展示使用 DiT 偵測文件不同部分的例子。
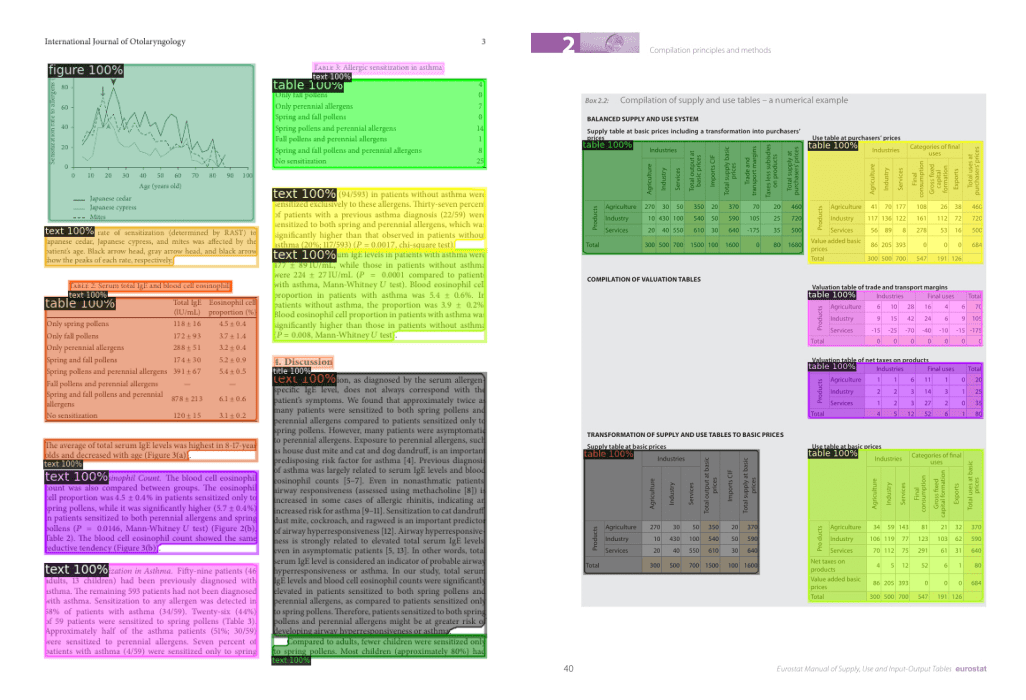
使用 DiT 進行文件版面分析。
文件版面分析通常使用 mAP(平均平均精確率)指標,這項指標常用於評估物件偵測模型。重要的版面分析基準資料集包括 PubLayNet。撰文時的最先進模型 LayoutLMv3,整體 mAP 分數為 0.951(來源)。
文件解析比版面分析更進一步,旨在識別並提取文件中的重要資訊(通常以鍵值配對呈現),例如發票表格中的姓名、項目和總額。這個 LayoutLMv2 Space 示範如何解析文件,識別問題、答案和標題。
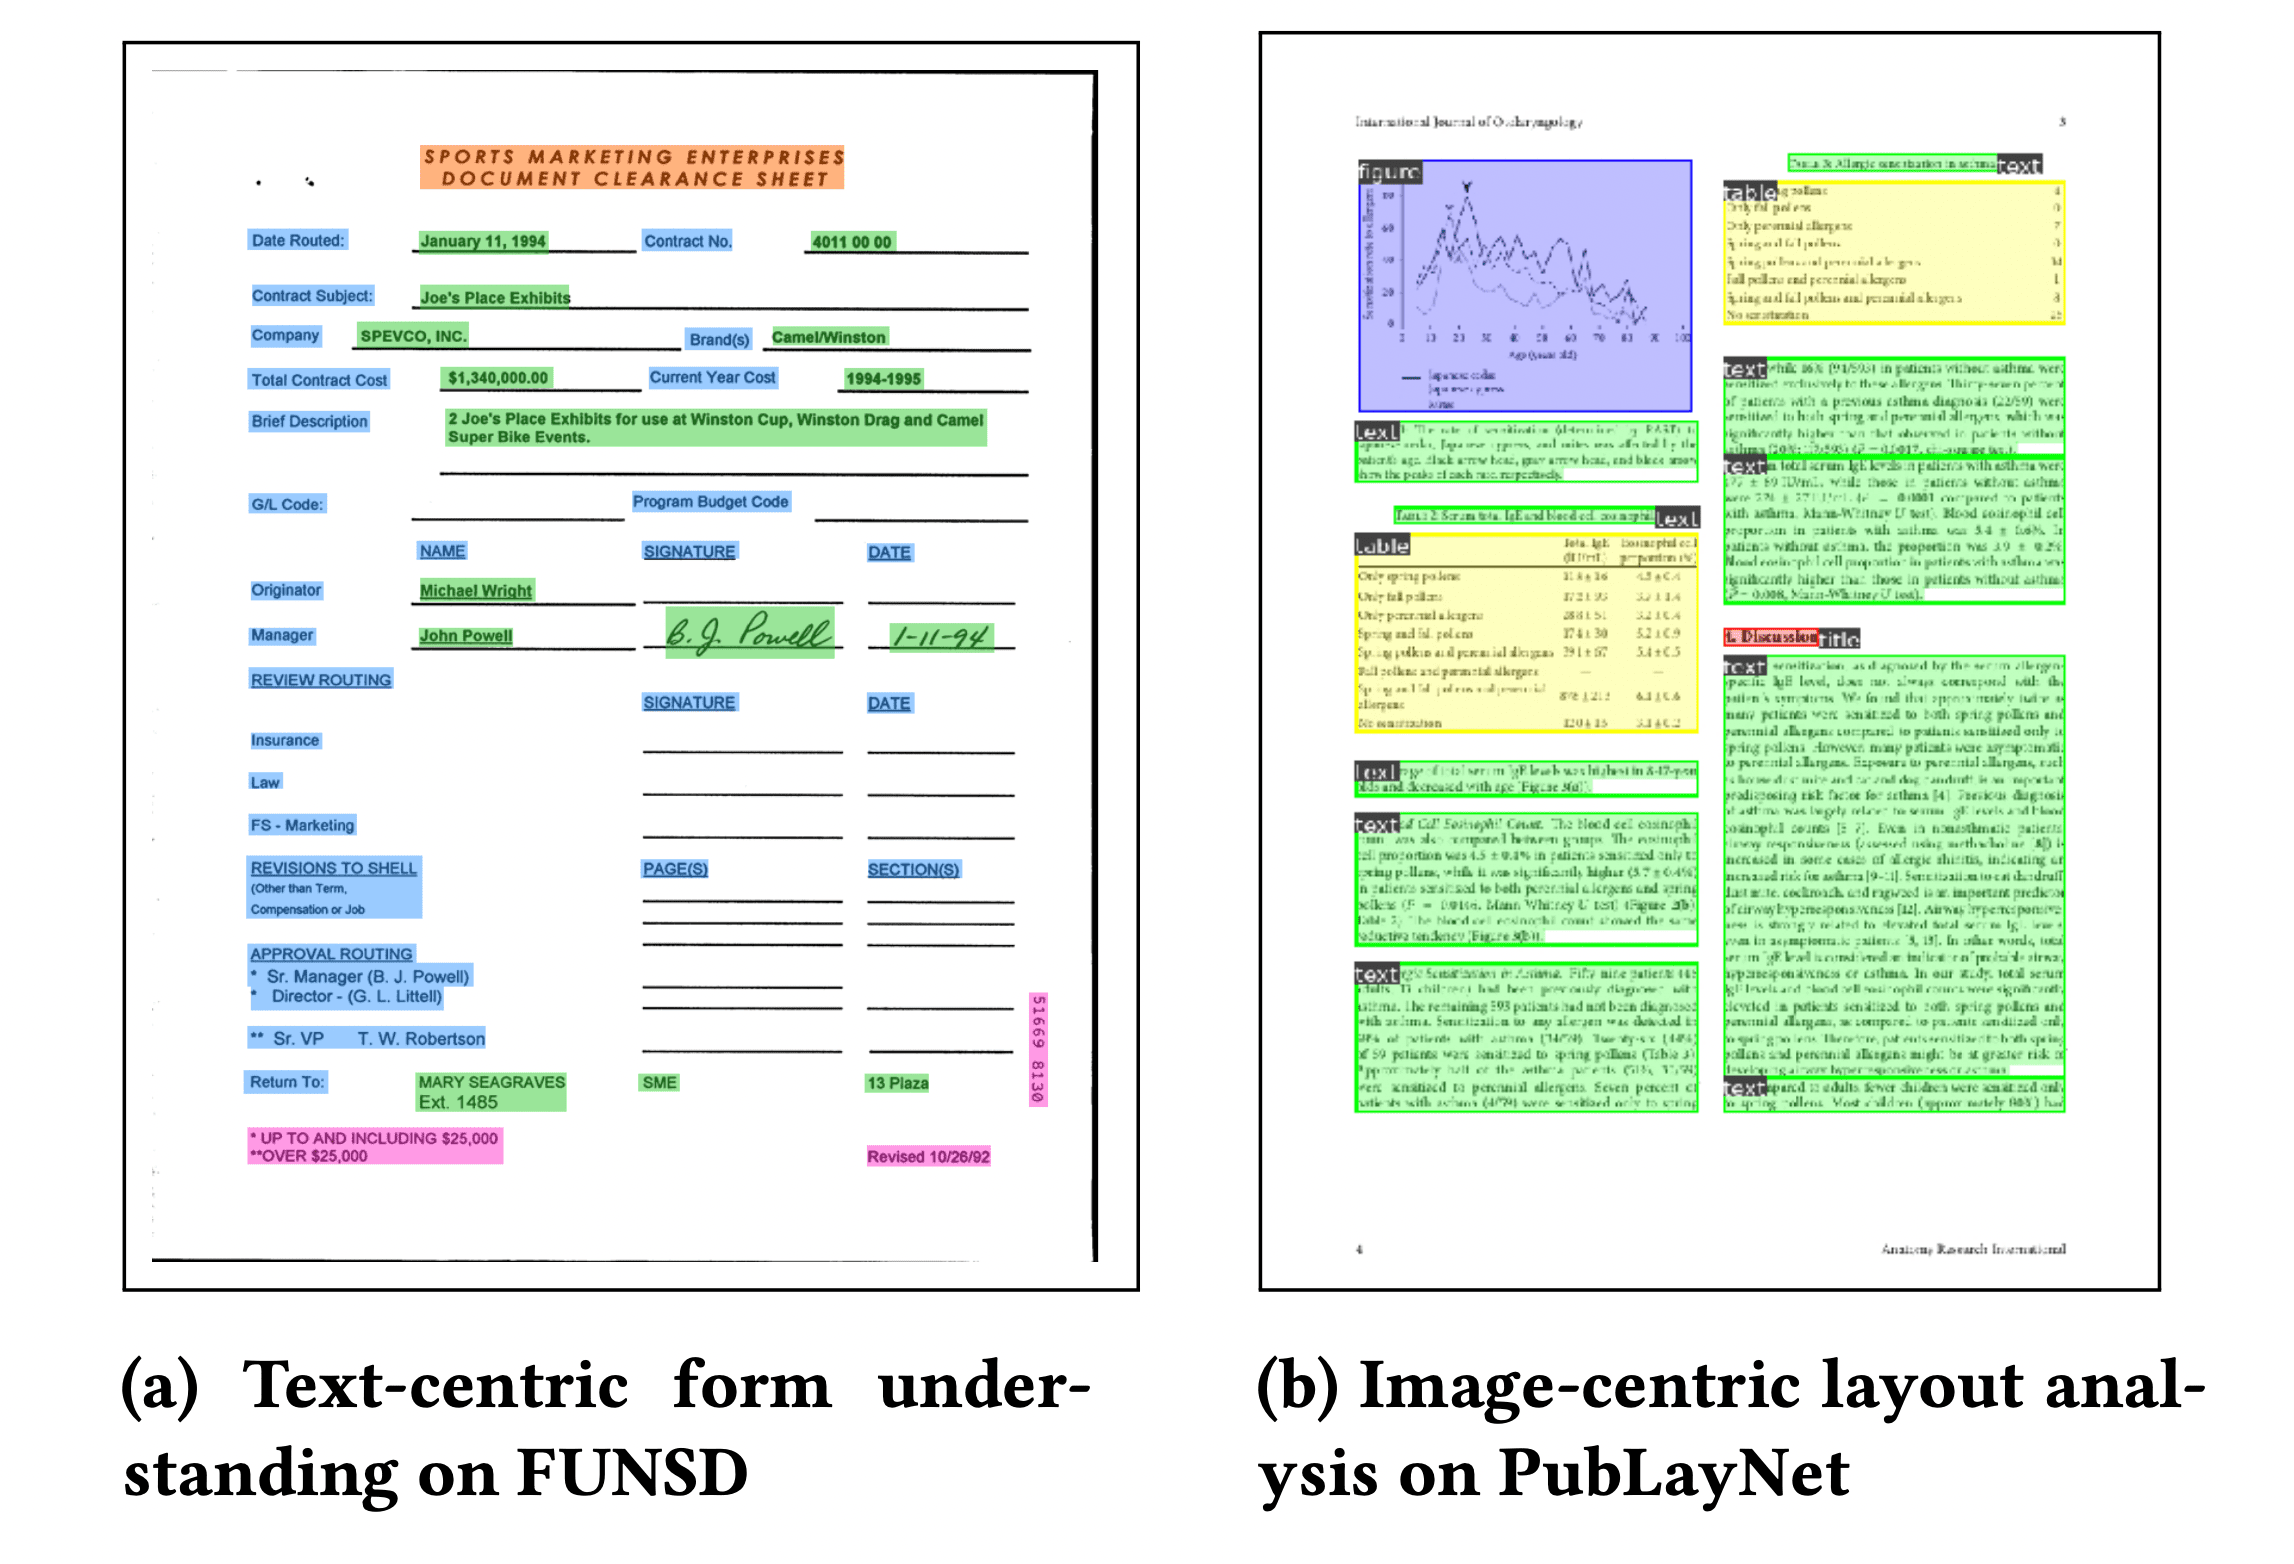
第一版 LayoutLM(現稱 LayoutLMv1)於 2020 年推出,在當時的基準測試中大幅提升表現,至今仍是 Hugging Face Hub 上最受歡迎的 Document AI 模型之一。LayoutLMv2 和 LayoutLMv3 在預訓練期間加入視覺特徵,進一步改善效能。LayoutLM 系列令 Document AI 效能大幅躍進。例如,在 FUNSD 基準資料集上,BERT 模型的 F1 分數為 60%,使用 LayoutLM 則可達 90%!
LayoutLMv1 已有許多後繼模型,包括 ERNIE-Layout;它在這個 Space 展現出良好結果。多語言用途方面,LayoutLM 亦有多語言變體,例如 LayoutXLM 和 LiLT。LayoutLM 論文中的圖片展示模型如何分析不同文件。
LayoutLM 的許多後繼模型採用生成式端到端方法。這個方向始於 Donut 模型:它直接接收文件圖片作為輸入,並生成文字輸出,毋須依賴獨立 OCR 引擎。

由 encoder-decoder Transformer 組成的 Donut 模型。圖片取自 Donut 論文。
Donut 推出後,亦有多款類似模型問世,包括 Google 的 Pix2Struct 和 Microsoft 的 UDOP。現時可微調 LLaVa-NeXT 和 Idefics2 等大型視覺語言模型,以端到端方式執行文件解析。事實上,只要任務可定義為圖片至文字任務,這些模型便可微調以執行任何 Document AI 任務,從文件圖片分類到文件解析均可。例如,可參閲這份教學筆記本,瞭解如何微調 Google 的 PaliGemma(較小型的視覺語言模型),使其能從收據圖片輸出 JSON。

PaliGemma 等視覺語言模型可針對任何圖片至文字任務進行微調。請參閲教學筆記本。
資料科學家發現,文件版面分析和資訊提取是企業的重要應用情境。現有商業方案通常無法處理大部分企業資料在內容和結構上的多樣性。因此,資料科學團隊自行微調模型,往往能超越商業工具。
文件通常包含表格,而大部分 OCR 工具對表格資料並非開箱即用。表格偵測旨在找出表格位置;表格提取則會建立該資訊的結構化表示。表格結構辨識旨在識別組成表格的個別部分,例如列、欄和儲存格。表格功能分析(FA)則負責辨認表格的鍵和值。Table transformer 的圖片展示各子任務之間的差異。
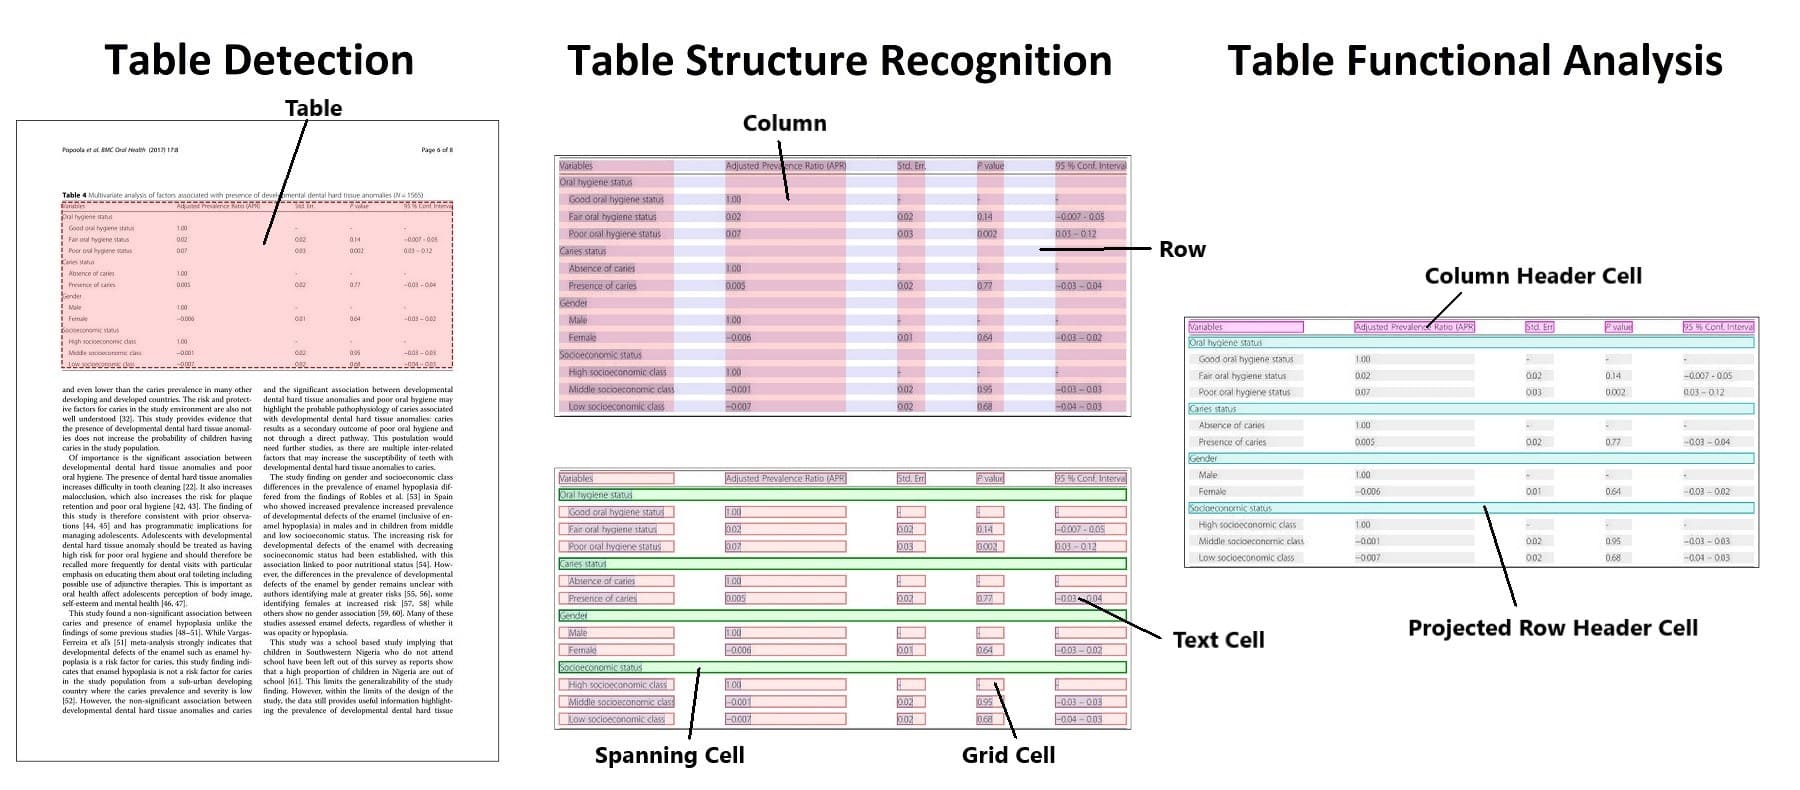
表格偵測和結構辨識的方法,與文件版面分析相似,會使用物件偵測模型輸出一組邊界框及相應類別。
Table Transformer 等最新方法可用同一模型執行表格偵測和表格結構辨識。Table Transformer 是類似 DETR 的物件偵測模型,使用 PubTables-1M(包含一百萬張表格的資料集)訓練。表格偵測和結構辨識通常使用平均精確率(AP)指標評估。據報告,Table Transformer 在 PubTables-1M 上的表格偵測 AP 為 0.966,表格結構辨識加功能分析 AP 為 0.912。
表格偵測和提取是很有前景的方法,但在你的資料上結果可能不同。根據我們的經驗,表格質素和格式差異很大,會影響模型表現。使用部分自訂資料進一步微調,可大幅改善效能。
文件問答大幅改變了人們與 AI 互動的方式。近年進展令模型能回答有關圖片的問題,這稱為文件視覺問答,簡稱 DocVQA。模型收到問題後會分析圖片並作答。下圖展示 DocVQA 資料集中的例子。使用者問:「寫下的郵遞區號是甚麼?」模型則回答問題。
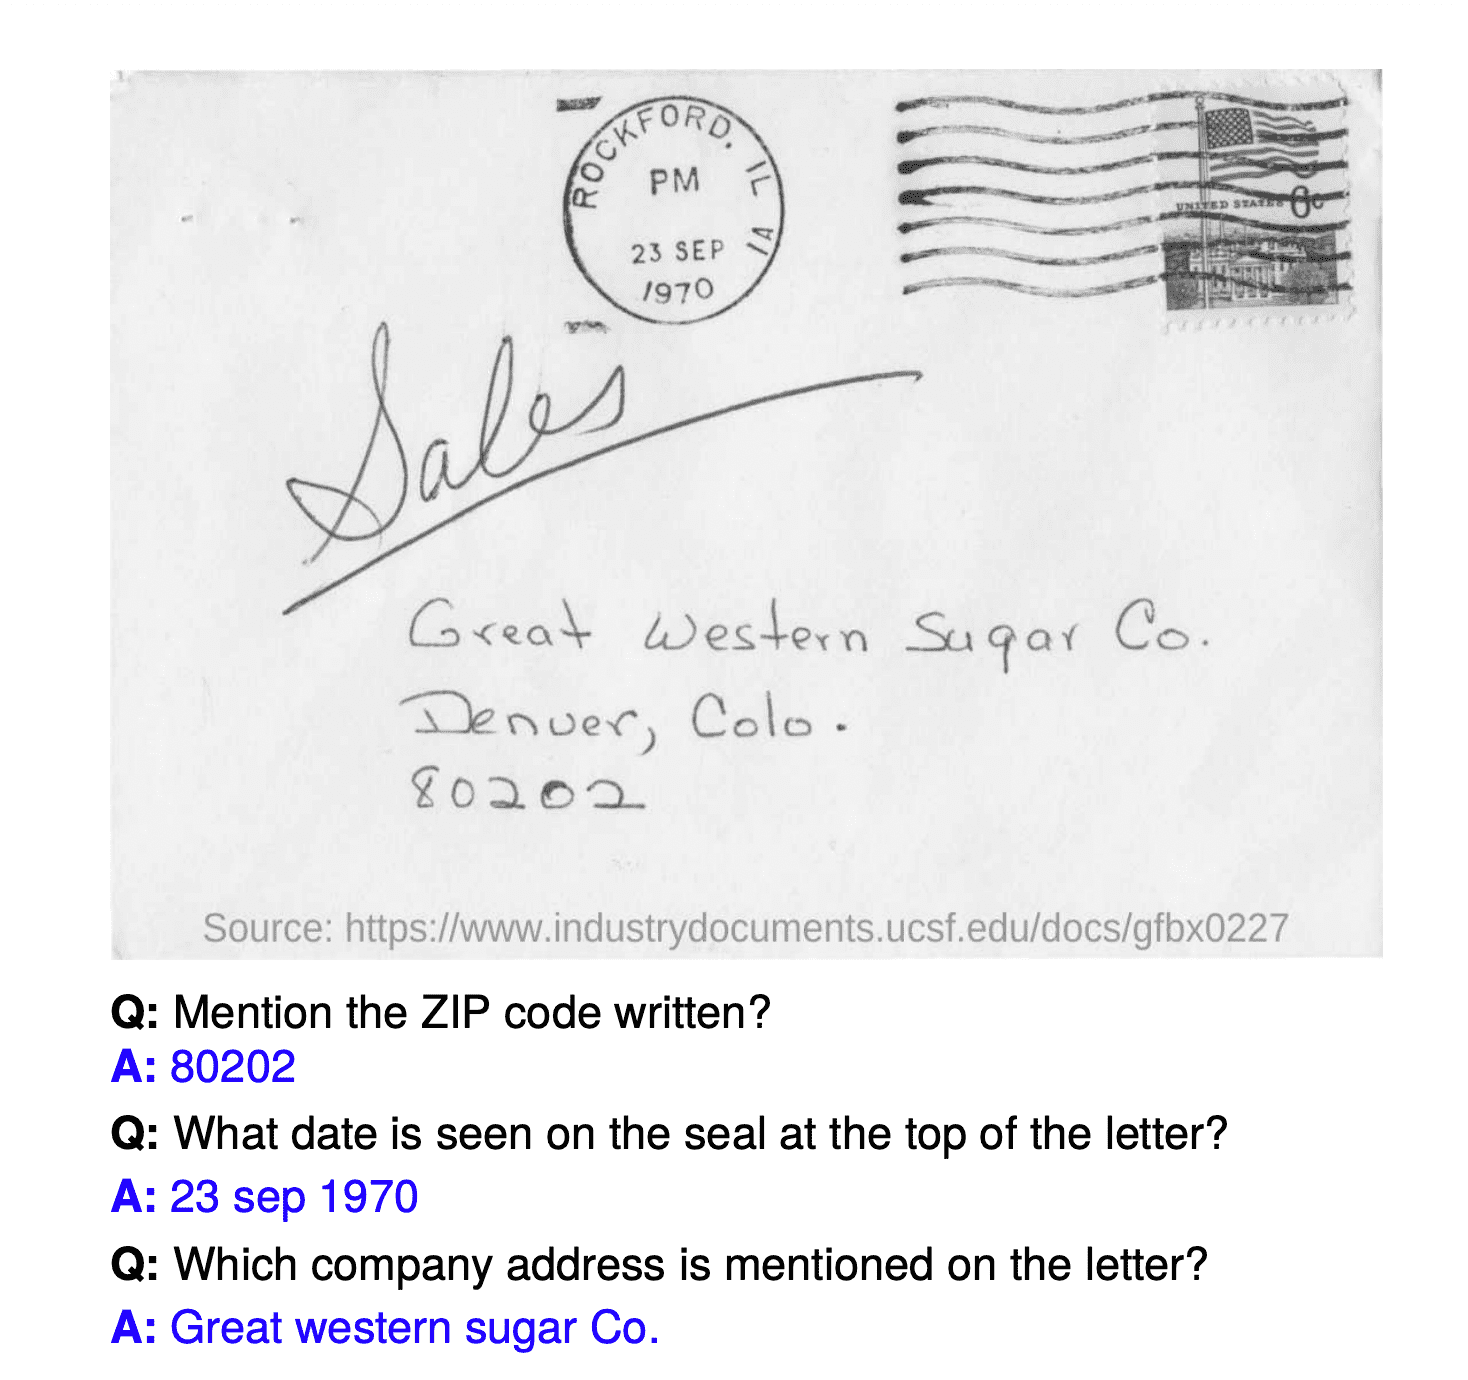
過去,建立 DocVQA 系統通常需要多個模型協作。 可能要分別使用模型分析文件版面、執行 OCR、提取實體,然後回答問題。最新的 DocVQA 模型可由單一(多模態)模型以端到端方式完成問答。
DocVQA 通常使用平均正規化 Levenshtein 相似度(ANLS)指標評估。關於此指標的詳情,請參閲這份指南。現時開源模型中,DocVQA 基準測試的最先進模型是 LayoutLMv3,ANLS 分數為 83.37。不過,此模型由 OCR 和多模態 Transformer 組成一條 pipeline。
Donut、LLaVa-NeXT 和 Idefics2 等較新模型,則使用單一 Transformer 神經網絡端到端處理任務,毋須依賴 OCR。Impira 提供了一個精彩的 Space,示範使用 LayoutLM 和 Donut 執行 DocVQA。
視覺問答很有吸引力,但要成功使用,仍有許多事項要考慮。準確的訓練資料、評估指標和後處理都至關重要。準備採用此用途的團隊須留意,DocVQA 很難穩定運作。有時回應會難以預測,模型亦可能「幻覺」,提供文件中不存在的答案。視覺問答模型可能承襲資料偏見,帶來倫理問題。妥善設定模型和執行後處理,是建立成功 DocVQA 方案不可或缺的一環。
Document AI 有哪些授權問題?
業界和學術界都為推進 Document AI 作出巨大貢獻,資料科學家可使用各式各樣的模型和資料集。不過,授權問題可能令企業方案無法開展。 部分知名模型採用限制性授權,禁止商業用途。最值得留意的是,Microsoft 的 LayoutLMv2 和 LayoutLMv3 檢查點不能作商業用途。開始專案時,我們建議仔細評估候選模型的授權。及早了解將使用哪些模型非常重要,因為這可能影響資料收集和標註。本文末有一份熱門模型及其授權資料表。
Document AI 有哪些資料準備問題?
Document AI 的資料準備既關鍵又具挑戰性,必須確保資料標註妥當。以下分享我們在資料準備方面學到的心得和可行做法。
首先,機器學習取決於資料的規模和質素。如果文件圖片質素欠佳,便不能指望 AI 憑空讀懂文件。同樣地,如果訓練資料很少但類別很多,效能可能不理想。Document AI 和其他機器學習問題一樣,通常資料越多,效能越好。
其次,方法要保持彈性。你可能要測試多種方法才能找出最佳方案。OCR 就是一個好例子:可以使用 Tesseract 等開源產品、Cloud Vision API 等商業方案,或 Donut 等開源多模態模型內建的 OCR 功能。
第三,先從少量資料開始標註,並慎選工具。根據我們的經驗,數百份文件已能取得不錯結果。因此先小規模開始,仔細評估表現。確定整體方法後,再逐步擴大資料量,以盡量提高預測準確度。標註時請記住,版面識別和文件資訊提取等任務,需要識別文件內的特定區域,因此要確保標註工具支援邊界框。
Document AI 有哪些建模問題?
自行構建模型的彈性,讓資料科學家有很多選擇。我們強烈建議團隊先從預訓練開源模型開始。這些模型可針對你的文件微調,通常是最快取得理想模型的方法。
如團隊考慮自行建立預訓練模型,請留意這可能涉及數百萬份文件,訓練模型亦可能需時數星期。建立預訓練模型需要大量心力,不建議大部分資料科學團隊採用。建議先微調現有模型,但請先考慮以下問題。
你希望模型負責 OCR 嗎?例如,Donut 不要求先對文件執行 OCR,能直接處理完整解析度圖片,因此建模前毋須進行 OCR。不過,視乎問題設定,獨立取得 OCR 結果可能更簡單。
是否應使用更高解析度的圖片?使用 LayoutLMv2 處理圖片時,會將圖片縮小至 224 乘 224,破壞原有長寬比例。Donut、Pix2Struct 和 Idefics2 等較新模型則使用完整的高解析度圖片,保留原有長寬比例。研究顯示,提高圖片解析度可大幅提升效能,因為模型能「看見」更多內容。不過,訓練和推理所需記憶體亦會增加。

圖片解析度對下游效能的影響。取自 Pix2Struct 論文。
你如何評估模型?要留意邊界框是否對齊。請確保你選用的 OCR 引擎所提供的邊界框與模型處理器對齊。檢查這點可避免結果意外地欠佳。其次,按專案要求選擇評估指標。例如,在 token 分類或問答等任務中,100% 吻合未必是最佳指標。部分吻合指標可將更多可能的 token 視為相符,例如將「Acme」和「inside Acme」判定為匹配。最後,評估時亦要考慮倫理問題,因為這些模型可能使用帶偏見的資料,或產生不穩定、可能對某些羣體不利的結果。
後續步驟
你看到 Document AI 的可能性了嗎?我們每天都與企業合作,使用最先進的視覺和語言模型解鎖有價值的資料。本文提供了多個示範連結,可作為起點。最後一節列出開始編寫自訂模型(例如視覺問答模型)的資源。準備好開始建立方案後,Hugging Face 公開 Hub是很好的起點,當中有大量 Document AI 模型。
如想加快 Document AI 工作進度,Hugging Face 可以提供協助。我們透過企業加速計劃與企業合作,為 AI 應用情境提供指引。Document AI 方面,我們可協助建立預訓練模型、提升微調任務的準確度,或全面指導你如何處理首個 Document AI 應用情境。
我們亦可提供運算點數套裝,讓你大規模使用訓練(AutoTrain)或推理(Spaces 或 Inference Endpoints)產品。
資源
以下可找到多款 Document AI 模型的筆記本和教學:
- Niels 的 Transformers-Tutorials
- Philipp 的 使用 Hugging Face Transformers 進行 Document AI
Document AI 有哪些熱門開源模型?
下表列出現時在 Document AI 任務中達到最先進表現的 Transformers 模型。值得留意的一個趨勢是,越來越多視覺語言模型以端到端方式執行 Document AI 任務,將文件圖片作為輸入並生成文字輸出。
最後更新於 2024 年 6 月。
Document AI 有哪些指標和資料集?
下表列出 Document AI 常見任務的指標和資料集。最後更新於 2022 年 11 月。
| 任務 | 常用指標 | 基準資料集 |
|---|---|---|
| 光學字元辨識 | 字元錯誤率(CER) | |
| 文件圖片分類 | 準確率、F1 | RVL-CDIP |
| 文件版面分析 | mAP(平均平均精確率) | PubLayNet、XFUND(表格) |
| 文件解析 | 準確率、F1 | FUNSD、SROIE、CORD |
| 表格偵測和提取 | mAP(平均平均精確率) | PubTables-1M |
| 文件視覺問答 | 平均正規化 Levenshtein 相似度(ANLS) | DocVQA |
來源:Hugging Face Blog · huggingface.co