如何在 Amazon Bedrock 上以 Grok 4.7 建立長時程智能體
Build long-horizon agents with Grok 4.7 on Amazon Bedrock
文章展示如何在 Amazon Bedrock 上以 Grok 4.7 建立工具呼叫智能體,並以三項需要搜尋的任務比較 low、medium、high、xhigh 四種推理力度。
文章以三項答案可窮舉驗證的任務比較推理力度與 token 用量,並提供可移用於自有 Agent 評測的測試設計和生產監控方法。
SpaceXAI 的 Grok 4.7 現已登陸 Amazon Bedrock。Amazon Bedrock 提供多個供應商的基礎模型(FM)供用戶選擇。SpaceXAI 表示,Grok 4.7 經過訓練,能在較困難的任務上持續工作更長時間,並知道何時檢查自己的工作成果。這對 Agent 尤其重要,因為 Agent 需要透過多個步驟完成任務,並在過程中核實所得結果。
以這種方式運作的 Agent 不只要查找資料,還要提出一個候選答案,根據已學到的內容核對答案,再不斷完善,直至答案符合要求。Grok 4.7 提供推理力度設定,用來控制每次回應前進行多少推敲;對於 Agent 工作負載,實際問題是應採用哪個級別。
本文會在 Grok 4.7 上建構一個工具呼叫 Agent,並以三項需要搜尋而非單純查找的任務評估它。這些任務包括:根據警報診斷兩項服務同時中斷、在互相影響的限制下安排維護工作,以及在預算限制下選出最佳遷移組合。每項任務都只有一個正確答案,並已透過暴力搜尋驗證。我們在每個推理力度級別都執行這三項任務,每項重複六次,合共進行 72 次 Agent 執行。
Agent 在 72 次執行中答對 67 次。在 xhigh 級別,18 次全部答對;在 low 級別,18 次中答對 15 次,而輸出 Token 用量約為八分之一。這清楚呈現可按每項請求調校的取捨;本文亦會説明如何在自己的任務上進行測量,以及如何在正式環境中監察表現。
本文全程報告 Token 數量,而非貨幣金額。Token 價格會變動,而實際成本是根據用量計算,因此以 Token 表示的測量結果仍然有效。
SpaceXAI 對 Grok 4.7 的説明
SpaceXAI 表示,Grok 4.7 採用比 Grok 4.6 更大的基礎模型,並在難度更高的任務組合上進行了更長時間的強化學習訓練。這些任務的權重偏向需要多個小時才能完成的問題。SpaceXAI 表示,該模型更擅長核實自己的工作成果,以及管理較長的上下文。
SpaceXAI 公佈的基準測試結果也反映了這個重點。相較 Grok 4.6,最大幅度的提升出現在衡量持續工作能力,而非單輪回答的類別。
| 基準測試 | 類別 | Grok 4.6 | Grok 4.7 |
| Terminal-Bench 4.0 | 多小時終端機工作 | 20.3% | 37.6% |
| EEBench | 電機工程 | 53.0% | 64.0% |
| Harvey Legal Agent Benchmark | 法律工作 | 15.8% | 19.6% |
| CursorBench 4.0 | 較長時間執行的程式編寫 | 40.4% | 46.3% |
| HealthBench Professional | 臨牀推理 | 48.5% | 56.7% |
| AA Briefcase v1.1 | 多小時辦公室工作 | 1,546 | 1,657 |
來源:SpaceXAI,《Introducing Grok 4.7》(https://x.ai/news/grok-4-7)。分數為模型推出時 SpaceXAI 公佈的數據。
基準測試展示模型在標準任務上的表現。若要了解模型在自己的工作負載上的表現,下一步就是以類似自身工作內容的任務進行測量;本文其餘部分會逐步説明這個做法。
SpaceXAI 列出 Grok 4.7 的上下文視窗為 500K Token,支援文字和圖片輸入,以及文字輸出。在 Amazon Bedrock 上,該模型支援可設定的推理力度、工具呼叫和結構化輸出。
如何在 Amazon Bedrock 上使用 Grok 4.7
Grok 4.7 在 bedrock-runtime 端點上執行,並透過跨區域推理設定檔存取。現有兩個設定檔:
| 推理設定檔 | 路由 | 適用情況 |
| us.xai.grok-4.7 | 在美國地理區域內 | 你有美國資料駐留要求 |
| global.xai.grok-4.7 | 商用 AWS 區域 | 你不受資料駐留限制,並希望獲得最充裕的可用容量 |
跨區域推理會將請求路由至多個 AWS 區域,讓你無須逐區管理容量,亦可提高吞吐量。請求須指定其中一個推理設定檔,而非單獨的模型 ID。
此模型支援 OpenAI 相容的 Chat Completions 和 Responses API,以及 Amazon Bedrock Converse API。在 Converse 中,推理會以 reasoningContent 區塊連同 text 區塊一併傳回。在 inferenceConfig 中,只設定 maxTokens,並將推理力度等模型專屬參數放入 additionalModelRequestFields。
如需目前支援的區域、服務級別及 token 價格清單,請參閲 Amazon Bedrock 使用者指南中的 Grok 4.7 模型卡,以及 Amazon Bedrock 定價頁面(https://aws.amazon.com/bedrock/pricing/)。
先決條件
- 具備 Amazon Bedrock 存取權,並已啟用 Grok 4.7 模型存取權的 AWS 帳戶。
- Python 3.9 或更新版本,並已安裝
openai、boto3和aws-bedrock-token-generator。 - 已在你的環境中設定 AWS 憑證。
你的 AWS Identity and Access Management (IAM) 身分必須在推理設定檔及帳戶的預設專案上均具備 bedrock:InvokeModel:
arn:aws:bedrock:{region}::inference-profile/us.xai.grok-4.7,或相當於global.的權限。arn:aws:bedrock:{region}:{account-id}:project/default。
請在政策陳述式中包含這兩項資源。除推理設定檔的權限外,亦必須具備預設專案的權限。
連接模型
在正式環境中使用時,我們建議使用現有的 AWS 憑證產生短期持有人權杖,讓驗證仍與你的 IAM 身分綁定,而且無須儲存長期有效的密碼:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

REGION = "us-west-2"
MODEL_ID = "us.xai.grok-4.7"

client = OpenAI(
    api_key=provide_token(region=REGION),
    base_url=f"https://bedrock-runtime.{REGION}.amazonaws.com/openai/v1",
    timeout=360,
    max_retries=0,  # retries are handled explicitly, see "Build in retries" below
)
推理 token 會計入輸出 token,並在產生答案文字前先佔用 max_completion_tokens 的額度,因此設定上限時,應為兩者預留足夠空間。如果推理期間達到上限,回應就不會包含答案文字,因此請在 Agent 程式碼中檢查內容是否為空;如遇到這種情況,請提高上限。我們的測試將上限設為 32,768 tokens,在各種推理力度設定下都留有餘量。
Grok 4.7 支援四種推理力度:low、medium、high 和 xhigh。不同模型版本的推理力度可能有所變更,因此值得向服務確認,而非將清單硬編碼:
def supported_effort_levels(candidates=("none", "low", "medium", "high", "xhigh", "max")):
    supported = []
    for level in candidates:
        try:
            client.responses.create(model=MODEL_ID, input="Say OK.",
                reasoning={"effort": level}, max_output_tokens=2048)
            supported.append(level)
        except Exception as exc:
            if "unsupported_value" not in str(exc) and "invalid_value" not in str(exc):
                raise
    return supported


print(supported_effort_levels())  # ['low', 'medium', 'high', 'xhigh']
設計需要推理的任務
不少 Agent 評估都在測試細心程度:讀取一筆記錄、篩選資料,再計算總和。這類任務值得納入;但若要了解推理力度帶來的作用,任務就必須要求搜尋:答案不能直接從資料讀出,必須先提出答案,再加以驗證。
我們建立了一個包含 20 個服務的合成環境,透過七個工具開放使用,並在其上設計了三項任務。每項任務都只有一個正確答案,而且設計上不能只靠簡單的啟發式方法就找到答案。
| 任務 | Agent 必須完成的工作 | 任務需要推理的原因 |
| two_fault_diagnosis | 兩個服務在 03:00 無聲失效,另外 12 個服務則發出警示。找出失效的兩個服務 | 失效的服務不會發出警示,因此答案不在發出警示的服務之中。共有 190 種可能的配對,只有一組能恰好解釋觀察到的警示 |
| maintenance_schedule | 用四晚為八個服務安裝修補程式,每晚兩個;須符合十項限制,並遵守同一團隊的兩個服務不可安排在同一晚的規則 | 共有 2,520 種可能排程,只有一種有效。團隊規則取決於 Agent 必須查找的資料 |
| migration_budget | 在預算內選擇要遷移的候選項目,將風險降低幅度最大化,並計入傳遞性先決條件 | 53 個可行方案,其中一個是最佳方案。先選擇比率最高者,得到的方案會比最佳方案少九分 |
四項做法可確保這類測量可信,亦適用於大部分 Agent 評估。
列明評分器所依據的每項規則。如果提示詞沒有説明某個邊界情況,合理的答案也可能被判錯,最終令評估衡量的是規格,而非模型。例如,診斷提示詞明確指出,服務故障本身不會觸發警報。
確認每項任務只有一個答案。每個環境都夠簡單,可以列舉所有可能答案,因此我們在執行前檢查了每個候選答案。以排程為例,只需幾行程式碼:
import itertools

ALL_SLOTS = sorted(set(itertools.permutations([1, 1, 2, 2, 3, 3, 4, 4])))

def valid_schedules(services, constraints):
    return [s for slots in ALL_SLOTS
        if satisfies(s := dict(zip(services, slots)), constraints)]

assert len(valid_schedules(SERVICES, CONSTRAINTS)) == 1  # exactly one answer
assert len(valid_schedules(SERVICES, CONSTRAINTS_WITHOUT_TEAM_RULE)) > 1 # the rule matters評分時只看指定的最後一行,而非整段回應。每個提示詞都要求 Agent 以類似 FINAL: auth, checkout 的一行作結。評分器只讀取該行,因此即使回應在解釋推理過程時討論其他候選答案,評分也只根據結論:
def final_line(answer):
    lines = [l for l in (answer or "").splitlines() if "FINAL" in l.upper()]
return lines[-1] if lines else None分開追蹤格式是否正確,以及答案是否正確。缺少最後一行,與最後一行有誤,是不同的訊號。在我們的測試中,全部 72 個回應都包含可供評分的最後一行。
當有效值已知時,使用 enum 限定工具參數,確保每次工具呼叫都指向實際存在的資源:
TOOLS = [
    {"type": "function", "function": {
        "name": "get_dependencies",
        "description": "Services that one service directly depends on.",
        "parameters": {
            "type": "object",
            "properties": {"service": {"type": "string", "enum": SERVICE_NAMES}},
            "required": ["service"],
        }}},
    # The remaining six tools follow the same shape.
]
系統提示詞刻意保持簡短,並要求 Agent 在作答前檢查答案:
AGENT_SYSTEM = (
    "You are an infrastructure analyst agent. Use the tools to gather facts and never guess "
    "a value you can look up. Before answering, check your answer against every rule in the "
    "task. End with the FINAL line exactly as the task specifies."
)
Agent 循環採用標準的工具呼叫流程:設定 reasoning_effort 後呼叫模型、執行每個傳回的工具呼叫、以 tool_call_id 為鍵加入結果,然後重複以上步驟,直至模型不再要求使用工具。在整個循環中追蹤 prompt_tokens 和 completion_tokens,便可得出下一節報告的 token 數量。
結果
每個任務在每個推理力度下執行六次,合共 72 次。Agent 有 67 次答對。
| 任務 | low | medium | high | xhigh |
| two_fault_diagnosis | 5 次(共 6 次) | 6 次(共 6 次) | 6 次(共 6 次) | 6 次(共 6 次) |
| maintenance_schedule | 5 次(共 6 次) | 5 次(共 6 次) | 5 次(共 6 次) | 6 次(共 6 次) |
| migration_budget | 5 次(共 6 次) | 6 次(共 6 次) | 6 次(共 6 次) | 6 次(共 6 次) |
| 三項任務合計 | 15 次(共 18 次) | 17 次(共 18 次) | 17 次(共 18 次) | 18 次(共 18 次) |
| 每次執行 | low | medium | high | xhigh |
| 平均輸出 token 數 | 1,184 | 6,430 | 6,778 | 9,147 |
| 相對於 low 的輸出 token 數 | 1.0x | 5.4x | 5.7x | 7.7x |
| 平均工具呼叫次數 | 17.2 | 18.7 | 17.8 | 18.1 |
| 用時中位數 | 18s | 98s | 89s | 106s |
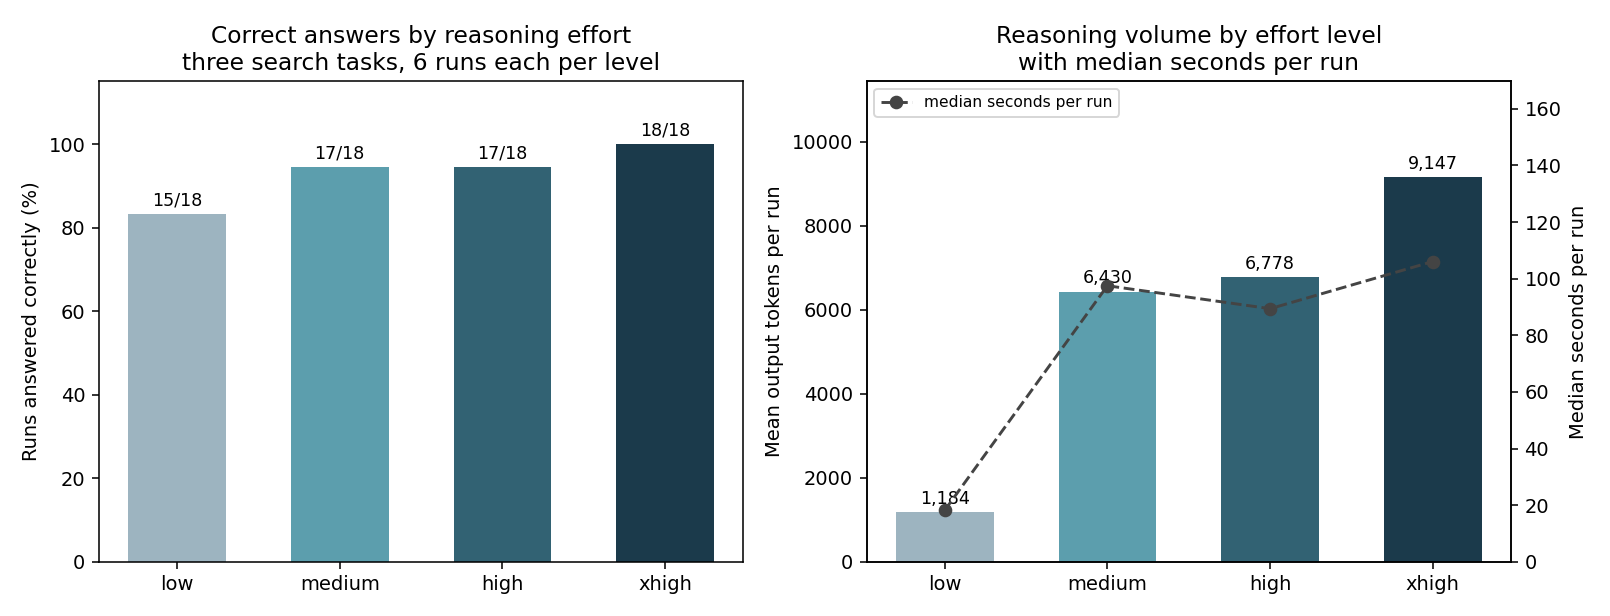
圖 1:各推理力度下答對的執行次數比例(左),以及每次執行的平均輸出 token 數,並以線條疊加每次執行的用時中位數(右)
三項觀察。
xhigh 每次執行都答對。在 xhigh 下,三項任務合共 18 次執行全部答對;medium 和 high 則各答對 18 次中的 17 次。每項任務在每個力度下只執行六次,因此不同力度之間的差異只能作參考,未足以得出具統計定論的結論;不過,三項任務呈現的趨勢一致。
推理力度影響 Agent 推理的程度,而非探索的範圍。各力度下的工具呼叫次數基本持平,每次執行介乎 17.2 至 18.7 次。無論推理力度如何,Agent 收集的資訊都相同;變化的是它對這些資訊進行推理的程度,輸出 token 數由 low 時的 1,184 增至 xhigh 時的 9,147。
low 的性價比相當高。 在 low 下,Agent 在 18 次執行中有 15 次答對,使用的輸出 token 約為 xhigh 的八分之一,中位執行時間為 18 秒。如果可以接受稍低的正確率,或答案會在後續流程中接受審核,low 是高效之選。如果每個答案都必須一次答對,較高級別是較穩妥的預設選擇。
推理力度如何影響答案
這些任務針對一類特定難度而設;檢視各推理力度如何處理這些任務,有助判斷何時值得投入更多推理。
優化。 遷移任務講求考慮不同組合,而非逐一排列選項。選出個別比例最高的候選項,所得答案雖然合理,卻比最佳結果少 9 分。在 medium 及以上,Agent 在全部 18 次執行中都找到了最佳組合。
假設檢驗。 診斷任務要求從正反兩方面檢查一對候選項:每個警報都必須得到解釋,而每項沒有發出警報的服務也必須與答案一致。在 medium 及以上,Agent 在全部 18 次執行中都找到了正確的一對。
約束滿足。 排程任務結合了十項列明的限制,以及一項取決於查詢所得擁有權資料的團隊規則。xhigh 每次都產生有效排程,而這項任務最能清楚顯示最高級別帶來的差異。
三項任務呈現的模式是:當 Agent 需要比較多個候選答案,而非沿單一路徑得出結果時,額外投入推理最有價值。
在正式環境中監察推理
在正式環境中,你沒有已知答案可用作評分基準,但知道每次執行使用了多少輸出 token 和工具呼叫次數。這些數據可提供有用的操作訊號。
各級別的正確執行,其推理量都有一個明確下限。medium 及以上的每次正確執行至少使用 1,739 個輸出 token,而一般執行則使用數千個。如果某次執行沒有呼叫任何工具,或輸出量遠低於該級別的正常水平,便值得標記以供檢視:
def flag_for_review(run, baseline):
    """baseline: output tokens of graded, correct runs at the same effort level."""
    reasons = []
    if run["tool_calls"] == 0:
        reasons.append("made no tool calls")
    if run["output_tokens"] < 0.2 * min(baseline):
        reasons.append(f"used {run['output_tokens']} output tokens, "
            f"under a fifth of the lowest correct run ({min(baseline)})")
    return reasons
根據已評分的執行,按任務及推理力度校準基準,再套用於尚未評分的執行。將標記視為檢視或重新執行的提示。在 low 下,每次執行都很短,輸出量是較弱的訊號,因此應配合抽查。
在系統提示詞中要求 Agent 核實答案,這項做法值得保留,因為檢視每次執行時,Agent 的推理過程會較容易追蹤。凡是有已知答案的情況,應配合自動評分,讓質素評估獨立於執行記錄。
選擇推理力度
這些結果帶出幾項實用原則。
按任務性質調整推理力度。 涉及搜尋、優化或檢驗假設的任務,最受惠於 medium 或更高級別。沿單一路徑完成的任務,或答案會在後續流程中接受審核的任務,則可使用 low,提升效率。
按請求設定推理力度,而非按 Agent 設定。 推理力度是請求參數,因此 Agent 可在規劃和核實步驟採用較高級別,並在格式化工具結果等機械式步驟採用 low。這樣既能兼得較高級別的大部分可靠性,又可降低 token 成本。
在自己的任務上重複測試。每個設定只執行一次,只會得到一個觀測值。每個設定重複執行數次,便可瞭解結果有多一致。
監察推理用量。按推理力度級別追蹤每次執行的輸出 Token 數量及工具呼叫次數,可及早提醒你在使用結果前檢視執行過程。
這項量度方法的限制
每項任務及每個推理力度級別各執行六次。這足以顯示三項任務的整體趨勢是否一致,但不足以計算信賴區間。不同級別之間的差異只宜作參考。
合成環境。工具讀取由程式碼產生的數據,因此可以證明每項任務只有一個正確答案,並自動評分。真實工具會帶來延遲、不完整結果及錯誤,這些情況均未在此測試。
以分鐘計,而非小時計。在 low,執行時間中位數為 18 秒;在 xhigh,則為 106 秒。這是長時程工作的縮小版替代指標。這個方法可沿用,但絕對數值則不適用。
一個模型版本、一個區域、每項任務一個提示詞。同一任務的不同措辭可能會改變結果,這也是明確列出每項規則如此重要的原因之一。
Token 數量,而非成本。如要換算成貨幣,請套用 Amazon Bedrock 定價頁面上適用於你所用推理設定檔及服務級別的現行費率。Global 和 US Geo 設定檔的定價不同,而 Flex 和 Priority 服務級別則會套用不同的倍數。
Agent 工作負載的操作控制措施
加入重試機制。大量發出呼叫的 Agent,應在設計中加入重試機制。設定請求逾時,只重試可重試的錯誤,採用指數退避並加入隨機抖動;如果回應中包含 Retry-After 標頭,亦應遵從:
import random, time

RETRYABLE = {408, 429, 500, 502, 503, 504}

def call_with_backoff(fn, attempts=7, base=4.0, cap=180.0):
    for attempt in range(1, attempts + 1):
        try:
            return fn()
        except Exception as exc:
            status = getattr(exc, "status_code", None)
            retryable = status in RETRYABLE or "timed out" in str(exc).lower()
            if not retryable or attempt == attempts:
                raise
            time.sleep(random.uniform(base, min(cap, base * 2 ** attempt)))
按需輸送量會隨時間逐步提升,因此新建高流量工作負載時,應逐步增加負載,而非一開始便以全速運行。
稽核執行過程。模型呼叫記錄功能會將請求及回應資料寫入 Amazon Simple Storage Service (Amazon S3) 或 Amazon CloudWatch Logs,讓你事後檢視執行過程的完整記錄。
大規模監察推理用量。Amazon CloudWatch 指標會提供 Token 用量的整體概況,讓前文所述各級別的基準數據可用作設定警示的依據。
按 Agent 分攤開支。AWS Cost Explorer 和 AWS Cost and Usage Report 的成本明細會按模型細分用量;結合每項任務的 Token 數量,便可同時掌握單位成本和總帳單。
按緊急程度配合成本。服務級別按每項請求設定,因此同一部署可透過 Flex 級別處理夜間分析,並透過 Priority 處理互動式請求。對於以較高推理力度級別運行的工作負載,選擇服務級別亦是進一步控制成本的手段。
選擇路由設定檔。跨區域推理會擴大長時間執行的工作可使用的容量池。Global 設定檔會從你選擇的商業 AWS 區域提供服務,每個 Token 的定價通常低於地理路由。US 設定檔則會將處理過程限制在美國境內。選擇時除了考慮成本,亦應考慮資料駐留要求。
清理
本文中的範例不會建立需要付費的 AWS 資源,除了每次請求所耗用的 token 費用。如果你已產生長期 Amazon Bedrock API 金鑰,完成後請在 Amazon Bedrock 主控台刪除,因為該金鑰在撤銷前會一直有效。由 IAM 憑證產生的短期 token 則會自行到期。
如果你在測試期間啟用了將模型呼叫記錄寫入 Amazon S3,請檢查儲存貯體,並刪除不再需要的物件。
結論
SpaceXAI 訓練 Grok 4.7,讓它能在更具挑戰性的任務上花更多時間,並知道何時需要檢查自己的工作。在三項需要搜尋而非直接查找的任務中,Agent 在 72 次測試中有 67 次答對,而所有測試都在 xhigh 下進行。由於推理力度可按請求設定,你可以為 Agent 的每個步驟選擇詳盡程度與 token 成本之間的平衡。
有三項值得納入自己的評估。設計答案可驗證的任務,並列明評分器所依據的每項規則。重複進行測試,以瞭解每種設定的一致性。按推理力度級別監察輸出 token 數量和工具呼叫次數,讓你在衡量品質的同時,也掌握營運方面的指標。
延伸閲讀
- 在 Amazon Bedrock 推出 Grok
- Grok 4.7 現已在 Amazon Bedrock 推出
- 使用跨區域推理,跨 AWS 區域路由模型推理請求
- Amazon Bedrock 入門
- Chat Completions API
- Amazon Bedrock 定價
- Grok 4.7 簡介 (SpaceXAI)
作者簡介

Suheel Farooq
Suheel 是 AWS 的首席解決方案架構師,專門研究人工智能、機器學習和生成式 AI。他協助基礎模型供應商客戶在 AWS 上設計、建置、現代化及擴展 AI/ML 和生成式 AI 工作負載,涵蓋將基礎模型引入 Amazon Bedrock、優化訓練和推理,以及建置 Agentic AI 解決方案。他的經驗涵蓋 AWS 的 AI/ML 和生成式 AI 產品組合,尤其是 Amazon Bedrock、Amazon Bedrock AgentCore 和 Amazon SageMaker AI。閒暇時,Suheel 喜歡健身和遠足。

Anirban Gupta
Anirban 是 AWS 的首席工程師,常駐美國西雅圖,專注設計安全且可大規模擴展的 Amazon Bedrock 模型服務基礎設施。他主導了平台上多個基礎模型推出背後的技術工作。加入 Amazon Bedrock 之前,他曾任 AWS Outposts 首席工程師,負責建置混合式內部部署雲端基礎設施。

James Wang
James 是 SpaceXAI 的資深產品增長經理。他曾任 Cerebras 產品市場總監,負責推出 Cerebras Inference 和 CS-3 AI 加速器。在此之前,James 是 ARK Invest 的首席 AI 分析師。他在 NVIDIA 展開職業生涯,於深度學習發展初期推出首批支援 CUDA 的 GPU。

Ikenna Izugbokwe
Ikenna 是 AWS 的首席解決方案架構師,專門研究網絡、容器和 AI 基礎設施。他協助模型供應商擴展訓練和推理系統,同時支援在 AWS 上快速部署不斷演進的前沿模型。他的工作日益涵蓋 Agentic AI,包括建置可靠且具成本效益的多代理系統,以及支援這些系統在生產環境運行的推理基礎設施。
來源:AWS Machine Learning Blog · aws.amazon.com