Hugging Face 示範如何訓練個人化程式碼助手 HugCoder
Personal Copilot: Train Your Own Coding Assistant
Hugging Face 示範以其 GitHub 組織內按 stargazers 排名前 10 的公開程式碼庫,微調 StarCoder 製作個人化程式碼助手 HugCoder。
文章示範以 Hugging Face 公開程式碼庫微調個人化程式碼助手,並對照 QLoRA 與全量微調的成本和 HumanEval 結果,呈現訓練資源與表現的取捨。
在不斷演變的程式設計和軟件開發領域,追求效率和生產力帶來了不少創新,其中之一就是 Codex、StarCoder 和 Code Llama 等程式碼生成模型的出現。這些模型展現出生成近似人類編寫程式碼片段的出色能力,因此作為程式設計助理,潛力巨大。
不過,這些預訓練模型雖然能在各種任務上表現出色,前方還有一個令人振奮的可能性:按照你的特定需求調整程式碼生成模型。想像一下,可在企業規模部署的個人化程式設計助理。
本文會介紹我們如何建立 HugCoder 🤗,這是一個以 huggingface GitHub 組織公開儲存庫中的程式碼內容微調的程式碼 LLM。我們會討論資料收集流程、訓練實驗和一些有趣的結果,讓你能以自己的專有程式碼庫建立個人 Copilot,並介紹幾種可供進一步實驗的延伸方向。
開始吧 🚀
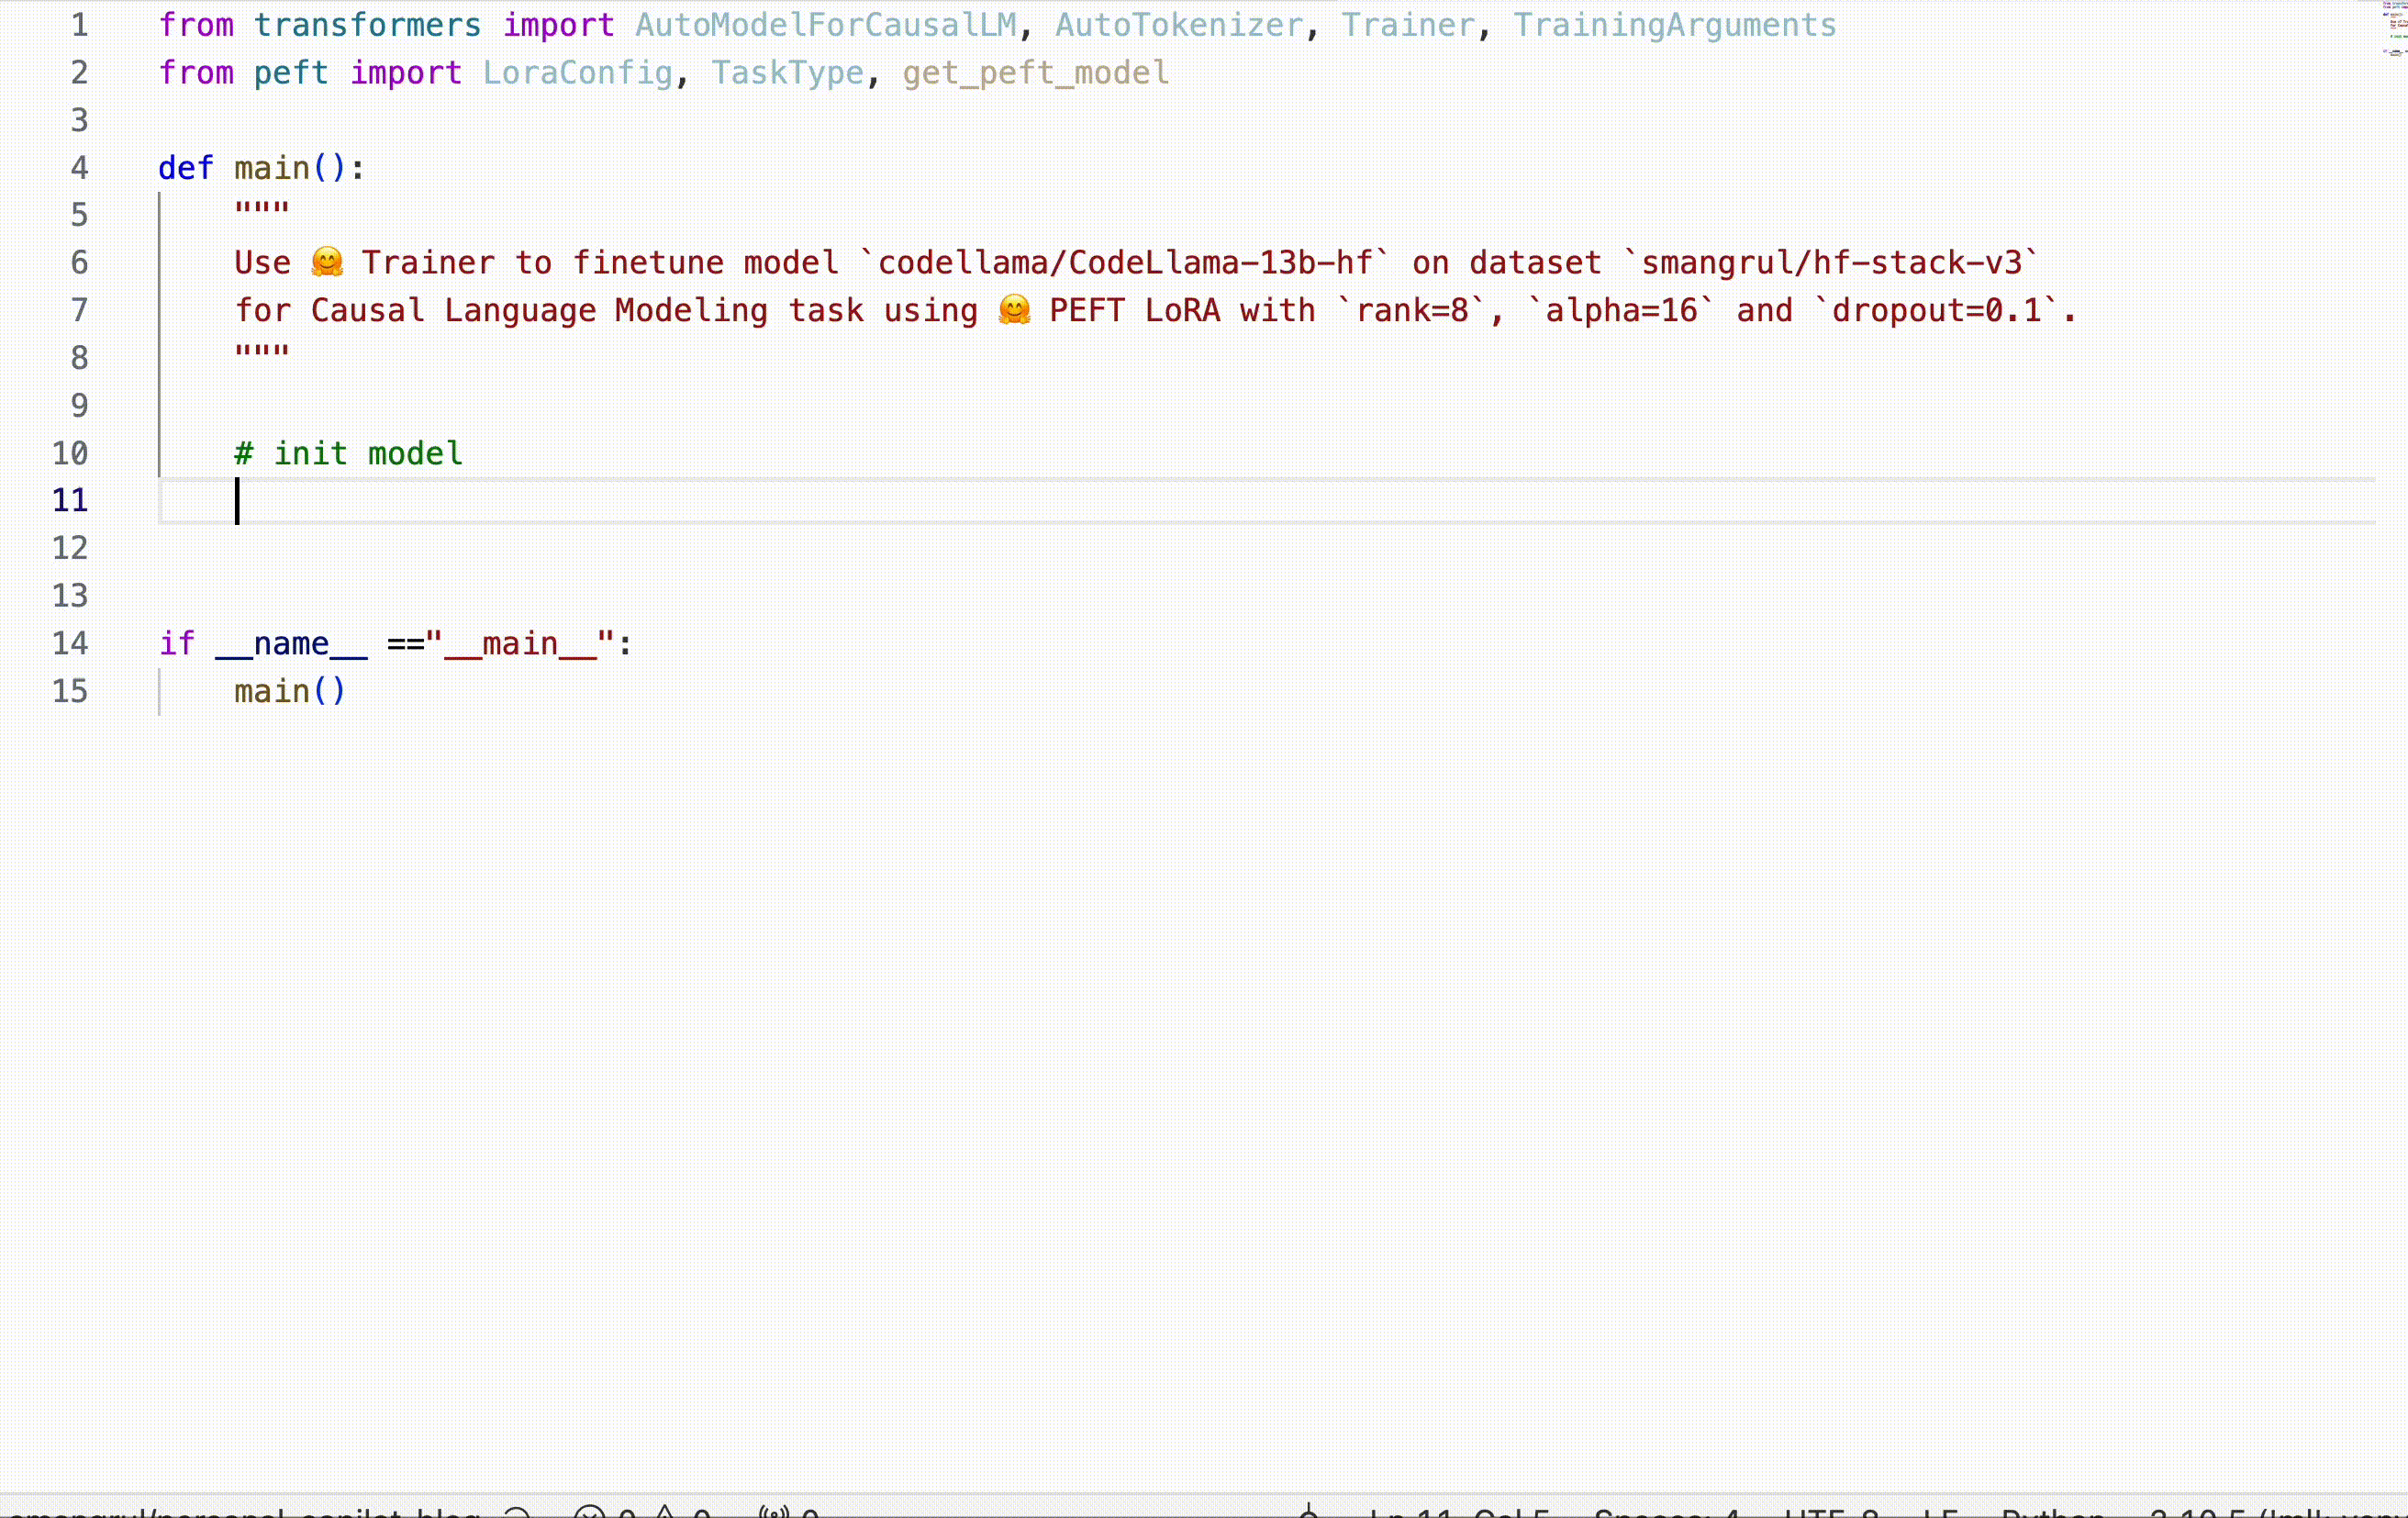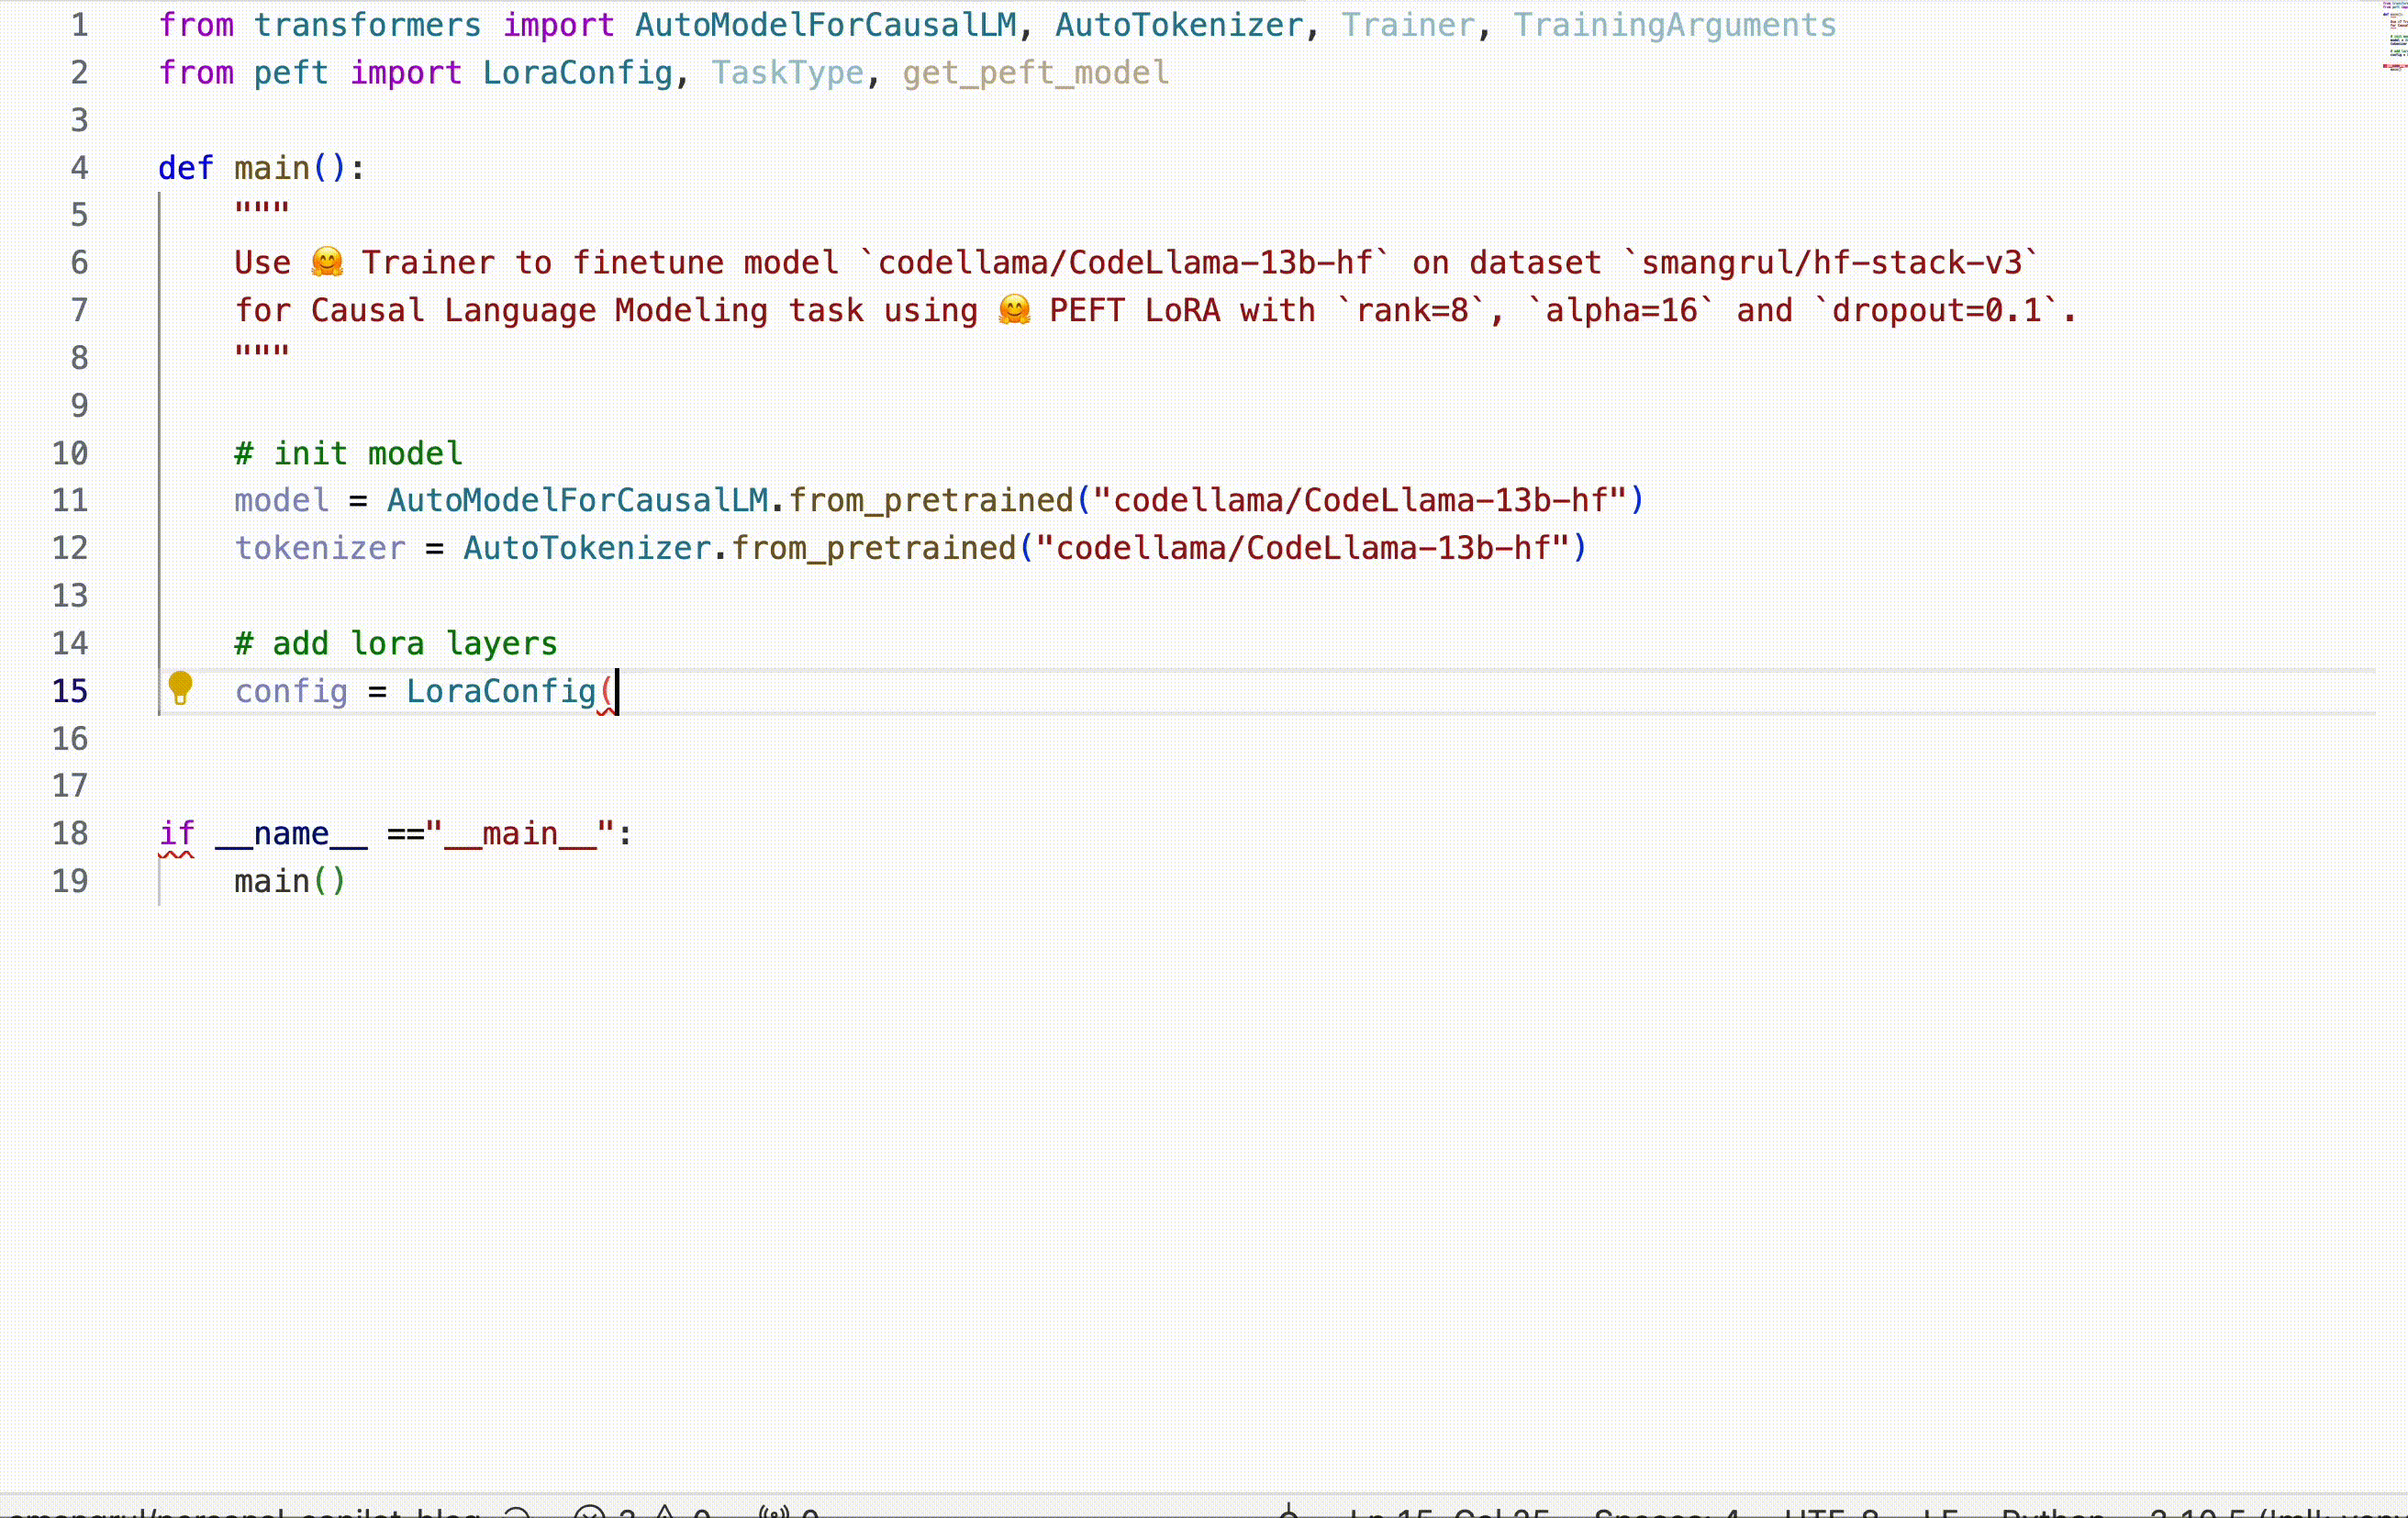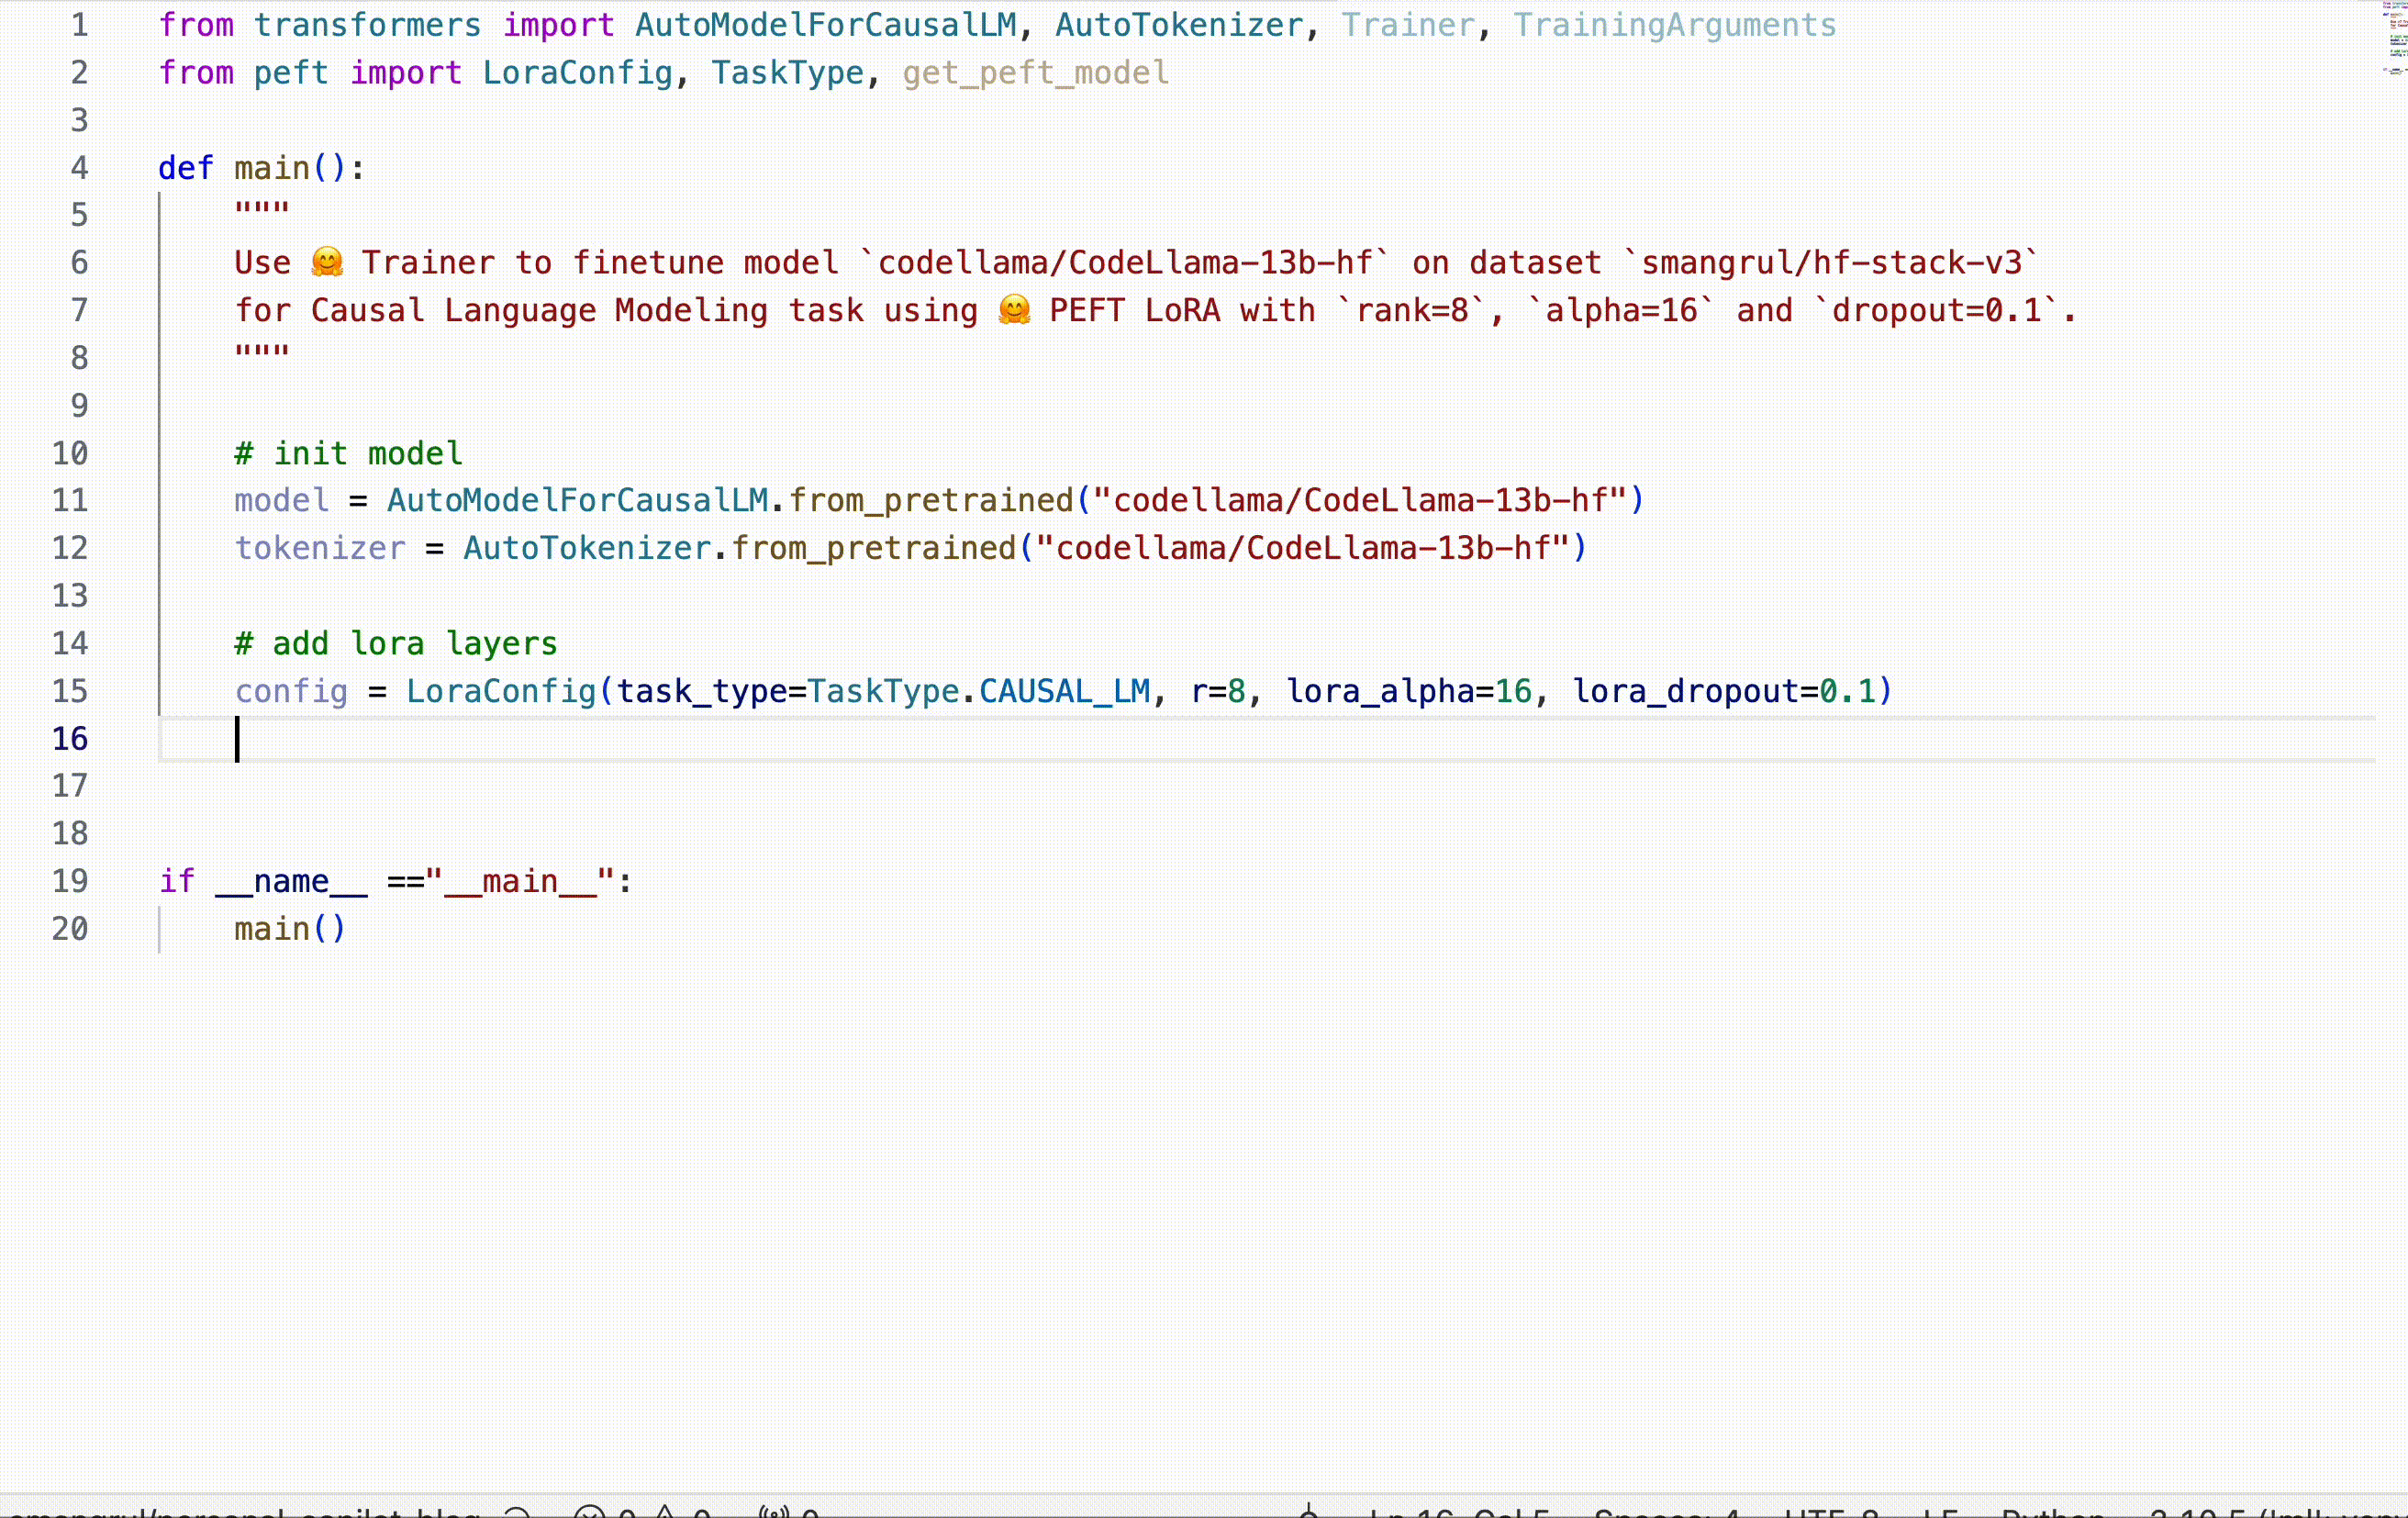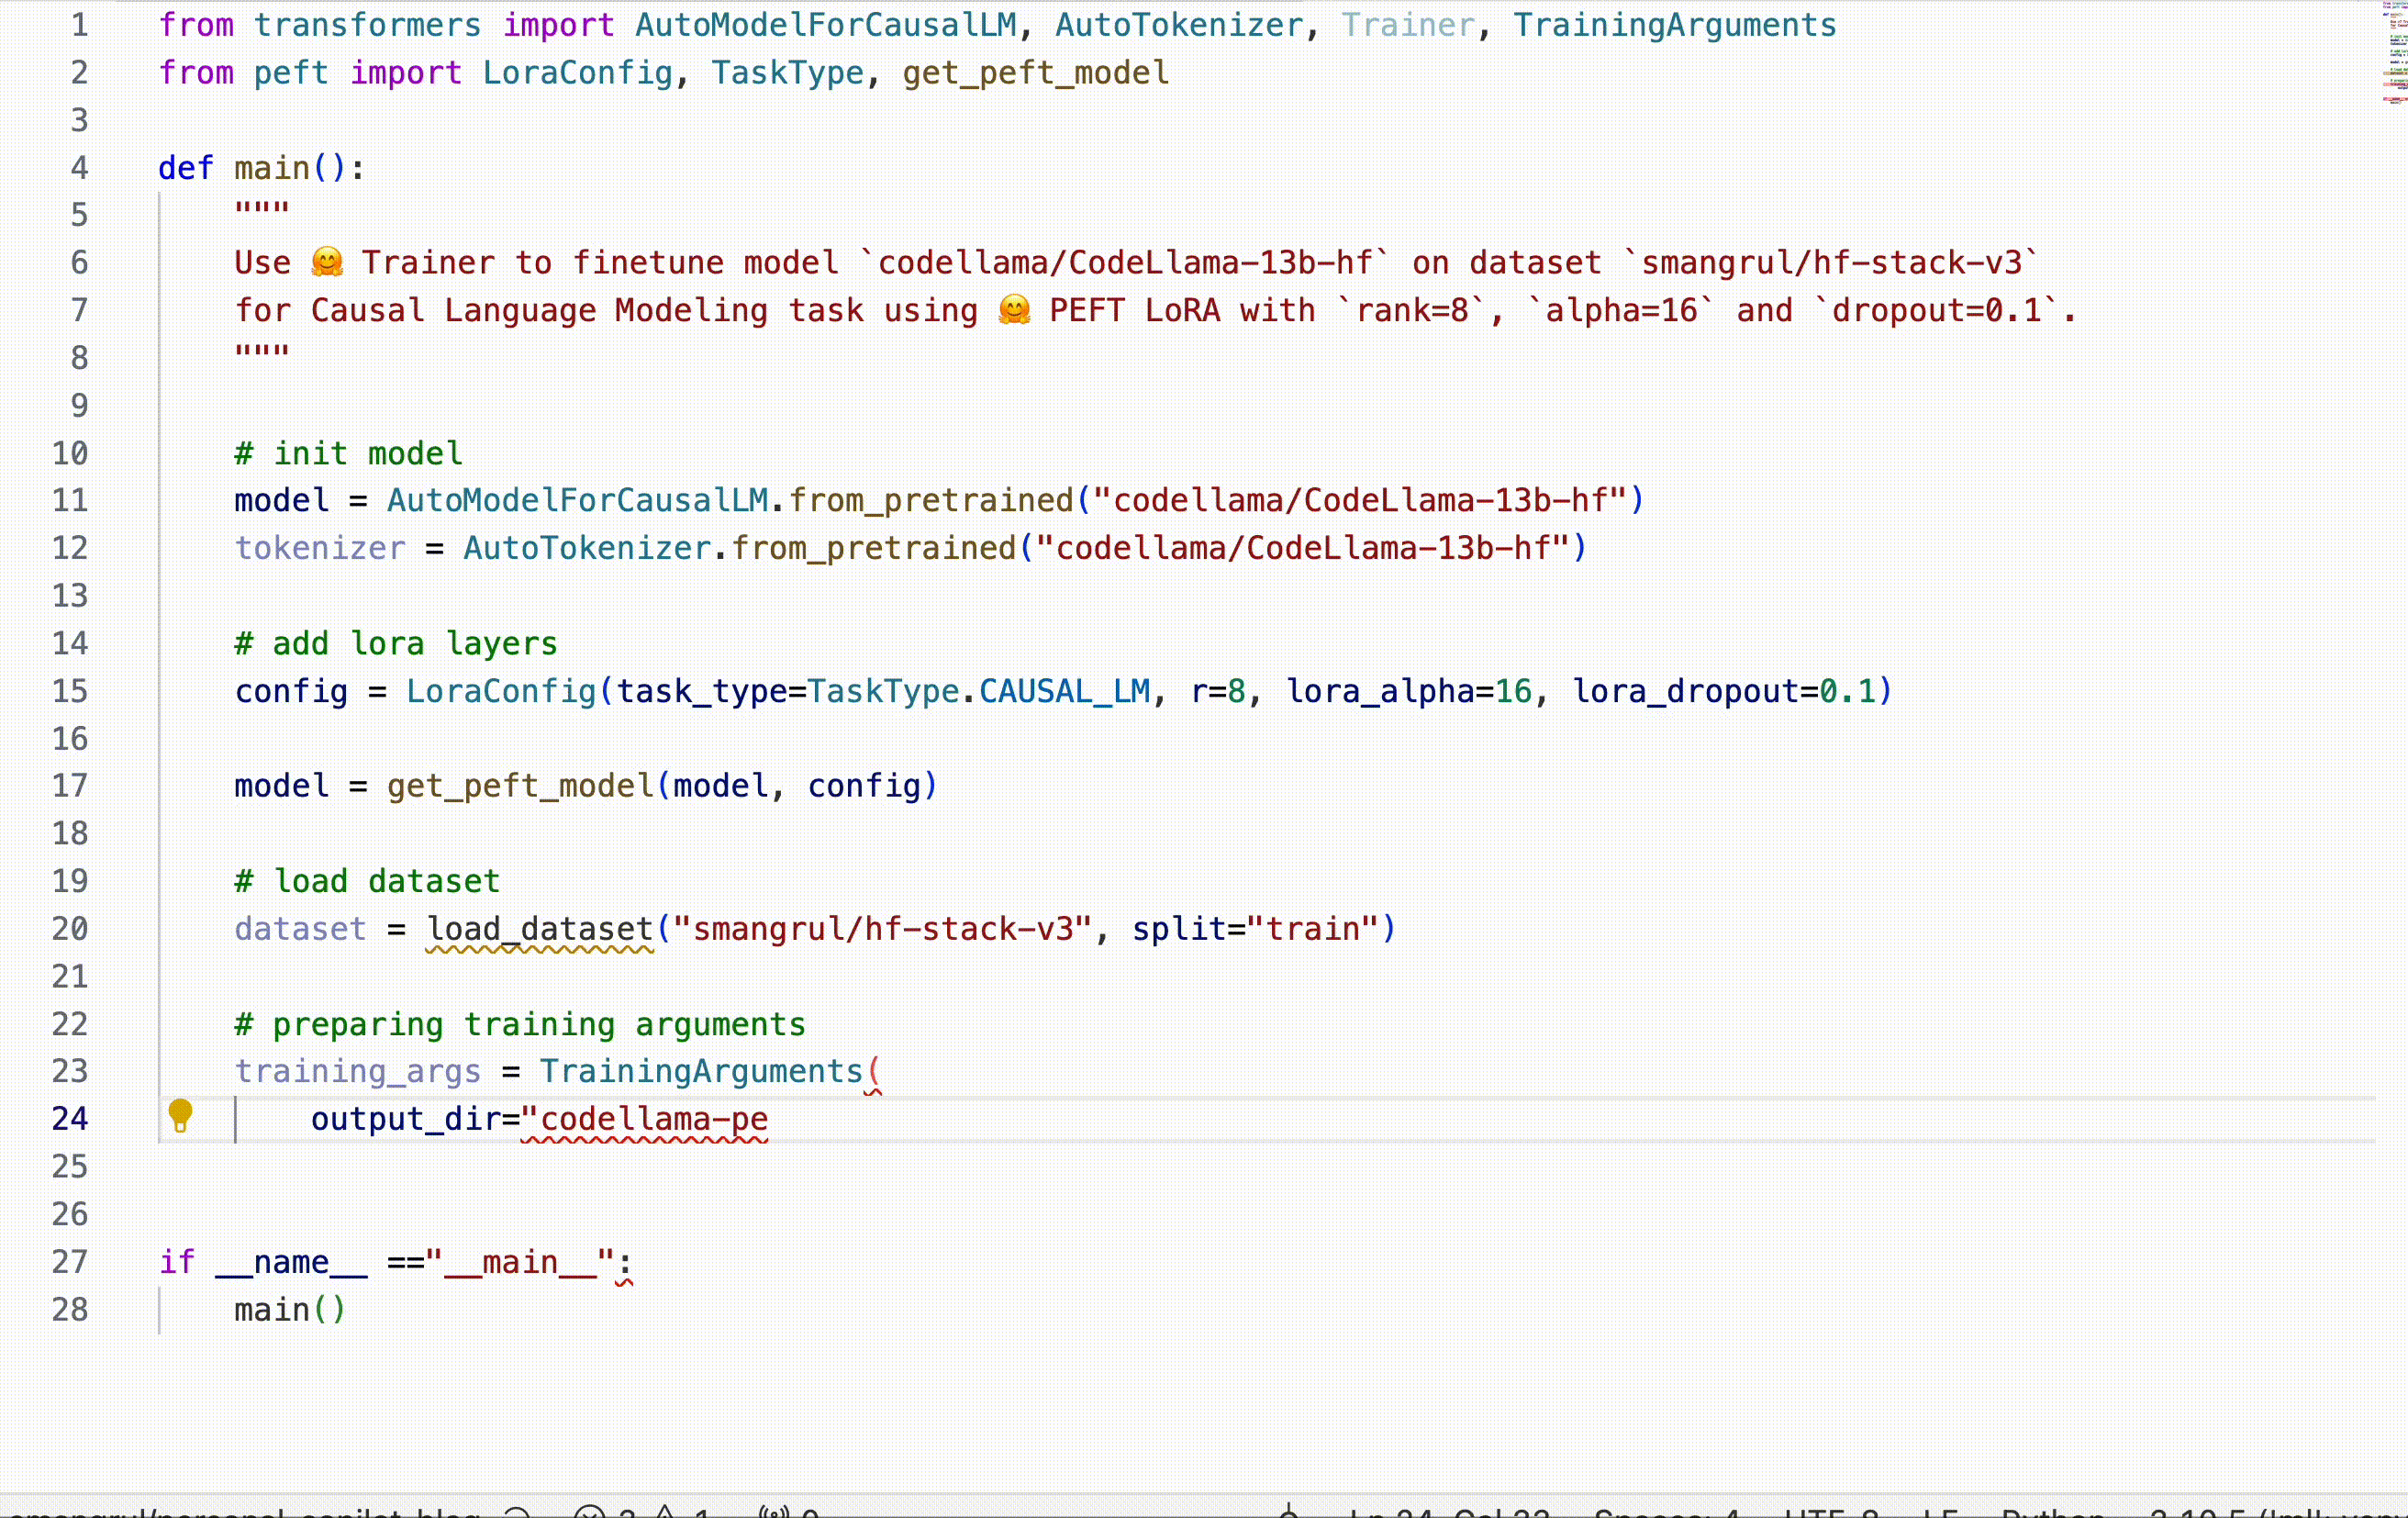
資料收集流程
我們想要的資料集概念上很簡單,結構如下:
| 儲存庫名稱 | 儲存庫中的檔案路徑 | 檔案內容 |
| --- | --- | --- |
| --- | --- | --- |
使用 Python GitHub API 擷取 GitHub 程式碼內容相當直接。不過,視乎儲存庫數量以及每個儲存庫中的程式碼檔案數目,很容易遇到 API 速率限制。
為避免這類問題,我們決定把所有公開儲存庫 clone 到本機,再從中擷取內容,而不透過 API 取得。我們使用 Python 的 multiprocessing 模組平行下載所有 repo,詳見下載指令碼。
儲存庫通常會包含圖片、簡報和其他資產等非程式碼檔案,我們不打算擷取這些內容。我們建立了副檔名清單,用來篩除這些檔案。解析 Jupyter Notebook 以外的程式碼檔案時,我們直接使用「utf-8」編碼;至於 Notebook,只會採用其中的程式碼 cell。
我們也排除了所有與程式碼無直接關係的檔案路徑,包括 .git、__pycache__ 和 xcodeproj。
為了以較節省記憶體的方式序列化內容,我們採用分塊處理和 Feather 格式。完整實作請參閲這份指令碼。
最終資料集已上載至 Hub,內容如下:
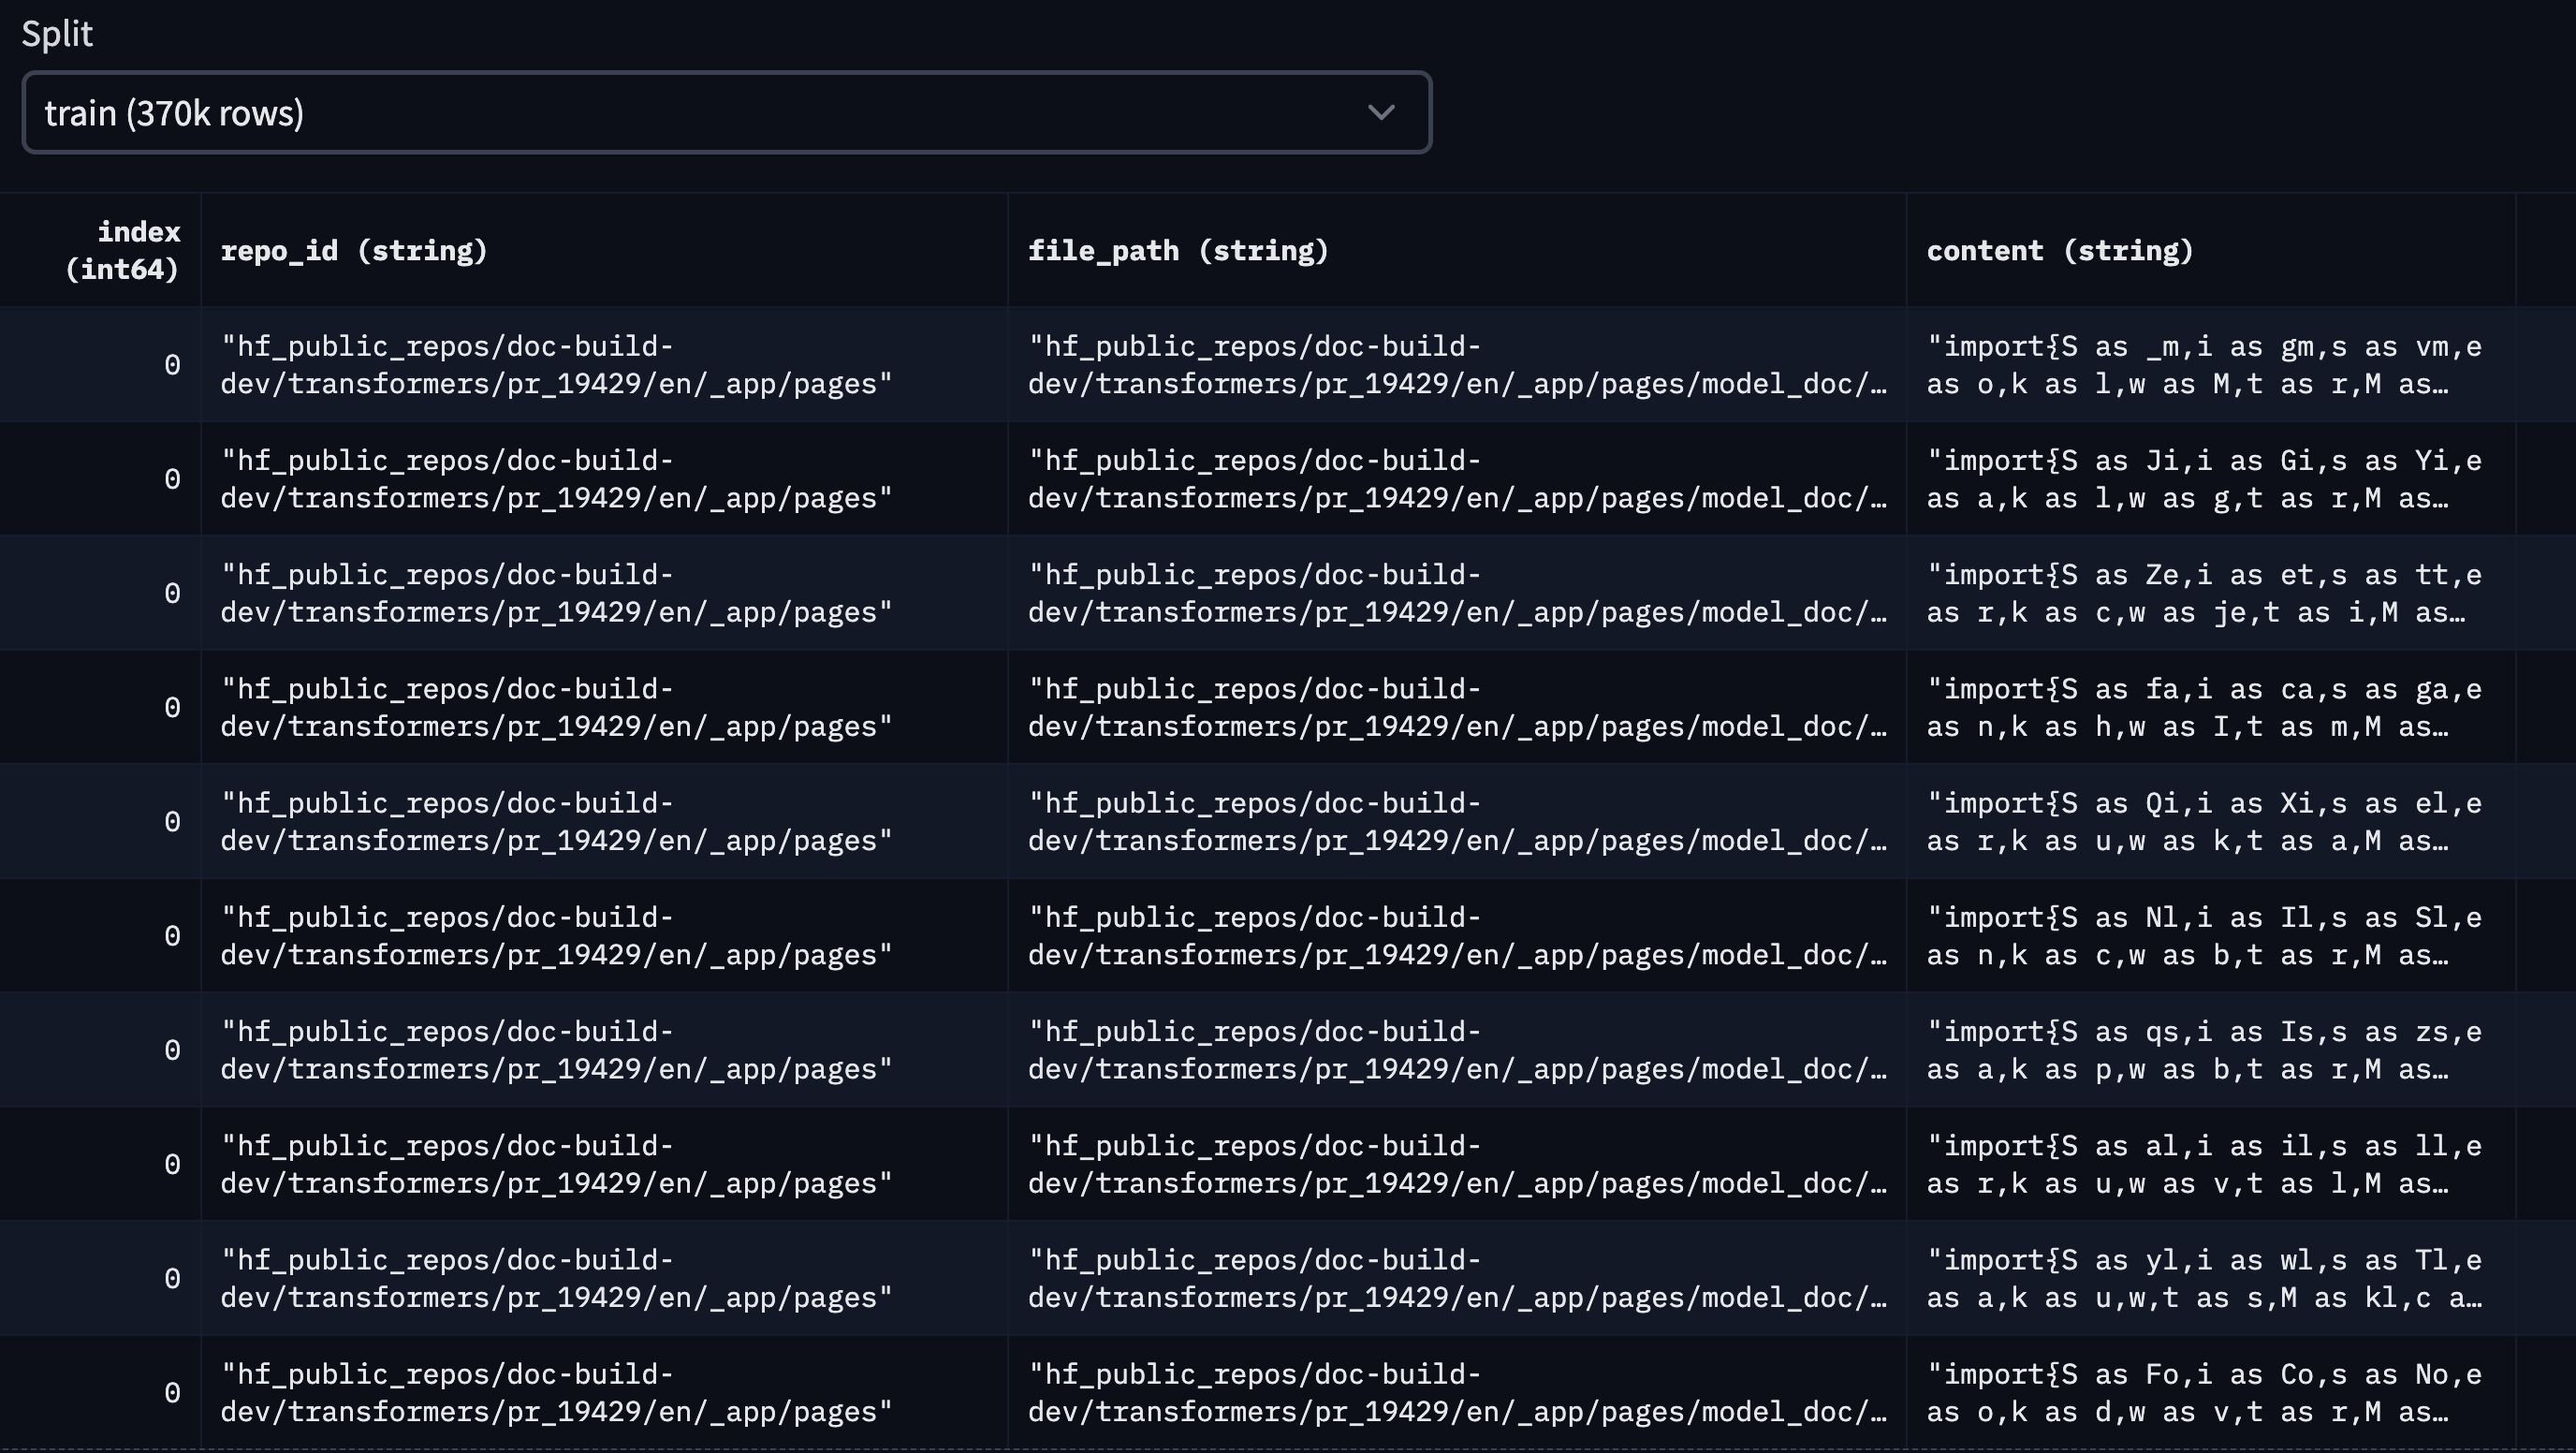
本文會採用 Hugging Face 最受歡迎的 10 個公開儲存庫,按 star 數量排序如下:
['transformers', 'pytorch-image-models', 'datasets', 'diffusers', 'peft', 'tokenizers', 'accelerate', 'text-generation-inference', 'chat-ui', 'deep-rl-class']
這是我們用來生成資料集的程式碼,而這是 Hub 上的資料集。以下是內容快照:
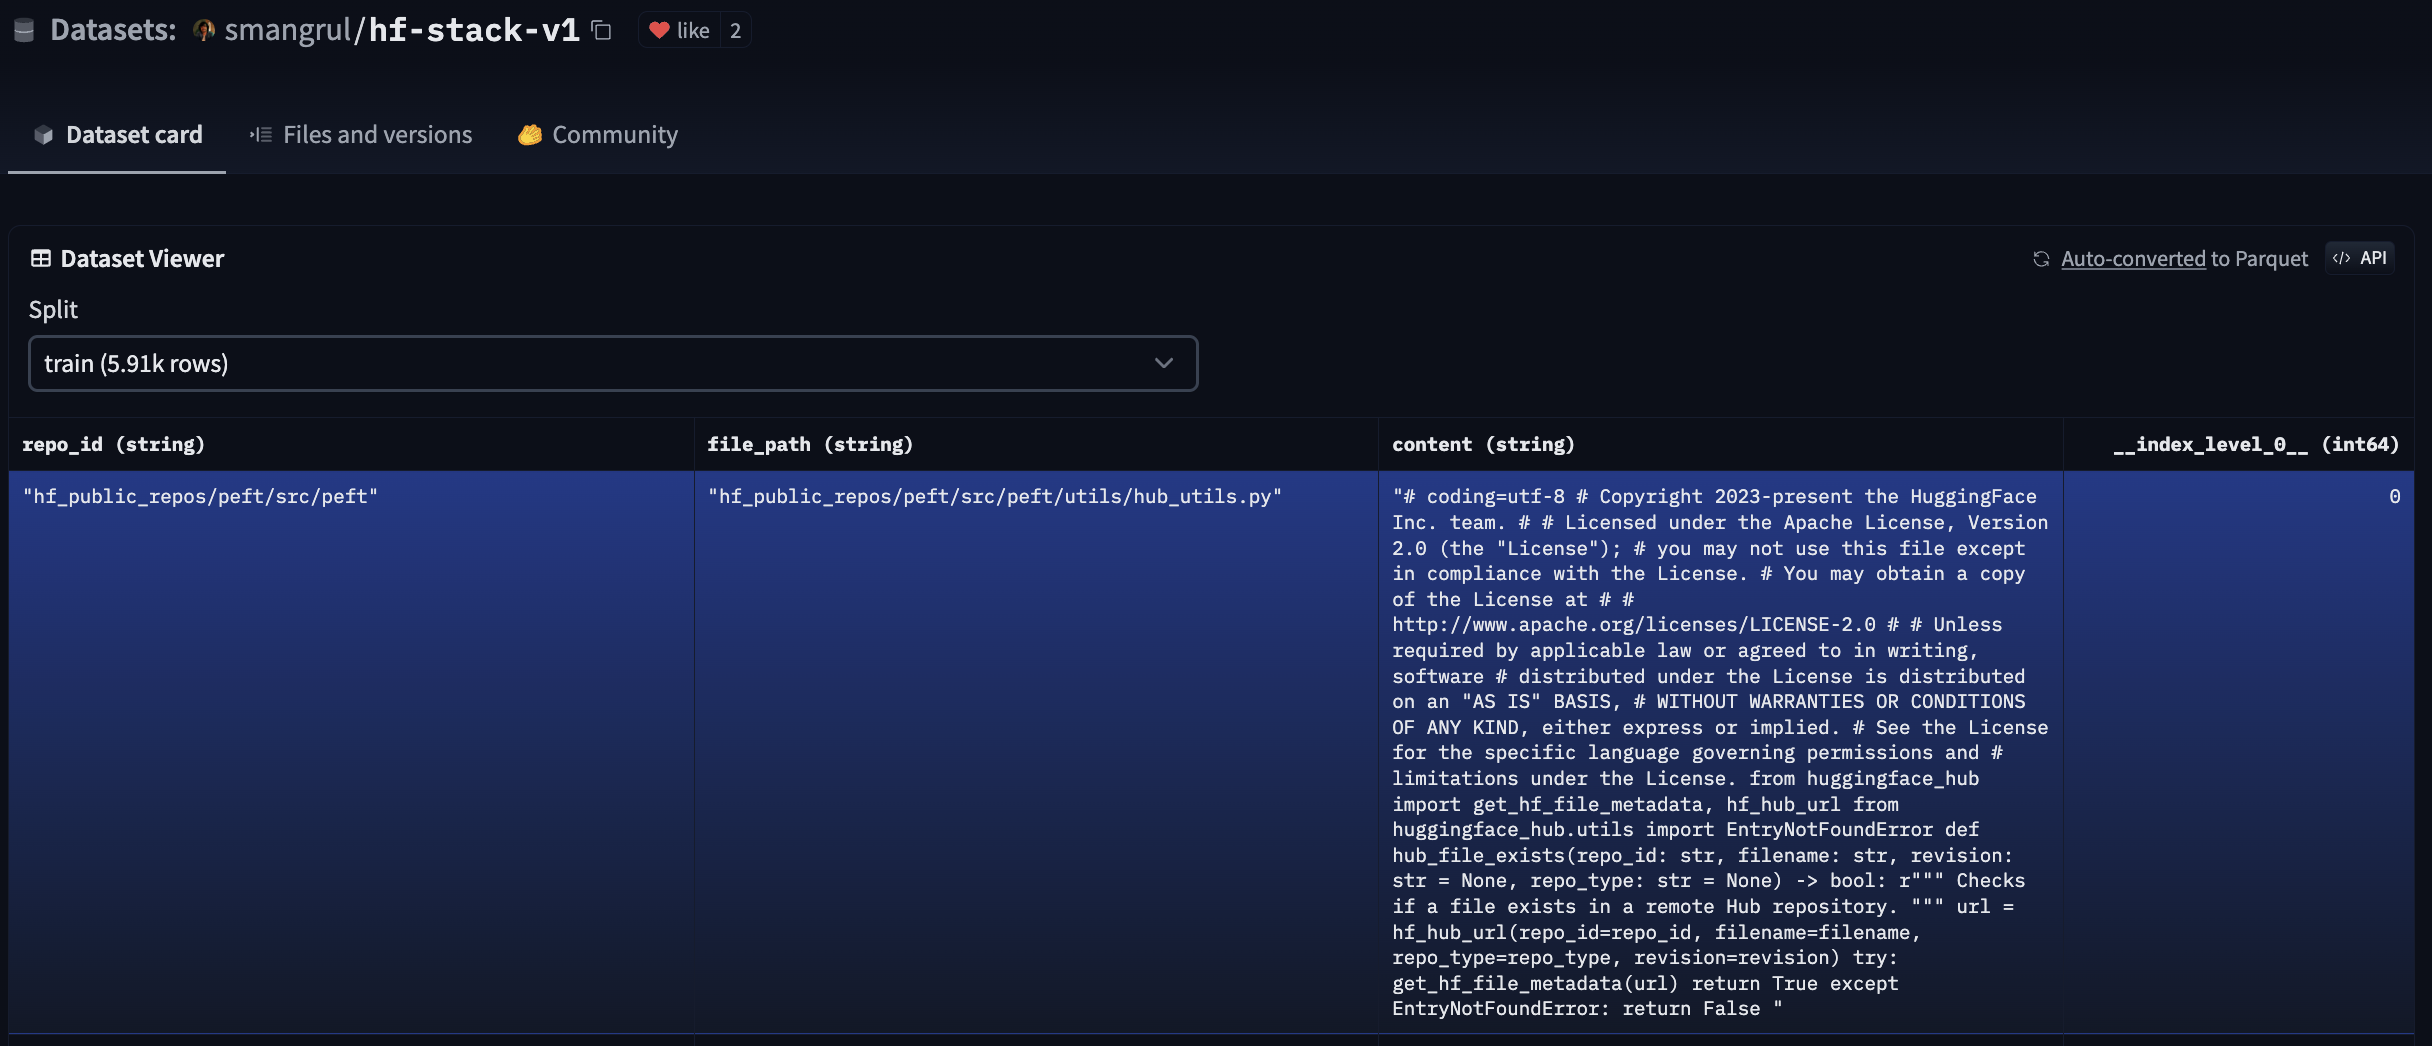
為降低專案複雜度,我們沒有對資料集去重。如果你想在生產應用中採用去重技術,這篇網誌是瞭解程式碼 LLM 去重的絕佳資源。
微調個人 Co-Pilot
本節會微調以下模型:bigcode/starcoder(15.5B 參數)、bigcode/starcoderbase-1b(1B 參數)、Deci/DeciCoder-1b(1B 參數)。所有實驗都會使用 🤗 PEFT(參數高效微調),在單張 A100 40GB GPU 的 Colab Notebook 執行。此外,我們會示範如何在配備 8 張 A100 80GB GPU 的機器上,透過 🤗 Accelerate 的 FSDP 整合完整微調 bigcode/starcoder(15.5B 參數)。訓練目標是中間填補(FIM):把訓練序列的部分內容移到末端,再以自回歸方式預測重新排序後的序列。
為甚麼選 PEFT?完整微調成本很高。以下用一些數字説明:
完整微調所需的最低 GPU 記憶體:
- 權重:2 bytes(混合精度訓練)
- 權重梯度:2 bytes
- 使用 Adam 時的 optimizer state:原始 FP32 權重佔 4 bytes,加上第一和第二動量估算值共 8 bytes
- 以上各項相加後,每個參數的成本為 16 bytes
- 15.5B 模型 -> 248GB GPU 記憶體,尚未計算儲存中間 activation 所需的大量記憶體 -> 至少需要 4 張 A100 80GB GPU
由於硬件需求極高,我們會使用 QLoRA 進行參數高效微調。以下是使用 QLoRA 微調 StarCoder 所需的最低 GPU 記憶體:
trainable params: 110,428,160 || all params: 15,627,884,544 || trainable%: 0.7066097761926236
- 基礎模型權重:0.5 bytes * 15.51B 凍結參數 = 7.755 GB
- Adapter 權重:2 bytes * 0.11B 可訓練參數 = 0.22GB
- 權重梯度:2 bytes * 0.11B 可訓練參數 = 0.12GB
- 使用 Adam 時的 optimizer state:4 bytes * 0.11B 可訓練參數 * 3 = 1.32GB
- 以上相加為 9.51 GB,約 10GB -> 需要 1 張 A100 40GB GPU 🤯。之所以選用 A100 40GB GPU,是因為訓練時 sequence length 為 2048、batch size 為 4,長序列的中間 activation 會提高記憶體需求。下文會看到,GPU 記憶體實際需求為 26GB,可在 A100 40GB GPU 上容納。此外,A100 GPU 對 Flash Attention 2 的相容性較佳。
以上計算沒有包括中間 activation checkpointing 所需的記憶體,而這項需求相當龐大。我們使用 Flash Attention V2 和 Gradient Checkpointing 解決此問題。
- 使用 QLoRA、Flash Attention V2 和 Gradient Checkpointing 時,模型在單張 A100 40GB GPU 上總共佔用26 GB記憶體,batch size 為 4。
- 使用 FSDP 完整微調並配合 Flash Attention V2 和 Gradient Checkpointing 時,每張 GPU 佔用70 GB 至 77.6 GB記憶體,per_gpu_batch_size 為 1。
請參閲 model-memory-usage,輕鬆計算在 🤗 Hugging Face Hub 託管的模型進行訓練和大型模型推論所需的 vRAM。
完整微調
我們會使用 PyTorch Fully Sharded Data Parallel(FSDP)技術,在 8 張 A100 80GB GPU 上完整微調 bigcode/starcoder(15B 參數)。FSDP 詳情請參閲使用 PyTorch FSDP 微調 Llama 2 70B及透過 PyTorch Fully Sharded Data Parallel 和 Accelerate 訓練大型模型。
資源
- 程式碼庫:連結。使用 Transformers 最近加入的 Flash Attention V2 支援。
- FSDP 配置:fsdp_config.yaml
- 模型:bigcode/stacoder
- 資料集:smangrul/hf-stack-v1
- 微調後的模型:smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab
啟動訓練的指令見 run_fsdp.sh。
accelerate launch --config_file "configs/fsdp_config.yaml"  train.py \
    --model_path "bigcode/starcoder" \
    --dataset_name "smangrul/hf-stack-v1" \
    --subset "data" \
    --data_column "content" \
    --split "train" \
    --seq_length 2048 \
    --max_steps 2000 \
    --batch_size 1 \
    --gradient_accumulation_steps 2 \
    --learning_rate 5e-5 \
    --lr_scheduler_type "cosine" \
    --weight_decay 0.01 \
    --num_warmup_steps 30 \
    --eval_freq 100 \
    --save_freq 500 \
    --log_freq 25 \
    --num_workers 4 \
    --bf16 \
    --no_fp16 \
    --output_dir "starcoder-personal-copilot-A100-40GB-colab" \
    --fim_rate 0.5 \
    --fim_spm_rate 0.5 \
    --use_flash_attn
總訓練時間為9 小時。按 lambdalabs 對 8 張 A100 80GB GPU 收取每小時 $12.00 計算,總成本為$108。
PEFT
我們會示範如何透過 🤗 PEFT,在單張 A100 40GB GPU 上使用 QLoRA 微調 bigcode/starcoder(15B 參數)。QLoRA 和 PEFT 方法的詳情,請參閲使用 bitsandbytes、4-bit 量化和 QLoRA,讓 LLM 更普及及🤗 PEFT:在資源有限的硬件上高效微調十億級模型。
資源
- 程式碼庫:連結。使用 Transformers 最近加入的 Flash Attention V2 支援。
- Colab Notebook:連結。記得選擇 A100 GPU 和 High RAM 設定。
- 模型:bigcode/stacoder
- 資料集:smangrul/hf-stack-v1
- QLoRA 微調模型:smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab
啟動訓練的指令見 run_peft.sh。總訓練時間為12.5 小時。每小時$1.10,按 lambdalabs 價格計算,總成本為$13.75。相當划算 🚀!成本比完整微調低7.8 倍。
比較
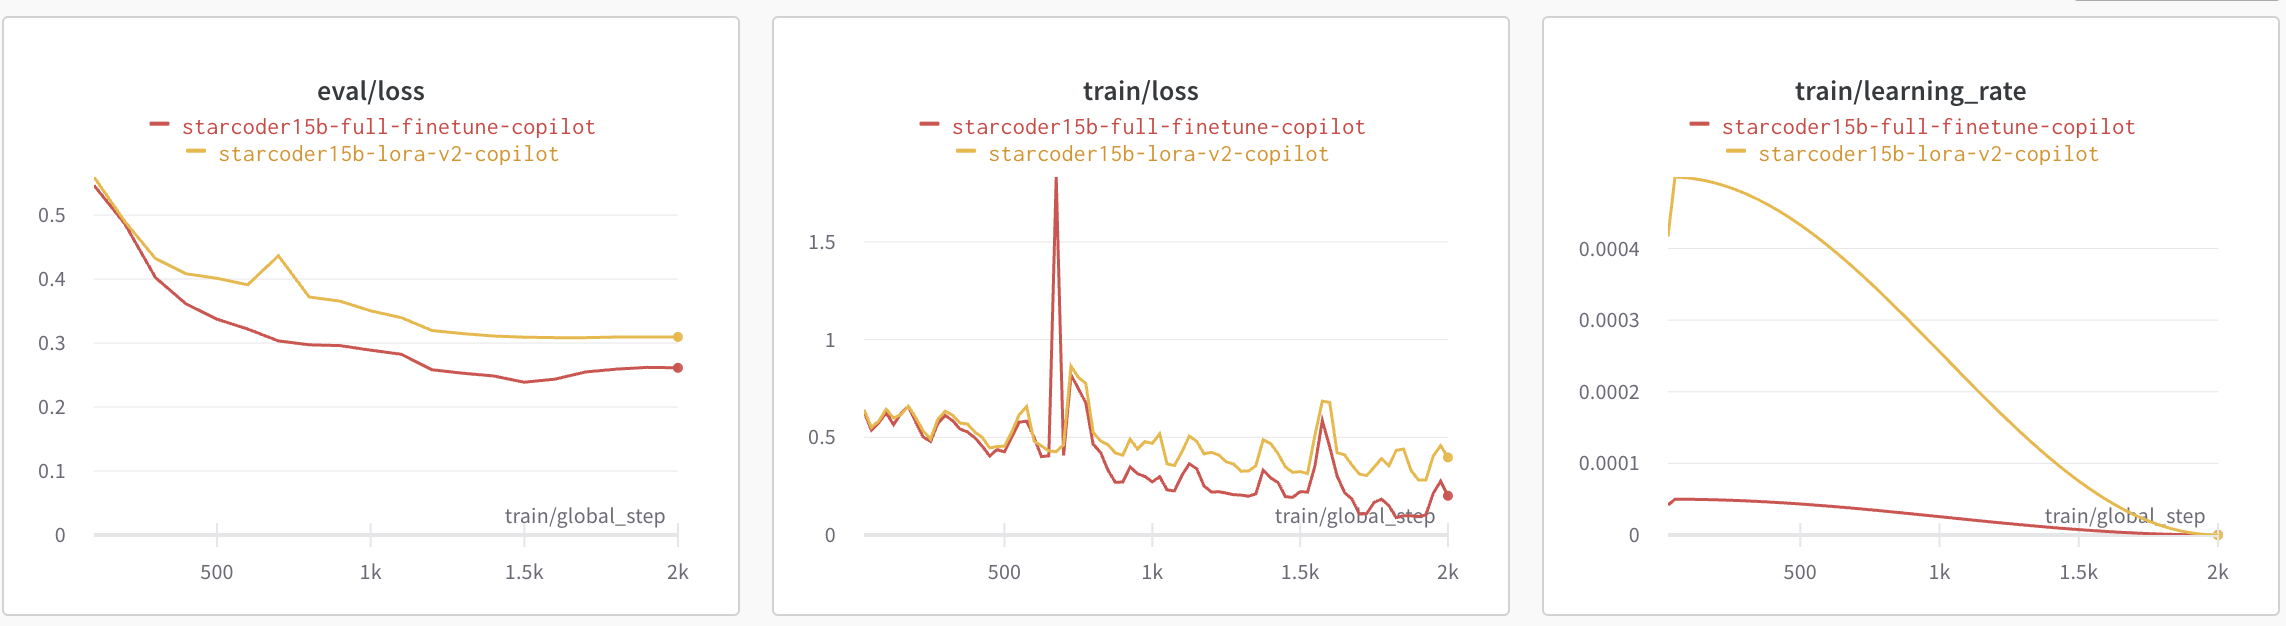
下圖比較 QLoRA 和完整微調的評估 loss、訓練 loss 及 learning rate scheduler。我們觀察到完整微調的 loss 稍低,收斂速度也略快於 QLoRA。PEFT 微調所用的 learning rate 是完整微調的 10 倍。
為確保 QLoRA 模型沒有造成災難性遺忘,我們在模型上執行 Python Human Eval。以下是結果。Pass@1 代表每道題只考慮一個生成程式碼候選時的通過率。可以看到,在 humaneval-python 上,基礎模型 bigcode/starcoder(15B 參數)和微調後的 PEFT 模型 smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab 表現相若。
| 模型 | Pass@1 |
| bigcode/starcoder | 33.57 |
| smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab | 33.37 |
現在來看看一些質化範例。手動分析時,我們注意到 QLoRA 有輕微過度擬合,因此透過 PEFT 的 add_weighted_adapter 工具,建立權重為 0.8 的新加權 adapter,以降低其影響。
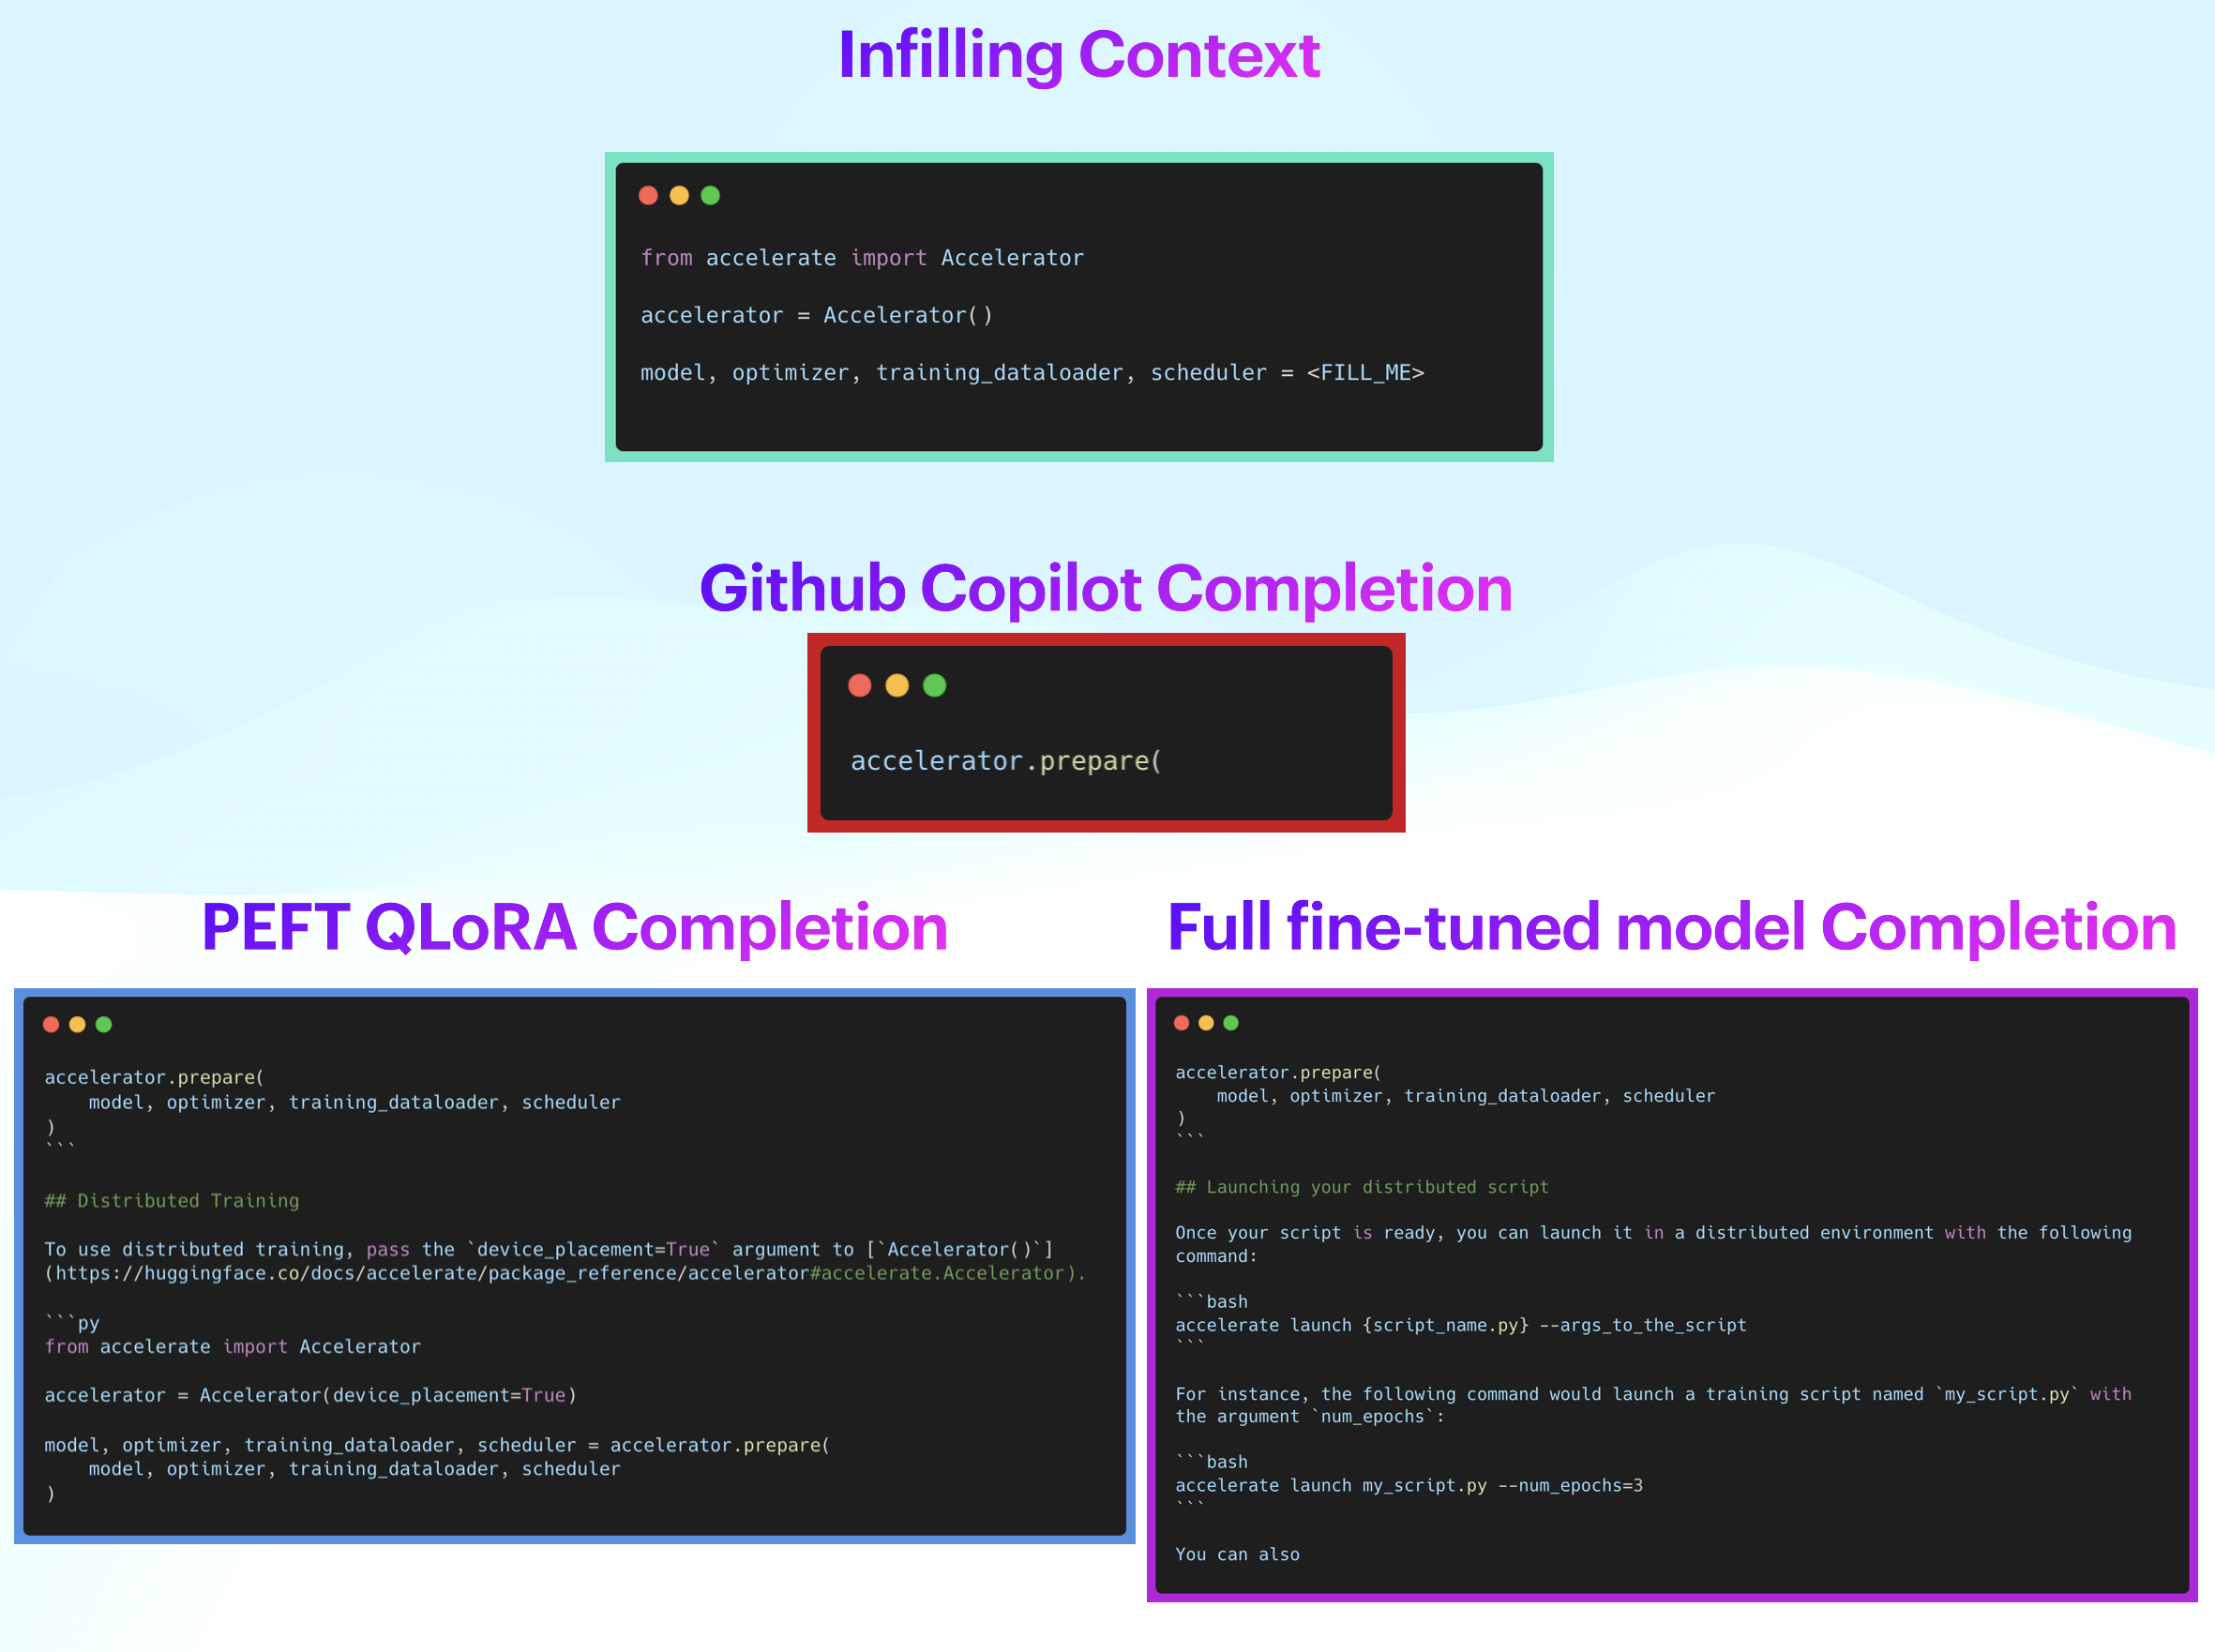
以下會看 2 個程式碼補全例子,模型的任務是補上 <FILL_ME> 佔位符所代表的部分。我們會比較 GitHub Copilot、QLoRA 微調模型和完整微調模型生成的補全文字。
 質化比較例子 1
在上面的例子中,GitHub Copilot 的補全方向正確,但幫助不大。QLoRA 和完整微調模型則能正確補上整個函式呼叫及所需參數,但之後也生成了不少雜訊。可透過後處理限制補全內容,只保留至右括號或換行符為止。請注意,QLoRA 和完整微調模型生成的品質相若。
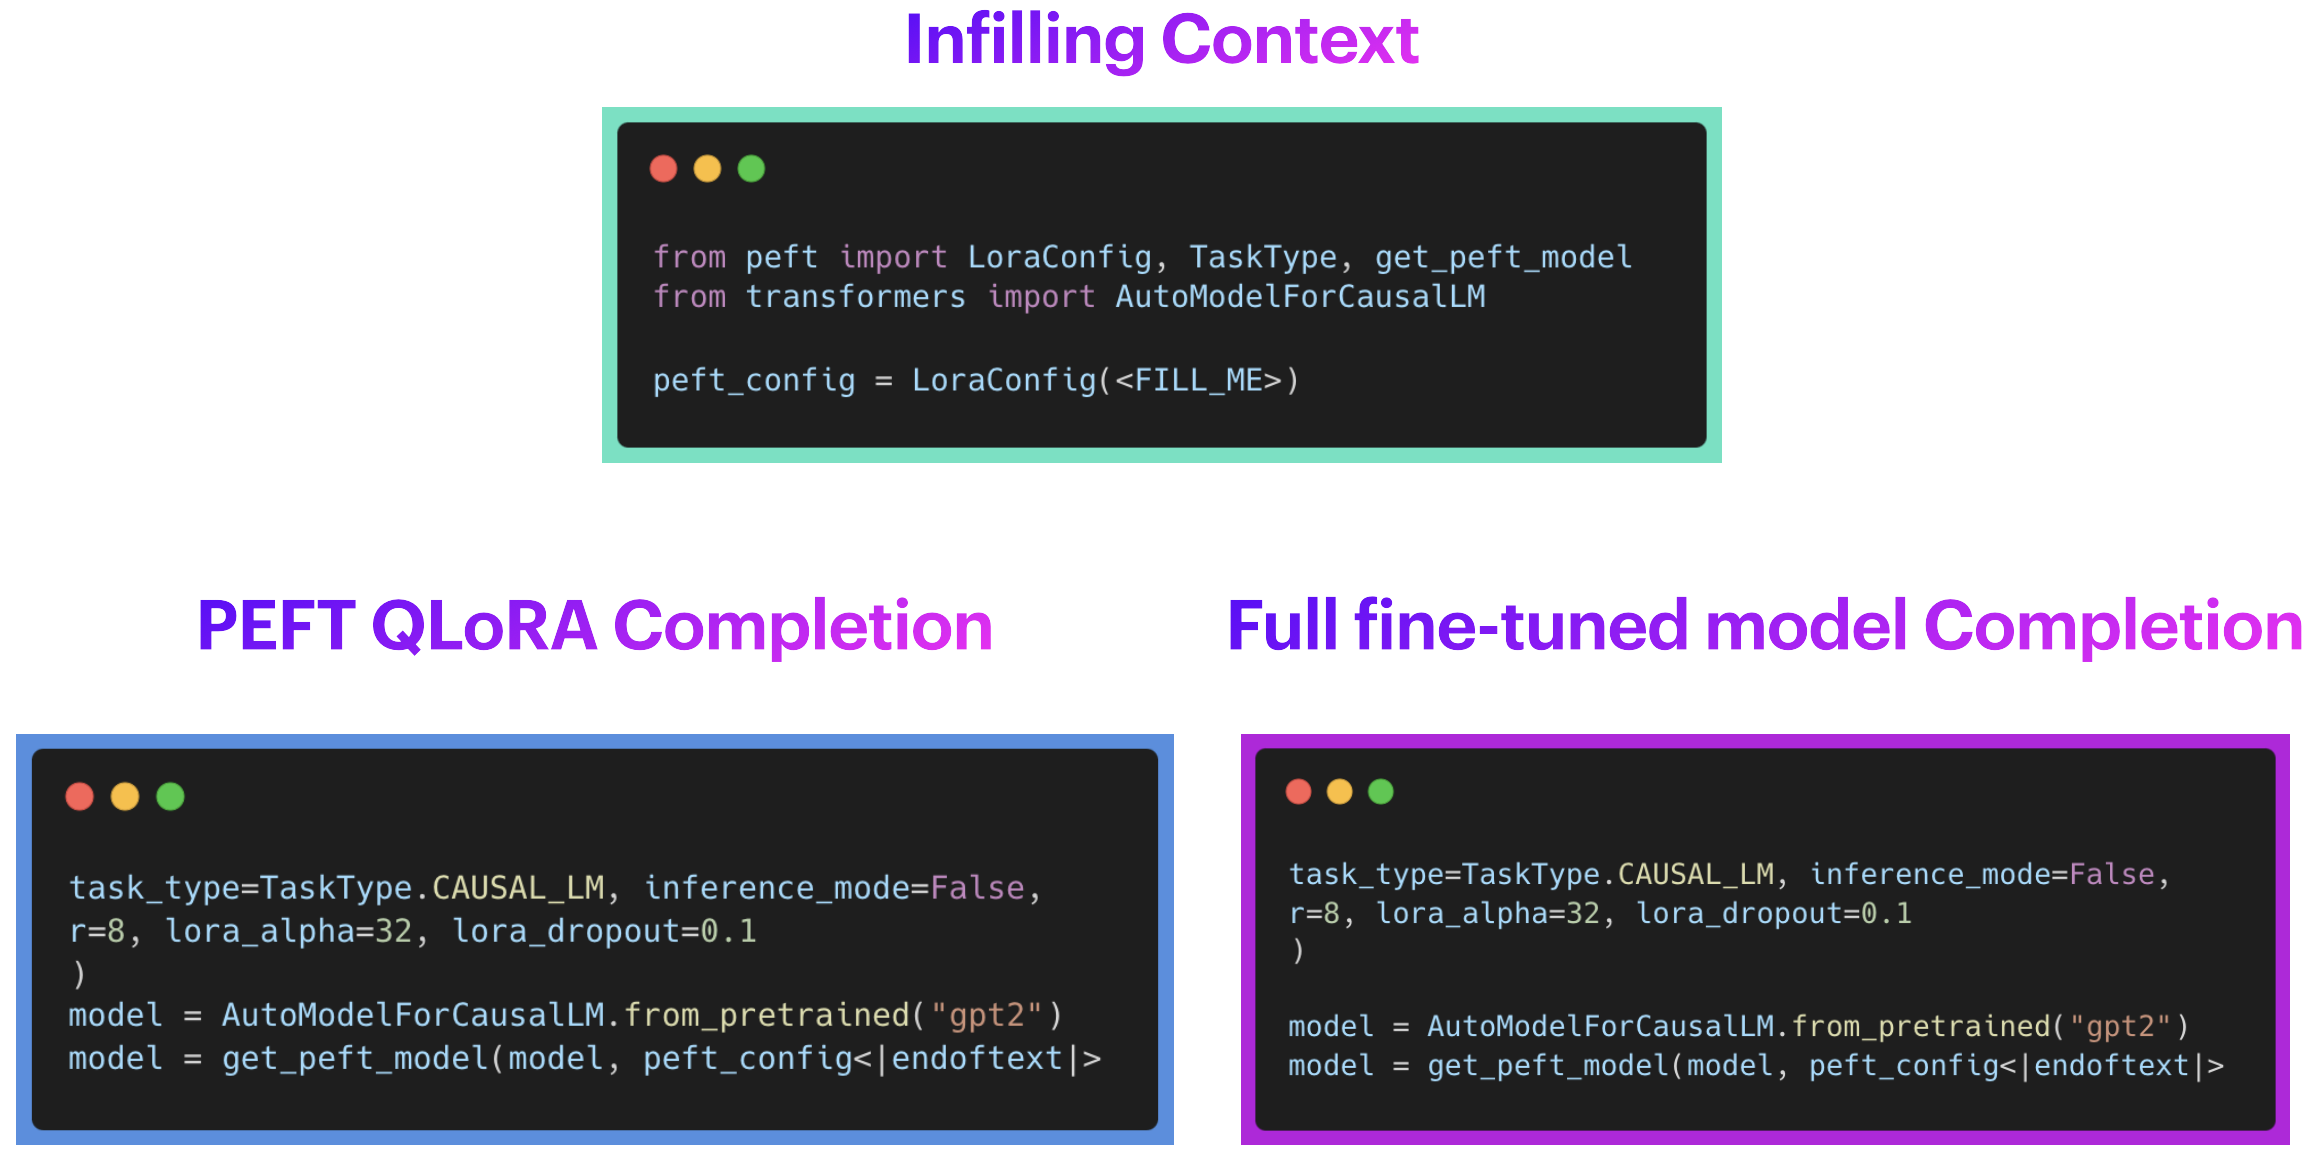 質化比較例子 2
在上方第二個例子中,GitHub Copilot 沒有提供任何補全內容。可能是因為 🤗 PEFT 是近期推出的函式庫,尚未包含在 Copilot 的訓練資料中;這正是我們希望解決的問題。另一方面,QLoRA 和完整微調模型都能正確補上整個函式呼叫及所需參數。再次提醒,兩者生成的品質相若。完整微調模型和 PEFT 模型的推論程式碼及多個範例,分別見 Full_Finetuned_StarCoder_Inference.ipynb 和 PEFT_StarCoder_Inference.ipynb。
由此可見,兩種版本生成的內容都符合預期。太好了!🚀
如何在 VS Code 使用?
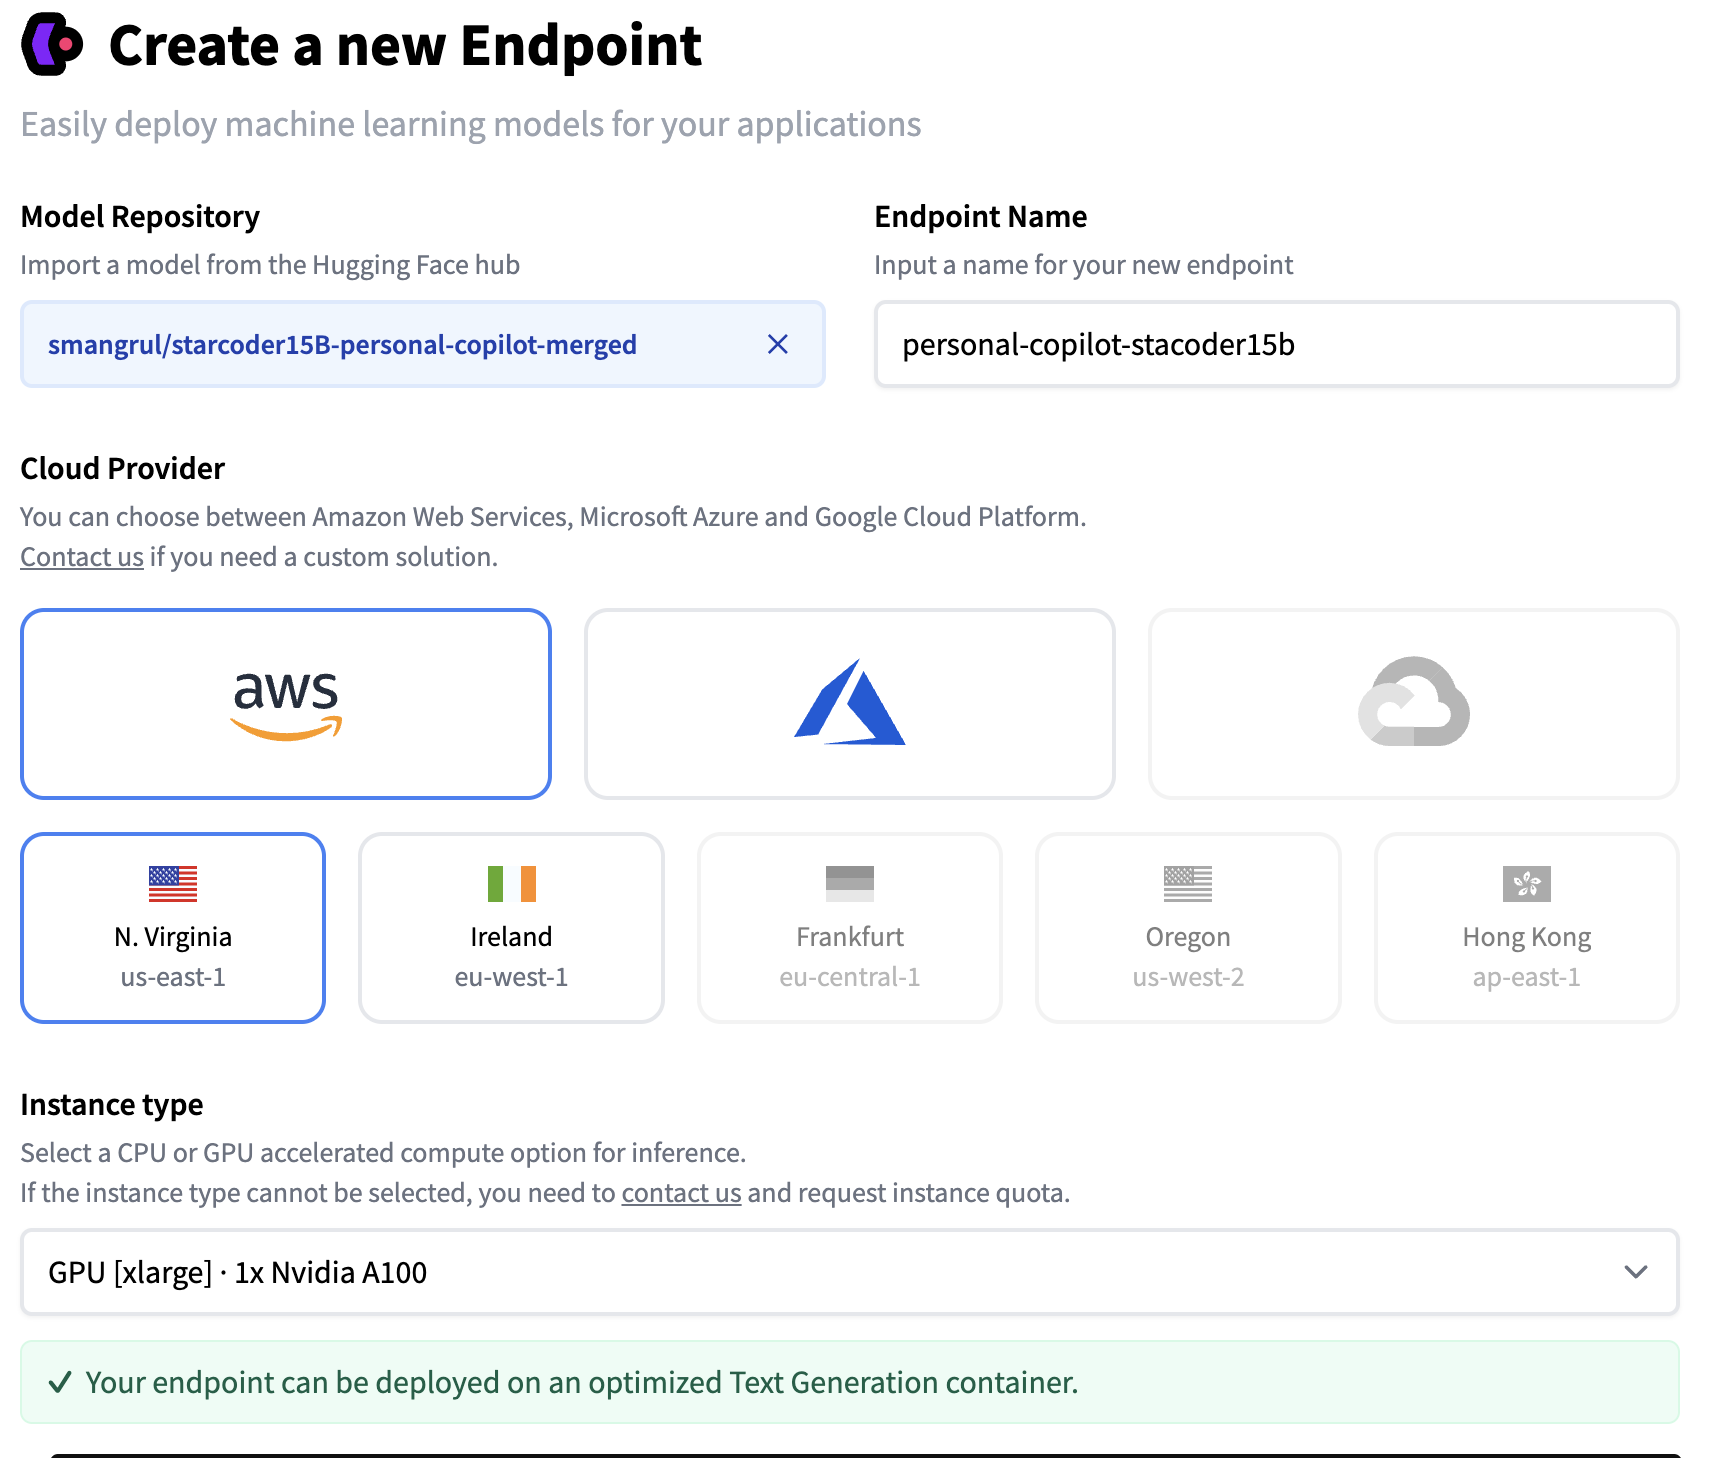
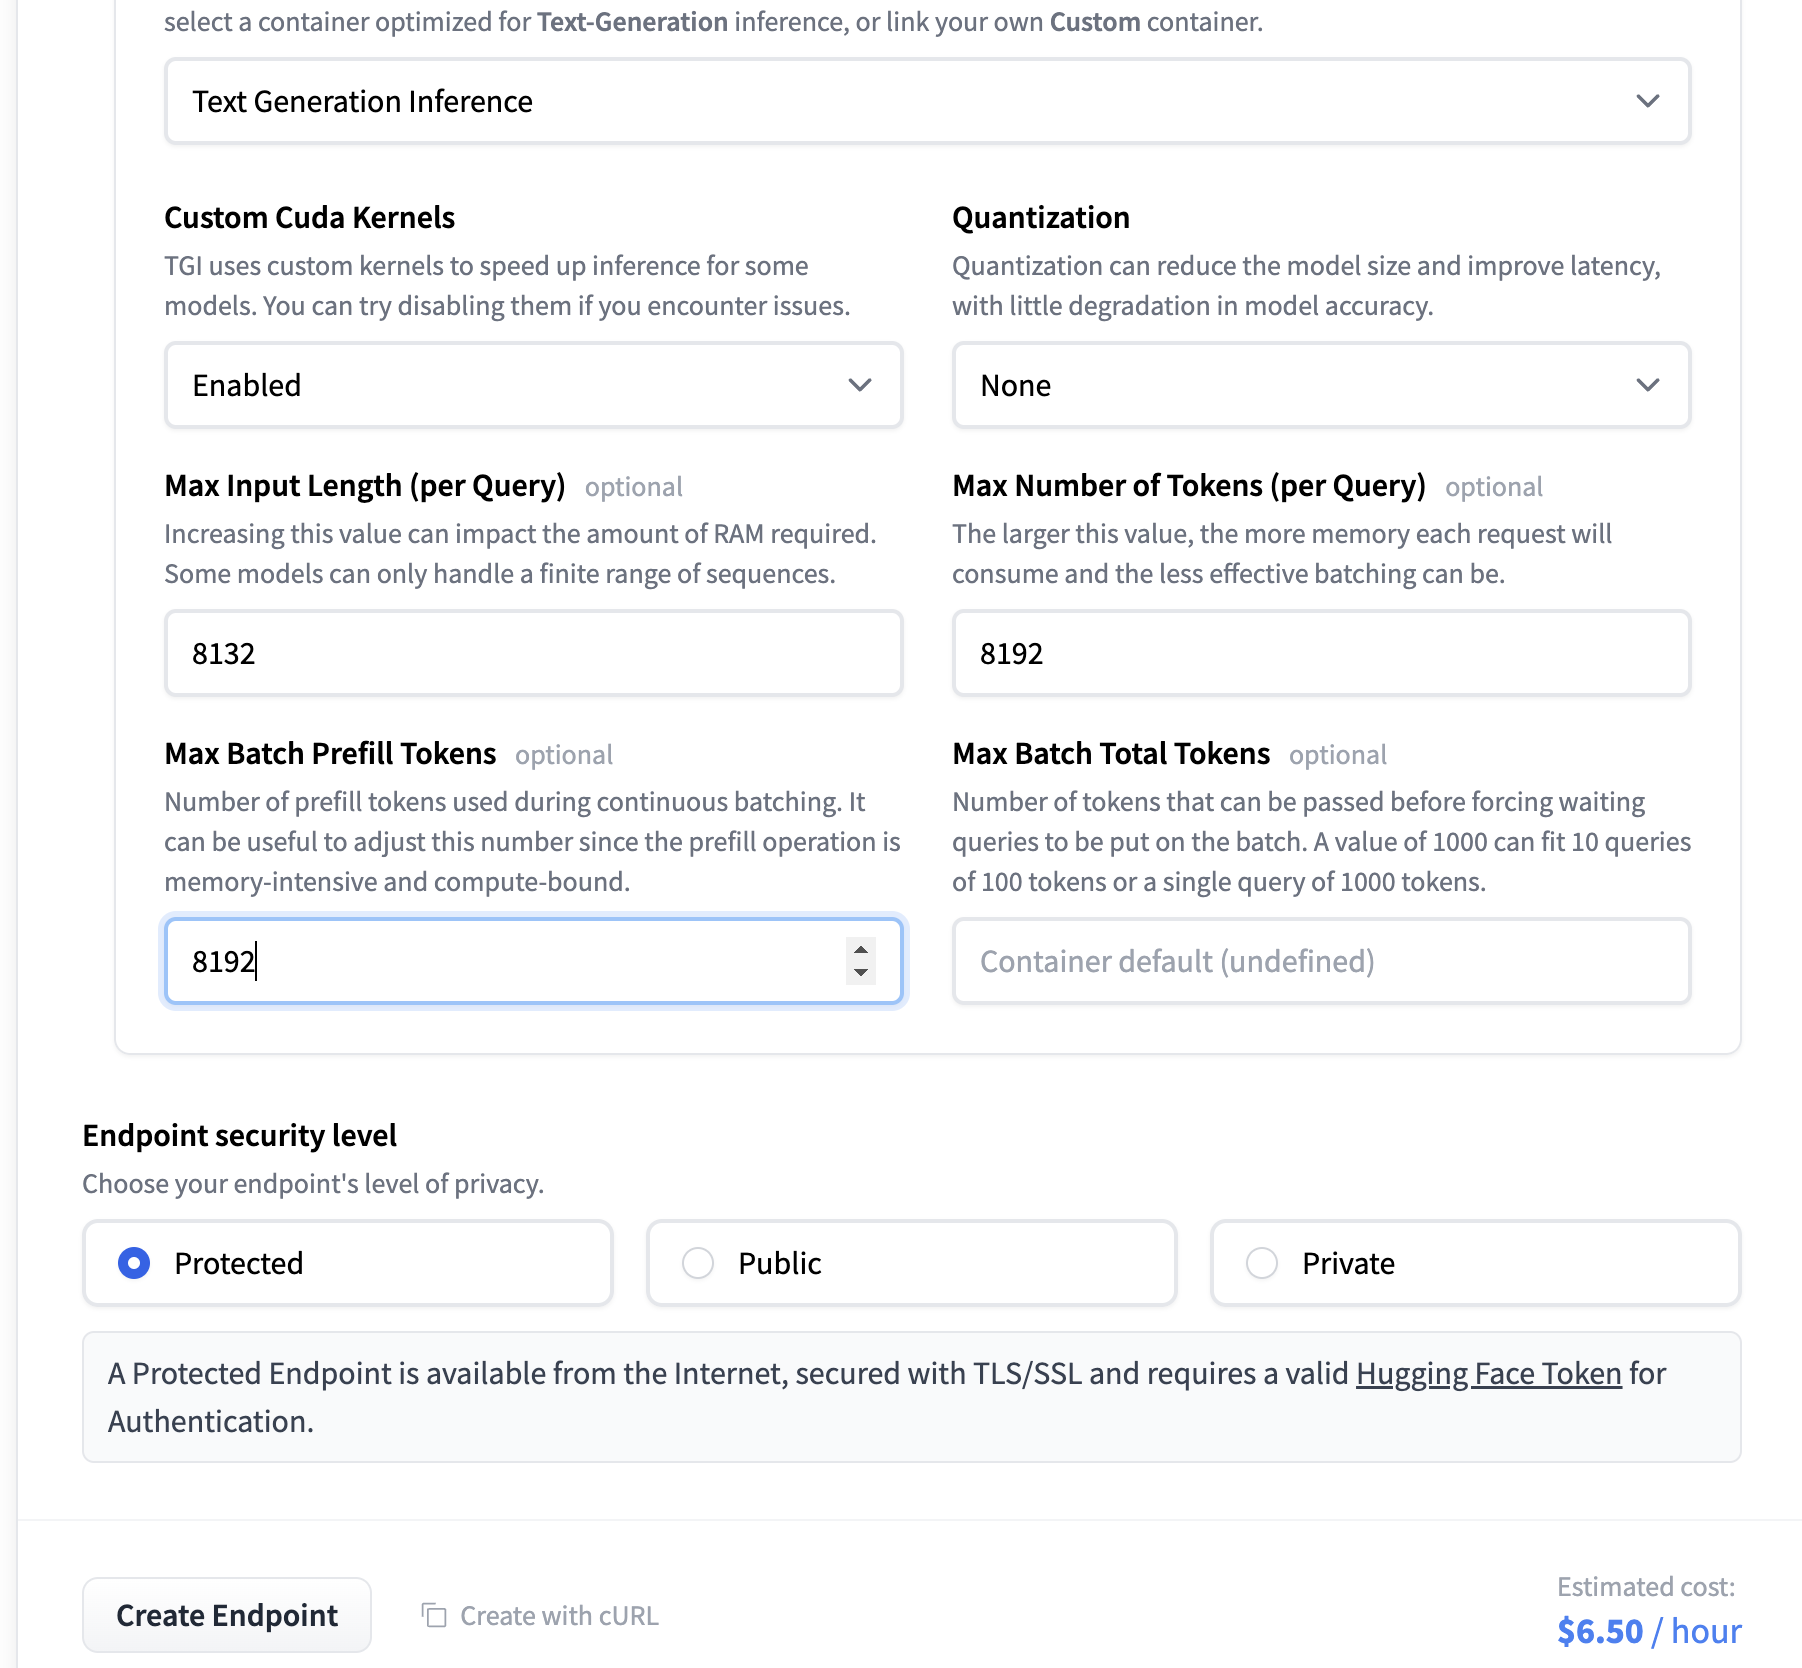
你可以透過 🤗 llm-vscode VS Code 擴充功能,配合以 🤗 Inference Endpoints 託管的模型,輕鬆設定自訂程式碼補全 LLM。以下會逐步介紹所需操作。部署 endpoint 的詳情請參閲Inference Endpoints 文件。
設定 Inference Endpoint
以下截圖展示建立自訂 Inference Endpoint 的步驟。我們使用 QLoRA 模型,並匯出為完整大小的合併模型,方便透過 transformers 載入。
設定 VS Code 擴充功能
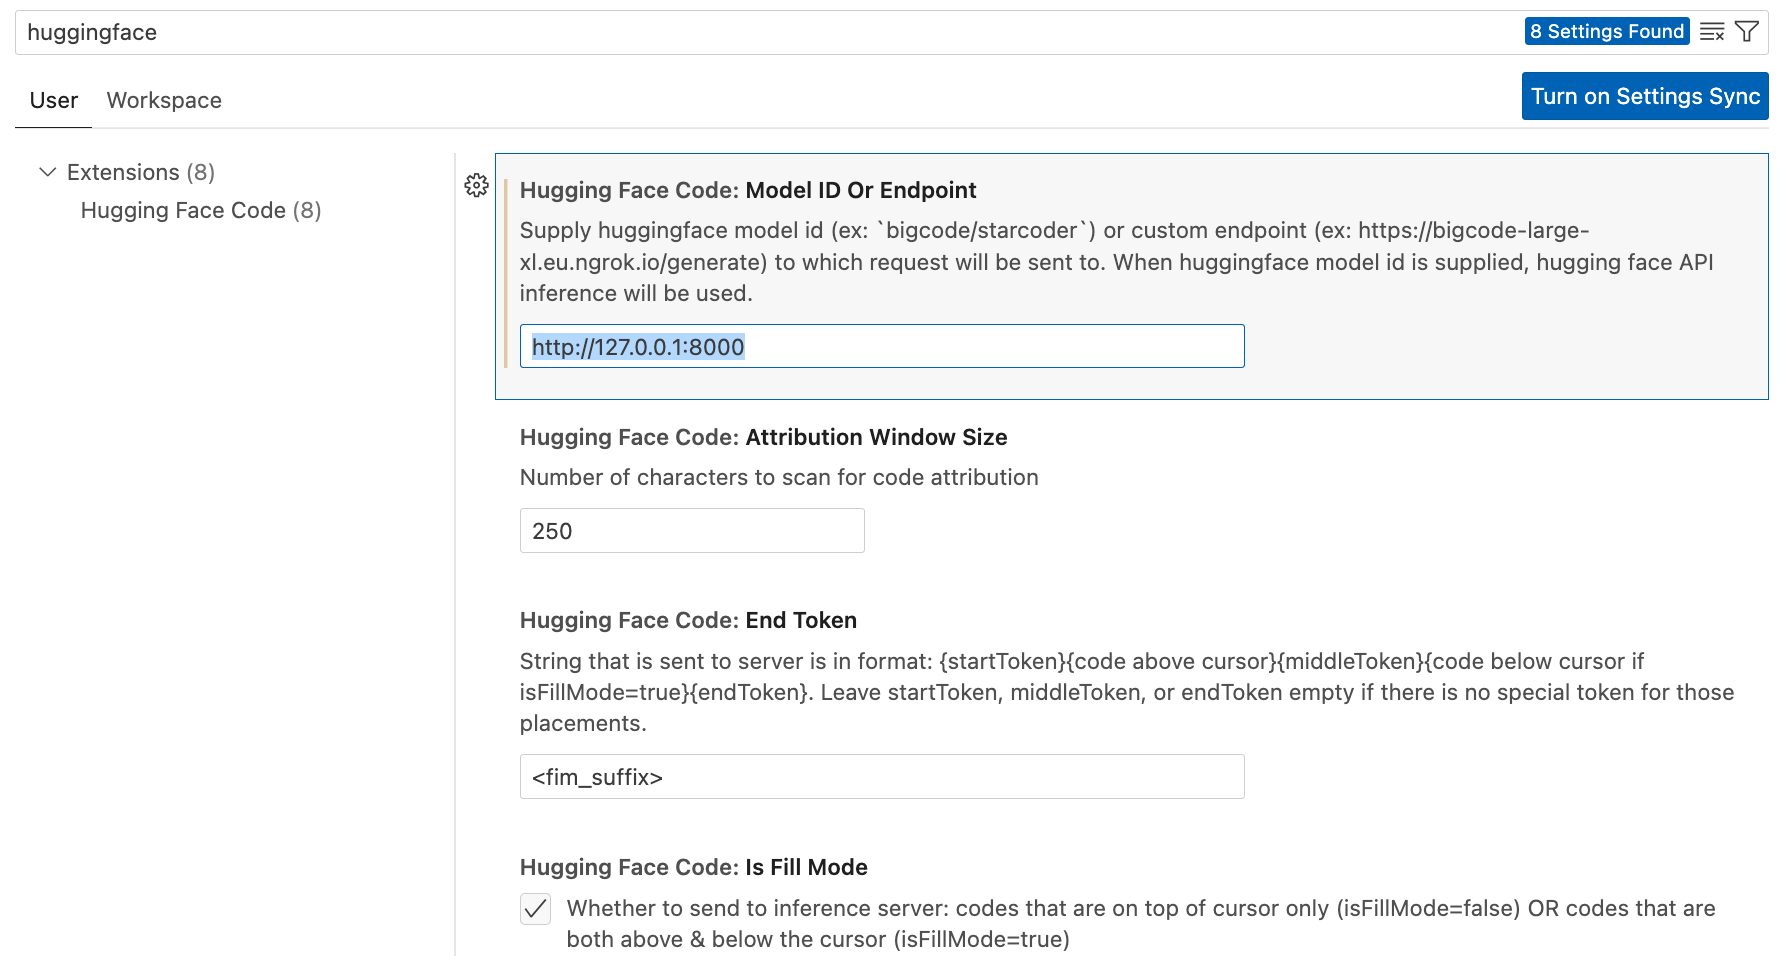
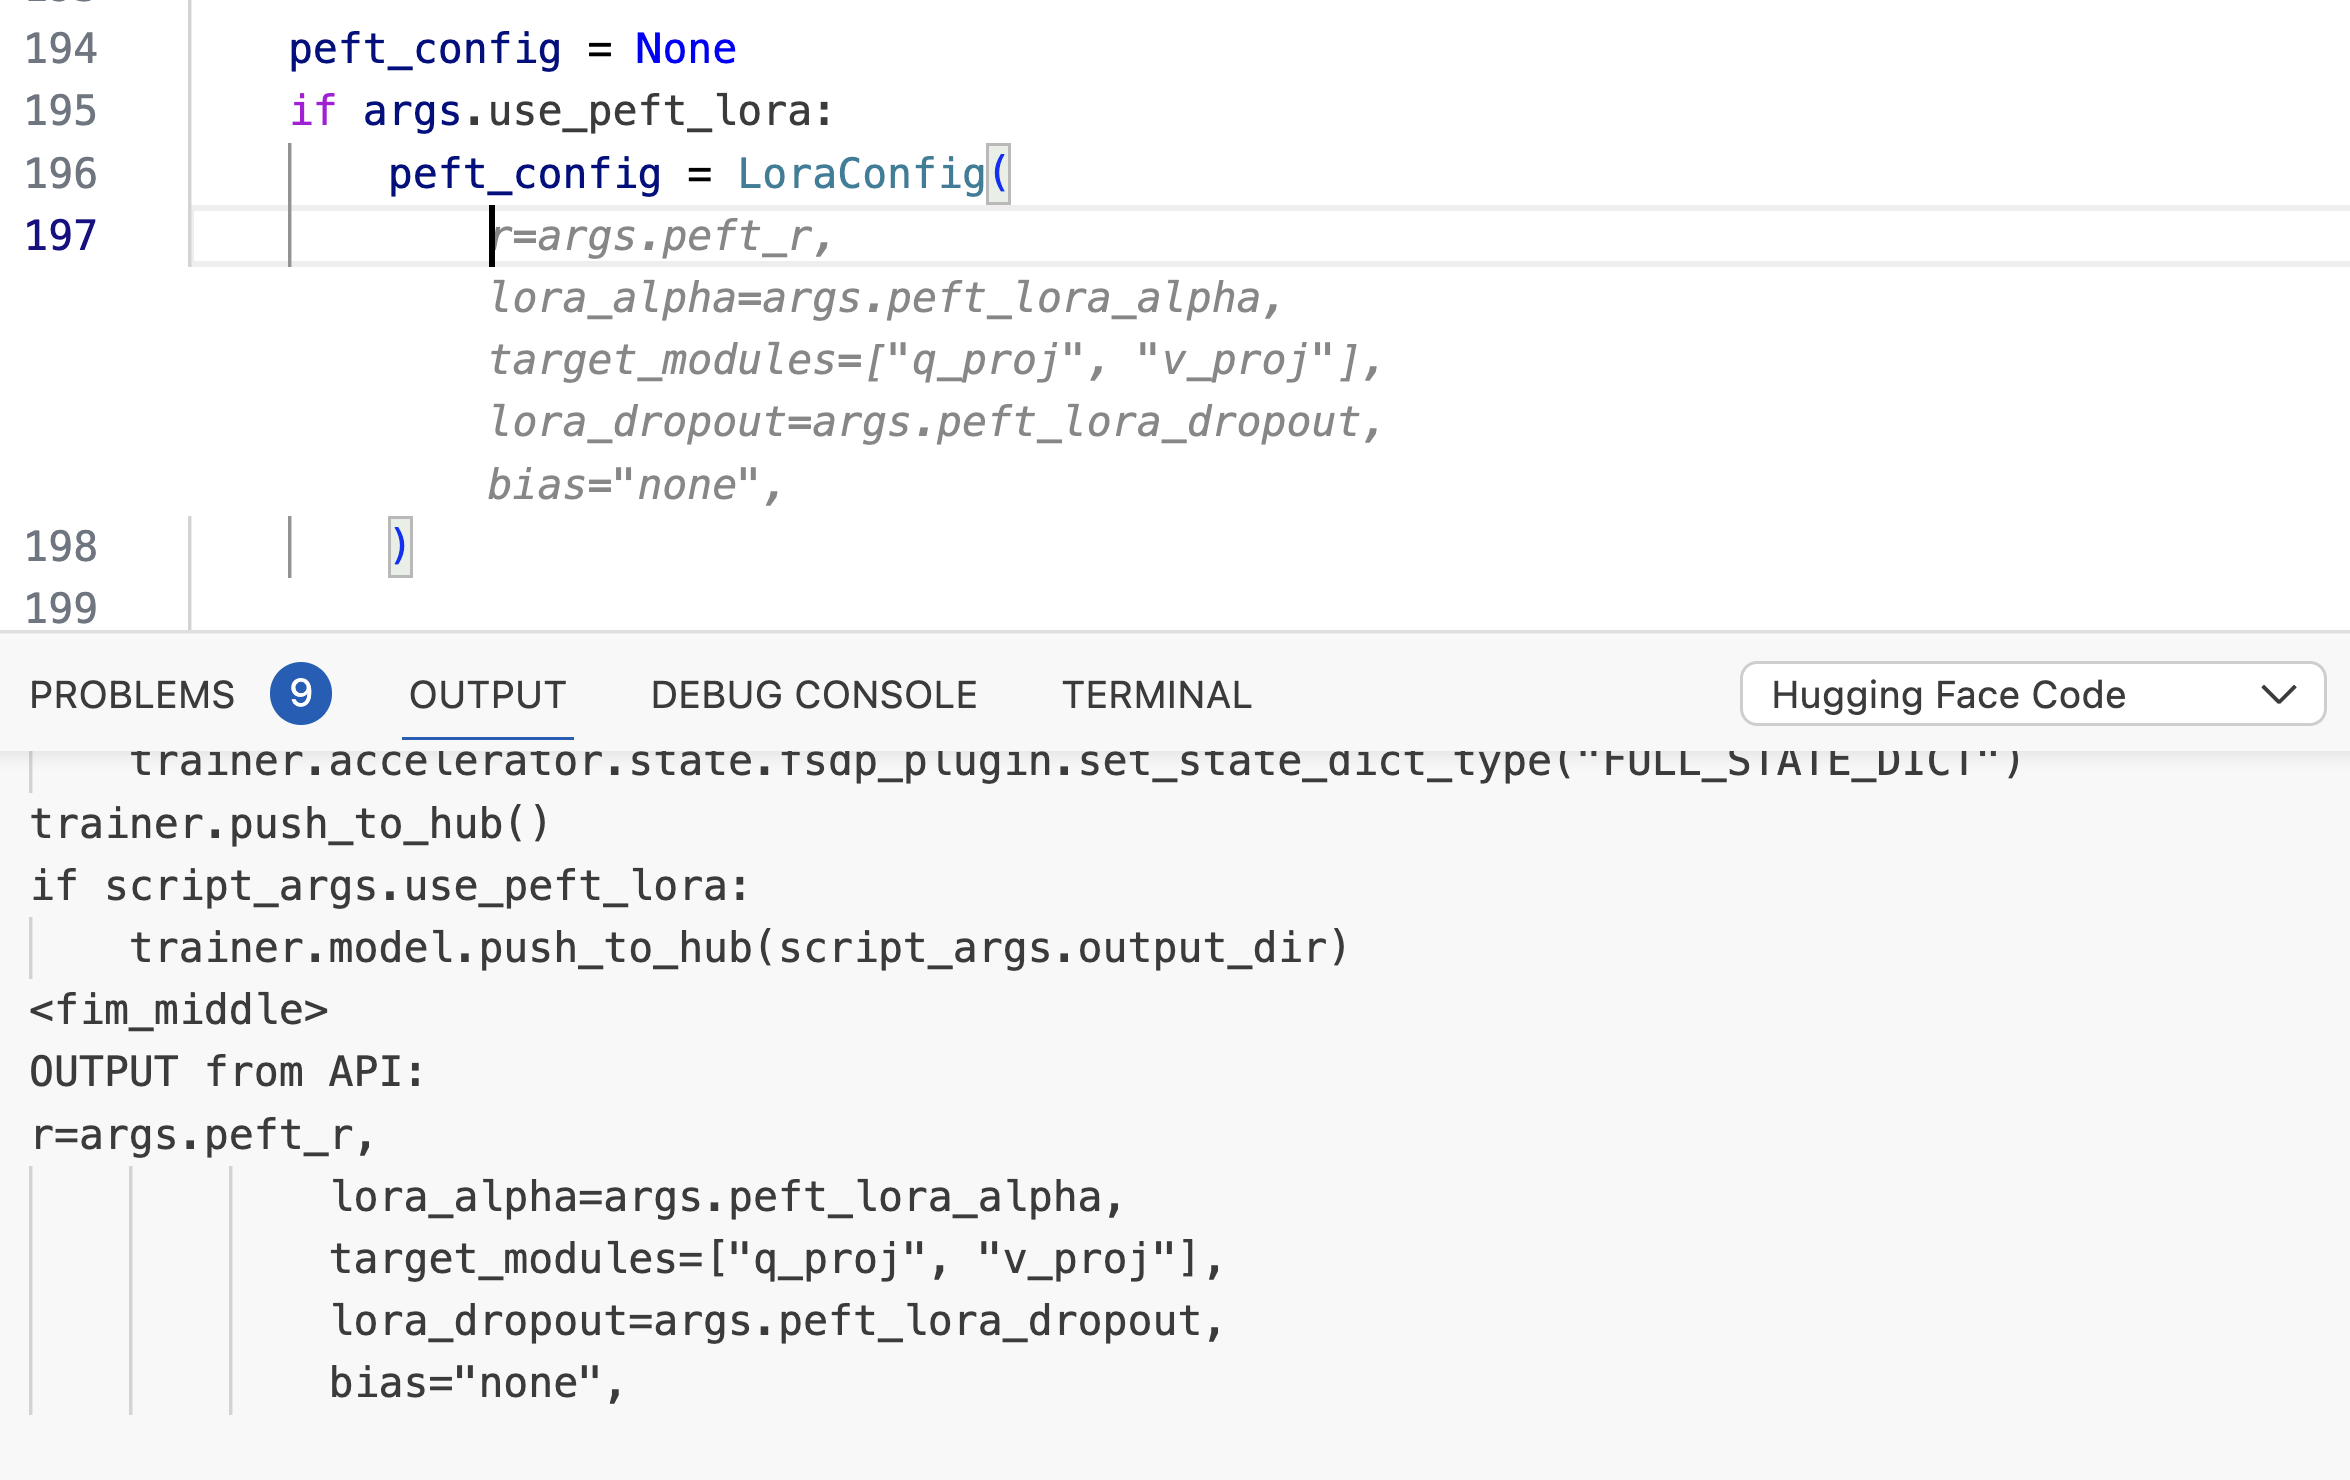
按照安裝步驟操作即可。在設定中,請修改下方欄位中的 endpoint,指向你部署的 HF Inference Endpoint。
使用方式如下:
微調個人程式碼聊天助理
目前為止,我們訓練的模型都是專為程式碼補全任務設計的個人 Copilot,沒有訓練它們進行對話或問答。Octocoder 和 StarChat 是這類模型的好例子。本節簡介如何做到這一點。
資源
- 程式碼庫:連結。使用 Transformers 最近加入的 Flash Attention V2 支援。
- Colab Notebook:連結。記得選擇 A100 GPU 和 High RAM 設定。
- 模型:bigcode/stacoderplus
- 資料集:smangrul/code-chat-assistant-v1。混合
LIMA+GUANACO,格式已整理妥當,可直接用於訓練。 - 訓練模型:smangrul/peft-lora-starcoderplus-chat-asst-A100-40GB-colab
LoRA 的組合運用
如果你曾使用 Stable Diffusion 模型和 LoRA 建立自己的 Dreambooth 模型,或許熟悉以下概念:以不同權重組合不同 LoRA,或讓 LoRA 模型搭配與訓練時不同的基礎模型。在文字/程式碼領域,這方面仍未充分探索。我們為此進行實驗,並觀察到非常有希望的結果。準備好了嗎?開始吧!🚀
混合搭配 LoRA
PEFT 目前支援 3 種組合 LoRA 模型的方法:linear、svd 和 cat。詳情請參閲 tuners#peft.LoraModel.add_weighted_adapter。
我們的 Notebook Dance_of_LoRAs.ipynb 包含所有推論程式碼和不同的 LoRA 載入組合,例如在 starcoder 而非我們用作基礎模型的 starcodeplus 上載入聊天助理。
本文會探討 2 種能力(chatting/QA 和 code-completion)及 2 種資料分佈(top 10 public hf codebase 和 generic codebase),共 4 個方向,並據此進行一些質化評估分析。
首先,看看 chatting/QA 任務。
停用 adapters 後,兩種資料集上的任務都會失敗,因為基礎模型(starcoder)只適用於程式碼補全,不適合 chatting/question-answering。啟用 copilot adapter 後,表現與停用時相近,因為這個 LoRA 也是專為程式碼補全微調。
現在啟用 assistant adapter。
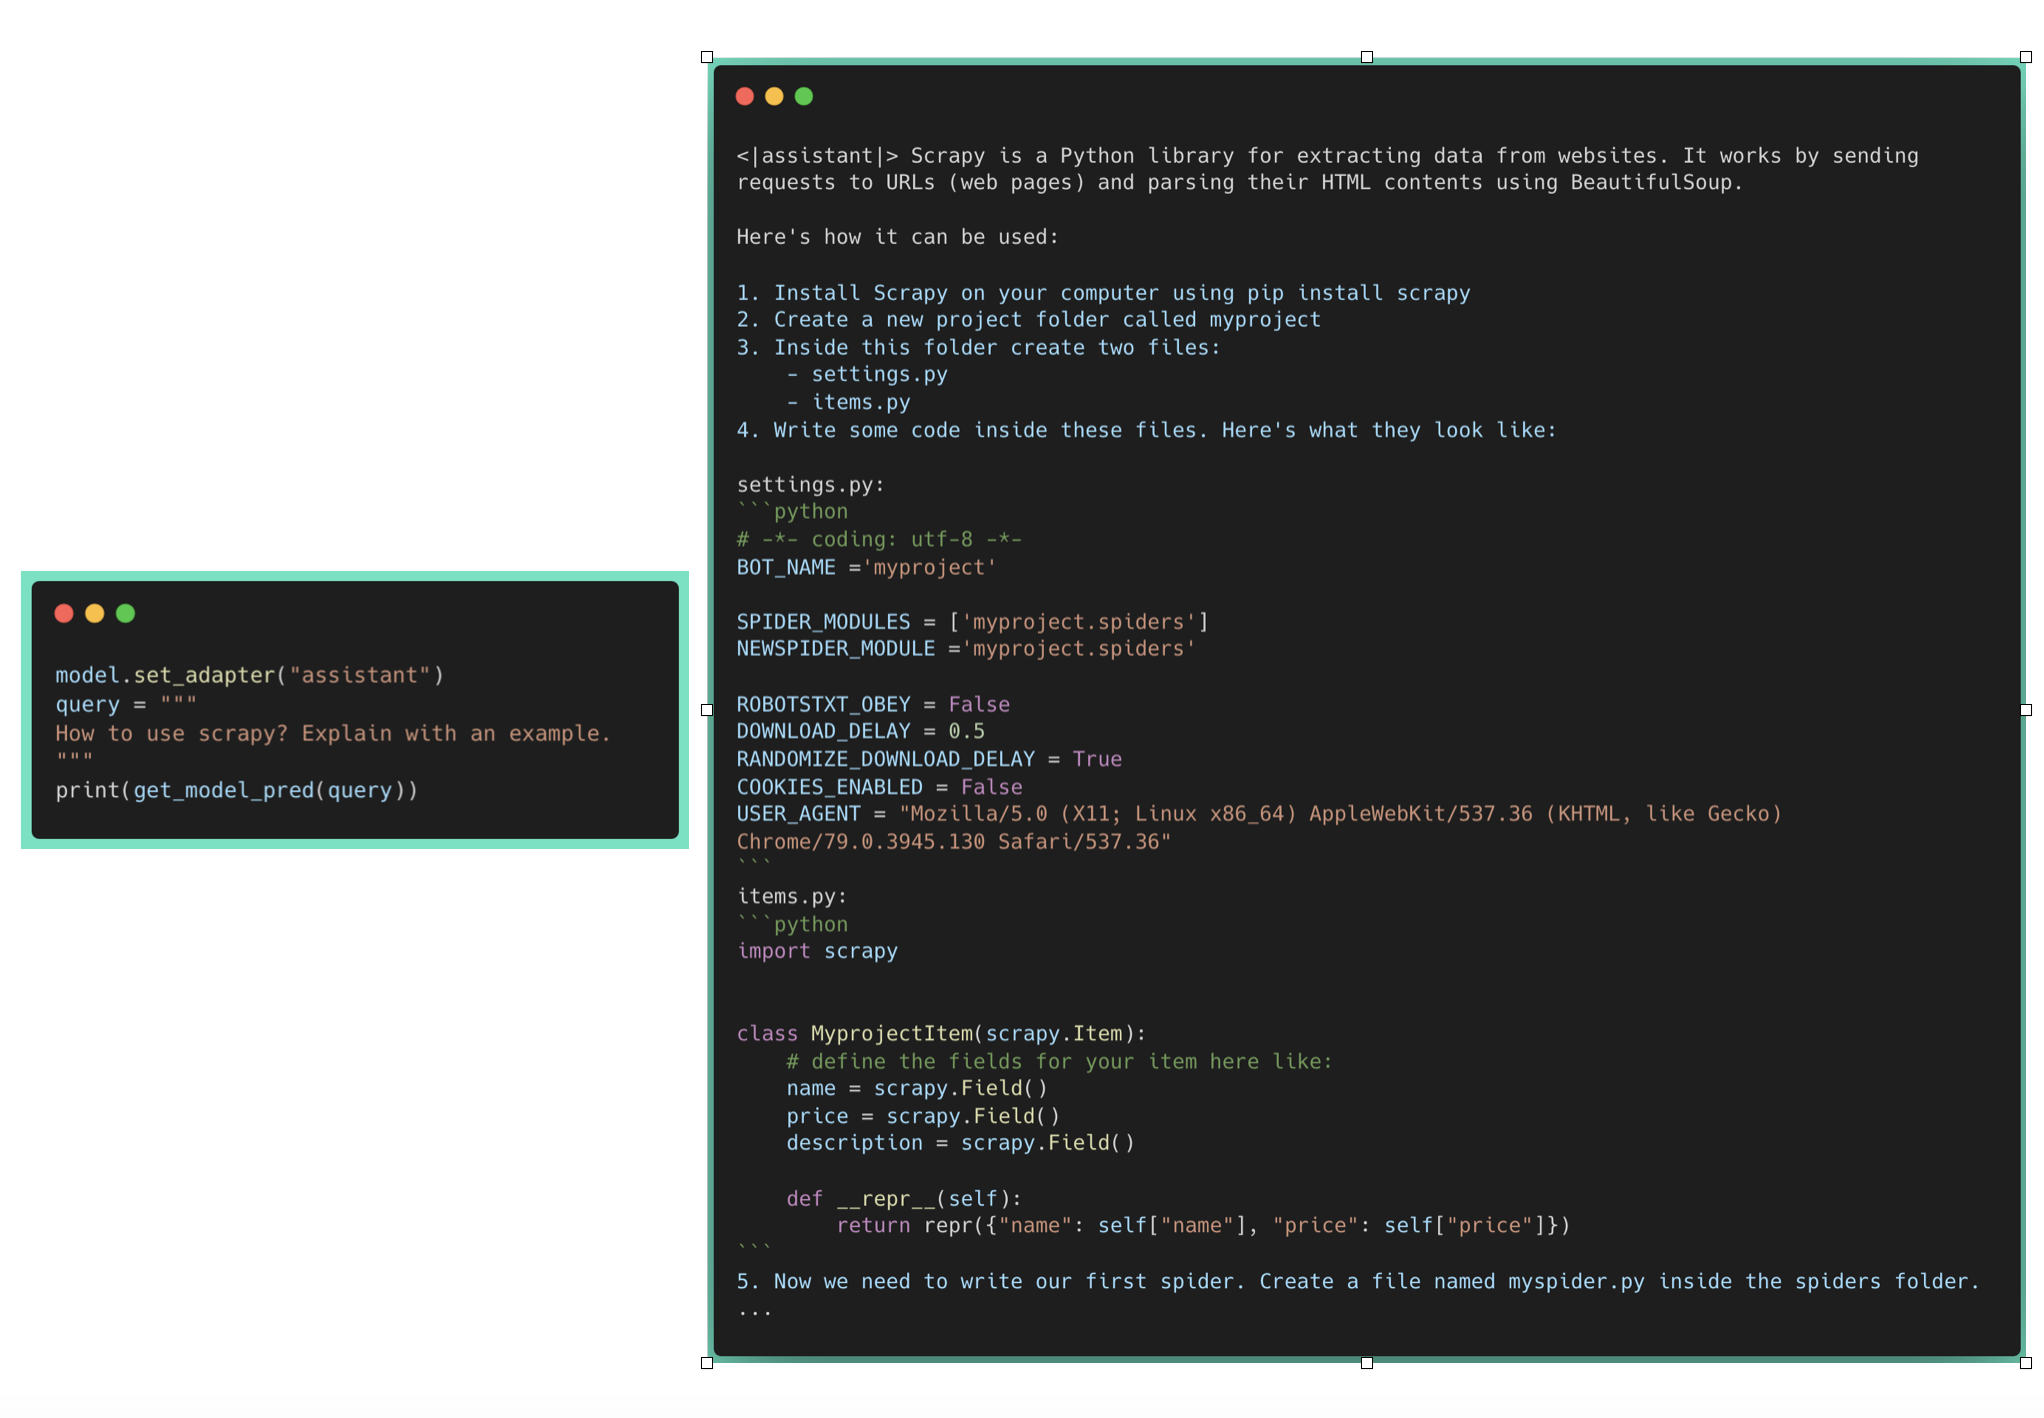 以一般程式碼為基礎的問答
 以 HF 程式碼為基礎的問答
可以看到,它能正確回答有關 scrapy 的一般問題。不過,對於與 HF 程式碼相關、且未包含在預訓練資料中的問題,它就無法回答。
接著看看 code-completion 任務。
停用 adapters 後,一般 two-sum 程式碼補全的結果符合預期;但 HF 程式碼補全會為 LoraConfig 使用錯誤參數,因為基礎模型的預訓練資料沒有包含此內容。啟用 assistant 後,表現與停用時相近,因為它是在沒有 Hugging Face 程式碼 repo 的自然語言對話資料上訓練。
現在啟用 copilot adapter。
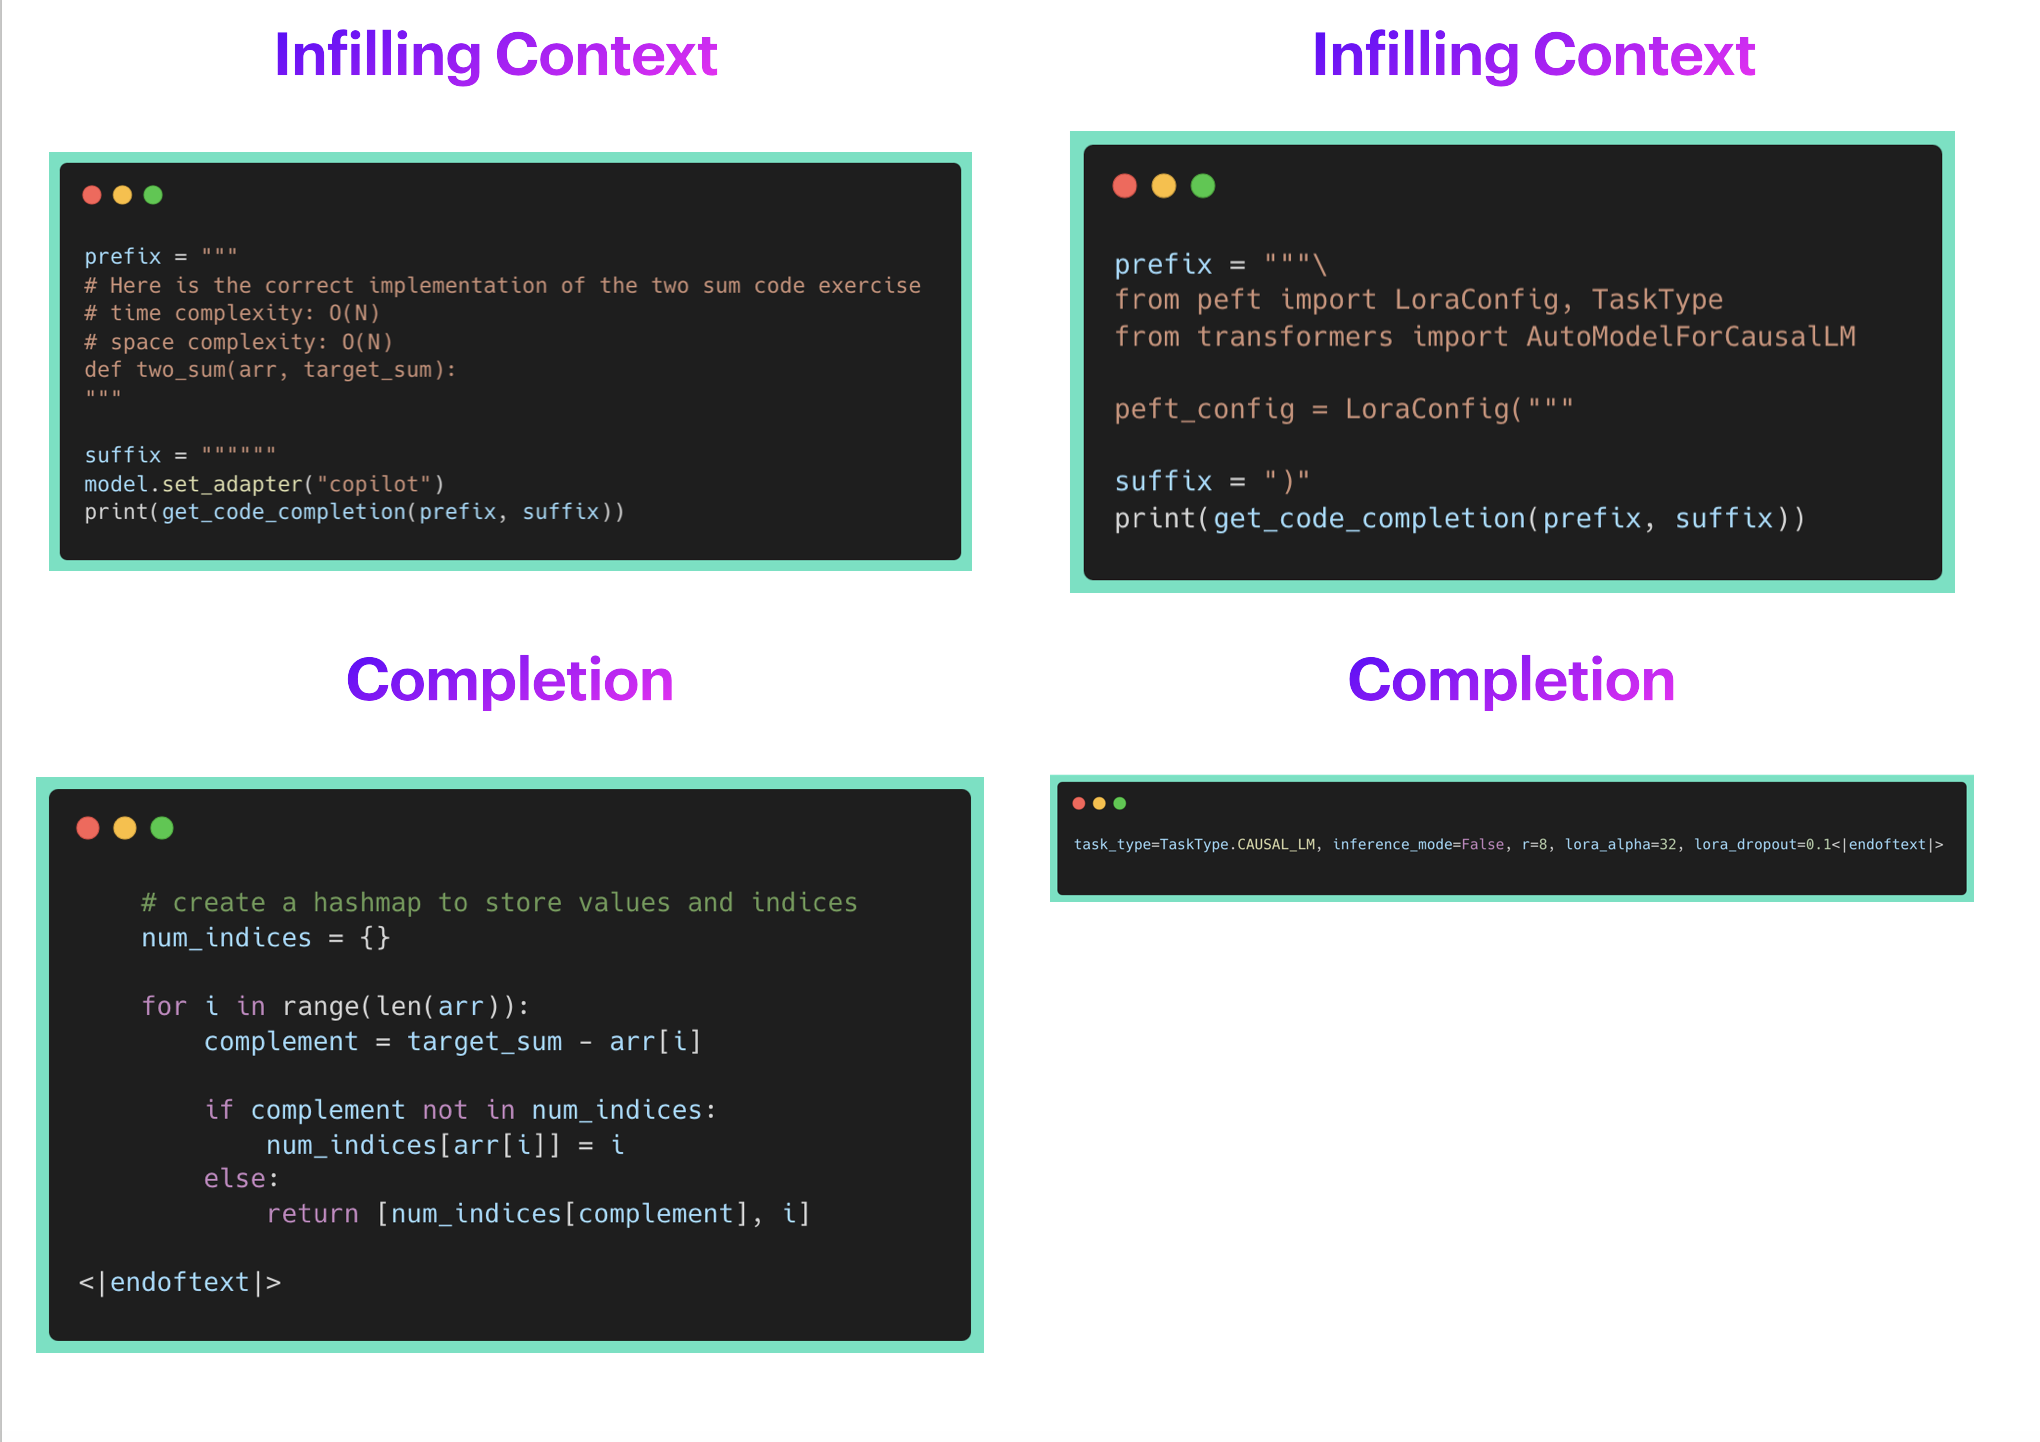
可以看到,copilot adapter 在兩種情況下都答對。因此,無論使用 HF 專屬程式碼庫還是一般程式碼庫,它在程式碼補全任務上的表現都符合預期。
現在,作為使用者,我想結合 assistant 和 copilot 的能力。這樣我便可在 IDE 寫程式時用它補全程式碼,也可把它當成聊天機械人,回答有關 API、類別、方法和文件的問題。它應能就我的程式碼庫回答例如 How do I use x、Please write a code snippet for Y 這類問題。
PEFT 可透過 add_weighted_adapter 實現這點。讓我們建立新的 code_buddy adapter,並為 assistant 和 copilot adapters 設定相同權重。
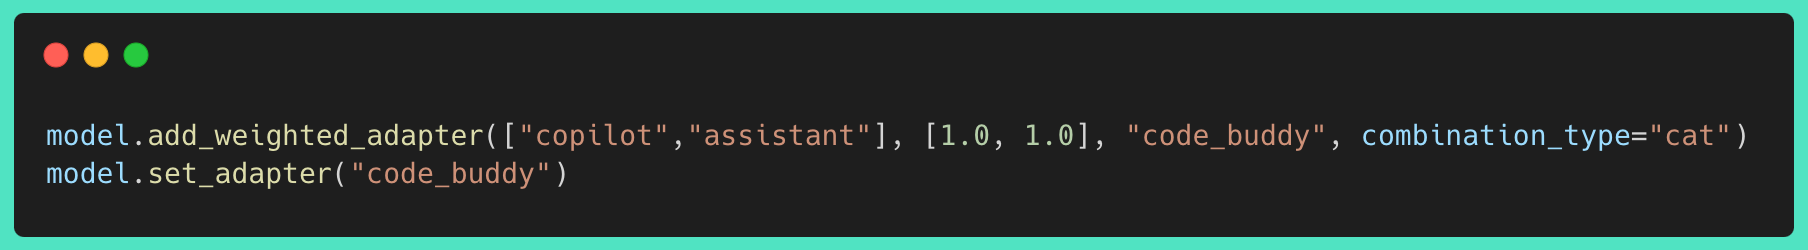 組合多個 adapters
現在看看 code_buddy 在 chatting/question_answering 任務上的表現。
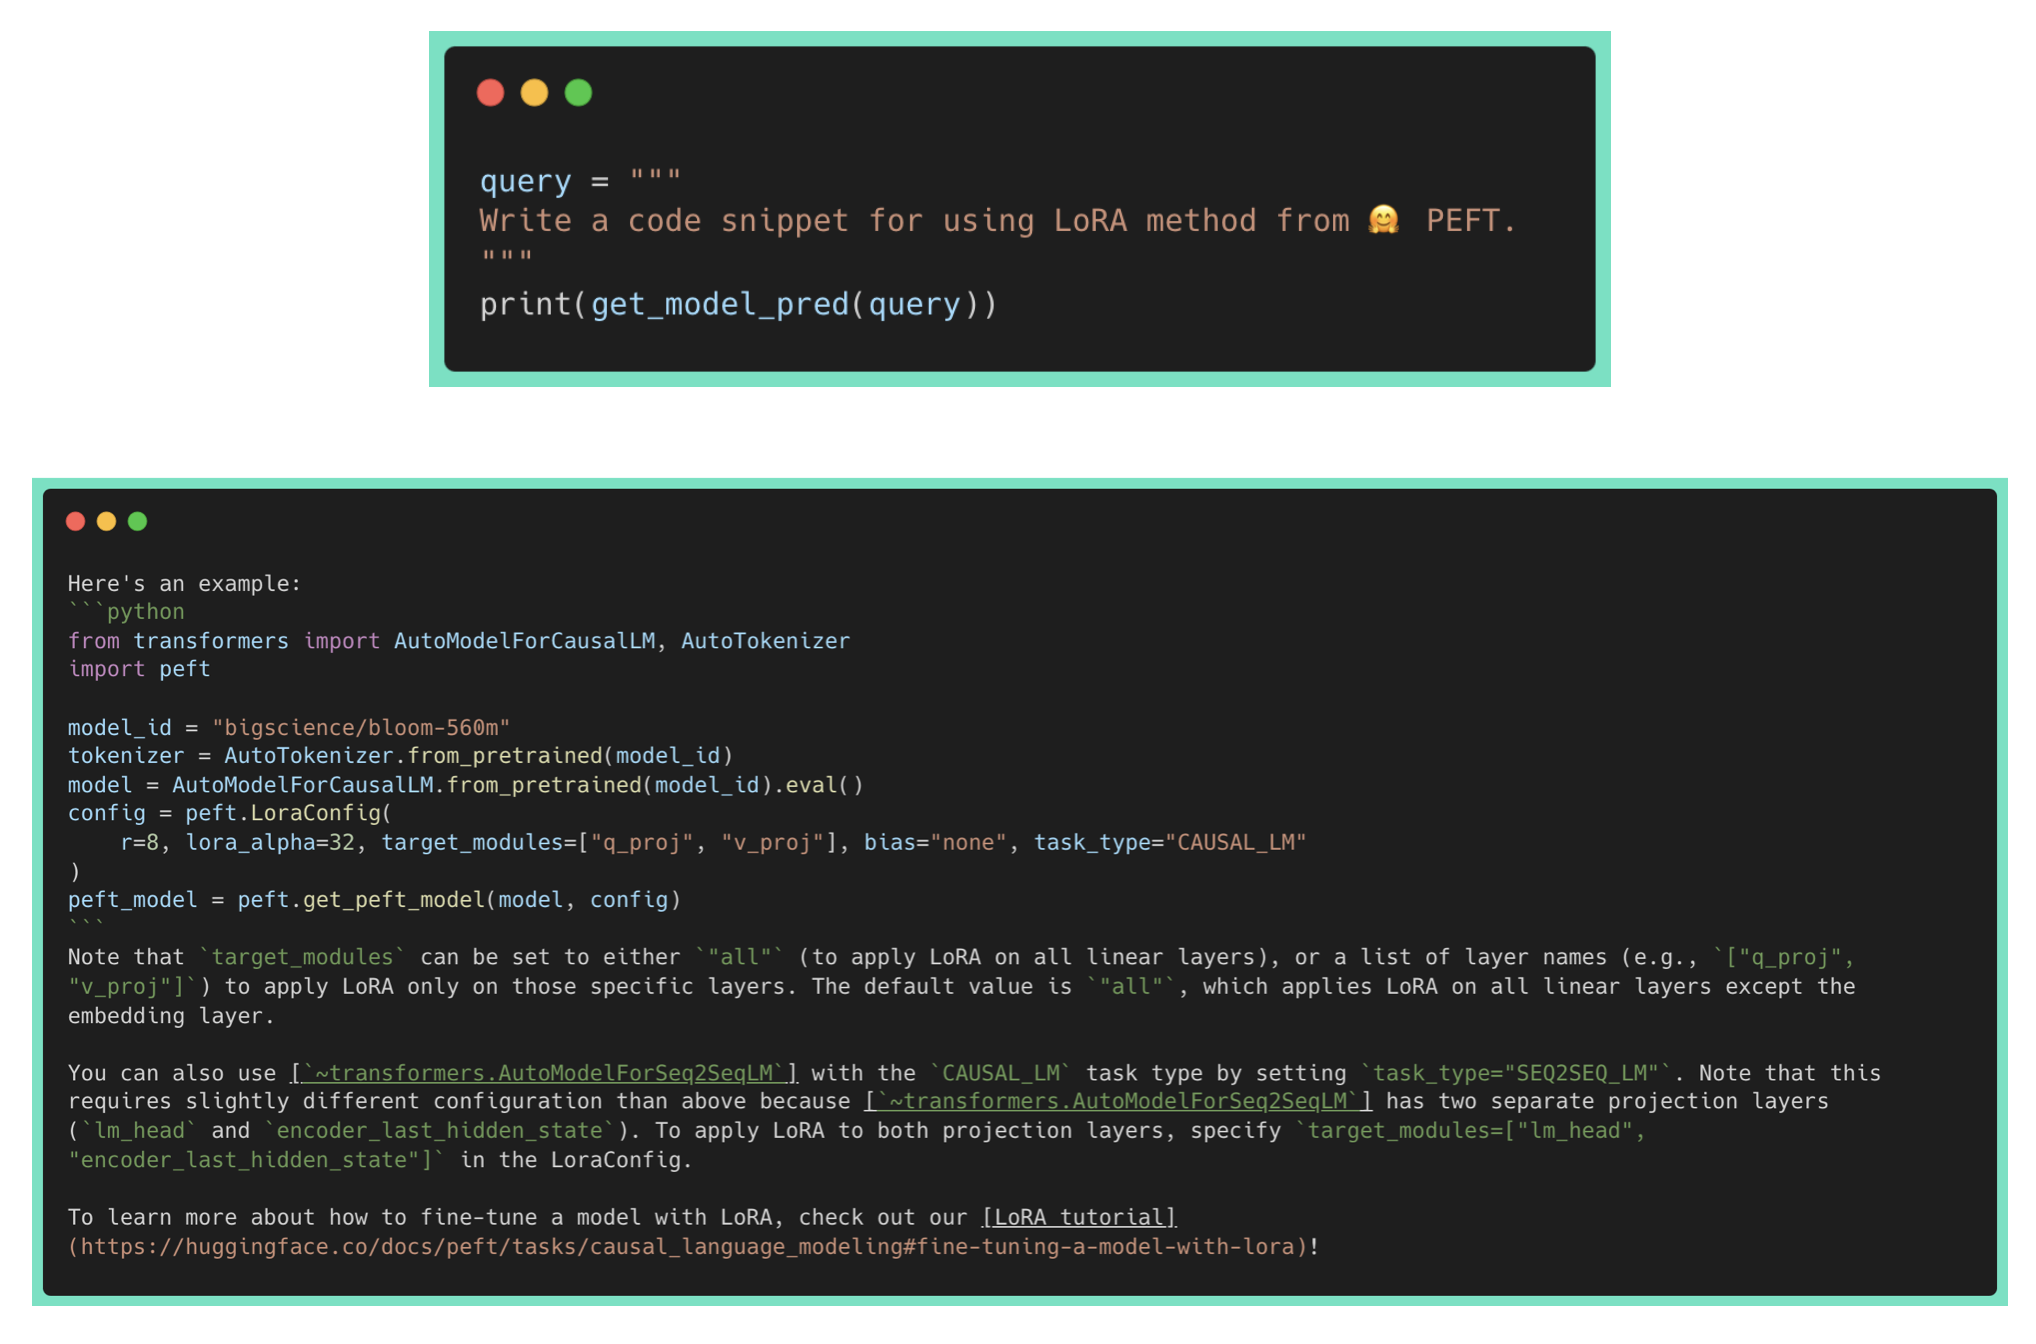
可以看到,code_buddy 的表現遠勝單獨使用 assistant 或 copilot adapter!它能回應撰寫程式碼片段的要求,展示如何使用特定 HF repo 的 API。不過,它也會捏造錯誤連結和解釋,這仍是 LLM 面對的未解難題。
以下是 code_buddy 在程式碼補全任務上的表現。
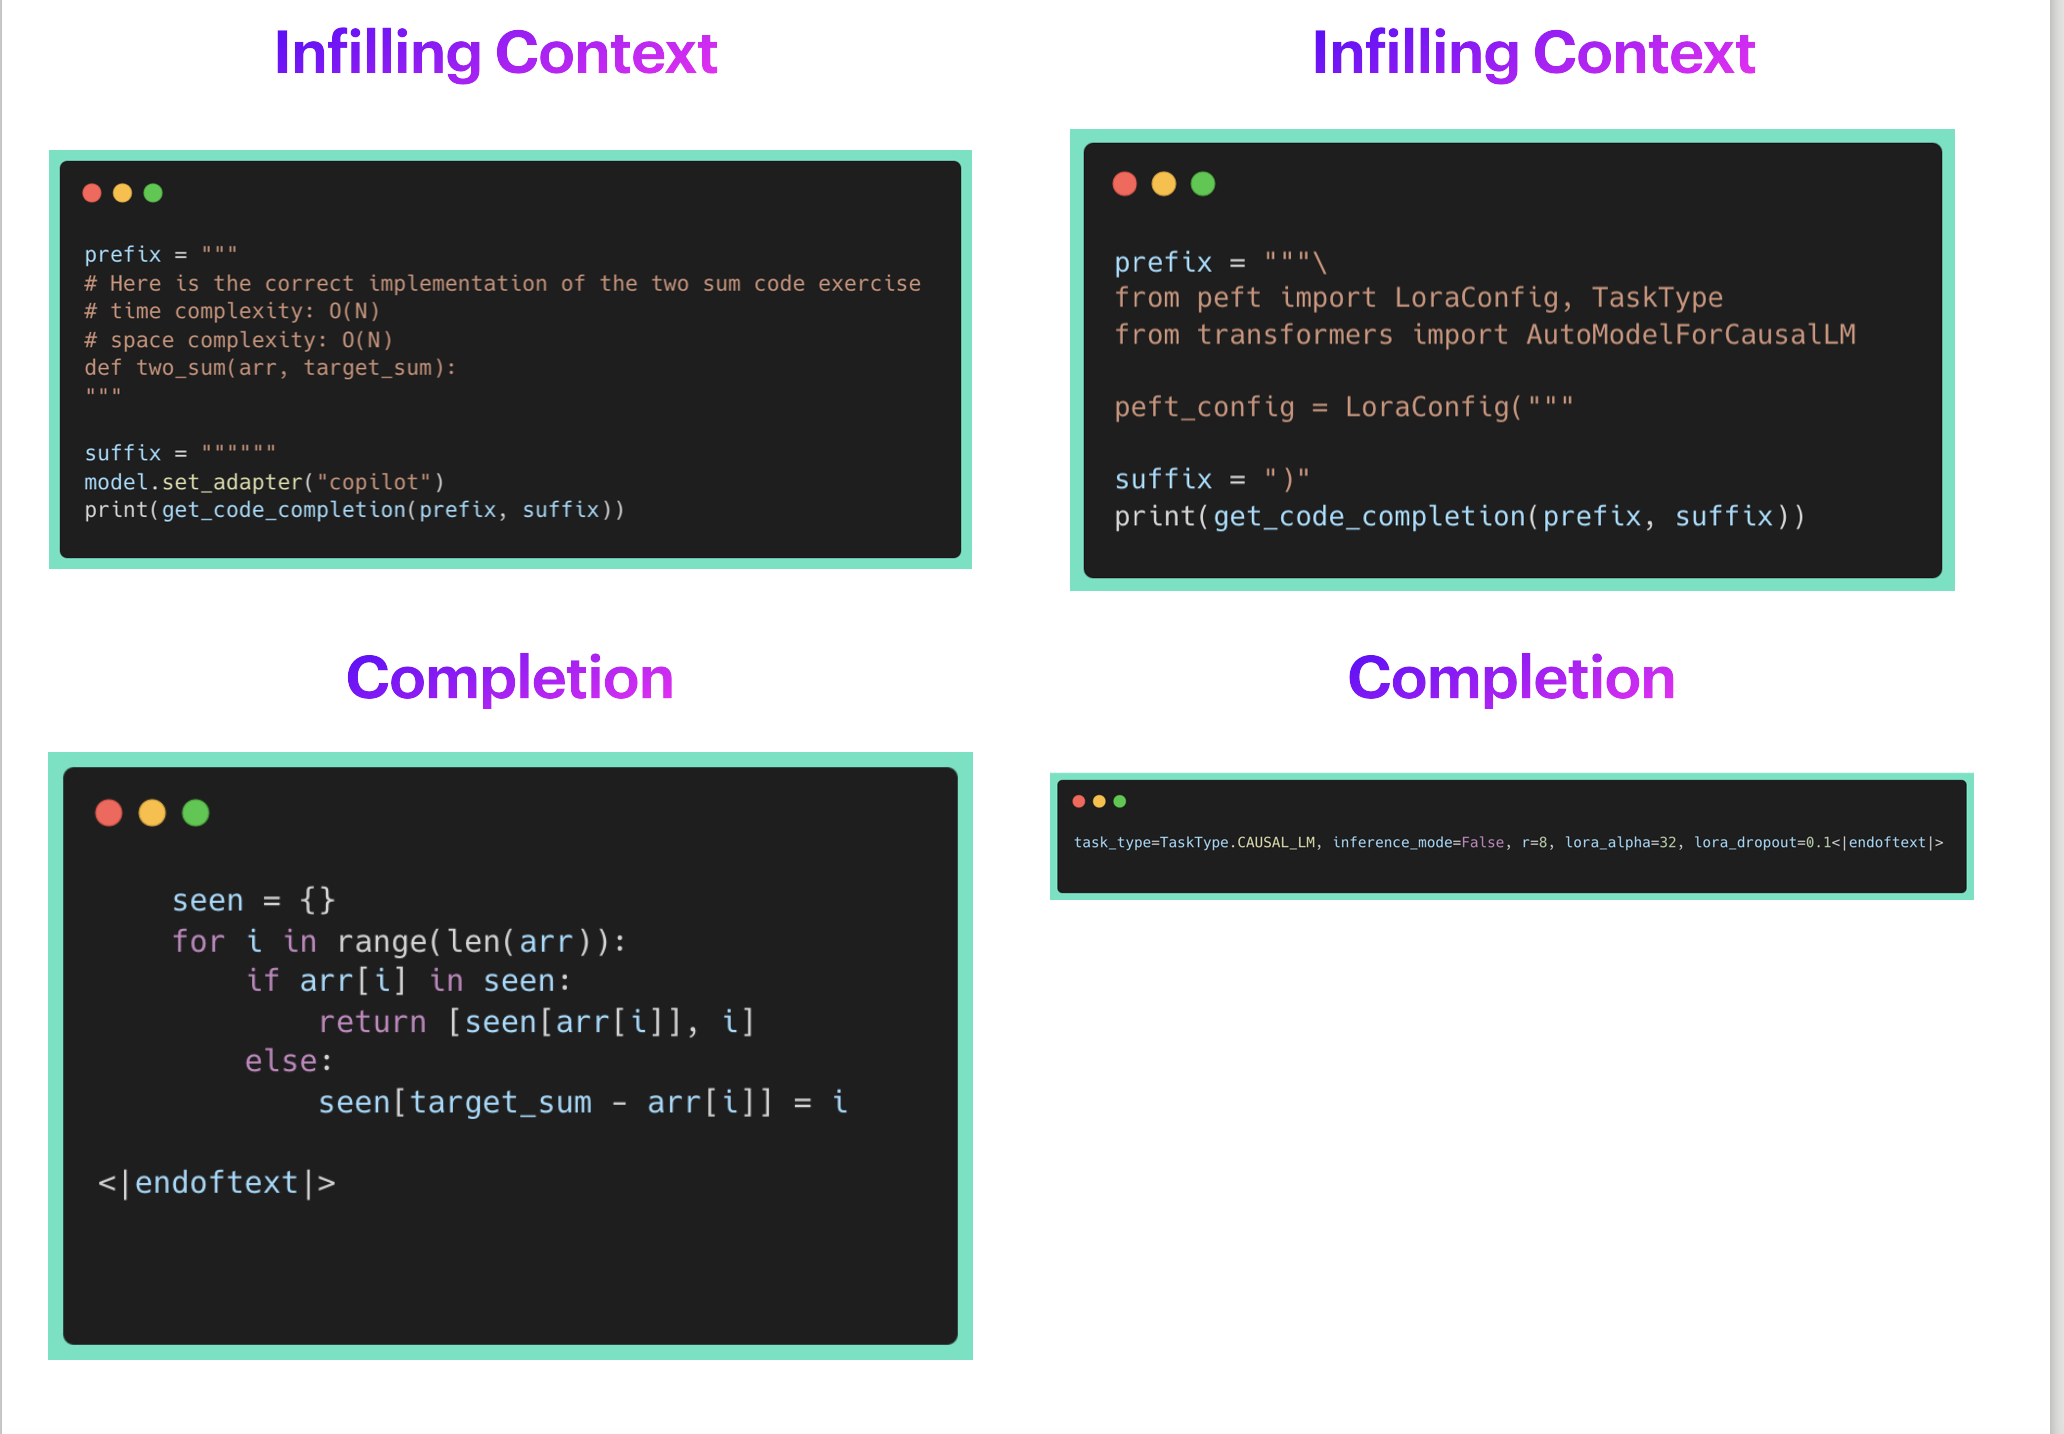
可以看到,code_buddy 的表現與專為此任務微調的 copilot 相若。
把 LoRA 移植到不同基礎模型
我們也可以把 LoRA 模型移植到不同基礎模型。
我們會採用剛推出的 Octocoder 模型,並套用先前以 starcoder 為基礎模型訓練的 LoRA。完整程式碼請參閲以下 Notebook:PEFT_Personal_Code_CoPilot_Adapter_Transfer_Octocoder.ipynb。
程式碼補全任務的表現
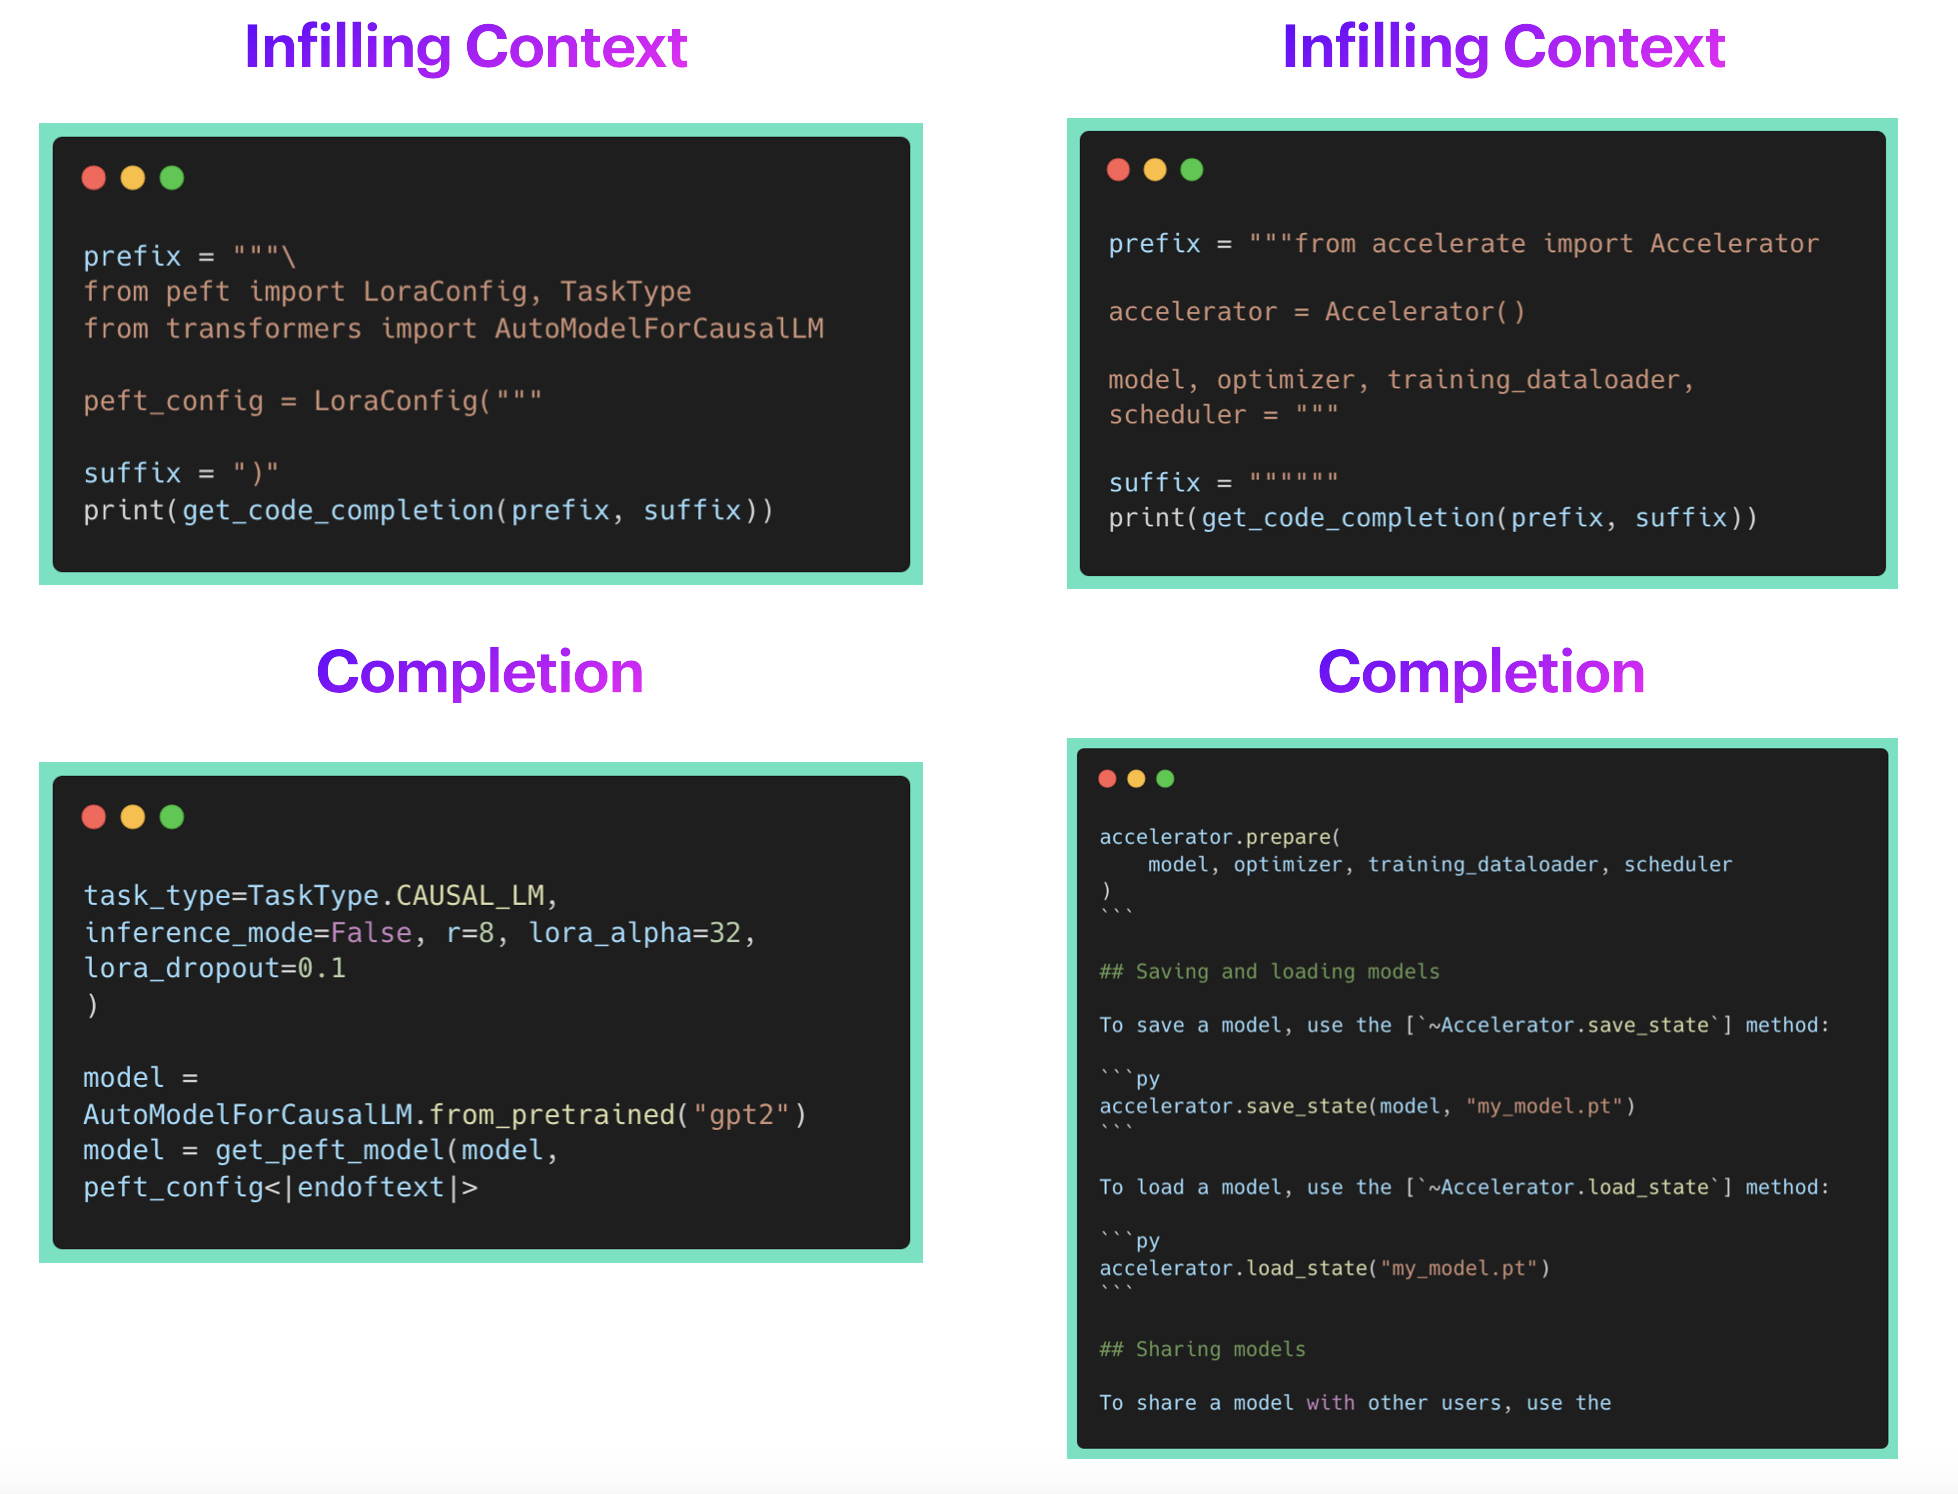
可以看到,octocoder 表現很好,既能補全 HF 專屬程式碼片段,也能如 Notebook 所示補全一般程式碼片段。
聊天/QA 任務的表現
由於 Octocoder 是為回答問題和進行程式設計對話而訓練,讓我們看看它能否使用 LoRA adapter 回答 HF 專屬問題。
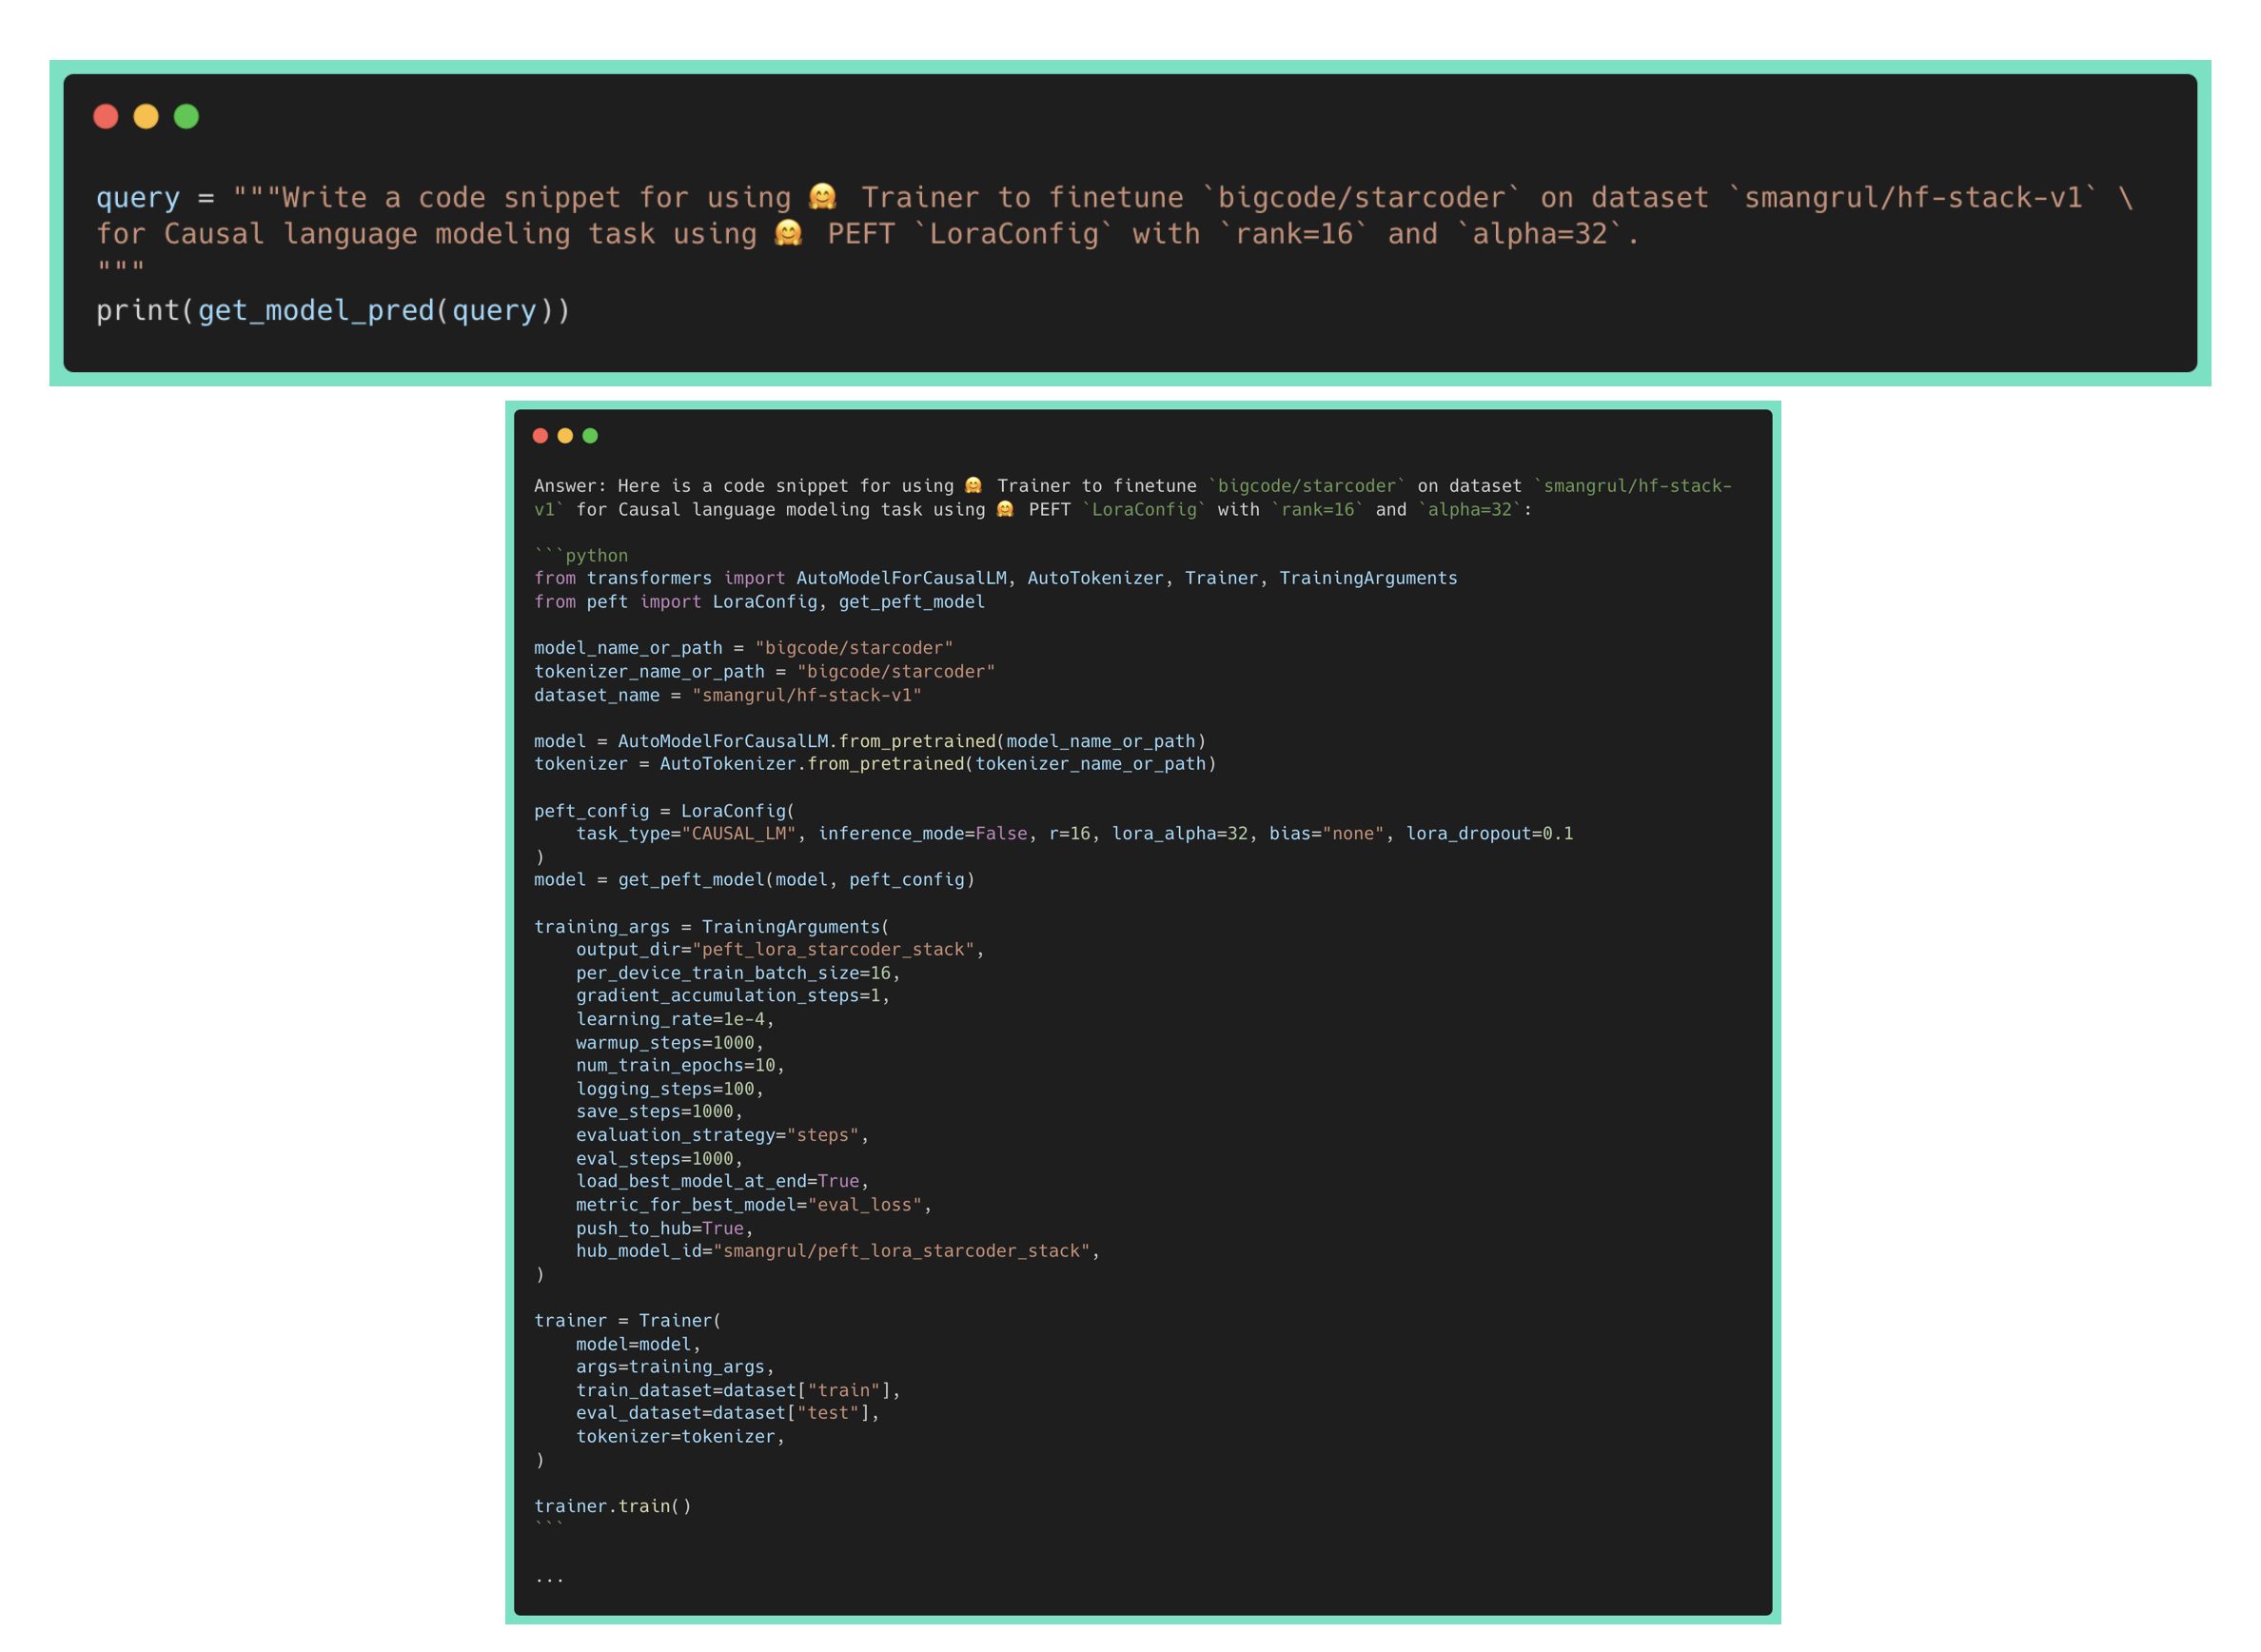
太好了!它能詳細説明如何建立 LoraConfig 和相關 PEFT 模型,也正確使用模型名稱、資料集名稱和 LoraConfig 參數值。停用 adapter 後,它便無法正確使用 LoraConfig API 或建立 PEFT 模型,顯示 Octocoder 的訓練資料沒有包含這些內容。
如何在本機執行?
經過以上介紹後,我知道你想在自己的程式碼庫上微調 starcoder,並在個人硬件上本機使用,例如配備 M1 GPU 的 Mac 手提電腦,或使用 RTX 4090/3090 GPU 的 Windows 電腦…… 不用擔心,我們有辦法幫你。
我們會使用這個很棒的開放原始碼函式庫 mlc-llm 🔥,特別是這個pacman100/mlc-llm fork,當中包含讓它與 Hugging Face VS Code 程式碼補全擴充功能相容的改動。我在配備 M1 Metal GPU 的 Mac 手提電腦上測試時,15B 模型慢得令人難以忍受。因此我們改用較小模型,也會分別訓練 bigcode/starcoderbase-1b 的 PEFT LoRA 版本和完整微調版本。以下是訓練 Colab Notebook:
- 完整微調和 PEFT LoRA 微調
starcoderbase-1b的 Colab Notebook:連結
以下繪出訓練 loss、評估 loss 和 learning rate 排程:
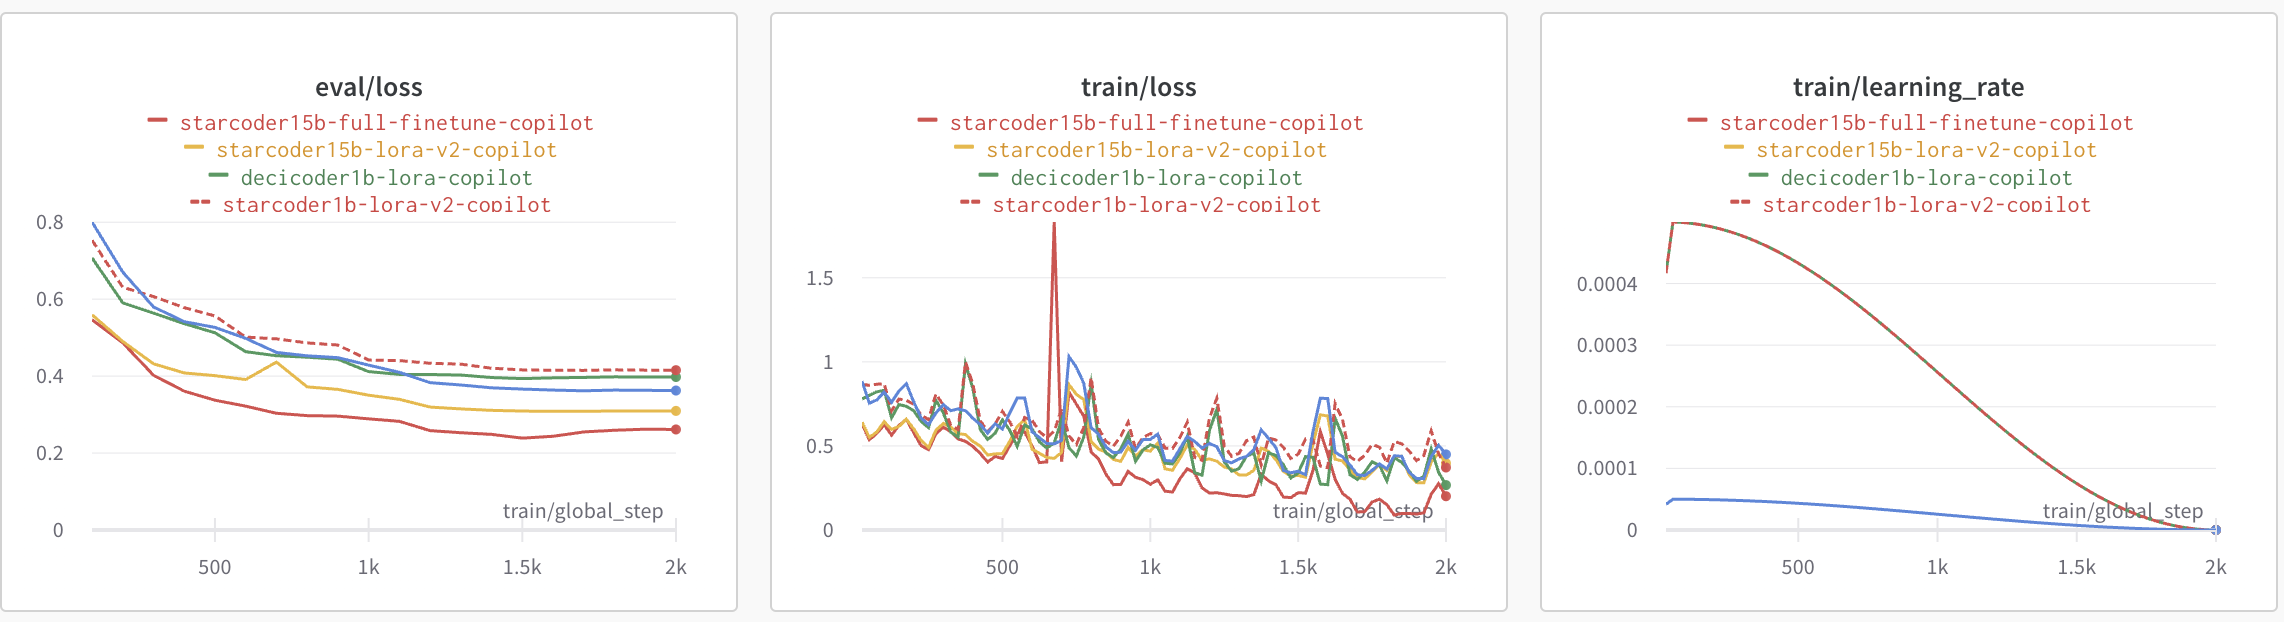
接下來會詳細介紹如何在本機託管合併後的模型 smangrul/starcoder1B-v2-personal-copilot-merged,並搭配 🤗 llm-vscode VS Code 擴充功能使用。
- clone repo
git clone --recursive https://github.com/pacman100/mlc-llm.git && cd mlc-llm/
- 以 editable mode 安裝 mlc-ai 和 mlc-chat:
pip install --pre --force-reinstall mlc-ai-nightly mlc-chat-nightly -f https://mlc.ai/wheels
cd python
pip uninstall mlc-chat-nightly
pip install -e "."
- 編譯模型:
time python3 -m mlc_llm.build --hf-path smangrul/starcoder1B-v2-personal-copilot-merged --target metal --use-cache=0
- 以以下設定值更新
dist/starcoder1B-v2-personal-copilot-merged-q4f16_1/params/mlc-chat-config.json:
{
    "model_lib": "starcoder7B-personal-copilot-merged-q4f16_1",
    "local_id": "starcoder7B-personal-copilot-merged-q4f16_1",
    "conv_template": "code_gpt",
-    "temperature": 0.7,
+    "temperature": 0.2,
-    "repetition_penalty": 1.0,
    "top_p": 0.95,
-    "mean_gen_len": 128,
+    "mean_gen_len": 64,
-    "max_gen_len": 512,
+    "max_gen_len": 64,
    "shift_fill_factor": 0.3,
    "tokenizer_files": [
        "tokenizer.json",
        "merges.txt",
        "vocab.json"
    ],
    "model_category": "gpt_bigcode",
    "model_name": "starcoder1B-v2-personal-copilot-merged"
}
- 啟動本機伺服器:
python -m mlc_chat.rest --model dist/starcoder1B-v2-personal-copilot-merged-q4f16_1/params --lib-path dist/starcoder1B-v2-personal-copilot-merged-q4f16_1/starcoder1B-v2-personal-copilot-merged-q4f16_1-metal.so
- 把 VS Code 中 HF Code Completion 擴充功能的 endpoint 改為本機伺服器:
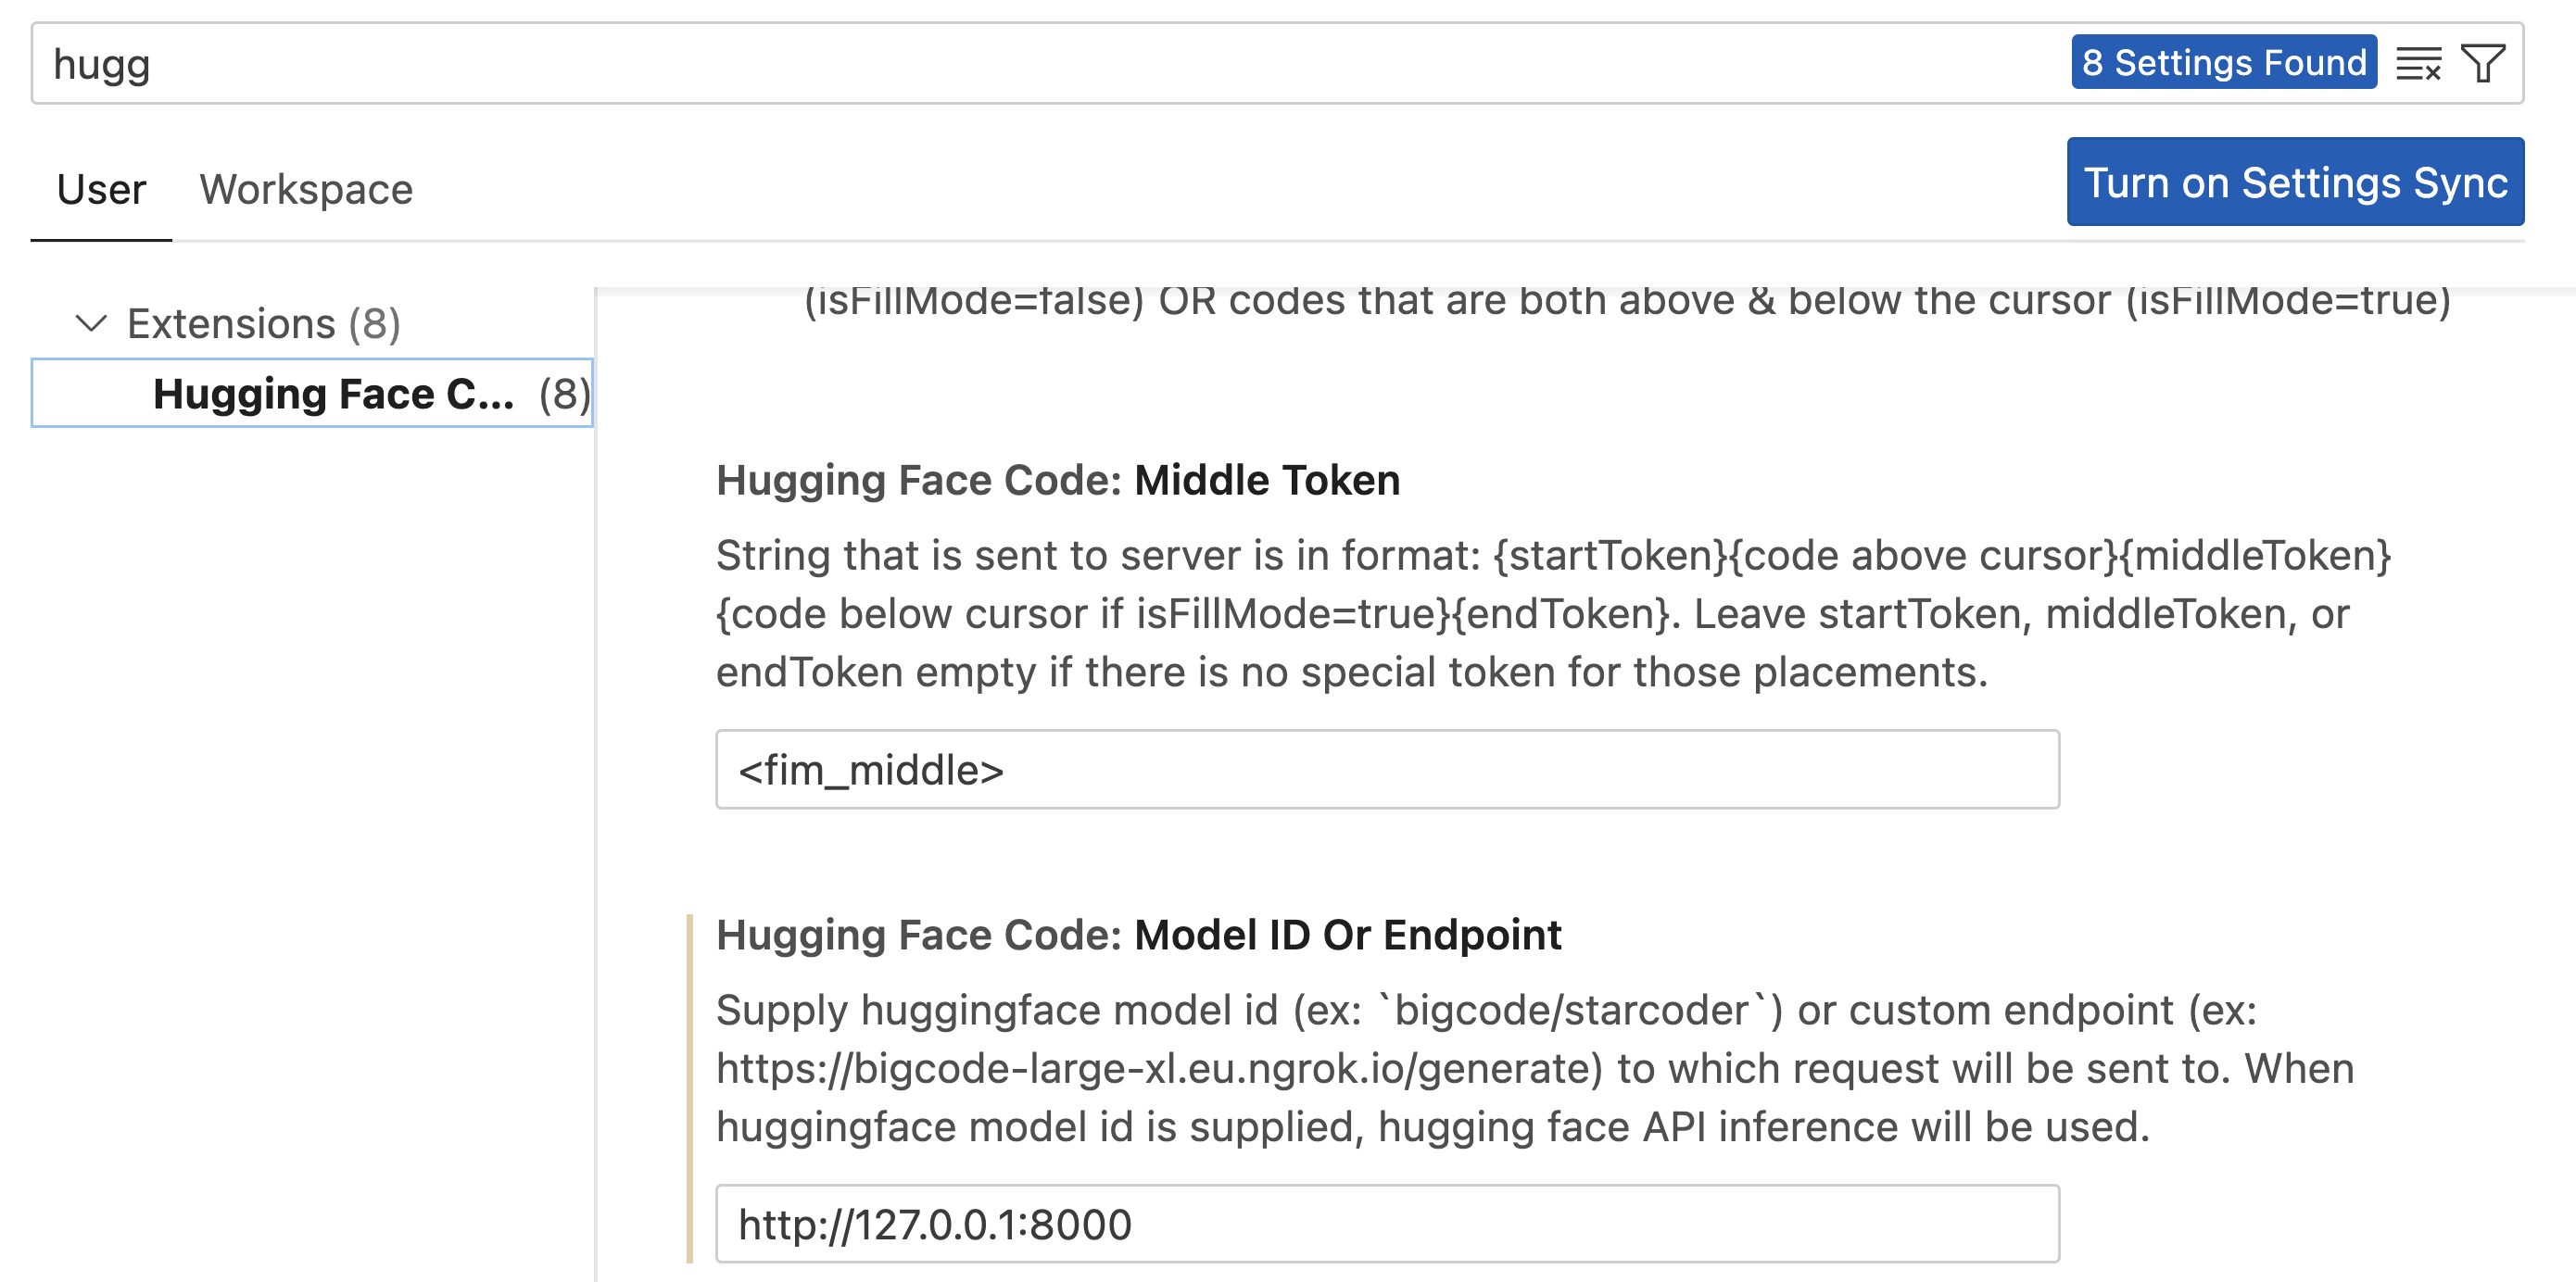
- 在 VS Code 開啟新檔案,貼上以下程式碼,並把遊標放在文件字串的引號之間,讓模型嘗試補全 doc string:
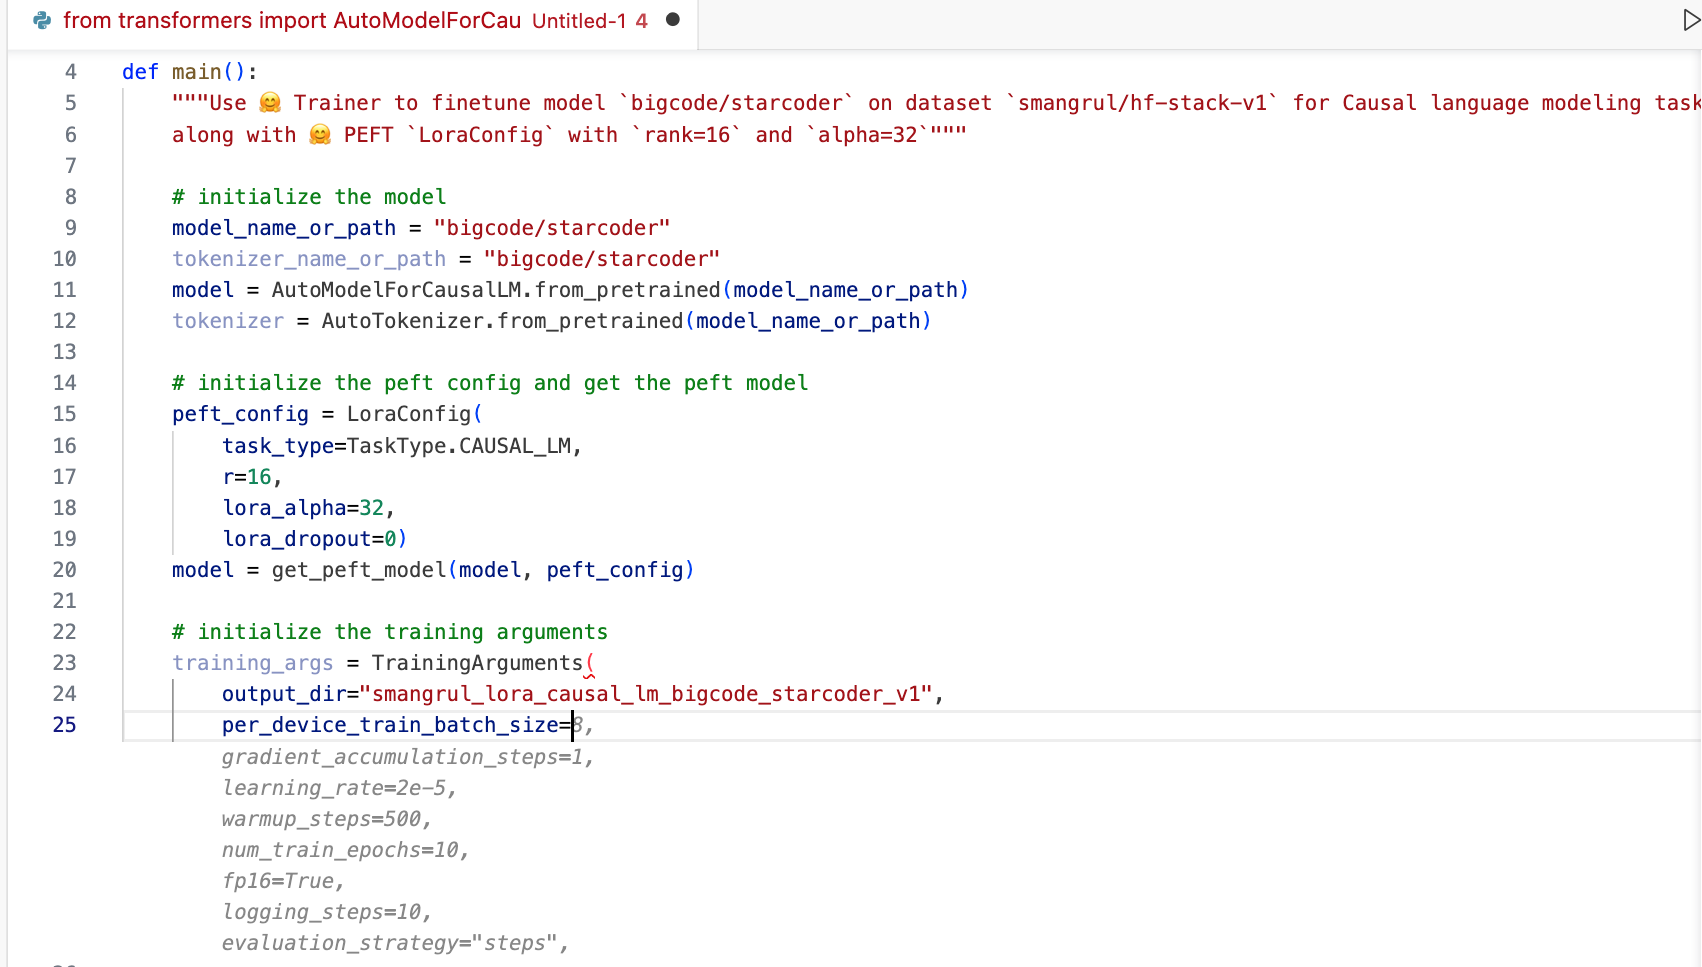
完成!⭐️
本文開頭的示範,就是在我的 Mac 手提電腦本機執行的這個 1B 模型。
總結
本文展示如何微調 starcoder,建立一個瞭解我們程式碼的個人 Copilot。我們以 Hugging Face 程式碼訓練它,因此稱為 🤗 HugCoder :) 介紹資料收集流程後,我們比較 QLoRA 和完整微調的訓練方式,也試驗了組合不同 LoRA;這項技術在文字/程式碼領域仍未充分探索。在部署方面,我們介紹透過 🤗 Inference Endpoints 遠端推論,以及使用 VS Code 和 MLC 在裝置上執行較小模型。
如果你把這些方法應用於自己的程式碼庫,請告訴我們!
鳴謝
感謝 Pedro Cuenca、Leandro von Werra、Benjamin Bossan、Sylvain Gugger 和 Loubna Ben Allal 協助撰寫本文。
來源:Hugging Face Blog · huggingface.co