Airbnb 如何以每項任務成本管理 Amazon Bedrock 上的編碼智能體
How Airbnb uses cost per task to operate coding agents on Amazon Bedrock
Airbnb 分享以每項任務成本評測及 Amazon Bedrock 的 CloudWatch 生產訊號,為編碼智能體選擇預設模型和推理強度上限。評測按未快取輸入、快取讀取、快取寫入及輸出 token 計價,並與延遲、輸出 token 數和節流情況對照。
文章把評測中的每項任務成本與上線後的用戶支出、請求量及配額指標連結,展示編碼智能體選型和容量管理的可操作方法。
Amazon Bedrock 透過共用 API 提供多間供應商的基礎模型,並由 AWS 管理模型基礎設施。它與 AWS 存取控制及監察功能整合,並在 AWS 內處理提示詞、程式碼和模型回應。
隨着編碼代理投入正式環境,模型和用量的變化可能影響延遲、容量和成本。Amazon Bedrock 在 Amazon CloudWatch 中的執行階段指標,有助團隊調查延遲上升、節流和 token 消耗變化。評估(evals)則補充這些營運指標,透過一組固定且具代表性的任務,評估代理的工作質素。
本文會介紹 Airbnb 如何評估編碼代理所用的模型,並監察這些模型在 Amazon Bedrock 上的使用情況。我們會説明每項任務成本如何引導模型選擇,以及生產環境數據如何協助我們在用量變化時重新檢視選擇。我們亦會介紹用來調查延遲、節流和支出的執行階段訊號。
在 Airbnb,每星期都有數以千計的工程師及工程相關人員使用 AirChat(我們用來執行編碼代理的內部工具)。代理透過我們的大型語言模型(LLM)閘道發出模型請求,而閘道在 Amazon Bedrock 上運行。Bedrock 在 AWS 內處理 Airbnb 的程式碼、提示詞和模型回應。約五星期內推出了八個新模型。到 10 月中旬,工程師透過編碼代理發出的請求中,約三分之二使用了這些新模型。
每次發布都可能同時改變輸出 token 數量、成本、延遲和容量,而隨模型發布的基準測試圖表,並不能反映模型如何處理工程師的工作。因此,我們會並行運作兩套系統。推出模型前,我們會以自己的任務進行評估,量度每個模型的評分和每項任務成本。每項任務成本是代理完成一項任務所用全部 token 的牌價成本。
推出模型後,可觀察性工具會顯示生產環境中有哪些變化。如果生產環境的用量與評估結果不符,我們便會查明原因。
解決方案概覽
你可以透過 CloudWatch 中 AWS/Bedrock 命名空間的幾項訊號,診斷大部分生產環境問題:
- 延遲:
InvocationLatency、TimeToFirstToken、OutputTokenCount,以及每秒輸出 token 數(OTPS);OTPS 需自行推算。 - 節流:
InvocationThrottles,以及每項請求會預留作抵扣配額的 token 數量;這項數據需由你自行發布。Bedrock 亦會發布EstimatedTPMQuotaUsage,用以量度所有推理 API(Converse、InvokeModel、ConverseStream和InvokeModelWithResponseStream)的預計每分鐘 token(TPM)配額消耗,其中包括快取寫入 token 和輸出消耗乘數。你可以利用這項指標,在達到配額上限前設定預警,追蹤各模型的配額消耗,並在用量受到速率限制前申請提高配額。 - 成本:
InputTokenCount(未快取的輸入)、CacheReadInputTokenCount、CacheWriteInputTokenCount和OutputTokenCount,每項均按各自費率計價。快取讀取的成本低於未快取的輸入,而快取寫入的成本則可能因應模型而較高。快取命中率下降可能會增加每項請求的成本。
除了這些指標,我們亦會加入每項任務成本。我們的評估會量度每個模型及每種允許使用的推理力度的評分和每項任務成本。推理力度是一項設定,用來控制模型在回應前進行多少推理。我們會根據結果選擇每項預設設定,即編碼工具預設使用的模型和推理力度,除非工程師另作選擇;亦會設定每個模型的推理力度上限,即我們允許該模型使用的最高推理力度。
架構
工程師會在 AirDev 工作區上執行 AirChat;這些工作區是雲端中的個人開發機器。他們亦可將工作交由 AirChat Remote 處理;它會在獨立的雲端工作區中執行雲端 Agent,讓工程師處理其他事情。兩種方式都會經由我們的 LLM 閘道連接至 Amazon Bedrock。
圖 1 展示 AirChat 和 AirChat Remote 如何透過我們的閘道連接至 Amazon Bedrock,亦展示評估和正式環境監察如何指引模型預設值和推理力度上限。
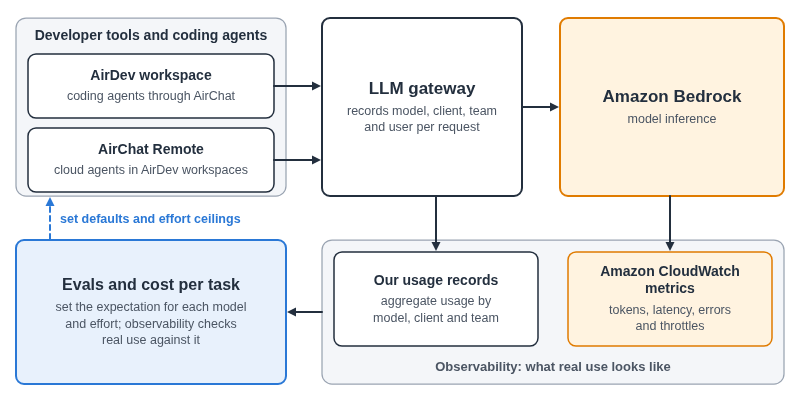
圖 1:編碼 Agent 和雲端 Agent 透過我們的 LLM 閘道呼叫 Amazon Bedrock。我們的使用記錄和 CloudWatch 指標反映實際使用情況,而我們會利用評估結果設定預設值和推理力度上限
閘道會記錄每個請求所用的模型、用戶端、團隊和用戶。我們只會以彙總方式使用這些記錄,作成本和容量規劃。CloudWatch 提供 token 數量、延遲、錯誤和節流數據。我們會比較這些正式環境訊號與評估分數及每項任務的成本,決定何時需要調整預設值或推理力度上限。
先決條件
在 AWS 方面,你需要:
- 存取你計劃執行和評估的 Amazon Bedrock 模型。如要查看各 AWS 區域的模型可用情況,請參閲 Amazon Bedrock User Guide 中的按模型列出的區域可用情況。
- 透過
ConverseStream或InvokeModelWithResponseStream發出的串流呼叫。Bedrock 只會為串流 API 發佈TimeToFirstToken。 - 在每個你會呼叫的 AWS 區域啟用模型調用記錄。此功能預設為關閉。記錄可能包含完整提示詞和回應,以及呼叫者的身分,因此應限制可讀取記錄的人員,並設定保留期限。
為呼叫者使用已加上標籤的 IAM 角色,並啟用成本分配標籤。請在開始收集前啟用標籤,因為啟用後不會補回較早的成本。
你亦需要自行準備三項資料:
- 一組取自自身工程工作的任務。每項任務都要有初始程式碼儲存庫狀態、工程師會撰寫的提示詞,以及你信任的評分器。評分器是為 Agent 的工作評分的程式或模型。我們會根據實際程式碼變更、這些變更的審核意見,以及原始工單未有明確説明的決策來建立任務。步驟 2 會展示其中一項。
- 一個置於 Bedrock 前端的閘道或代理伺服器,記錄每個請求所用的模型、用戶端、團隊、用戶和 token 數量。
- 一份列出你執行的每個模型公開牌價的表格,每項價格均註明日期,讓你能以相同基準計算評估 token 和正式環境 token 的成本。
推出前,先界定 Agent 可存取的內容,以及哪些操作需要人工審核。在隔離的工作區中執行程式碼,並在合併前測試生成的變更。Amazon Bedrock Guardrails 可協助過濾提示詞和回應中的有害內容及敏感資訊。對於根據所提供參考資料生成的回應,脈絡依據檢查可標示缺乏支持的主張。在自己的任務上測試這些控制措施,並將其延遲和成本納入測量。
操作示範
先量度完成一項任務的成本,再利用結果選擇模型預設值、檢查正式環境的運作情況、管理容量,以及將支出歸屬至相應項目。
步驟 1:完成一項任務的成本是多少?
編碼 Agent 需要發出多個請求才能完成一項任務,而模型每次處理請求時都會重新讀取截至當時的上下文。因此,我們會計算整項任務的成本。
Bedrock 會為每個請求列出四類 token:未快取的輸入、快取讀取、快取寫入及輸出。在一次評測中,我們會逐個請求計算這四類 token 的費用,再將該任務內各請求的費用加總。本文所有成本均採用該次執行當日的公開牌價。對於每個受測模型、推理力度及 Agent 用戶端,我們都會在評分旁列出平均成本,而平均值亦計入低分嘗試。
推理力度會同時影響評分和成本。在我們測試的一個模型上,將推理力度由低調至高,評分提高了 0.8 分,但每項任務的成本升至 2.5 倍。我們會根據這些結果設定推理力度上限,並由閘道強制執行。
第 2 步:評測新模型要多快?
新模型推出當天下午,我們只需向 Agent 發出一個請求,便會啟動評測活動,讓新模型通過所有任務套件的測試。每個套件都是一組固定的同類任務,我們共有七個套件。Agent 會將數百項任務分配到各個套件及數個雲端工作空間;評分器一完成評分,結果便會即時顯示。數小時內便有首批結果。翌日早上,每個套件都已有評分及每項任務的成本,我們也取得了為整個機構作出部署決定所需的資料。
這種速度有賴已經編寫好的任務。每項任務都存放在一個資料夾內,當中包含一次執行所需的一切。以下是我們機器學習工作中的一項精簡任務:
honest-holdout-bakeoff/
  instruction.md     what the agent is told
  task.toml          time limit, CPUs and memory
  environment/       Dockerfile for the sandbox
  tests/test.sh      runs the grader and writes the reward
  tests/grader.py    the checks
  solution/          a reference solution that must pass the grader

instruction.md (excerpt):
  We have two candidate models for a prediction task, and we need to
  know which one to ship.
  ...
  Then answer the question we actually have to decide: is either
  candidate worth rolling out over the system already in production?
評分器每次執行時都會根據固定資料重新計算正確答案,而 Agent 只有在所有檢查均通過時才會獲得 1 分獎勵。若要測試一個模型在每種推理力度下的表現,請在工作設定檔中將每種推理力度各自列為一個 Agent:
job_name: model-a-effort-sweep
n_attempts: 1                # one attempt per task at each effort
datasets:
  - path: tasks/ml           # each task brings its own grader
agents:
  - name: model-a-low
    model_name: vendor/model-a
    kwargs: {reasoning_effort: low}
  - name: model-a-medium
    model_name: vendor/model-a
    kwargs: {reasoning_effort: medium}
  - name: model-a-high
    model_name: vendor/model-a
    kwargs: {reasoning_effort: high}
兩個範例都採用 Harbor 的格式。Harbor 是一個用於在沙盒中執行 Agent 評測的開源框架。如果你剛起步,這是其中一個選擇。
評測執行方式還可以進一步優化。最難的是撰寫評分準則,也就是評分器遵循的評分指南。我們的長任務會分多輪進行,每輪之間都有一名模擬審核者提出質疑。模型評分器會按八個加權維度為每次執行評分,每個維度的分數為 0 至 3。
Correctness of delivery   25     Judgment                 10
Verification quality      15     Evidence and reporting   10
Autonomy                  15     Readability              10
Design and workload fit   10     Operational discipline    5

Ceiling: if the reviewer had to rescue the agent repeatedly
(autonomy 0 or 0.5), the total is capped at 25 of 100.
有了這類上限,需要救援的 Agent 不能單靠表達潤飾取得高分。
第 3 步:部署後要監察甚麼?
延遲上升時,在提交支援個案前,先繪製三項指標的圖表:TimeToFirstToken代表開始生成前的等待時間,OutputTokenCount代表回應長度,而 OTPS 代表生成速度。Bedrock 沒有原生 OTPS 指標。你可以按照 Amazon Bedrock User Guide 的説明,透過指標數學推導:
OTPS = OutputTokenCount / (InvocationLatency - TimeToFirstToken) * 1000在我們工作階段的例子中,延遲上升了 40%,但首個 token 時間和 OTPS 均維持不變。有人修改了系統提示詞,要求回答更加詳盡,令每個請求的輸出 token 數量上升了 50%。模型以相同速度生成內容,但回應更長。提示詞變更及模型升級都應視為部署,並在儀錶板上標示。
我們每星期都會並列查看每個模型的 CloudWatch 執行階段指標,以及閘道的用量記錄。為了規劃成本及容量,我們也會查看整體用量:每個請求的成本,以及每週每位用戶的平均請求數。新模型可能會影響這兩項數值。每次部署後,我們都會將它們與根據評測中每項任務的成本作出的預期比較。
第 4 步:評測結果理想,正式環境的表現又如何?
有一款模型,我們稱為 model A,在我們的評測中表現不錯。在編碼任務上,它的得分比我們之前表現最佳的模型高出三分以上。每項任務的成本大致相同,而且所有模型均由同一評分器評分。我們推出 model A,將 effort 上限設為 high,並要求大家大部分工作使用 low 或 medium。
推出數週後,我們按標價計算 model A 在正式環境中的用量成本,並檢視整體數據。model A 每名用戶的平均每週支出,是前一款模型的數倍。model A 每個請求的成本約為之前的三倍,而平均每名 model A 用戶發出的請求數量也約為之前的三倍。
輸出 token 只佔每個請求成本的十分之一。大部分成本來自快取中的上下文,而模型每次收到請求都會重新讀取這些內容。model A 可以長時間自主工作,因此用戶開始讓它進行長時間、自主執行的工作階段。
評測衡量模型完成一項任務的表現;正式環境衡量用戶選擇如何使用它。
後來,一款較新的模型在相同任務及評分器下取得比 model A 更高的分數,而每項任務的成本約為 model A 的六分之一。我們只需更改設定,便把 model A 的用戶轉移至這款新模型。
接着,我們針對同一用戶羣組(即 model A 的重度用戶)檢視整體變化。在使用新模型的首個完整星期,該羣組向其主要模型發出的請求數量大致相同,而在該模型上的支出降至約七分之一。
第 5 步:為何你會遭限流,以及流量接下來會流向何處
在 bedrock-runtime 端點上,請求抵達時,Bedrock 會先檢查你的每分鐘 token 配額,然後模型才會開始輸出內容。它會預留未快取的輸入 token、快取寫入所需的 token,以及 max_tokens(即該請求獲準輸出的 token 上限)。模型生成內容時,Bedrock 會調整這項預留,並在請求完成結算後退回未使用的部分。快取讀取從不計入配額,因此某個請求在配額上的消耗可能很低,帳單成本卻可能很高。大部分模型的輸出 token 會按 1:1 的扣減率結算;部分現有模型的扣減率則高出數倍,因此請查看你所用模型的扣減率。
顯示已計費 token 的儀錶板,可能會在請求正遭限流時,仍顯示尚有餘量。以我們這個工作階段的例子來説,每分鐘配額為 1 million tokens,流量為每分鐘 300 個請求。儀錶板顯示配額只用了約 30%。套用 5:1 的輸出 token 扣減率後,已完成的請求實際消耗約 77% 配額。
接納請求時採用不同的計算方式。每個請求最初會預留 600 個未快取輸入 token,另加上限設為 4,096 的 max_tokens,合共 4,696 個 token。在 p99 水平,回應長度約為 800 個 token。
將 max_tokens 下調至 1,024,會令初始預留量降至 1,624 個 token,減少約 65%。該上限仍高於 p99 水平。輸入及輸出維持不變時,最終的配額消耗也會維持不變。較小的預留量可騰出更多空間接納請求。請監察 stopReason,以識別遭截斷的回應。使用退避及隨機抖動,並為重試次數設上限。
需求亦可能超出任何單一模型可用的餘量。你需要預先知道工作可以分流至何處,而我們的評測能回答這個問題。答案可能是來自另一個模型系列的模型。對於我們使用的每款主要模型,我們至少會保留一款等效模型;它在我們的評測中表現同樣出色,而且可以透過負載平衡分流至該模型。沒有這些評測,要決定工作分流至何處就只能靠猜測。
如果模型的容量餘裕仍然緊張,我們可以更改設定中的預設值,重新分配流量。首先,確認對應模型有能力承接額外負載,而且你的配額足以應付。也要確保該模型有足夠流量,以維持存取權:模型進入 Legacy 期間後,現有客戶如有 15 天沒有使用,可能會失去存取權。Legacy 模型會一直運作至生命週期結束;此後,Bedrock 會在所有 Region 移除該模型,對該模型的請求會失敗,而 Bedrock 不會自動轉移你的流量。當LegacyModelInvocations升至零以上時發出警報。
步驟 6:這筆開支屬於誰?
Bedrock 執行階段指標按ModelId劃分,因此你可以查看哪個模型處理了請求,卻無法得知是哪個團隊發出請求。Bedrock 發佈的指標包含及不包含ModelId維度;如果請求在 Bedrock 解析出模型前便失敗,就只會出現在不含該維度的指標序列中,因此按ModelId篩選會低估錯誤數量。Bedrock 提供三種方法歸因開支:
- 哪個團隊或用戶?Bedrock 會記錄每個請求的呼叫者 IAM 身分。為角色加上標籤,或傳入工作階段標籤,即可在 AWS Cost Explorer 和 AWS Cost and Usage Report(CUR 2.0)中查看各標籤的成本。
- 哪個應用程式?應用程式推論設定檔以模型為單位,因此請為每個應用程式和模型建立一個帶有標籤的設定檔,並呼叫相應設定檔的 ARN。
- 哪項功能或提示詞?呼叫
Converse時,在requestMetadata中傳入鍵值對。Bedrock 會將這些資料寫入模型呼叫記錄,不會將其列入帳單。如要計算成本,請將記錄中的 Token 數量乘以已公佈的費率。傳統 CUR 和 CUR 2.0 均不包含每個請求的 ID,因此請按模型、用量類型和時段比較總數,將兩者對帳。
如果透過閘道呼叫,Bedrock 看到的會是閘道的角色,因此應讓閘道為每位用戶各自承擔一個帶有專屬RoleSessionName或工作階段標籤的角色。請為該工作階段快取這些憑證,因為每個請求都承擔一次角色,可能會超出 AWS Security Token Service(AWS STS)的速率配額。歸因功能失效時,請求仍會成功,因此當 Bedrock 無法傳送模型呼叫記錄時,請設定警報。
我們的用量記錄可按模型、用戶端、團隊和用戶歸因用量;我們只會以彙總方式使用這些資料,作成本和容量規劃。我們會根據同一組四項 Token 數量計算每項工作的成本,以便比較評測與正式環境的 Token 組成和成本。
結果
我們可以在一夜之間,從模型推出進展到部署決策。一次推出後,模型 A 的每位用戶每週平均開支,是上一個模型的數倍。我們將高用量用戶轉移到較新的模型。在第一個完整星期,該組在主要模型上的開支降至約七分之一,而請求數大致相同。對於每個主要使用的模型,我們的評測都能找出可重新分配流量至的對應模型。
清理
測試完成後,請停止已啟動的評測工作和 Agent 程序。如果只為本指南啟用模型呼叫記錄,請使用 DeleteModelInvocationLoggingConfiguration,在每個 Region 停用記錄功能。
呼叫者不再使用已建立的應用程式推論設定檔後,請使用 DeleteInferenceProfile 刪除。移除只為本指南建立的 IAM 角色、政策和資源標籤。停用只供這些測試使用的成本分配標籤。刪除不再需要的測試 CloudWatch 日誌羣組和 S3 日誌物件。
結論
每次推出模型時,我們都會進行四項檢查:
- 發布當日:以每種推理力度,使用新模型執行你自己的任務,並記錄每項任務的評分和成本。
- 推出前:根據這些數據選擇預設推理力度並設定上限。停用任何成本較高、評分卻低於較低推理力度的設定。
- 首幾週:比較每次請求的成本和每位用戶的平均請求次數,以及評測中的每項任務成本;兩者均按相同的四種 token 數量計算價格。
- 在需要之前:找出哪些模型系列中的模型在你的評測中取得相同評分,並在重新平衡前檢查其容量和你的配額。
我們選用 Amazon Bedrock,因為它讓我們透過一個 API 使用多個模型系列。這讓我們可以沿用現有的 AWS 存取控制和記錄功能,同時由 AWS 管理模型基礎設施。我們使用評測為工作選擇模型,並透過可觀測性掌握何時需要重新檢視這些選擇。
如要進一步瞭解,請參閲《Amazon Bedrock User Guide》中的以下頁面:
關於作者

Alan Yao
Alan 是 Airbnb 的資深軟件工程師,負責領導 AI 輔助工程的模型評測工作。他建立評測工具,以衡量各模型每項任務的評分和成本。Airbnb 利用這些評測,為工程師選擇預設使用的編碼模型和推理力度。

Rashim Gupta
Rashim 是 Amazon Bedrock 團隊的產品管理高級經理。他的團隊負責開發 Web Search、Observability、Spend Control 和 Governance 等服務功能。

Jayadev Vadakkanmarveettil
Jayadev 是 Amazon Bedrock 團隊的首席產品經理。他負責推動增長的項目,並主管配額和容量管理方面的產品體驗。

Sang Kong
Sang 是 AWS 的首席解決方案架構師。他協助策略性客戶部署具可擴展性、韌性和成本效益的解決方案。他常駐北加州,喜歡與家人遠足,也喜歡創作氛圍音樂音景。
來源:AWS Machine Learning Blog · aws.amazon.com