Amazon SageMaker AI 即時端點新增 KV-aware routing
Amazon SageMaker AI real-time endpoints now support KV cache aware routing
Amazon SageMaker AI 即時端點新增 KV-aware routing,根據模型容器回報的 KV cache 狀態,把請求路由至持有最長匹配快取且負載未過高的實例。
文章比較 KV-aware routing 與 prefix-aware routing 的路由依據,並以長對話工作負載的測試呈現延遲、吞吐量及快取命中率變化。
今天,Amazon SageMaker AI 推出 KV 快取感知路由(KV-aware routing),這是一種適用於即時端點的新路由策略。它會使用模型容器回報的快取狀態,並將每個請求送往已快取與其提示詞長前綴相符內容、而且負載不過高的執行個體。這項策略適合為多輪對話、共用長提示詞或高負載情境提供大型語言模型(LLM)服務的團隊。你只需在兩處啟用這項功能:為模型新增一個環境變數,讓容器回報其快取內容;並在端點設定中將 RoutingStrategy 設為 KV_AWARE。用戶端仍可使用原有的 API 呼叫端點。
這項功能要解決的問題如下:聊天助理、檢索增強生成(RAG)及使用長系統提示詞的 Agent 等 LLM 應用程式,會傳送許多開頭文字相同的請求。模型會將處理提示詞的結果保留在 GPU 記憶體的 KV 快取中;如果相同的開頭再次送到同一個執行個體,模型便可略過這部分工作。在本系列第 1 部分中,我們介紹了 Amazon SageMaker AI 的前綴感知路由,它會將開頭相同的請求送往同一個執行個體。前綴感知路由只根據請求推斷前綴快取的位置,因此無法得知執行個體是否已清除該快取。
前綴感知路由只根據請求選擇執行個體。它會對請求開頭進行雜湊,最多取你設定的 PrefixLength(InvokeEndpoint 負載的位元組數;若使用 OpenAI 相容的 Chat Completions API,則取訊息文字的字元數),並將開頭相同的請求送往同一個執行個體。它無法得知執行個體實際快取了哪些內容。當每個請求都以相同的共用文字開頭時,這種方法效果良好;但在以下兩種情況下,效果較差:
執行個體上的快取會隨時間改變。GPU 記憶體用滿時,執行個體會清除較舊的 KV 快取項目,但路由器仍會將匹配的請求送往該執行個體,彷彿快取仍然處於熱狀態。
對話開始時內容較短。在多輪聊天中,每一輪都會增加對話記錄。只要請求長度仍短於 PrefixLength,每一輪新增內容都會改變路由器進行雜湊的文字,因此下一輪可能會送到不同於先前快取對話內容的執行個體。只有當請求長度超過 PrefixLength 後,對話各輪才會維持在同一個執行個體上。
本文將説明 KV 快取感知路由的運作方式、適用情境,以及如何在單一模型端點和推理元件端點上啟用、呼叫及驗證這項功能。
KV 快取感知路由的運作方式
KV 快取感知路由分為三個部分:模型容器回報已快取的內容;SageMaker AI 為端點維護受管理的快取索引,以記錄該狀態;端點則使用這個索引,為每個請求選擇執行個體。
當你透過 SM_VLLM_KV_EVENTS_CONFIG 啟用事件後,容器每次儲存或淘汰快取項目時,都會發佈 KV 快取事件,而 SageMaker AI 會使用這些事件,讓索引保持最新。索引只保存指標:快取內容經單向截斷後的雜湊值,每個雜湊值均對應至存有該內容的執行個體或推論元件副本。索引絕不會儲存提示詞、token ID、請求酬載或 KV 張量。收到請求時,端點會將提示詞切分成 token,並在索引中查找這些 token。索引會傳回快取中存有部分提示詞的執行個體或推論元件副本,以及各自存有多少提示詞內容。例如,如果執行個體 A 快取了某段對話的開頭,該對話的下一輪便會傳送至 A。由於索引是按 token 而非固定的位元組數進行比對,多輪對話歷史隨着內容增加,仍可完整匹配。即使請求只有部分提示詞相同,仍會傳送至匹配內容最長的執行個體。
接着,端點會權衡各候選項快取的提示詞內容有多少,以及其繁忙程度,然後從中選擇。如果候選項過於繁忙,便會略過。因此,即使匹配內容最長的執行個體正忙碌,請求仍會傳送至下一個最合適且可用的執行個體。如果沒有候選項有實用的匹配內容,或所有候選項都繁忙,請求便會改用負載感知路由,如「路由開銷與後備方案」一節所述。你無須像使用前綴感知路由時那樣設定並行處理閾值。索引也會配合執行個體集羣變化。縮減規模時,已移除執行個體的項目會從索引中刪除。擴展規模或更新取代執行個體時,新執行個體的快取會是空的,因此短時間內延遲可能會較高。
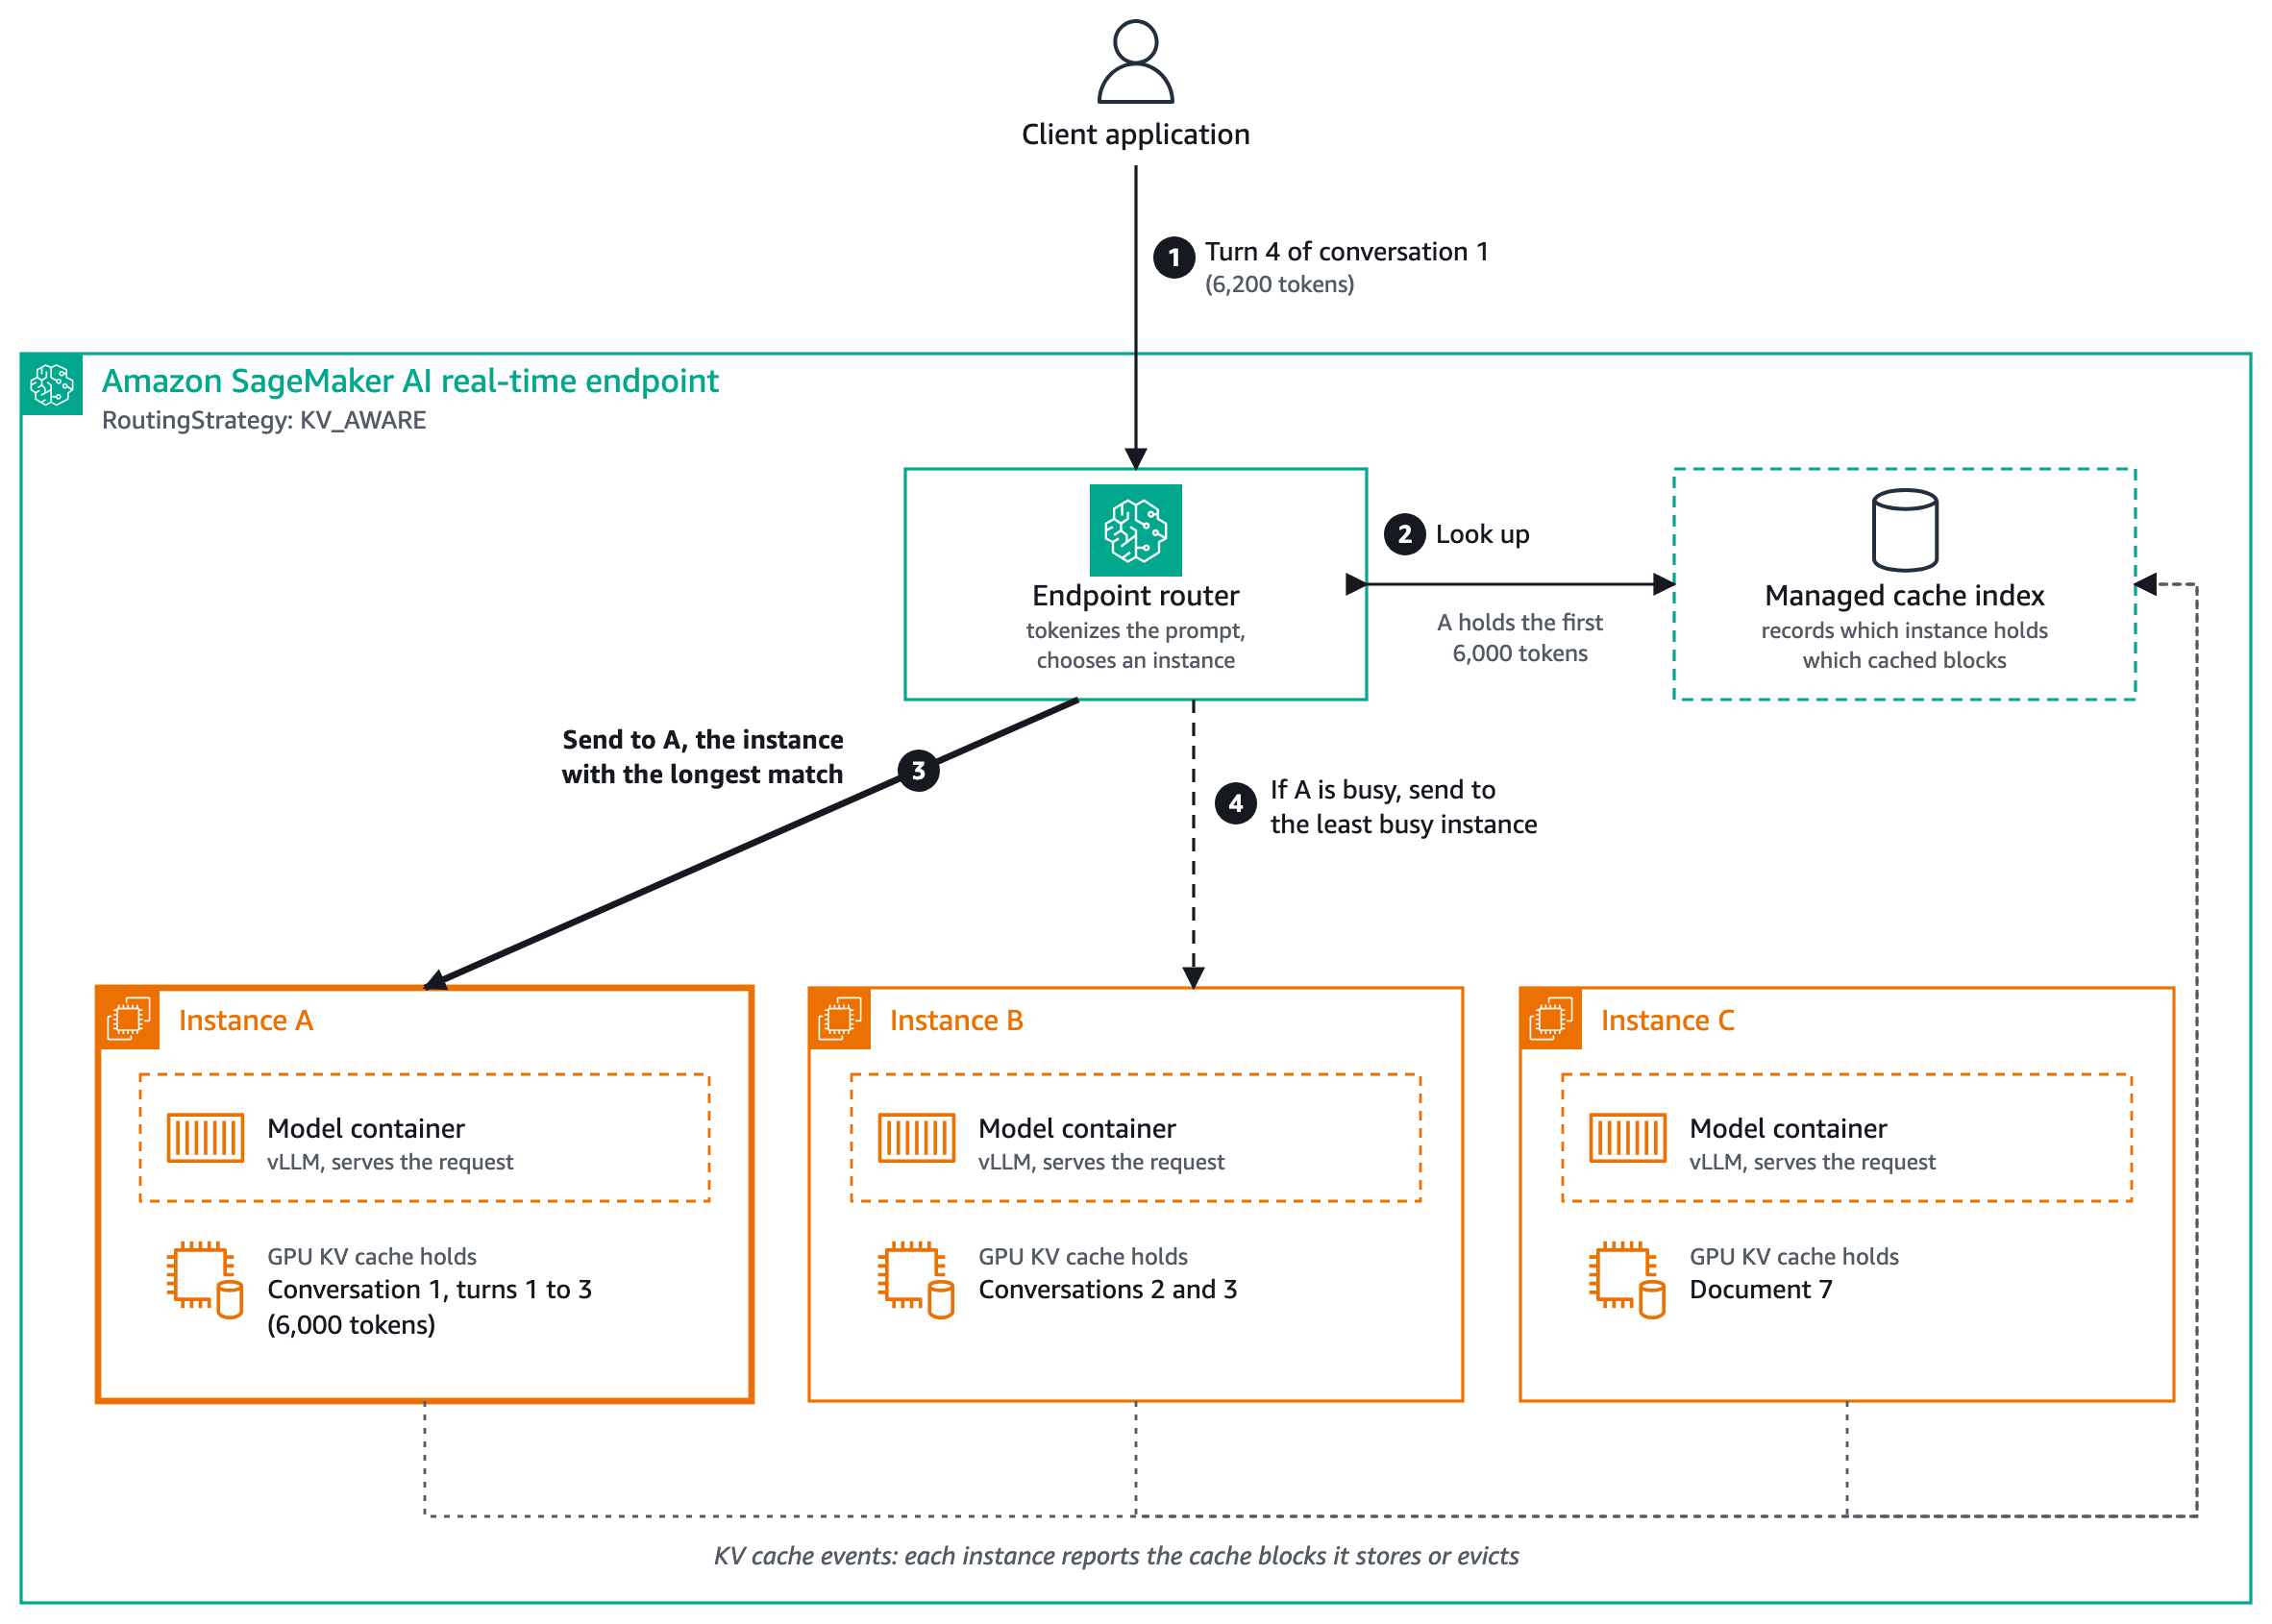
圖 1:SageMaker AI 端點上的 KV 感知路由。路由器會查詢受管理的快取索引,並將請求轉送至存有最長匹配快取內容的執行個體。每個執行個體都會將 KV 快取事件回報至索引
在圖 1 中,端點有三個執行個體:A、B 和 C。每個執行個體都在自己的模型容器中執行相同模型(即「要求與限制」一節所列的 AWS vLLM Deep Learning Container),並在 GPU 記憶體中擁有自己的 KV 快取,因此各執行個體快取的內容各不相同:A 保存對話 1 的第 1 至 3 輪,B 保存對話 2 和 3,而 C 保存文件 7。當對話 1 的第 4 輪送達時(步驟 1),路由器會將其切分成 token,並在受管理的快取索引中查找(步驟 2)。索引顯示,A 保存了該請求 6,200 個 token 中的前 6,000 個,因此路由器會將請求傳送至 A(步驟 3),而 A 只需計算其餘 token。如果 A 正忙碌,路由器便會改為將請求傳送至最不繁忙的執行個體(步驟 4)。KV 感知路由需要有可供選擇的目的地,因此只有在至少有兩個執行個體,或至少有兩個推論元件副本時才會啟用。只有一個執行個體時,每個請求都會傳送至該執行個體,設定不會產生作用。
SageMaker AI 上的路由策略
隨着此功能推出,SageMaker AI 為即時端點提供四種路由策略。你可以在端點設定中的 RoutingConfig,為每個生產變體設定策略。
| 策略 | 路由方式 | 建議用途 |
| RANDOM(預設) | 將每個請求傳送至隨機選取的執行個體。 | 適用於一般用途工作負載、非 LLM 模型,以及彼此可互換的請求。 |
| LEAST_OUTSTANDING_REQUESTS | 將每個請求傳送至目前處理中請求數量最少的執行個體。 | 適用於處理時間各異,而且希望所有執行個體保持同等繁忙的工作負載。 |
| PREFIX_AWARE | 將共用相同提示詞前綴(最多至 PrefixLength)的請求傳送至同一個執行個體。達到 ConcurrencyThreshold 時,溢出的請求會轉送至另一個執行個體。 | 適用於請求開首固定位置包含共用文字的 LLM 工作負載,並可使用任何支援前綴快取的推理框架。 |
| KV_AWARE(新) | 根據容器回報的快取狀態,將每個請求傳送至持有相符快取前綴的執行個體,並權衡相符長度與負載。若無法匹配,則改用負載感知路由。 | 適用於在支援的容器上執行的 LLM 工作負載,包括多輪對話、快取頻繁遭到清除,或請求開首隻有部分內容相同的情況。 |
前綴感知或 KV 感知
兩種策略都會將請求傳送至可能已快取其前綴的位置。兩者的分別在於如何判斷快取位置,以及對容器的要求。
| 前綴感知路由 | KV 感知路由 | |
| 快取位置的來源 | 根據請求前綴推斷 | 容器回報的快取狀態 |
| 每個請求增加的延遲 | 第 1 部分為 1.3–1.9 毫秒 | 短提示詞需時數毫秒,長提示詞則更久,主要耗時在 token 化 |
| 匹配方式 | 前 PrefixLength 個位元組(Invoke API)或字元(OpenAI 相容 API) | tokens,最長的快取匹配 |
| 參數 | PrefixLength、ConcurrencyThreshold | 無須設定 |
| 容器 | 任何已啟用前綴快取的容器 | 支援的容器,並已啟用前綴快取及 KV 快取事件(請參閲 Requirements and limits) |
| 請求 payload | 任何格式 | OpenAI 相容的 Completions 或 Chat Completions 格式 |
效能
我們以兩種方式比較 KV 感知路由與隨機路由:在生產規模的執行個體上進行大型基準測試,以及進行較小型、可重現的比較。你可按照「驗證 KV 感知路由是否正常運作」中的步驟進行。
基準測試結果
在使用 Llama 3.1 70B Instruct、部署於七個 ml.p5.48xlarge 執行個體的基準測試中,我們進行了 30 分鐘測試,由 20 或 100 名模擬用戶進行多輪對話及文件問答,提示詞長度最多約 64,000 tokens。與隨機路由相比,在負載較高且提示詞較長時,KV 感知路由最多可將 p50 首個 token 時間(TTFT)縮短 97%,並將吞吐量提高 234%。KV 快取命中率則由 3–48% 提高至 80–93%。即使負載較低,長提示詞也有改善。短提示詞的增益最小,因為可節省的預填充處理較少。實際結果視乎你的工作負載而定。如要量度自身流量的效果,請按照「驗證 KV 感知路由是否正常運作」中的檢查步驟進行。
路由開銷與後備處理
端點在路由請求前,會先將提示詞轉換為 tokens,並在受管理的快取索引中查找。短提示詞的查找需時數毫秒,長提示詞則更久,主要耗時在 token 化;不過,與快取命中所節省的時間相比,這段時間仍然很短。對於使用標準選項的純文字請求,端點計算出的 tokens 會傳送給模型,因此不會重複轉換提示詞。
如果查找速度較慢、找不到有用的匹配項,或所有匹配的執行個體都繁忙,端點便會使用負載感知路由來傳送請求,行為與 LEAST_OUTSTANDING_REQUESTS 策略相同。請求仍會獲得處理,但無法享有快取帶來的效益。如果端點無法將請求切分為 token,也會採用相同的回退方式,但在「呼叫端點」一節所述的兩種錯誤情況除外。這些回退情況在推出時不會顯示於 SageMaker AI 主控台或指標中,因此請使用「確認 KV 感知路由是否正常運作」一節中的檢查方法,確認路由對你的流量有效。
提示詞非常短時,可節省的預填充運算較少,因此前綴感知路由可能已足夠。
何時使用 KV 感知路由
前綴感知路由無須變更容器,但無法得知執行個體實際持有的內容。KV 感知路由會向容器查詢其持有的內容,因此更精準。當有大量快取上下文可重用,而快取又面臨壓力時,KV 感知路由便能發揮作用:例如提示詞很長、負載很高,以及執行個體的 GPU 記憶體不足以容納 KV 快取。發生這種情況時,容器會逐出最近最少使用的快取部分,包括共用提示詞和對話記錄中的部分內容。
例如,某個支援助理運行於三個執行個體上,而每段對話都以相同的 6,000-token 知識庫摘錄開頭。對話 1 在執行個體 A 上開始,A 會快取該摘錄。流量上升後,A 的記憶體不足,容器便逐出該摘錄的大部分內容。執行個體 B 最近處理了另一段使用相同摘錄的對話,仍保留其頭 4,000 個 token。當對話 1 的下一輪訊息到達時,前綴感知路由會再次將它傳送至 A,由 A 重新計算該摘錄。使用 KV 感知路由時,A 的容器已回報逐出情況,因此索引會顯示 B 持有最長的匹配內容,請求便會傳送至 B,由 B 只重新計算剩餘的 token。在低負載時,A 不會逐出任何內容,而兩種策略都會將請求傳送至 A,並使用完整的快取。
當請求重用快取上下文的方式無法由固定長度的前綴涵蓋時,KV 感知路由最能發揮作用:
多輪對話: 每一輪都會傳送完整的對話記錄,因此快取前綴會隨輪數增加。KV 感知路由會匹配整段已快取的對話記錄,並將每段對話固定路由至持有相關內容的執行個體。對話越長,這一點越重要。受管理的快取索引反映逐出情況後,路由器就不會繼續將對話傳送至已經刪除其快取的執行個體。
具有共用上下文的高吞吐量推理: RAG 應用程式會在提示詞前置加入擷取到的文件,而助理則會在每個請求中傳送冗長的系統提示詞。當這些提示詞很長且執行個體面臨記憶體壓力時,KV 感知路由便很合適。如果共用前綴穩定且負載適中,前綴感知路由也很合適。請將共用內容放在最前面,並保持順序相同:如果相同文件的排列順序不同,提示詞的開頭便不再相同,因此無法匹配。
難以調校前綴長度的工作負載: 使用前綴感知路由時,你需要選擇一個 PrefixLength,既涵蓋共用文字,又避免將本應留在一起的請求分散開來。KV 感知路由無須調校前綴長度,因為它會根據實際快取的內容進行匹配。
如果你的請求開頭有相同且穩定的系統提示詞或文件、提示詞較短,或負載中等,前綴感知路由便是合適的選擇,而且無需更改容器。在這些情況下,執行個體有足夠的 GPU 記憶體來保留共用文字的快取,因此兩種策略都能找到這些內容。如果你的容器不受 KV 感知路由支援,前綴感知路由同樣是合適的選擇,因為只要容器啟用了前綴快取便可使用。如果你的請求較短且可以互換,或你的模型不是 LLM,可重用的快取上下文很少,因此請使用 RANDOM 或 LEAST_OUTSTANDING_REQUESTS。
如果你不確定哪種方式較合適,可以先使用前綴感知路由,將自己的流量傳送至 KV_AWARE 端點,並按照「確認 KV 感知路由正常運作」一節所述,比較首個 token 所需時間、吞吐量和命中率。
要求和限制
啟用 KV 感知路由前,請確認你的容器、端點和請求符合以下要求:
容器: 推出時,KV 感知路由支援適用於 SageMaker AI 的 AWS vLLM Deep Learning Container:包含 vLLM 0.33.0 或更新版本的映像,或 Amazon Linux 組建 server-sagemaker-cuda-v2.8.0 或更新版本。必須啟用前綴快取(預設為啟用),並使用 SM_VLLM_KV_EVENTS_CONFIG 環境變數開啟 KV 快取事件,做法見「如何啟用」。SageMaker AI 不會代你設定此項目。
端點和執行個體: GPU 執行個體類型上的即時單一模型端點和推論元件端點,包括動態低秩適配(LoRA)適配器。你亦可使用 AWS CloudFormation 設定 KV 感知路由。單一模型端點至少要有兩個執行個體,或推論元件至少要有兩個副本(可位於同一執行個體),路由才會啟用。數量較少時,你仍可設定 KV_AWARE,端點亦不會因此遭拒;但每個請求都會傳送至唯一的執行個體或副本。
請求: 使用 InvokeEndpoint、InvokeEndpointWithResponseStream 或 SageMaker AI OpenAI 相容的 Chat Completions API 傳送 OpenAI 相容的 Completions 或 Chat Completions 承載內容。不支援 InvokeEndpointWithBidirectionalStream。如果你設定 model 欄位,其值必須與 SM_VLLM_MODEL 相同。
SDK 版本: 追蹤 KV 快取命中率所需的詳細可觀測性功能,需要 AWS Command Line Interface (AWS CLI) 2.35.6 或更新版本,或 Boto3 1.43.31 或更新版本。
SageMaker AI 會在端點開始處理流量前檢查這些要求。如果檢查失敗,請求或部署便會失敗,並顯示説明缺少項目的訊息。如需設定、驗證行為和配額的完整清單,請參閲 SageMaker AI 文件。
如何啟用
你需要在兩處啟用 KV 感知路由:模型和端點設定。範例筆記簿會完整執行所有步驟,適用於單一模型端點和推論元件端點。
1. 在模型中開啟 KV 快取事件 – 建立模型時,請在容器環境中加入 SM_VLLM_KV_EVENTS_CONFIG。若未設定此項目,端點便沒有可用來進行路由的快取狀態。此設定中的連接埠只在執行個體內部使用,因此無須向網絡開放。
"Environment": {
    "SM_VLLM_MODEL": "<model-id-or-/opt/ml/model>",
    "SM_VLLM_KV_EVENTS_CONFIG": "{\"enable_kv_cache_events\": true, \"publisher\": \"zmq\", \"endpoint\": \"tcp://*:5557\", \"topic\": \"kv-events\", \"replay_endpoint\": \"tcp://*:5658\"}"
}
2. 在端點設定中選擇 KV 感知路由 – 在生產變體的 RoutingConfig 中,將 RoutingStrategy 設為 KV_AWARE:
"RoutingConfig": {
    "RoutingStrategy": "KV_AWARE"
}
如果你的容器映像是為 CUDA 13 建置,亦請在生產變體中將 InferenceAmiVersion 設為支援該版本的 AMI,例如 al2023-ami-sagemaker-inference-gpu-4-1。否則容器可能無法啟動。請參閲推論 GPU 驅動程式。
確認帳戶的端點配額足以應付所選的執行個體類型和數量,如有需要,請申請增加 Service Quotas 配額。
同一個 RoutingConfig 設定亦適用於推理元件端點,包括動態 LoRA 配接器。對於配接器,KV 感知路由會在已載入該配接器的執行個體中作出選擇。
呼叫端點
呼叫端點的方式不變。在請求本文中傳送包含 InvokeEndpoint 的 Chat Completions 請求內容,或包含 InvokeEndpointWithResponseStream 和 "stream": true 的請求內容:
{"messages": [{"role": "user", "content": "What is your return policy?"}]}你亦可透過 SageMaker AI OpenAI 相容的 Chat Completions API,使用 OpenAI Python 用戶端呼叫端點。GitHub 上的透過 SageMaker AI 使用 OpenAI 相容 API筆記本示範瞭如何呼叫單一模型端點和推理元件。
KV 感知路由不會套用第 1 部分介紹的多租戶前綴隔離:它會忽略前綴感知 ID 標頭和 prompt_cache_key 欄位。若請求將頂層 cache_salt 欄位設為非 null 值,系統會以 400 錯誤拒絕該請求。
KV 感知路由新增了兩種錯誤情況:如果請求的 model 欄位指定了容器未提供服務的模型,請求便會失敗並出現 ModelError;如果請求的 cache_salt 為非 null 值,系統便會以 400 錯誤拒絕該請求。推理本身的錯誤仍會照舊返回,而 Amazon CloudWatch 中模型容器本身的日誌則有助你找出原因。端點不會將 KV 感知路由決策的日誌傳送至你的帳戶,因此請使用「驗證 KV 感知路由是否正常運作」一節中的檢查方式,例如每個請求的 cached_tokens 和 KV 快取命中率,瞭解路由的運作情況。
驗證 KV 感知路由是否正常運作
KV 感知路由不會新增自己的指標,因此你需要檢查它對模型的影響。你可以透過以下三種方式進行檢查。
檢查每個請求的快取命中 – 容器預設不會回報提示詞 token 詳情,因此請在模型環境中將 SM_VLLM_ENABLE_PROMPT_TOKENS_DETAILS 設為 true。之後,每個回應都會包含 usage.prompt_tokens_details.cached_tokens,即由 KV 快取提供的提示詞 token 數量。當你傳送後續回合,或傳送以與先前請求相同內容開頭的另一個請求時,非零值表示請求已到達一個儲存了該前綴的執行個體。
在 Amazon CloudWatch 中檢查模型指標 – 建立端點設定時加入 --metrics-config '{"EnableDetailedObservability": true}',即可啟用詳細可觀測性;請使用「要求與限制」一節所列的 SDK 版本。SageMaker AI 隨即會發佈模型容器的指標,包括 KV 快取命中率和 TTFT。請按照使用 PromQL 進行詳細可觀測性中的説明查詢這些指標。
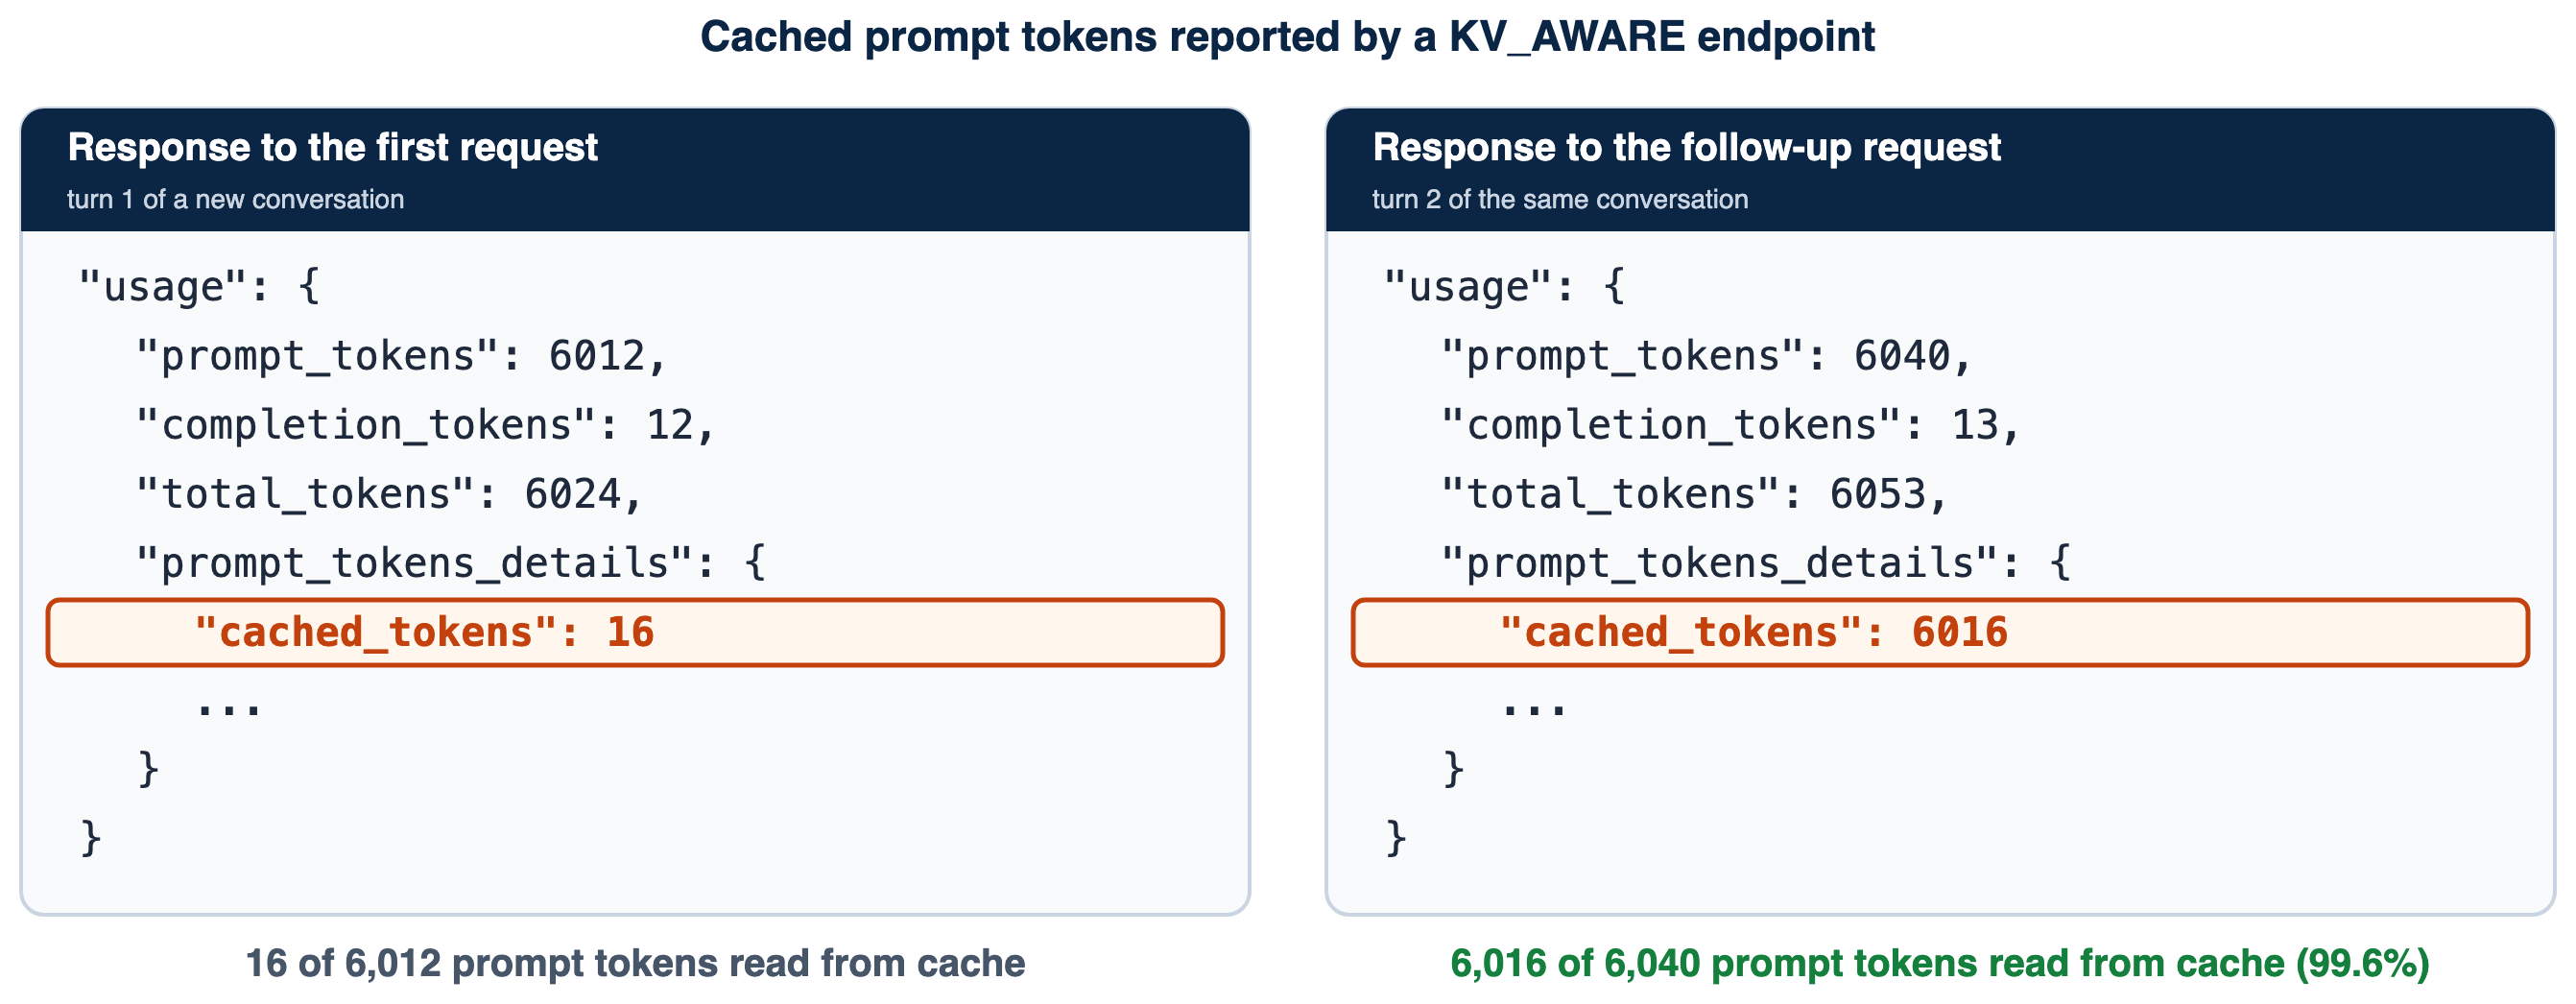
圖 2:驗證 KV 感知路由。(a) 後續請求顯示,大部分提示詞 token 均由 KV 快取提供。(b) SageMaker AI Insights 儀錶板中同一端點的 KV 快取命中率
與原本會採用的策略比較 – 對大部分 LLM 工作負載而言,實際上是在 KV_AWARE 和 PREFIX_AWARE 之間作出選擇,因此請比較這兩種策略,並加入 RANDOM 端點作為基準。每個端點使用相同的模型、執行個體類型和執行個體數量,並在相同並行程度下傳送相同提示詞,維持相同時間,確保唯一差異是路由策略。測試時,請按照正式環境流量的方式重用上下文,例如使用多輪對話或共用文件。如果 KV_AWARE 和 PREFIX_AWARE 在你的流量下表現相若,前綴感知路由會是較簡單的選擇。
作為這項比較的例子,我們在一個小型端點上比較了 RANDOM 和 KV_AWARE。我們向兩個端點發送相同的多輪工作負載,兩者的差異只有路由策略。每個端點都有兩個 ml.g5.xlarge 執行個體,在支援的容器上提供 Qwen3-4B-Instruct-2507 服務。每次測試發送 128 個請求:32 名模擬用戶,每人就一份文件提出 4 個問題;文件從 12 份約 7,400 個 token 的文件中選取。每個問題都會重新發送截至當時的對話內容,因此第一個問題之後的每個問題都可以重用快取的上下文。我們進行了兩組測試,每組包含兩次測試;第 1 組先使用 RANDOM,第 2 組先使用 KV_AWARE。每組都使用新的文件,讓兩個端點一開始的快取均為空。表 1 以第 1 組 / 第 2 組的形式顯示結果。
| 指標 | RANDOM | KV_AWARE |
| CloudWatch ModelLatency 平均值 (ms) | 4,124 / 5,100 | 1,235 / 1,314 |
| CloudWatch ModelLatency p50 (ms) | 3,153 / 4,083 | 656 / 700 |
| CloudWatch ModelLatency p90 (ms) | 8,334 / 10,746 | 3,213 / 3,535 |
| CloudWatch ModelLatency p99 (ms) | 17,779 / 16,249 | 6,876 / 7,238 |
| 問題 2–4 的首個 token 時間 p50 (ms) | 1,284 / 1,632 | 237 / 245 |
| 問題 2–4 的首個 token 時間 p90 (ms) | 5,039 / 6,101 | 456 / 367 |
| 所有請求的首個 token 時間 p90 (ms) | 5,003 / 5,683 | 1,465 / 1,759 |
| 由快取提供的提示詞 token 比例 | 0.761 / 0.701 | 0.903 / 0.903 |
| 測試時間 (s) | 31.1 / 36.9 | 17.9 / 18.0 |
| CloudWatch OverheadLatency 平均值 (ms) | 13.1 / 8.1 | 27.1 / 27.5 |
表 1:相同工作負載下的 RANDOM 和 KV_AWARE 路由。每個儲存格顯示第 1 組 / 第 2 組的結果。ModelLatency 和 OverheadLatency 是端點的 Amazon CloudWatch 指標。客戶端測量首個 token 時間和測試時間。快取比例是一次測試中 cached_tokens 的總和除以 prompt_tokens 的總和
在兩組測試中,KV_AWARE 的 CloudWatch ModelLatency 都較低(平均值分別為 1,235 和 1,314 ms,對比 4,124 和 5,100 ms),問題 2–4 的首個 token 時間也較短(p50 分別為 237 和 245 ms,對比 1,284 和 1,632 ms)。它的快取比例也較高,兩組測試均為 90 percent,對比 76 和 70 percent。使用 KV_AWARE 時,OverheadLatency 平均高出 14 至 19 ms;這是 SageMaker AI 在模型容器之外所花的時間。這次測試只涉及一個模型、一種執行個體類型,以及一個包含長篇共用文件的工作負載,因此請按本節前文所述測量自己的流量。圖 3 顯示 SageMaker AI 主控台為這兩個端點提供的模型延遲圖表。
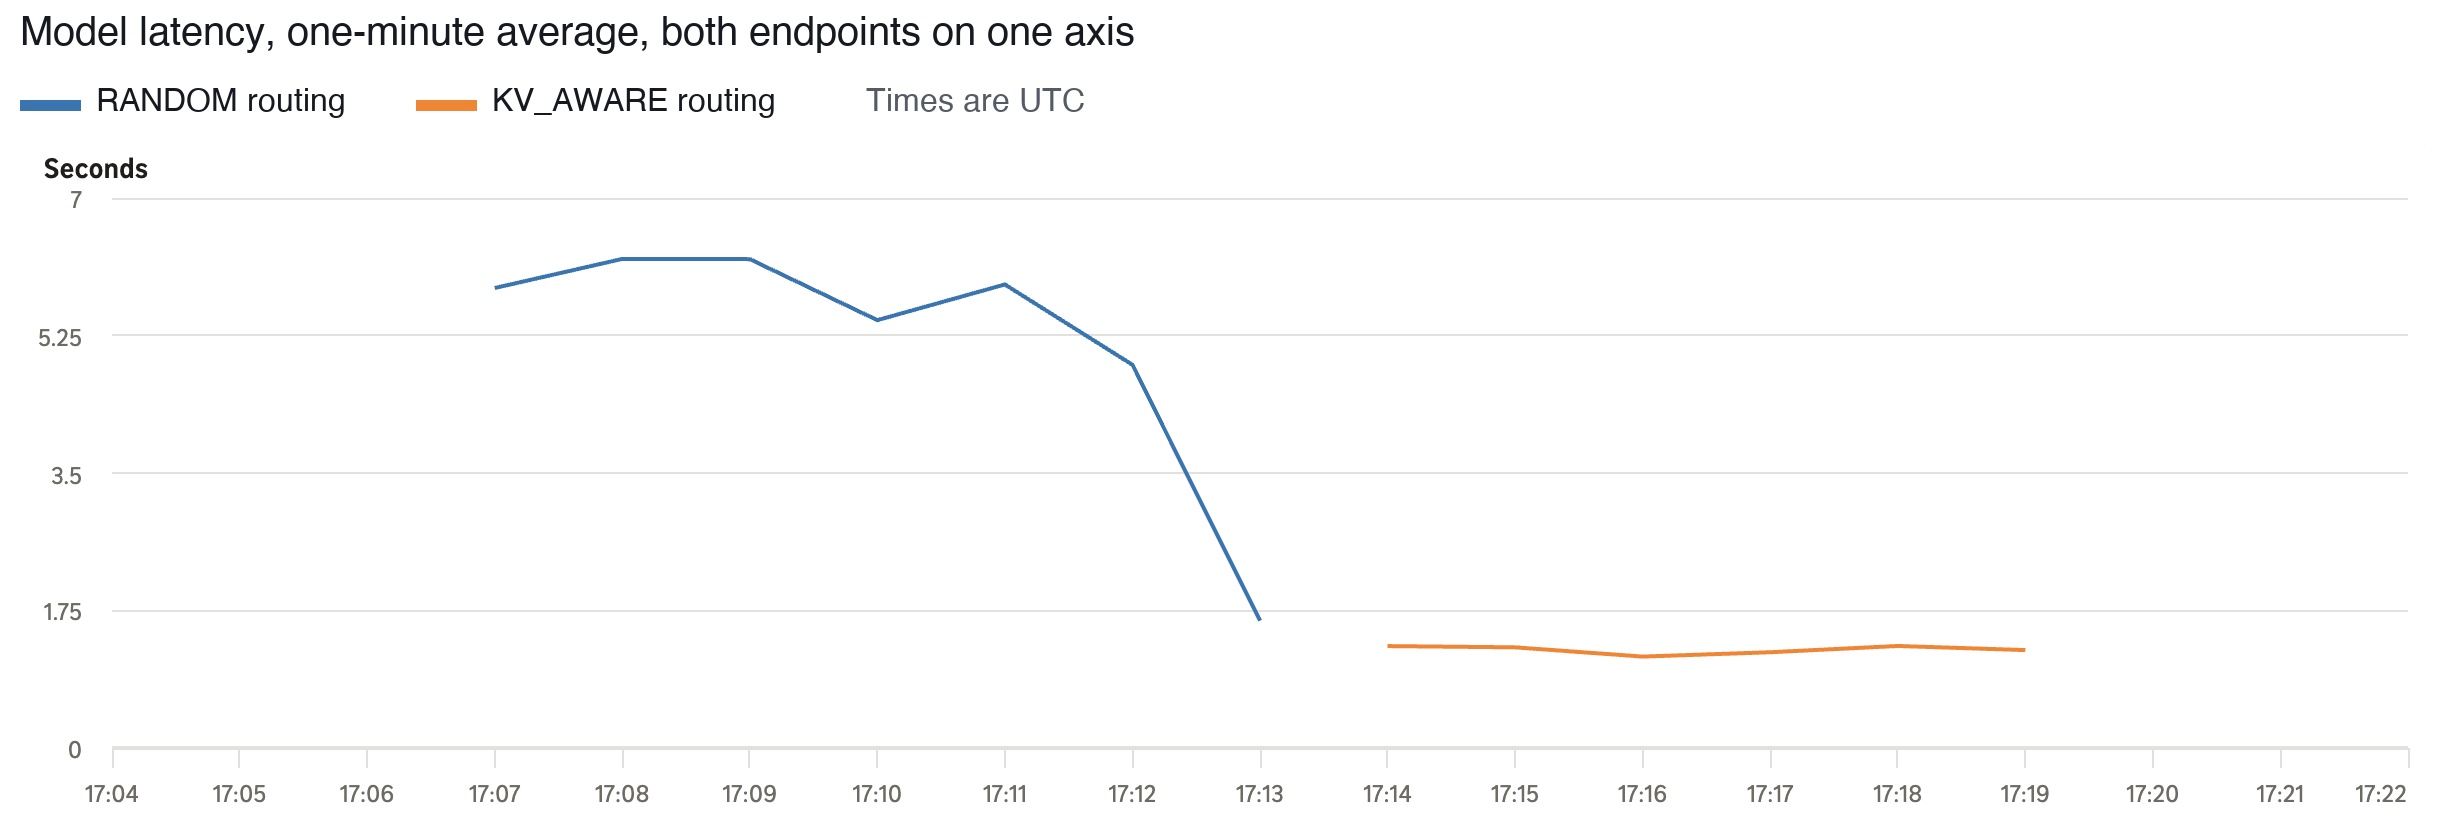
圖 3:Amazon CloudWatch 中 RANDOM 端點(藍色)和 KV_AWARE 端點(橙色)的每分鐘平均模型延遲,兩者共用 0–7 秒的縱軸範圍。每個端點都以新文件連續執行七次相同的工作負載,先執行 RANDOM。RANDOM 的平均模型延遲為 4.9–6.2 秒,KV_AWARE 則為 1.2–1.3 秒。最後一個 RANDOM 數值較低,因為該分鐘只涵蓋該次測試最後 20 個請求
如果兩者的表現都不及 RANDOM,請確認容器已啟用前綴快取和 KV 快取事件,詳情請參閲「要求與限制」。
範例筆記本
範例筆記本將本文介紹的步驟應用於 Qwen/Qwen3-4B-Instruct-2507,分別在兩個 ml.g5.xlarge 執行個體上(單一模型端點所需的最低數量),以及有兩個副本的推理元件端點上執行。筆記本使用兩種 API 呼叫端點,並在容器日誌中顯示後續請求由 KV 快取提供服務;它不會比較路由策略。請在最後執行清理儲存格,以免持續產生費用。
清理
為免持續產生費用,請刪除已建立的資源。對於推理元件端點,請先刪除推理元件(delete-inference-component),再刪除端點、端點組態和模型(delete-endpoint、delete-endpoint-config、delete-model)。
實用指引
啟用 KV 感知路由後,以下三項做法有助維持其成效。
監察 KV 快取命中率 – 上線後持續進行詳細的可觀測性監察,並在 SageMaker AI Insights 儀錶板(圖 2b)查看 KV 快取命中率的變化,或按照「確認 KV 感知路由正常運作」一節的説明,使用 PromQL 查詢該指標。
為冷啟動作好準備 – 當請求首次帶有新上下文(例如新文件或對話的第一輪)時,任何執行個體都沒有快取內容。KV 感知路由可加快後續請求,而非第一個請求。
為擴展及更新期間重建快取作好準備 – 如「KV 感知路由的運作方式」一節所述,新執行個體啟動時快取是空的。為減輕延遲增加的影響,單模型端點可採用滾動更新或藍綠更新;推論元件則可採用 RollingUpdatePolicy。
結論
KV 感知路由為 SageMaker AI 即時端點提供另一種路由方式,將請求傳送至已快取相關提示詞的位置。它會使用模型容器回報的快取狀態,因此當執行個體因記憶體壓力而清除快取時,路由也會根據快取狀態調整。本系列第 1 部分介紹的前綴感知路由,仍是適用於穩定的共享提示詞、較短上下文及中等負載的較簡單選擇。兩種策略的路由都由 SageMaker AI 在端點內處理,因此你無須自行建置或執行路由層。只需在模型中設定一個環境變數,並在端點設定中設定 "RoutingStrategy": "KV_AWARE",即可啟用。
凡支援 SageMaker AI 即時推論並使用受支援容器的端點,現時均可在所有 AWS 商業區域使用 KV 感知路由,而且無須額外付費。SageMaker AI 會代你執行及管理快取索引,你只需支付端點所用執行個體的費用。KV_AWARE 是現有 RoutingStrategy 欄位的新值,因此無須建立新的設定物件,舊版 AWS CLI 和 Boto3 亦可接受此值。要開始使用,請閲讀文件,在小型端點上執行範例筆記簿,然後在自有流量的副本上比較 KV_AWARE 與 PREFIX_AWARE。
作者簡介

Dmitry Soldatkin
Dmitry 是 AWS Amazon SageMaker AI 推論專家解決方案架構全球負責人。他協助客戶設計、建置及最佳化生成式 AI 和機器學習方案,專注於推論效能最佳化、深度學習,以及在企業內擴展 ML。此前,他曾在金融服務、保險及電訊公司帶領團隊。

Shashi Kiran
Shashi 是 AWS 分散式推論專家解決方案架構全球負責人,致力於解決客戶在擴展及最佳化 AI/ML 推論方面的複雜挑戰。他協助客戶設計及建置生成式 AI 和深度學習的分散式服務平台,並將客戶需求和實際經驗轉化為 Amazon SageMaker 的產品方向。

Apoorva Chandra
Apoorva 是 Amazon SageMaker AI 推論團隊的產品經理,專注於端點體驗及託管體驗。她與在生產環境部署生成式 AI 模型的客戶合作,讓加速運算資源更易取得、運作成本更低,並更易預測及管理。工作以外,Apoorva 喜歡行山、探索咖啡店,以及與朋友相聚。

Shijie Lyu
Shijie 是 Amazon SageMaker AI 推理團隊的軟件開發工程師,負責大規模語言模型推理及訓練。他的工作涵蓋 KV 感知路由、LoRA 配接器服務、推測解碼、快速擴展及異構叢集。他亦負責構建強化學習後訓練基礎設施、使用 CUDA 和 Triton 優化 GPU 核心,並參與 vLLM 和 SGLang 開源專案。
來源:AWS Machine Learning Blog · aws.amazon.com